浏览器代理值得从旧版切换到 Claude Fable 5.2 吗?

如果你的浏览器代理目前运行在 5.1 上,我们会建议切换到 Claude Fable 5.2。它更快、更便宜,也更准确。在这次 Claude Fable 5.2 与 5.1 对比测试中,我们让每个模型在相同的 28 项 Web 任务上各运行一次,Fable 5.2 的成功率为 89.3%,Fable 5.1 为 82.1%。在两个模型都成功完成的任务中,Fable 5.2 每项任务耗时 418.5 秒、成本 $2.63,Fable 5.1 则为 450.6 秒和 $3.28。
- 从多个官方网站收集相同信息时,Fable 5.2 的平均成本更低,成功率也略高。
- 对于单个 Web 应用内的工作流,两个模型各自的 4 次尝试全部成功,Fable 5.2 每项任务成本更低。
- 不过,如果你的主要任务是开放式研究,Fable 5.1 在保持与 Fable 5.2 相同成功率的同时,成本略低。
| 模型 | 成功率 | 每项成功任务耗时 | 每项成功任务成本 | 每次成功尝试成本 |
|---|---|---|---|---|
| Claude Fable 5.2 | 89.3% (25/28) | 418.5 s | $2.63 | $3.13 |
| Claude Fable 5.1 | 82.1% (23/28) | 450.6 s | $3.28 | $4.85 |
Fable 5.2 完成了前代未能完成的哪些任务
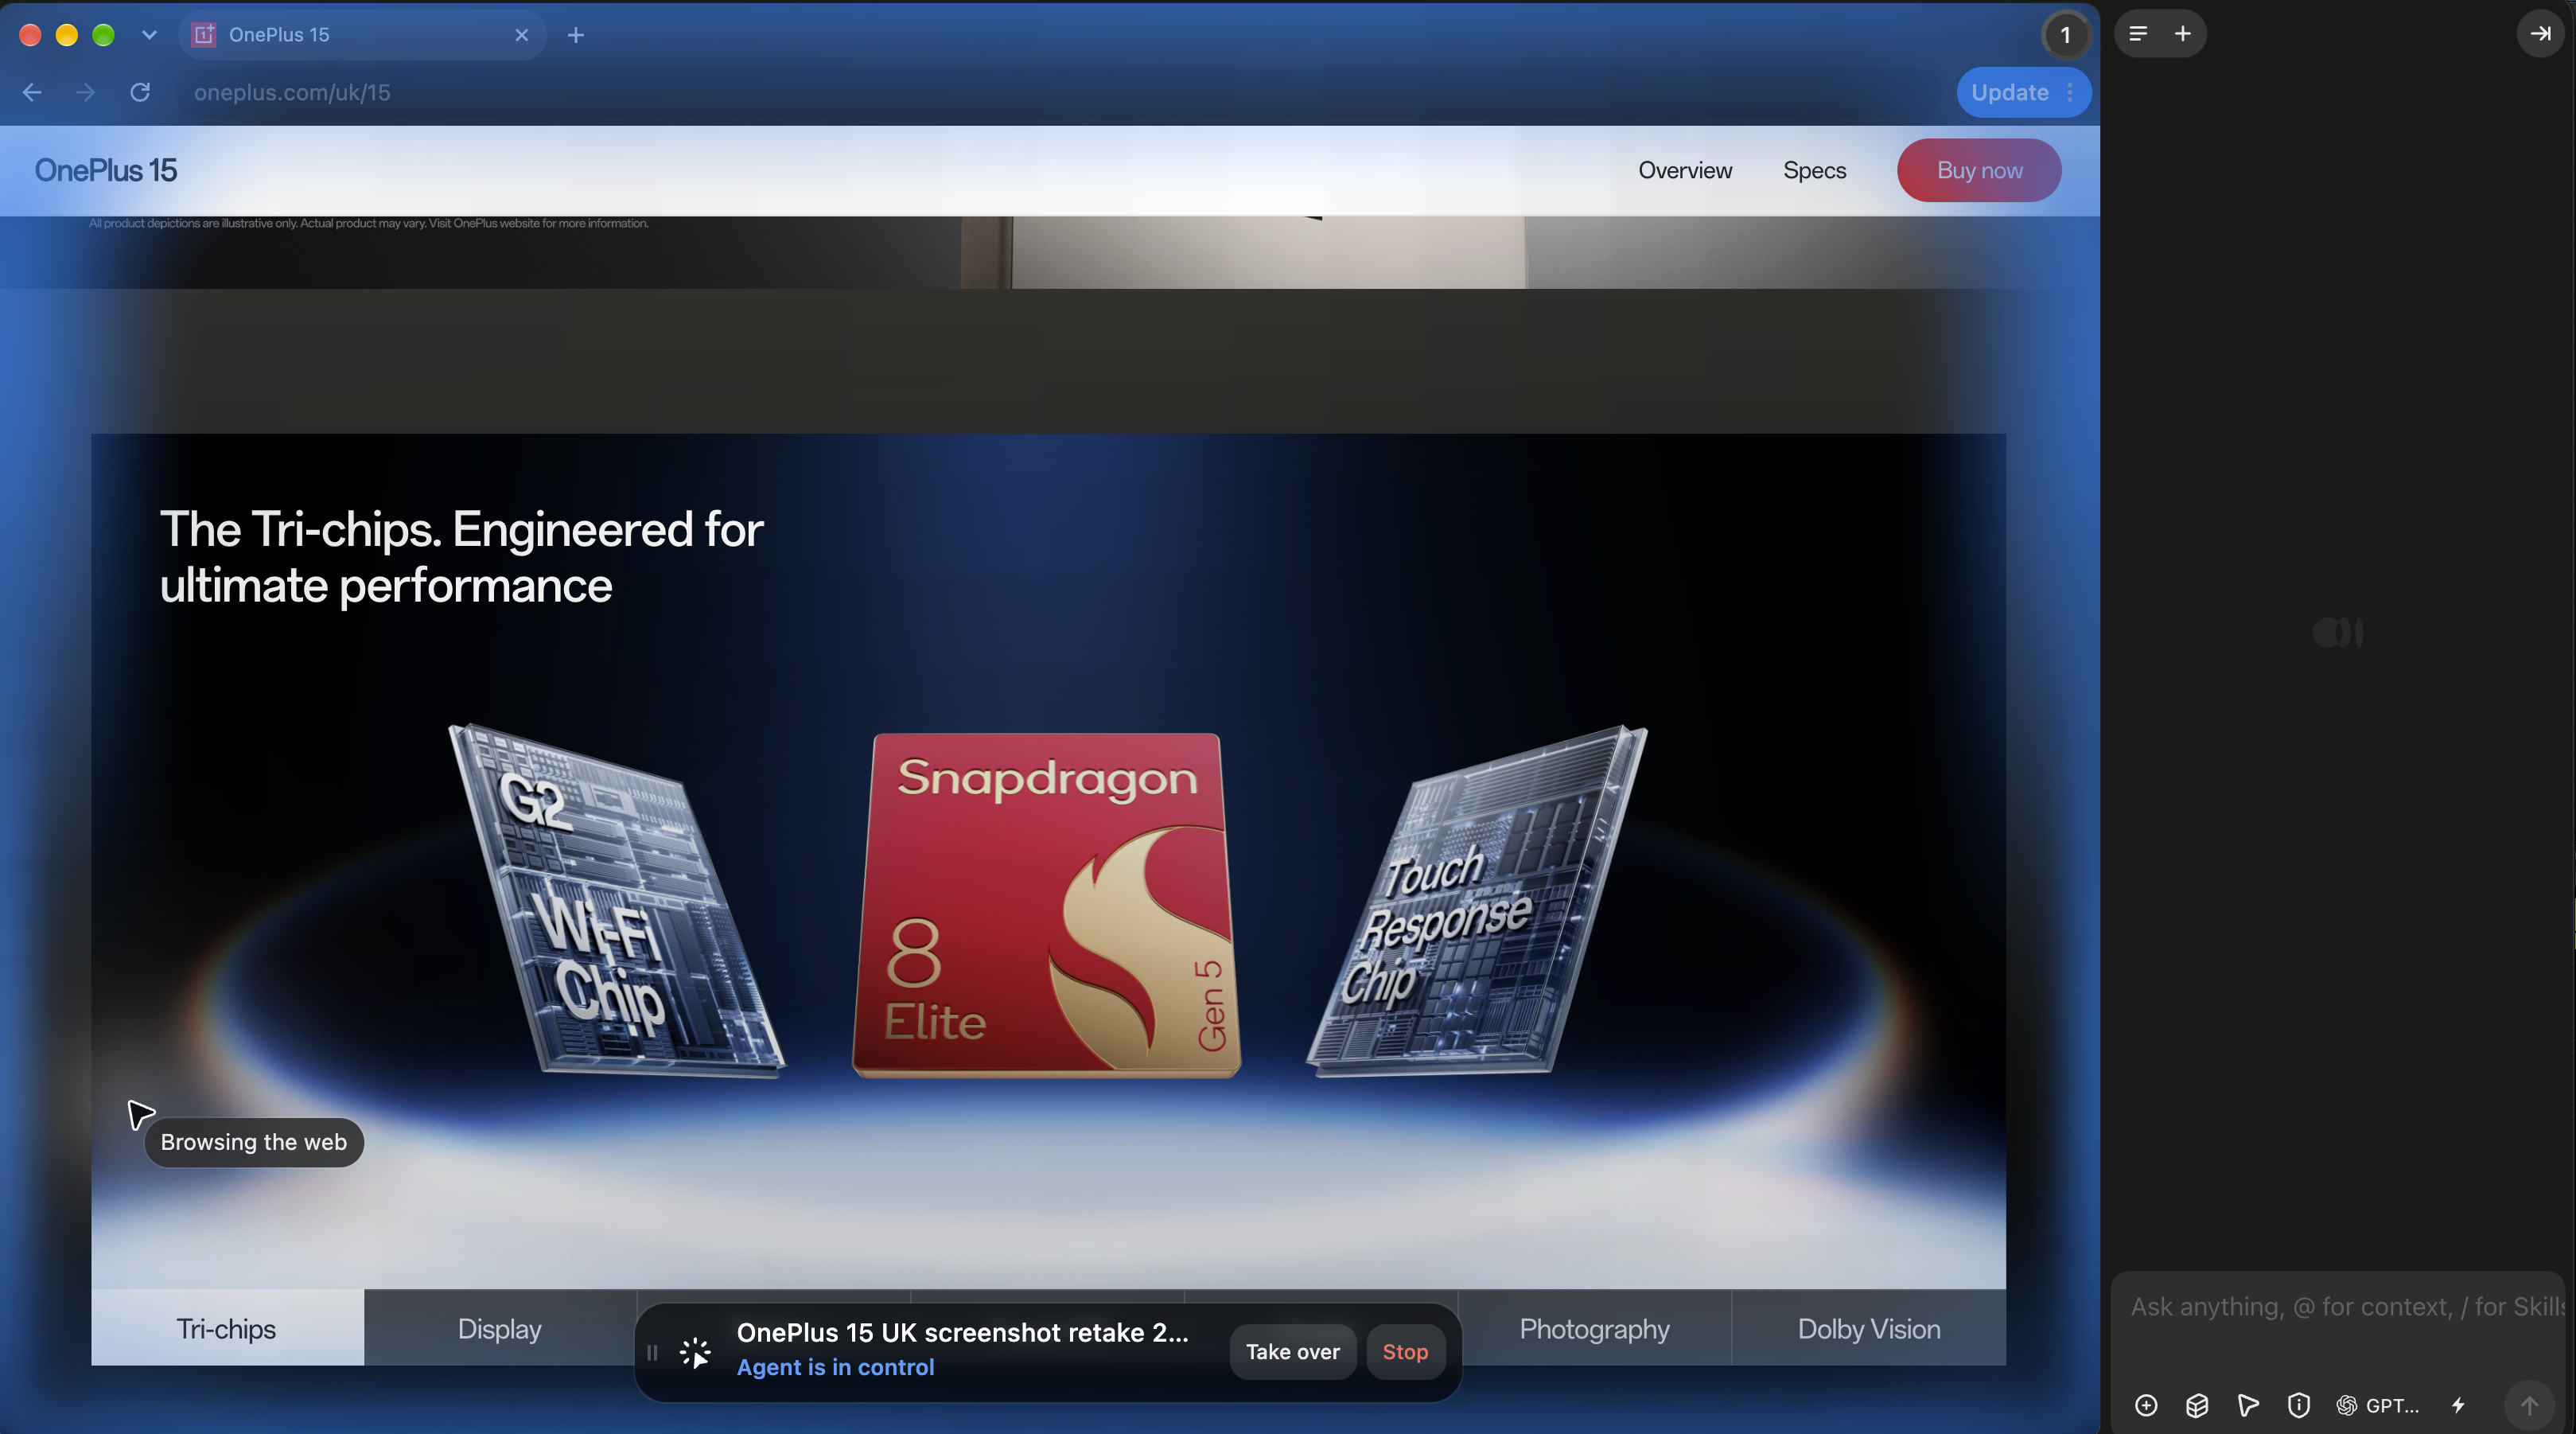
两个 Fable 模型都是能力很强的浏览器代理,因此我们用要求较高的日常工作来测试。其中一项是挑选工作手机:从各家厂商自己的官网,为九款旗舰手机制作规格表,每款包含多个字段。OnePlus 15 的概览页面只在一张没有替代文本的产品图片中展示 IP 等级。两个模型都在 ego(lite) 中打开了该页面。Fable 5.2 截取了这张图片,并读出了全部四个等级:IP66、IP68、IP69 和 IP69K。
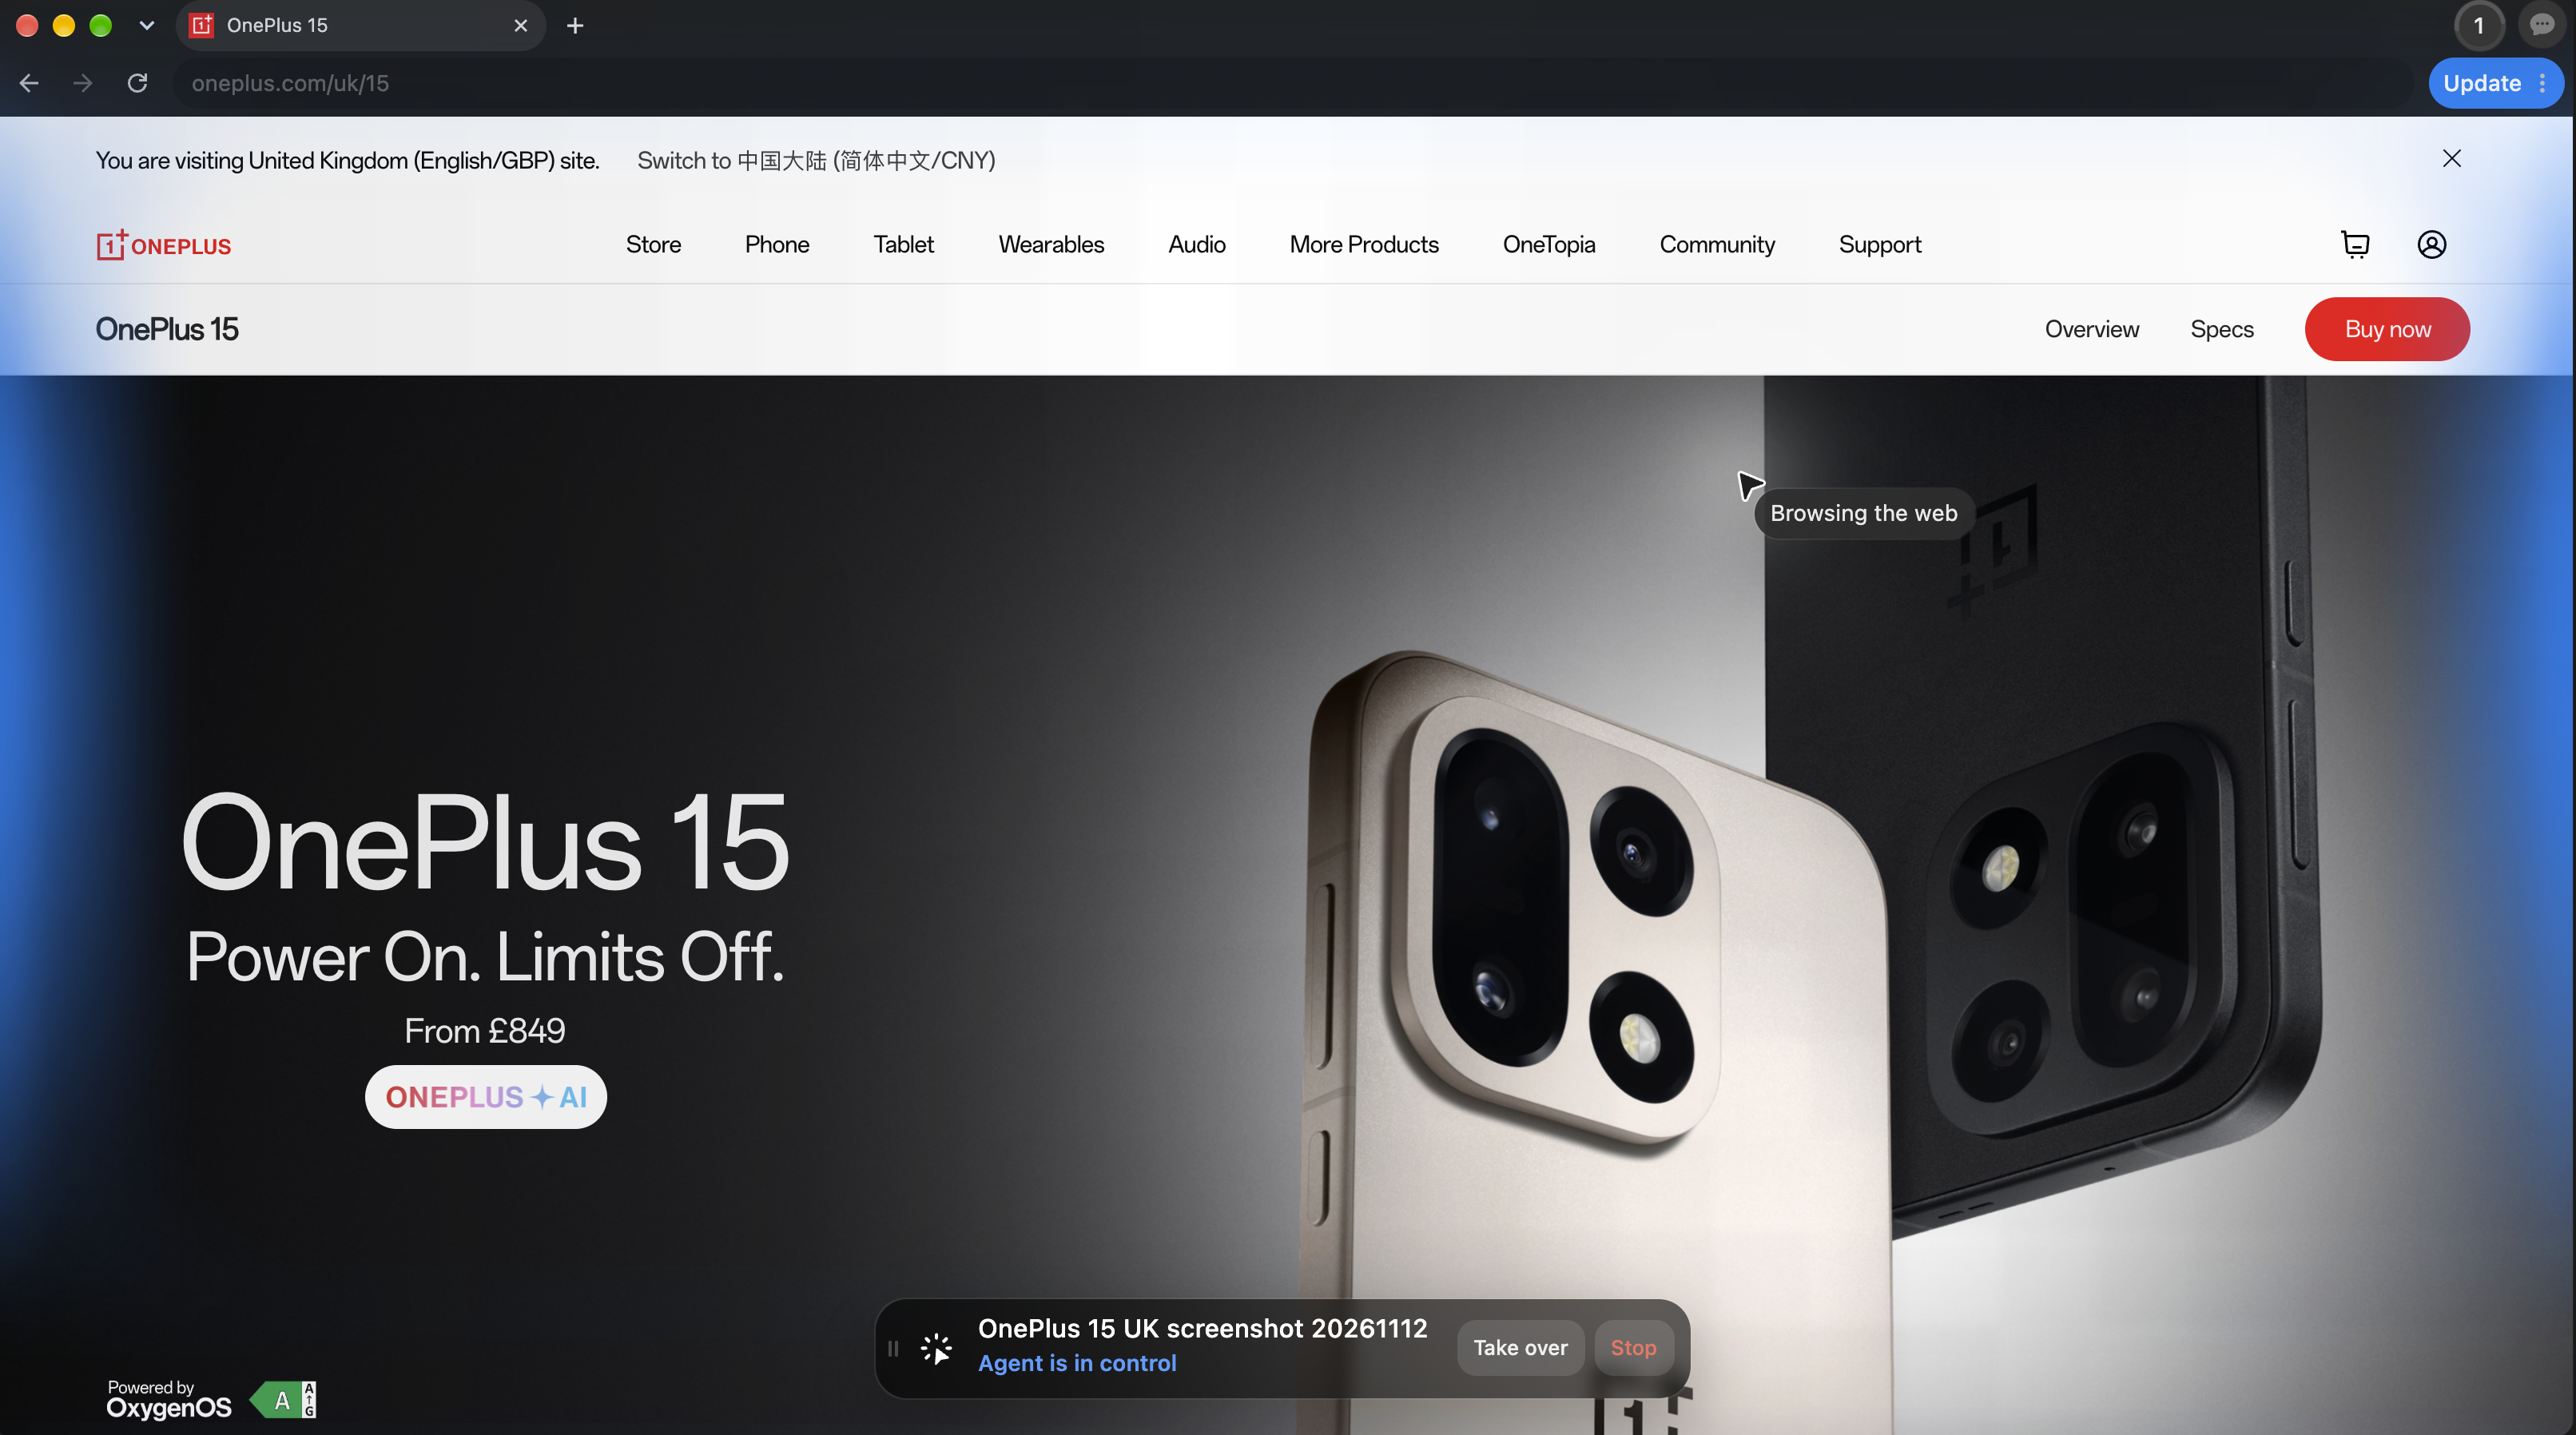
Fable 5.1 在同一页面的文本中搜索 IP 代码,没有找到。随后,它从规格页面的一行生态设计说明中获取了 IP68。最终表格只为 OnePlus 15 列出一个等级,因此这款手机也没有出现在它的 IP69 设备列表中。Fable 5.2 在这项任务上进行了 65 次工具调用,Fable 5.1 则为 31 次,因此正确答案的成本是 $6.04,对比之下另一个答案为 $3.13。
哪些工作用 Fable 5.1 就已足够
Fable 5.1 是一款能胜任工作的浏览器代理,继续使用它仍然合理。它成功完成了每项 Web 应用工作流和研究任务,例如预订旅行、填写采购订单和追溯信息来源。如果你的代理主要处理这类任务,切换不会显著增加完成的任务数。实际收益是价格降低约 20%。不过,如果你的代理经常需要跨多个站点填写很长的规格表或对比表,Fable 5.2 仍是更好的选择。在这些情况下,缺失或错误的字段值通常很难发现。
为什么 Fable 5.2 更便宜
Fable 5.2 更便宜,主要是因为 Anthropic 降低了定价。它的公开标价对每种 token 都比 Fable 5.1 低 20%。这也是我们建议切换的最主要原因。从效率来看,两者完成一项任务所做的工作量大致相同。Fable 5.2 每项任务生成的输出 token 约少 18%,但工具调用略多,为 35 次,而另一模型为 32 次,两者相互抵消。若按 Fable 5.1 的费率计价,账单金额会一样。
使用浏览器代理时,你主要是在为模型读取内容付费,而非写出内容。Fable 5.2 约 70% 的支出用于上下文:它获取的页面文本、快照和截图,加上先前的步骤记录,模型每轮都会重新读取这些内容。这也是跨越太多站点的工作往往最贵的原因。从 8 到 12 个官方网站采集相同信息,Fable 5.2 每项任务成本为 $4.65,而在最多三个站点上查询的任务成本为 $1.35。我们会根据代理的工作类型制定预算,而不只看模型价格。
更大的节省体现在每个可用结果的成本上。任务出错时,Fable 5.1 在停止前花费更多,因此约三分之一的总支出用于失败的尝试;Fable 5.2 则约为八分之一。把这些失败算在内,每次成功尝试的成本,Fable 5.1 为 $4.85,Fable 5.2 为 $3.13。这才是我们比较成本时会关注的数字。
以表格查看
| 工作类型 | Fable 5.2 成功情况 | Fable 5.1 成功情况 | Fable 5.2 每项任务成本 | Fable 5.1 每项任务成本 | 计入成本的任务数 |
|---|---|---|---|---|---|
| 所有任务类型 | 25/28 | 23/28 | $2.63 | $3.28 | 23 |
| 跨站点数据采集 | 9/10 | 8/10 | $4.65 | $5.77 | 8 |
| 搜索与比较 | 8/8 | 7/8 | $1.35 | $1.84 | 7 |
| Web 应用自动化 | 4/4 | 4/4 | $1.44 | $1.84 | 4 |
| 研究与综合 | 3/3 | 3/3 | $2.02 | $1.87 | 3 |
| 社交媒体验证 | 1/3 | 1/3 | $1.96 | $3.32 | 1 |
如何运行
我们运行了 claude-fable-5-2,在 Claude Code 中将推理强度设为 high,并配备 Bash、Read、Write、Edit 和 Skill 工具。代理会加载 ego-browser 的 skill 文件,并在 ego(lite) 中通过 ego-browser 操作页面。它会编写简短的 JavaScript 脚本,由 ego-browser 运行这些脚本来控制 ego(lite) 中的页面。
常见问题
对于浏览器代理,Claude Fable 5.2 比 Fable 5.1 更好吗?
在我们的测试中,是的:Claude Fable 5.2 完成了 Fable 5.1 成功完成的每项任务,还额外完成了两项。在相同的代理运行框架和浏览器工具中,对 28 项 Web 任务各运行一次,Fable 5.2 的 28 次尝试中有 25 次成功(89.3%),Fable 5.1 的 28 次尝试中有 23 次成功(82.1%)。其中一项额外成功的任务是制作规格表,Fable 5.2 从产品图片中读出了 IP 代码。
值得从 Fable 5.1 升级到 Claude Fable 5.2 吗?
值得。对浏览器代理来说,Claude Fable 5.2 值得升级,因为完成相同工作所需的成本更低,也没有丢掉 Fable 5.1 已成功完成的任何任务。它在 28 次尝试中成功了 25 次,Fable 5.1 在 28 次中成功了 23 次。在两个模型都成功完成的 23 项任务中,它每项任务成本为 $2.63,而另一模型为 $3.28,节省来自 Anthropic 的 20% 降价。
Claude Fable 5.2 的每项任务成本比 Fable 5.1 更低,还是只在每个 token 上更便宜?
Claude Fable 5.2 不仅每个 token 更便宜,每项任务也更便宜:在两个模型都成功完成的 23 项 Web 任务中,每项任务成本为 $2.63,对比之下另一模型为 $3.28。它的各类 token 公开标价都低 20%。如果按 Fable 5.1 的费率计价,它在这些任务上的用量大约会花费 $3.28,因此已完成任务上每项任务的节省,来自价格下调。
Claude Fable 5.2 使用的 token 比 Fable 5.1 少吗?
在全部 28 次尝试中,Claude Fable 5.2 使用的输出 token 少了 29%,每次尝试为 20,138 个,Fable 5.1 为 28,481 个。在两个模型都成功完成的 23 项任务中,它生成的输出 token 仍更少,每项任务为 18,581 个,而另一模型为 22,607 个。如果按相同费率计价,它在这些任务上的总用量成本与 Fable 5.1 大致相同。
Claude Fable 5.2 在浏览器任务上比 Fable 5.1 更快吗?
是的,略快:在两个模型都成功完成的 23 项 Web 任务中,Claude Fable 5.2 每项任务耗时 418.5 秒,Fable 5.1 为 450.6 秒。Fable 5.2 在这 23 项任务中的 13 项更快。两者使用相同的代理运行框架和浏览器工具,耗时包含等待模型 API 的时间。
把 Claude Fable 5.2 用作浏览器代理,成本是多少?
在我们的测试中,Claude Fable 5.2 在两个模型都成功完成的 23 项 Web 任务上,每项任务平均成本为 $2.63;计入全部 28 次尝试后,每次成功尝试的成本为 $3.13。Fable 5.1 每项任务成本为 $3.28,每次成功尝试成本为 $4.85。跨站点数据采集是最昂贵的工作类型,Fable 5.2 每项任务成本为 $4.65。
Claude Fable 5.2 在浏览器自动化方面擅长什么?
在我们的测试中,Claude Fable 5.2 的每次 Web 应用自动化、搜索与比较、研究任务尝试都成功了,跨站点数据采集的 10 次尝试中有 9 次成功。Fable 5.1 在 10 次跨站点尝试中有 8 次成功,在 8 次搜索与比较尝试中有 7 次成功。Fable 5.2 额外成功的两项,来自这两类工作。
Claude Fable 5.1 在哪些方面仍能与 Fable 5.2 持平?
在 Web 应用工作流和开放式研究方面,Claude Fable 5.1 与 Fable 5.2 持平。两个模型各自的 4 次 Web 应用自动化尝试和 3 次研究与综合尝试全部成功。在研究任务中,Fable 5.1 每项任务成本为 $1.87,而另一模型为 $2.02;在 Web 应用工作流中,Fable 5.2 更便宜,为 $1.44,而另一模型为 $1.84。
Claude Fable 5.2 会在完成多步浏览器任务前停下来吗?
在我们的测试中没有:Claude Fable 5.2 的每次尝试都以最终答案结束,没有一次用尽 100 步额度。它的三次失败都给出了最终答案,但没有答对全部必需的字段值。
Claude Fable 5.2 能在无人值守的情况下执行浏览器任务吗?
Claude Fable 5.2 独立完成了大部分任务,在 28 次尝试中有 25 次成功,但它的三次失败也都以包含错误的最终答案结束。其中两次从错误来源取了字段值,例如较晚发布的安全版本,或另一份地区性新闻稿。涉及版本发布或定价数据时,请检查每个字段值具体来自哪个页面。
Claude Fable 5.2 如何使用浏览器?
Claude Fable 5.2 可以通过代理运行框架和浏览器工具来操作浏览器。在我们的测试中,它运行于 Claude Code,通过 ego-browser 操作 ego(lite),编写简短的 JavaScript 脚本,由 ego-browser 执行以控制页面。在这套配置下,它在 Web 任务的 28 次尝试中成功了 25 次。
测试方法
我们比较了 Claude Fable 5.2(claude-fable-5-2)和 Claude Fable 5.1(claude-fable-5-1),两者都将推理强度设为 high,使用相同的代理运行框架:配备 Bash、Read、Write、Edit 和 Skill 工具的 Claude Code。两者都通过 ego-browser 操作 ego(lite)。模型的脚本需要什么,ego-browser 就以相应形式提供页面:无障碍快照、页面文本或截图。测试于 2026 年 11 月 12 日在 Linux 上运行。
28 项任务涵盖五类工作。Web 应用自动化指测试用业务应用内的工作流,例如核对发票与付款。搜索与比较涉及一到三个站点,例如在 MDN 和 Can I use 上检查浏览器支持情况。跨站点数据采集指从 8 到 12 个官方网站收集相同字段,例如 12 家中央银行的利率决议。研究与综合是开放式任务,例如追溯 Wikipedia 表格的来源。社交媒体验证要求将 X 帖子与官方页面对应起来。每项任务只属于一类。
每个模型对每项任务运行一次,一项任务的一次运行就是一次尝试。只有最终答案中的每个必需字段值都正确,尝试才算成功。每次尝试最多有 100 步和 60 分钟。一步指模型的一轮交互,一次工具调用指模型调用工具一次,一次浏览器命令则是交给 ego-browser 的一段脚本。耗时是每次尝试实际经过的时间,包含等待模型 API 的时间。成本以美元计,根据每次尝试的 token 用量按 Anthropic 的公开标价计算,缓存读取和缓存写入分别使用各自的费率。每项成功任务的耗时和成本,在两个模型都成功完成的 23 项任务上比较。每次成功尝试的成本,是全部尝试的成本总和除以成功尝试的数量。
完整结果
每个单元格显示模型对该任务的一次尝试是否成功、耗时多少秒(包含等待模型 API 的时间),以及美元成本。其他部分的平均值使用未舍入的成本计算。
| 任务 | 工作类型 | Claude Fable 5.2 | Claude Fable 5.1 |
|---|---|---|---|
| 在预订应用中,按差旅政策预订航班、座位和酒店 | Web 应用自动化 | 成功 · 220.0 s · $1.66 | 成功 · 208.2 s · $2.19 |
| 在监控应用中,将服务监控项调整至符合书面标准 | Web 应用自动化 | 成功 · 140.7 s · $1.02 | 成功 · 158.2 s · $1.60 |
| 在库存应用中,根据库存水平创建采购订单 | Web 应用自动化 | 成功 · 163.0 s · $1.06 | 成功 · 128.2 s · $1.29 |
| 在财务应用中,将二月发票与付款对应并发起争议 | Web 应用自动化 | 成功 · 316.3 s · $2.02 | 成功 · 308.8 s · $2.28 |
| 对照讲座视频的 GitHub 代码和 arXiv 论文,核对视频章节 | 搜索与比较 | 成功 · 136.3 s · $1.14 | 成功 · 221.8 s · $1.57 |
| 使用 FRED 计算通胀数据,并在 BLS 核实 | 搜索与比较 | 成功 · 122.7 s · $1.03 | 成功 · 93.3 s · $1.11 |
| 在 MDN 和 Can I use 上交叉核对六项 Web 功能的浏览器支持情况 | 搜索与比较 | 成功 · 179.2 s · $1.14 | 成功 · 239.1 s · $2.13 |
| 在航班搜索站点上查找三个城市的最便宜直飞票价 | 搜索与比较 | 成功 · 683.0 s · $2.24 | 失败 · 768.3 s · $4.41 |
| 将 ClinicalTrials.gov 上的 3 期试验与对应的 DailyMed 药品说明书核对 | 搜索与比较 | 成功 · 178.6 s · $1.52 | 成功 · 267.6 s · $2.24 |
| 在厂商的美国商店,为三种笔记本电脑配置查询价格并比较 | 搜索与比较 | 成功 · 378.2 s · $2.46 | 成功 · 392.0 s · $3.17 |
| 核对票房数据库与 Wikipedia 上六部电影的票房数据 | 搜索与比较 | 成功 · 102.2 s · $1.09 | 成功 · 87.6 s · $1.12 |
| 在 Companies House 上筛查英国四家公司 | 搜索与比较 | 成功 · 101.2 s · $1.09 | 成功 · 185.4 s · $1.52 |
| 根据 9 家 SaaS 信任中心的信息制作合规矩阵 | 跨站点数据采集 | 成功 · 1110.0 s · $6.16 | 成功 · 737.9 s · $5.56 |
| 从厂商网站收集 8 款相机的五项规格 | 跨站点数据采集 | 成功 · 482.4 s · $3.49 | 成功 · 480.9 s · $4.35 |
| 从厂商的英国网站收集 9 款旗舰手机的五项规格 | 跨站点数据采集 | 成功 · 992.6 s · $6.04 | 失败 · 467.5 s · $3.13 |
| 收集 9 场开发者大会的开场主题演讲信息 | 跨站点数据采集 | 成功 · 920.8 s · $4.85 | 成功 · 1168.4 s · $8.85 |
| 从厂商的美国网站收集 9 款电动 SUV 的续航和充电数据 | 跨站点数据采集 | 成功 · 1120.9 s · $6.91 | 成功 · 1261.0 s · $6.91 |
| 从 Hugging Face 和厂商页面收集 9 个开放权重模型的规格与许可证 | 跨站点数据采集 | 成功 · 758.7 s · $5.24 | 成功 · 1059.6 s · $6.26 |
| 从 9 家劳工机构收集法定最低工资 | 跨站点数据采集 | 成功 · 567.0 s · $4.25 | 成功 · 640.1 s · $5.32 |
| 从 12 家中央银行的网站收集 2026 年首次利率决议 | 跨站点数据采集 | 成功 · 525.9 s · $3.51 | 成功 · 435.1 s · $4.52 |
| 比较 9 个无服务器平台的免费层级 | 跨站点数据采集 | 成功 · 501.1 s · $2.77 | 成功 · 665.2 s · $4.40 |
| 比较同一张专辑在 9 家音乐服务上的条目信息 | 跨站点数据采集 | 失败 · 408.6 s · $1.98 | 失败 · 292.4 s · $2.22 |
| 在公共模型数据库中统计超过 EU 计算量门槛的模型数量 | 研究与综合 | 成功 · 195.2 s · $1.64 | 成功 · 80.4 s · $1.08 |
| 从交互式排行榜图表读取成本和得分数据点 | 研究与综合 | 成功 · 317.1 s · $2.39 | 成功 · 327.3 s · $2.41 |
| 追溯 Wikipedia 表格中 10 个单元格的来源 | 研究与综合 | 成功 · 382.2 s · $2.03 | 成功 · 342.7 s · $2.12 |
| 将 8 个品牌在 X 上的产品帖子与新闻稿对应 | 社交媒体验证 | 失败 · 1132.7 s · $3.79 | 失败 · 2200.8 s · $14.22 |
| 将 8 个开源项目在 X 上的安全帖子与各自的公告对应 | 社交媒体验证 | 失败 · 750.8 s · $3.75 | 失败 · 3302.8 s · $12.30 |
| 将一周的 SpaceX 在 X 上的发射帖子与 Wikipedia 发射列表对应 | 社交媒体验证 | 成功 · 706.2 s · $1.96 | 成功 · 875.8 s · $3.32 |