¿Vale la pena cambiar a Claude Fable 5.2 para los agentes de navegador?

Recomendaríamos cambiar a Claude Fable 5.2 si tu agente de navegador funciona actualmente con 5.1. Es más rápido, barato y preciso. En nuestra prueba de Claude Fable 5.2 frente a 5.1, ejecutamos cada modelo una vez en las mismas 28 tareas web: Fable 5.2 superó el 89.3% y Fable 5.1 el 82.1%. En las tareas que superaron ambos modelos, Fable 5.2 necesitó 418.5 segundos y $2.63 por tarea, frente a 450.6 segundos y $3.28 de Fable 5.1.
- Al recopilar los mismos detalles de varios sitios oficiales, Fable 5.2 tuvo un coste medio menor y una tasa de éxito algo mayor.
- En los flujos de trabajo dentro de una sola aplicación web, ambos modelos superaron los 4 intentos y Fable 5.2 costó menos por tarea.
- Sin embargo, si tu tarea principal es la investigación exploratoria, Fable 5.1 costó algo menos con la misma tasa de éxito que Fable 5.2.
| Modelo | Tasa de éxito | Tiempo por tarea superada | Coste por tarea superada | Coste por intento exitoso |
|---|---|---|---|---|
| Claude Fable 5.2 | 89.3% (25/28) | 418.5 s | $2.63 | $3.13 |
| Claude Fable 5.1 | 82.1% (23/28) | 450.6 s | $3.28 | $4.85 |
Dónde Fable 5.2 termina lo que su predecesor no pudo
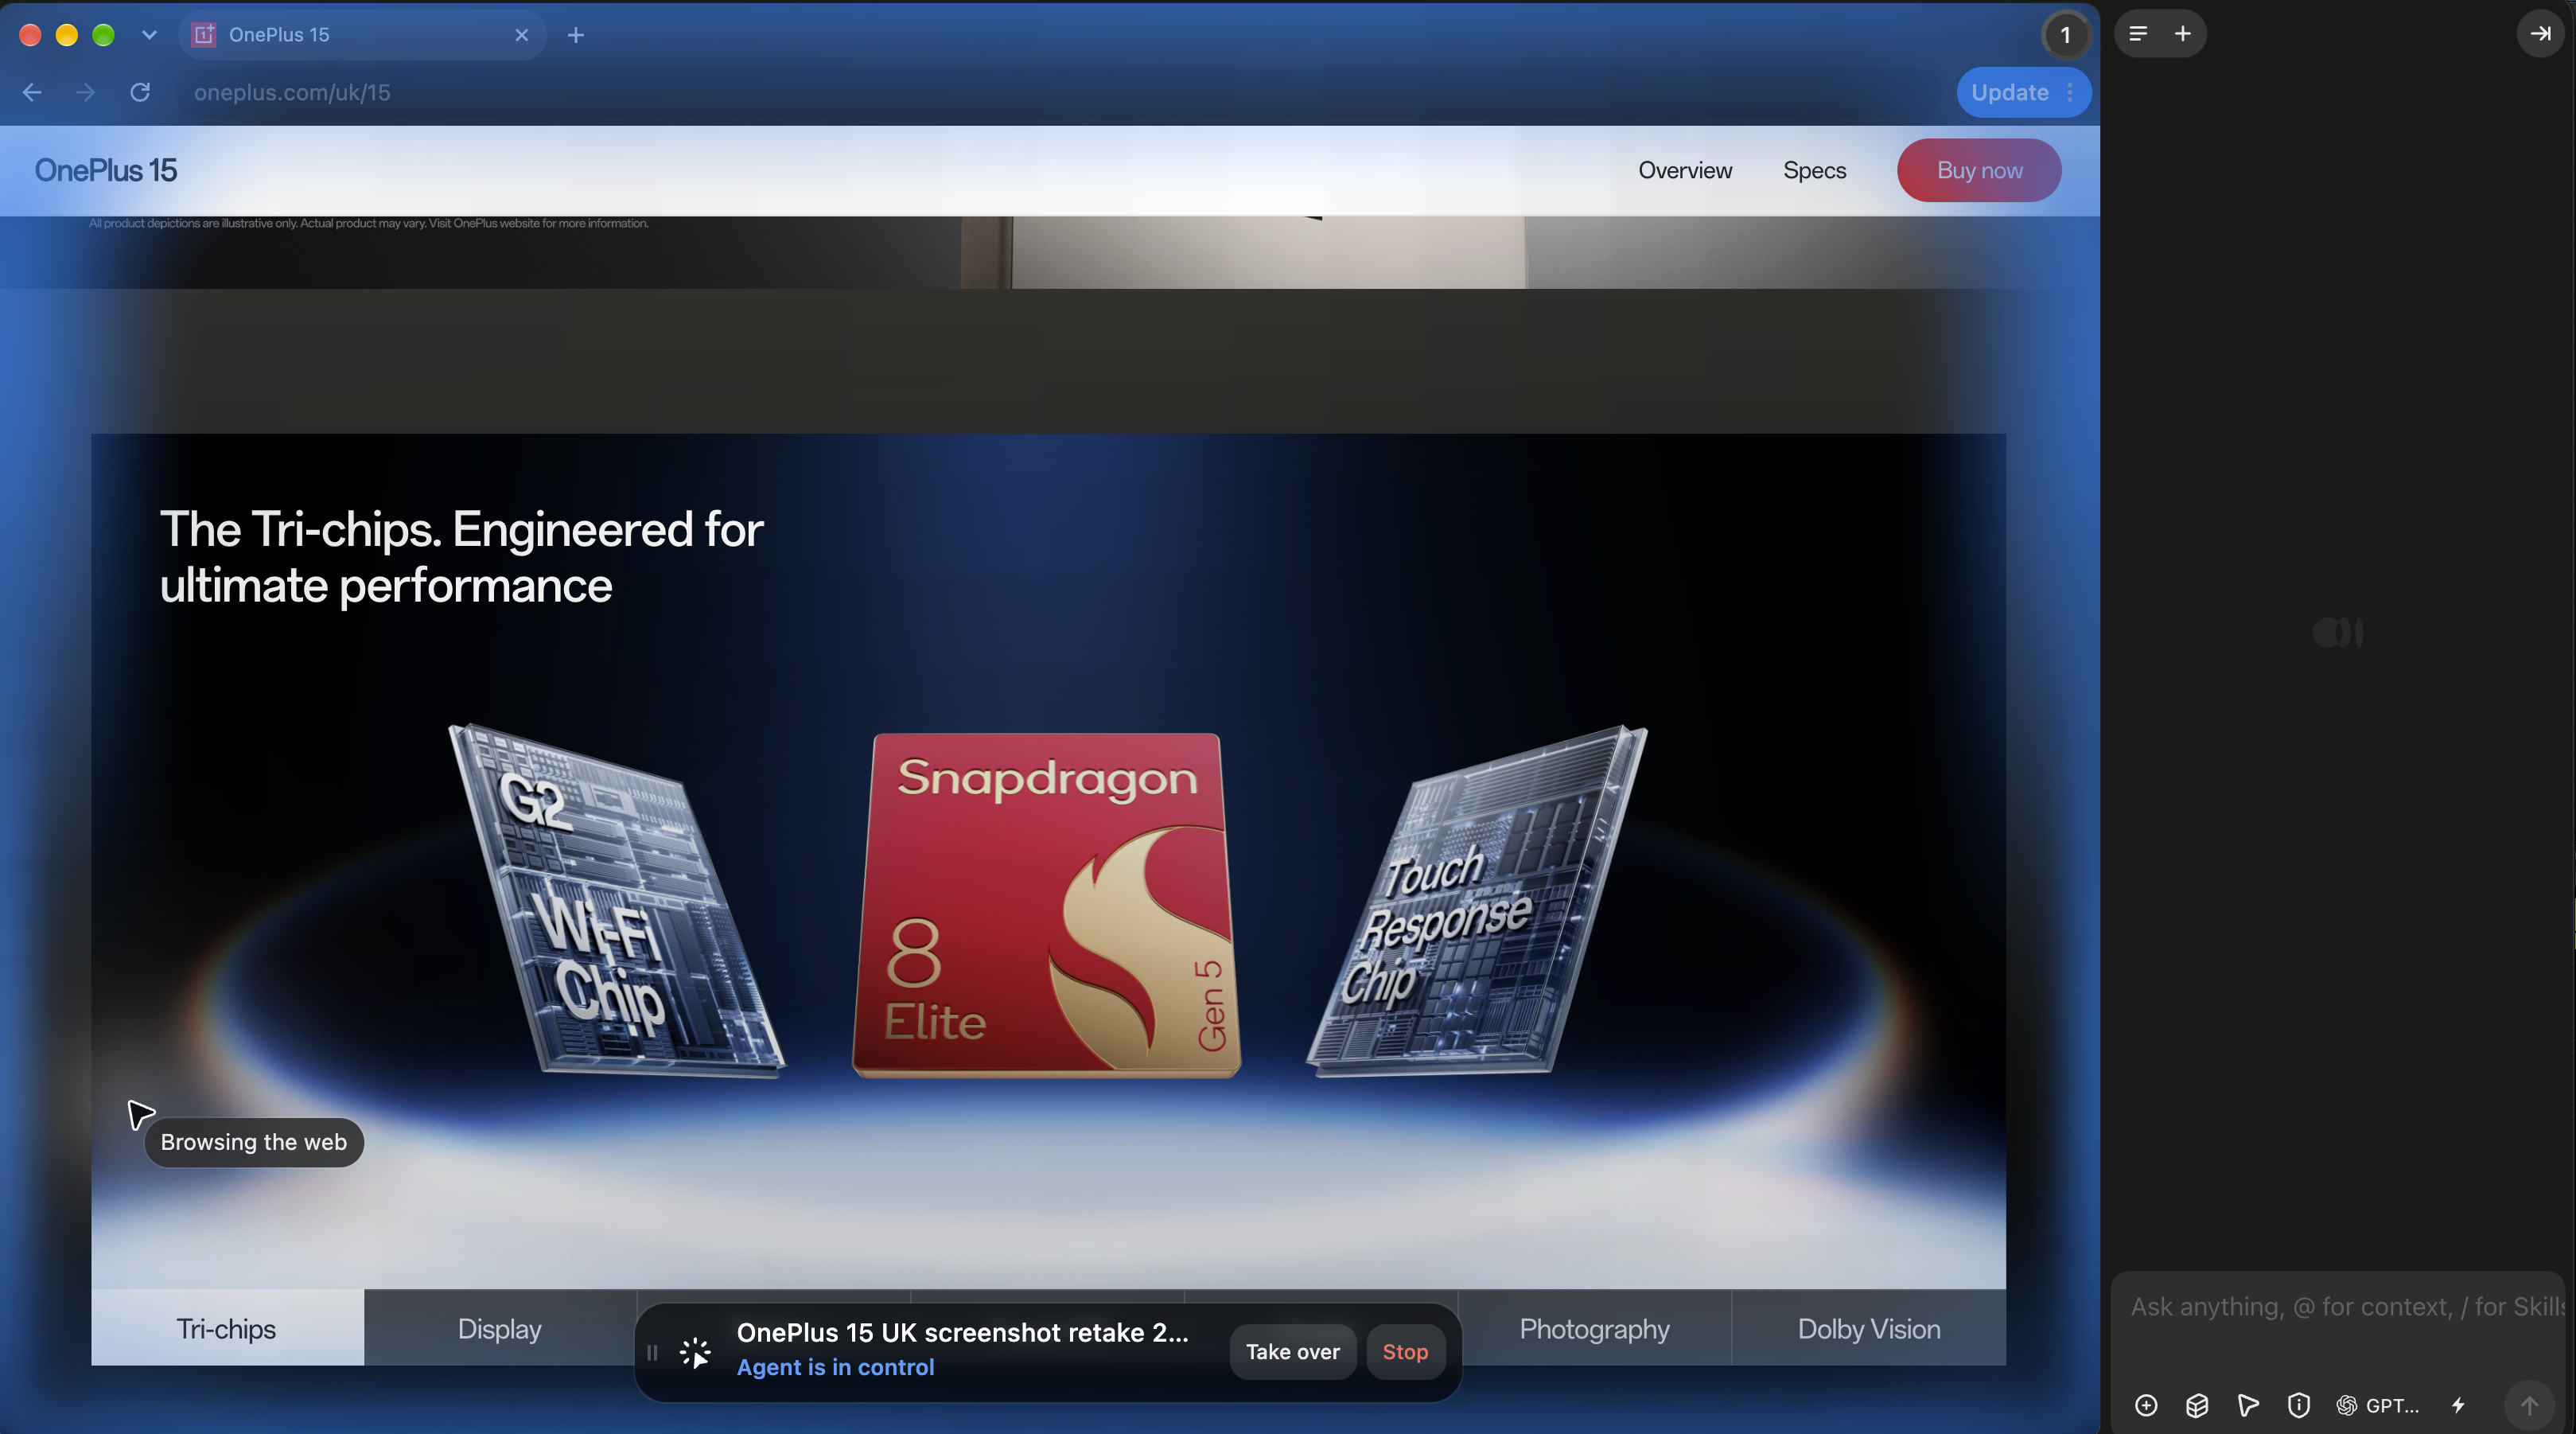
Ambos modelos Fable son buenos agentes de navegador, así que los probamos en trabajos cotidianos con requisitos exigentes. Uno consistía en elegir un teléfono de trabajo: crear una ficha de especificaciones de nueve teléfonos de gama alta, con muchos campos por teléfono, usando el sitio de cada fabricante. En la página de presentación del OnePlus 15, las clasificaciones IP solo aparecen dentro de una imagen del producto sin texto alternativo. Ambos modelos abrieron esa página en ego(lite). Fable 5.2 hizo una captura de pantalla de la imagen y leyó las cuatro clasificaciones: IP66, IP68, IP69 e IP69K.
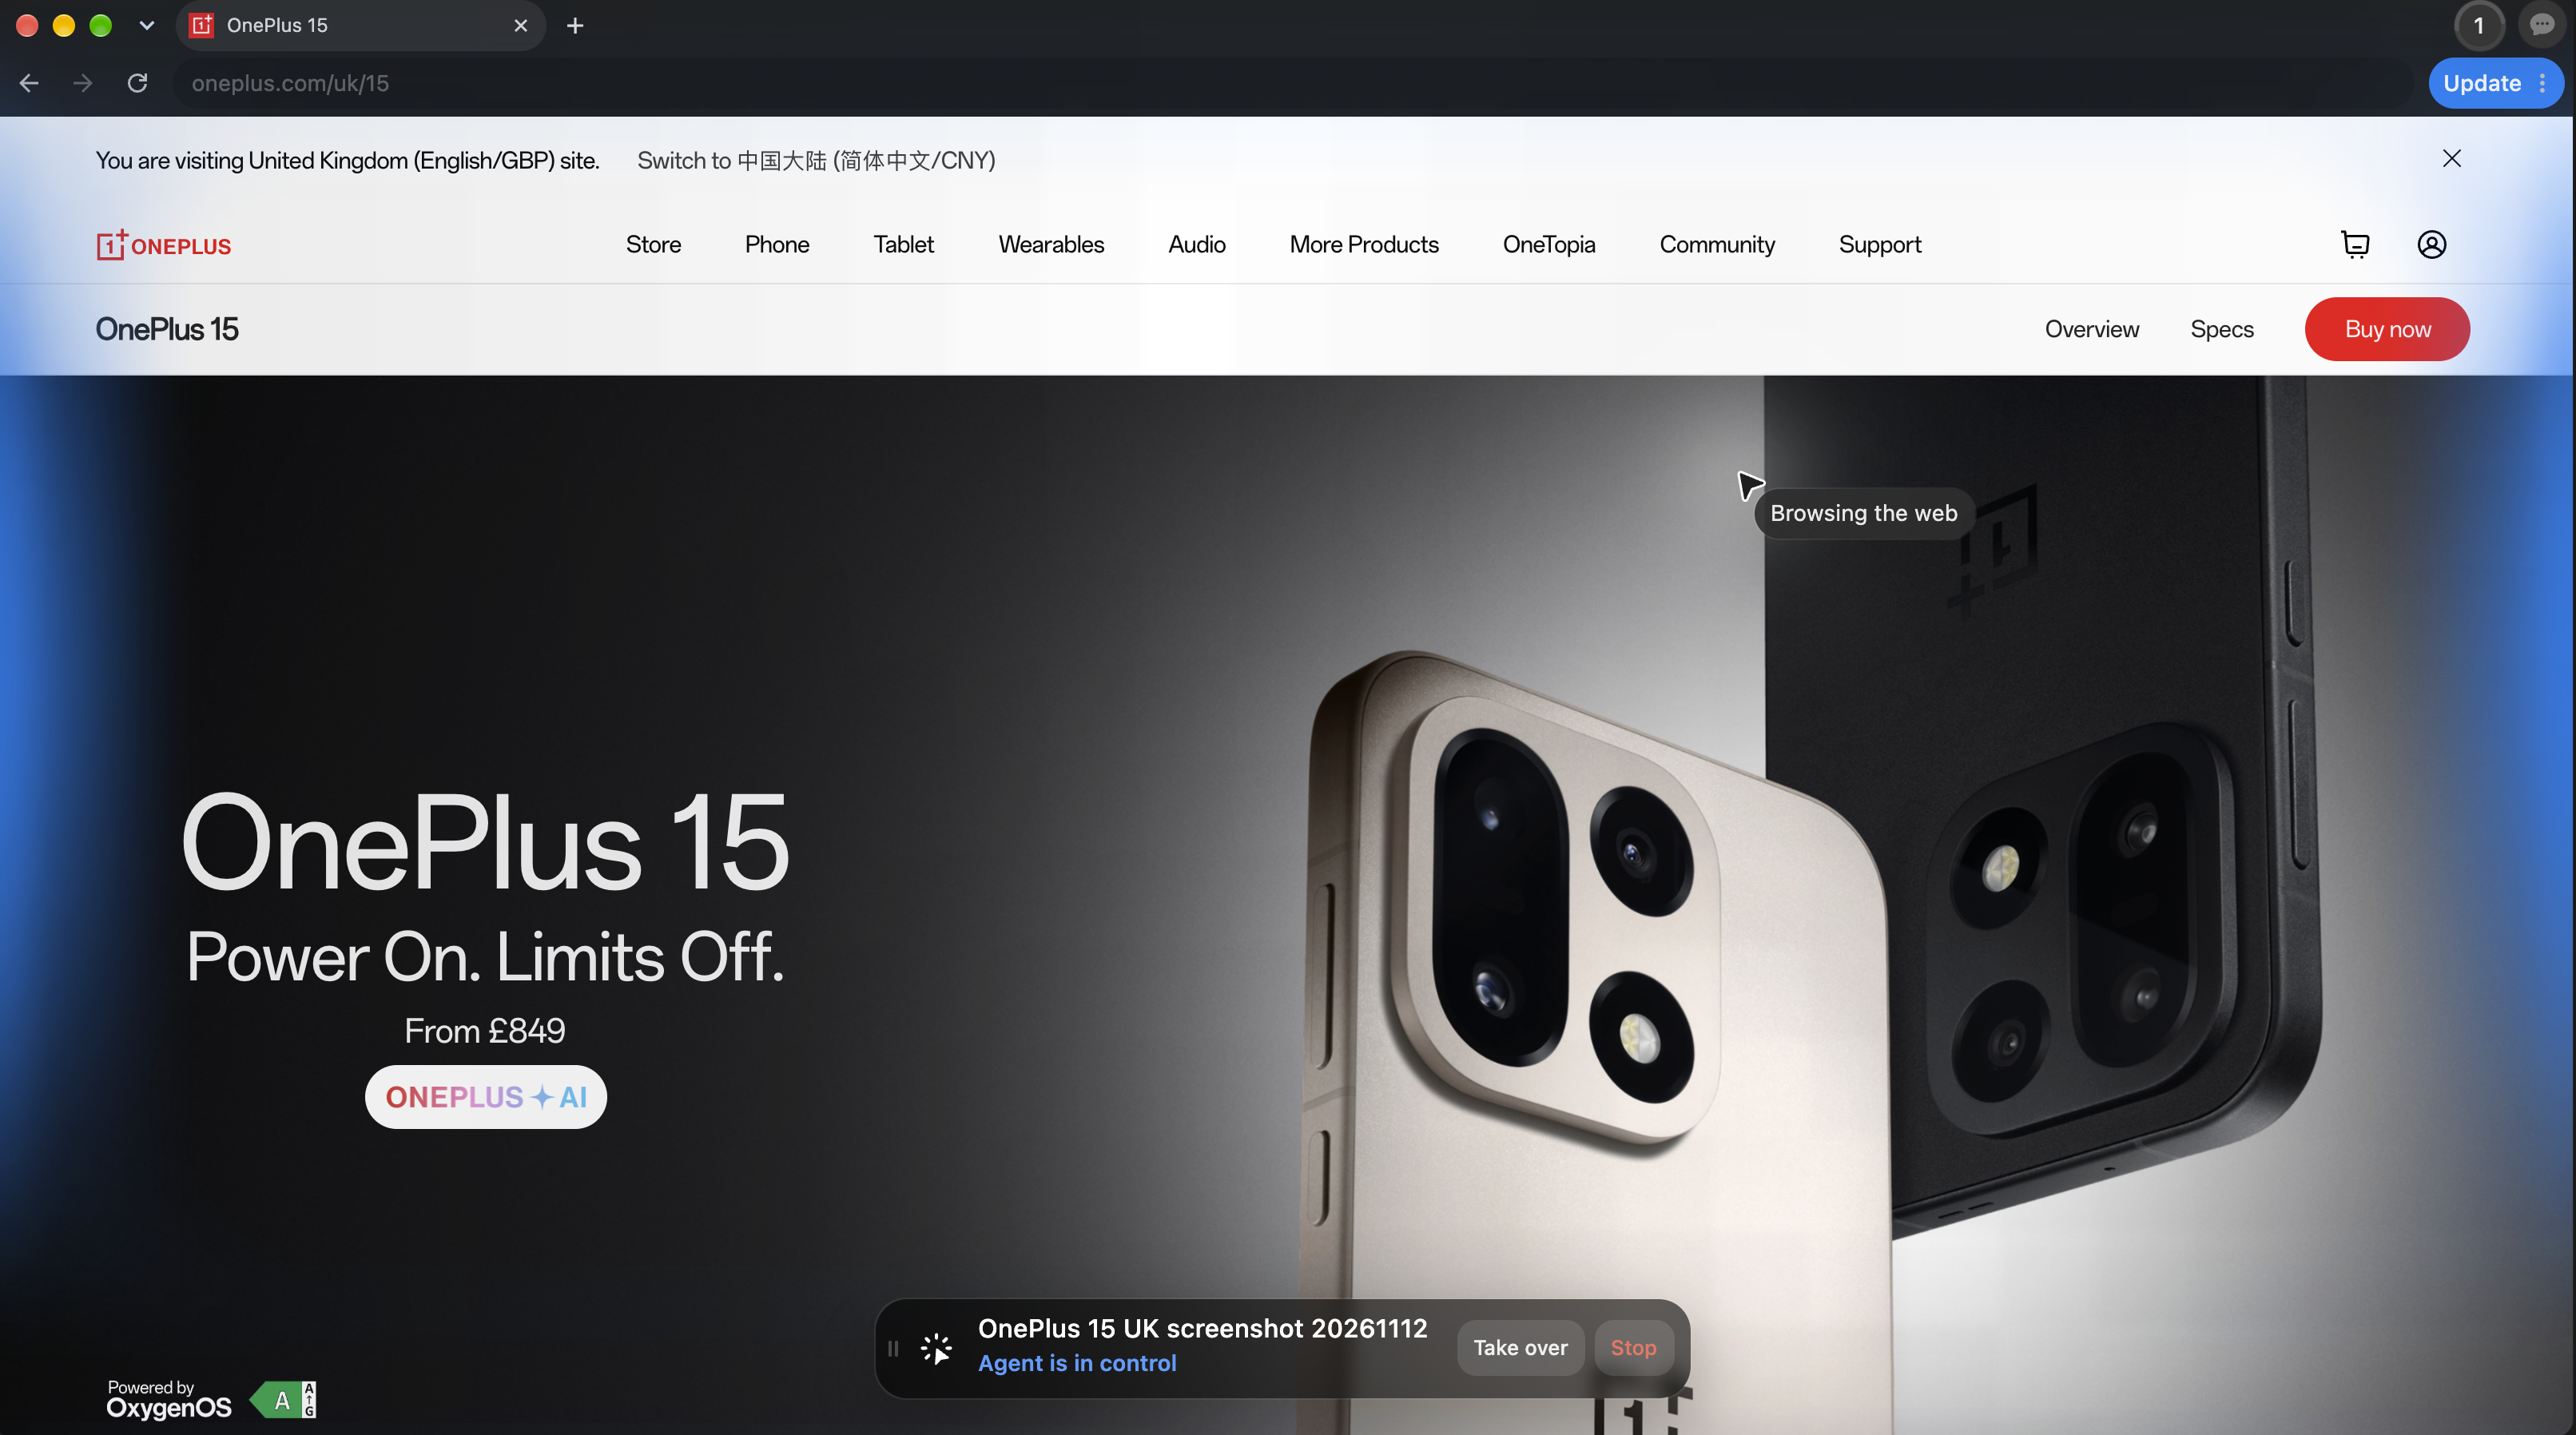
Fable 5.1 buscó códigos IP en el texto de la misma página y no encontró ninguno. Después tomó IP68 de una línea sobre ecodiseño en la página de especificaciones. Su tabla final asignó al OnePlus 15 una sola clasificación, por lo que el teléfono también quedó fuera de su lista de dispositivos IP69. Fable 5.2 hizo 65 llamadas a herramientas en esta tarea y Fable 5.1 hizo 31, de modo que la respuesta correcta costó $6.04, frente a $3.13.
Dónde Fable 5.1 ya hace un trabajo suficientemente bueno
Fable 5.1 es un agente de navegador capaz y seguir usándolo aún tiene sentido. Superó todos los flujos de aplicaciones web y las tareas de investigación, como reservar viajes, rellenar pedidos de compra y rastrear fuentes de información. Si tu agente se ocupa principalmente de tareas así, cambiar no aumentará de forma drástica las tareas terminadas. Lo que ganarías en la práctica es un precio aproximadamente un 20% menor. Sin embargo, Fable 5.2 sigue siendo la mejor opción si tu agente rellena a menudo fichas de especificaciones o tablas comparativas largas en varios sitios. En estos casos suele ser difícil detectar un valor omitido o incorrecto.
Por qué Fable 5.2 es más barato
Fable 5.2 es más barato principalmente porque Anthropic bajó el precio. Sus precios de lista son un 20% inferiores para todos los tipos de tokens respecto a Fable 5.1. Esa es también la principal razón para recomendar el cambio. En términos de eficiencia, ambos hicieron aproximadamente la misma cantidad de trabajo para terminar una tarea. Fable 5.2 generó alrededor de un 18% menos de tokens de salida por tarea, pero hizo algunas llamadas más a herramientas, 35 frente a 32, por lo que ambos efectos se compensan. A las tarifas de Fable 5.1, el importe resultante sería el mismo.
En un agente de navegador pagas sobre todo para que el modelo lea, no para que escriba. Aproximadamente el 70% del gasto de Fable 5.2 fue al contexto: el texto de las páginas, las instantáneas y las capturas que obtuvo, más sus pasos anteriores, que vuelve a leer en cada turno. Por eso los trabajos que abarcan demasiados sitios suelen ser los más caros. Recopilar los mismos detalles de entre 8 y 12 sitios oficiales costó $4.65 por tarea con Fable 5.2, mientras que una consulta en hasta tres sitios costó $1.35. Presupuestaríamos según el tipo de trabajo de tu agente, además del precio del modelo.
El mayor ahorro aparece al medirlo por resultado útil. Cuando una tarea salía mal, Fable 5.1 gastaba más antes de detenerse, por lo que aproximadamente un tercio de su total se fue a intentos fallidos, frente a un octavo de Fable 5.2. Al contar esos fallos, cada intento exitoso costó $4.85 con Fable 5.1 y $3.13 con Fable 5.2. Esa es la cifra que miraríamos al comparar el coste.
Ver como tabla
| Tipo de trabajo | Éxitos de Fable 5.2 | Éxitos de Fable 5.1 | Coste por tarea de Fable 5.2 | Coste por tarea de Fable 5.1 | Tareas incluidas en el coste |
|---|---|---|---|---|---|
| Todos los tipos de trabajo | 25/28 | 23/28 | $2.63 | $3.28 | 23 |
| Recopilación de datos en varios sitios | 9/10 | 8/10 | $4.65 | $5.77 | 8 |
| Búsqueda y comparación | 8/8 | 7/8 | $1.35 | $1.84 | 7 |
| Automatización de aplicaciones web | 4/4 | 4/4 | $1.44 | $1.84 | 4 |
| Investigación y síntesis | 3/3 | 3/3 | $2.02 | $1.87 | 3 |
| Verificación de redes sociales | 1/3 | 1/3 | $1.96 | $3.32 | 1 |
Cómo ejecutarlo
Ejecutamos claude-fable-5-2 con el esfuerzo de razonamiento en high en Claude Code, con las herramientas Bash, Read, Write, Edit y Skill. El agente carga el archivo de skill de ego-browser y controla ego(lite) mediante ego-browser. Escribe scripts breves de JavaScript que ego-browser ejecuta para controlar las páginas en ego(lite).
Preguntas frecuentes
¿Es Claude Fable 5.2 mejor que Fable 5.1 para los agentes de navegador?
En nuestras pruebas, sí: Claude Fable 5.2 superó todas las tareas que superó Fable 5.1 y dos más. En 28 tareas web, ejecutadas una vez cada una en el mismo entorno de agente y con la misma herramienta de navegador, Fable 5.2 superó 25 de 28 intentos (89.3%) y Fable 5.1 superó 23 de 28 (82.1%). Uno de los éxitos adicionales fue una ficha de especificaciones en la que Fable 5.2 leyó códigos IP de una imagen del producto.
¿Vale la pena actualizar de Fable 5.1 a Claude Fable 5.2?
Sí, Claude Fable 5.2 merece la actualización para agentes de navegador porque costó menos para el mismo trabajo y no perdió ninguna tarea que hubiera superado Fable 5.1. Superó 25 de 28 intentos, frente a 23 de 28 de Fable 5.1. En las 23 tareas que superaron ambos modelos, costó $2.63 por tarea frente a $3.28, lo que corresponde a la rebaja de precio del 20% de Anthropic.
¿Es Claude Fable 5.2 más barato que Fable 5.1 por tarea o solo por token?
Claude Fable 5.2 es más barato tanto por tarea como por token: $2.63 frente a $3.28 en las 23 tareas web que superaron ambos modelos. Sus precios de lista son un 20% inferiores para todos los tipos de tokens. A las tarifas de Fable 5.1, su uso en esas tareas costaría unos $3.28, por lo que el ahorro por tarea en el trabajo terminado es la rebaja del precio.
¿Usa Claude Fable 5.2 menos tokens que Fable 5.1?
En los 28 intentos, Claude Fable 5.2 usó un 29% menos de tokens de salida: 20 138 por intento, frente a 28 481 de Fable 5.1. En las 23 tareas que superaron ambos modelos, también generó menos tokens de salida: 18 581 por tarea frente a 22 607. Si se aplicaran las mismas tarifas, su uso total en esas tareas costaría aproximadamente lo mismo que el de Fable 5.1.
¿Es Claude Fable 5.2 más rápido que Fable 5.1 en las tareas de navegador?
Sí, ligeramente: en las 23 tareas web que superaron ambos modelos, Claude Fable 5.2 necesitó 418.5 segundos por tarea y Fable 5.1, 450.6 segundos. Fable 5.2 fue más rápido en 13 de esas 23 tareas. Ambos se ejecutaron en el mismo entorno de agente y con la misma herramienta de navegador, y el tiempo incluye la espera de la API del modelo.
¿Cuánto cuesta ejecutar Claude Fable 5.2 como agente de navegador?
En nuestras pruebas, Claude Fable 5.2 costó una media de $2.63 por tarea en las 23 tareas web que superaron ambos modelos, y $3.13 por intento exitoso al contar los 28 intentos. Fable 5.1 costó $3.28 por tarea y $4.85 por intento exitoso. La recopilación de datos en varios sitios fue el tipo de trabajo más caro: $4.65 por tarea para Fable 5.2.
¿En qué destaca Claude Fable 5.2 en la automatización del navegador?
Claude Fable 5.2 superó todos los intentos de automatización de aplicaciones web, búsqueda y comparación e investigación en nuestras pruebas, y 9 de 10 intentos de recopilación de datos en varios sitios. Fable 5.1 superó 8 de 10 intentos en varios sitios y 7 de 8 de búsqueda y comparación. Los dos éxitos adicionales de Fable 5.2 se dieron en esos dos tipos de trabajo.
¿En qué sigue Claude Fable 5.1 a la altura de Fable 5.2?
Claude Fable 5.1 igualó a Fable 5.2 en flujos de aplicaciones web e investigación exploratoria. Ambos modelos superaron los 4 intentos de automatización de aplicaciones web y los 3 de investigación y síntesis. En investigación, Fable 5.1 costó $1.87 por tarea frente a $2.02, mientras que en los flujos de aplicaciones web Fable 5.2 fue más barato: $1.44 frente a $1.84.
¿Se detiene Claude Fable 5.2 antes de terminar tareas de navegador de varios pasos?
No en nuestras pruebas: todos los intentos de Claude Fable 5.2 terminaron con una respuesta final y ninguno agotó el presupuesto de 100 pasos. Sus tres fallos fueron respuestas finales que no acertaron todos los valores requeridos.
¿Puede Claude Fable 5.2 ejecutar tareas de navegador sin supervisión?
Claude Fable 5.2 terminó la mayoría de las tareas por su cuenta y superó 25 de 28 intentos, pero cada uno de sus tres fallos también terminó con una respuesta final que contenía errores. En dos ocasiones tomó valores de una fuente incorrecta, como una versión de seguridad posterior u otro comunicado de prensa regional. Para los datos sobre versiones o precios, comprueba de qué página salió cada valor.
¿Cómo puede Claude Fable 5.2 usar un navegador?
Claude Fable 5.2 puede controlar un navegador mediante un entorno de agente y una herramienta de navegador. En nuestras pruebas se ejecutó en Claude Code y controló ego(lite) mediante ego-browser, escribiendo scripts breves de JavaScript que ego-browser ejecutó para controlar las páginas. Con esa configuración superó 25 de 28 intentos en tareas web.
Cómo realizamos las pruebas
Comparamos Claude Fable 5.2 (claude-fable-5-2) y Claude Fable 5.1 (claude-fable-5-1), ambos con el esfuerzo de razonamiento en high, en el mismo entorno de agente: Claude Code con las herramientas Bash, Read, Write, Edit y Skill. Ambos controlaron ego(lite) mediante ego-browser, que entrega la página al modelo como una instantánea de accesibilidad, texto de la página o captura de pantalla, según lo que pida su script. Ejecutamos las pruebas el 12 de noviembre de 2026 en Linux.
Las 28 tareas abarcan cinco tipos de trabajo. La automatización de aplicaciones web consiste en flujos dentro de aplicaciones empresariales de prueba, como conciliar facturas con pagos. La búsqueda y comparación abarca de uno a tres sitios, como comprobar la compatibilidad del navegador en MDN y Can I use. La recopilación de datos en varios sitios recoge los mismos campos de entre 8 y 12 sitios oficiales, como las decisiones de tasas de 12 bancos centrales. Las tareas de investigación y síntesis son exploratorias, como rastrear una tabla de Wikipedia hasta sus fuentes. La verificación de redes sociales relaciona publicaciones de X con páginas oficiales. Cada tarea pertenece a un solo tipo.
Cada modelo ejecutó cada tarea una vez; una ejecución de una tarea es un intento. Un intento tiene éxito cuando su respuesta final acierta todos los valores requeridos. Cada intento tenía un máximo de 100 pasos y 60 minutos. Un paso es un turno del modelo, una llamada a una herramienta es una llamada que el modelo hace a una herramienta y un comando de navegador es un script entregado a ego-browser. El tiempo es el tiempo real transcurrido por intento, incluida la espera de la API del modelo. El coste se expresa en dólares estadounidenses y se calcula a partir del uso de tokens de cada intento a los precios de lista de Anthropic, aplicando a las lecturas y escrituras de caché sus respectivas tarifas. El tiempo y el coste por tarea superada se comparan en las 23 tareas que superaron ambos modelos. El coste por intento exitoso divide el coste total de todos los intentos entre el número de intentos exitosos.
Resultados completos
Cada celda muestra si el único intento del modelo tuvo éxito, cuánto tiempo tardó en segundos, incluida la espera de la API del modelo, y cuánto costó en dólares estadounidenses. Las medias del resto del artículo usan costes sin redondear.
| Tarea | Tipo de trabajo | Claude Fable 5.2 | Claude Fable 5.1 |
|---|---|---|---|
| Reservar vuelos, asientos y hotel según una política de viajes en una aplicación de reservas | Automatización de aplicaciones web | Éxito · 220.0 s · $1.66 | Éxito · 208.2 s · $2.19 |
| Ajustar los monitores de servicio a una norma escrita en una aplicación de monitorización | Automatización de aplicaciones web | Éxito · 140.7 s · $1.02 | Éxito · 158.2 s · $1.60 |
| Crear pedidos de compra a partir del nivel de existencias en una aplicación de inventario | Automatización de aplicaciones web | Éxito · 163.0 s · $1.06 | Éxito · 128.2 s · $1.29 |
| Conciliar las facturas de febrero con los pagos y abrir disputas en una aplicación financiera | Automatización de aplicaciones web | Éxito · 316.3 s · $2.02 | Éxito · 308.8 s · $2.28 |
| Comprobar los capítulos de una videoclase con su código de GitHub y su artículo de arXiv | Búsqueda y comparación | Éxito · 136.3 s · $1.14 | Éxito · 221.8 s · $1.57 |
| Calcular cifras de inflación a partir de FRED y confirmarlas en BLS | Búsqueda y comparación | Éxito · 122.7 s · $1.03 | Éxito · 93.3 s · $1.11 |
| Contrastar la compatibilidad de seis funciones web en los navegadores con MDN y Can I use | Búsqueda y comparación | Éxito · 179.2 s · $1.14 | Éxito · 239.1 s · $2.13 |
| Buscar las tarifas sin escalas más baratas para tres ciudades en un sitio de búsqueda de vuelos | Búsqueda y comparación | Éxito · 683.0 s · $2.24 | Fallo · 768.3 s · $4.41 |
| Relacionar ensayos de fase 3 de ClinicalTrials.gov con sus fichas de DailyMed | Búsqueda y comparación | Éxito · 178.6 s · $1.52 | Éxito · 267.6 s · $2.24 |
| Consultar los precios y comparar tres configuraciones de portátiles en la tienda estadounidense de un fabricante | Búsqueda y comparación | Éxito · 378.2 s · $2.46 | Éxito · 392.0 s · $3.17 |
| Conciliar la taquilla de seis películas entre una base de datos de taquilla y Wikipedia | Búsqueda y comparación | Éxito · 102.2 s · $1.09 | Éxito · 87.6 s · $1.12 |
| Examinar cuatro empresas británicas en Companies House | Búsqueda y comparación | Éxito · 101.2 s · $1.09 | Éxito · 185.4 s · $1.52 |
| Crear una matriz de cumplimiento a partir de 9 centros de confianza SaaS | Recopilación de datos en varios sitios | Éxito · 1110.0 s · $6.16 | Éxito · 737.9 s · $5.56 |
| Recopilar cinco especificaciones de 8 cámaras de los sitios de sus fabricantes | Recopilación de datos en varios sitios | Éxito · 482.4 s · $3.49 | Éxito · 480.9 s · $4.35 |
| Recopilar cinco especificaciones de 9 teléfonos de gama alta de los sitios de sus fabricantes para el Reino Unido | Recopilación de datos en varios sitios | Éxito · 992.6 s · $6.04 | Fallo · 467.5 s · $3.13 |
| Recopilar detalles de las ponencias inaugurales de 9 conferencias para desarrolladores | Recopilación de datos en varios sitios | Éxito · 920.8 s · $4.85 | Éxito · 1168.4 s · $8.85 |
| Recopilar cifras de autonomía y carga de 9 SUV eléctricos de los sitios de sus fabricantes para Estados Unidos | Recopilación de datos en varios sitios | Éxito · 1120.9 s · $6.91 | Éxito · 1261.0 s · $6.91 |
| Recopilar especificaciones y licencias de 9 modelos de pesos abiertos de Hugging Face y las páginas de sus proveedores | Recopilación de datos en varios sitios | Éxito · 758.7 s · $5.24 | Éxito · 1059.6 s · $6.26 |
| Recopilar los salarios mínimos legales de 9 autoridades laborales | Recopilación de datos en varios sitios | Éxito · 567.0 s · $4.25 | Éxito · 640.1 s · $5.32 |
| Recopilar la primera decisión de tasas de 2026 de 12 sitios de bancos centrales | Recopilación de datos en varios sitios | Éxito · 525.9 s · $3.51 | Éxito · 435.1 s · $4.52 |
| Comparar los planes gratuitos de 9 plataformas sin servidor | Recopilación de datos en varios sitios | Éxito · 501.1 s · $2.77 | Éxito · 665.2 s · $4.40 |
| Comparar la ficha de un mismo álbum en 9 servicios de música | Recopilación de datos en varios sitios | Fallo · 408.6 s · $1.98 | Fallo · 292.4 s · $2.22 |
| Contar los modelos que superan los umbrales de cómputo de la UE en una base de datos pública de modelos | Investigación y síntesis | Éxito · 195.2 s · $1.64 | Éxito · 80.4 s · $1.08 |
| Leer los puntos de coste y puntuación de un gráfico de clasificación interactivo | Investigación y síntesis | Éxito · 317.1 s · $2.39 | Éxito · 327.3 s · $2.41 |
| Rastrear 10 celdas de una tabla de Wikipedia hasta sus fuentes | Investigación y síntesis | Éxito · 382.2 s · $2.03 | Éxito · 342.7 s · $2.12 |
| Relacionar las publicaciones sobre productos de 8 marcas en X con sus comunicados de prensa | Verificación de redes sociales | Fallo · 1132.7 s · $3.79 | Fallo · 2200.8 s · $14.22 |
| Relacionar las publicaciones de seguridad en X de 8 proyectos de código abierto con sus propios anuncios | Verificación de redes sociales | Fallo · 750.8 s · $3.75 | Fallo · 3302.8 s · $12.30 |
| Relacionar una semana de publicaciones de SpaceX sobre lanzamientos en X con las listas de lanzamientos de Wikipedia | Verificación de redes sociales | Éxito · 706.2 s · $1.96 | Éxito · 875.8 s · $3.32 |