Evaluamos el uso del navegador de DeepSeek V4.1 Flash frente a GPT-6.1 Sol en 72 tareas web

Elegiríamos GPT-6.1 Sol para un agente que trabaje en muchos sitios y DeepSeek V4.1 Flash para flujos dentro de una sola aplicación web. Cada modelo ejecutó dos veces cada una de nuestras 72 tareas en ego-browser, de modo que cada modelo realizó 144 intentos. GPT-6.1 Sol superó 121 de sus 144 intentos (84.0%) y DeepSeek V4.1 Flash superó 82 (56.9%). En las 29 tareas que ambos modelos superaron en todos los intentos, GPT-6.1 Sol tardó 219.7 segundos por tarea, con un coste de $0.310, y DeepSeek V4.1 Flash tardó 321.7 segundos, con un coste de $0.047.
Al leer los registros, vimos que los dos modelos trabajan de forma distinta. GPT-6.1 Sol suele manejar varios sitios en un comando, mientras que DeepSeek V4.1 Flash trabaja en una página cada vez y sigue buscando. En las tareas que recopilan los mismos campos en 8 sitios o más, DeepSeek V4.1 Flash agotó sus 100 pasos en 23 intentos. En nuestras aplicaciones de prueba, donde el trabajo se desarrolla dentro de una sola aplicación web, casi igualó la tasa de éxito y la velocidad de GPT-6.1 Sol por aproximadamente una sexta parte del coste.
Cada modelo también tiene una debilidad para la que conviene prepararse. GPT-6.1 Sol a veces deja de buscar demasiado pronto: falló en ambos intentos de 3 tareas, mientras que DeepSeek V4.1 Flash siguió buscando y superó los dos. DeepSeek V4.1 Flash dio más respuestas incorrectas pese a responder menos veces: 34 de sus 144 intentos terminaron con una respuesta incorrecta, frente a 23 de GPT-6.1 Sol.
Tasa de éxito, velocidad y coste
GPT-6.1 Sol lidera la tasa de éxito y la velocidad, mientras que el coste de DeepSeek V4.1 Flash equivale aproximadamente al 15% del de su rival. Comparamos tiempo y coste en las 29 tareas que ambos modelos superaron en todos los intentos, por lo que las cifras de ninguno incluyen trabajo fallido. Las filas correspondientes a las 72 tareas sí incluyen intentos fallidos.
| Métrica | GPT-6.1 Sol | DeepSeek V4.1 Flash |
|---|---|---|
| Tasa de éxito, las 72 tareas | 84.0% (121 de 144 intentos) | 56.9% (82 de 144 intentos) |
| Tiempo por tarea, 29 tareas que ambos superaron siempre | 219.7 s | 321.7 s |
| Tiempo por tarea, las 72 tareas | 321.6 s | 511.4 s |
| Coste por tarea, 29 tareas que ambos superaron siempre | $0.310 | $0.047 |
| Coste por tarea, las 72 tareas | $0.483 | $0.071 |
| Coste por intento superado, las 72 tareas | $0.575 | $0.124 |
| Llamadas a herramientas por tarea, las 72 tareas | 34.6 | 61.6 |
Ejecuciones del 7 de noviembre de 2026, con ambos modelos en ego-browser. Cada modelo ejecutó cada tarea dos veces. El tiempo incluye la espera de las respuestas de la API de cada modelo.
DeepSeek V4.1 Flash cuesta menos porque sus precios son más bajos, no porque haga menos trabajo. Realizó 61.6 llamadas a herramientas por tarea, frente a las 34.6 de GPT-6.1 Sol. Incluso por intento superado, DeepSeek V4.1 Flash costó $0.124 y GPT-6.1 Sol, $0.575.
La mayor parte de la diferencia en tasa de éxito procede de un tipo de trabajo. En las tareas que recopilan los mismos campos en 8 sitios o más, GPT-6.1 Sol superó 51 de 64 intentos y DeepSeek V4.1 Flash superó 21. En los flujos de aplicaciones web, los dos modelos superaron 29 y 28 de 30 intentos, respectivamente.
| Tipo de trabajo | Tareas | GPT-6.1 Sol | DeepSeek V4.1 Flash |
|---|---|---|---|
| Flujos de aplicaciones web | 15 | 96.7% (29/30) | 93.3% (28/30) |
| Búsqueda y comparación en pocos sitios | 8 | 93.8% (15/16) | 81.3% (13/16) |
| Investigación y síntesis | 12 | 66.7% (16/24) | 62.5% (15/24) |
| Contrastar publicaciones de X con otras fuentes | 5 | 100% (10/10) | 50.0% (5/10) |
| Recopilar los mismos campos en 8 sitios o más | 32 | 79.7% (51/64) | 32.8% (21/64) |
| Todas las tareas | 72 | 84.0% (121/144) | 56.9% (82/144) |
La tasa de éxito es la proporción de intentos superados, con dos intentos por tarea.
En los flujos de aplicaciones web, la tasa de éxito apenas separó a los dos modelos, de modo que el coste marca la diferencia. En las tareas que abarcan muchos sitios, GPT-6.1 Sol tuvo éxito con mucha más frecuencia.
Cómo trabaja GPT-6.1 Sol
GPT-6.1 Sol suele manejar varios sitios en un comando. Cuando una tarea abarca muchos sitios, los mantiene abiertos en pestañas separadas y hace avanzar varias en cada comando de ego-browser. Ambos modelos recibieron el mismo archivo de skill de ego-browser, que explica cómo mantener abiertas varias pestañas cuando una tarea lo necesita. En las tareas que recopilan los mismos campos en 8 sitios o más, el 56% de los comandos de navegador de GPT-6.1 Sol trabajaron en dos pestañas o más. DeepSeek V4.1 Flash hizo esto en menos del 1% de sus comandos de navegador.
La tarea del terremoto muestra cómo funciona. Pide la hora, la magnitud y la profundidad de un terremoto de 2025 según los informes de 9 agencias. En un comando, GPT-6.1 Sol leyó la página del evento del USGS, abrió los datos científicos en la página del evento de EMSC, abrió la página del evento de GFZ y dirigió una cuarta pestaña a INGV. Superó ambos intentos, con 40 llamadas a herramientas en uno y 32 en el otro. DeepSeek V4.1 Flash recorrió las 9 agencias una tras otra en una sola pestaña, rellenando sus formularios de búsqueda por turnos, y agotó los 100 pasos en ambos intentos.
En nuestras ejecuciones, GPT-6.1 Sol necesitó menos llamadas a herramientas y terminó antes. En las 29 tareas que ambos modelos superaron en todos los intentos, realizó 28.6 llamadas por tarea, frente a las 43.0 de DeepSeek V4.1 Flash. En las 16 tareas de ese grupo ajenas a aplicaciones web, GPT-6.1 Sol fue más rápido en 14. En los flujos de aplicaciones web, solo trabajó en dos pestañas o más en el 3% de sus comandos de navegador y los dos modelos tardaron prácticamente lo mismo.
La debilidad de GPT-6.1 Sol es que a veces deja de buscar demasiado pronto. Falló en ambos intentos de 3 tareas y DeepSeek V4.1 Flash superó los dos. En la tarea LiveBench, ambos modelos buscaron GPT-5.4 con nivel de razonamiento High en la clasificación y solo encontraron su fila xHigh. Después de 12 llamadas a herramientas, GPT-6.1 Sol informó de que la página no mostraba esa puntuación. DeepSeek V4.1 Flash siguió buscando y encontró el valor, 75.1, en un selector de modelos situado más abajo en la misma página, en la sección Insights.
La tarea de los frameworks de frontend siguió el mismo patrón. En un intento, GPT-6.1 Sol buscó “16.3.” en la lista de versiones de Next.js e informó del primer resultado: 16.3.2, del 21 de agosto. DeepSeek V4.1 Flash recorrió las páginas de la lista de versiones, formada en su mayoría por compilaciones canary, y encontró 16.3.8, publicada el 30 de septiembre. Cuando GPT-6.1 Sol indique que un valor no está en un sitio, u opte por el primer resultado de una búsqueda, comprobaríamos ese valor por nuestra cuenta antes de utilizar la respuesta.
Cómo trabaja DeepSeek V4.1 Flash
DeepSeek V4.1 Flash trabaja en una página cada vez y sigue hasta encontrar lo que busca. Realizó 61.6 llamadas a herramientas por tarea, frente a las 34.6 de GPT-6.1 Sol. Esa persistencia le permitió superar las tareas LiveBench y de frameworks de frontend en las que GPT-6.1 Sol falló.
Dentro de una sola aplicación web, trabajar en una página cada vez apenas marcó diferencias. Nuestros 15 flujos de aplicaciones web se ejecutan en aplicaciones de prueba que llenamos con datos nuevos, como una aplicación de reservas de viajes y otra de gastos. DeepSeek V4.1 Flash superó 28 de sus 30 intentos allí y GPT-6.1 Sol superó 29. En los 13 flujos que ambos modelos superaron en todos los intentos, DeepSeek V4.1 Flash tardó 173.0 segundos por tarea, con un coste de $0.028, y GPT-6.1 Sol tardó 169.3 segundos, con un coste de $0.170.
Reservar un viaje conforme a la política es un ejemplo típico. La tarea pide al agente reservar vuelos de ida y vuelta dentro de la política de viajes, elegir asientos de pasillo y reservar un hotel a una milla como máximo del lugar del evento. Ambos modelos superaron los dos intentos. DeepSeek V4.1 Flash tardó 189.2 segundos por tarea, con un coste de $0.033, y GPT-6.1 Sol tardó 199.4 segundos, con un coste de $0.253.
Al abarcar 8 sitios o más, esa misma forma de trabajar agota los pasos. En esas 32 tareas, DeepSeek V4.1 Flash superó 21 de 64 intentos y GPT-6.1 Sol superó 51. El primero realizó allí 82.2 llamadas a herramientas por tarea, el doble de las 41.1 de GPT-6.1 Sol. De los 26 intentos en los que agotó los 100 pasos, 23 correspondían a estas tareas.
Cuando DeepSeek V4.1 Flash sí da una respuesta, comprobaríamos sus conclusiones con sus propios datos y las páginas que leyó. Falló en 62 intentos: 34 terminaron con una respuesta incorrecta y 28 sin respuesta. De esos 28, 26 agotaron los 100 pasos y 1 terminó cuando la API de DeepSeek devolvió errores del servidor. Los 23 intentos fallidos de GPT-6.1 Sol acabaron con una respuesta incorrecta. En un intento de la tarea de teléfonos de gama alta, la propia tabla de DeepSeek V4.1 Flash indicaba que el Galaxy S26 pesaba 167 g. Sin embargo, la línea bajo la tabla nombraba al motorola signature, de 186 g, como el teléfono más ligero.
Qué modelo elegir
En ego-browser, usa GPT-6.1 Sol para un agente que trabaje en muchos sitios. Superó el 84.0% de sus intentos y nunca agotó los pasos. En las tareas que recopilan los mismos campos en 8 sitios o más superó 51 de 64 intentos y terminó antes el trabajo que abarcaba varios sitios.
Usa DeepSeek V4.1 Flash para flujos dentro de una sola aplicación web. En nuestras aplicaciones de prueba superó 28 de 30 intentos, tardó prácticamente lo mismo que GPT-6.1 Sol y costó aproximadamente una sexta parte. No contaríamos con él para trabajos de 8 sitios o más, donde superó 21 de 64 intentos.
Para consultas en pocos sitios y tareas de investigación, eliges entre tiempo y dinero. DeepSeek V4.1 Flash superó 13 de 16 intentos en consultas y 15 de 24 en investigación; GPT-6.1 Sol superó 15 de 16 y 16 de 24. DeepSeek V4.1 Flash costó menos y tardó más en ambos tipos de trabajo.
Elijas el modelo que elijas, comprueba los valores clave de su respuesta. Ambos dieron en ocasiones respuestas que parecían completas, pero contenían un valor incorrecto. Ejecutamos ambos modelos con un esfuerzo de razonamiento high en ego-browser, que se proporciona junto con ego(lite) y lo controla como navegador del agente.
Preguntas frecuentes
¿Es DeepSeek V4.1 Flash tan bueno como GPT-6.1 Sol para usar el navegador?
Dentro de una sola aplicación web, casi; al abarcar muchos sitios, no. En los flujos de aplicaciones web, DeepSeek V4.1 Flash superó 28 de 30 intentos y GPT-6.1 Sol superó 29. En las tareas que recopilan los mismos campos en 8 sitios o más, DeepSeek V4.1 Flash superó 21 de 64 intentos y GPT-6.1 Sol superó 51. En las 72 tareas, superaron el 56.9% y el 84.0% de sus intentos, respectivamente.
¿Por qué GPT-6.1 Sol es más rápido que DeepSeek V4.1 Flash en un navegador?
En nuestras ejecuciones, GPT-6.1 Sol necesitó menos llamadas a herramientas, en parte porque suele manejar varios sitios en un comando. En las tareas que recopilan los mismos campos en 8 sitios o más, el 56% de sus comandos de navegador trabajaron en dos pestañas o más, frente a menos del 1% de los de DeepSeek V4.1 Flash. En las 29 tareas que ambos modelos superaron en todos los intentos, GPT-6.1 Sol realizó 28.6 llamadas y empleó 219.7 segundos por tarea; DeepSeek V4.1 Flash realizó 43.0 y empleó 321.7. En los flujos de aplicaciones web tardaron prácticamente lo mismo.
¿Cuánto más barato es DeepSeek V4.1 Flash que GPT-6.1 Sol para tareas de navegación?
DeepSeek V4.1 Flash cuesta aproximadamente un 15% de lo que cuesta GPT-6.1 Sol. En las 29 tareas que ambos modelos superaron en todos los intentos, DeepSeek V4.1 Flash costó $0.047 por tarea y GPT-6.1 Sol, $0.310. En las 72 tareas, DeepSeek V4.1 Flash costó $0.071 por tarea y GPT-6.1 Sol, $0.483. Por intento superado, DeepSeek V4.1 Flash costó $0.124 y GPT-6.1 Sol, $0.575.
¿Por qué DeepSeek V4.1 Flash falla en tareas que abarcan muchos sitios?
Aproximadamente la mitad de sus fallos en ese grupo se deben a agotar los pasos. En las tareas que recopilan los mismos campos en 8 sitios o más, trabaja en una página cada vez y realizó 82.2 llamadas a herramientas por tarea, frente a las 41.1 de GPT-6.1 Sol. De sus 43 intentos fallidos en estas tareas, 23 terminaron sin respuesta tras agotar los 100 pasos.
¿Por qué GPT-6.1 Sol comete errores en algunas tareas de navegación?
En LiveBench y en la tarea de frameworks de frontend, dejó de buscar demasiado pronto. En LiveBench, después de 12 llamadas a herramientas, GPT-6.1 Sol informó de que la página no mostraba una puntuación; DeepSeek V4.1 Flash la encontró más abajo en la misma página, en la sección Insights. DeepSeek V4.1 Flash superó ambos intentos de 3 tareas en las que GPT-6.1 Sol falló dos veces.
¿Comete DeepSeek V4.1 Flash más errores que GPT-6.1 Sol?
Sí. De los 144 intentos de DeepSeek V4.1 Flash, 34 terminaron con una respuesta incorrecta, frente a 23 de GPT-6.1 Sol. DeepSeek V4.1 Flash también respondió menos veces, porque 28 de sus intentos acabaron sin respuesta. En un intento de la tarea de teléfonos de gama alta, su propia tabla indicaba que el Galaxy S26 pesaba 167 g, pero el resumen nombraba a un teléfono de 186 g como el más ligero.
¿Puede DeepSeek V4.1 Flash rellenar formularios y ejecutar flujos en una aplicación web?
Sí. DeepSeek V4.1 Flash superó 28 de 30 intentos en 15 flujos de aplicaciones web de nuestras aplicaciones de prueba y GPT-6.1 Sol superó 29 de 30. Las tareas incluían reservar un viaje, aplicar pagos de lockbox y aprobar informes de gastos. En las 13 tareas que ambos modelos superaron en todos los intentos, DeepSeek V4.1 Flash costó $0.028 por tarea y GPT-6.1 Sol, $0.170.
¿Qué tareas de navegación puede hacer DeepSeek V4.1 Flash por menos que GPT-6.1 Sol?
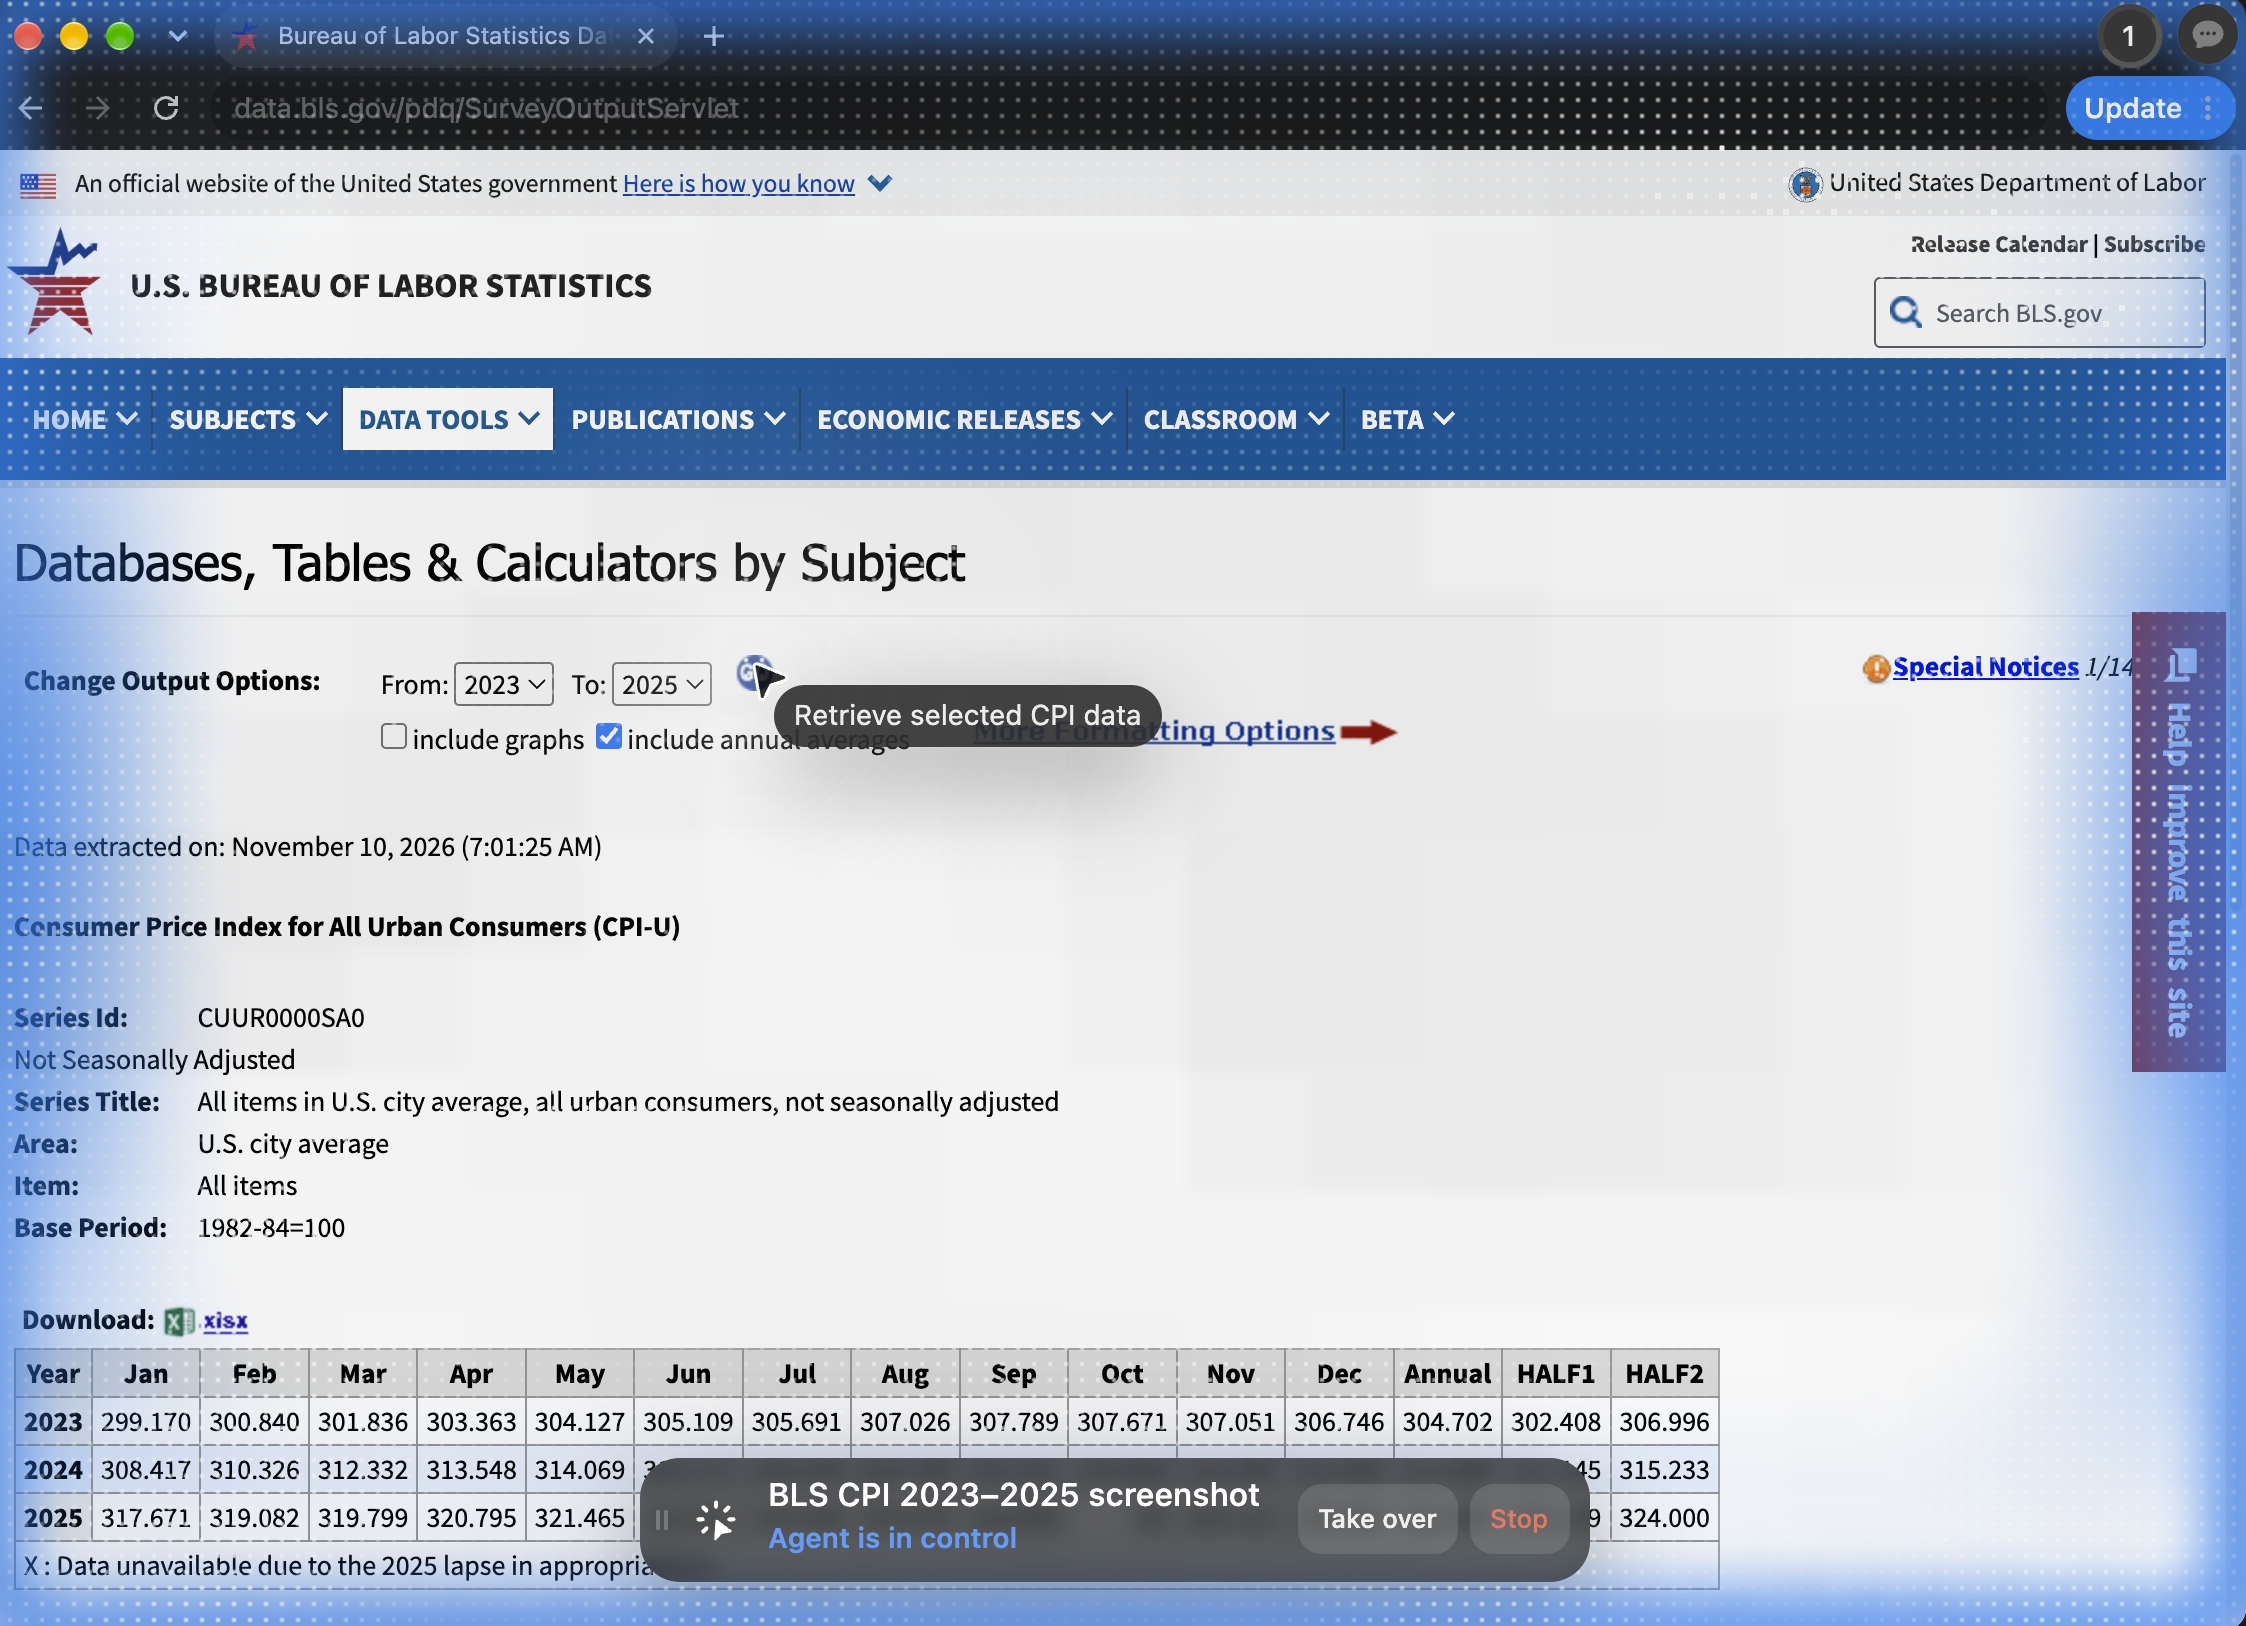
Principalmente flujos dentro de una sola aplicación web, donde 11 de los 15 flujos cumplieron tres condiciones. En esas 11 tareas, DeepSeek V4.1 Flash tuvo éxito con la misma frecuencia que GPT-6.1 Sol, tardó como máximo un 10% más y costó menos de una tercera parte. Otras tres tareas cumplieron las mismas condiciones: un informe de inflación con datos de FRED y BLS, apuntes de estudio a partir de una clase, código y un artículo científico, y la verificación de un CVE de sudo en nueve avisos de distribuciones de Linux.
¿Cuántas llamadas a herramientas hace DeepSeek V4.1 Flash en comparación con GPT-6.1 Sol?
En las 72 tareas, DeepSeek V4.1 Flash realizó 61.6 llamadas a herramientas por tarea, aproximadamente un 78% más que las 34.6 de GPT-6.1 Sol. En las tareas que recopilan los mismos campos en 8 sitios o más, DeepSeek V4.1 Flash realizó 82.2 por tarea, el doble de las 41.1 de GPT-6.1 Sol. En los flujos de aplicaciones web, DeepSeek V4.1 Flash realizó 33.3 por tarea y GPT-6.1 Sol, 26.0.
¿Merece la pena usar DeepSeek V4.1 Flash para agentes de navegación?
Sí, para flujos dentro de una sola aplicación web: DeepSeek V4.1 Flash superó allí 28 de 30 intentos por aproximadamente una sexta parte del coste de GPT-6.1 Sol. Para un agente que trabaje en muchos sitios, GPT-6.1 Sol es la mejor opción, porque superó el 84.0% de sus intentos y DeepSeek V4.1 Flash superó el 56.9%.
Cómo realizamos las pruebas
Ejecutamos ambos modelos el 7 de noviembre de 2026 en macOS, en ego-browser con ego(lite) 0.6.3.2. Los dos se ejecutaron en el entorno de agentes pi con el archivo de skill de ego-browser. Los llamamos mediante los identificadores deepseek-flash y gpt-6.1-sol, con esfuerzo de razonamiento high. Ambos tenían el mismo límite de 100 pasos por intento. Un paso es un turno del modelo y, en casi todos los pasos, el modelo hizo una llamada a una herramienta. Cada modelo ejecutó dos veces cada una de las 72 tareas, por lo que cada modelo realizó 144 intentos.
Las tareas son 72 trabajos complejos de automatización web. Algunos se ejecutan en sitios reales y otros en aplicaciones de prueba que llenamos con datos nuevos. Los agrupamos según el tipo de trabajo que pide cada tarea:
| Tipo de trabajo | Tareas | Ejemplo de tarea |
|---|---|---|
| Flujos de aplicaciones web | 15 | Reservar un viaje que cumpla la política |
| Búsqueda y comparación en pocos sitios | 8 | Informe de inflación con datos de FRED, contrastado con el BLS |
| Investigación y síntesis | 12 | Rastrear una tabla de Wikipedia hasta sus fuentes |
| Contrastar publicaciones de X con otras fuentes | 5 | Contrastar publicaciones de lanzamientos de SpaceX en X con Wikipedia |
| Recopilar los mismos campos en 8 sitios o más | 32 | Decisiones sobre tipos de interés de 12 bancos centrales |
Cada tarea pertenece a un solo grupo. Las 5 tareas que verifican publicaciones en X forman un grupo propio, incluso cuando abarcan 8 cuentas.
Cada tarea se evalúa con entre 3 y 10 comprobaciones. Un intento solo se considera superado si las supera todas.
Para ver cómo trabaja cada modelo, leímos los registros de sesión de los intentos de ambos. Consideramos que un comando del navegador trabaja en dos o más pestañas cuando el script que el modelo envía a ego-browser en ese comando lee información o realiza acciones en dos o más pestañas.
La tasa de éxito es la proporción de intentos superados. Todas las cifras por tarea de este artículo, incluidas las de tiempo, coste y llamadas a herramientas, son la media de los dos intentos de esa tarea. El tiempo va desde el inicio de un intento hasta su respuesta final o, si no respondió, hasta su último paso, e incluye la espera de las respuestas de la API de cada modelo. El coste se calcula aplicando los precios del proveedor a los tokens de cada intento. El coste por intento superado es el coste de los 144 intentos dividido por el número de intentos superados. Al comparar tiempo y coste, utilizamos las 29 tareas que ambos modelos superaron en todos los intentos, salvo que el texto indique lo contrario.
En la columna Resultado de abajo, «Igualó por menos» significa que DeepSeek V4.1 Flash tuvo éxito con la misma frecuencia que GPT-6.1 Sol, tardó como máximo un 10% más y costó menos de una tercera parte. «Igualó, más lento» significa que ambos modelos tuvieron éxito con la misma frecuencia, pero la tarea no cumplió esas condiciones de tiempo y coste.
Resultados completos
Cada celda muestra el número de intentos superados de un total de 2, seguido del tiempo por tarea y el coste por tarea. El tiempo y el coste son las medias de los dos intentos de la tarea, y el tiempo incluye la espera de las respuestas de la API de cada modelo.
| Tarea | Tipo de trabajo | Resultado | GPT-6.1 Sol | DeepSeek V4.1 Flash |
|---|---|---|---|---|
| Añadir cargos de tarjeta sin conciliar a un informe de gastos | Flujos de aplicaciones web | Igualó por menos | 2/2, 169.6 s, $0.193 | 2/2, 157.1 s, $0.026 |
| Aplicar pagos de lockbox | Flujos de aplicaciones web | Igualó por menos | 2/2, 185.2 s, $0.141 | 2/2, 184.3 s, $0.025 |
| Aprobar un informe de gastos de viaje | Flujos de aplicaciones web | Igualó por menos | 2/2, 156.3 s, $0.120 | 2/2, 144.6 s, $0.020 |
| Reservar un viaje que cumpla la política | Flujos de aplicaciones web | Igualó por menos | 2/2, 199.4 s, $0.253 | 2/2, 189.2 s, $0.033 |
| Ajustar los monitores de servicios a un estándar | Flujos de aplicaciones web | Igualó por menos | 2/2, 133.9 s, $0.131 | 2/2, 119.3 s, $0.024 |
| Revisión de la puntualidad de los transportistas y reglas de alerta | Flujos de aplicaciones web | Igualó por menos | 2/2, 198.1 s, $0.140 | 2/2, 213.7 s, $0.042 |
| Solicitar dietas diarias de manutención | Flujos de aplicaciones web | Igualó por menos | 2/2, 123.4 s, $0.109 | 2/2, 93.2 s, $0.018 |
| Solicitar el reembolso diario por kilometraje | Flujos de aplicaciones web | Igualó, más lento | 2/2, 246.6 s, $0.228 | 2/2, 282.4 s, $0.036 |
| Cubrir turnos de guardia teniendo en cuenta las ausencias | Flujos de aplicaciones web | Igualó por menos | 2/2, 85.6 s, $0.108 | 2/2, 69.0 s, $0.013 |
| Crear pedidos de compra a partir de los puntos de reposición | Flujos de aplicaciones web | Igualó, más lento | 2/2, 116.7 s, $0.123 | 2/2, 146.9 s, $0.019 |
| Tramitar devoluciones de pedidos dañados | Flujos de aplicaciones web | Igualó, más lento | 2/2, 238.5 s, $0.293 | 2/2, 297.5 s, $0.045 |
| Bloquear o desbloquear despliegues según los presupuestos de error | Flujos de aplicaciones web | Igualó por menos | 1/2, 90.1 s, $0.086 | 1/2, 74.1 s, $0.013 |
| Conciliar facturas con pagos y abrir disputas | Flujos de aplicaciones web | Igualó por menos | 2/2, 212.0 s, $0.214 | 2/2, 224.6 s, $0.042 |
| Revertir versiones publicadas durante un bloqueo de despliegues | Flujos de aplicaciones web | GPT-6.1 Sol superó más intentos | 2/2, 115.4 s, $0.111 | 1/2, 241.3 s, $0.040 |
| Redactar y presentar un análisis posterior a un incidente | Flujos de aplicaciones web | Igualó por menos | 2/2, 135.5 s, $0.158 | 2/2, 126.7 s, $0.026 |
| Las tarifas más baratas de vuelos sin escalas en un buscador de vuelos | Búsqueda y comparación en pocos sitios | Igualó, más lento | 1/2, 380.6 s, $0.492 | 1/2, 1058.9 s, $0.096 |
| Comparar tres portátiles Mac | Búsqueda y comparación en pocos sitios | Igualó, más lento | 2/2, 278.5 s, $0.529 | 2/2, 320.4 s, $0.065 |
| Informe de inflación con datos de FRED, contrastado con el BLS | Búsqueda y comparación en pocos sitios | Igualó por menos | 2/2, 117.8 s, $0.158 | 2/2, 93.6 s, $0.019 |
| Instantánea KYC de cuatro empresas del Reino Unido | Búsqueda y comparación en pocos sitios | GPT-6.1 Sol superó más intentos | 2/2, 181.1 s, $0.269 | 1/2, 170.1 s, $0.034 |
| Contrastar ensayos clínicos con las fichas técnicas de los medicamentos | Búsqueda y comparación en pocos sitios | GPT-6.1 Sol superó más intentos | 2/2, 338.8 s, $0.487 | 1/2, 293.6 s, $0.052 |
| Conciliar la recaudación de taquilla de seis películas | Búsqueda y comparación en pocos sitios | Igualó, más lento | 2/2, 189.2 s, $0.209 | 2/2, 210.5 s, $0.028 |
| Apuntes de estudio a partir de una clase, código y un artículo científico | Búsqueda y comparación en pocos sitios | Igualó por menos | 2/2, 215.6 s, $0.422 | 2/2, 232.5 s, $0.041 |
| Funciones web en MDN y Can I use | Búsqueda y comparación en pocos sitios | Igualó, más lento | 2/2, 161.8 s, $0.197 | 2/2, 430.5 s, $0.049 |
| Precios de API en capturas de Wayback | Investigación y síntesis | DeepSeek V4.1 Flash superó más intentos | 0/2, 410.4 s, $0.300 | 2/2, 1111.2 s, $0.065 |
| Gráfico de la clasificación de ARC Prize | Investigación y síntesis | Igualó, más lento | 2/2, 197.0 s, $0.247 | 2/2, 341.1 s, $0.081 |
| Verificar 10 afirmaciones de un resumen semanal de IA | Investigación y síntesis | GPT-6.1 Sol superó más intentos | 2/2, 184.3 s, $0.331 | 0/2, 307.3 s, $0.059 |
| Comparar cinco API de modelos chinos para calcular una factura mensual | Investigación y síntesis | Igualó, más lento | 2/2, 205.8 s, $0.344 | 2/2, 278.6 s, $0.055 |
| Auditoría de divulgación de 8 modelos de frontera según el Reglamento de IA de la UE | Investigación y síntesis | Ninguno superó la tarea | 0/2, 555.1 s, $1.007 | 0/2, 530.4 s, $0.126 |
| Enumerar lanzamientos de modelos por API de septiembre a partir de seis registros de cambios | Investigación y síntesis | GPT-6.1 Sol superó más intentos | 2/2, 148.2 s, $0.260 | 1/2, 378.5 s, $0.078 |
| Modelos que superan los umbrales de cómputo de la UE | Investigación y síntesis | GPT-6.1 Sol superó más intentos | 2/2, 94.0 s, $0.095 | 1/2, 170.2 s, $0.034 |
| Elegir endpoints de OpenRouter para GLM 5.3 | Investigación y síntesis | Igualó, más lento | 2/2, 222.2 s, $0.305 | 2/2, 363.4 s, $0.067 |
| Elegir un modelo para reclamaciones de seguros alemanas con seis requisitos | Investigación y síntesis | DeepSeek V4.1 Flash superó más intentos | 1/2, 155.3 s, $0.261 | 2/2, 285.0 s, $0.057 |
| Calcular el coste de una carga de trabajo de tickets de soporte con 6 páginas de precios | Investigación y síntesis | Igualó, más lento | 1/2, 334.8 s, $0.559 | 1/2, 399.2 s, $0.101 |
| Examinar una actualización de LiveBench | Investigación y síntesis | DeepSeek V4.1 Flash superó más intentos | 0/2, 67.8 s, $0.129 | 2/2, 215.3 s, $0.050 |
| Rastrear una tabla de Wikipedia hasta sus fuentes | Investigación y síntesis | GPT-6.1 Sol superó más intentos | 2/2, 286.6 s, $0.222 | 0/2, 514.5 s, $0.060 |
| 8 fichajes de clubes: X frente a los sitios de los clubes | Contrastar publicaciones de X con otras fuentes | GPT-6.1 Sol superó más intentos | 2/2, 1099.5 s, $1.485 | 0/2, 2198.8 s, $0.080 |
| 8 lanzamientos de productos: publicaciones en X frente a comunicados de prensa | Contrastar publicaciones de X con otras fuentes | GPT-6.1 Sol superó más intentos | 2/2, 583.1 s, $0.725 | 0/2, 1451.6 s, $0.086 |
| Publicaciones sobre el Nobel de 8 universidades en X | Contrastar publicaciones de X con otras fuentes | GPT-6.1 Sol superó más intentos | 2/2, 790.7 s, $0.835 | 1/2, 2557.1 s, $0.117 |
| Versiones de seguridad de 8 proyectos de código abierto: X frente a los avisos de seguridad | Contrastar publicaciones de X con otras fuentes | Igualó, más lento | 2/2, 426.5 s, $0.724 | 2/2, 1306.2 s, $0.117 |
| Contrastar publicaciones de lanzamientos de SpaceX en X con Wikipedia | Contrastar publicaciones de X con otras fuentes | Igualó, más lento | 2/2, 156.2 s, $0.166 | 2/2, 841.3 s, $0.044 |
| Comunicados sobre el clima de 2025 de 11 agencias meteorológicas | Recopilar los mismos campos en 8 sitios o más | GPT-6.1 Sol superó más intentos | 1/2, 616.5 s, $1.076 | 0/2, 556.2 s, $0.120 |
| Tráfico de 2025 en 8 aeropuertos | Recopilar los mismos campos en 8 sitios o más | Igualó, más lento | 1/2, 609.4 s, $1.015 | 1/2, 750.7 s, $0.127 |
| Campeones de 2025-26 de 9 ligas | Recopilar los mismos campos en 8 sitios o más | GPT-6.1 Sol superó más intentos | 2/2, 577.7 s, $1.193 | 0/2, 798.0 s, $0.110 |
| 8 cámaras en 8 sitios de marcas | Recopilar los mismos campos en 8 sitios o más | GPT-6.1 Sol superó más intentos | 2/2, 381.1 s, $0.511 | 1/2, 540.1 s, $0.083 |
| 8 encuestas a desarrolladores | Recopilar los mismos campos en 8 sitios o más | GPT-6.1 Sol superó más intentos | 2/2, 348.6 s, $0.585 | 0/2, 537.0 s, $0.122 |
| 9 SUV eléctricos | Recopilar los mismos campos en 8 sitios o más | GPT-6.1 Sol superó más intentos | 2/2, 557.3 s, $1.111 | 0/2, 620.2 s, $0.104 |
| 9 modelos de pesos abiertos | Recopilar los mismos campos en 8 sitios o más | Igualó, más lento | 1/2, 448.1 s, $0.703 | 1/2, 548.0 s, $0.110 |
| Cumplimiento normativo de 9 proveedores de SaaS | Recopilar los mismos campos en 8 sitios o más | GPT-6.1 Sol superó más intentos | 1/2, 434.7 s, $0.598 | 0/2, 452.0 s, $0.081 |
| Ediciones vigentes de 9 normas | Recopilar los mismos campos en 8 sitios o más | Igualó, más lento | 2/2, 282.9 s, $0.675 | 2/2, 386.3 s, $0.059 |
| Teléfonos de gama alta de 9 marcas | Recopilar los mismos campos en 8 sitios o más | GPT-6.1 Sol superó más intentos | 2/2, 439.4 s, $0.620 | 0/2, 509.0 s, $0.077 |
| Planes gratuitos de 9 servicios de CI | Recopilar los mismos campos en 8 sitios o más | GPT-6.1 Sol superó más intentos | 2/2, 350.6 s, $0.525 | 0/2, 617.3 s, $0.118 |
| Planes gratuitos de 9 plataformas sin servidor | Recopilar los mismos campos en 8 sitios o más | GPT-6.1 Sol superó más intentos | 2/2, 209.9 s, $0.319 | 1/2, 390.7 s, $0.077 |
| Ponencias principales de 9 conferencias de desarrolladores | Recopilar los mismos campos en 8 sitios o más | GPT-6.1 Sol superó más intentos | 2/2, 429.1 s, $0.586 | 0/2, 949.7 s, $0.114 |
| Últimas elecciones en 9 lugares | Recopilar los mismos campos en 8 sitios o más | Ninguno superó la tarea | 0/2, 582.7 s, $1.114 | 0/2, 625.3 s, $0.120 |
| Última versión de 9 entornos de ejecución de lenguajes | Recopilar los mismos campos en 8 sitios o más | GPT-6.1 Sol superó más intentos | 2/2, 326.9 s, $0.638 | 0/2, 464.1 s, $0.090 |
| Última versión estable de 9 navegadores de escritorio | Recopilar los mismos campos en 8 sitios o más | Igualó, más lento | 2/2, 263.2 s, $0.510 | 2/2, 552.6 s, $0.104 |
| Últimas versiones estables de 9 frameworks de frontend | Recopilar los mismos campos en 8 sitios o más | DeepSeek V4.1 Flash superó más intentos | 0/2, 252.0 s, $0.375 | 2/2, 425.9 s, $0.069 |
| Salario mínimo en 9 jurisdicciones | Recopilar los mismos campos en 8 sitios o más | GPT-6.1 Sol superó más intentos | 2/2, 520.4 s, $0.834 | 0/2, 630.3 s, $0.088 |
| Un álbum en 9 servicios de música | Recopilar los mismos campos en 8 sitios o más | Igualó, más lento | 2/2, 260.6 s, $0.660 | 2/2, 485.6 s, $0.055 |
| Ediciones de un libro en 10 fuentes | Recopilar los mismos campos en 8 sitios o más | DeepSeek V4.1 Flash superó más intentos | 1/2, 315.6 s, $0.477 | 2/2, 498.5 s, $0.061 |
| Un coche en 9 programas de pruebas de choque | Recopilar los mismos campos en 8 sitios o más | GPT-6.1 Sol superó más intentos | 1/2, 345.1 s, $0.524 | 0/2, 609.2 s, $0.104 |
| Un medicamento en 8 organismos reguladores | Recopilar los mismos campos en 8 sitios o más | Ninguno superó la tarea | 0/2, 52.7 s, $0.060 | 0/2, 614.5 s, $0.117 |
| Un terremoto según 9 agencias | Recopilar los mismos campos en 8 sitios o más | GPT-6.1 Sol superó más intentos | 2/2, 321.3 s, $0.750 | 0/2, 694.1 s, $0.109 |
| Un juego según 8 organismos de clasificación | Recopilar los mismos campos en 8 sitios o más | GPT-6.1 Sol superó más intentos | 2/2, 496.2 s, $0.659 | 0/2, 666.1 s, $0.092 |
| Una estampa en 10 colecciones de museos | Recopilar los mismos campos en 8 sitios o más | GPT-6.1 Sol superó más intentos | 2/2, 465.4 s, $0.777 | 0/2, 693.7 s, $0.098 |
| Un CVE de sudo en 9 avisos de distribuciones | Recopilar los mismos campos en 8 sitios o más | Igualó por menos | 2/2, 389.0 s, $0.487 | 2/2, 280.1 s, $0.045 |
| El número uno de una semana en 9 listas nacionales | Recopilar los mismos campos en 8 sitios o más | Igualó, más lento | 2/2, 530.8 s, $0.771 | 2/2, 631.1 s, $0.090 |
| Primeras estimaciones del PIB del 2.º trimestre de 9 agencias | Recopilar los mismos campos en 8 sitios o más | GPT-6.1 Sol superó más intentos | 2/2, 471.3 s, $0.927 | 1/2, 616.9 s, $0.105 |
| Decisiones sobre tipos de interés de 12 bancos centrales | Recopilar los mismos campos en 8 sitios o más | GPT-6.1 Sol superó más intentos | 2/2, 374.9 s, $0.620 | 0/2, 496.5 s, $0.109 |
| Fechas de soporte de 9 versiones de productos de proveedores | Recopilar los mismos campos en 8 sitios o más | Igualó, más lento | 2/2, 273.8 s, $0.390 | 2/2, 327.4 s, $0.065 |
| El entorno de ejecución de protobuf en 9 registros de paquetes | Recopilar los mismos campos en 8 sitios o más | GPT-6.1 Sol superó más intentos | 1/2, 415.8 s, $0.544 | 0/2, 566.7 s, $0.082 |
| El premio principal de 9 festivales de cine | Recopilar los mismos campos en 8 sitios o más | GPT-6.1 Sol superó más intentos | 2/2, 628.3 s, $0.969 | 0/2, 665.1 s, $0.093 |
Registro de actualizaciones: publicado por primera vez el 9 de noviembre de 2026 con las ejecuciones del 7 de noviembre de 2026: dos intentos por tarea para cada modelo en 72 tareas.