Vaut-il la peine de passer à Claude Fable 5.2 pour les agents de navigation ?

Si votre agent de navigation utilise actuellement 5.1, nous vous recommanderions de passer à Claude Fable 5.2. Il est plus rapide, moins cher et plus précis. Dans notre comparaison de Claude Fable 5.2 et 5.1, nous avons exécuté chaque modèle une fois sur les mêmes 28 tâches web. Fable 5.2 en a réussi 89.3% et Fable 5.1, 82.1%. Sur les tâches réussies par les deux modèles, Fable 5.2 a pris 418.5 secondes et coûté $2.63 par tâche, contre 450.6 secondes et $3.28 pour Fable 5.1.
- Pour recueillir les mêmes informations sur plusieurs sites officiels, Fable 5.2 coûtait moins cher en moyenne et avait un taux de réussite légèrement plus élevé.
- Pour les workflows dans une seule application web, chacun des deux modèles a réussi les 4 tentatives, et Fable 5.2 coûtait moins cher par tâche.
- En revanche, si votre principale activité est la recherche ouverte, Fable 5.1 coûtait légèrement moins cher tout en conservant le même taux de réussite que Fable 5.2.
| Modèle | Taux de réussite | Temps par tâche réussie | Coût par tâche réussie | Coût par tentative réussie |
|---|---|---|---|---|
| Claude Fable 5.2 | 89.3% (25/28) | 418.5 s | $2.63 | $3.13 |
| Claude Fable 5.1 | 82.1% (23/28) | 450.6 s | $3.28 | $4.85 |
Ce que Fable 5.2 termine et que son prédécesseur ne terminait pas
Les deux modèles Fable sont de bons agents de navigation ; nous les avons donc testés sur des travaux quotidiens aux exigences élevées. L’un consistait à choisir un téléphone professionnel : établir une fiche comparative pour neuf smartphones haut de gamme, avec de nombreux champs par téléphone, à partir du site de chaque fabricant. Sur la page de présentation du OnePlus 15, les indices IP ne figurent que dans une image du produit sans texte alternatif. Les deux modèles ont ouvert cette page dans ego(lite). Fable 5.2 a fait une capture d’écran de l’image et lu les quatre indices : IP66, IP68, IP69 et IP69K.
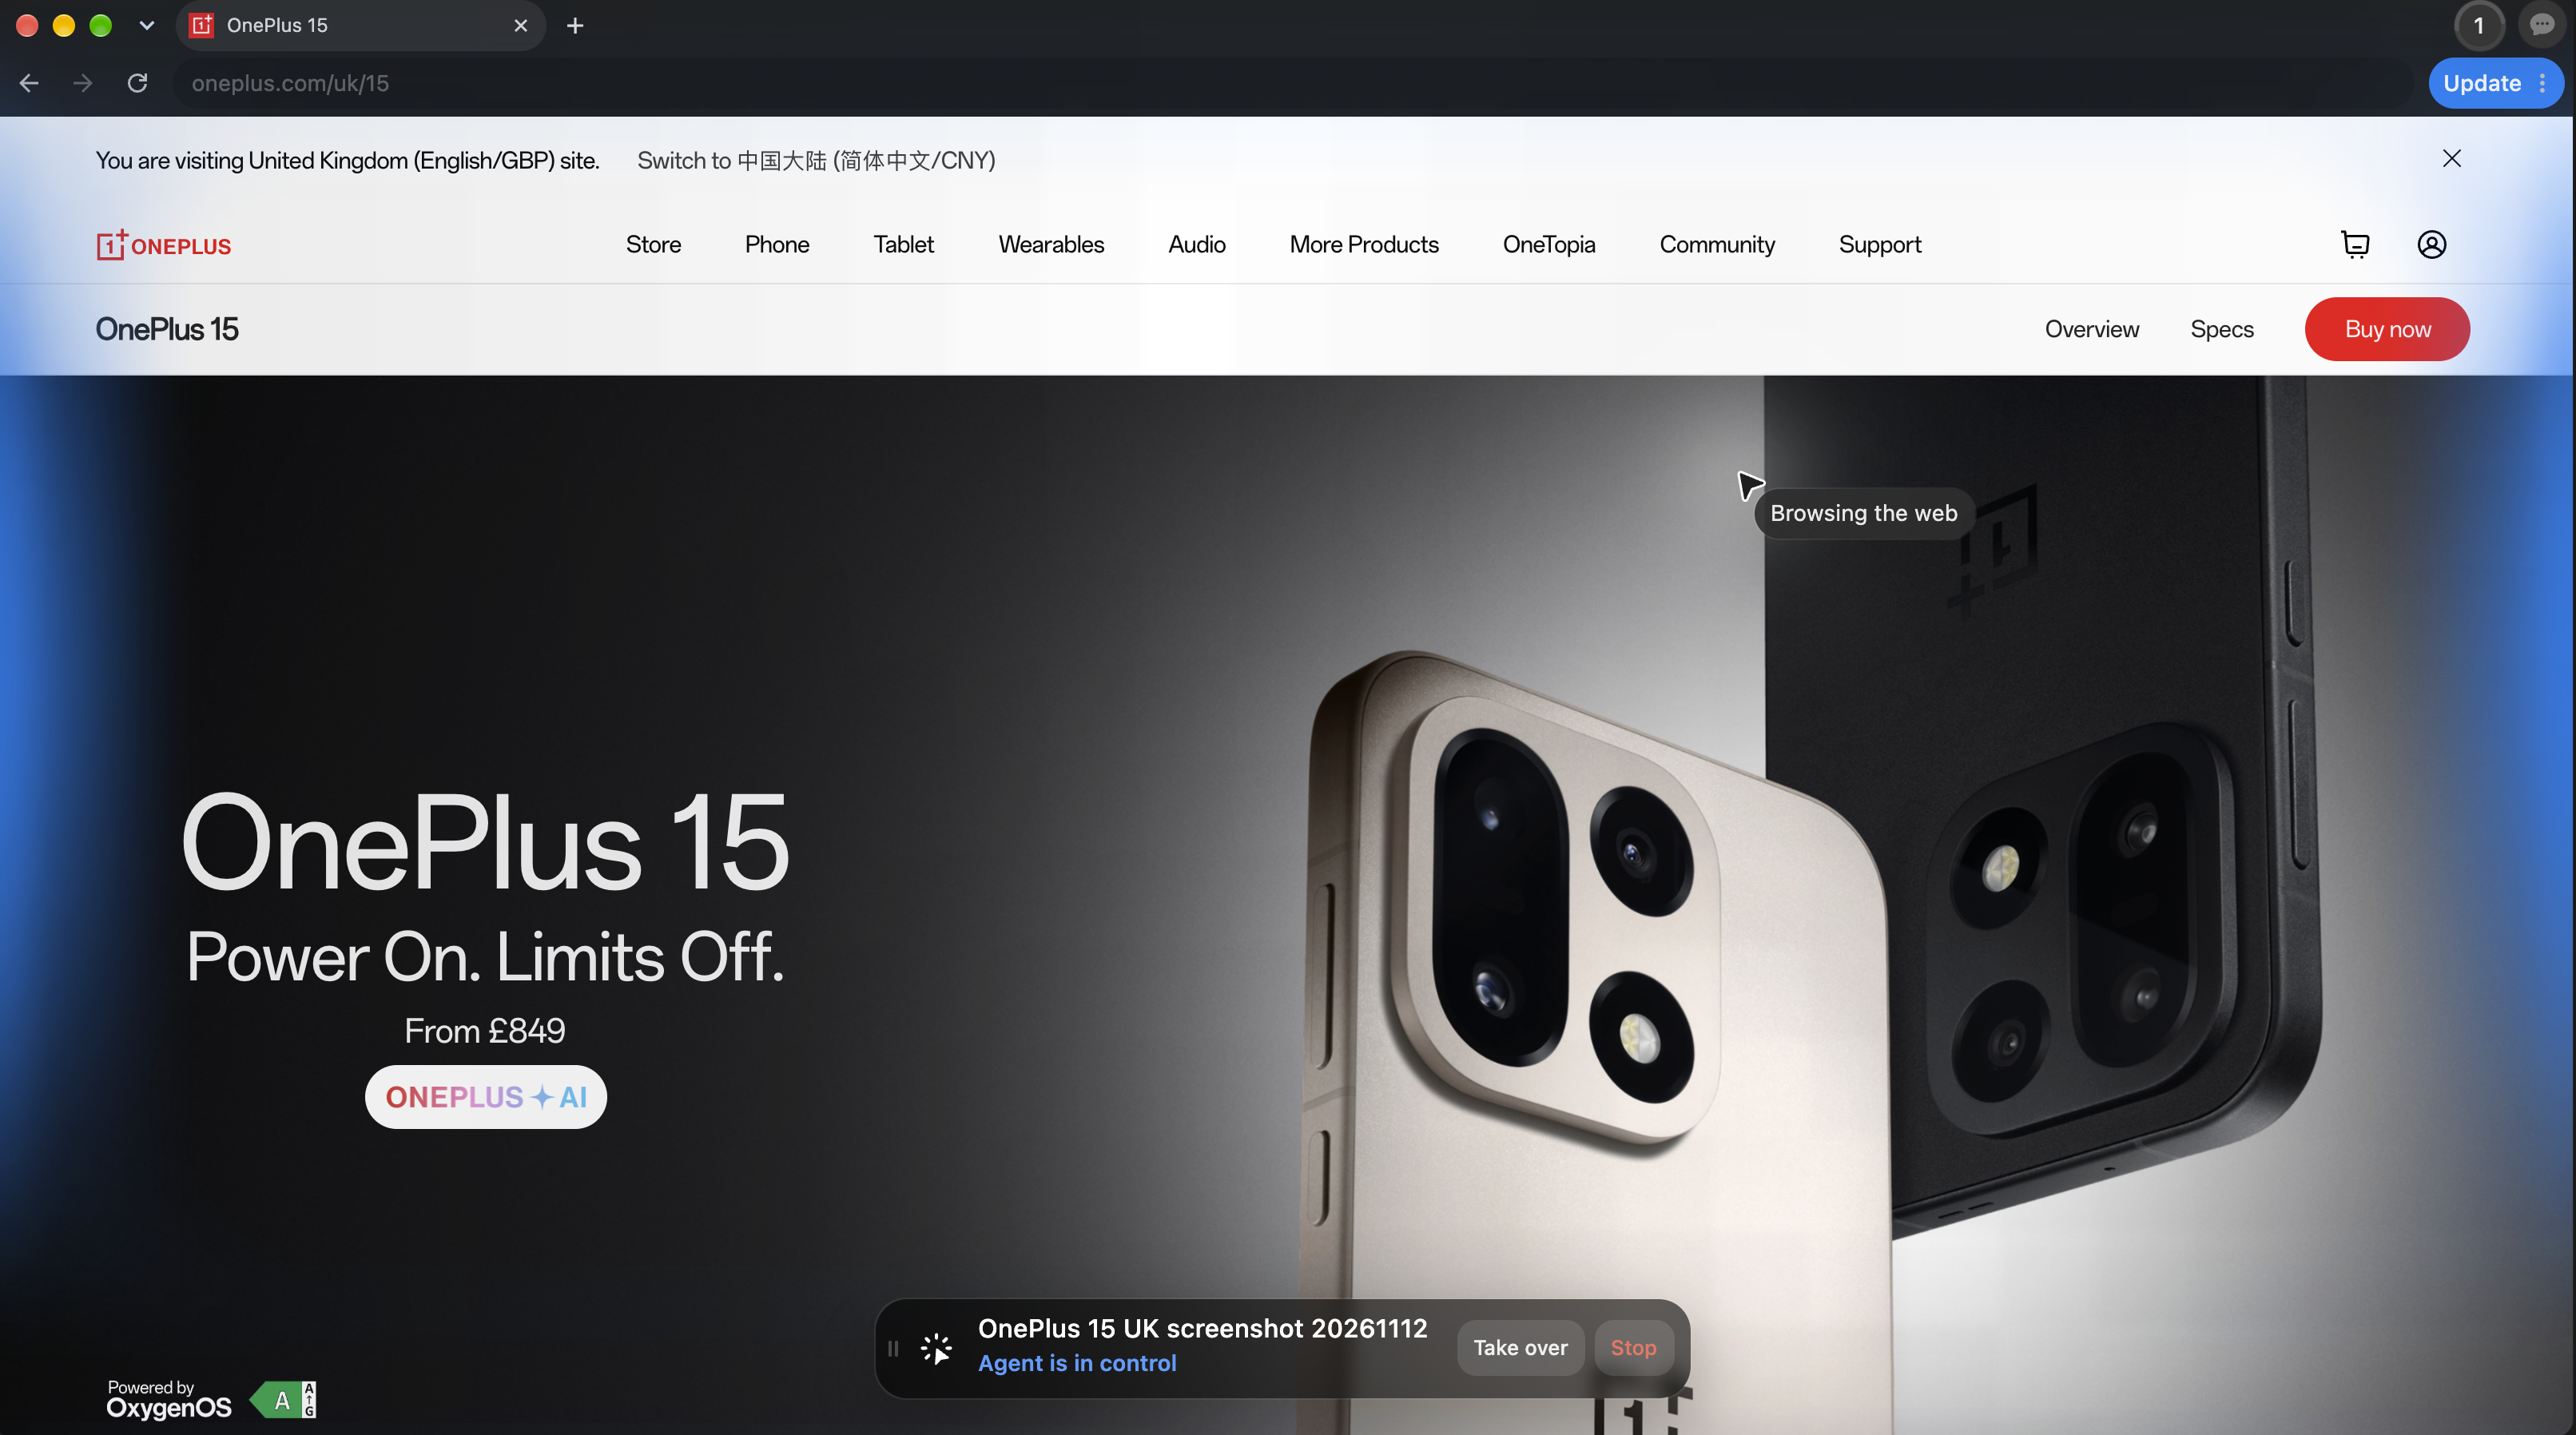
Fable 5.1 a recherché les codes IP dans le texte de la même page sans en trouver. Il a ensuite relevé IP68 dans une ligne sur l’écoconception de la page des caractéristiques. Son tableau final n’indiquait qu’un seul indice pour le OnePlus 15 : le téléphone manquait donc aussi dans sa liste des appareils IP69. Fable 5.2 a effectué 65 appels aux outils sur cette tâche et Fable 5.1, 31. La bonne réponse a donc coûté $6.04, contre $3.13.
Les cas où Fable 5.1 fait déjà suffisamment bien le travail
Fable 5.1 est un agent de navigation compétent, et il reste raisonnable de le conserver. Il a réussi tous les workflows d’applications web et toutes les tâches de recherche, comme les réservations de voyages, le remplissage de bons de commande et la recherche des sources d’une information. Si votre agent traite surtout ce genre de tâches, changer de modèle n’augmentera pas considérablement le nombre de tâches terminées. Le gain réel serait un prix inférieur d’environ 20%. Fable 5.2 reste toutefois le meilleur choix si votre agent remplit souvent de longues fiches de caractéristiques ou des tableaux comparatifs à partir de plusieurs sites. Dans ces cas, une valeur manquante ou erronée est généralement difficile à repérer.
Pourquoi Fable 5.2 coûte moins cher
Fable 5.2 coûte moins cher surtout parce qu’Anthropic a baissé ses prix. Ses prix catalogue sont inférieurs de 20% à ceux de Fable 5.1 pour chaque catégorie de tokens. C’est aussi la principale raison pour laquelle nous recommandons de changer de modèle. En matière d’efficacité, les deux ont accompli à peu près la même quantité de travail pour terminer une tâche. Fable 5.2 a généré environ 18% de tokens de sortie en moins par tâche, mais effectué quelques appels aux outils de plus, 35 contre 32 : les deux effets se compensent. Au tarif de Fable 5.1, la facture serait la même.
Avec un agent de navigation, vous payez surtout le modèle pour lire, plutôt que pour écrire. Environ 70% des dépenses de Fable 5.2 sont allées à son contexte : le texte des pages, les instantanés et les captures d’écran récupérés, ainsi que ses étapes précédentes. Il relit cet ensemble à chaque tour. C’est pourquoi les travaux couvrant trop de sites sont souvent les plus coûteux. Recueillir les mêmes informations sur 8 à 12 sites officiels coûtait $4.65 par tâche avec Fable 5.2, tandis qu’une recherche sur trois sites au maximum coûtait $1.35. Nous établirions le budget selon le travail de votre agent, et pas seulement selon le prix du modèle.
L’économie est plus marquée dans le coût par résultat exploitable. Quand une tâche tournait mal, Fable 5.1 dépensait davantage avant de s’arrêter : environ un tiers de son total est donc allé à des tentatives échouées, contre un huitième pour Fable 5.2. En comptant ces échecs, chaque tentative réussie coûtait $4.85 avec Fable 5.1 et $3.13 avec Fable 5.2. C’est ce chiffre que nous examinerions pour comparer les coûts.
Afficher sous forme de tableau
| Type de travail | Réussites de Fable 5.2 | Réussites de Fable 5.1 | Coût par tâche de Fable 5.2 | Coût par tâche de Fable 5.1 | Tâches retenues pour le coût |
|---|---|---|---|---|---|
| Tous les types de travail | 25/28 | 23/28 | $2.63 | $3.28 | 23 |
| Collecte de données multisites | 9/10 | 8/10 | $4.65 | $5.77 | 8 |
| Recherche et comparaison | 8/8 | 7/8 | $1.35 | $1.84 | 7 |
| Automatisation d’applications web | 4/4 | 4/4 | $1.44 | $1.84 | 4 |
| Recherche et synthèse | 3/3 | 3/3 | $2.02 | $1.87 | 3 |
| Vérification sur les réseaux sociaux | 1/3 | 1/3 | $1.96 | $3.32 | 1 |
Comment l’exécuter
Nous avons exécuté claude-fable-5-2 avec un effort de raisonnement high dans Claude Code, avec les outils Bash, Read, Write, Edit et Skill. L’agent charge le fichier de skill ego-browser et pilote ego(lite) via ego-browser. Il écrit de courts scripts JavaScript qu’ego-browser exécute pour contrôler les pages dans ego(lite).
Questions fréquentes
Claude Fable 5.2 est-il meilleur que Fable 5.1 pour les agents de navigation ?
Dans nos tests, oui : Claude Fable 5.2 a réussi toutes les tâches réussies par Fable 5.1, plus deux autres. Sur 28 tâches web, exécutées une fois chacune dans le même cadre d’exécution d’agent et avec le même outil de navigateur, Fable 5.2 a réussi 25 tentatives sur 28 (89.3%) et Fable 5.1, 23 sur 28 (82.1%). L’une des réussites supplémentaires était une fiche de caractéristiques pour laquelle Fable 5.2 a lu les codes IP dans une image de produit.
Vaut-il la peine de passer de Fable 5.1 à Claude Fable 5.2 ?
Oui, passer à Claude Fable 5.2 en vaut la peine pour les agents de navigation : il coûtait moins cher pour le même travail et n’a perdu aucune tâche réussie par Fable 5.1. Il a réussi 25 tentatives sur 28, contre 23 sur 28 pour Fable 5.1. Sur les 23 tâches réussies par les deux modèles, il coûtait $2.63 par tâche, contre $3.28 : cette économie correspond à la baisse de prix de 20% d’Anthropic.
Claude Fable 5.2 coûte-t-il moins cher par tâche que Fable 5.1, ou seulement par token ?
Claude Fable 5.2 coûte moins cher par tâche comme par token : $2.63 contre $3.28 sur les 23 tâches web réussies par les deux modèles. Ses prix catalogue sont inférieurs de 20% pour chaque catégorie de tokens. Au tarif de Fable 5.1, son utilisation sur ces tâches coûterait environ $3.28 : l’économie par tâche sur le travail terminé vient donc de la baisse de prix.
Claude Fable 5.2 utilise-t-il moins de tokens que Fable 5.1 ?
Sur l’ensemble des 28 tentatives, Claude Fable 5.2 a utilisé 29% de tokens de sortie en moins : 20 138 par tentative, contre 28 481 pour Fable 5.1. Sur les 23 tâches réussies par les deux modèles, il générait encore moins de tokens de sortie : 18 581 par tâche, contre 22 607. À tarifs identiques, le coût de son utilisation totale sur ces tâches serait à peu près le même que celui de Fable 5.1.
Claude Fable 5.2 est-il plus rapide que Fable 5.1 sur les tâches de navigation ?
Oui, légèrement : sur les 23 tâches web réussies par les deux modèles, Claude Fable 5.2 a pris 418.5 secondes par tâche et Fable 5.1, 450.6 secondes. Fable 5.2 était plus rapide sur 13 de ces 23 tâches. Les deux utilisaient le même cadre d’exécution d’agent et le même outil de navigateur ; le temps comprend l’attente de l’API du modèle.
Combien coûte l’utilisation de Claude Fable 5.2 comme agent de navigation ?
Dans nos tests, Claude Fable 5.2 coûtait en moyenne $2.63 par tâche sur les 23 tâches web réussies par les deux modèles, et $3.13 par tentative réussie en comptant les 28 tentatives. Fable 5.1 coûtait $3.28 par tâche et $4.85 par tentative réussie. La collecte de données multisites était le type de travail le plus cher, à $4.65 par tâche pour Fable 5.2.
Quelles sont les forces de Claude Fable 5.2 en automatisation du navigateur ?
Claude Fable 5.2 a réussi toutes les tentatives d’automatisation d’applications web, de recherche et comparaison, et de recherche dans nos tests, ainsi que 9 tentatives de collecte de données multisites sur 10. Fable 5.1 a réussi 8 tentatives multisites sur 10 et 7 tentatives de recherche et comparaison sur 8. Les deux réussites supplémentaires de Fable 5.2 venaient de ces deux types de travail.
Dans quels cas Claude Fable 5.1 reste-t-il au niveau de Fable 5.2 ?
Claude Fable 5.1 était au niveau de Fable 5.2 sur les workflows d’applications web et la recherche ouverte. Chacun des deux modèles a réussi les 4 tentatives d’automatisation d’applications web et les 3 tentatives de recherche et synthèse. Sur la recherche, Fable 5.1 coûtait $1.87 par tâche, contre $2.02 ; sur les workflows d’applications web, Fable 5.2 était moins cher, à $1.44 contre $1.84.
Claude Fable 5.2 s’arrête-t-il avant d’avoir terminé les tâches de navigation à plusieurs étapes ?
Pas dans nos tests : chaque tentative de Claude Fable 5.2 s’est terminée par une réponse finale, et aucune n’a épuisé le budget de 100 étapes. Ses trois échecs étaient des réponses finales qui ne donnaient pas correctement toutes les valeurs requises.
Claude Fable 5.2 peut-il exécuter des tâches de navigation sans supervision ?
Claude Fable 5.2 a terminé seul la plupart des tâches, réussissant 25 tentatives sur 28. Mais chacun de ses trois échecs s’est aussi terminé par une réponse finale contenant des erreurs. À deux reprises, il a relevé des valeurs dans la mauvaise source, par exemple une version de sécurité ultérieure ou un autre communiqué de presse régional. Pour les données de publication ou de tarification, vérifiez la page d’origine de chaque valeur.
Comment Claude Fable 5.2 peut-il utiliser un navigateur ?
Claude Fable 5.2 peut piloter un navigateur au moyen d’un cadre d’exécution d’agent et d’un outil de navigateur. Dans nos tests, il tournait dans Claude Code et pilotait ego(lite) via ego-browser, en écrivant de courts scripts JavaScript qu’ego-browser exécutait pour contrôler les pages. Avec cette configuration, il a réussi 25 tentatives sur 28 sur les tâches web.
Notre méthode de test
Nous avons comparé Claude Fable 5.2 (claude-fable-5-2) et Claude Fable 5.1 (claude-fable-5-1), tous deux avec un effort de raisonnement high, dans le même cadre d’exécution d’agent : Claude Code avec les outils Bash, Read, Write, Edit et Skill. Les deux pilotaient ego(lite) via ego-browser, qui présente la page au modèle sous la forme demandée par son script : instantané d’accessibilité, texte de la page ou capture d’écran. Nous avons exécuté les tests le 12 novembre 2026, sous Linux.
Les 28 tâches couvrent cinq types de travail. L’automatisation d’applications web désigne les workflows dans des applications métier de test, comme le rapprochement des factures et des paiements. La recherche et comparaison couvre un à trois sites, par exemple la vérification de la prise en charge par les navigateurs sur MDN et Can I use. La collecte de données multisites consiste à recueillir les mêmes champs sur 8 à 12 sites officiels, par exemple les décisions de taux de 12 banques centrales. La recherche et synthèse est ouverte, comme lorsqu’on retrouve les sources d’un tableau de Wikipedia. La vérification des réseaux sociaux rapproche des publications sur X de pages officielles. Chaque tâche n’appartient qu’à un seul type.
Chaque modèle a exécuté chaque tâche une fois, et une exécution d’une tâche constitue une tentative. Une tentative réussit si sa réponse finale donne correctement toutes les valeurs requises. Chaque tentative disposait au maximum de 100 étapes et de 60 minutes. Une étape est un tour du modèle, un appel à un outil est un appel effectué par le modèle à un outil, et une commande du navigateur est un script transmis à ego-browser. Le temps est la durée réelle par tentative, attente de l’API du modèle comprise. Le coût est exprimé en dollars américains et calculé à partir de la consommation de tokens de chaque tentative aux prix catalogue d’Anthropic, avec les lectures et écritures du cache comptabilisées à leurs tarifs respectifs. Le temps et le coût par tâche réussie sont comparés sur les 23 tâches réussies par les deux modèles. Le coût par tentative réussie est le coût de toutes les tentatives divisé par le nombre de tentatives réussies.
Résultats complets
Chaque cellule indique si l’unique tentative du modèle a réussi, sa durée en secondes, attente de l’API du modèle comprise, et son coût en dollars américains. Les moyennes présentées ailleurs utilisent les coûts non arrondis.
| Tâche | Type de travail | Claude Fable 5.2 | Claude Fable 5.1 |
|---|---|---|---|
| Réserver des vols, des sièges et un hôtel selon une politique de voyage dans une application de réservation | Automatisation d’applications web | Réussite · 220.0 s · $1.66 | Réussite · 208.2 s · $2.19 |
| Mettre les moniteurs de services en conformité avec une norme écrite dans une application de supervision | Automatisation d’applications web | Réussite · 140.7 s · $1.02 | Réussite · 158.2 s · $1.60 |
| Créer des bons de commande à partir des niveaux de stock dans une application de gestion des stocks | Automatisation d’applications web | Réussite · 163.0 s · $1.06 | Réussite · 128.2 s · $1.29 |
| Rapprocher les factures de février des paiements et ouvrir des contestations dans une application financière | Automatisation d’applications web | Réussite · 316.3 s · $2.02 | Réussite · 308.8 s · $2.28 |
| Vérifier les chapitres d’une vidéo de cours à partir de son code GitHub et de son article arXiv | Recherche et comparaison | Réussite · 136.3 s · $1.14 | Réussite · 221.8 s · $1.57 |
| Calculer des chiffres d’inflation à partir de FRED et les confirmer sur BLS | Recherche et comparaison | Réussite · 122.7 s · $1.03 | Réussite · 93.3 s · $1.11 |
| Recouper la prise en charge de six fonctionnalités web par les navigateurs sur MDN et Can I use | Recherche et comparaison | Réussite · 179.2 s · $1.14 | Réussite · 239.1 s · $2.13 |
| Trouver les tarifs sans escale les moins chers pour trois villes sur un site de recherche de vols | Recherche et comparaison | Réussite · 683.0 s · $2.24 | Échec · 768.3 s · $4.41 |
| Rapprocher les essais de phase 3 sur ClinicalTrials.gov des notices correspondantes des médicaments sur DailyMed | Recherche et comparaison | Réussite · 178.6 s · $1.52 | Réussite · 267.6 s · $2.24 |
| Relever les prix et comparer trois configurations de portables dans la boutique américaine d’un fabricant | Recherche et comparaison | Réussite · 378.2 s · $2.46 | Réussite · 392.0 s · $3.17 |
| Rapprocher les chiffres du box-office de six films entre une base de données de recettes et Wikipedia | Recherche et comparaison | Réussite · 102.2 s · $1.09 | Réussite · 87.6 s · $1.12 |
| Examiner quatre entreprises britanniques sur Companies House | Recherche et comparaison | Réussite · 101.2 s · $1.09 | Réussite · 185.4 s · $1.52 |
| Construire une matrice de conformité à partir de 9 centres de confiance SaaS | Collecte de données multisites | Réussite · 1110.0 s · $6.16 | Réussite · 737.9 s · $5.56 |
| Recueillir cinq caractéristiques de 8 appareils photo sur les sites des fabricants | Collecte de données multisites | Réussite · 482.4 s · $3.49 | Réussite · 480.9 s · $4.35 |
| Recueillir cinq caractéristiques de 9 smartphones haut de gamme sur les sites britanniques des fabricants | Collecte de données multisites | Réussite · 992.6 s · $6.04 | Échec · 467.5 s · $3.13 |
| Recueillir les détails des conférences d’ouverture de 9 événements pour développeurs | Collecte de données multisites | Réussite · 920.8 s · $4.85 | Réussite · 1168.4 s · $8.85 |
| Recueillir les chiffres d’autonomie et de recharge de 9 SUV électriques sur les sites américains des fabricants | Collecte de données multisites | Réussite · 1120.9 s · $6.91 | Réussite · 1261.0 s · $6.91 |
| Recueillir les caractéristiques et licences de 9 modèles à poids ouverts sur Hugging Face et les pages des fournisseurs | Collecte de données multisites | Réussite · 758.7 s · $5.24 | Réussite · 1059.6 s · $6.26 |
| Recueillir les salaires minimums légaux auprès de 9 organismes du travail | Collecte de données multisites | Réussite · 567.0 s · $4.25 | Réussite · 640.1 s · $5.32 |
| Recueillir la première décision de taux de 2026 sur les sites de 12 banques centrales | Collecte de données multisites | Réussite · 525.9 s · $3.51 | Réussite · 435.1 s · $4.52 |
| Comparer les offres gratuites de 9 plateformes serverless | Collecte de données multisites | Réussite · 501.1 s · $2.77 | Réussite · 665.2 s · $4.40 |
| Comparer la fiche d’un même album sur 9 services musicaux | Collecte de données multisites | Échec · 408.6 s · $1.98 | Échec · 292.4 s · $2.22 |
| Dénombrer les modèles dépassant les seuils de calcul de l’UE dans une base publique de modèles | Recherche et synthèse | Réussite · 195.2 s · $1.64 | Réussite · 80.4 s · $1.08 |
| Lire les points de coût et de score sur un graphique interactif de classement | Recherche et synthèse | Réussite · 317.1 s · $2.39 | Réussite · 327.3 s · $2.41 |
| Remonter de 10 cellules d’un tableau de Wikipedia à leurs sources | Recherche et synthèse | Réussite · 382.2 s · $2.03 | Réussite · 342.7 s · $2.12 |
| Rapprocher les publications de produits de 8 marques sur X de leurs communiqués de presse | Vérification sur les réseaux sociaux | Échec · 1132.7 s · $3.79 | Échec · 2200.8 s · $14.22 |
| Rapprocher les publications de sécurité de 8 projets open source sur X de leurs propres annonces | Vérification sur les réseaux sociaux | Échec · 750.8 s · $3.75 | Échec · 3302.8 s · $12.30 |
| Rapprocher une semaine de publications de lancements de SpaceX sur X des listes de lancements de Wikipedia | Vérification sur les réseaux sociaux | Réussite · 706.2 s · $1.96 | Réussite · 875.8 s · $3.32 |