結論から言います。Playwright MCP は条件付きで導入する価値があります。公開ページでの短いセッションには向きますが、長いタスクやログインが必要なサイトには向きません。そこではトークン消費(公開されている計測ではテスト実行あたり 89K-114K)と、まっさらなプロファイルゆえのログインの壁が支配的になります。トークン消費で行き詰まっているなら、ego (lite) はページを Snapshot としてエージェントに渡すため、節約できるのは単一のステップではなくタスク全体の合計です。
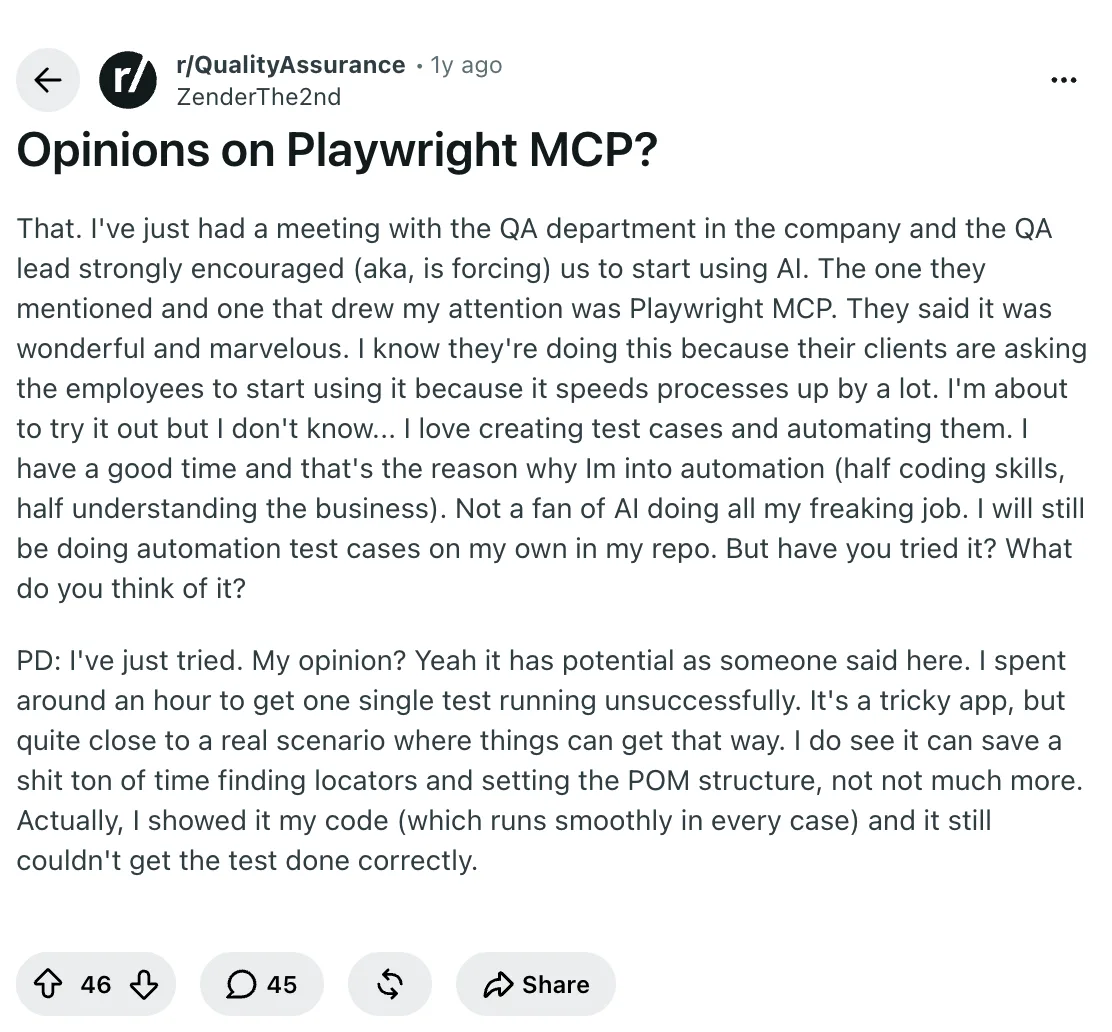
r/QualityAssurance のある QA エンジニアは、リードから Playwright MCP は「素晴らしく、驚くべきもの」だと聞かされていました。そして実際に試すと、厄介なアプリに対する1つのテストに1時間かけても、パスしませんでした。
同じスレッドは、Playwright MCP は「とてつもないポテンシャル」があるのに過小評価されているとも書いています。どちらの見方も正しく、だからこそ先ほどの評価には条件が付きます。きちんと分解して見ていきましょう。
Playwright MCP とは何か
Playwright MCPは Microsoft によるオープンソースの MCP サーバーで、ページのアクセシビリティツリーをスナップショットとして取り、その構造化テキストを LLM に渡し、モデルが選んだ操作(クリック、入力、ナビゲーション)を実ブラウザで実行します。
それ自体は AI 製品ではなく、テストフレームワークでもありません。MCP 対応のエージェント(Claude Code、Cursor、VS Code、Codex)が、視覚モデルなしで Web ページを見て操作できるようにする配管です。差別化点はスナップショット方式にあります。要素は ref=e5 のような参照 ID 付きのテキストとして届くため、モデルはピクセルではなく構造に基づいて行動します。
セットアップは本当に1行です。Claude Code の場合:
claude mcp add playwright npx @playwright/mcp@latestこのアクセシビリティスナップショットの設計は、動く理由であり、高くつく理由でもあります。この点は覚えておいてください。
Playwright MCP は何が得意か
マーケティングページではなく、実際の利用レポートで繰り返し現れる強みが3つあります。
1. 数分で動くところまで到達する。 設定1行で、エージェントは20以上のブラウザツールを手にします。スクリプトの足場も、フレームワークの選定も不要です。ブラウザを自動化したことがない人にとって、これが現存する最短の道であり、Microsoft の Playwright チームが公式に保守しているため、多くのコミュニティ製ブリッジのように腐らずブラウザの変更に追随します。
初回の体験が魅力を決めます。「ステージングサイトを開いて、サインアップフォームがメールアドレスを検証するか教えて」と入力すると、30秒後にはエージェントがブラウザを開き、フォームに不正なアドレスを入力し、エラーメッセージの内容を報告しています。このカテゴリの他のセットアップで、ここまで速く到達できるものはありません。
2. ロケーターの発見とテストの下書き。 QA スレッドからの正直な称賛:「ロケーターを見つけて POM 構造を組む時間をものすごく節約できる」。エージェントにページを指して、ページオブジェクトクラスとテストの下書きを頼むのは本当に機能します。あるコメント投稿者は、この方法で300行の構造化されていないテストクラスを55行にしました。
3. 決定論的で監査可能な操作。 モデルがピクセル座標を推測するのではなく要素の ref を対象にするため、操作は再現可能で、すべてのステップがレビューできるログ付きのツール呼び出しになります。GitHub Copilot のコーディングエージェントが自身の UI 変更の検証に使っており、これは実運用での裏付けです。
Playwright MCP がつまずく場面
失敗パターンは3つ、それぞれに証拠があります。
1. トークン消費の請求。 操作のたびに新しいページスナップショットが返り、それらがコンテキストに積み上がります。r/ClaudeCode の現場報告では、テスト1回か2回でチャットが圧縮されてしまいます。スナップショットが大きすぎるために、まったく読み込めないサイトもあります。公式リポジトリの Issue #889は、同じタスクで2つのマイナーバージョン間に6倍のトークン増加があったと報告しています。2026年1月の3ツール比較(Cole Medin が公開した YouTube ベンチマーク)では、Playwright MCP はタスクの80%を一発で完了したのに対し、CLI ベースのアプローチ(agent-browser)は95%でした。差の原因は、期待した要素が最初の探索で見つからないと失敗するアクセシビリティツリー検索に直接たどられています。
公開されている数字では、MCP でのテスト実行1回は89K-114K トークンで、CLI 実行は 24K-27K です。トークンが悩みなら、実際にログイン済みのブラウザで動く ego-browser スキルが逃げ道です。計測の内訳はPlaywright MCP 対 CLI の記事。
2. 長いタスクでは筋を見失う。 ステップ 12-15 まで進むと、セッションは古いページ状態を 60-90K トークン抱えることがあり、計測された失敗は雄弁です。エージェントが、すでに存在しないログインページの要素を参照しました。多段階のワークフローは、まさにエージェントに任せたい場面であり、まさにこのアーキテクチャが無理をする場面です。
3. 複雑な実世界のページ。 QA エンジニアが1時間かけても成功しなかったテストの相手は、珍しいアプリではなく、ただ厄介なだけの「実際のシナリオにかなり近い」ものでした。生成されるコードも完成品ではありません。「その大部分を100%リファクタリングすることになる」のです。出力は成果物ではなく下書きとして扱ってください。状態漏れについては、Currents の分析(リセットしない限り、呼び出しをまたいで Cookie とストレージが残ります)という指摘もあり、複雑なフローには実際の監督が必要です。
Playwright MCP のテストはなぜ不安定(flaky)になるのか、どうデバッグするか
不安定さのほとんどはブラウザの気まぐれではなく状態の問題です。原因は、スナップショットが古い、ナビゲーションが落ち着いていない、アニメーションがまだ動いている、あるいはエージェントが前のページからの思い込みを持ち込んでいることです。新しい context で失敗を再現し、URL とスナップショットを記録してから、ロケーターを変えたり待機を長くしたりする前に、コンソールとネットワークの証拠を確認します。
回数制限付きのリトライは、既知のネットワーク競合のような、分類済みの一時的な失敗にだけ1回使います。同じアサーションが2回失敗したら、グリーンになるまでリトライせず、止めてトレースを保存します。修正は、アプリのシグナルを待つ明示的な待機、スナップショットの範囲を狭めること、決定論的なテストフィクスチャかもしれません。もう1つ適当なタイムアウトを足すことではありません。
複雑なページや未知のページにエージェントはどう対応すべきか
アクセシビリティスナップショットは、アプリケーションの完全なモデルではなく地図として扱います。エンタープライズ向け SPA では、行を仮想化したり、コントロールをメニューの奥に隠したり、状態が変わるまで操作可能な要素を描画しなかったりすることがあります。エージェントには、対象の周辺の DOM を調べ、見えているラベルとロールを確認し、構造化ビューでは人間に見えるものが説明できないときにスクリーンショットを撮るよう指示します。
未知のページは小さな観察に分けます。現在の URL と見出しを特定し、1つの操作に関係するコントロールを列挙し、その操作を実行し、結果の状態を検証します。影響の大きいワークフローでは、本番データの送信、削除、変更の前に人間の承認ゲートを置きます。スナップショットは業務上の意図を安全に推測できません。
Playwright MCP は並行するブラウザセッションを維持できるか
Playwright MCP は、クライアント設定がブラウザプロセスと context を再利用する場合、ツール呼び出しをまたいでそれらを保持できます。ただし持続は安全な分離と同じではありません。ステップごとに新しい context を起動して閉じるワークフローはログイン状態を失い、1つの context を共有する複数のエージェントは、タブ、Cookie、思い込みを互いに漏らします。
並行作業では、タスクごとに専用の context または Space を与え、対象と担当をラベル付けし、成果物を保存したら明示的に閉じます。コードで定義した context と決定論的な CI ライフサイクル制御が欲しいなら、Playwright のほうが適しています。並行作業が CI 主導ではなくエージェント主導なら、ego (lite) のほうが適しています。Claude Code や Codex は、それぞれ専用の Space で100以上のブラウザ自動化タスクを同時に実行できます。
Cloudflare や CAPTCHA、ボット対策にはどう向き合うか
Playwright MCP はボット対策を回避する手段ではなく、対象サイトが自動化を検知しないと約束できるブラウザツールはありません。robots の指示、利用規約、レート制限、ログイン要件、適用法を尊重してください。チャレンジを突破するために、ステルスプラグイン、フィンガープリント偽装、CAPTCHA 解決サービス、プロキシローテーションを使わないでください。
許可されたタスクが Cloudflare や CAPTCHA のページに到達したら、URL と表示されているチャレンジを記録し、エージェントを一時停止し、完了するか、承認済みの API やデータソースへ切り替えるかを権限ある人に判断させます。通常のユーザーブラウザはまっさらなプロファイルの摩擦を減らすことはありますが、許可を与えたりアクセス制御を取り除いたりはしません。
無料のローカル MCP サーバーはブラウザ調査に十分か
ローカルの MCP サーバーはホスト型ブラウザの費用をなくし、ナビゲーションを自分のマシンに留めます。ただし「無料」はコストゼロを意味しません。モデルは依然としてトークンを消費し、更新、認証情報、ブラウザプロセス、ポリシーの見直しは自分の責任です。スナップショットが小さく、情報源を人間が確認できる、短い公開リサーチタスクの出発点としては妥当です。
ログインが必要なワークフローを繰り返すなら、インストールコマンドではなく総作業量を比較してください。ego (lite) も無料でローカルです。Chrome プロファイルをインポートすれば、エージェントはすでにサインイン済みのセッションから作業するため、こうした実行を遅くする SSO の割り込みは目に見えて減ります。ただしサイト側が再サインインを求めることはあります。決定論的なリグレッション、大量収集、サーバー側の稼働率が必要なら、コミットされたテストフレームワークか承認済みの API を使ってください。
Playwright MCP はどんな人に向いているか
評価は、実際に何をしたいかで明確に分かれます。
| あなたは | 評価 | 理由 |
|---|---|---|
| テストスイートを書く QA エンジニア | はい、下書きツールとして | ロケーターとページオブジェクトには最適です。実際のスイートには自分のフレームワークを残してください。MCP は実行レイヤーであり、テストランナーではありません。 |
| 定期的にスクレイピングやデータ抽出をする | おそらく向かない | 長い複数ページの実行はスナップショットの蓄積という壁にぶつかり、ログインが必要な情報源はまっさらなプロファイルではカバーされません。 |
| ときどきエージェントにページを確認してほしい開発者 | はい、ただし予算の管理とともに | 約10ステップ未満の短いセッションが最適です。実行のたびにコンテキストを確認してください。 |
| 自分のアカウントで毎日ブラウザタスクを実行する | いいえ | 二重に向いていません。トークンコストはステップ数に比例して増え、ログイン状態は自分のものではありません。 |
最後の行が ego (lite) の位置です。ステップ単位ではなくタスク全体でトークンを節約する無料の Chromium ブラウザで、それが動かすブラウザはすでにあなたとしてサインイン済みです。
逃げ道を比べているなら、選択の形はこうです。3つとも実ブラウザエンジンを動かし、3行目は最初の2つを組み合わせたものです。
| 経路 | できること | できないこと |
|---|---|---|
| Playwright MCP | シェルアクセスのないものも含め、あらゆる MCP クライアントで動く。コード不要のセットアップ | 長いタスクでトークンコストを一定に保てない。既定ではログイン状態がない |
| Playwright CLI | スナップショットをディスクに書くことでトークンを約4分の1に削減。シェルツールや CI と組み合わせられる | コーディング以外のエージェントには使えない。あなたのセッションのないまっさらなプロファイルを起動する |
| ego (lite) と ego-browser | ワークフロー全体を、ログインを保つ実ブラウザで1つのスクリプトとして実行。無料 | CI コンテナでヘッドレス実行できない。アサーションを持つテストフレームワークではない |
この表の裏には計測された数字があります。Real-World Bench は同じ31タスクのスイートを、5つのツールでライブサイトに対して実行し、モデル(gpt-5.6-sol、max effort)も独立した審査も同じです。数字の前に1つ正直な注記をします。計測された Playwright の項目は、MCP サーバーではなく公式の CLI 経路である playwright-cli なので、上の表の2行目として読んでください。playwright-cli は31タスクの71.0%を完全に完了し、1タスクあたり平均 $3.42 でした。この支出を完了したタスクだけに割ると、$3.42 ÷ 71.0% 完了 = 完了タスクあたり $4.82 です。ego (lite) は31タスクで93.5%を完了し、1タスクあたり $1.64、つまり $1.64 ÷ 93.5% = 完了タスクあたり $1.75 で、1タスクあたり平均30.3モデルターン、playwright-cli は42.8でした。セッション、判定、ハーネスはego-browser-benchmark-framework リポジトリ。
ego (lite) と Playwright MCP の完全な比較を見る そういう状況ならこちらを。そうでなければ、Playwright MCP は良い出発点です。
FAQ:無料・安全・テストに向くか
Playwright MCP は無料か
はい。Playwright MCP は Apache-2.0 ライセンスのオープンソースで、Microsoft が保守しており、npm(@playwright/mcp)から無料でインストールできます。無料ではないのは、LLM のサブスクリプションや API 請求を通じて発生するトークン消費で、実際のコストはそこにあります。
Playwright MCP は安全か
ローカルで動作し、宣言されたブラウザツールだけを公開するため、エージェントの操作は監査可能です。尊重すべき境界が2つあります。任意の browser_run_code_unsafe ツールは任意の JavaScript を実行し、ドキュメント自身が RCE 相当と呼んでいるので、信頼できないクライアントでは無効のままにします。もう1つは、リセットしない限りブラウザの状態(Cookie、ストレージ)がツール呼び出しをまたいで残り、タスク間でセッションコンテキストが漏れる可能性です。
Playwright MCP はテストに向いているか
探索、下書き、バグの再現には向いていますが、リグレッションスイートの実行には向きません。アサーションモデルもリトライも決定論の保証もないので、スクリプト化した Playwright テストは CI に置き、その手前の対話レイヤーとして MCP を使います。
Playwright MCP は Cursor や Codex で動くか
はい。Cursor では Settings、MCP、Add new MCP Server の順に追加し、コマンドは npx @playwright/mcp@latest です。Codex では codex mcp add playwright npx @playwright/mcp@latest を使います。同じ標準の JSON 設定ブロックが、VS Code、Windsurf、その他ほとんどの MCP クライアントで動きます。
Playwright MCP は日常的に何に使われているか
2026年によくある実際の用途は、テストの下書きとページオブジェクトの生成、コーディングエージェントに自身の UI 変更を検証させること、不安定な挙動をオンデマンドで再現すること、公開ページでの短い探索的な自動化です。
では、Playwright MCP は良いのか。1行でインストールできる無料ツールとしては、本当に良いと言えます。冒頭の QA リードはポテンシャルについて間違っていませんでした。ただ条件を飛ばしていただけです。セッションを短く保ち、ページを公開のままにし、生成コードを下書きとして扱えば、その席にふさわしい働きをします。タスクが長くなったりログインの内側に移ったりしたとき、それは Playwright MCP が悪いのではなく、あなたがそれを超えて成長したのです。