简短回答:Browser Use 自己掌控一套自主浏览器 Agent 循环;Stagehand 给开发者一个 CDP 原生 SDK,把确定性代码和 AI 原语混在一起用;ego (lite) 则把一个完整的 Chromium 交给 Agent 去驱动。选择依据应该是“下一步动作由谁掌控”,而不是功能清单。
我们安装当前软件包,让每种可运行的产品浏览器接口执行同一个本地多步骤请求流程,并保留全部失败、工具输出、服务端事件和截图。由于没有模型服务访问条件,AI Agent 路线无法运行,以下结果明确受此限制。
披露:ego (lite) 由我们开发。
核心区别是什么?
把自主性和浏览器控制分开看,对比就简单多了。Browser Use 是一个 Agent 框架。Stagehand 是面向浏览器 Agent 的 SDK。ego (lite) 则是一个提供给外部编码 Agent 使用的浏览器。
| 决策因素 | Browser Use | Stagehand | ego (lite) |
|---|---|---|---|
| 主要角色 | 自主 Agent 循环与浏览器运行时 | 兼顾确定性与 AI 动作的混合 SDK | 面向可执行 shell 的 Agent 的持久真实浏览器 |
| 本次检查的运行时版本 | 使用 Python 3.12;软件包版本 0.13.10 | 要求 Node 22.18 或更高版本;软件包版本 4.1.0 | 已安装的 macOS 应用和 CLI 版本 0.5.2.16 |
| 谁决定下一步动作? | Browser Use 循环中配置的模型 | 你的代码,AI 只在你调用它的地方介入 | 你的编码 Agent,通过脚本和 CDP |
| 官方语言支持 | Python | TypeScript、Python 和 Go | 任何能运行其 shell skill 的 Agent |
| 最适合的默认场景 | 需要探索的未知路径 | 在代码库中维护的浏览器工作流 | 在持久个人浏览器中执行的编码 Agent 任务 |
Browser Use:模型掌握路线
Browser Use 是一个MIT 许可的 Python 框架,由一个 Agent 观察页面、决定做什么、执行操作,然后重复这一过程。当路径无法提前写死时,这种抽象是合适的。这也意味着模型选择、提示词、超时、输出校验、浏览器配置文件(Profile)以及基础设施,都是你系统的一部分。
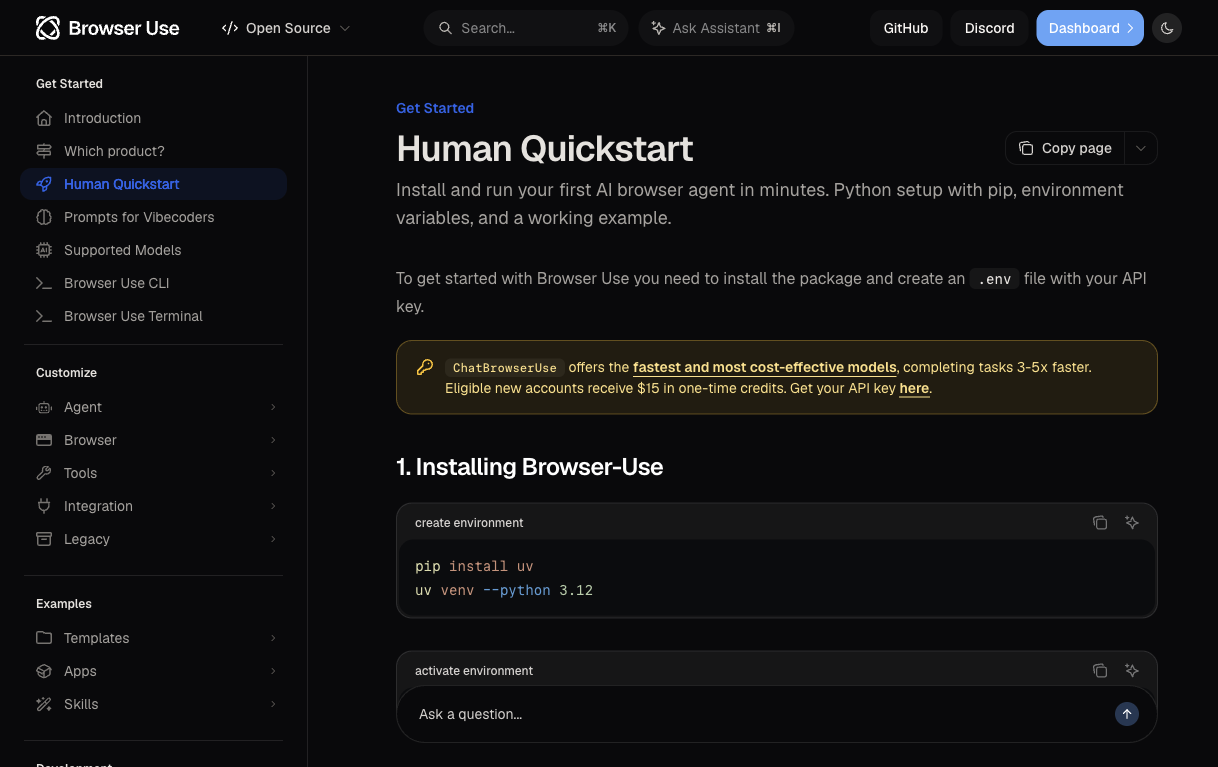
官方快速入门要求安装 Python 包,并将模型 API key 写入 .env 文件。上方截图记录了这一前置条件。可打开 Quickstart 原始分辨率截图 查看原文。
Stagehand:路径由代码掌控
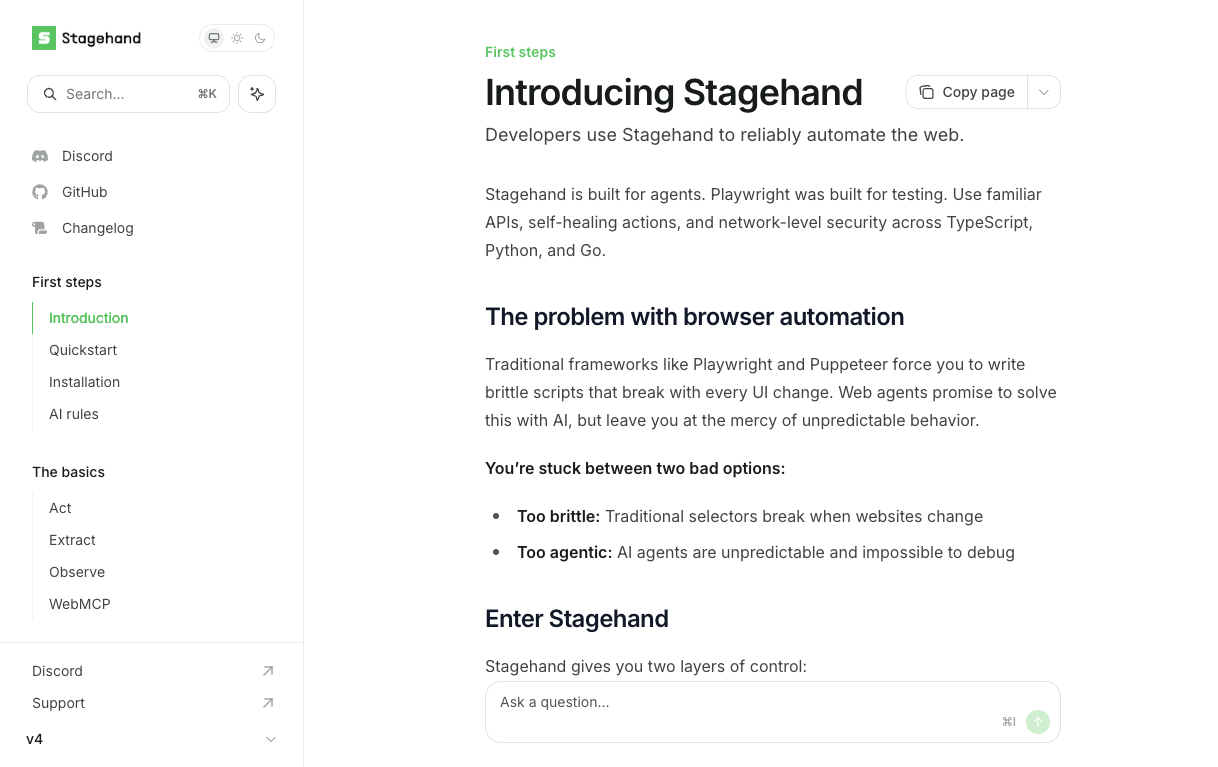
Stagehand 是 Browserbase 的开源浏览器 Agent SDK。当前 v4 SDK 使用基于 CDP 的浏览器接口作为运行时,同时提供熟悉的 Page 方法,不再以 Playwright 作为运行时。act、extract、observe 让开发者把已知步骤保留为确定性代码,只在不确定的步骤调用已配置的模型。
ego (lite):你的编码 Agent 在其中工作的浏览器
ego (lite) 不再引入另一个规划模型。Codex 或 Claude Code 这样的编码 Agent 为 Chromium TaskSpace 编写 JavaScript 工作流。本次案例测试了页面字段、刷新、截图和经服务器核实的写入,没有测试跨域 iframe 或 shadow DOM。
这次浏览器层实测得出了什么结果?
2026 年 9 月 28 日,我们用一个独立的本地 Request Desk 应用测试实际可运行的浏览器接口。每条路线都必须为订单 6123 创建相同的合成请求,指派给 Mira、设置 High 优先级、保存、标记为 Ready、重新加载页面,并返回已保存记录。在负责人和优先级正确之前,系统会拒绝 Ready 操作。独立的服务端状态接口和事件日志提供判定依据。
版本分别为 Python 3.12 上的 browser-use 0.13.10、Node 23.11 上的 @browserbasehq/stagehand 4.1.0,以及 ego-browser 0.5.2.16。Browser Use 和 Stagehand 使用独立的无头 Chrome 153 配置文件;ego 使用真实 Space 和 Chromium 154。测试 shell 中没有模型服务 API key 或 Ollama 程序,因此 Browser Use Agent 和 Stagehand AI act、extract、observe 路线无法运行。我们实测的是产品浏览器接口,不能将其解释为自主 Agent 或模型成本比较。
核心浏览器调用可以直接检查。Browser Use 使用 BrowserSession 和 actor Page,Stagehand 在 Stagehand.create 后使用 localBrowser 与 Page 定位器,ego 使用 TaskSpace Page。完整脚本、软件包锁定文件、原始工具输出、服务端事件、截图,以及最初和修正后的评分表,都收录在复现包中。
# Browser Use 0.13.10, after opening the local page
await (await element('#order')).fill('6123')
await (await element('#subject')).fill('Address discrepancy QA')
await (await element('#create')).click()
await page.evaluate('() => { document.querySelector("#owner").value="Mira"; document.querySelector("#priority").value="High"; }')
await page.evaluate('() => document.querySelector("#save").scrollIntoView({block:"center"})')
await (await element('#save')).click()
await page.evaluate('() => document.querySelector("#ready").scrollIntoView({block:"center"})')
await (await element('#ready')).click()
await page.reload()
// Stagehand 4.1.0, localBrowser after Stagehand.create({ browser })
await page.locator('#order').fill('6123');
await page.locator('#subject').fill('Address discrepancy QA');
await page.locator('#create').click();
await page.locator('#owner').selectOption('Mira');
await page.locator('#priority').selectOption('High');
await page.locator('#save').click();
await page.locator('#ready').click();
await page.reload();| 产品浏览器路线 | 排查后完成的三次固定脚本运行 | 注入的假成功 |
|---|---|---|
| Browser Use BrowserSession | bu-10、bu-11、bu-12:四项检查全部通过 | bu-fault-4:重新加载后为 Draft |
| Stagehand localBrowser | sh-4、sh-5、sh-6:四项检查全部通过 | sh-fault-2:重新加载后为 Draft |
| ego-browser Space | ego-4、ego-5、ego-6:四项检查全部通过 | ego-fault-2:重新加载后为 Draft |
表格仅描述最终修正脚本的结果,不代表产品的总体成功率。此前的每一次失败都已保留。在我们的测试应用中,Browser Use 的 select_option 返回时,并未选中缺少显式 value 的选项;早期保存也没有到达服务端。我们通过其 Page.evaluate 接口设置值,并在点击前滚动到按钮,才解决这两个问题。Stagehand 有一次早期失败,原因是我们的脚本在异步保存完成前读取页面。最初的评分脚本还只读取 stdout,但 ego-browser 把结构化控制台日志写到 stderr;未经修改的原始日志和独立复核脚本记录了这项修正。我们没有删除任何排查运行。
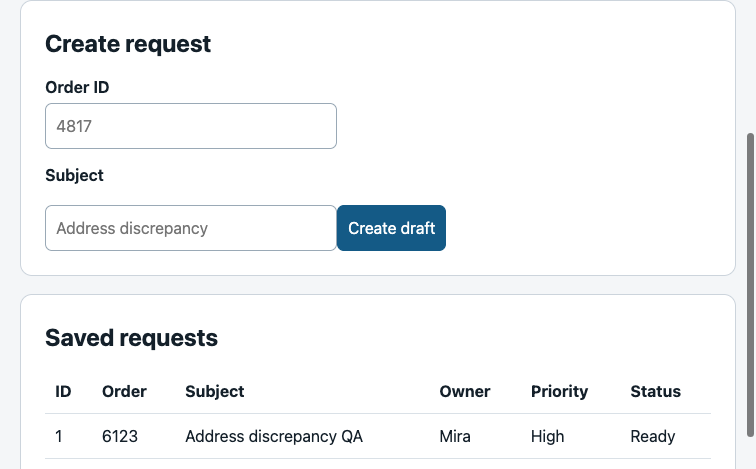
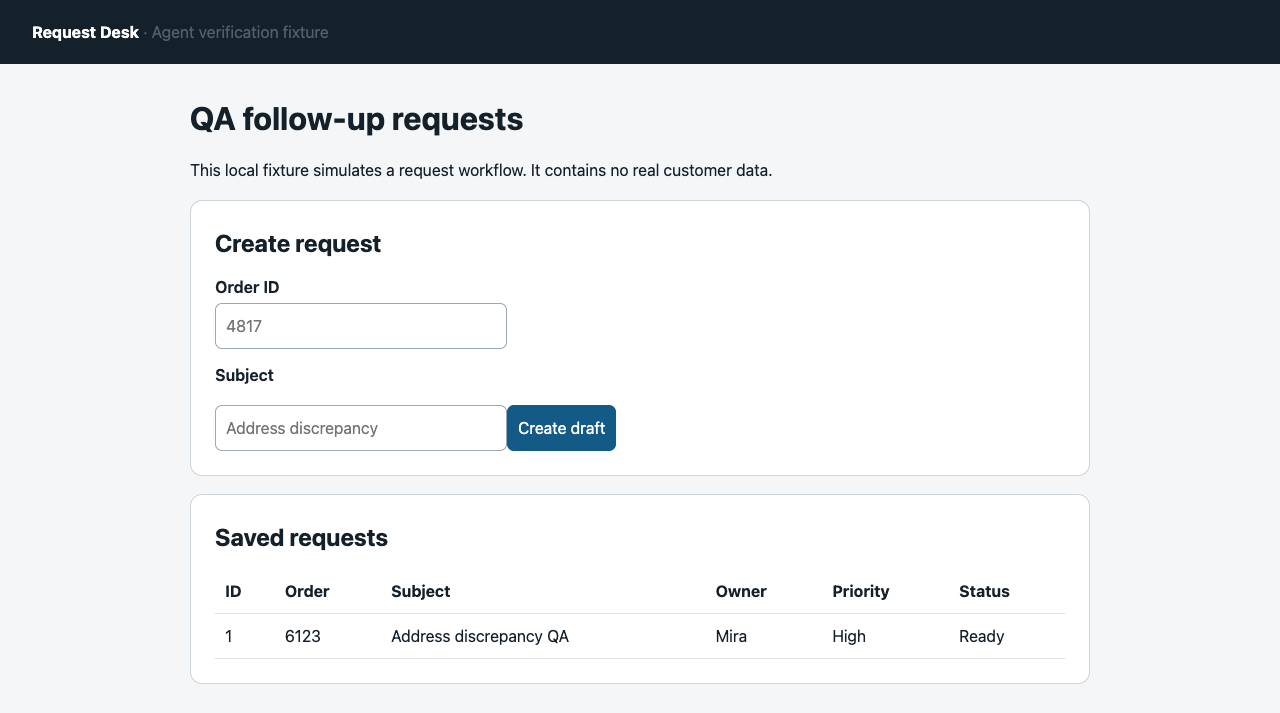
sh-4 在重新加载后的截图记录了订单 6123、负责人 Mira、优先级 High、状态 Ready。独立服务端事件日志与这行记录一致。可打开 sh-4 原始分辨率截图 查看未经修改的浏览器画面。
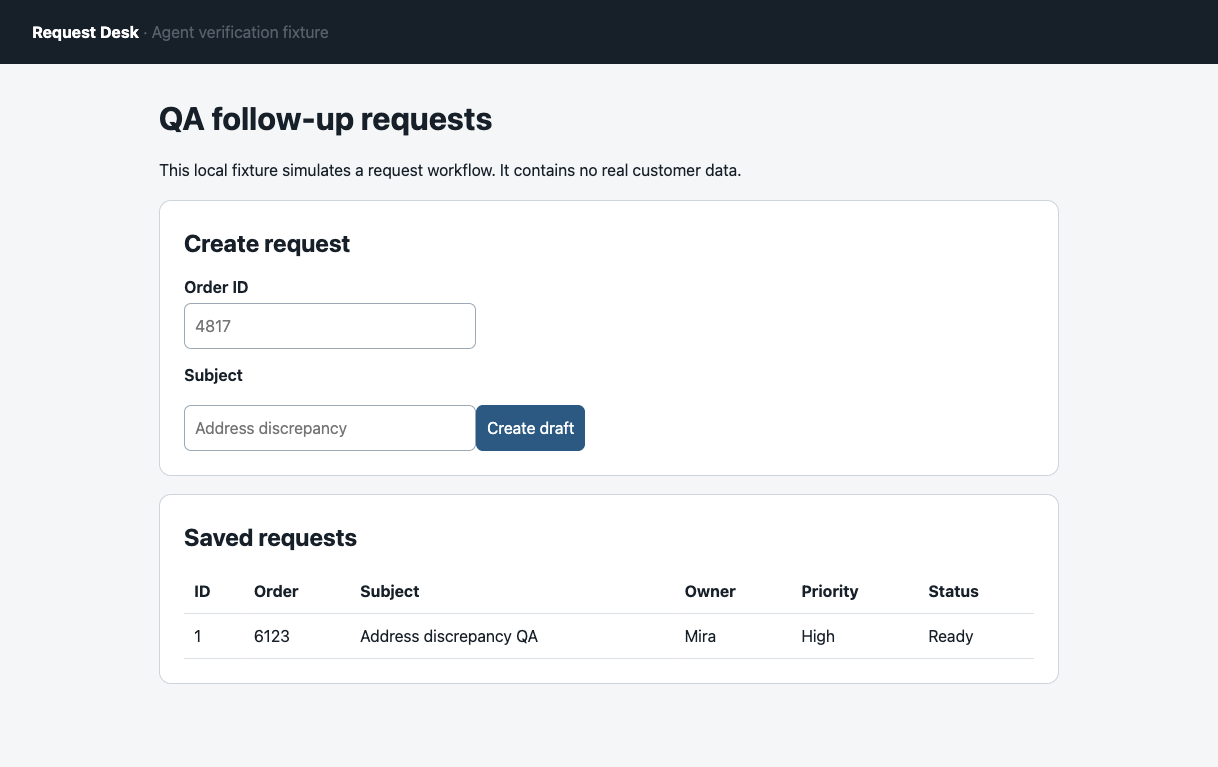
打开完整的原始结果截图:Browser Use bu-10, Stagehand sh-4, ego-browser ego-4.
在故障注入中,三条路线都收到即时成功信号,但服务端仍把请求保留为 Draft。下一次加载页面以及 ready_write_suppressed 事件揭示了差异。这说明 Toast、HTTP 200 响应或重新加载前的截图,都不足以证明浏览器任务已经持久保存。每条路线仅有一次故障运行,无法据此估计真实环境中的故障率。
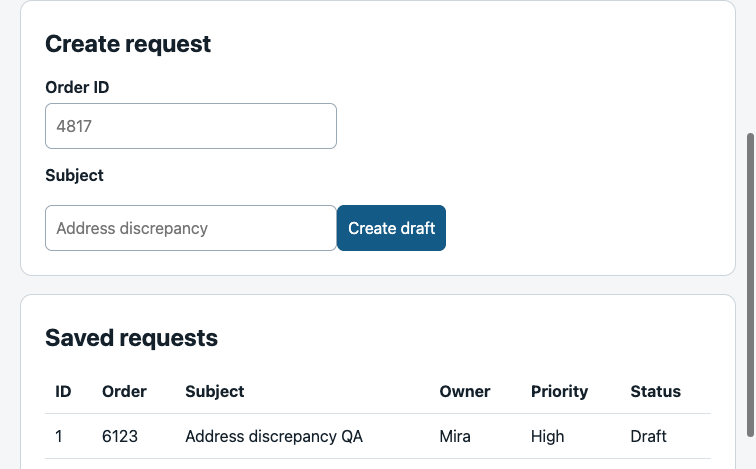
下载复现包,检查全部 32 次尝试、原始与修正后的评分、版本锁定文件、测试应用、实际浏览器脚本、截图和服务端事件。公开副本将 ego runner 的输出路径改为相对于解压目录的路径;来源与公开版本的 SHA-256 对照表列出两个发生转换的文件。这些运行没有测量模型 token、账单费用、AI 规划质量或跨产品速度。
另有一项独立的外部比较:Skyvern 报告的 2026 年 9 月 Books to Scrape 测试,其中 Browser Use Cloud 和 Stagehand 都进行重复运行,报告标明了共用的模型名称和失败链接。它使用的任务、托管方式、模型配置和评分方法与我们的实验不同。应把它看作另一个操作者的报告,不能当作本地测试应用的额外试验。
哪个浏览器 Agent 能上生产环境?
脱离运行模式谈谁是生产环境赢家,没有意义。如果需要一个自主 Agent 自己去探索路径,Browser Use 最合适。如果团队自己维护代码库,希望在确定性浏览器代码旁边使用 AI 原语,Stagehand 更合适。 AgentQL是面向查询的方案,适合想在 Playwright 浏览器之上用自然语言描述数据结构的团队;而Skyvern是工作流平台,当可视化、服务托管的流程比嵌入浏览器 SDK 更重要时,值得评估。browse CLI则是一个有用的本地对照项,适合让 Agent 调用一个很小的命令接口。
把这些标签当作起点,而不是保证。采用任何一个之前,先用你真正需要的页面、账号状态和输出 schema 跑一遍只读验收任务。测量完成率、失败步骤后的恢复能力、留存的证据、人工介入次数,以及每个成功结果的成本。一个在 demo 里看起来很自主的工具,到了生产环境仍然可能需要队列、重试、校验器,以及一条人工升级路径。
| Production question | What to verify |
|---|---|
| Can it recover? | Retry limits, timeout state, and a resumable session rather than a blind replay |
| Can it be audited? | URL, inputs, extracted output, screenshots or logs, and the final validation decision |
| Can it be contained? | Separate profiles or Spaces, domain policy, scoped credentials, and a stop or takeover control |
一次浏览器 Agent 执行要花多少钱?
真正有用的单位是每个成功结果的成本,而不是宣传的 Token 单价。要把模型输入和输出 Token、浏览器或会话分钟数、网络或代理费用、存储、重试,以及人工检查失败所花的时间都算进去。一次 100 Token 的提取如果需要重跑三次,可能比一个更长但一次成功的确定性脚本还贵。
根据文档,Stagehand 的 act、extract、observe 可把模型调用限制在指定步骤;Browser Use Agent 可以规划操作路线;ego (lite) 可以让现有编程 Agent 承担规划。我们的 9 月案例没有为浏览器产品接入模型服务,也无法观察编程 Agent 的 token 或账单费用。这是浏览器接口及校验案例,不是价格基准测试。
Agent 应该如何处理登录和验证码(CAPTCHA)?
把身份验证当作一次状态转换来处理,而不是当作要攻破的挑战。给 Agent 一个最小权限的浏览器配置文件(Profile),导航到登录页,然后暂停,让账号所有者输入密码、一次性验证码或 passkey。只有当页面进入可验证的登录态之后才继续。把验证码(CAPTCHA)、WAF 和频率限制响应保留为明确的停止条件;不要自动化破解,也不要绕过网站的访问控制。
想看更深入的威胁模型,可以读我们的browser-agent security checklist。它覆盖了提示词注入、凭证边界、审批关卡,以及在 Agent 能触达重要账号之前就该准备好的 kill switch。
如何自动化那些经常改版的网站?
使用分层契约。尽可能让导航和高风险操作保持确定性,优先使用可访问名称和稳定的 data 属性,而不是坐标,把 AI 观察留给真正不确定的边缘情况。每次提取之后,都要断言 URL、记录条数、必填字段,以及源页面的校验和或可见标签。契约失败时,保存页面证据并停下来修复,不要让 Agent 去猜。
自愈选择器可以减少维护工作,但它们不能证明字段的含义没有变。网站发版后跑一个小型金丝雀任务,锁定包版本,并保留一条回退路径。面对经常变化的网站,正确的做法是可观测的恢复,而不是无上限的重试循环。
如何避免 AI 提取返回错误的数字?
先校验结构,再校验语义。要求返回的行数符合预期,数值在合理范围内,单位、排名或日期顺序正确,并且能引用到具体的源元素。对于价格,要对比货币和商品标识;对于排名,要对比页面上可见的名次;对于计数,无法明确解析的格式化文本一律拒绝。任何一项不变量校验失败,就返回带证据的错误,而不是给出一个看起来合理的数字。
9 月的案例测试写入操作,没有测试 AI 提取。故障注入显示了一个相似的问题:HTTP 200 响应和即时 Ready 状态看起来都有效,但保存的记录仍是 Draft。重新加载并核对独立服务端事件才发现问题。此次没有运行 Stagehand extract 或 Browser Use Agent,因此不能从这些运行推断 AI 提取准确率。
本地 AI 模型能稳定跑起来吗?
9 月的运行无法给出实测答案。测试 shell 中没有 Ollama 程序或模型服务 key,因此我们只测试了浏览器接口。如需评估本地模型,必须固定确切版本、量化方式、上下文长度、浏览器、超时、Prompt 和任务评分规则。保留全部失败,并对照源页面或服务端状态验证每个输出。
一个可执行的测试方法是把已知导航步骤写在代码中,仅让模型处理不确定的步骤。记录输入和输出 token、响应时间、重试、错误及验收结果。不能把确定性的 BrowserSession 或 localBrowser 运行称为 AI Agent 试验。模型决策需要独立的运行 ID 和独立的判定依据。
非专家如何自动化一个烦人的任务?
从一个只读、且有明确终点的任务开始:收集一份短列表、复制一份报告,或者把某个页面总结成一个文件。用自然语言写清起始 URL、允许访问的域名、预期输出和停止条件。在单独的浏览器配置文件(Profile)或 ego (lite) Space 中运行,先检查第一次的结果,然后再加翻页或第二个网站。
例如,一个邮件转 RAG 的工作流,应该先把每个问题提取成带编号的 JSON 数组,保留邮件主题和时间戳,并在建立索引前请求人工审核。这样一份小契约,比让 Agent 读完整個收件箱再判断哪些重要更容易调试。等只读路径可以稳定复现后,再逐个动作地加入需要人工批准的写操作。
三者各自需要什么才能运行?
可见的 API 只是安装配置的一部分。真正第一次运行要面对的,还包括语言运行时、浏览器二进制或服务、模型访问、配置文件(Profile),以及校验结果的地方。
| Product | 最低限度的实际安装配置 | 可用性检查日期:2026 年 9 月 28 日 |
|---|---|---|
| Browser Use | 本次核验的 Quickstart 使用 Python 3.12。还需安装包或 CLI、受支持的模型服务商或已配置的本地模型、浏览器配置文件,并校验结果。 | MIT 包可免费自托管;模型和浏览器基础设施另计费用;可选的 Browser Use Cloud 按用量计费 |
| Stagehand | 当前语言 SDK、兼容 ESM 的 TypeScript 配置、本地或 Browserbase 浏览器,以及受支持的模型或用于 AI 原语的客户端回调 | MIT SDK 可免费自托管;模型和浏览器费用仍需自付;Browserbase 是可选的托管生产路径 |
| ego (lite) | 桌面应用、一次性的 ego-browser skill 配置,以及一个能写代码并验证工作流、可执行 shell 的编码 Agent | macOS 下载免费;Windows 仍在等待名单中;编码 Agent 自身的套餐或 API 用量另计 |
新安装在 Python 3.12 环境中解析到 browser-use 0.13.10,在 Node 23.11 环境中解析到 Stagehand 4.1.0。Stagehand 需要先执行 Stagehand.create({ browser }),才能使用 localBrowser 上下文。在我们的测试应用中,Browser Use 的 actor Page 需要显式设置选项值,并在点击前滚动。ego-browser 0.5.2.16 在已有 Space 中运行;我们的评分脚本必须从 stderr 读取其控制台输出。这些是可复现的配置及测试脚本发现,不构成生产环境排名。
应该怎么理解会话?
Browser Use 文档介绍了真实浏览器配置文件(Profile)复用和配置文件同步。Stagehand 的本地浏览器选项暴露了 userDataDir 和配置文件保留,而 Browserbase 提供了托管的会话路径。ego (lite) 从常驻的桌面浏览器出发,把 Agent 的工作限制在独立的 Space 中。
如果你的应用需要自行创建并持有浏览器配置文件(Profile)或远程会话,就选 Browser Use 或 Stagehand。如果希望现有的编码 Agent 在一个常驻、可见的桌面浏览器上工作,并继承你真实的 Chrome 登录态,就选 ego (lite)。无论走哪条路,在接入有价值的账号之前,先明确 Agent 可以访问哪些账号、域名和操作。
关于连接模型本身,可以阅读我们的Agent 如何连接现有浏览器的指南以及browser-agent security checklist,然后再接入有价值的账号。
你应该选哪一个?
当任务是探索时,选 Browser Use
如果 Agent 需要探索一条不熟悉的路径、适应不断变化的页面,并决定下一步做什么,Browser Use 提供了正确的高层抽象。要为能力足够的模型、追踪、超时、重试和独立校验器预留预算。需要确定性的逃生通道时,仍然可以直接调用浏览器 API。
当工作流属于代码时,选 Stagehand
如果浏览器工作流由工程团队负责,稳定的路径就应该留在代码和测试里。只对可变的部分调用 extract 或 act,然后把输出与源页面的不变量做校验。当 Browserbase 已经契合你的部署模型时,Stagehand 尤其有吸引力,不过它也支持本地浏览器执行。
当编码 Agent 需要自己的常驻浏览器时,选 ego (lite)
如果 Codex、Claude Code 或其他具备 shell 能力的 Agent 已经在做规划和写代码,再引入第二个浏览器自动化框架就有些多余。ego (lite) 补上的正是缺失的那一环:一个免费的完整 Chromium,由你的编码 Agent 驱动,直接操作真实网站。
当任务完全确定时,选择 Playwright
如果 DOM 和路由都是已知的,那么既不需要完整的 Agent 循环,也不需要 AI 提取。更低层的自动化库更容易测试,推理成本也更低。我们的Browser Use 与 Playwright 对比一文直接讨论了这条边界。
真正的限制有哪些?
Browser Use
这个框架提供自主 Agent,但在没有模型服务时,我们没有运行这条路线。在当前 BrowserSession 案例中,缺少显式 value 的选项并未在 select_option 返回后改变;保存点击也没有写入,直到我们先显式滚动。修正后的浏览器层路线完成了固定任务,但不能据此验证自主 Agent 的表现。
Stagehand
Stagehand 是开发者 SDK。你仍需设计流程、为 AI 能力配置模型,并建立结果检查。它的 localBrowser 路线完成了固定任务,但早期有一次因脚本未等待异步 UI 状态而失败。9 月案例没有测试 extract 的语义。
ego (lite)
当具备 shell 能力的编码 Agent 需要持久化的浏览器状态、隔离的任务 Space(隔离空间),以及在 macOS 上可让人接管的可视化路径时,ego (lite) 最为合适。它把规划留在编码 Agent 里,把浏览器执行放在专门的桌面环境中。如果你要做无人值守的 CI、独立的自主导航,或者服务器端的浏览器集群,请先对比无头浏览器与真实浏览器的取舍,并选择为这种运行方式设计的基础设施。最初的评分脚本因 ego 控制台输出写入 stderr 而误判;保留的原始记录和复核脚本纠正的是我们的测试脚本错误,不是产品故障。
常见问题
Stagehand 是基于 Playwright 构建的吗?
不是。当前 Stagehand v4 文档描述的是带有熟悉浏览器 API、基于 CDP 运行时的 Agent SDK。我们安装的 4.1.0 localBrowser 路线使用 Stagehand 自身的浏览器接口,不是 Playwright Test 运行器。
不依赖 Browserbase 也能用 Stagehand 吗?
可以。Stagehand v4 既提供 localBrowser 路径,也提供 Browserbase 的 launch 和 connect 路径。本次测试我们用的就是 localBrowser。当托管会话、代理、可观测性,或者生产级浏览器基础设施与你的部署需求匹配时,Browserbase 才有意义。
Stagehand 与 Browser Use:做网页抓取哪个更好?
对于已知网站和固定字段,Stagehand 这种确定性优先的形态通常更容易校验。对于未知网站、连路径本身都需要探索的场景,Browser Use 的自主循环是更好的起点。如果数据源位于一个持久化的个人浏览器中,而且编码 Agent 已经接管了任务,那么 ego (lite) 是第三种架构,而不是可以直接替换的 SDK 替代品。
三者都能保持登录态吗?
三者都提供了会话策略,但归属模型不同。Browser Use 可以复用或同步浏览器配置文件(Profile)。Stagehand 可以保留本地用户数据目录,也可以使用 Browserbase 的托管会话。ego (lite) 则围绕持久化浏览器状态和隔离的 Space 来设计。但这一切都不能证明它们与每个网站或账号都能自动兼容。
这次案例比较了 Browser Use Agent 和 Stagehand AI 吗?
没有。9 月案例使用 Browser Use BrowserSession、Stagehand localBrowser 和 ego-browser Space,没有共用的模型客户端。由于模型访问条件不足,Agent 与 AI 能力路线无法运行。未来若要比较 AI,需要共用任务、模型、账号状态、成功判定规则,重复运行并单独记录费用。
哪个方案最便宜?
这些软件包可以自行托管,但模型、浏览器、代理、重试和人工复核仍有费用;托管服务另行计费。2026 年 9 月 28 日,ego (lite) macOS 下载页标为免费,而编程 Agent 使用独立订阅或 API 费用。此次没有测量模型 token 或实际账单,不能据此给总成本排名。
它们中有能稳定绕过验证码(CAPTCHA)的吗?
不要因为任何“通用绕过”的宣传而选择这三者中的任何一个。Browser Use Cloud 和浏览器基础设施厂商提供与验证码(CAPTCHA)相关的服务,持久化的浏览器配置文件(Profile)也能减少一些重复验证,但网站行为会变化,反机器人系统本身就是对抗性的。本次实验我们没有测试验证码(CAPTCHA)处理。