मुख्य निष्कर्ष पहले: ब्राउज़र MCP सर्वर के लिए, टूल परिभाषाएँ छोटी करने से अक्सर उतना फ़ायदा नहीं होता जितना पेज रिस्पॉन्स छोटा करने से होता है, क्योंकि स्नैपशॉट स्कीमा से कहीं बड़े हो सकते हैं। असली बचत एग्ज़िक्यूशन मॉडल बदलने से आ सकती है: एक प्रकाशित Playwright तुलना में उसके CLI और MCP सेटअप के लिए लगभग 27K बनाम 114K टोकन बताए गए, जबकि प्रोसेस से बाहर चलने वाली स्क्रिप्ट चुने हुए पेज डेटा को मॉडल कॉन्टेक्स्ट से बाहर रख सकती हैं।
बचत इसी प्रोसेस-से-बाहर वाले रूट से आती है। हमारे प्रकाशित बेंचमार्क में डॉक्युमेंट किए गए heredoc पैटर्न ने परीक्षण किए गए ब्राउज़र कार्य एक-एक कमांड चलाने की तुलना में 44% कम एग्ज़िक्यूशन राउंड में और 21.6% कम लागत पर पूरे किए।
यहाँ एक आँकड़ा है जो समस्या को नया नज़रिया देता है: Playwright MCP से लिए गए एक डैशबोर्ड पेज स्नैपशॉट का माप ~12,000 टोकन निकला, और एक Salesforce पेज के लिए 114K. उसी सर्वर के पूरे टूल-स्कीमा ओवरहेड की रिपोर्ट ~4,200 टोकन थी। स्कीमा ऑप्टिमाइज़ेशन फ़िक्स्ड लागत में मदद कर सकता है, पर हर कदम का पेज पेलोड नहीं हटाता।
तो यह सूची ईमानदारी से क्रम में है: दो तरीके फ़िक्स्ड लागत के लिए, दो रिस्पॉन्स पेलोड के लिए, और दो जो असल में ग्राफ़ की दिशा बदलते हैं। हर एक के साथ आँकड़े और वे स्थितियाँ हैं जहाँ वह लागू होता है।
MCP टोकन खपत असल में कहाँ से आती है?
तीन बकेट, और यह जानना कि आपके सेटअप में कौन सा हावी है, तय करता है कि कौन सा तरीका फ़ायदेमंद होगा।
फ़िक्स्ड लागत: हर रजिस्टर्ड सर्वर सेशन शुरू होते ही अपने टूल स्कीमा कॉन्टेक्स्ट में लोड करता है, चाहे वे इस्तेमाल हों या नहीं। Speakeasy की इंजीनियरिंग टीम ने मापा कि स्टैटिक टूलसेट के लिए कुल टोकन उपयोग का 60-80% इनपुट स्कीमा था, और यह कोई भी काम शुरू होने से पहले।
हर कदम की लागत: हर टूल रिस्पॉन्स कॉन्टेक्स्ट में पहुँचता है। सर्च या डेटाबेस MCP में यह नतीजों का पेलोड होता है; ब्राउज़र MCP में यह पेज स्नैपशॉट होते हैं, जो उस पेज की जटिलता के साथ बढ़ते हैं जो आपके नियंत्रण में नहीं है।
जमाव: बातचीत हर पुराना रिस्पॉन्स रखती है। एक मापे गए Playwright MCP सेशन में कदम 12-15 तक 60-90K टोकन के ज़्यादातर पुराने स्नैपशॉट जमा हो चुके थे, और वह ऐसे एलिमेंट्स का ज़िक्र करने लगा जो अब मौजूद ही नहीं थे।
पहले निदान करें, फिर अपना तरीका चुनें।
तरीका 1: कम टूल रजिस्टर करें
कैसे: अपने MCP कॉन्फ़िग का ऑडिट करें और इस हफ़्ते इस्तेमाल न होने वाले सर्वर हटाएँ; capability फ़्लैग वाले सर्वर के लिए सिर्फ़ ज़रूरी समूह लोड करें (Playwright MCP का --caps फ़्लैग vision, pdf और devtools टूल को opt-in के पीछे रखता है)।
आँकड़े: अकेले Playwright MCP के 26+ टूल में ~4,200 टोकन के स्कीमा बताए गए; कई सर्वर वाला सेटअप फ़िक्स्ड ओवरहेड को कई गुना कर सकता है। बिना इस्तेमाल वाले सर्वर हटाने से कॉन्टेक्स्ट बचता है, पर जाँच लें कि कोई ज़रूरी वर्कफ़्लो या सेफ़्टी चेक न चला जाए।
कब लागू होता है: जब आपका सेशन ऐसे टूल के साथ शुरू हो जिनकी ज़रूरत नहीं। यह आम तौर पर कम जोखिम वाला है, पर वापस लौटने का रास्ता लिखित रखें और कॉन्फ़िग बदलने के बाद ज़रूरी वर्कफ़्लो दोबारा जाँचें।
तरीका 2: स्कीमा हल्के करें (या उन्हें लेज़ी लोड करें)
कैसे: जो सर्वर आप बनाते हैं उनमें विवरण छोटे करें, दोहराई गई enum लिस्टिंग हटाएँ और नेस्टेड पैरामीटर ऑब्जेक्ट फ्लैट करें। बड़ा रूप है डायनैमिक टूलसेट: तीन मेटा-टूल (search_tools, describe_tools, execute_tool) उजागर करें ताकि पूरे स्कीमा सिर्फ़ उन टूल के लिए लोड हों जिन्हें मॉडल असल में इस्तेमाल करने की योजना बनाता है।
आँकड़े: Speakeasy ने 40 से 400 टूल वाले टूलसेट पर डायनैमिक तरीके का बेंचमार्क किया और 160x तक टोकन कमी बताई, जिसमें सरल कामों पर इनपुट टोकन 96.7% और जटिल कामों पर 91.2% घटे। इन आँकड़ों को अध्ययन-विशेष मानें: उसी बेंचमार्क में 2-3x ज़्यादा टूल कॉल और लगभग 50% धीमे रन बताए गए।
कब लागू होता है: जब आप बड़े टूलसेट चलाते हैं (दर्जनों सर्वर या सैकड़ों API ऑपरेशन)। अगर आपकी समस्या एक ब्राउज़र सर्वर के स्नैपशॉट हैं, तो यह तरीका लगभग कुछ नहीं बदलता।
तरीका 3: रिस्पॉन्स में क्या लौटे, यह फ़िल्टर करें
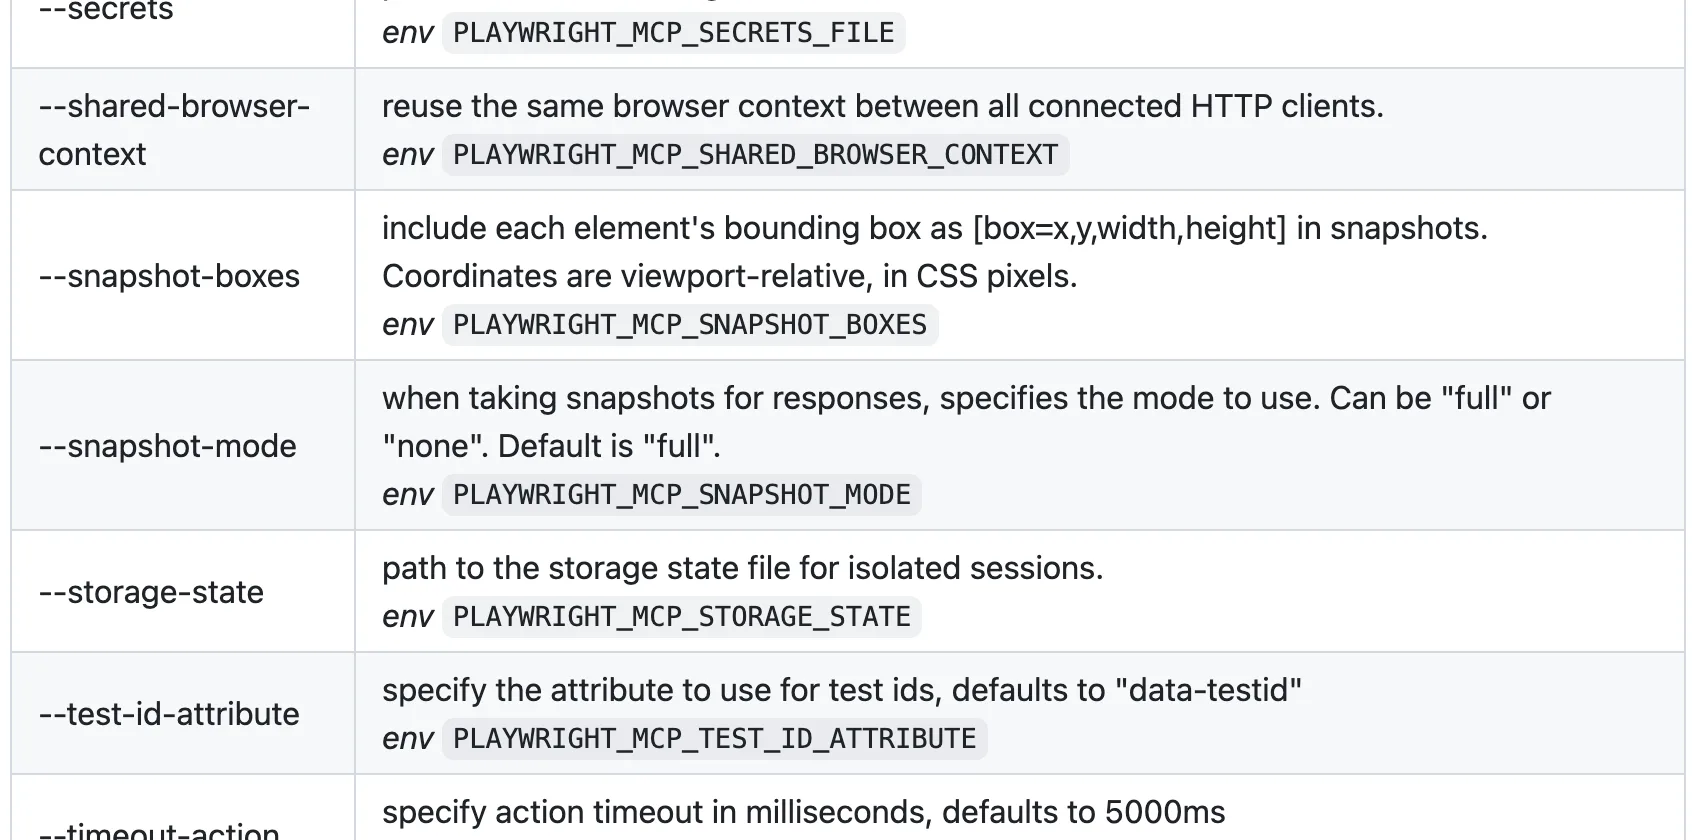
कैसे: सर्वर के पहले से मौजूद रिस्पॉन्स-शेपिंग विकल्प इस्तेमाल करें। Playwright MCP: filename पैरामीटर console logs, network dumps और snapshots को कॉन्टेक्स्ट के बजाय डिस्क पर लिखता है (एजेंट वही वापस पढ़ता है जो उसे चाहिए); browser_network_requests डिफ़ॉल्ट रूप से static assets छोड़ देता है और एक filter regexp लेता है; --image-responses omit इमेज पेलोड हटा देता है; --console-level लॉग की मात्रा सीमित करता है।
आँकड़े: बड़े पेलोड वाले सेशन में एक network dump छोटे क्रमांकित सारांश से लेकर हज़ारों टोकन तक हो सकता है, जब पूरे headers और bodies inline लौटाए जाएँ। डिस्क पर लिखकर चुन-चुन कर पढ़ने का पैटर्न ही वजह है कि तरीका 5 का CLI रूट लंबे वर्कफ़्लो में भी लगभग स्थिर रह पाता है।
कब लागू होता है: जब आपके ट्रांसक्रिप्ट में ऐसे बड़े रिस्पॉन्स पेलोड दिखें जो आपने माँगे नहीं थे। दस मिनट के फ़्लैग, वर्कफ़्लो में कोई बदलाव नहीं।
तरीका 4: ब्राउज़र स्नैपशॉट छोटे करें
कैसे: हर रिस्पॉन्स के साथ पूरा accessibility tree जोड़ना बंद करें। Playwright MCP का --snapshot-mode none स्नैपशॉट को सिर्फ़ माँगे जाने पर लाया जाता है; browser_find पूरा tree कैप्चर किए बिना एक एलिमेंट ढूँढता है (डॉक्स के मुताबिक पूरे स्नैपशॉट से सस्ता); --output-max-size टूल रिस्पॉन्स के आकार पर सख़्त सीमा लगाता है और बड़ा आउटपुट रिस्पॉन्स के बाद डिस्क पर भेजता है (v0.0.76 में जोड़ा गया); और --mobile हल्के पेज माँगता है।
आँकड़े: उद्धृत मापों में प्रति action एक लॉगिन फ़ॉर्म के लिए लगभग 3,800 टोकन और डैशबोर्ड के लिए 12,000 टोकन बताए गए; असली आउटपुट पेज और कॉन्फ़िगरेशन के हिसाब से बदलता है। सीमित finds और स्पष्ट स्नैपशॉट लागत को हर कदम से घटाकर सिर्फ़ उन कदमों तक लाते हैं जिन्हें दिशा तय करनी होती है, और कुछ मल्टी-स्टेप टेस्ट में 3-5x कमी बताई गई।
हमने उद्योग के आँकड़ों को यूँ ही मानने के बजाय ख़ुद चलाया: एक असली Chrome DevTools MCP सेशन, एक take_snapshot कॉल, एक मध्यम सरल पेज पर।
import asyncio
from mcp import ClientSession, StdioServerParameters
from mcp.client.stdio import stdio_client

async def main():
    params = StdioServerParameters(
        command="npx",
        args=["--yes", "chrome-devtools-mcp@latest", "--headless", "--isolated"],
    )
    async with stdio_client(params) as (read, write):
        async with ClientSession(read, write) as session:
            await session.initialize()
            nav = await session.call_tool("navigate_page", {"url": "https://news.ycombinator.com/"})
            print("navigate_page chars:", len("".join(c.text for c in nav.content if hasattr(c, "text"))))

            snap = await session.call_tool("take_snapshot", {})
            snap_text = "".join(c.text for c in snap.content if hasattr(c, "text"))
            print("take_snapshot chars:", len(snap_text))
            print(snap_text[:700])

# Real output
navigate_page chars: 123
take_snapshot chars: 38285
## Latest page snapshot
uid=1_0 RootWebArea "Hacker News" url="https://news.ycombinator.com/"
  uid=1_1 link url="https://news.ycombinator.com/"
  uid=1_2 link "Hacker News" url="https://news.ycombinator.com/news"
    uid=1_3 StaticText "Hacker News"
  uid=1_4 link "new" url="https://news.ycombinator.com/newest"
    uid=1_5 StaticText "new"
  uid=1_6 StaticText " | "
  uid=1_7 link "past" url="https://news.ycombinator.com/front"
    uid=1_8 StaticText "past"
  uid=1_9 StaticText " | "
  uid=1_10 link "comments" url="https://news.ycombinator.com/newcomments"
    uid=1_11 StaticText "comments"
  uid=1_12 StaticText " | "
  uid=1_13 link "ask" url="https://news.ycombinator.com/ask"
...
38,285 अक्षर, लगभग 9-10K टोकन, उस पेज के एक स्नैपशॉट के लिए जो ऊपर बताए गए लॉगिन फ़ॉर्म और डैशबोर्ड से सरल है। यह एक उपयोगी संदर्भ बिंदु है, पर पेज का आकार बदलता रहता है और उद्धृत आँकड़ों में हर साइट के लिए दोहराने योग्य ट्रेस शामिल नहीं है।
कब लागू होता है: जब आप ब्राउज़र MCP पर बने रहें और तकलीफ़ हर कदम की लागत हो। यह सबसे मज़बूत सिर्फ़-कॉन्फ़िग तरीका है, और इसकी सीमा संरचनात्मक है: पेज की स्थिति फिर भी कॉन्टेक्स्ट से होकर जाती है, इसलिए लंबे कामों में जमाव होता रहता है।
तरीका 5: CLI रूट अपनाएँ
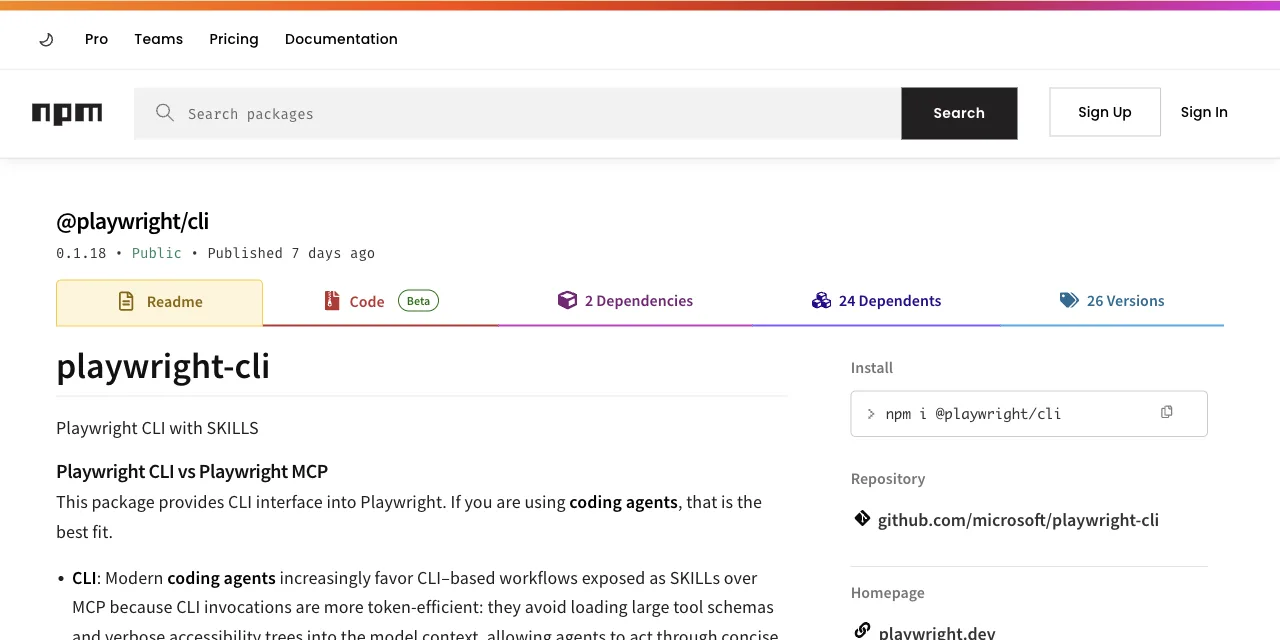
कैसे: टूल कॉल की जगह shell कमांड चलाएँ। Microsoft का आधिकारिक Playwright CLI स्नैपशॉट को डिस्क पर YAML में लिखता है और फ़ाइल पाथ लौटाता है; एजेंट चुन-चुन कर पढ़ता है। अब तो Playwright MCP का README भी टोकन दक्षता के लिए coding agents को इसी रास्ते की ओर इशारा करता है.
आँकड़े: एक प्रकाशित तुलना में MCP पर हर टेस्ट 114K टोकन बनाम CLI पर 27K (लगभग 4x) बताए गए, उसके काम और कॉन्फ़िगरेशन के लिए। उस तुलना में स्कीमा ओवरहेड ~4,200 टोकन से घटकर ~68 रह गया (एक --help पढ़ना)। एक स्वतंत्र 8-चरणीय टेस्ट ने वही आकार मापा: ~89K बनाम ~24K।
कब लागू होता है: जब आपका एजेंट कोड लिख सकता हो और shell कमांड चला सकता हो (Claude Code, Cursor, Codex)। यही शर्त है। हमने इस रूट को Playwright MCP vs CLI तुलना में विस्तार से मापा।
तरीका 6: एग्ज़िक्यूशन को प्रोसेस से बाहर ले जाएँ
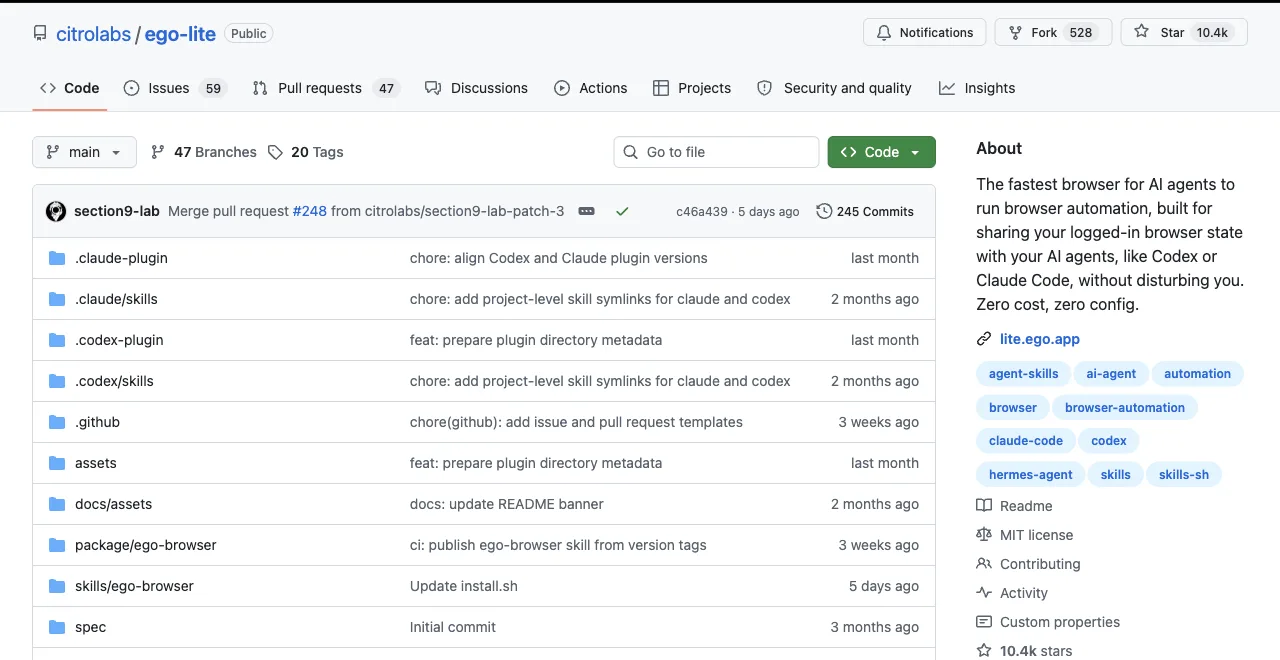
कैसे: हर action के लिए एक कमांड के बजाय एजेंट पूरे वर्कफ़्लो का बयान करने वाला एक छोटा प्रोग्राम लिखता है और उसे heredoc के रूप में लोकल रनटाइम में पाइप करता है। लूप, इंतज़ार और extraction मॉडल के बाहर चलते हैं; कोई वर्कफ़्लो सिर्फ़ चुने हुए अंतिम फ़ील्ड लौटा सकता है, जिससे ज़्यादातर पेज डेटा कॉन्टेक्स्ट से बाहर रहता है।
आँकड़े: इस पैटर्न के हमारे प्रकाशित बेंचमार्क में heredoc एग्ज़िक्यूशन ने वही ब्राउज़र कार्य 44% कम एग्ज़िक्यूशन राउंड में, 35.5% कम टूल कॉल के साथ, और एक-एक कमांड चलाने की तुलना में 21.6% कम लागत पर पूरे किए।
कब लागू होता है: जब आप रोज़ ब्राउज़र कार्य चलाते हैं और काम को चरणों में बाँटा जा सकता है। यहीं ego (lite) टोकन का गणित बदलता है: पेज एजेंट तक raw HTML के बजाय एक Snapshot के रूप में पहुँचता है, यानी स्थिर @N रेफ़्स वाला accessibility tree, और एजेंट एक-एक टूल कॉल के बजाय एक ही पेज-साइड JavaScript कॉल में कई action चला सकता है, इसलिए बचत पूरे काम पर गिनी जाती है, किसी एक कदम पर नहीं।
ऊपर के heredoc आँकड़े एग्ज़िक्यूशन पैटर्न को अलग से मापते हैं। पूरे टूल का अलग माप है: Real-World Bench के पाँच टूल में, लाइव प्रोडक्शन साइटों पर एक ही मॉडल और जज के साथ 31-टास्क बेंचमार्क में, ego (lite) ने 31 में से 93.5% टास्क पूरी तरह पूरे किए, हर पूरे किए टास्क पर $1.75 की लागत से, और ट्रैक किए गए सभी छह मीट्रिक में पाँच में से पहले रहे; रन, रूब्रिक और डेटासेट सबके लिए सार्वजनिक हैं ego-browser-benchmark-framework रिपॉज़िटरी.
यह असल में ऐसा दिखता है: ऊपर के take_snapshot उदाहरण में इस्तेमाल हुए उसी Hacker News पेज पर रिकॉर्ड किया गया ego-browser सेशन। JavaScript heredoc के रूप में जाता है, और सिर्फ़ काम के फ़ील्ड लौटकर आते हैं।
ego-browser nodejs <<'EOF'
const task = await egoBrowser.newTaskSpace('evidence-egobrowser-hn')
console.log({ taskSpaceId: task.id })

await task.page.goto('https://news.ycombinator.com/', { waitUntil: 'load', timeout: 20000 })
const title = await task.page.title()
const topStory = await task.page.locator('.athing .titleline > a').first().innerText()
const points = await task.page.locator('.subtext .score').first().innerText().catch(() => null)
console.log({ title, url: task.page.url(), topStory, points })
EOF

# Real output
{
  "taskSpaceId": 13
}
{
  "title": "Hacker News",
  "url": "https://news.ycombinator.com/",
  "topStory": "Qwen 3.8 27B",
  "points": "412 points"
}
एजेंट तक लौटकर लगभग 150 अक्षर आए, जबकि ऊपर के take_snapshot उदाहरण में उसी पेज के accessibility tree के 38,285। यही अंतर, न कि इस सूची के पहले वाले स्कीमा-ट्रिमिंग तरीके, ब्राउज़र के काम का टोकन बिल असल में हिलाता है।
ऊपर का कोड खुले ego-lite रिपॉज़िटरी पर चलता है, किसी ब्लैक बॉक्स पर नहीं; अगर आप किसी काम को इसके अंदर भेजने से पहले देखना चाहते हैं कि heredoc रनटाइम असल में क्या कर रहा है, तो ego-browser स्किल का सोर्स ख़ुद पढ़ें।
GitHubHTML और वेब-कंटेंट टोकन घटाएँ
HTML टोकन घटाने का सबसे तेज़ तरीका है कि कंटेंट मॉडल कॉन्टेक्स्ट में पहुँचने से पहले सिर्फ़ वही फ़ील्ड निकालें जो काम को चाहिए। scripts, styles, navigation और बार-बार दोहराए गए accessibility nodes लौटाने के बजाय Readability-शैली का article extractor, ज़रूरी कंटेनर तक सीमित selector, या typed response schema इस्तेमाल करें।
- title, URL, timestamp और माँगे गए फ़ील्ड लौटाएँ; सूची की पंक्तियाँ, टेक्स्ट लंबाई, DOM गहराई और screenshot के आयाम सीमित रखें।
- पूरे पेज के स्नैपशॉट के बजाय locator के नतीजे या सीमित subtree को प्राथमिकता दें, और बड़ी टेबल को पेजों में बाँटें।
- मूल URL और raw-response pointer या content hash रखें ताकि संपीड़ित नतीजा ऑडिट करने योग्य रहे।
संपीड़न कॉन्टेक्स्ट का ऑप्टिमाइज़ेशन है, अर्थ की पूर्णता या सुरक्षा की गारंटी नहीं। फ़ैसले को प्रभावित करने वाले labels, links, structured data और आस-पास के साक्ष्य बनाए रखें; extraction पर भरोसा कम हो तो raw पेज पर लौट जाएँ।
लंबी बातचीत और एजेंट मेमोरी संभालें
लंबे चलने वाले एजेंट को टिकाऊ स्थिति चैट ट्रांसक्रिप्ट के बाहर रखनी चाहिए। पूरे हुए काम को छोटे checkpoint में सारांशित करें, बड़े artifacts डिस्क पर रखें, और हर टूल रिस्पॉन्स दोबारा चलाने के बजाय अगले action के लिए ज़रूरी तथ्य ही दोबारा लोड करें।
- एक रोलिंग सारांश रखें जिसमें लक्ष्य, फ़ैसले, मौजूदा URL, authenticated प्रोफ़ाइल, बाक़ी actions और ज्ञात failure modes हों।
- raw HTML, screenshots, traces और logs को path या hash से संदर्भित artifacts के रूप में रखें; उन्हें हर टर्न में वापस पेस्ट न करें।
- जब ट्रांसक्रिप्ट ज़्यादातर पुरानी हिस्ट्री बन जाए तो किसी checkpoint पर नया सेशन शुरू करें, और डेटा बदलने से पहले checkpoint जाँचें।
हमेशा चलने वाले ऑपरेशन के लिए बजट फिर भी चाहिए। प्रति घंटा और प्रति पूरा टास्क टोकन ट्रैक करें, मेमोरी के लिए retention सीमाएँ तय करें, और एजेंट से कहें कि उसने कौन-सा जमा साक्ष्य लोड किया, यह बताए।
टूल स्कीमा और MCP कॉन्फ़िगरेशन ऑप्टिमाइज़ करें
टूल स्कीमा फ़िक्स्ड ओवरहेड हैं, इसलिए कम और साफ़ ऑपरेशन उजागर करें। बिना इस्तेमाल वाले सर्वर हटाएँ, वैकल्पिक capabilities को gate करें, दोहराए गए विवरण छोटे करें, और जब किसी सर्वर में दर्जनों या सैकड़ों टूल हों तो lazy discovery या semantic router इस्तेमाल करें।
- सेशन की शुरुआत में और हर कॉन्फ़िगरेशन बदलाव के बाद स्कीमा टोकन मापें; यह न मानें कि छोटी JSON फ़ाइल ज़रूरी constraints छिपा दे तो भी सुरक्षित है।
- पैरामीटर नाम और enum मान भरोसेमंद कॉल के लिए इतने स्पष्ट रखें कि काम चले; ज़्यादा संपीड़न retries बढ़ा सकता है और जितना बचाता है उससे ज़्यादा महँगा पड़ सकता है।
- विशेष ब्राउज़र, डेटाबेस या GitHub टूल सिर्फ़ उसी काम के लिए लोड करें जिसे वे चाहिए, फिर अगले सेशन के लिए उन्हें बंद कर दें।
डायनैमिक टूलसेट स्कीमा-भारी कॉन्टेक्स्ट को नाटकीय रूप से घटा सकते हैं, पर वे discovery कॉल और लेटेंसी जोड़ते हैं। कुल टोकन, टूल कॉल, सफलता दर और wall-clock समय को साथ मिलाकर आँकें।
कोडिंग एजेंट में टोकन की बर्बादी घटाएँ
कोडिंग एजेंट तब टोकन बर्बाद करते हैं जब वे बिना बदले फ़ाइलें दोबारा पढ़ते हैं, किसी स्थानीय सवाल के लिए पूरी रिपॉज़िटरी खोजते हैं, या लंबा कमांड आउटपुट स्ट्रीम करते हैं। एजेंट को सीमित फ़ाइल दायरा दें और टूल से पहले सारांश, गिनती और फेल होने वाली पंक्तियाँ लौटाने को कहें।
- स्पष्ट path और pattern के साथ ripgrep इस्तेमाल करें, फिर पूरी फ़ाइलें उगलने के बजाय हर मैच के आस-पास की छोटी पंक्ति-सीमा खोलें।
- build और test logs किसी फ़ाइल में भेजें; exit code और पहली काम की errors लौटाएँ, साथ में पूरे artifact का लिंक।
- एक edit के बाद पूरे suite से पहले सबसे छोटा ज़रूरी टेस्ट चलाएँ, और जो पहले ही जाँचा जा चुका है उसे दर्ज करें ताकि एजेंट उसे दोहराए नहीं।
- नियत formatting, migrations और दोहराए जाने वाले edits के लिए scripts इस्तेमाल करें; मॉडल के टर्न चुनाव और समीक्षा के लिए बचाएँ।
लक्ष्य कम अनुपयोगी टोकन हैं, कम जाँचें नहीं। सही सुधार तक ले जाने वाली संक्षिप्त failure report उस छोटे पर अस्पष्ट जवाब से सस्ती है जो कई retries करा दे।
बेकाबू खर्च और टूल-कॉल लूप रोकें
हर autonomous लूप के चारों ओर सख़्त सीमाएँ लगाएँ: अधिकतम actions, बीता समय, input और output टोकन, retries और खर्च। बजट पूरा होने पर diagnostic record के साथ रोकें; किसी एजेंट को चुपचाप तब तक चलते न रहने दें जब तक API allowance या margin ख़त्म न हो जाए।
- navigation, extraction और writes के बाद progress जाँच ज़रूरी रखें; जब URL, स्थिति या लौटा डेटा बिना बदलाव दोहराए तो रोक दें।
- exponential backoff सिर्फ़ अस्थायी विफलताओं के लिए, अधिकतम retry गिनती के साथ इस्तेमाल करें। 401/403, consent और CAPTCHA पेजों को समीक्षा माँगने वाली स्थितियाँ मानें, retry का ईंधन नहीं।
- प्रोवाइडर-साइड खर्च अलर्ट और प्रति-रन कोटा सेट करें, और मॉडल, prompt, completion, टूल, ब्राउज़र तथा recovery की लागतें अलग-अलग लॉग करें।
- writes को operation key या checkpoint के साथ idempotent बनाएँ ताकि retry से कोई order, message या record दोहरा न हो।
ticket triage या निर्धारित कामों के लिए कम जोखिम वाले आइटम नमूने में लें और अनिश्चित मामले इंसान तक भेजें। लागत नियंत्रण fail closed होने चाहिए, साथ में यह पता चले कि लूप क्यों रुका, इतना साक्ष्य बचा रहे।
स्ट्रक्चर्ड JSON बनाम नेचुरल लैंग्वेज: किफ़ायती रिपोर्ट बनाएँ
स्ट्रक्चर्ड डेटा तब टोकन बचाता है जब वह सवाल से मेल खाए। लंबे JSON wrappers या बार-बार दोहराए गए natural-language labels के बजाय सिर्फ़ ज़रूरी फ़ील्ड, स्थिर IDs, units और null handling वाला compact schema भेजें।
{ "id": "sku-42", "price": 19.99, "currency": "USD", "checkedAt": "2026-08-30T00:00:00Z" }- मॉडल तुलना करने से पहले dates, currencies और numbers सामान्य करें; हर record के साथ provenance रखें।
- किसी टेम्पलेट से HTML या PDF रिपोर्ट बनाएँ और मॉडल को पूरा रेंडर किया दस्तावेज़ नहीं, समेकित तथ्य भेजें।
- रिपोर्ट लिखने या आगे भेजने से पहले ज़रूरी फ़ील्ड, row counts, ranges और duplicate IDs जाँचें।
compact रिपोर्ट तभी भरोसेमंद है जब उसका स्रोत और validation स्थिति दिखे। raw dataset का लिंक और schema version रखें ताकि पाठक सारांश दोहरा सकें या उस पर सवाल उठा सकें।
MCP सर्वर बेस्ट प्रैक्टिस: शुरुआत किस तरीके से करें?
इस क्रम में कि आप ब्राउज़र कार्य कितनी बार चलाते हैं, क्योंकि आवृत्ति तय करती है कि कॉन्फ़िग की छोटी-मोटी बदलाव काफ़ी हैं या नहीं।
| आपका उपयोग | किससे शुरू करें | अपेक्षित बचत |
|---|---|---|
| कभी-कभार MCP उपयोग, कई सर्वर कॉन्फ़िगर | तरीके 1 + 3 (सर्वर हटाएँ, रिस्पॉन्स फ़िल्टर करें) | प्रति सेशन संभवतः हज़ारों टोकन, वर्कफ़्लो में लगभग कोई बदलाव नहीं |
| बड़े कस्टम टूलसेट (100+ ऑपरेशन) | तरीका 2 (डायनैमिक टूलसेट) | उद्धृत स्कीमा-हावी अध्ययन में 160x तक |
| हर हफ़्ते ब्राउज़र MCP, MCP पर बने रहते हुए | तरीका 4 (स्नैपशॉट ट्रिमिंग) | कुछ उद्धृत मल्टी-स्टेप टेस्ट में 3-5x |
| कोडिंग एजेंट के साथ रोज़ ब्राउज़र कार्य | तरीके 5 + 6 (CLI, फिर प्रोसेस से बाहर) | एक CLI तुलना में लगभग 4x; प्रोसेस से बाहर चलाने पर चुना हुआ पेज डेटा कॉन्टेक्स्ट से बाहर रह सकता है |
आख़िरी ईमानदार बात: तरीके 1-4 मौजूदा आर्किटेक्चर को बेहतर करते हैं, तरीके 5-6 उसे बदलते हैं। अगर आप चारों कॉन्फ़िग तरीके लगा चुके हैं और फिर भी context compaction देख रहे हैं, तो यही संकेत है कि अब फ़्लैग से आगे की ज़रूरत है।
GitHub पर मिलने वाले token-optimizer प्रोजेक्ट्स पर एक बात: ऐसे wrappers जो MCP रिस्पॉन्स को मॉडल तक पहुँचने से पहले संपीड़ित या फ़िल्टर करते हैं। ये सीमांत स्तर पर असली बचत हैं, और इनमें तरीके 3-4 की संरचनात्मक सीमा भी विरासत में आती है: रिस्पॉन्स डेटा हर कदम पर फिर भी कॉन्टेक्स्ट से होकर जाता है, बस कम। पैच के तौर पर उपयोगी, योजना के तौर पर नहीं।
और अगर कोई कहे कि टूल परिभाषाएँ ही पूरी समस्या हैं: 400-ऑपरेशन वाले API gateway के लिए यह सच है, उस ब्राउज़र सर्वर के लिए झूठ जिसका अकेला डैशबोर्ड स्नैपशॉट उसके पूरे स्कीमा ब्लॉक से तीन गुना भारी है। तरीका चुनने से पहले अपना ट्रांसक्रिप्ट मापें; दो मिनट की जाँच यह है कि एक सेशन स्क्रॉल करें और देखें कौन-से पेलोड बार-बार आते हैं।
Mac के लिए ego (lite) डाउनलोड करें किसी असली काम पर प्रोसेस-से-बाहर रूट आज़माने के लिए, या पढ़ें कि ब्राउज़र MCP के टोकन कहाँ जाते हैं, इसका पूरा विश्लेषण. लेख पढ़ने के लिए मुफ़्त है; किसी भी ऐप, मॉडल, नेटवर्क या proxy के उपयोग की लागत आपके सेटअप पर निर्भर है।