Un modello Ollama locale può guidare un browser reale, ma il modello è solo una parte della configurazione. Serve anche un agent harness capace di trasformare le tool call in azioni, un livello browser che riesca davvero a eseguirle e un contesto sufficiente a mantenere lo stato della pagina in memoria lungo più passaggi. Se una di queste parti si rompe, l'agente può continuare a rispondere normalmente mentre il browser non si muove mai.
Ci sono diversi modi per collegare questa pila. Playwright MCP espone gli strumenti del browser a un client MCP, Browser Use si collega tramite il suo wrapper Ollama ed ego (lite) abbina un modello locale a uno Space Chromium visibile tramite la skill ego-browser. Il percorso ego (lite) è utile quando vuoi che modello, sessione del browser e dati delle pagine restino sulla stessa macchina, mantenendo comunque l'esecuzione visibile e disponibile per il takeover. Qualunque percorso tu scelga, l'affidabilità delle tool call e la dimensione del contesto contano di solito più del browser stesso.
I limiti pratici emergono in fretta. Ollama può partire con una finestra di contesto di appena 4.000 token sulle macchine con meno memoria, mentre la sua documentazione consiglia almeno 64.000 token per i carichi di lavoro degli agenti. L'inferenza locale elimina la fattura per token dell'API, ma pressione sulla memoria, latenza e tentativi ripetuti determinano comunque se un'attività nel browser arriva davvero a termine. Gli esempi che seguono si basano sulla documentazione ufficiale consultata il 20 settembre 2026; questo articolo non presenta risultati di benchmark diretti da questa macchina.
Un modello Ollama locale può guidare un browser agent?
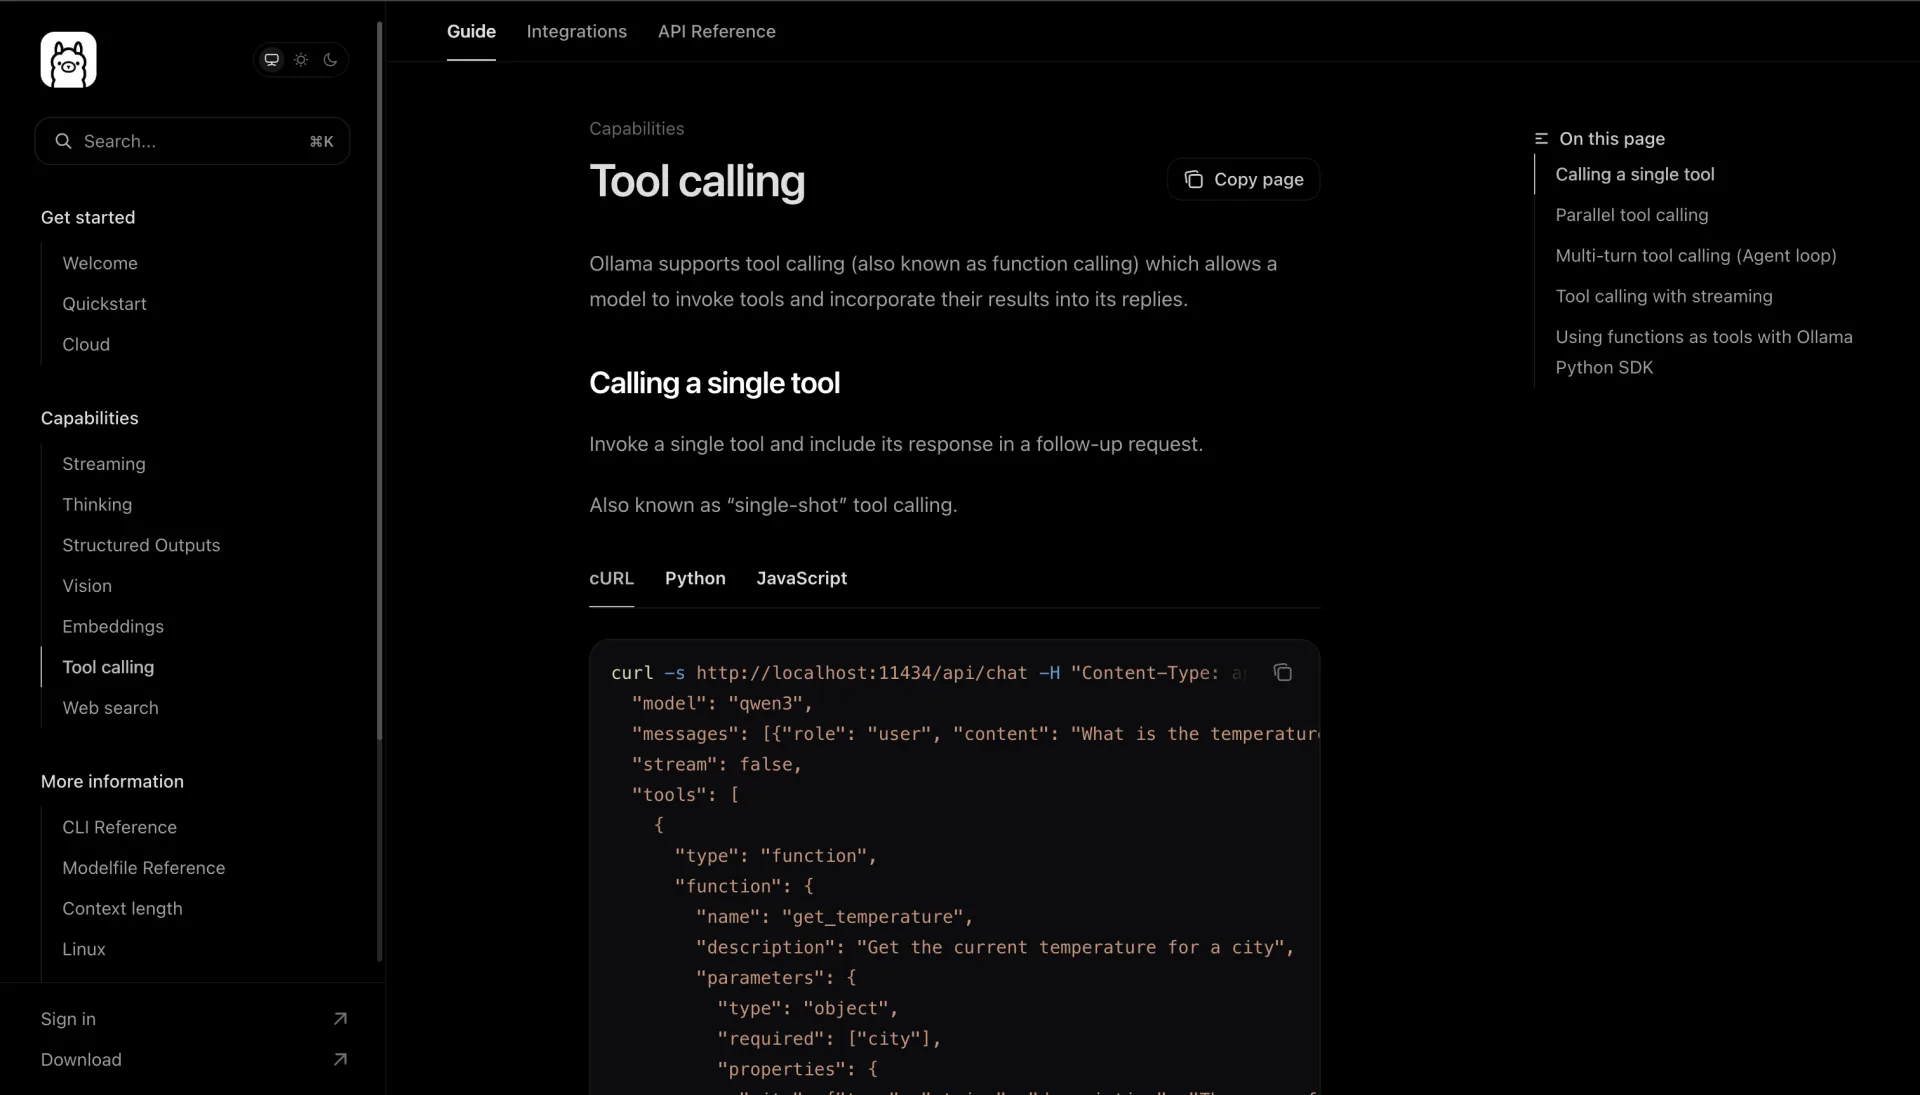
A un browser agent non serve un modello di frontiera per muovere un browser. Serve un modello che restituisca una tool call strutturata, un agent harness che trasformi quella chiamata in un'azione del browser e un contesto sufficiente a contenere lo stato della pagina che l'harness restituisce. La documentazione di Ollama mostra un ciclo completo di agente con qwen3, incluse tool call parallele e un ciclo multi-turno, e il suo esempio di ricerca web guida un agente di ricerca con il molto più piccolo qwen3:4b.
Quello che cambia con un browser reale è il volume. Una singola osservazione della pagina può arrivare a migliaia di token e un flusso di lavoro può richiedere decine di osservazioni prima di concludersi. Un modello che chiama correttamente uno strumento in una demo può fallire alla decima chiamata, dopo che il contesto si è riempito di snapshot e risultati precedenti.
Scegli il percorso di accesso prima del modello. Se una semplice richiesta HTTP o un'API ufficiale restituiscono già i dati, usali: sono più veloci, più economici e più facili da mantenere di qualsiasi browser agent. Un browser è la risposta giusta quando il flusso richiede una sessione reale, come un login che un client HTTP non riesce a completare, contenuto renderizzato dopo il caricamento, paginazione, compilazione di moduli o verifica in più passaggi che funziona solo in un browser visibile.
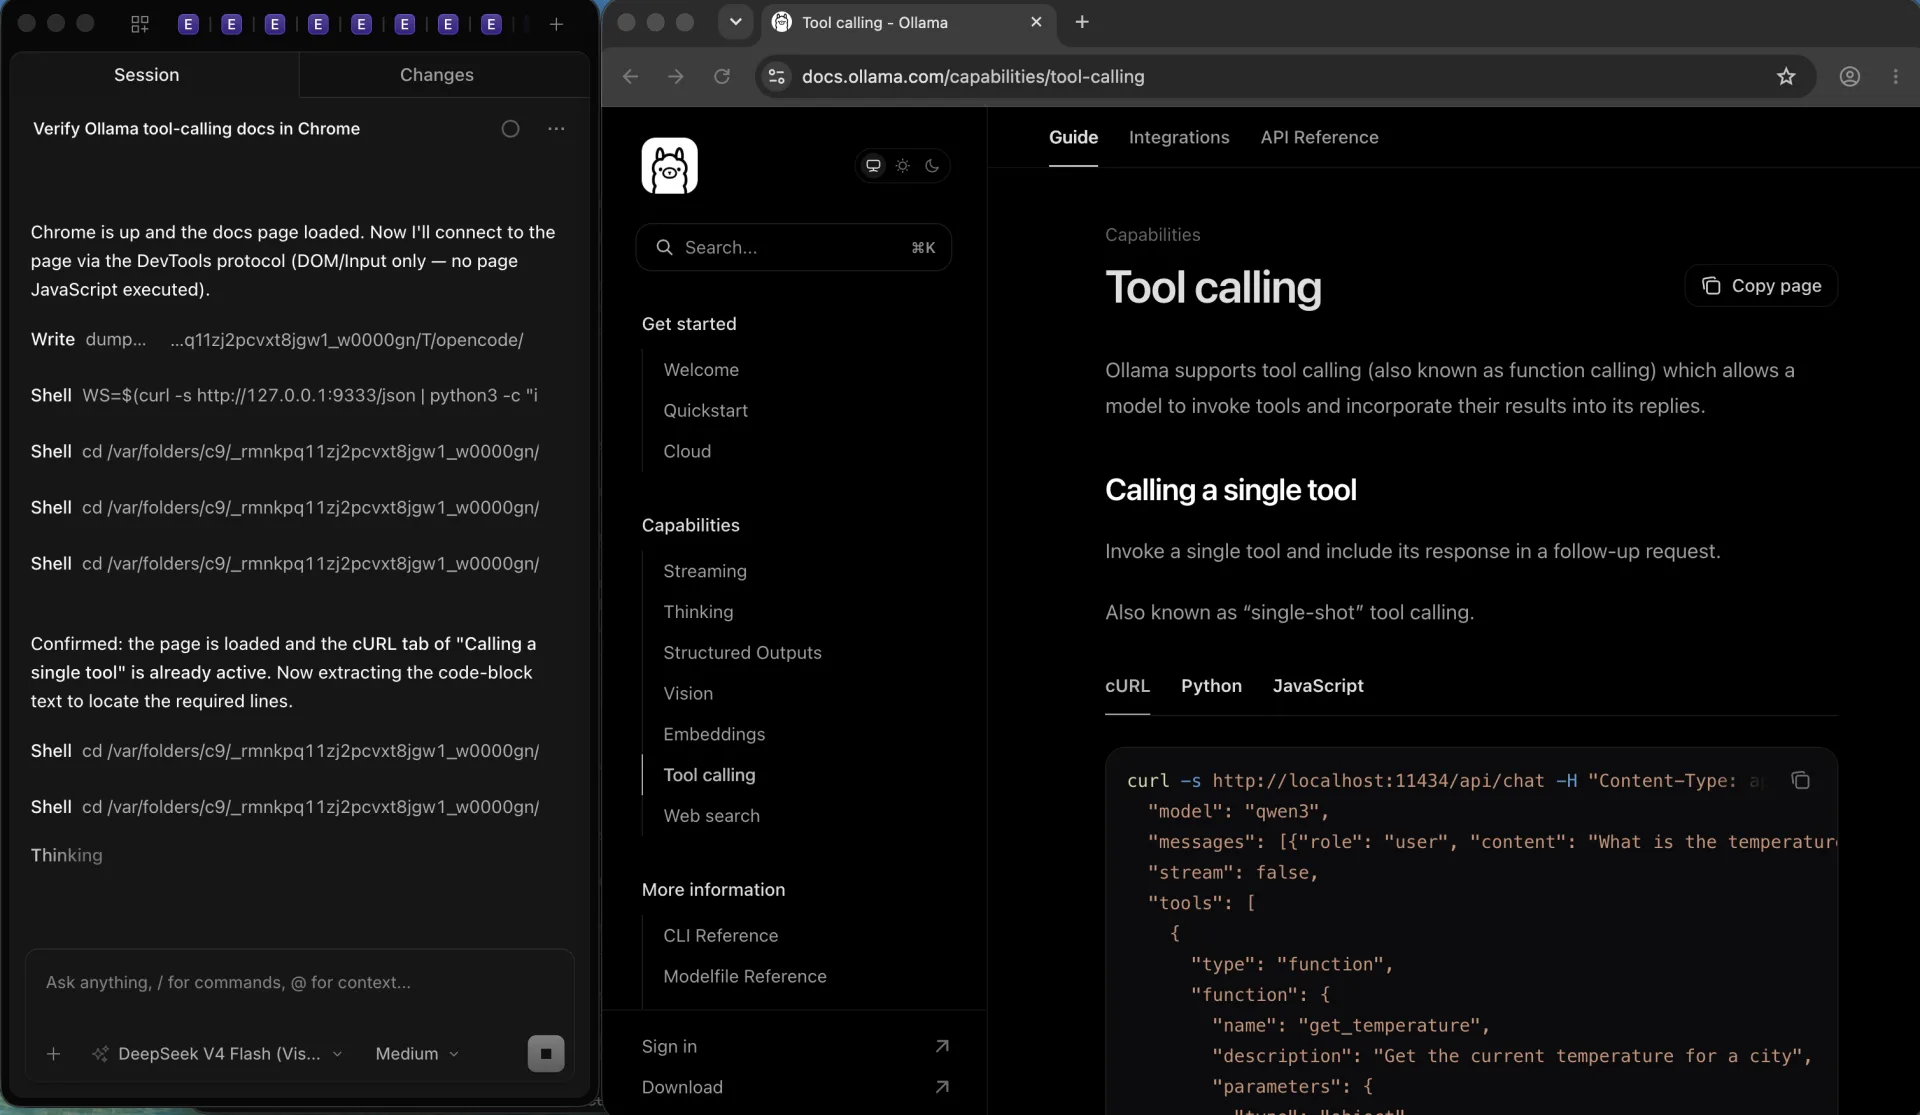
Quali modelli Ollama supportano davvero il tool calling?
La libreria dei modelli di Ollama ha un filtro Tools, e quel filtro è il primo controllo onesto: elenca i modelli i cui produttori dichiarano il tool calling, non modelli certificati per i browser agent.
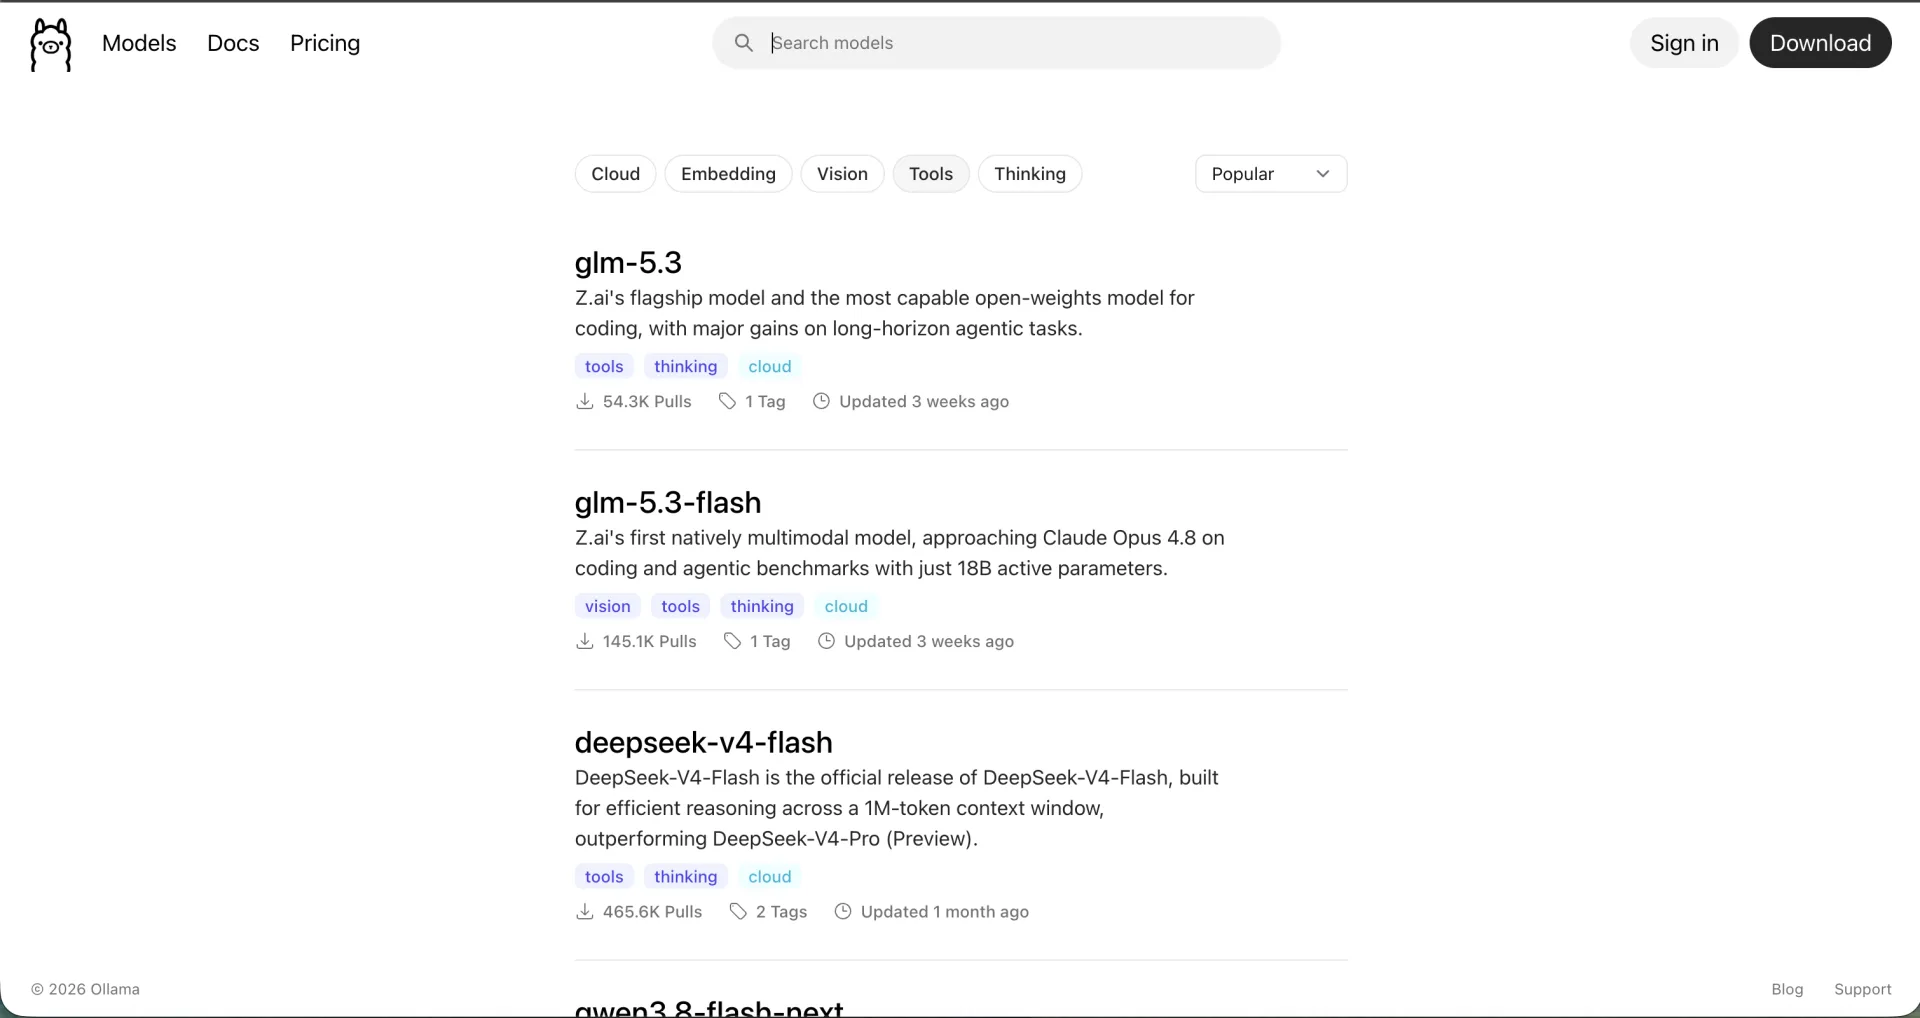
Al momento della verifica il filtro includeva voci locali come qwen3.8 27b, qwen3.6 a 27b e 35b, muse-glimmer 30B, nemotron-3.5-lightning 30B, ornith a 9b e 35b, laguna-s-2.1 e granite4.1 a 3b, 8b e 30b. Altre voci dello stesso elenco, come glm-5.3 e deepseek-v4-flash, sono modelli cloud e non girano sulla tua macchina. Gli elenchi della libreria cambiano, quindi riapri il filtro e rileggi i tag prima di scaricare.
Due esempi ufficiali fissano il livello minimo pratico. La guida di Ollama al tool calling usa qwen3 per chiamate singole, parallele e multi-turno. La guida ai modelli di Browser Use documenta un wrapper Ollama locale come ChatOllama con llama3.1:8b, un modello da 8B, e avverte che alcuni modelli restituiscono lo schema delle azioni del browser nel formato sbagliato e che esempi concreti del formato corretto vanno inseriti nel prompt.
Il modello da aspettarsi: la disciplina dello schema conta più della dimensione. Un modello più piccolo con tag tools che emette chiamate valide porterà a termine più attività nel browser di un modello più grande che racconta cosa farebbe. Prova una sola tool call prima di affrontare un flusso completo.
Quali requisiti hardware e di memoria servono a un browser agent locale?
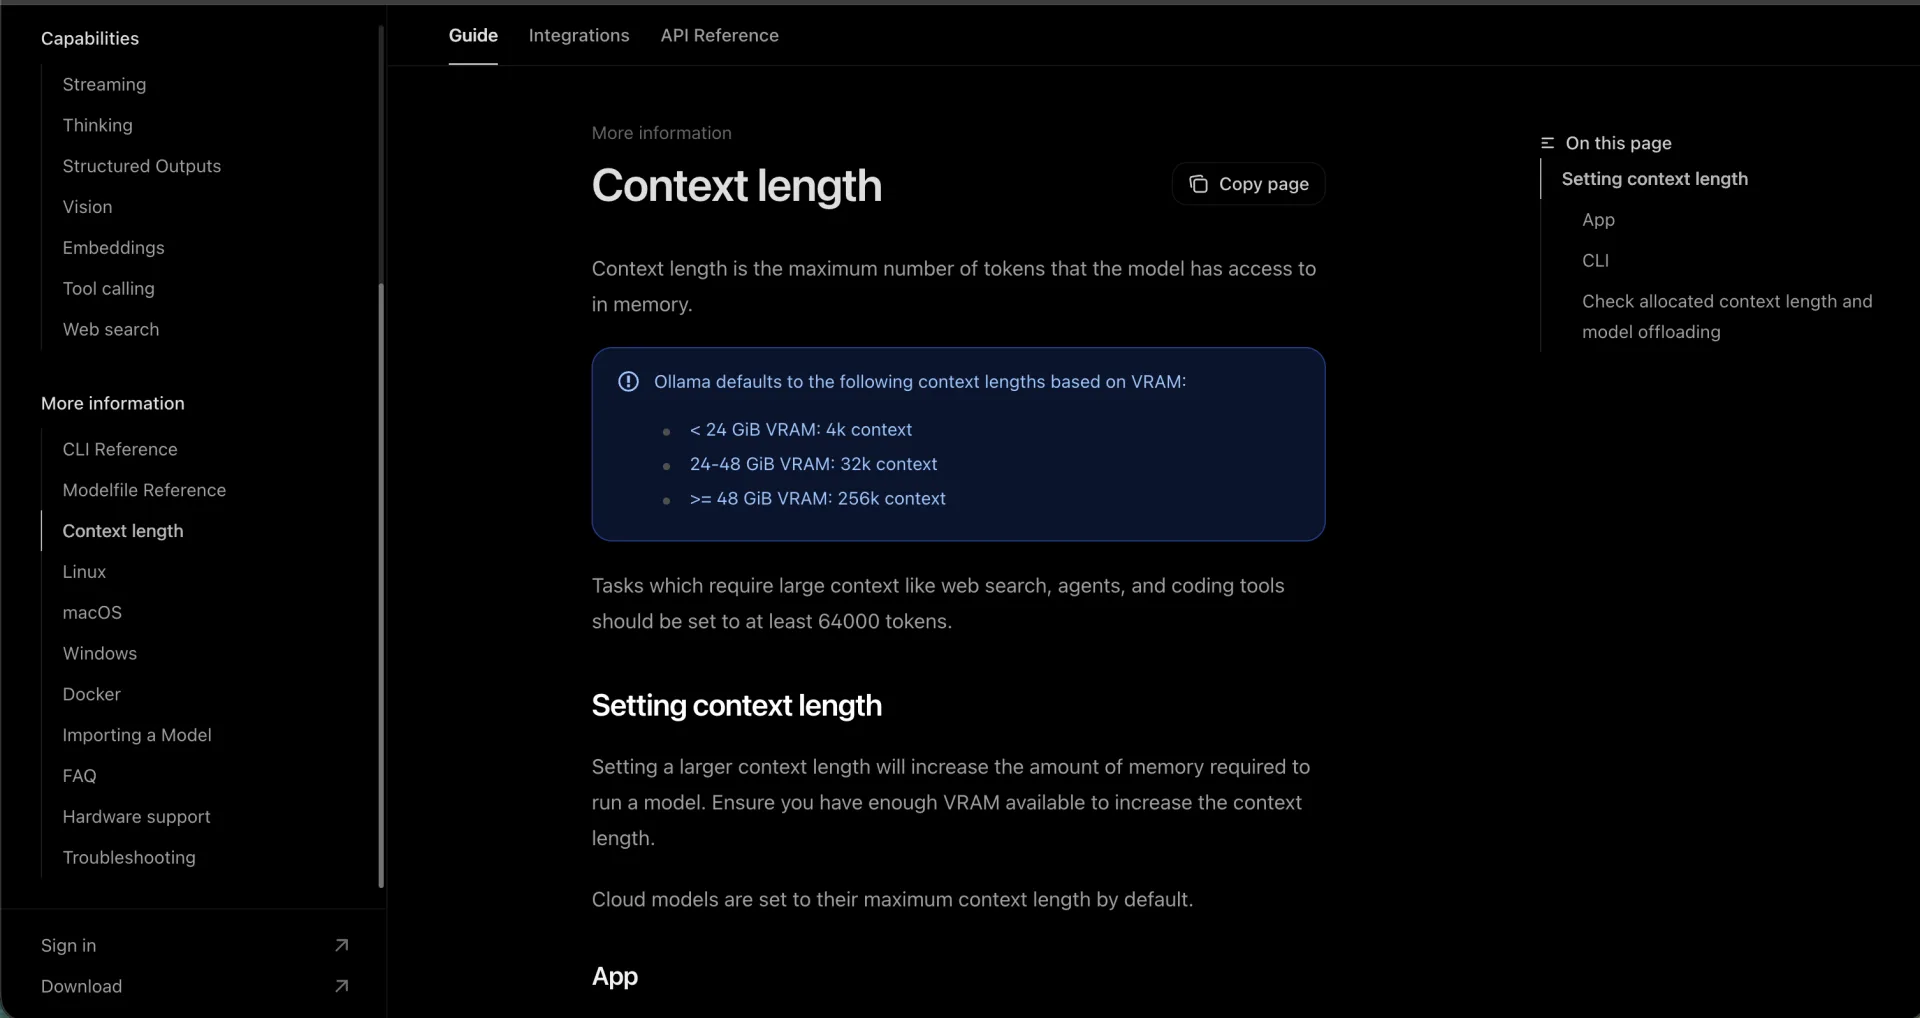
La pagina di Ollama sulla lunghezza del contesto collega i valori predefiniti alla memoria: sotto 24 GiB di VRAM il valore predefinito è 4k token, da 24 a 48 GiB è 32k, mentre da 48 GiB in su è 256k. La stessa pagina consiglia almeno 64.000 token per agenti, ricerca web e strumenti di coding, e avverte che un contesto più ampio richiede più memoria. Le FAQ documentano ancora una base di 4096 token per le macchine con meno memoria.
Altre due regole contano per gli agenti. Su GPU, il caricamento simultaneo di modelli richiede che il modello entri interamente nella VRAM. E se aumenti le richieste parallele, la memoria richiesta da Ollama scala con OLLAMA_NUM_PARALLEL moltiplicato per la lunghezza del contesto, quindi due sessioni parallele possono raddoppiare la memoria del contesto.
La dimensione del download non è la memoria di esecuzione. Il tutorial di ego (lite) per i modelli locali elenca qwen3.8 27b come download Q4_K_M di circa 18 GB e nota che eseguirlo richiede memoria anche per il contesto e per le altre applicazioni della macchina. L'esempio Ollama di Browser Use elenca llama3.1:8b a 4,9 GB. Un browser desktop, un editor e il sistema operativo competono per lo stesso pool.
Il comando di riferimento è ollama ps, che riporta la SIZE del modello, la ripartizione PROCESSOR come 100% GPU o 100% CPU, il CONTEXT allocato e per quanto tempo il modello resta caricato. I modelli vengono scaricati dalla memoria dopo cinque minuti per impostazione predefinita, quindi un flusso di lavoro nel browser con lunghe pause può pagare una ricarica ogni volta.
Come collegare Ollama a un browser agent?
Il collegamento ha tre livelli: Ollama serve il modello, l'agent harness pianifica e chiama gli strumenti, il browser esegue. Solo il terzo livello cambia da un percorso all'altro. La configurazione locale minima è questa:
# 1. Install a tool-calling model
ollama pull qwen3.8:27b
ollama list

# 2. Serve Ollama with an agent-sized context window
OLLAMA_CONTEXT_LENGTH=65536 ollama serve

# 3. Check the OpenAI-compatible endpoint your harness will call
curl -fsS http://localhost:11434/v1/models
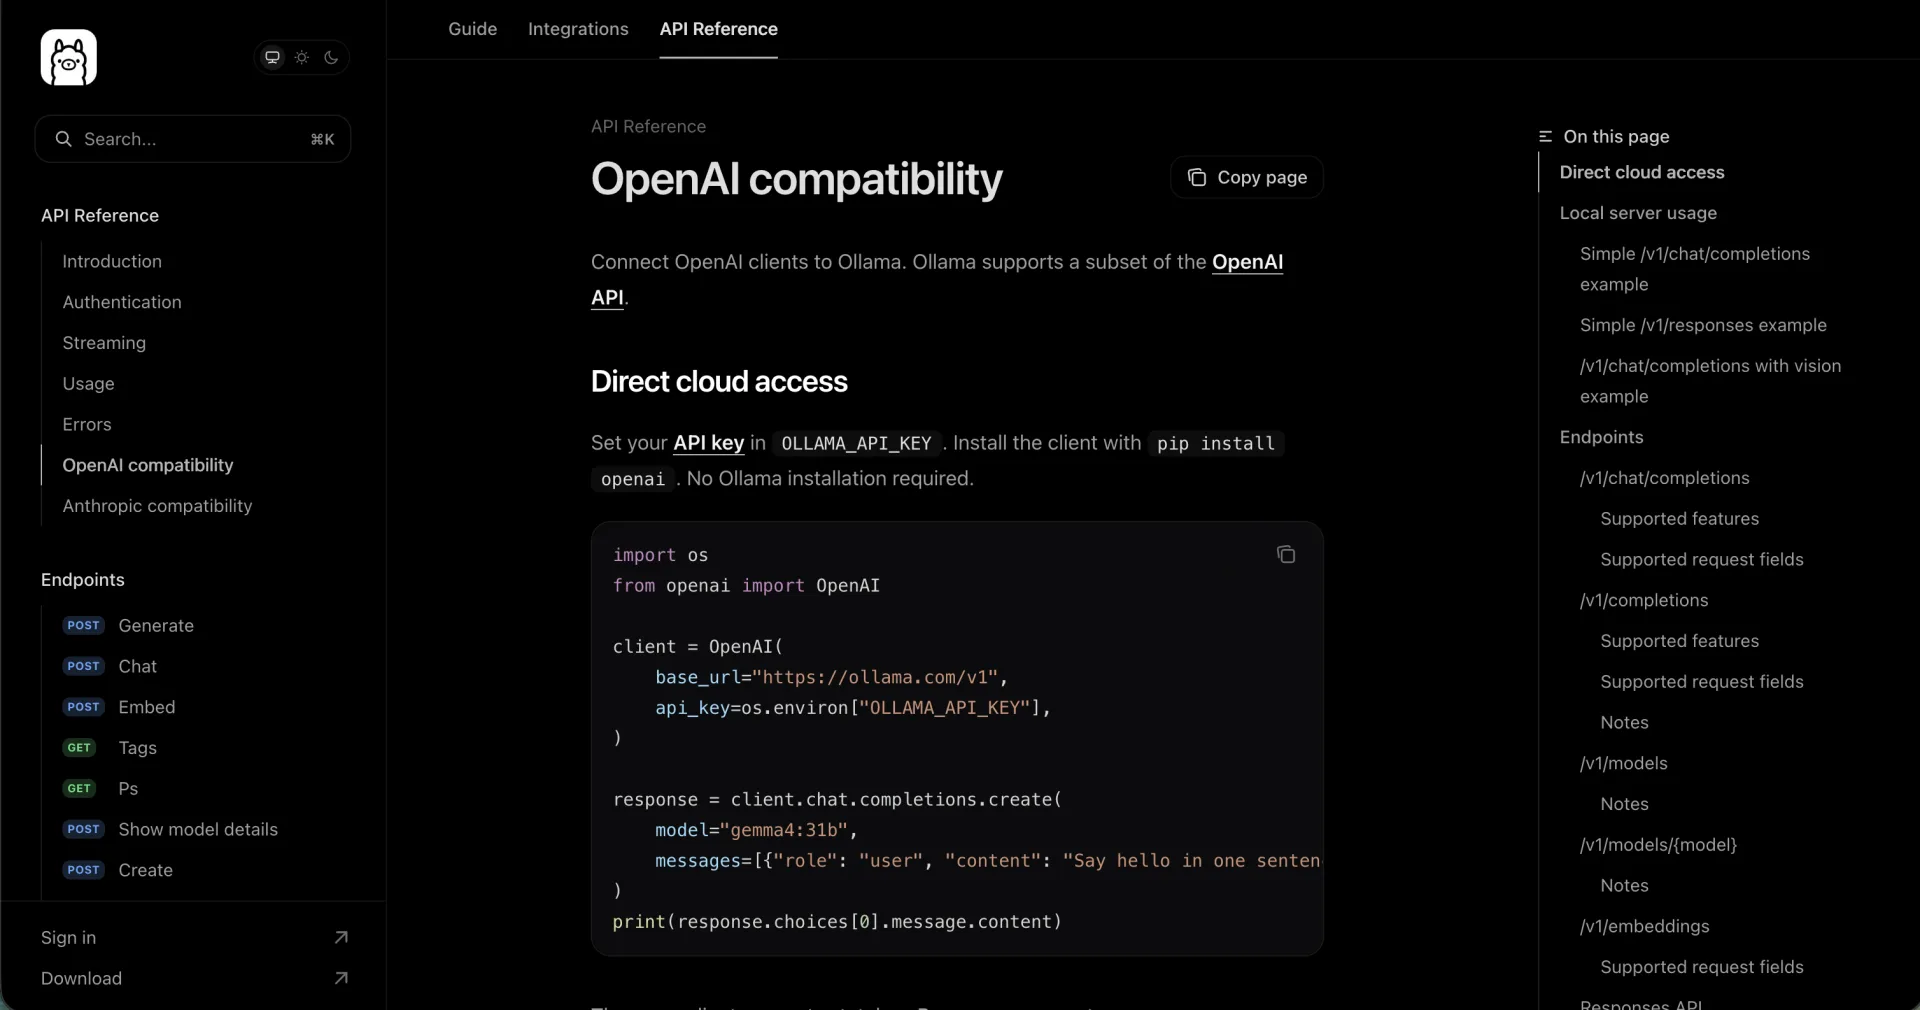
L'URL di base compatibile con OpenAI è http://localhost:11434/v1; in locale il valore della chiave API è richiesto ma viene ignorato. Se usi l'app Ollama invece della CLI, imposta la lunghezza del contesto nelle sue impostazioni; non serve eseguire entrambe. Poi scegli un percorso per il browser:
| Percorso | Chi parla con il modello locale | Qual è il browser |
|---|---|---|
| OpenCode con la skill ego-browser | OpenCode agisce come agente; Ollama è configurato come provider | ego (lite) esegue la sessione Chromium visibile e la skill la guida con un unico script Node.js |
| Playwright MCP | Il client MCP contiene il modello; il server espone solo gli strumenti del browser | Playwright avvia Chromium e restituisce snapshot di accessibilità |
| Browser Use | La libreria Python chiama il server locale tramite ChatOllama | Un browser locale o un browser cloud tramite la stessa libreria |
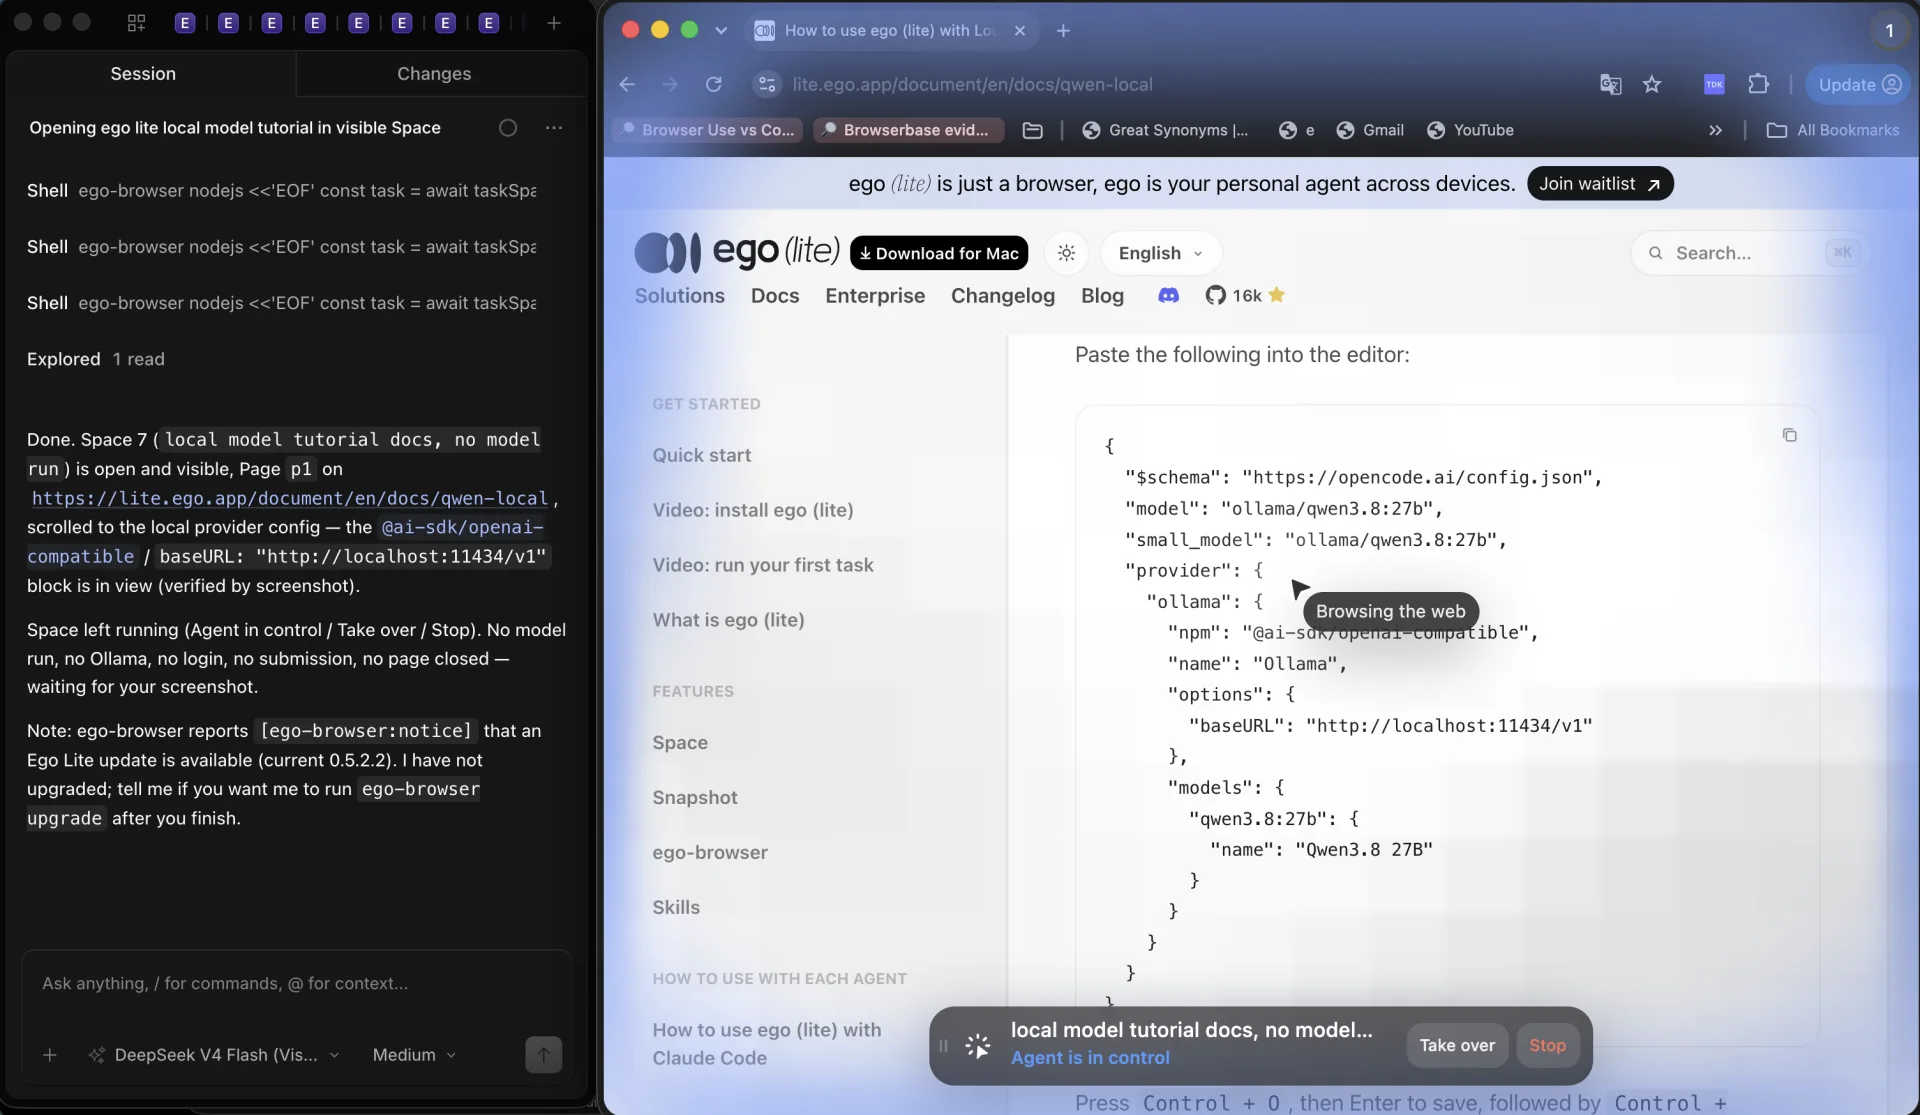
OpenCode con ego (lite) è il percorso con un tutorial locale ufficiale end-to-end. La sua voce provider in opencode.json usa @ai-sdk/openai-compatible con l'URL di base locale e imposta qwen3.8:27b sia per il modello principale sia per il modello piccolo. Il tutorial abilita poi l'accettazione automatica dei permessi, carica la skill ego-browser e avvia OpenCode con il modello locale prima di chiedere la prima attività nel browser.
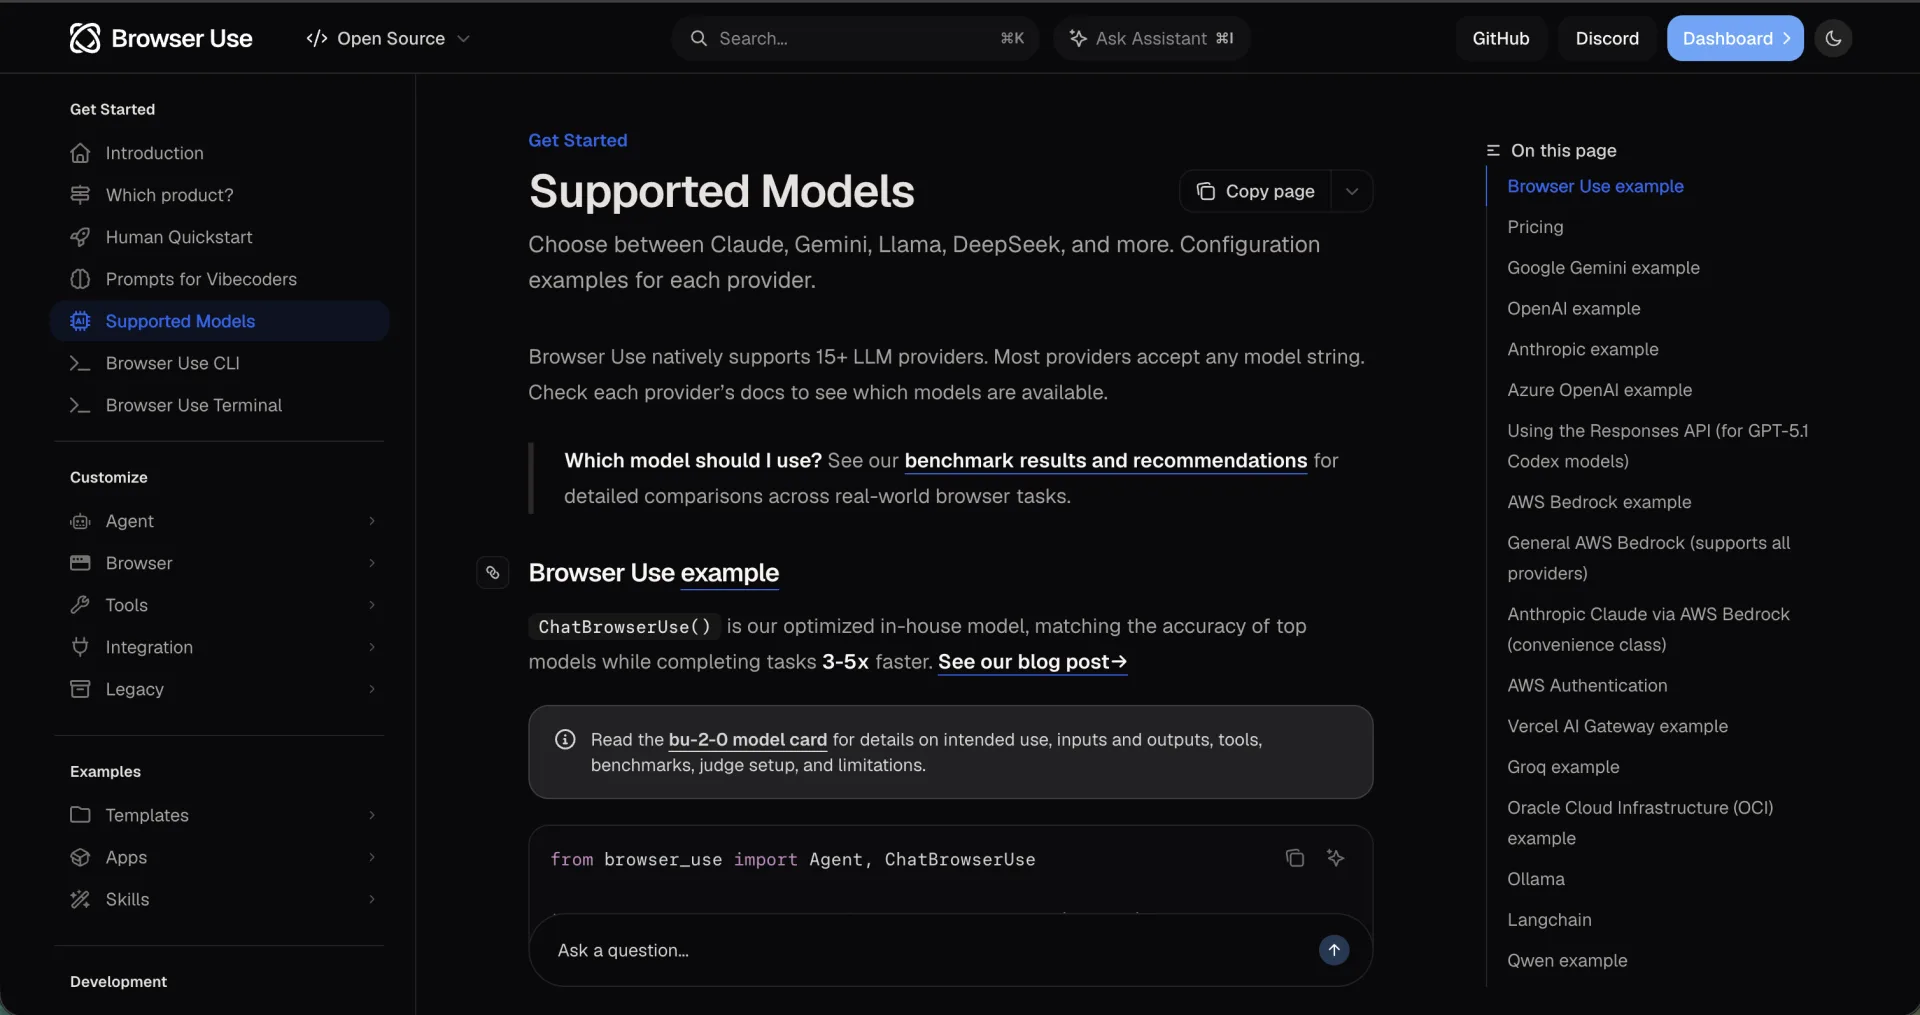
Playwright MCP è indipendente dal modello nel senso che espone strumenti tramite il protocollo e lascia il modello al client; la documentazione di Playwright non descrive un'integrazione con Ollama. Aspettati il costo in token più alto che la documentazione di Playwright attribuisce già a MCP: gli schemi degli strumenti e gli snapshot di accessibilità entrano nella conversazione. Un modello locale con una finestra di contesto piccola lo sentirà per primo.
Browser Use è una libreria Python con un wrapper Ollama documentato. Il repository è distribuito con licenza MIT e il suo README afferma che un browser locale più un modello locale tramite Ollama funziona, con i vincoli di hardware e modello. La sua documentazione rimanda a risultati di benchmark e consiglia di scegliere il modello in base ad attività, latenza e budget invece di dare per scontato che qualsiasi modello funzioni.
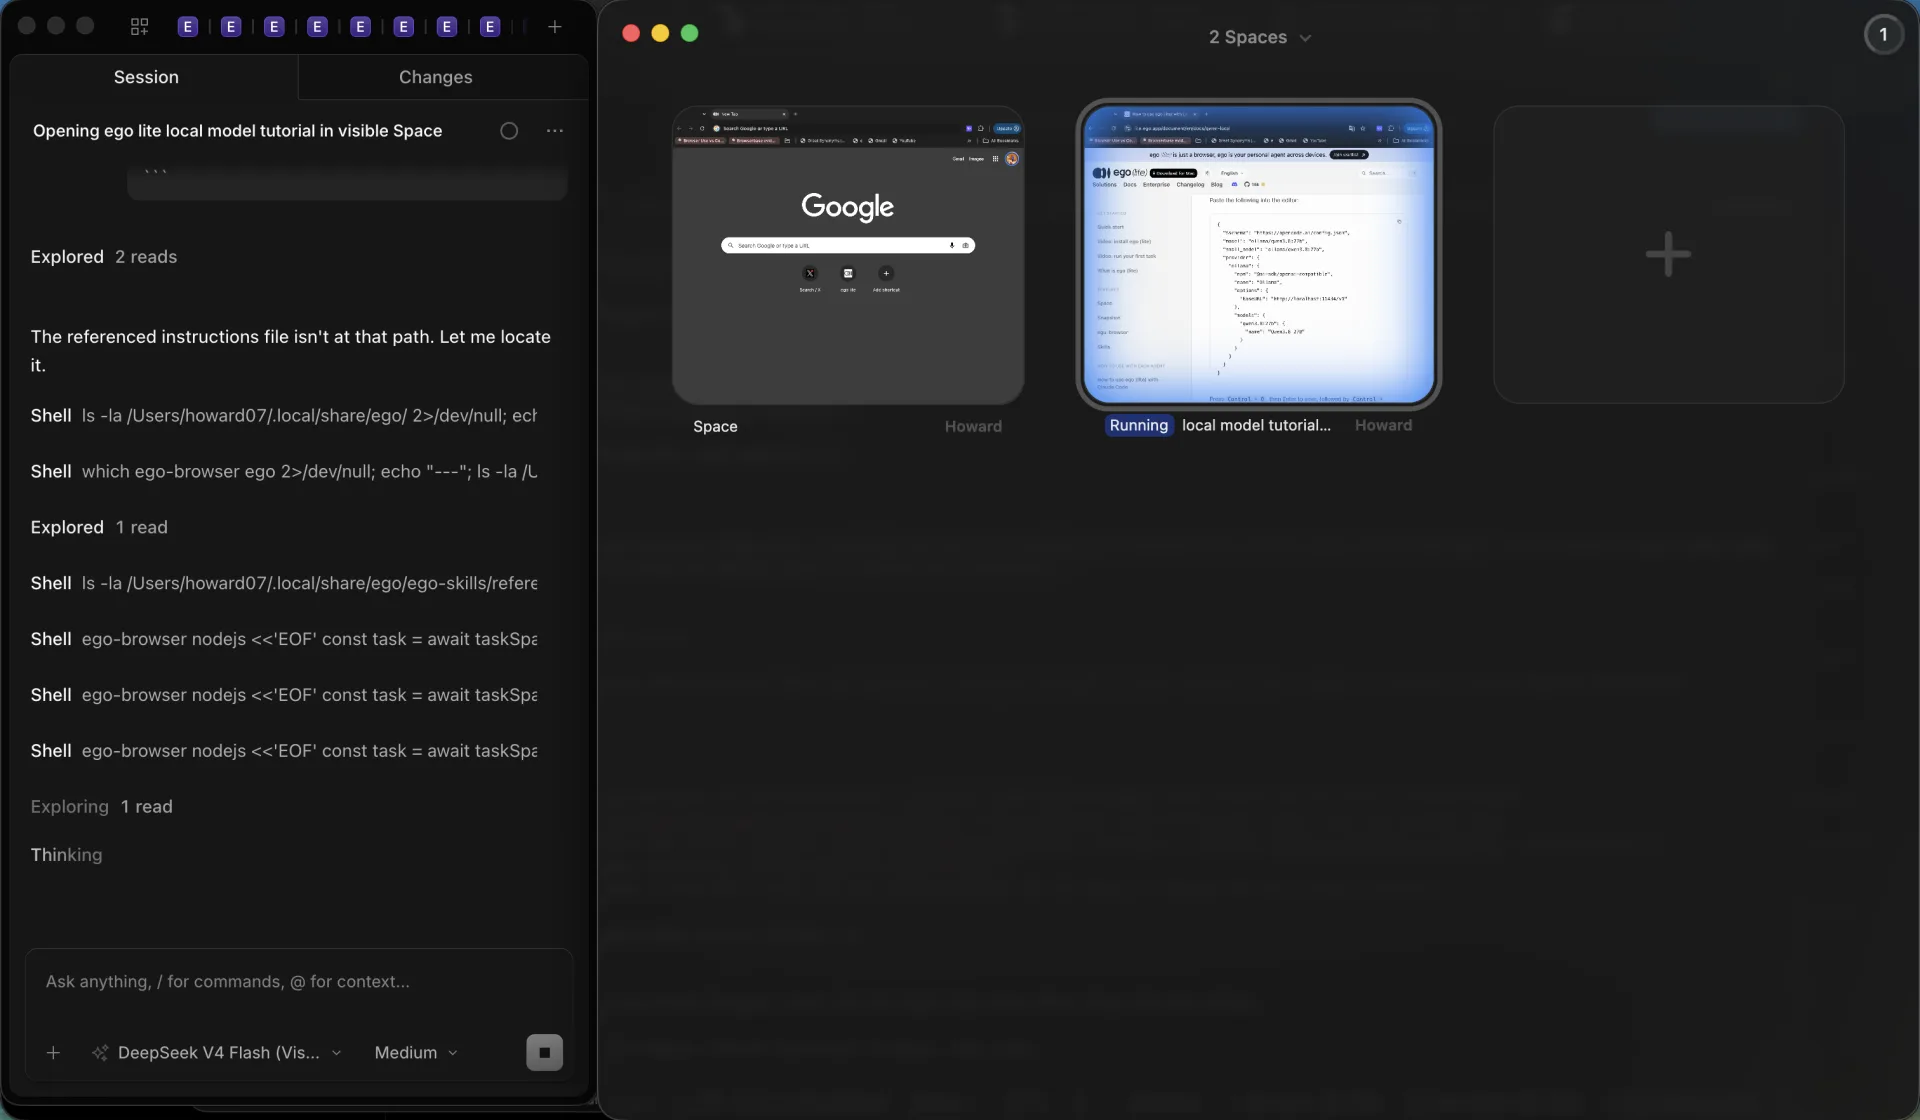
ego (lite) è il percorso in cui browser e modello condividono la stessa macchina. È un browser basato su Chromium e l'agente lo guida tramite la skill o la CLI ego-browser, non con un'estensione o una porta di debug remoto aperta. L'onboarding scrive la skill nelle directory delle skill dell'agente e uno Space dedicato tiene le schede dell'agente separate dalle tue, con la pagina dal vivo visibile e la possibilità di riprendere il controllo. Usalo quando una semplice richiesta HTTP non riesce a concludere il lavoro: un login, contenuto renderizzato dopo il caricamento, paginazione, moduli o verifica in più passaggi. L'agente mostra l'input, segue i passaggi chiave nello Space, recupera da un passaggio fallito e convalida il risultato prima di riferire. Se una richiesta HTTP o un'API ufficiale restituiscono già ciò che ti serve, quel percorso resta il più economico.
I limiti onesti: ego (lite) non è un sostituto immediato di Playwright o Puppeteer, uno Space è un confine di isolamento del lavoro e non un sandbox di sicurezza multi-tenant, e un modello hosted può ancora battere uno locale su un compito difficile. Il vantaggio locale è che la sessione del browser, i dati delle pagine e il modello restano sulla tua macchina.
Cosa si rompe prima: tool calling, contesto o latenza?
L'affidabilità delle tool call è la prima a rompersi, e in modo evidente. La guida ai modelli di Browser Use documenta i modelli che restituiscono lo schema delle azioni in un formato diverso da quello atteso e consiglia di aggiungere esempi concreti del formato al prompt. Nel tutorial di ego (lite) il sintomo è un modello che risponde in prosa invece di emettere tool call. In entrambi i casi il problema è nell'harness e nessuna finestra di contesto più grande lo risolve.
Il contesto fallisce in silenzio. Una pagina piena di snapshot può consumare migliaia di token per osservazione; Playwright documenta MCP come l'interfaccia con il costo in token più alto proprio per questo motivo, e l'esempio di ricerca web di Ollama tronca l'output lungo degli strumenti per rientrare. Quando la finestra si esaurisce, le osservazioni precedenti vengono scartate e l'agente ricomincia un lavoro già fatto.
La latenza è il costo che resta visibile. Il tutorial di ego (lite) afferma chiaramente che la velocità di generazione locale dipende da hardware, memoria disponibile e lunghezza del contesto, e suggerisce di provare un'attività più piccola quando un'esecuzione si blocca. Un modello scaricato dalla memoria dopo i cinque minuti di keep-alive aggiunge una ricarica prima del passaggio successivo.
Fai il debug in quest'ordine: conferma la tool call, poi la finestra di contesto con ollama ps, infine misura il tempo effettivo. Cambiare modello prima di aver controllato quei tre punti nasconde la causa reale.
Quando conviene passare a un modello hosted?
Passa al modello hosted quando dominano i tentativi ripetuti. Se il modello locale restituisce chiamate malformate su molti passaggi, se la pagina richiede pianificazione a lungo orizzonte o se la finestra di contesto continua a riempirsi prima della fine dell'attività, un modello hosted con una finestra più ampia e una migliore aderenza alle istruzioni concluderà più spesso di quanto costi.
La scelta del modello è trattata come una variabile di primo piano dagli harness stessi. Il repository di Browser Use consiglia il proprio modello ottimizzato per il browser e mantiene un benchmark pubblico per i compiti difficili, e le sue FAQ osservano che la scelta migliore dipende da attività, latenza e budget. È un segnale forte del fatto che nessun valore locale predefinito è sicuro.
Un flusso diviso è spesso meglio di un passaggio completo: esegui in locale i passaggi brevi, sensibili o ripetitivi e manda al modello hosted il passaggio difficile di pianificazione. Ricorda il confine: nel momento in cui un passaggio raggiunge un modello hosted, il suo prompt e l'estratto della pagina lasciano la tua macchina.
Il costo non è l'unico asse. Confronta il costo per attività completata, non il prezzo per token, perché un modello economico che richiede tre tentativi può costare più di un modello forte che finisce al primo colpo.
Cosa guadagni su privacy e costi?
La FAQ afferma che le esecuzioni locali restano locali: l'azienda non vede i tuoi prompt né i tuoi dati quando esegui in locale. I suoi modelli cloud sono un servizio separato che elabora prompt e risposte per fornire il servizio, senza archiviarli, registrarli né addestrarli. Le API di ricerca web e di recupero web sono anch'esse ospitate e richiedono un account Ollama e una chiave API, quindi un agente con la ricerca attiva non è del tutto locale.
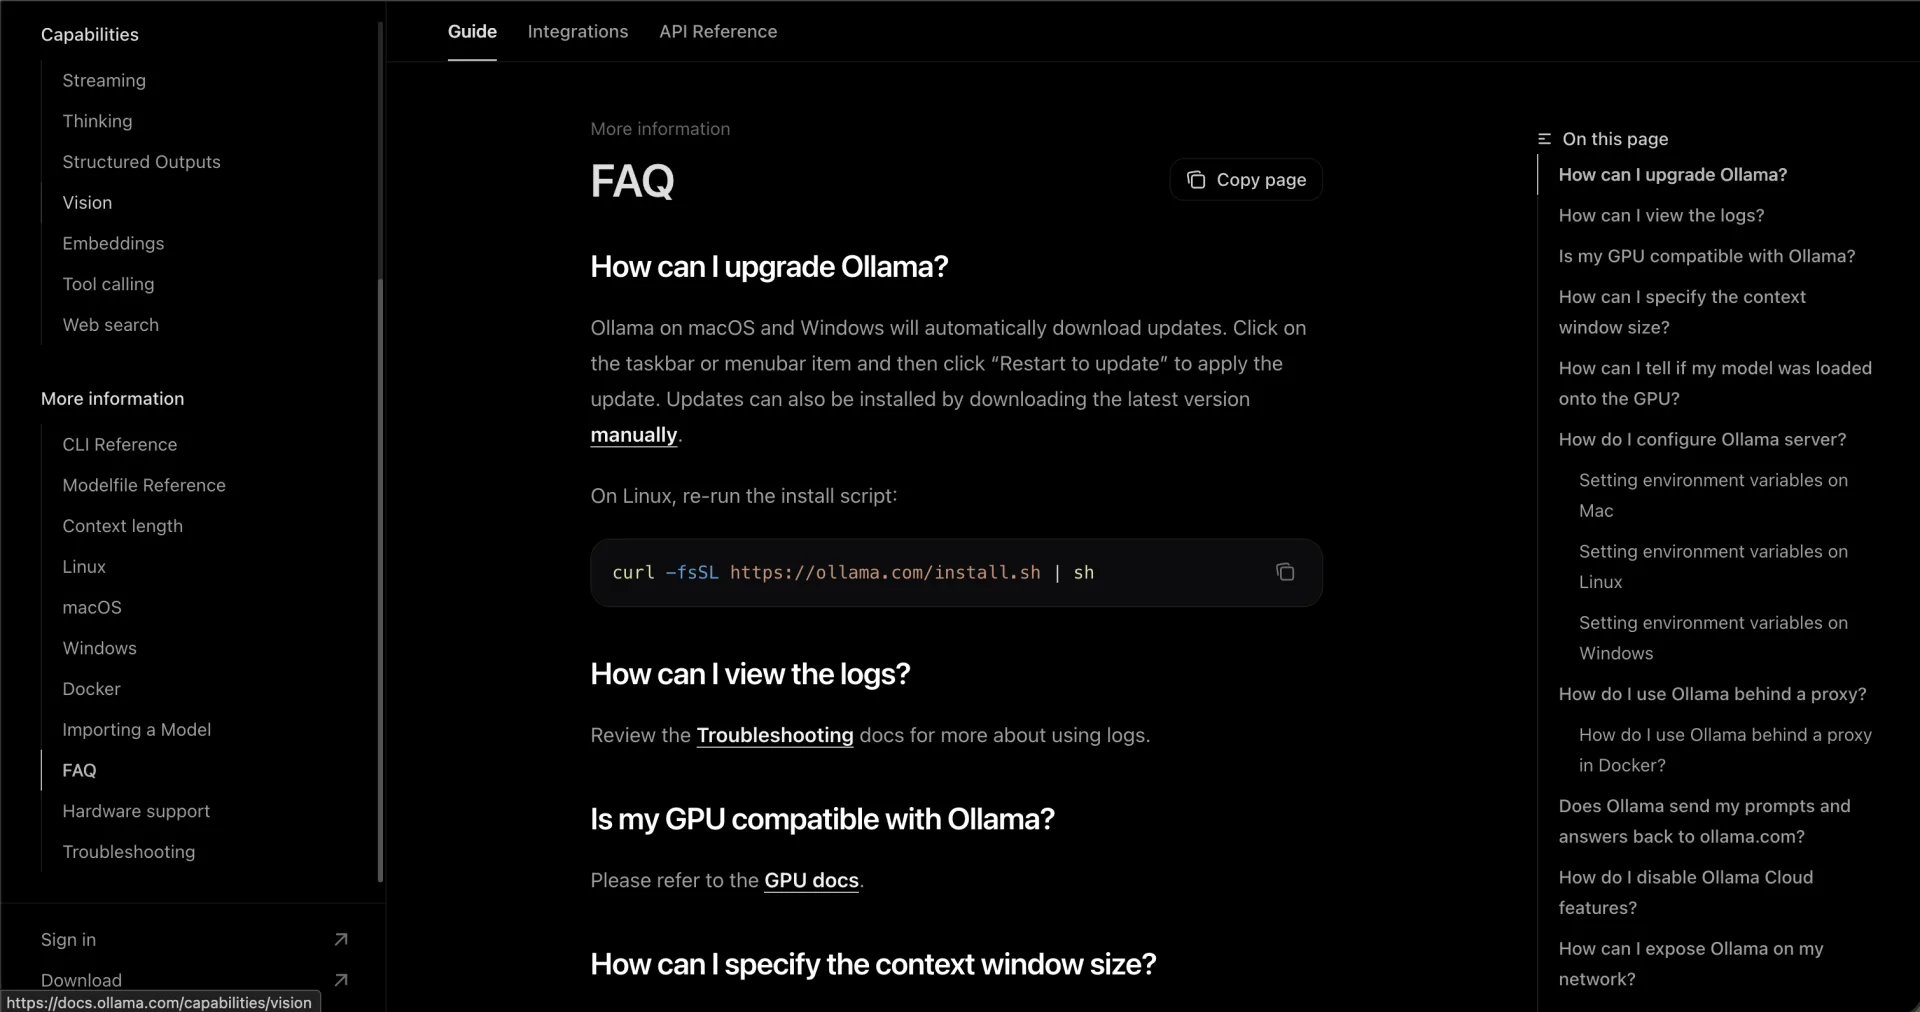
Se l'obiettivo è il funzionamento solo locale, Ollama documenta la disattivazione delle funzioni cloud tramite disable_ollama_cloud nel file di impostazioni del server o la variabile d'ambiente OLLAMA_NO_CLOUD. Il compromesso è esplicito nella documentazione: i modelli cloud e la ricerca web smettono di funzionare.
Il costo segue la stessa divisione. L'inferenza locale non ha una fattura per token, ma il browser agent consuma la tua memoria, la tua elettricità e il tuo tempo, e ogni tentativo ripetuto si paga in latenza invece che in denaro. L'inferenza hosted fattura per token e un servizio browser hosted può fatturare anche il tempo del browser. Misura un'attività completa, non una singola chiamata.
Per quanto riguarda il livello del browser, ego (lite) mantiene la sessione in locale: la pagina, lo stato di login e gli snapshot restano sulla macchina e l'unico traffico che esce è quello richiesto esplicitamente dal modello o da uno strumento. È l'argomento di privacy a favore dell'abbinamento tra un modello locale e un browser locale, ed è anche il suo limite: vale solo finché ogni passaggio resta locale.
Cosa abbiamo verificato e cosa non è stato eseguito
Questo articolo è un lavoro di documentazione, non un benchmark. Tutti i fatti sopra provengono da fonti ufficiali consultate il 20 settembre 2026: le pagine di Ollama su tool calling, lunghezza del contesto, compatibilità OpenAI, ricerca web e FAQ; il filtro Tools della libreria dei modelli Ollama; il repository di Browser Use e la sua pagina dei modelli supportati; l'introduzione di Playwright MCP; e le pagine di ego (lite) su modello locale, ego-browser e changelog. Il changelog di ego (lite) elencava la versione 0.5.0.32 come voce più recente al momento della verifica, e la 0.5.0.28 ha aggiunto l'attuale skill e toolset ego-browser su Chromium 152.
Niente è stato eseguito su questa macchina. Nessun modello è stato scaricato, Ollama non è stato installato né avviato, nessun browser agent è stato lanciato e non è stata presa alcuna misura di latenza, VRAM, token o tasso di successo. I dettagli sensibili alla versione, come i valori predefiniti del contesto, le dimensioni dei modelli e le voci della libreria, vanno ricontrollati prima di farci affidamento.
FAQ
Un browser agent con Ollama locale può funzionare senza GPU?
Può funzionare su CPU, e ollama ps mostrerà 100% CPU, ma la documentazione consiglia di evitare l'offload sulla CPU per le prestazioni e nota che la memoria scala con contesto e parallelismo. Aspettati una generazione più lenta e una finestra di contesto pratica più piccola; un modello più piccolo con tag tools è il punto di partenza migliore.
Quali modelli Ollama supportano il tool calling?
Parti dal filtro Tools della libreria dei modelli invece che da un elenco fisso, perché le voci cambiano. Al momento della verifica includeva qwen3.8 27b, qwen3.6 27b e 35b, muse-glimmer 30B, nemotron-3.5-lightning 30B, ornith 9b e 35b e granite4.1 3b, 8b e 30b. Il tag è una dichiarazione del produttore: verificalo con una vera tool call.
La ricerca web di Ollama è privata?
No. La ricerca web e il recupero web sono API ospitate che richiedono un account Ollama e una chiave API, quindi le query lasciano la macchina. Disattivare le funzioni cloud disattiva anche la ricerca web.
Playwright MCP supporta ufficialmente Ollama?
Playwright documenta MCP come interfaccia per i client MCP, non come integrazione con Ollama. Il modello viene dal client; se quel client può usare un modello Ollama locale che chiama gli strumenti, il server MCP non deve saperlo.
Perché il mio agente locale dice di aver cliccato ma non è cambiato nulla?
L'harness non ha ricevuto una tool call, oppure la tool call non è arrivata al browser. La soluzione indicata dal tutorial di ego (lite) è confermare che la skill del browser sia caricata e che il modello emetta tool call invece di descrivere azioni; la guida di Browser Use suggerisce di controllare lo schema delle azioni e di fornire al modello esempi concreti del formato.
ego (lite) sostituisce Playwright?
No. ego (lite) è un browser che l'agente guida tramite la sua skill e la sua CLI, e la sua documentazione afferma che il runtime non è un sostituto di Playwright o Puppeteer. Si adatta ai flussi locali, visibili e con login; Playwright resta lo strumento migliore per test headless ripetibili e CI.
Quanta VRAM serve per un browser agent locale?
Non esiste un totale ufficiale, perché pesi, contesto, parallelismo e il resto del desktop condividono la stessa memoria. La regola utile che arriva dalla documentazione: tieni il modello interamente nella VRAM per le prestazioni migliori, imposta almeno 64.000 token di contesto per il lavoro degli agenti, poi leggi SIZE, PROCESSOR e CONTEXT da ollama ps.
Un browser agent Ollama locale è un'opzione reale per flussi brevi, privati e ripetitivi su una macchina con memoria sufficiente, e una scelta dolorosa quando l'attività richiede pianificazione a lungo orizzonte oltre una finestra di contesto piccola. Collega un solo percorso, verifica una tool call, leggi ollama ps e lascia che le misurazioni decidano quando un modello hosted merita la sua fattura.