Browser Use向けローカルLLM 実際に使えるもの
Browser UseはOllama経由でローカルモデルを動かせます。セットアップ自体は難しくありません。難しいのは信頼性です。ローカルモデルは接続に成功しても、ツール呼び出しの形が違う、コンテキストが埋まる、ブラウザの1ステップに時間がかかりすぎるといった理由で失敗することがあります。Browser Useはローカル経路を文書化していますが、小さなローカルモデルが長い多段階タスクをうまくこなすと保証する品質ベンチマークは公開していません。
そのため、確認はいっそう重要になります。ローカル実行では、エージェントが最終的な答えを返したことだけでなく、期待したブラウザ操作が実際に行われたことを示す必要があります。Browser Useはその確認のために履歴と構造化された結果を提供しており、到達先を決定論的に読み取れば、成功したように見えて誤った結果を生んだ実行を捉えられます。ブラウザ側もローカルで可視のままにしたい場合は、ego(lite) をego-browserスキル経由でローカルモデルと組み合わせられます。ブラウザのセッション、ページデータ、モデルを同じマシンに置いたまま、実行を眺めたり引き継いだりできます。
残りはマシンとモデルの限界次第です。コンテキストのサイズ、VRAM、ツール呼び出しの正確さ、レイテンシは、ローカルのブラウザエージェントがタスクをやり切れるかに影響します。以下に示すコマンドとモデルの詳細は、2026年9月20日に確認した公式ドキュメントと、このリポジトリでの以前の比較テスト1件によるものです。本記事はこのマシンで新たなベンチマークを実行したものではありません。
Browser UseはローカルLLMで動かせるのか
はい。公式に示された道筋は短いものです。supported-modelsページにはOllamaがホスト型プロバイダーと並んで載っており、設定全体は1行で示されています。llm = ChatOllama(model="llama3.1:8b")。同じページでは、セットアップをOllamaのインストールとollama serveの実行、そしてモデルの取得はollama pull llama3.1:8bだと説明しており、4.9GBのダウンロードだと注記しています。
ニュアンスは、ドキュメントが何を主張し、何を主張していないかにあります。配線は文書化していますが、ローカルモデルのベンチマークや互換性リストは公開していません。クイックスタートはホスト型のChatBrowserUseモデルを推奨しています。Browser Useはこれを、トップモデル並みの精度を保ちながらタスクを3〜5倍速く完了すると説明しています。ローカル対応は、品質の余裕がまだ証明されていない現実的な経路と考え、導入前に自分のタスクで試してください。
もう1つの経路もあります。Browser Use CLIはコーディングエージェントにブラウザを直接操作させ、スキルとしてインストールでき、CDP経由でローカルのChromeまたはChromiumに接続します。ローカルモデルでコーディングエージェントを動かすなら、この組み合わせがクラウドなし構成の実際の姿です。
Browser Useで実際に動くローカルモデルはどれか
Browser Use向けのローカルモデルをランキングした公式ページは存在せず、それを示す人がいれば推測です。一次情報が提供するのは、少数の文書化された例と、1つの明確な警告だけです。
文書化された例はLlamaです。supported-modelsページのOllamaセクションはllama3.1:8bだけを使い、4.9GBのダウンロードサイズを示すものの、信頼性についての主張は添えていません。
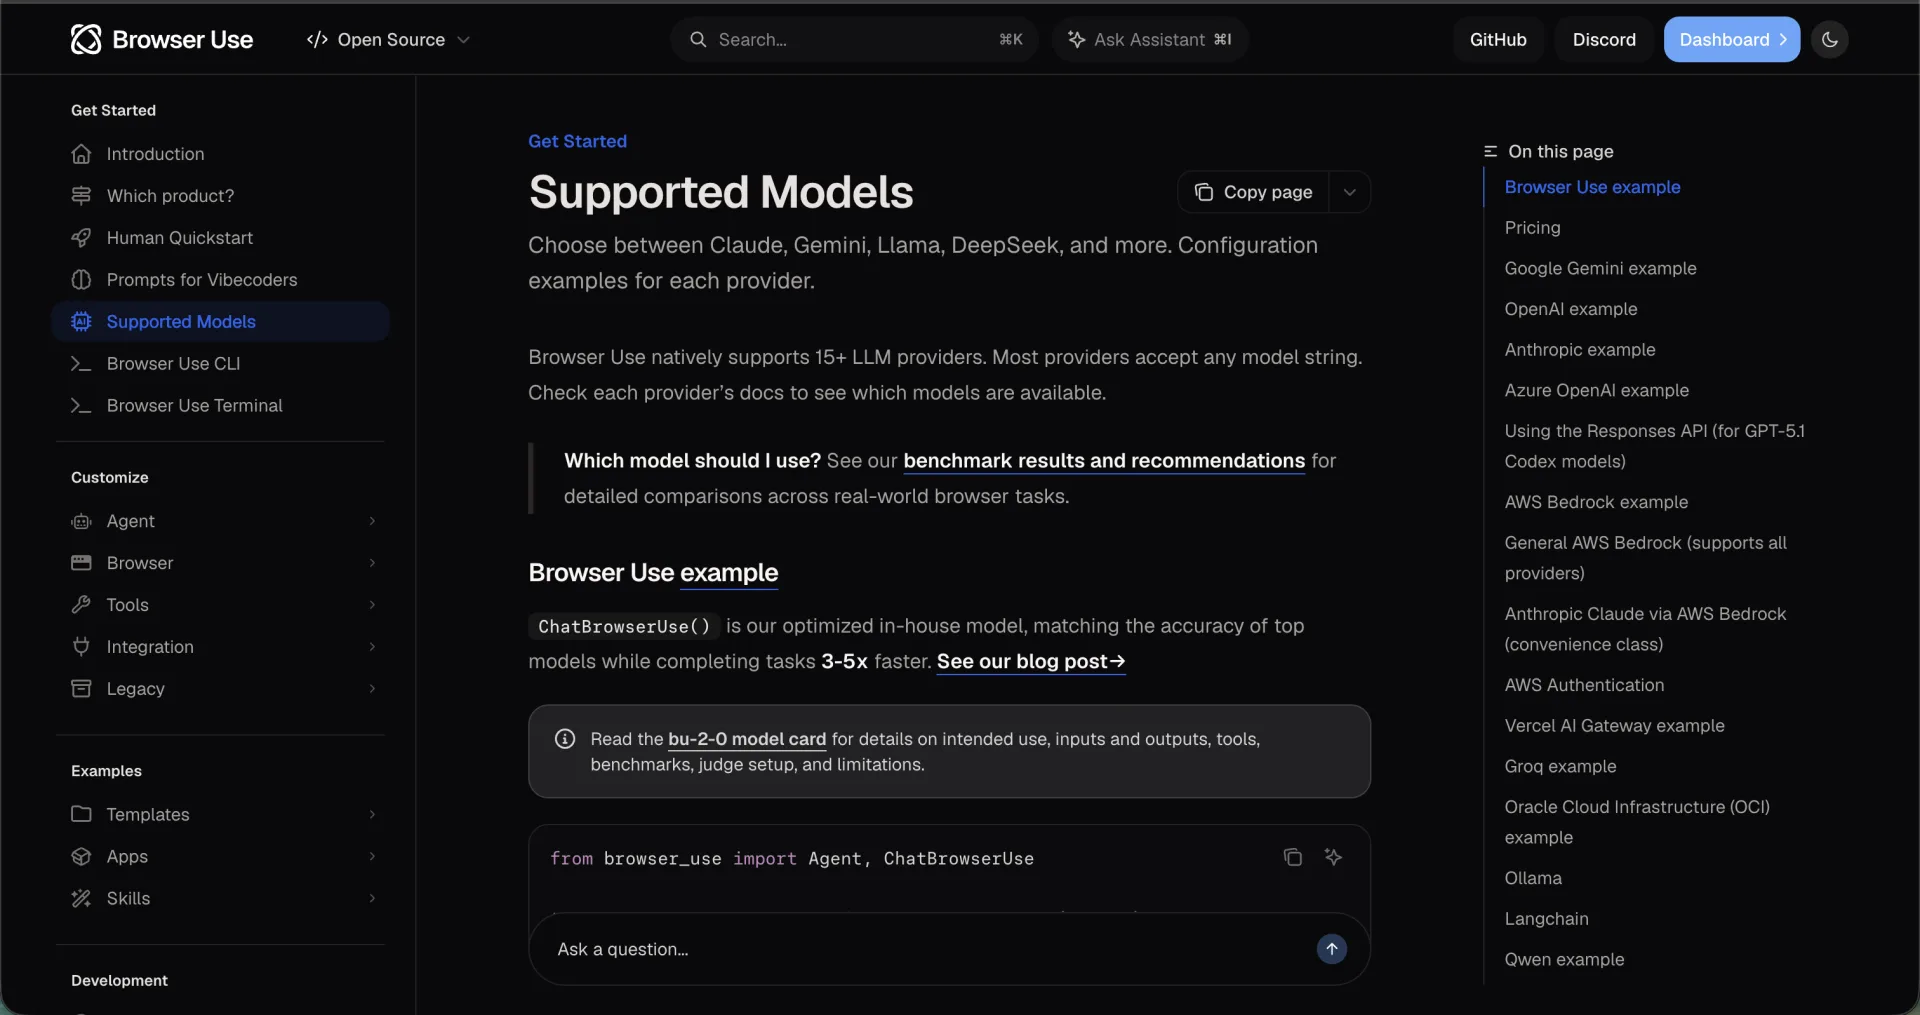
明確な警告はQwenに関するものです。同じページのQwenセクションは、現時点でBrowser Useに推奨されるのはqwen-vl-maxだけで、qwen-maxを含む他のQwenモデルにはアクションスキーマ形式の問題があり、小さめのQwenモデルはactions: [{"navigate": "google.com"}]を返すことがあり、エージェントが期待するのはactions: [{"navigate": {"url": "google.com"}}]です。提案されている修正は、正しいアクション形式の具体例をプロンプトに追加することです。qwen-vl-maxはAlibabaのホスト型モデルでローカルにダウンロードするものではないため、唯一明確に推奨されているQwenはローカルモデルではない点に注意してください。
Ollama自身のツール呼び出しのページは、そもそもモデルがツールに対応しているかを確認するのに最適です。例ではqwen3が使われていますが、これはqwen3がBrowser Useの推奨だという意味ではなく、そのモデル群がAPIの形に対応しているという意味です。
| 確認項目 | 合格条件 | 文書化された失敗の兆候 |
|---|---|---|
| ツール呼び出し | 応答にツール呼び出しが含まれ、テキストだけではない | ツール呼び出しのない、内容だけの応答 |
| アクションスキーマ | 引数が、エージェントの期待するネストしたオブジェクトと一致する | オブジェクトが必要な箇所にgoogle.comのような平坦な値が入る |
| 構造化出力 | formatフィールドに渡したJSONスキーマがそのまま解析できる | JSONの前後に文章が付く、またはスキーマから外れたフィールドが返る |
| マルチターンのループ | ツール結果が戻り、次のステップがそれに続く | 同じ呼び出しを繰り返す、または結果の前に止まる |
確認は4項目、1回で済みます。アクションスキーマの確認で失敗した場合、文書化された対処はプロンプト側です。期待するアクションオブジェクトの具体例を入れます。1つの呼び出しを整形できないモデルを補うために、ツールを増やしてはいけません。
一般的なマシンにOllamaとBrowser Useをセットアップする方法
この順番で進め、各ステップを個別に確認できるようにします。
- Ollamaをインストールする。 macOS、Windows、Linux向けにダウンロードしてアプリを開くか、ターミナルから始めます。Ollamaのクイックスタートによれば、ローカルモデルにAPIキーは不要です。
- サーバーを起動してモデルを取得する。 Browser Useはollama serveとollama pull llama3.1:8bを文書化しています。Ollamaのクイックスタートは最初のローカルチャットにollama run gemma4:e2bを使い、このモデルが約7.2GBのダウンロードであること、8GBの空きVRAMまたはユニファイドメモリを推奨することを記しています。
- Browser Useライブラリをインストールする。 クイックスタートはuvをインストールし、Python 3.12環境を作成してbrowser-useをインストールし、uvx browser-use installを実行してブラウザとChromiumを導入します。リポジトリのREADMEはライブラリにPython 3.11以上を求めています。
- エージェントをOllamaに向ける。 文書化された行はllm = ChatOllama(model="llama3.1:8b")です。残りのエージェント呼び出しはクイックスタートの例に従い、タスク文字列だけを自分のものにします。
- コーディングエージェントが操作の入口なら、CLIを使う。 Browser Use CLIページはuv tool install browser-useでインストールし、browser-use skill installでスキルを登録し、browser-use --doctorで接続を確認し、既定ではCDP経由で実行中のChromeまたはChromiumに接続します。
DeepSeekを使用すると、Browser Useはローカルで実行されますか?
DeepSeekのモデル名は、推論がどこで実行されるかを示すものではありません。Browser Useは、ブラウザがお使いのコンピューター上にありながら、ホスト型プロバイダーを呼び出すことができます。その構成でも、モデルへの入力はプロバイダーに送信されます。ローカルブラウザとローカル推論は別々の選択です。
このBrowser Useのサポートモデルガイドでは、DEEPSEEK_API_KEYを使用するChatDeepSeekと、ローカルOllamaサーバー用のChatOllamaが記載されています。DeepSeek APIクイックスタートは2026年10月22日に確認され、現在のFlashエンドポイント用にdeepseek-flashが記載されています。Browser Useのドキュメントには依然として古いdeepseek-chatの例が含まれているため、どちらの例も恒久的なデフォルトとして扱わず、プロバイダーのモデル名とインストール済みライブラリを確認してください。
画面が狭い場合は、表を横にスクロールするとすべての列を確認できます。
| 推論経路 | 確認すべき設定 | それが確立するもの |
|---|---|---|
| DeepSeekホスト型API | ChatDeepSeek + DEEPSEEK_API_KEY + 利用可能なプロバイダーモデル | ホスト型モデル接続。ローカル推論を確立するものではありません。 |
| ローカルで提供される重み | ChatOllama + インストール済みの正確なOllamaモデルタグ | モデルとサーバーが実際にローカルで実行される場合の、ローカル推論経路。 |
| 別の互換エンドポイント | アダプター、base_url、モデルID、エンドポイントの所有者 | API形式の一致。互換性だけでは有効なブラウザアクションを証明できません。 |
これはそれらのインターフェースから組み立てた設定例であり、完了したブラウザ実行ではありません。DEEPSEEK_MODELをプロバイダーアカウントで利用可能なモデルに設定し、APIキーはスクリプトとソース管理の外に保管してください。
import os
from browser_use import Agent, ChatDeepSeek

llm = ChatDeepSeek(model=os.environ["DEEPSEEK_MODEL"])
agent = Agent(
    task="Open https://example.com and report its visible heading. Do not submit forms.",
    llm=llm,
)
# In your existing async entry point: await agent.run()
意図的に別のエンドポイントを運用する場合を除き、ネイティブアダプターのプロバイダーデフォルトを使用してください。base_urlを変更する場合は、そのエンドポイントを誰が運用し、どのデータがマシンから出るかを記録してください。ローカルの重みについては、まずインストール済みのモデルタグとツール呼び出しの出力を確認してください。チャット応答の成功は、Browser Useのアクションスキーマ互換性を確立するものではありません。
この更新のためにDeepSeekを実行したり、ローカルの重みをダウンロードしたりはしていません。ここには新しい成功率、レイテンシ、コスト、ego(lite)の比較はありません。プロバイダーを選択する前に、自分が管理する同一のタスク、ブラウザ状態、完了チェック、リトライポリシーを使用し、請求額と失敗を別々に測定してください。ego(lite)はブラウザ実行ワークフローを変更しますが、推論がどこで行われるかは設定されたモデルが依然として決定します。
再現可能なモデルルートのレシートには何を記録すべきか?
再現可能な Browser Use の実行には、モデルラベル以上のものが必要です。要求したモデル、利用可能であればプロバイダーが報告したモデル、エンドポイントのホスト、プロバイダーアダプターとそのバージョン、ブラウザモード、タスク入力、および独立した完了チェックを記録してください。利用できないフィールドは不明のままにしてください。API キー、認証ヘッダー、Cookie、セッションのエクスポートを公開レシートに含めてはなりません。
2026年10月30日に確認した DeepSeek のクイックスタートは deepseek-flash を推奨しており、レガシーな deepseek-v4-flash および deepseek-v4-flash-vision-exp という名前は引き続き受け付けられるものの、DeepSeek-V4.1-Flash-1017 によって提供されると述べています。Browser Use のサポート対象モデルの例では、依然として DEEPSEEK_API_KEY とともに deepseek-chat が使用されています。このドキュメントの不一致は、インストール済みのアダプターとプロバイダーモデルを検証する理由であり、いずれかの組み合わせを正常に実行した証拠ではありません。
要求した名前と、返されたモデルフィールドがあればそれを別々に保持してください。受け付けられたエイリアスは不変のチェックポイント識別子ではなく、プロバイダーが報告した名前は実行間で同一の重みであることの証明ではありません。公式の OpenAI 互換 DeepSeek ベース URL は https://api.deepseek.com です。その Anthropic 互換ルートは異なります。両方の例が base_url 設定を使用しているという理由だけで、プロトコルパスを混在させないでください。
| オフライン構成 | 整合性の結果 | 未検証のまま残る項目 |
|---|---|---|
| ローカル推論と主張されたホスト型 DeepSeek エンドポイント | 却下: 宣言されたバックエンドが主張と矛盾しています。 | プロバイダーまたはモデルへのリクエストは行われませんでした。 |
| ローカルと主張された 127.0.0.1:11434 の Ollama | 構成整合性のみを理由に受理されました。 | そのプロセスが実際にローカルで計算するのか、それとも他の場所へプロキシするのか。 |
| ローカルと主張されたリモートの例示エンドポイントの Ollama | 却下: エンドポイントがループバックではありません。 | リモートエンドポイントには接続していません。 |
| 明示的にホスト型と宣言されたホスト型 DeepSeek エンドポイント | 構成整合性のみを理由に受理されました。 | 可用性、モデル解決、コスト、タスク完了。 |
この更新のために4つのオフライン構成ケースを実行しました。矛盾するローカル推論の主張2件は却下され、2つの構成は内部整合性のみを理由に受理されました。チェッカーは固定入力を使用し、エンドポイントやモデルを呼び出さず、Browser Use SDK もインポートしませんでした。表はそのチェックの完全な範囲を示しています。
ループバックエンドポイントはリクエストを他の場所へ転送する可能性があります。プロセスとバックエンドの構成を確認し、推論がマシン上に留まったと主張する前に、承認された実行の実際のトラフィックを検査してください。チェッカーは、モデルの可用性、アクションスキーマのサポート、ブラウザタスクの成功、またはプロバイダーの現在のエイリアスルーティングを検証できません。
ego(lite) は、選択したエージェントがそのモデルを提供する一方で、可視のブラウザ実行環境を提供できます。これによりブラウザのアクションは検査可能になりますが、ホスト型の DeepSeek 推論がローカルになるわけではありません。それがタスク要件である場合は、検証済みのローカルモデル/バックエンドを使用し、その後ブラウザの結果を独立して確認してください。ダウンロード可能なチェッカーは事前確認の補助であり、パフォーマンスやプライバシーの認証ではありません。
Browser Use のプロバイダーアダプターの例を確認する
DeepSeek のモデル名とプロトコルエンドポイントを確認する
ego(lite) を使ったローカルモデルのワークフローを見る
ローカルのブラウザエージェントに必要なVRAMとコンテキスト長はどれくらいか
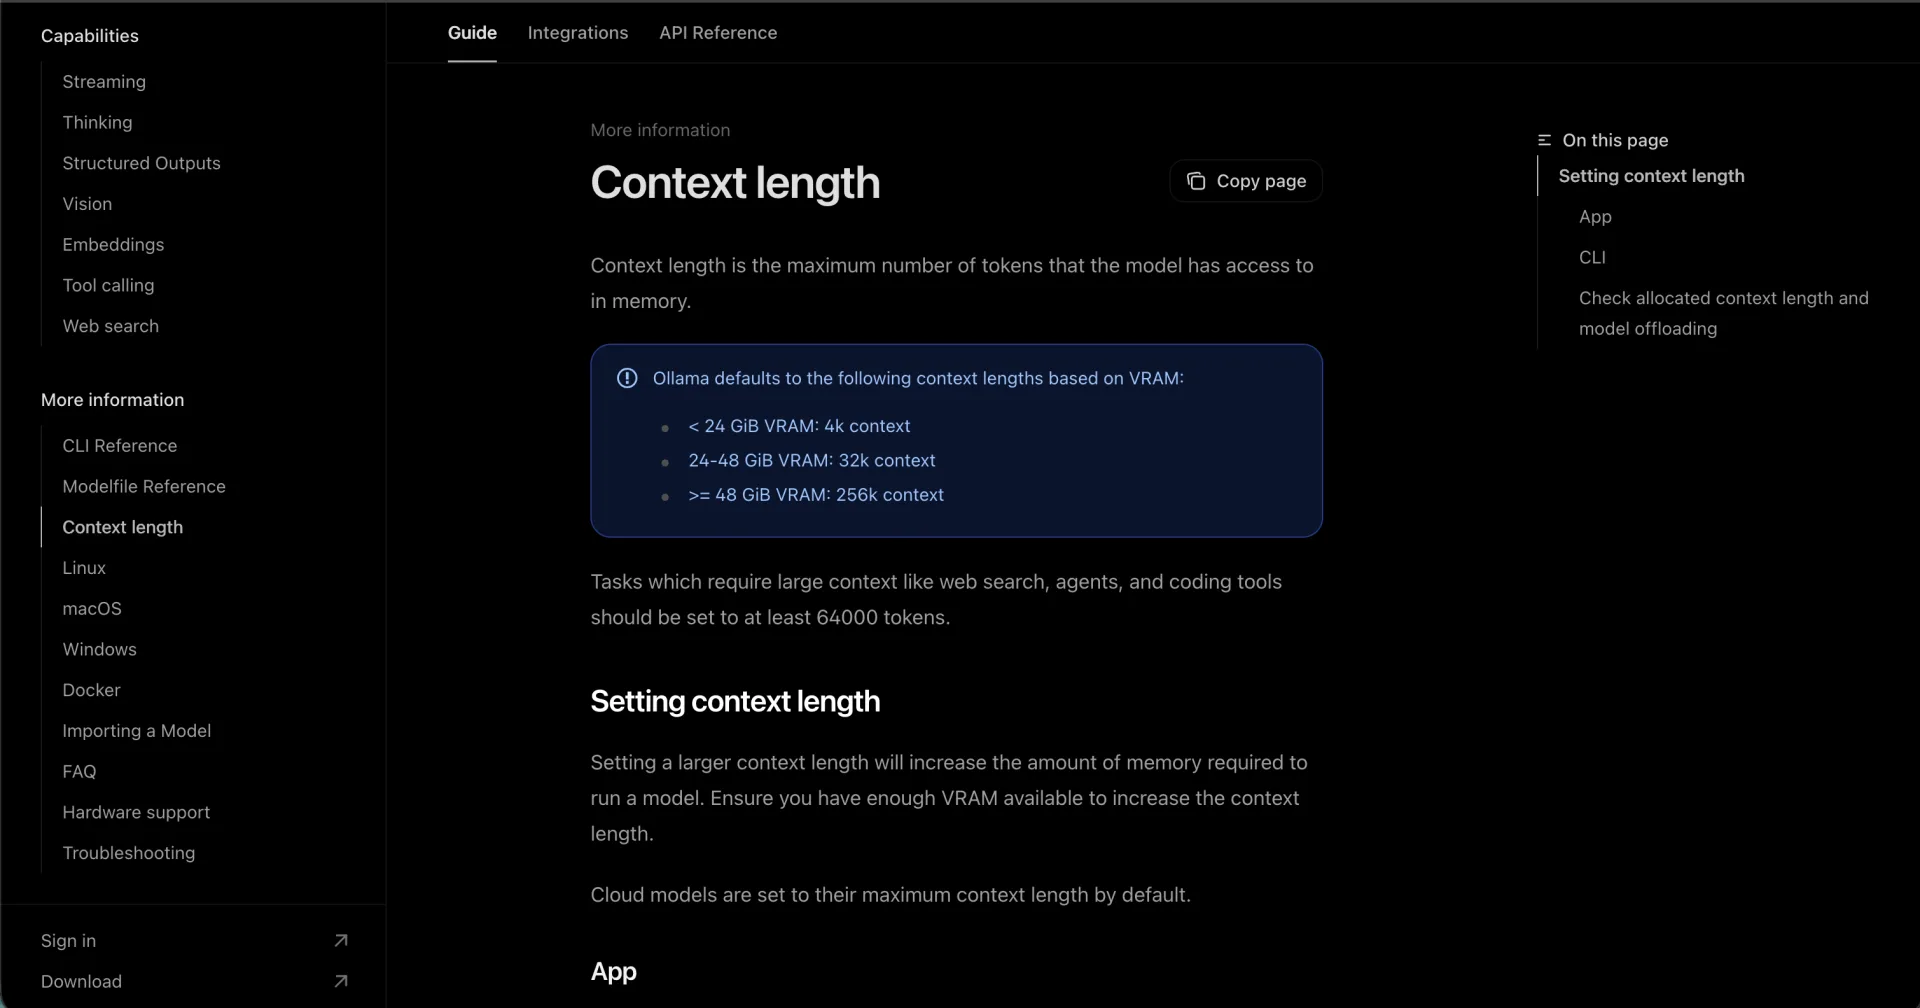
メモリの話は、ほぼコンテキスト長の話です。Ollamaのコンテキスト長ドキュメントは、利用可能なVRAMから既定値を決めています。24 GiB未満は4kトークン、24から48 GiBは32k、48 GiB以上は256kです。
| 利用可能なVRAM | Ollamaの既定コンテキスト |
|---|---|
| 24 GiB未満 | 4kトークン |
| 24から48 GiB | 32kトークン |
| 48 GiB以上 | 256kトークン |
この既定値はエージェントには合いません。同じページは、Web検索、エージェント、コーディングツールのように大きなコンテキストを要する作業では少なくとも64,000トークンに設定すべきこと、コンテキスト長を上げると必要なメモリも増えることを述べています。OllamaはモデルのCPUオフロードも警告しており、ollama psはPROCESSORの内訳と割り当てられたCONTEXTを示すので、両方を確認できます。
同じドキュメント群にある具体的なダウンロードサイズです。llama3.1:8bは4.9GB、gemma4:e2bは約7.2GBで8GBの空きVRAMまたはユニファイドメモリが推奨され、ego(lite) のローカルモデルチュートリアルは4bit量子化のqwen3.8:27b(約18GBのダウンロード)を使い、実行にはコンテキストや他のアプリの分のメモリも必要だと注記しています。
請求のもう半分はページの証拠です。ブラウザエージェントは各ステップでページの表現をモデルに送り、その表現は小さくありません。別のブラウザエージェントハーネスでの話ですが、Hacker Newsのフロントページのアクセシビリティスナップショット1回分を測ったところ、38,285文字、およそ9から10Kトークンでした。Browser Use自身のページシリアライズは異なりますが、予算の形は同じです。モデル、ツールスキーマ、ページの証拠、履歴が1つのコンテキストウィンドウを共有します。
実際によく起きる失敗は何か
失敗パターンは、ドキュメントと私たちのテストで繰り返し現れる3つで、それぞれ最初に確認すべき点が異なります。
1つ目は不正なツール呼び出しです。Browser Useは小さめのQwenモデルについて、前述の平坦な引数とネストした引数の例でこれを文書化しています。エージェントは実行できない呼び出しを受け取り、ループによっては同じ誤った形を繰り返すか、ステップ失敗として報告します。文書化された対処は、正しい具体例をプロンプトに入れることです。
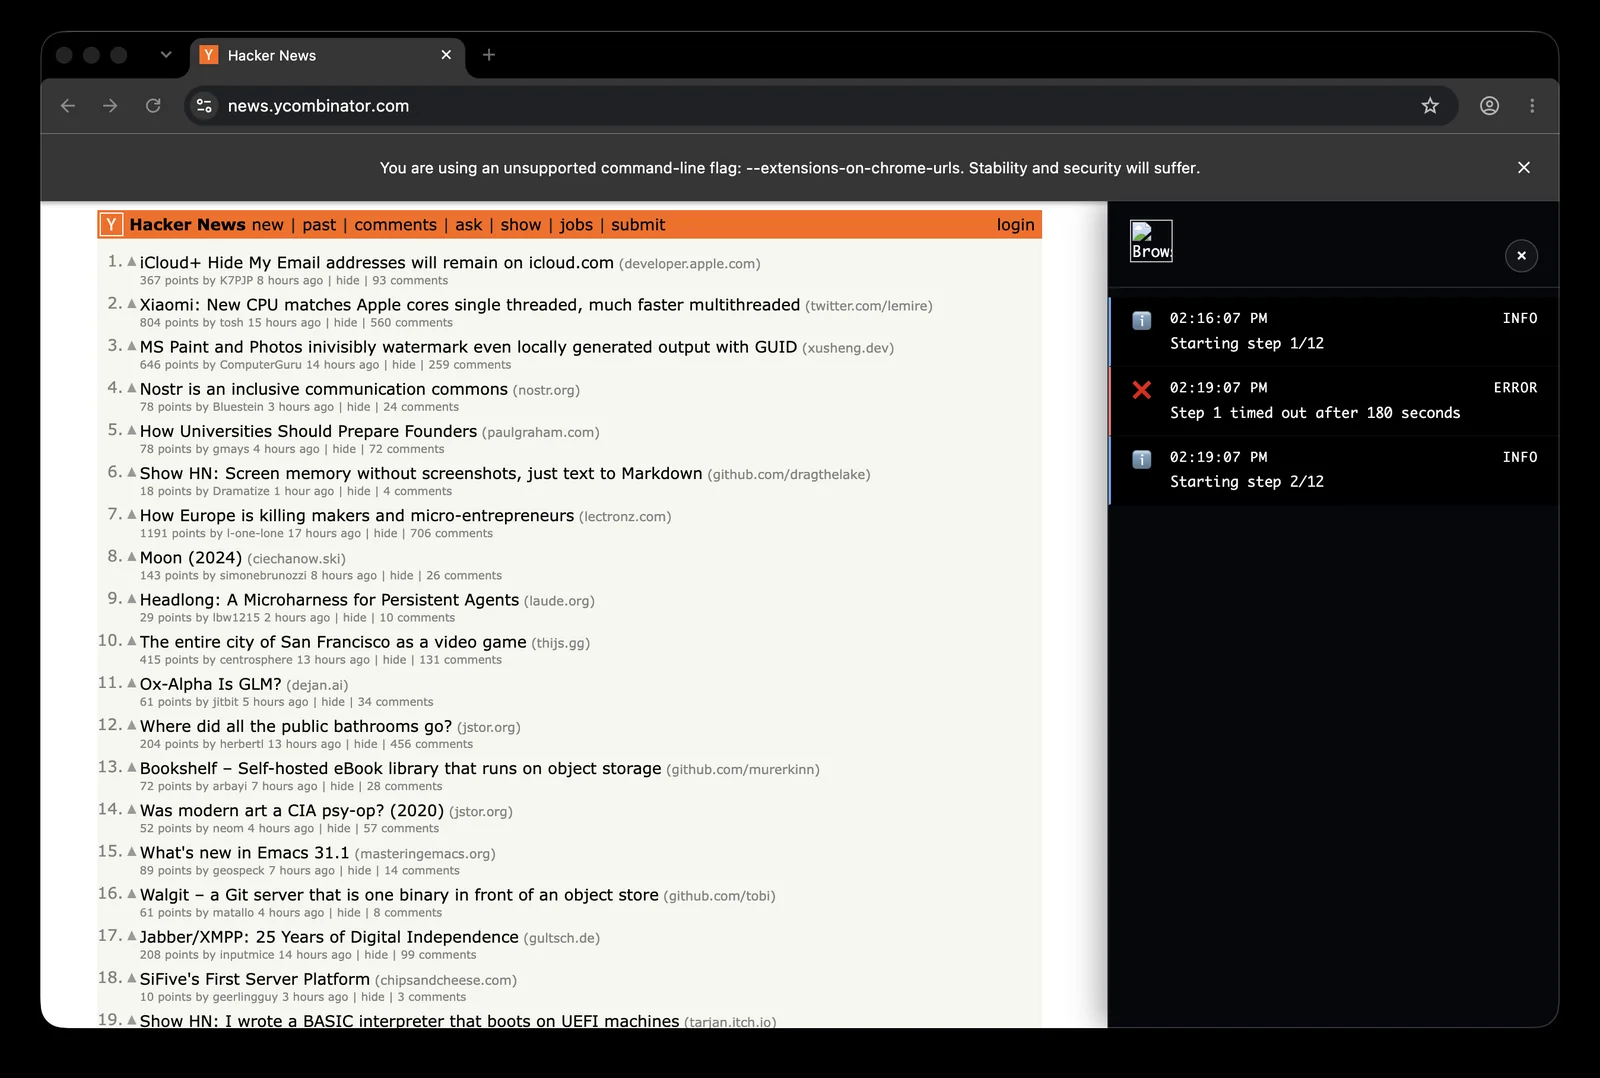
2つ目はタイムアウトで、これは私たちが実際に観測したものです。このリポジトリの2026年8月の比較テストでは、Browser Use 0.13.8とネイティブのOllamaアダプター、qwen3:4bの組み合わせがステップ1から先へ進めませんでした。1回目の試行では75秒のモデルタイムアウトが4回発生し、180秒のタイムアウトに変えた2回目と3回目でも構造化された結果は出ませんでした。同じインストール済みブラウザ層からモデルを外すと、BrowserSessionとPage.evaluateで正しい表示行を4.92秒で返しました。この分離が診断の要点です。失敗したのはモデルのループであり、ブラウザではありません。
3つ目は、モデルではなくパイプラインが失う状態です。Ollamaのストリーミングのドキュメントは、ストリーミングでツール呼び出しを扱う場合、thinking、content、tool_callsのすべてのチャンクを集め、ツール結果と一緒にまとめて返す必要があると明記しています。テキストだけを保持するハンドラーは呼び出しを落とします。Browser Useが文書化する状態の罠はもう2つあります。is_done()はタスクが成功したのではなく終端のdoneアクションが出たことを意味し、is_successful()はエージェント自身の評価です。実行は完了したように見えて、間違っていることがあります。
| 失敗 | 見える症状 | 最初の確認 |
|---|---|---|
| 不正なツール呼び出し | エージェントが呼び出しを拒否する、または同じ誤った形を繰り返す | 引数を期待されるアクションオブジェクトと比較する |
| モデルのタイムアウト | ステップ1が完了せず、構造化された結果も現れない | 同じブラウザタスクをモデルなしの経路で実行する |
| ツール呼び出しの取りこぼし | ストリームの呼び出しが実行者に届かない、またはループが止まる | ストリームハンドラーがcontentだけでなくtool_callsも保持しているか確認する |
実行が本当に成功したかを確認する方法
検証には3つの層があり、モデルが最も予測しにくい構成要素であるローカル実行では3つすべてが必要です。
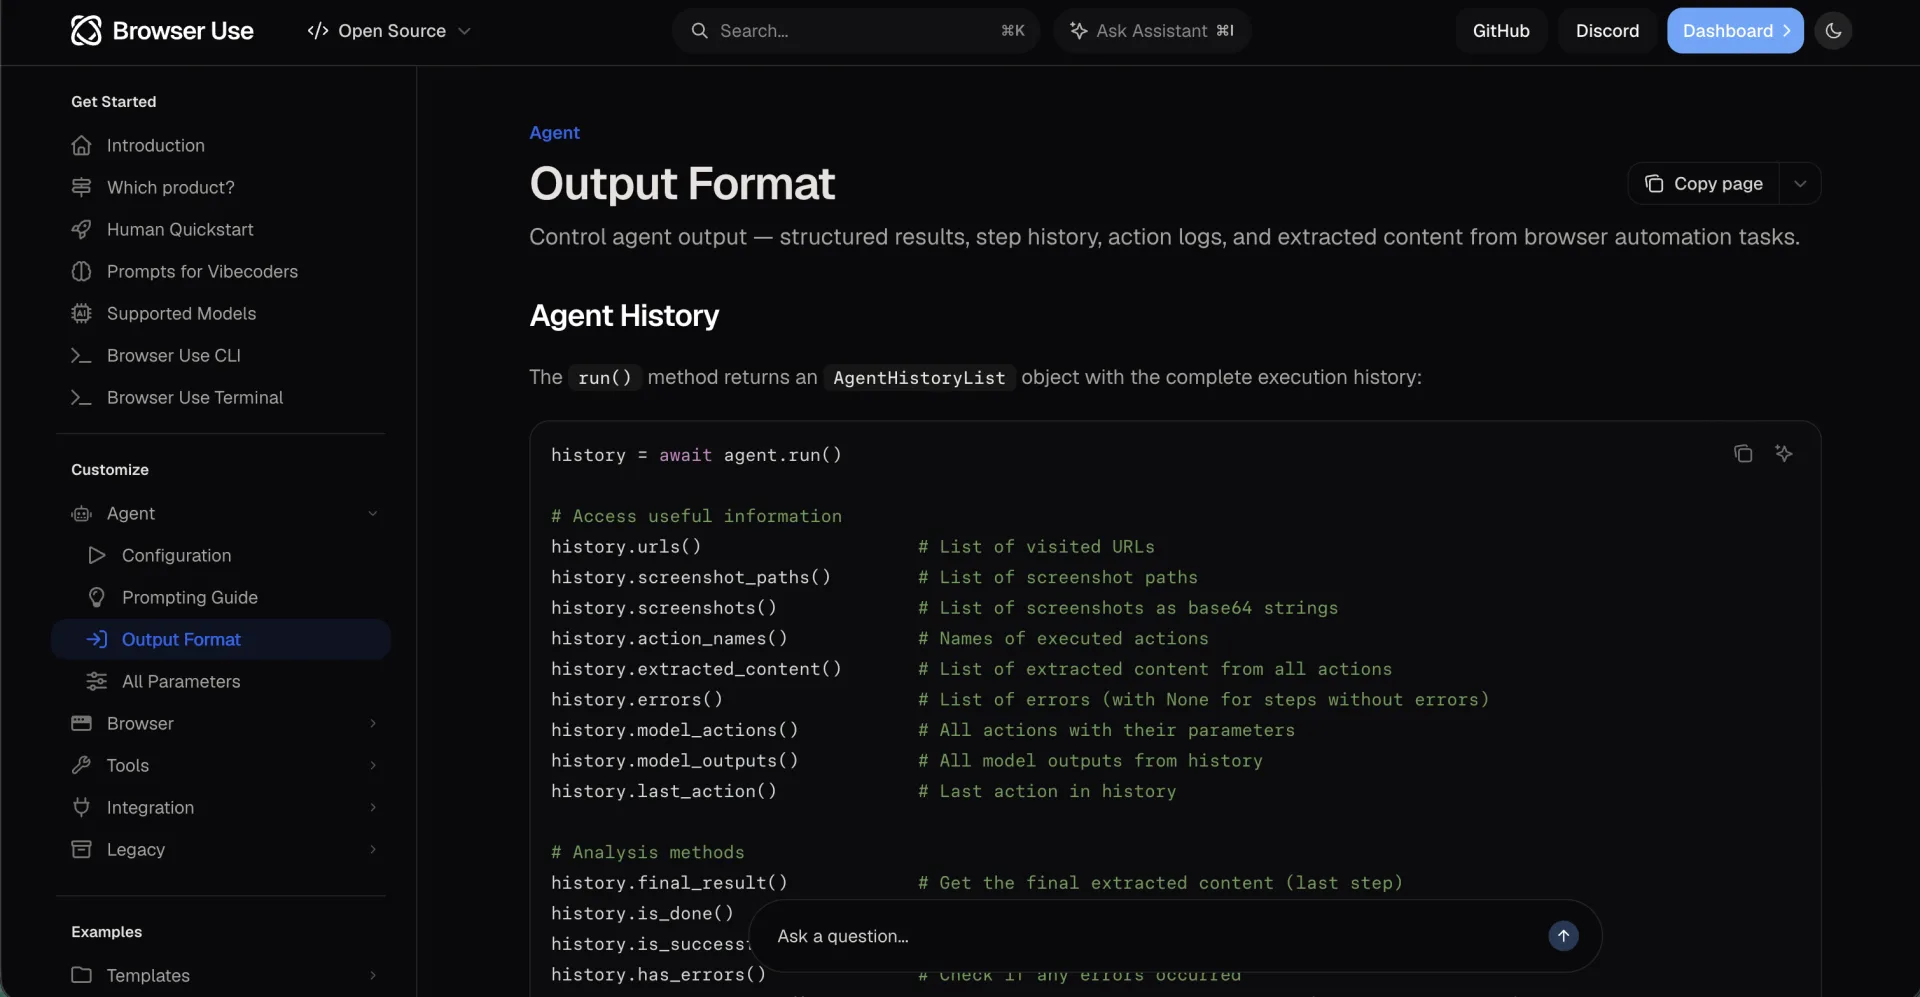
- 要約ではなく履歴を読む。 output-formatのドキュメントにはagent.run()が返すもの、errors()、action_names()、final_result()、screenshot_paths()、そして出力モデルスキーマを使った場合のstructured_outputが一覧されています。どのアクションが実際に実行され、どのエラースロットが空のままだったかを確認します。
- 結果を決定論的に読み直す。 この比較テストでは、スキーマは正しいが内容が誤った抽出を別ツールで見つけたのが、元ページの2回目の決定論的な読み取りでした。モデルのタイムアウト後に正しい行を確認したのも、Browser Useのページ評価の経路です。モデル呼び出しは書き手になれますが、唯一の読み手であってはいけません。
- チャットではなくマシンを確認する。 ollama psは割り当てられたコンテキストと、モデルがGPUとCPUのどちらにあるかを示します。CONTEXTが64kを大きく下回る場合や、PROCESSORにCPUオフロードが出ている場合は、モデルを疑う前に実行環境を直します。
外部への操作について、ドキュメントは率直です。フォームの送信や購入の完了のような重要な結果は、送信先システム側で確認するよう求めています。これはホスト型モデルだけでなく、ローカルモデルにもそのまま当てはまります。
ブラウザがego(lite) の場合、公式のトラブルシューティングには見落としやすいブラウザ側の確認があります。モデルが応答するのにブラウザが動かないときは、エージェントが操作を説明しているだけでなくツール呼び出しを発行しているかを確認し、ego-browserスキルを読み込み、ローカルコマンドの実行権限があるかも確認します。ブラウザについて文章を生成することは、ブラウザの操作ではありません。
ホスト型モデルを選ぶべきなのはどんなときか
Browser Use自身のドキュメントはこの問いに一方向の答えを出しています。ホスト型モデルのChatBrowserUseを推奨し、トップモデル並みの精度を保ちながらタスクをより速く完了すると説明し、条件を満たす新規アカウントには15ドルの初回クレジットがあります。これはベンダーの主張であり、プロジェクトが最も手厚く支える経路でもあります。
ローカルが正解になるのは、制約が能力ではなくプライバシーや独立性である場合です。プロンプトとページ内容をマシンの外に出せない、または外部への推論課金なしで実行したいなら、そこに到達する方法はローカルモデルだけです。代償は明確で、メモリ、コンテキスト、レイテンシ、ツール呼び出しの形式を自分で担うことになります。
| 状況 | 適した経路 | 理由 |
|---|---|---|
| ページ内容やプロンプトをマシンの外に出せない | ローカルモデル | 推論リクエストがマシンの外に出ず、コストはハードウェア側に移る |
| 最初の試作、または対象サイトが難しい | ホスト型モデル | Browser Use自身の推奨どおり、ツール呼び出しの整形と長いループはベンダー側の課題になる |
| 多数のページをまたぐ長い多段階リサーチ | ホスト型モデル | ローカルの4B実行はステップ1すら通過しなかった。長いループは信頼性の基準を上げる |
| 検証付きで狭く反復可能な抽出 | ローカルモデル | 小さいタスクと決定論的な確認の組み合わせが、ローカルモデルに最も見込みがある |
| 多数の並列ブラウザ、またはCIパイプライン | クラウドのブラウザ基盤 | 1台のデスクトップブラウザはスケールアウトしない |
正直な答えはハイブリッドであることが多いです。ホスト型モデルで下書きと選別を行い、狭く検証済みのタスクを1つローカルモデルへ移し、印象ではなく合格した結果を比較します。
モデルがローカルのとき、ego(lite) はどこで役立つか
ego(lite) はローカルで可視のChromiumブラウザであり、エージェントはego-browserスキルまたはCLIを通して操作します。ループのどちらの半分もクラウドアカウントを必要としない自然な組み合わせです。モデルはOllamaとしてマシン上で動き、ブラウザもマシン上で動き、ログイン状態は普段使っているプロファイルから来ます。
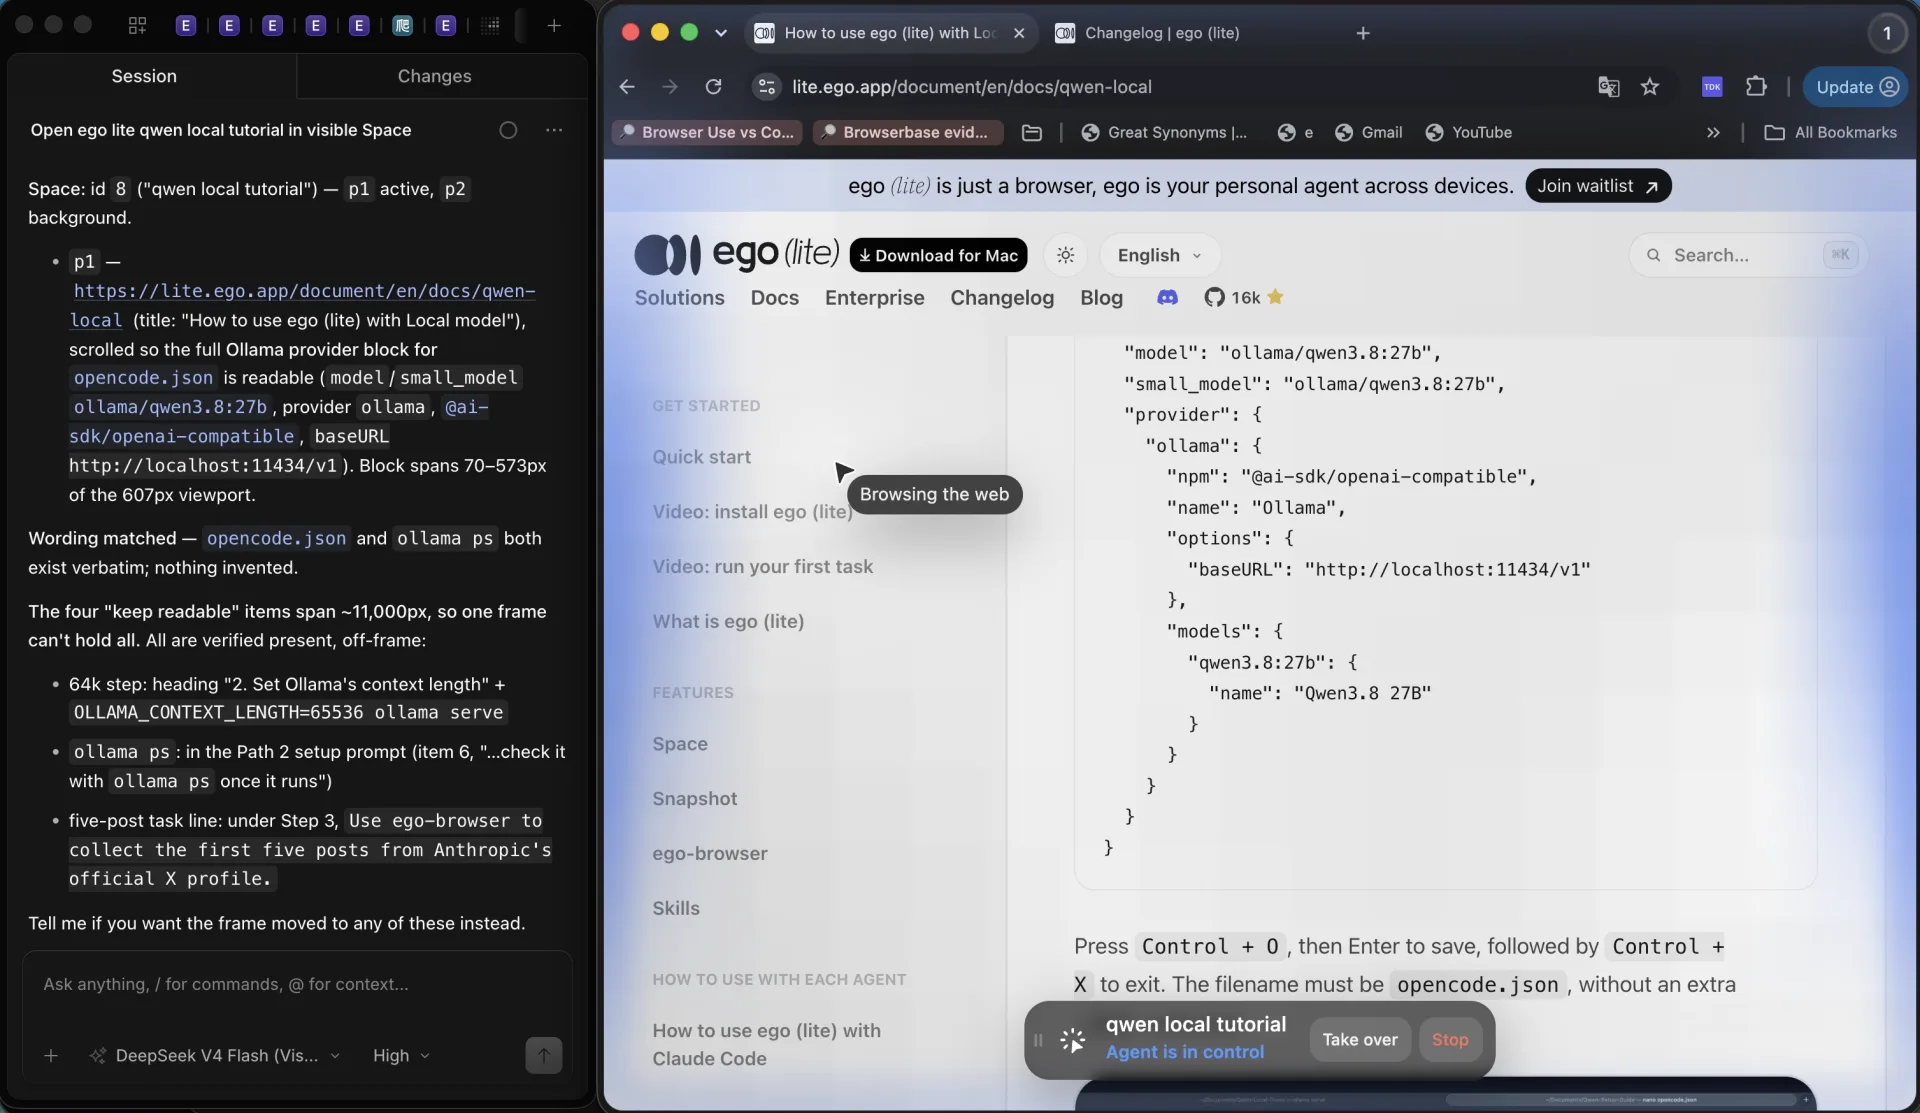
公式のローカルモデルチュートリアルは、Ollama、OpenCode、ego(lite) を1台のMacで使うループ全体を文書化しています。再現手順は次のとおりです。ego(lite) をインストールしてオンボーディングを完了すると、ego-browserスキルがエージェントのスキルディレクトリに書き込まれます。Ollamaのコンテキスト長を64k以上に設定します。ollama pull qwen3.8:27bでモデルを取得します。文書化されたOllamaプロバイダーブロックをopencode.jsonに追加します。http://localhost:11434/v1/modelsにモデルが並び、ollama psが64kのコンテキストを示すことを確認します。その後/ego-browserを読み込み、チュートリアル自身のタスク「Use ego-browser to collect the first five posts from Anthropic's official X profile.」を実行します。
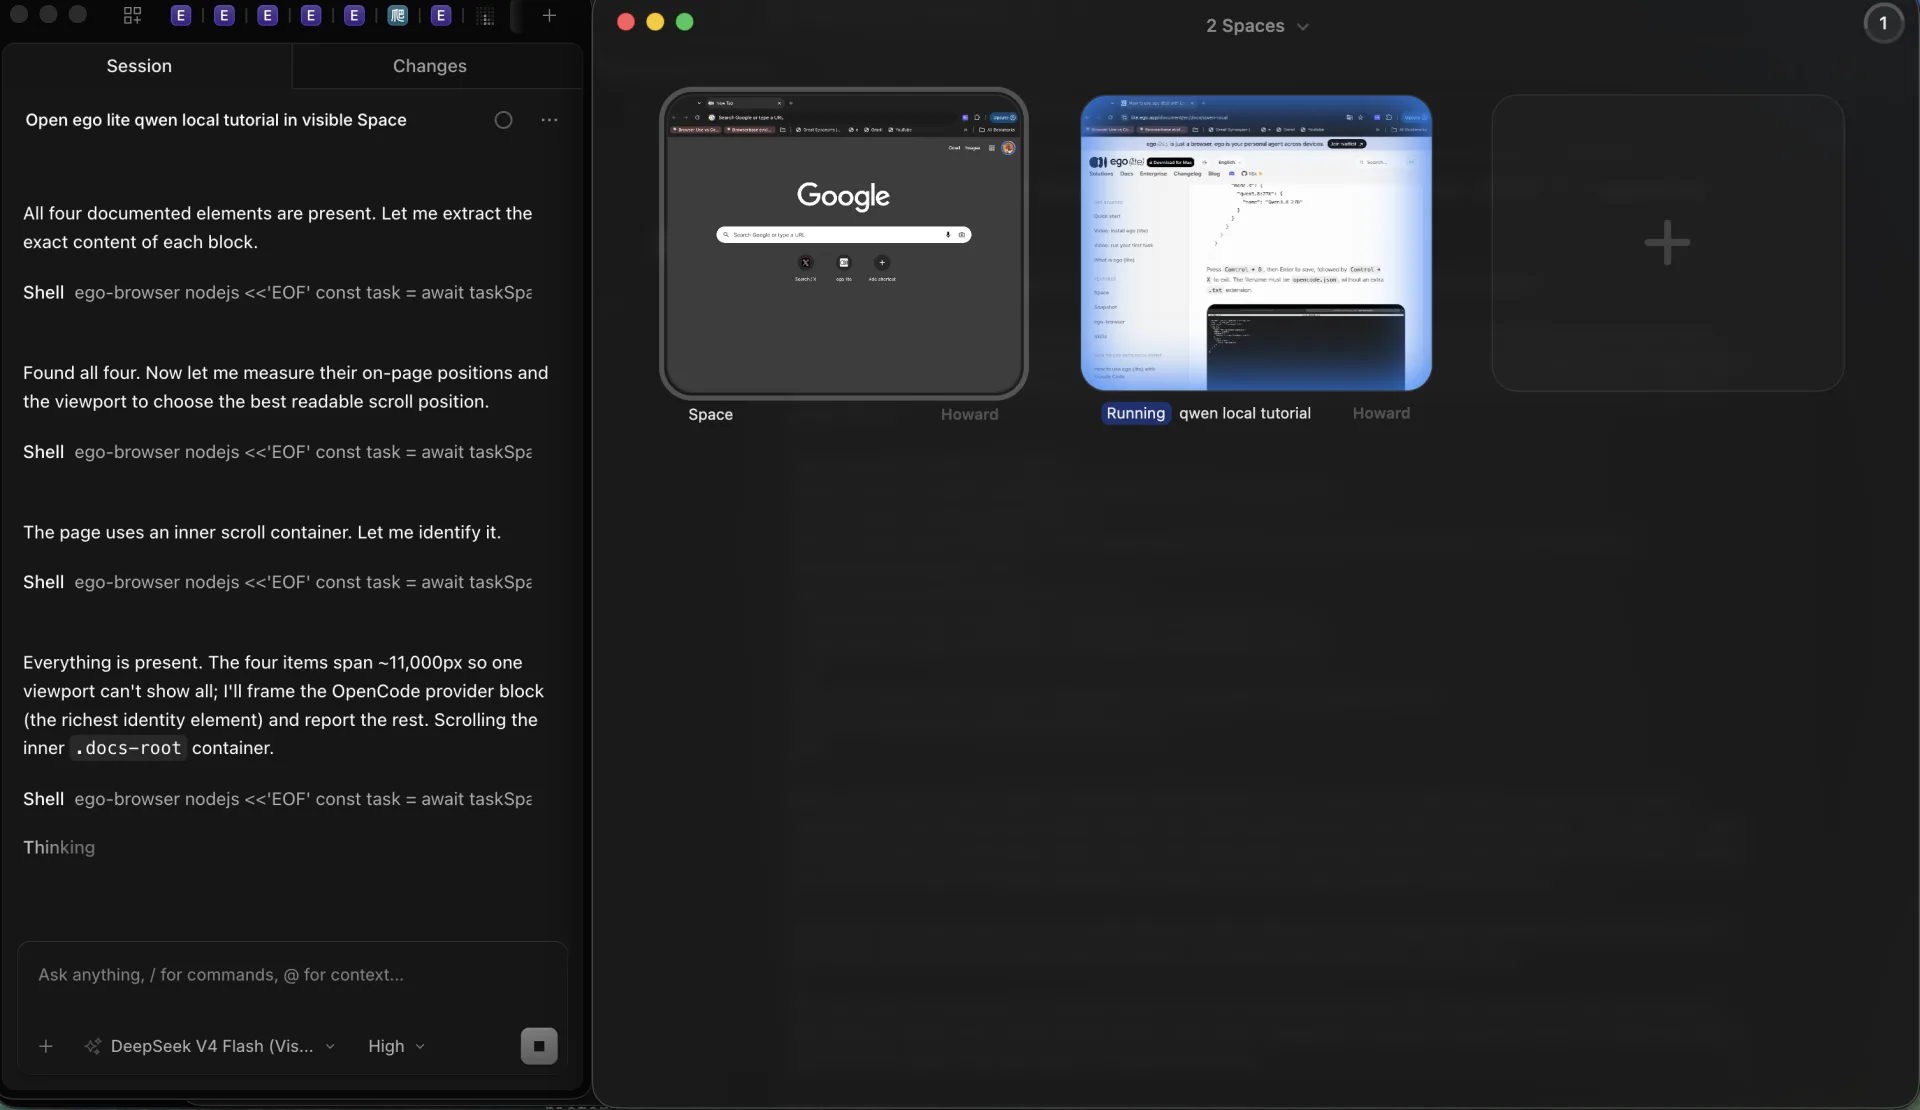
判断は1行でまとめられます。読み取り専用で、すでに持っているログインの背後にあり、ページ内容をマシンの外に出したくないタスクなら、ローカルモデルとego(lite) の組み合わせがその3つすべてを満たします。5件の投稿を集めるあのタスクは最初のテストに適しています。エージェントが応答するのにブラウザが動かない場合は、まずスキルの読み込みと権限を直します。1ステップに数分かかる場合は、タイムアウトを延ばすのではなく、タスクを小さくするかメモリを空けます。
制限は現実にあり、率直に述べておく価値があります。ego(lite) はmacOS向けのデスクトップブラウザであり、CIコンテナで動かせるヘッドレスブラウザではなく、テストフレームワークでもありません。Spaceはエージェントの作業をあなたのブラウジングから分離しますが、それはタスクの分離であり、堅牢なマルチテナント境界ではないため、伸縮する並列ワークロードでクラウドサンドボックスの代わりにはなりません。ローカルモデルもボトルネックのままです。ブラウザ側の改善で4Bモデルが長いタスクを計画できるようにはなりません。2026年9月20日に確認した変更履歴では、最新リリースは2026年9月12日の0.5.0.32で、2026年9月8日の0.5.0.28が新しいego-browserスキルとツールセットを追加し、ブラウザをChromium 152に更新しました。
ego(lite) のクイックスタートではインストールとオンボーディングを扱っており、実行中のリリースは変更履歴で確認できます。セッションの期限切れ、CAPTCHA、2FA、サイトの規約は、本記事のどの経路にも引き続き適用されます。
よくある質問
Browser UseはOllama経由でローカルモデルに対応していますか
はい。supported-modelsページはOllamaを文書化し、ChatOllama(model="llama3.1:8b")を示しています。ローカルモデルの品質ベンチマークは公開していないため、タスクの信頼性は自分で確かめる必要があります。
Browser Useに最も適したローカルモデルはどれですか
公式のランキングはありません。文書化されたOllamaの例はllama3.1:8bで、ドキュメントが明確に推奨する唯一のQwenモデルはホスト型のqwen-vl-maxです。どのローカルモデルも4つの確認で選別してください。ツール呼び出しが出るか、アクションスキーマの形が正しいか、構造化出力が解析できるか、マルチターンのループが続くかです。
小さなローカルモデルが、エージェントに拒否されるツール呼び出しを返すのはなぜですか
文書化されている最も一般的な理由は、アクションスキーマの形です。小さめのQwenモデルは、エージェントがネストしたオブジェクトを期待する箇所に平坦な引数を返したことがあります。文書化された修正は、正しいアクション形式の具体例をプロンプトに追加することです。
ローカルのブラウザエージェントを動かすには、どれくらいのVRAMが必要ですか
Ollamaの既定は、VRAMが24 GiB未満なら4kコンテキスト、24から48 GiBなら32k、48 GiB以上なら256kです。ドキュメントはエージェントやコーディングの作業に少なくとも64,000トークンを設定するよう述べています。コンテキストを上げればメモリ使用量も増えます。モデルがCPUにオフロードされると応答は遅くなります。ollama psはコンテキストとプロセッサの内訳の両方を示します。
ローカル実行が実際に成功したかは、どうすれば分かりますか
doneフラグだけを信用してはいけません。is_done()は終端のdoneアクションを報告するだけで、is_successful()はエージェント自身の評価です。履歴でエラーと実行済みアクションを読み、決定論的な確認で結果を読み直し、外部への結果は送信先システムで確認してください。
ローカルモデルは本当に無料ですか
Browser UseのPythonライブラリは無料でMITライセンスであり、ローカルモデルは推論の請求を増やしませんが、代わりにハードウェア、メモリ、レイテンシで支払います。リポジトリのFAQも明快です。モデルの推論とホスト型ブラウザは別々のコストであり、ローカル構成はハードウェアとモデルの要件に左右されます。
ローカルモデルはクラウドサンドボックスの代わりになりますか
いいえ。ローカルモデルとego(lite) のようなデスクトップブラウザは、1人のユーザーの1台のマシンで動きます。分離されたブラウザの群れではなく、Spaceはマルチテナントのセキュリティ境界ではなくタスクの分離です。
プライバシーや独立性が制約であるとき、ローカルモデルはBrowser Useを動かす正当な方法であり、文書化されたOllamaの経路は午後ひとつで試せる規模です。期待値は正しく持ってください。配線は文書化されていますが、品質の余裕は文書化されていません。だからモデルを選別し、決定論的な確認で測り、ローカル構成で終えられないタスクのためにホスト型モデルを手の届くところに残しておきましょう。