
Paginar no web scraping não é só chegar à página seguinte. O difícil é saber se ainda há dados para coletar e quando a lista de fato acabou. A maioria dos sites usa um de três padrões, páginas numeradas, Load More ou scroll infinito, e cada um pede uma estratégia de navegação, uma condição de espera e uma regra de parada diferentes. Erre nisso e o crawler pode parar cedo sem nunca lançar um erro.
Se os dados já estão no HTML ou em um endpoint JSON, em geral você não precisa de navegador; HTTP puro é mais simples e mais rápido. O navegador passa a ser útil quando a lista depende de renderização no cliente, de uma sessão autenticada, de tokens gerados na página ou de um scroll de verdade. E quando esses dados dependem de um navegador no qual você já está autenticado, o ego (lite) deixa um agente de IA rodar a mesma lógica de paginação dentro dessa sessão existente, em vez de reconstruir o estado de login.
Nas seções abaixo, testamos páginas numeradas, Load More e scroll infinito com uma pergunta só: a lista realmente acabou, ou o crawler simplesmente parou de pedir mais? Os exemplos usam um fixture local repetível com 135 linhas em páginas numeradas, 81 linhas renderizadas atrás do Load More e um feed infinito de 60 itens. No fim, o crawler não só pagina: ele registra onde parou, trata duplicatas e linhas perdidas e verifica se os dados coletados estão completos.
Como saber qual modo de paginação você tem
Três observações fecham a classificação. Mudar a URL ou clicar em um link numerado altera o conjunto de resultados: isso é paginação numerada. Um botão cujo rótulo promete mais conteúdo acrescenta linhas sem mudar a URL: isso é load more. Linhas que aparecem conforme você rola, sem controle para clicar, são scroll infinito. Quando a página mistura padrões, trate cada transição como um modo próprio, em vez de forçar um único loop a cobrir os dois.
Uma checagem rápida no navegador resolve mais depressa do que ler o código: abra o DevTools, observe o painel de rede e interaja uma vez. Uma requisição de navegação com parâmetro de página é paginação numerada. Uma requisição JSON ou HTML em segundo plano disparada por um clique é load more. Requisições que se repetem conforme você rola são scroll infinito, e a resposta costuma trazer o próximo offset, um presente para o crawler.
Páginas numeradas: derive a regra de URL e pare no momento certo
A paginação numerada é o modo mais amigável porque o estado mora na URL. Derive a regra pelas três primeiras páginas: qual parâmetro muda, se é número de página ou offset, e se o tamanho da página é fixo. A regra precisa ser expressável como uma função, e uma função correta produz a página 4 a partir da 3 sem visitar nada no meio.
// Derive once, then verify against page 2 and page 3 before trusting it.
const pageUrl = (n) => `https://example.com/listings?page=${n}`;

let page = 1;
const rows = [];
while (true) {
  await browserPage.goto(pageUrl(page));
  const batch = await browserPage.locator("tr.row").evaluateAll((nodes) =>
    nodes.map((node) => ({
      id: node.dataset.id,
      title: node.querySelector(".title").textContent.trim(),
      price: Number(node.querySelector(".price").textContent.replace(/[^0-9.]/g, "")),
    })),
  );
  if (batch.length === 0) break;
  rows.push(...batch);

  const hasNext = (await browserPage.locator("a#next").count()) > 0;
  if (!hasNext) break;
  page += 1;
}
O término merece mais cuidado do que costuma receber. Um link next ausente e um lote vazio são sinais reais de fim; um total fixo de páginas não é, porque as listas crescem e o número gravado hoje estará errado no mês que vem. Na execução do fixture, o crawler percorreu as páginas 1 a 5, coletou 135 linhas em 80 milliseconds e parou quando o link next desapareceu. Uma dessas cinco requisições devolveu 503 na primeira tentativa, o crawler tentou a mesma página uma vez e a nova tentativa funcionou.
Duas regras mantêm o loop honesto. Primeiro, faça uma pausa entre as requisições de página em vez de dispará-las o mais rápido possível, e respeite os termos do site e o protocolo de exclusão robots descrito em RFC 9309. Em segundo lugar, trate uma página repetida como sinal de parada quando a lista deveria estar ordenada, porque a paginação que ignora os próprios parâmetros pode, do contrário, girar para sempre.
Load more: clique, espere e deduplique
O load more esconde o estado atrás de um botão, então o crawler precisa criar o crescimento: clicar, esperar até a contagem de linhas de fato subir, coletar o que é novo e repetir até o botão sumir ou deixar de mudar qualquer coisa. A espera é onde a maioria das implementações falha. Uma pausa fixa até funciona numa conexão rápida e corta a lista em silêncio numa conexão lenta.
await browserPage.goto("https://example.com/listings");

while (true) {
  const button = browserPage.locator("#load-more");
  if ((await button.count()) === 0) break;

  const before = await browserPage.locator("tr.row").count();
  await button.click();
  await browserPage.waitForFunction(
    (n) => document.querySelectorAll("tr.row").length > n,
    before,
    { timeout: 10000 },
  );
}

const rows = await browserPage.locator("tr.row").evaluateAll((nodes) =>
  nodes.map((node) => ({ id: node.dataset.id, title: node.textContent.trim() })),
);
Na execução do fixture, 4 lotes de 20 linhas chegaram em 273 milliseconds, e a lista visível tinha 81 linhas contra um dataset de 80. A linha extra era uma duplicata que o fixture planta para modelar uma realidade comum: o mesmo registro chegando duas vezes entre lotes. A linha de status da própria página lia "Loaded 81 of 80", um bom lembrete de que o contador renderizado pelo site não é fonte de validação. Deduplique num identificador estável, como o record id da linha, não no título visível, e você remove exatamente essa uma duplicata.
Scroll infinito: gatilhos, estabilidade de altura e regras de parada
O scroll infinito não tem botão nem URL, então o gatilho e a condição de parada precisam ser inferidos. O gatilho costuma ser um elemento sentinela entrando no viewport ou um limiar de posição de scroll. A condição de parada é onde entra o julgamento, porque a lista não anuncia o fim de um jeito que você possa clicar.
Vale mostrar uma falha medida porque é a falha com a qual a maioria dos crawlers sai de fábrica. Rolar até o fim uma vez e checar se a contagem de linhas cresceu, sem esperar o próximo lote renderizar, reporta "no growth" na hora: o fixture parou em 15 of 60 linhas, um lote adentro, enquanto a rede já tinha sido pedida pelo lote seguinte. A checagem não errou o instante; errou ao tratar um momento quieto como o fim da lista.
A versão confiável espera uma condição observável e só então confirma o fim em várias checagens, não em uma. Role, espere a contagem de itens crescer ou a página declarar que o feed acabou, e só quando nenhuma das duas coisas acontecer por 3 checagens consecutivas trate a lista como terminada. No fixture, os mesmos 60 itens completaram em 4 rodadas de scroll com zero paradas falsas, e a linha de status final lia "End of feed (60 of 60)".
let stableChecks = 0;
while (stableChecks < 3) {
  const items = await browserPage.locator("article.post").count();
  await browserPage.evaluate(() => window.scrollTo(0, document.body.scrollHeight));

  const grew = await browserPage
    .waitForFunction(
      (n) =>
        document.querySelectorAll("article.post").length > n ||
        /end of feed/i.test(document.body.innerText),
      items,
      { timeout: 3000 },
    )
    .then(() => true)
    .catch(() => false);

  stableChecks = grew ? 0 : stableChecks + 1;
  if (!grew) await browserPage.waitForTimeout(700);
}
Dois detalhes separam um loop estável de um instável. A estabilidade de altura deve ser julgada pela contagem de itens extraídos, não pela altura do documento, porque imagens lazy e anúncios mudam a altura sem acrescentar registros. E o scroll precisa de fato redisparar o loader do site: implementações feitas sobre a Intersection Observer API disparam em mudanças de interseção, então alternar as posições de scroll é mais confiável do que deixar a página parada no fim.
Grave o estado do crawl e retome depois de uma queda
Os três modos compartilham um requisito: a execução precisa sobreviver à própria interrupção. Grave um checkpoint depois de cada lote concluído, com o modo, a posição e os registros coletados até ali, e faça do resume o caminho padrão, não um especial. No fixture, o crawl numerado foi interrompido depois da página 2 com 54 linhas no checkpoint. Um processo novo leu o checkpoint, continuou da página 3 e terminou com as mesmas 135 linhas e 133 ids únicos de uma execução sem interrupção.
import { readFileSync, writeFileSync } from "node:fs";

const CHECKPOINT = "./crawl-state.json";
const save = (state) => writeFileSync(CHECKPOINT, JSON.stringify(state));
const load = () => {
  try {
    return JSON.parse(readFileSync(CHECKPOINT, "utf8"));
  } catch {
    return { mode: "numbered", lastPage: 0, rows: [] };
  }
};

const state = load();
for (let page = state.lastPage + 1; page <= 5; page += 1) {
  state.rows.push(...(await crawlPage(page)));
  state.lastPage = page;
  save(state); // checkpoint after every page
}
O checkpoint também muda a depuração. Quando o crawl de fato produz uma contagem errada, você inspeciona o arquivo de estado em vez de rerodar o trabalho inteiro, e a posição gravada ali diz qual lote refetchar.
Duplicatas, linhas perdidas e falsas últimas páginas
Três sintomas cobrem a maior parte dos bugs de paginação, e cada um deixa assinatura nos dados, não no código. Duplicatas aparecem quando um lote se sobrepõe ao vizinho, o que acontece quando a lista por baixo reordena entre requisições e o identificador estável se repete. O fixture reproduziu isso exatamente: o mesmo id apareceu uma vez na página 2, de novo na página 3 e outra vez dentro da página 5. As duas duplicatas sumiram com um dedupe baseado em id.
Linhas perdidas em geral significam espera curta demais ou página pulada. Se o total falta exatamente um lote, olhe a interação antes da falta; se falta uma página, olhe o incremento do loop. O 503 transitório do fixture é o outro sabor desse bug: sem retry, a página 3 não teria contribuído nada e a execução teria reportado 106 linhas sem erro nenhum.
Uma falsa última página é a mais perigosa, porque o crawl reporta sucesso com menos dados. Acontece quando uma página devolve zero linhas por problema de sessão ou de renderização, e não porque a lista acabou, e o loop trata os dois casos igual. Distinga-os sondando de novo: peça a próxima página após um atraso curto e exija um marcador real de fim ou duas respostas vazias consecutivas antes de aceitar o término.
Valide contagens e a completude dos campos
Validar são duas checagens que levam segundos e pegam a maior parte das falhas silenciosas. A checagem de contagem compara o que foi coletado com cada número independente que você encontrar: o próprio "page 5 of 5" da última página numerada, um total no cabeçalho ou a soma das contagens por página vistas no caminho. A checagem de campos confirma que cada registro carrega os campos que o trabalho prometeu, e conta as exceções em vez de ignorá-las.
const unique = new Map(rows.map((row) => [row.id, row]));
const missing = rows.filter((row) => !row.title || !Number.isFinite(row.price));

console.log({
  raw: rows.length,
  unique: unique.size,
  removedDuplicates: rows.length - unique.size,
  missingFields: missing.length,
});
Nas 135 linhas numeradas do fixture, a checagem reportou zero campos faltando, 2 duplicatas removidas e 133 registros únicos, batendo com o dataset. Na lista de load more, reportou 1 duplicata em 81. Nenhum número é interessante sozinho; o que importa é que uma mudança em qualquer um fica visível na hora, em vez de aparecer num relatório posterior com um buraco misterioso.
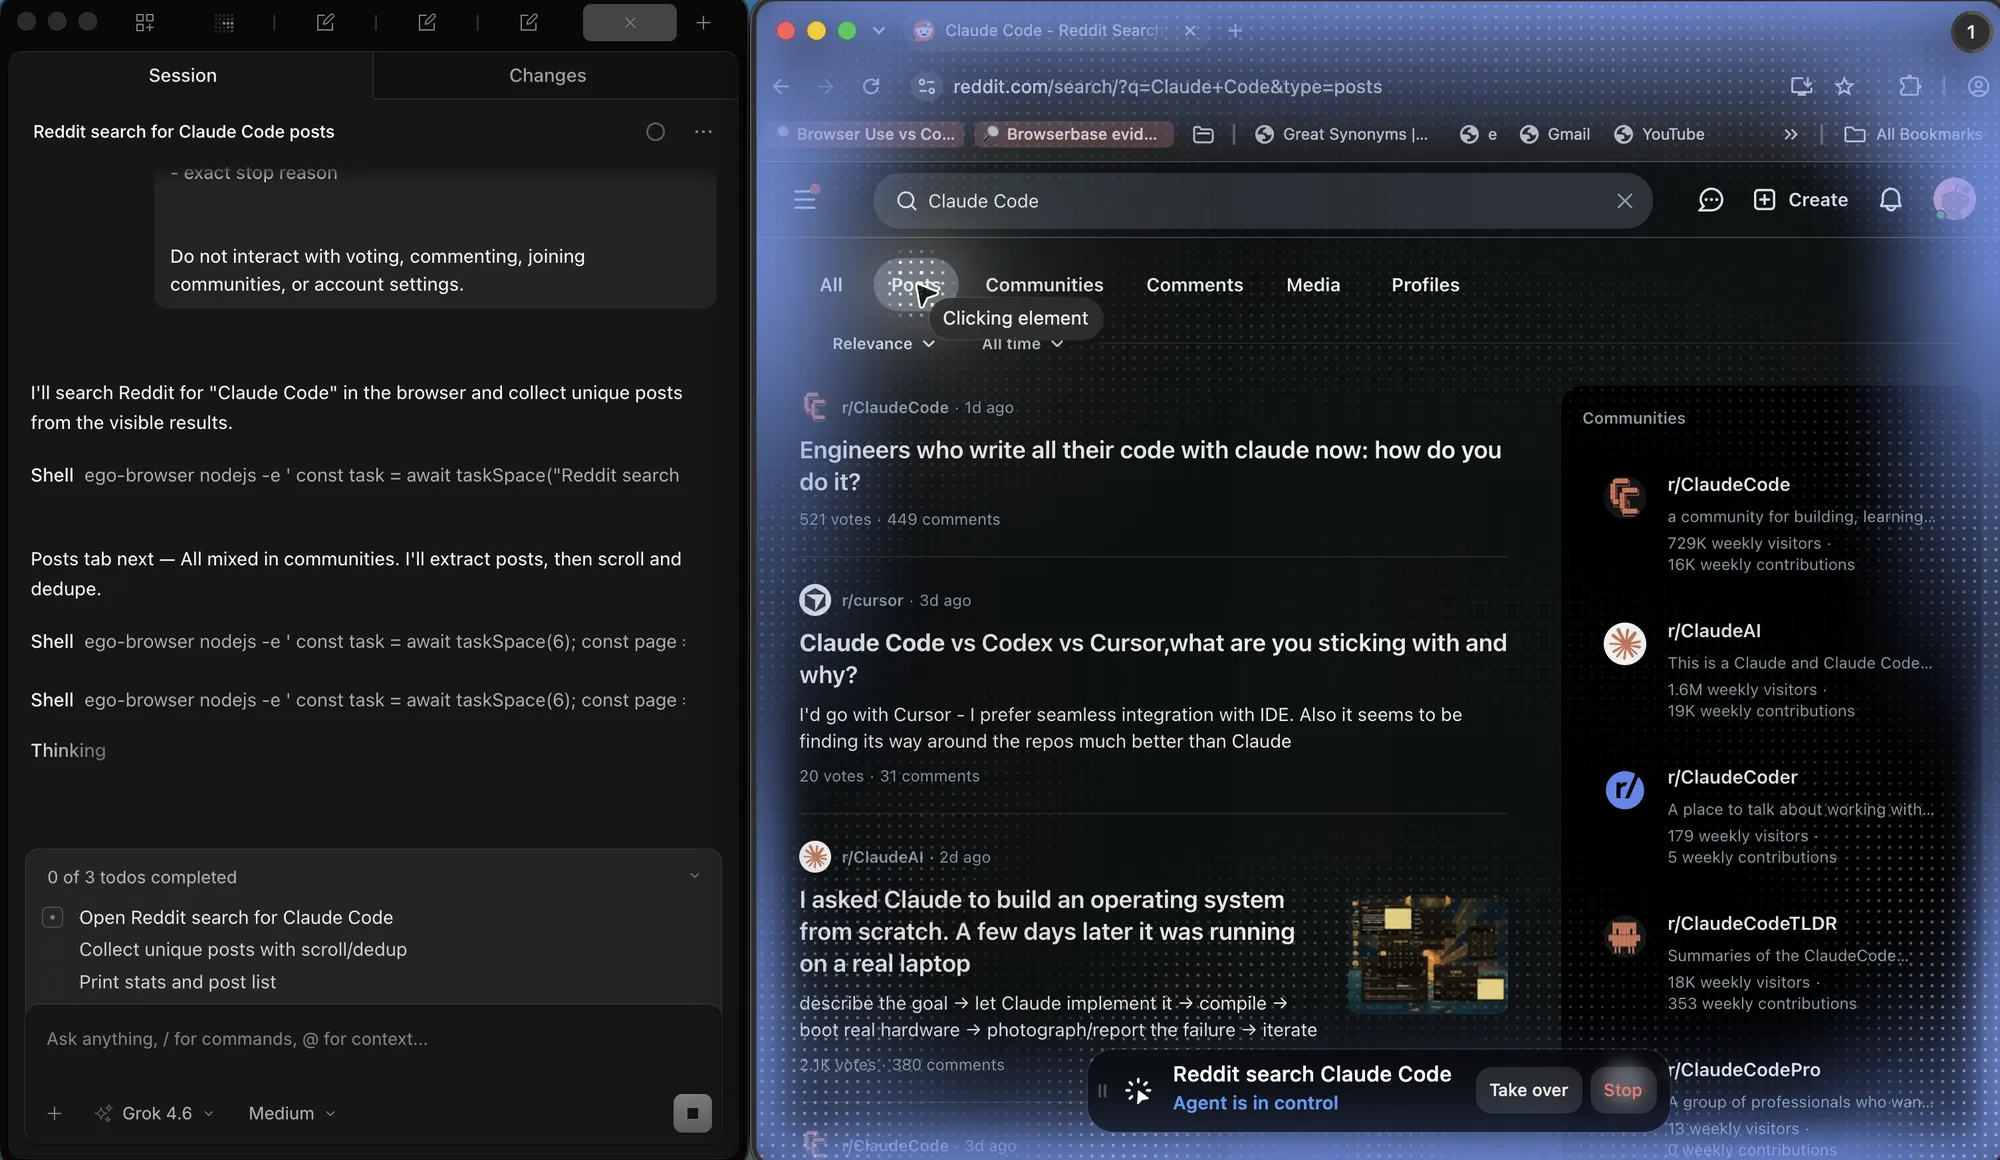
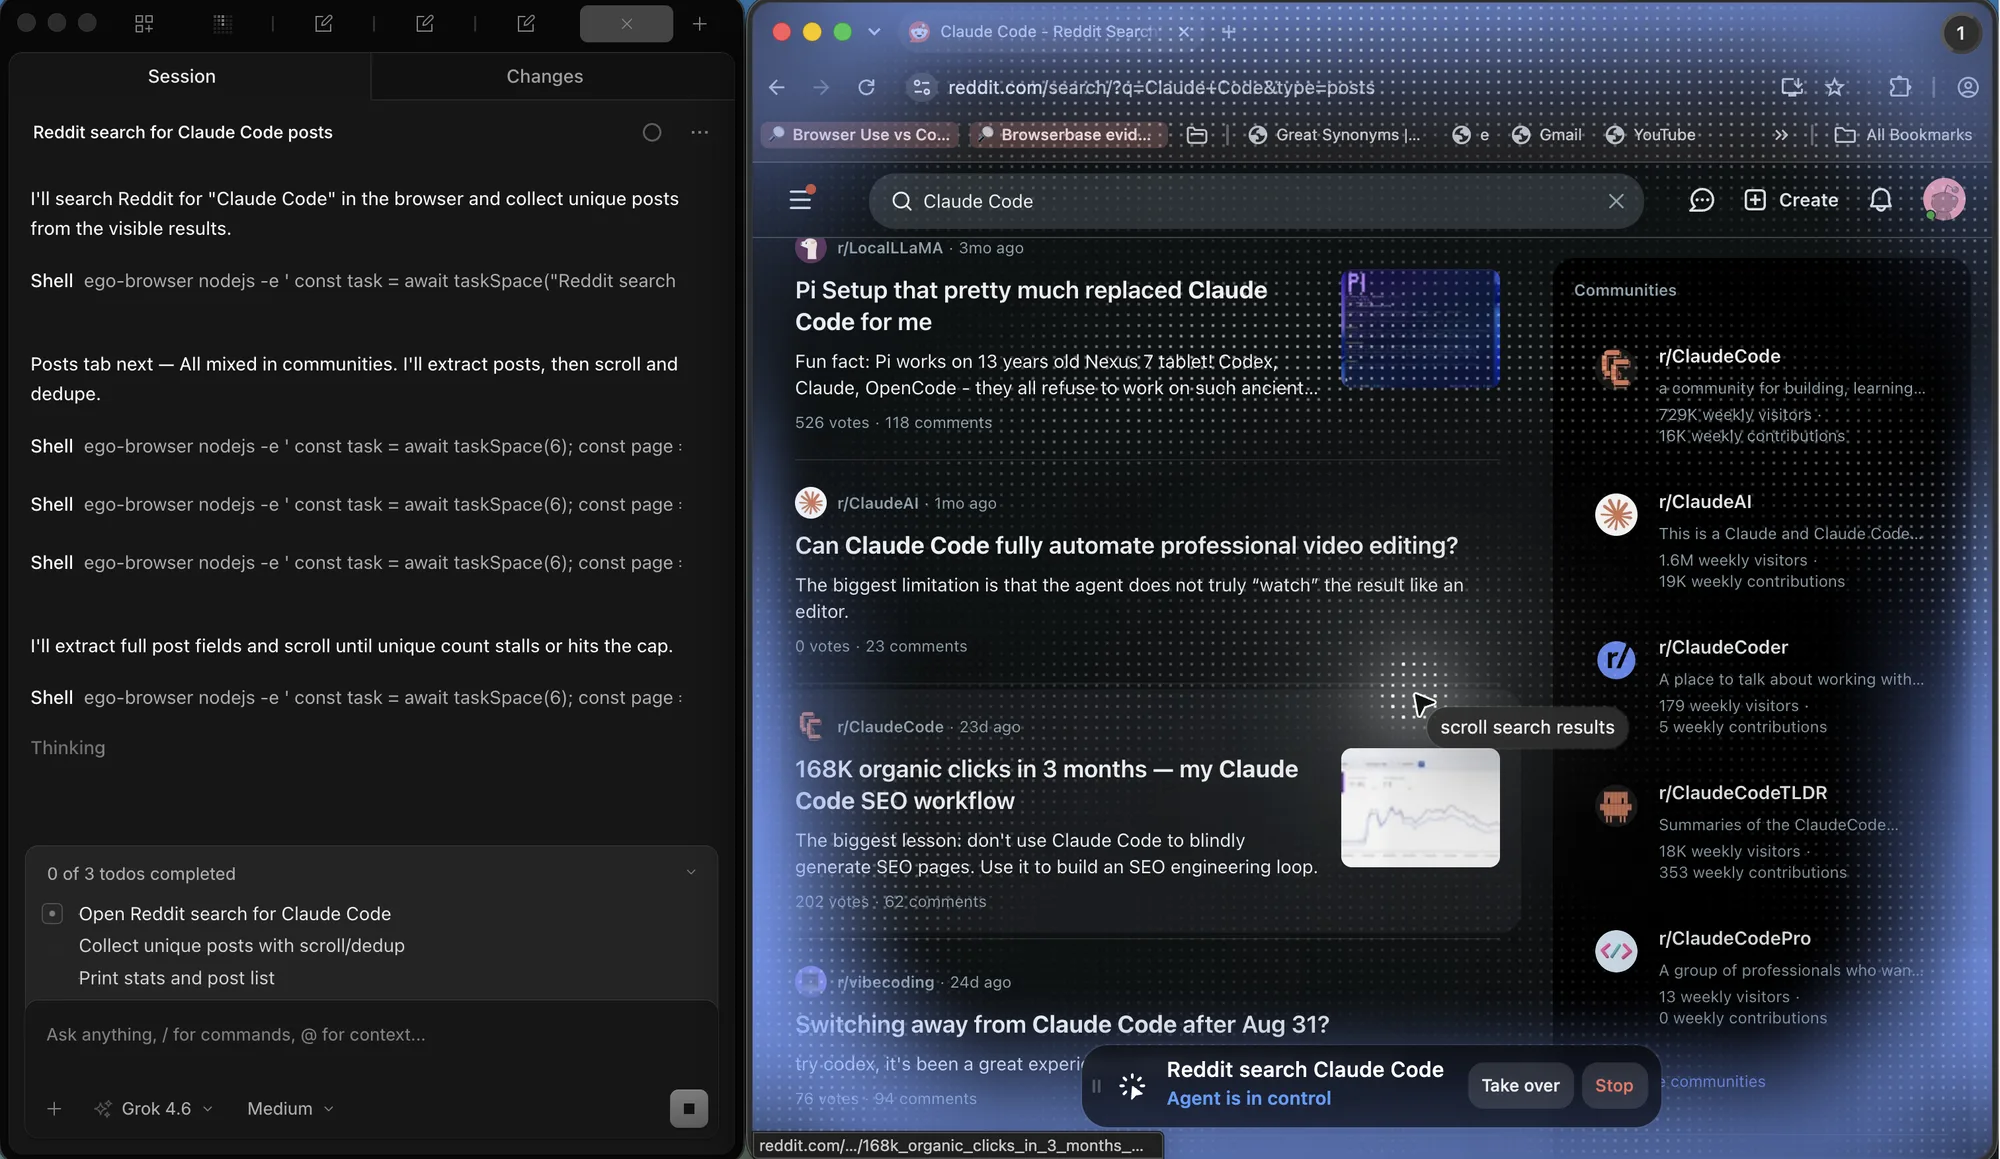
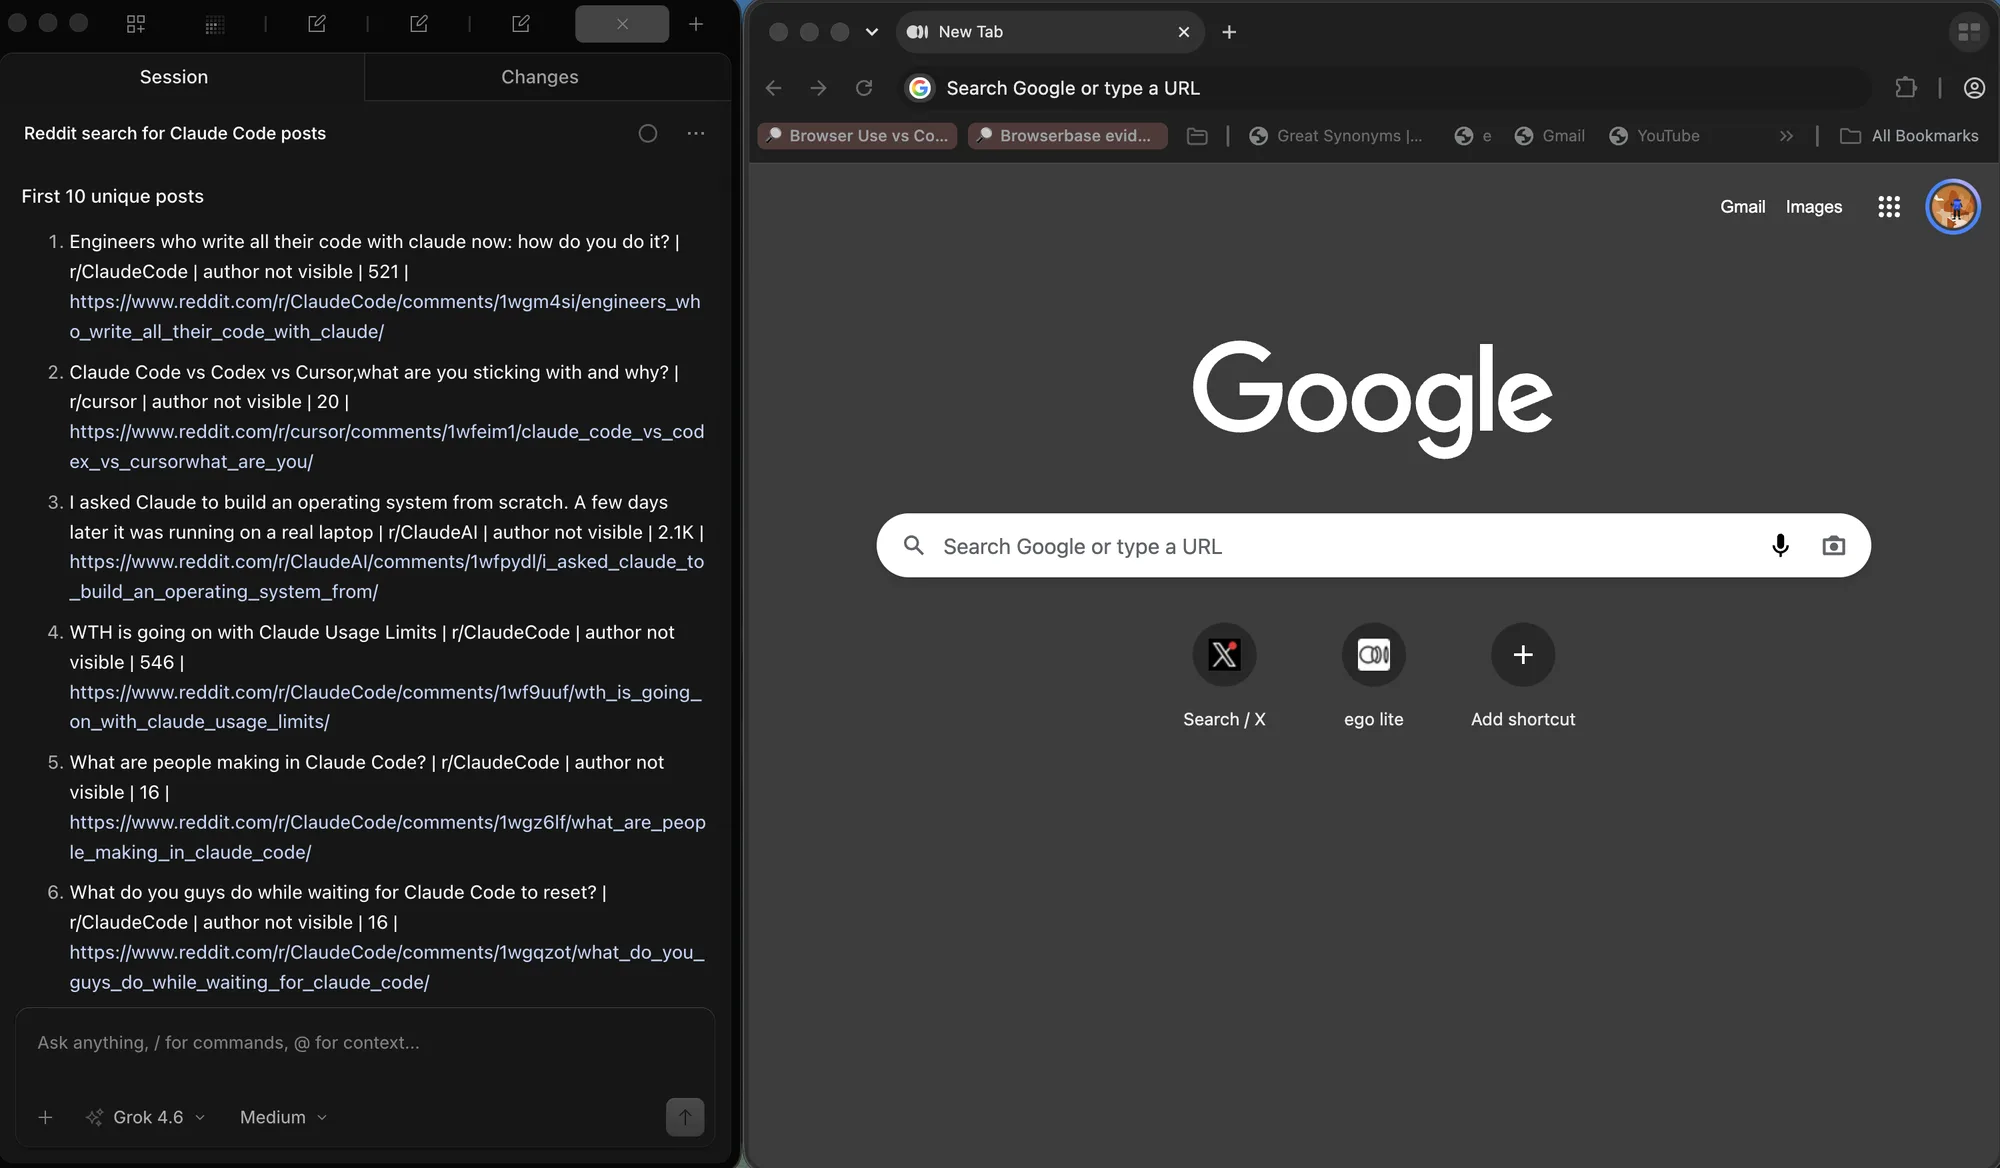
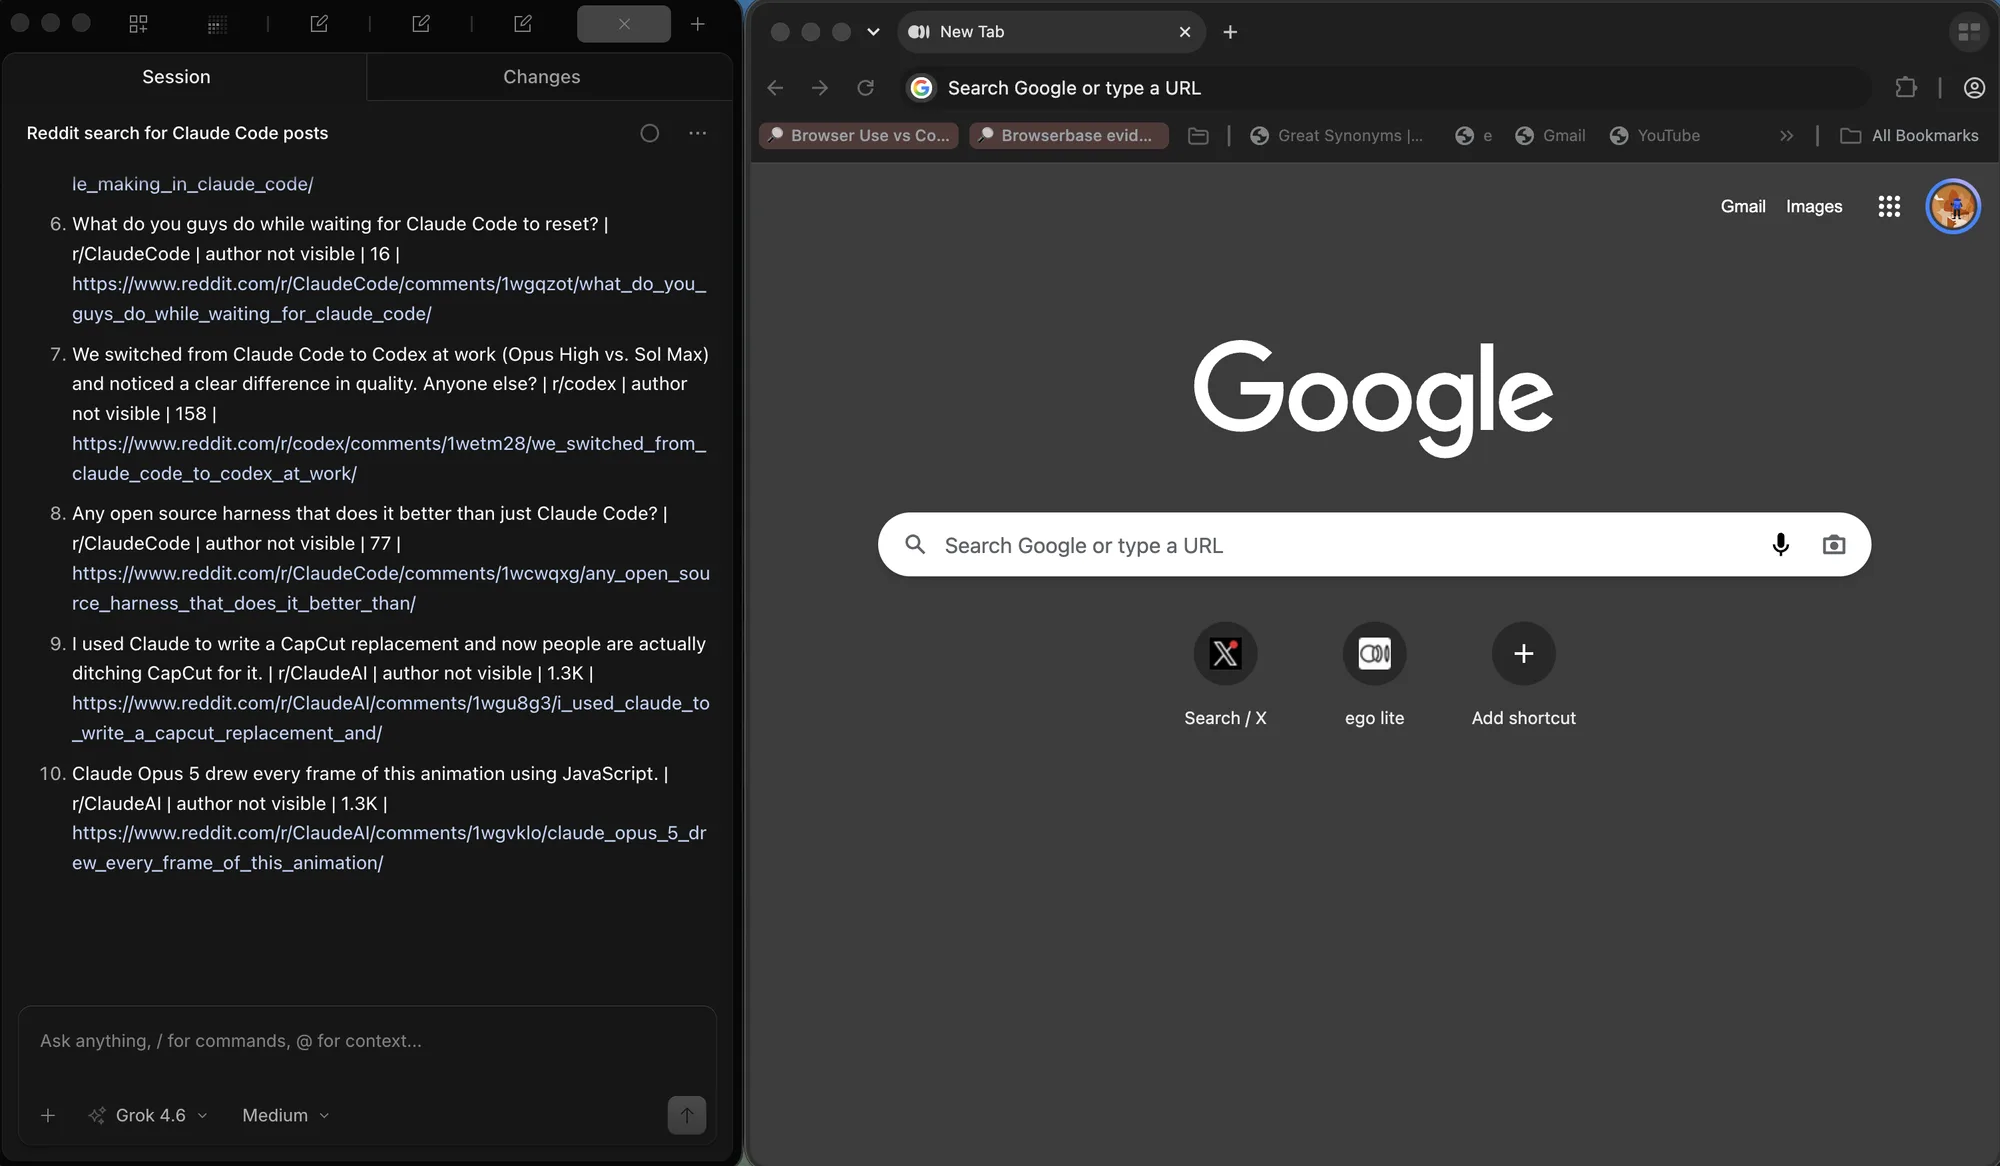
A execucao no Reddit usou a mesma verificacao numa lista unica em direto, nao no fixture de 135 linhas. Cada linha precisava de titulo, subreddit, votos e URL. A saida numerada e o que se valida depois do scroll.
Quando HTTP puro basta, e quando não basta
Os mesmos dados do fixture são alcançáveis sem navegador, e medir os dois caminhos é o jeito honesto de decidir o que o trabalho precisa. Um cliente HTTP puro percorreu as páginas numeradas pela URL, buscou os lotes de load more no endpoint JSON e puxou o feed infinito por offset, coletando todas as 135, 81 e 60 linhas em 24 milliseconds no total. Sem renderização, sem esperas, sem scroll.
Essa é a recomendação padrão, e convém dizê-la sem rodeio: se existe uma API oficial, use-a. Se a lista numerada é renderizada no servidor, peça as páginas direto. Se os modos load more ou infinito têm por trás um endpoint JSON sem assinatura, peça esse endpoint e pagine pelo offset. Um framework como Playwright não é necessário para nada disso, e o caminho HTTP é mais rápido e mais barato de rodar. O passo a passo de paginação da Apify, a documentação de seletores de paginação do Web Scraper, e o fluxo do painel de rede no guia de rede do Playwright cobrem o mesmo terreno a partir de pontos de partida diferentes.
O navegador se justifica quando os dados só existem depois da renderização no cliente, quando as requisições carregam uma assinatura ou um token gerado na página, quando a lista exige login, ou quando o endpoint responde diferente sem uma sessão real e um user agent real. Nesse ponto o navegador não é preferência de scraping, é o único caminho honesto, e as seções anteriores valem iguais.
O ego (lite) entra só depois que esse caminho HTTP falha. Se a lista precisa de um cookie autenticado, de um token gerado na página ou de um scroll que nunca acontece sem um viewport real, rode o mesmo loop numbered / load-more / infinite dentro de um navegador que já segura a sessão. Não comece por aí. O fixture já mostrou a resposta mais barata: 135, 81 e 60 linhas por HTTP puro em 24 ms.
Quando o navegador de fato for necessário, mantenha a lógica de crawl das seções anteriores. O ego (lite) entrega a página autenticada e um Space que você pode acompanhar; ele não inventa um algoritmo novo de paginação. Se um passo precisa de uma pessoa, pare. Se curl ou uma API oficial já devolve as linhas, fique no HTTP.
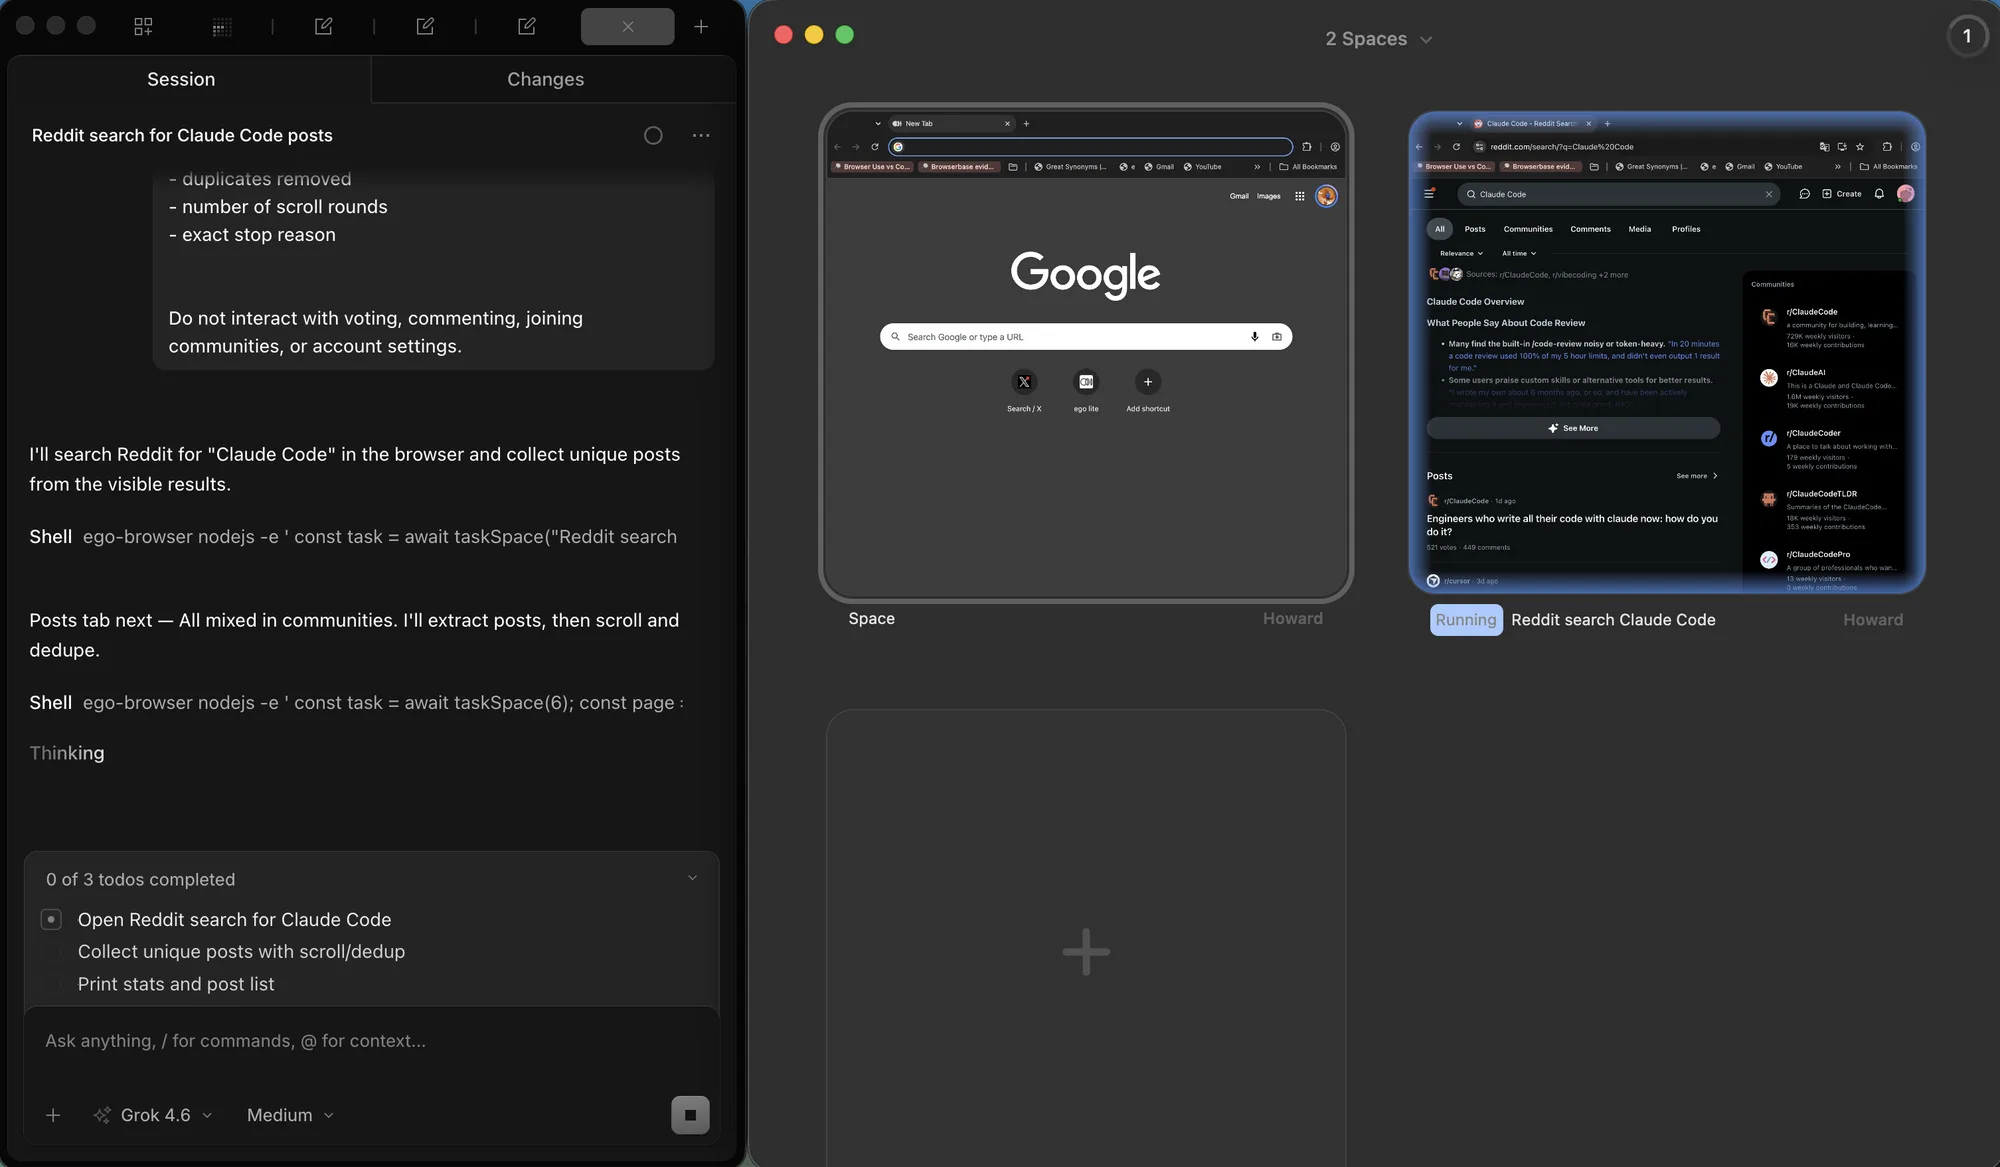
A regra de isolamento das paginas numeradas continua a aplicar-se. Dois crawlers que partilham uma janela disputam a posicao de scroll e reescrevem a ultima linha vista. No mesmo navegador, dois Spaces equivalem a dois contextos Playwright: um pode ficar idle no Google enquanto o outro continua a percorrer o Reddit. O ponto e o isolamento. A visao geral so mostra os dois ao mesmo tempo.
A versão 0.5.0.32 está registrada no changelog (2026-09-12). Confira de novo essa página, o início rápido, e o repositório no GitHub antes de citar um build mais novo. O guia vizinho Web scraping com JavaScript trata a decisão entre estático e renderizado pelo outro lado.
FAQ
Como sei quantas páginas uma lista numerada tem?
Você sabe quantas páginas uma lista numerada tem lendo o controle da última página, dividindo um total do cabeçalho pelo tamanho da página e caminhando até o fim uma vez. Trate essa estimativa como checagem, não como condição de parada do loop.
Por que meu scraper coleta duplicatas entre páginas?
Scrapers coletam duplicatas entre páginas quando a lista por baixo reordena, e um registro migra de um lote para o seguinte. Deduplique num record id estável, não no título visível, e registre quantas duplicatas você removeu.
Quanto tempo devo esperar depois de clicar em load more?
Até uma condição observável ser verdadeira: a contagem de linhas subiu, o estado disabled do botão limpou, ou uma linha conhecida do próximo lote apareceu. Um atraso fixo é um palpite que funciona até a rede ficar lenta, que é exatamente quando ele falha.
Como detectar o fim de um feed infinito?
Prefira um sinal explícito quando o site oferecer um, como uma mensagem de fim renderizada ou um flag has-more na resposta. Sem nenhum dos dois, exija várias checagens seguidas sem itens novos e sem mudança de altura no conteúdo carregado antes de parar, não um único momento quieto.
Devo usar um navegador headless para scraping com paginação?
Só quando os dados exigem renderização, uma sessão ou tokens na página. Listas renderizadas no servidor e endpoints JSON se saem melhor com HTTP puro, mais rápido e mais simples de rodar. Meça os dois caminhos uma vez; a comparação costuma deixar a decisão óbvia.
O que faz um crawl paginado parar cedo?
Três suspeitos habituais: uma espera que acabou antes do lote renderizar, um erro transitório tratado como página vazia, e uma sessão que expirou no meio da execução, de modo que a próxima página renderizou o formulário de login em vez das linhas. Cada um tem um conserto diferente, por isso o motivo da parada deve ser registrado junto com a contagem.
Como retomar um crawl depois de uma queda?
Faça checkpoint depois de cada lote concluído com o modo, a posição e as linhas coletadas até ali. O resume lê esse arquivo e reentra no modo na posição gravada. Refaça o fetch de um lote imediatamente antes da posição do checkpoint uma vez, para confirmar que a fonte não se deslocou por baixo do estado salvo.
Como validar que um crawl está completo?
Compare a contagem de registros únicos com pelo menos dois números independentes, como o total da própria última página e a soma das contagens por página, depois cheque a completude dos campos em cada linha e reporte as exceções. Uma contagem que bate e campos todos presentes é um sinal forte; qualquer um dos dois sozinho é fraco.
Preciso rolar devagar para disparar o lazy loading?
Em geral não, mas redispare o loader em vez de estacionar no fim. Os sites usam intersection observers que disparam na mudança, então alternar a posição ou rolar em degraus é mais confiável do que um salto grande, e torna a checagem de crescimento significativa.
Posso raspar uma lista paginada atrás de um login?
Sim, com uma sessão real e as mesmas regras: pagine com educação, mantenha a sessão viva e trate um redirecionamento para a página de login como problema de sessão, não como o fim da lista. Um navegador que já carrega o seu login, como o ego (lite), elimina por completo a etapa de reconstruir a sessão. O guia de sessão persistente cobre o tratamento de estado, e o caso de uso de scraping de preços mostra como fica uma coleta completa já autenticada.
