先说结论:agent-browser 和 Chrome DevTools MCP 解决的是两件不同的事(前者追求公开数据的抓取速度,后者侧重实时会话调试)。而像 ego (lite) 这样单独配置的浏览器,目标是把程序化控制与已授权的浏览器会话结合起来,服务日常工作;按这种方式配置时,并不需要共用同一个窗口。
如果你研究 Agent 浏览超过第一篇博客的深度,就会遇到这三个:Vercel 的 agent-browser、Google 的 Chrome DevTools MCP,以及 ego (lite)。它们经常被混为一谈。前两者是对 Agent 需求的不同押注,而第三个则是当这些成本被工程化消除后,两者结合所指向的形态。
先说明立场:ego (lite) 是我们自己做的产品。下文关于这三款工具的所有说法,都来自各自的官方文档或公开基准测试;ego (lite) 的缺点也和其他工具一样,直说不绕。
这三种架构分别是什么?
agent-browser:前面是 CLI,后面是一次性浏览器。
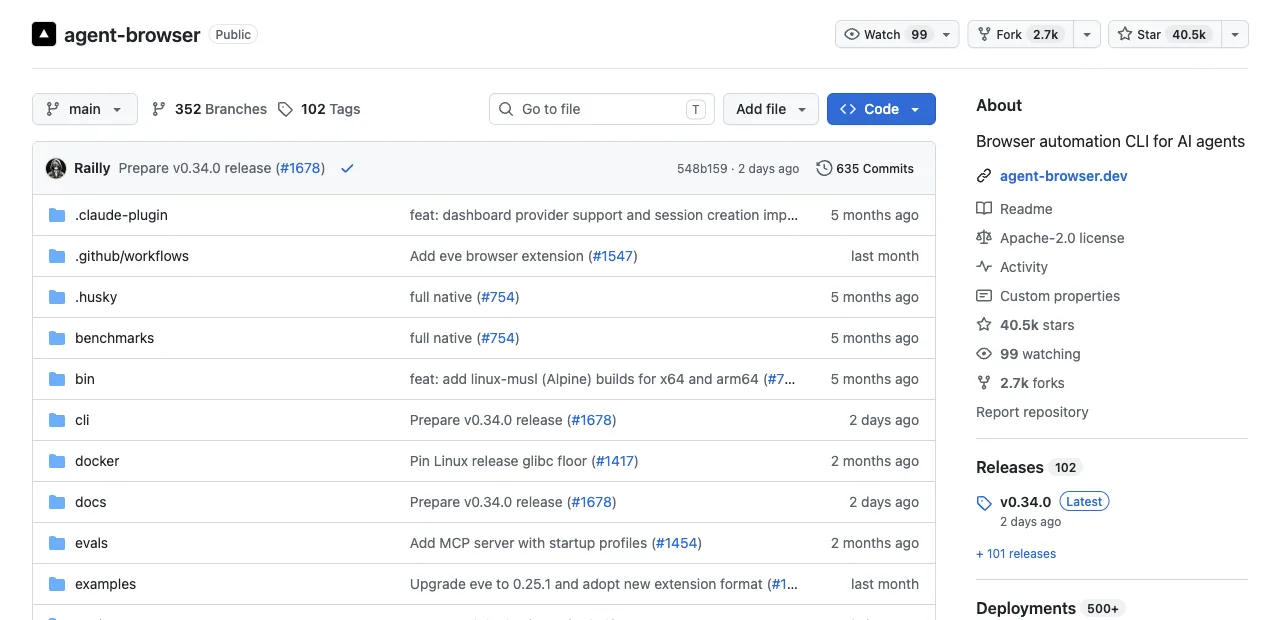
一个原生 Rust CLI(带一个用 Rust 写的 daemon,直接说 CDP),会下载 Chrome for Testing,并暴露一套“快照加 refs”的循环:agent-browser snapshot 返回带 refs(如 @e1)的无障碍树,随后 agent-browser click @e2 就能对这些 refs 执行操作。
会话被刻意隔离,每个会话有自己的 Cookie 和认证状态;它也能向外连接 CDP 端点和云端浏览器集群,例如Browserbase和 Browserless。它的设计目标是:在专为任务而生、用完即弃的浏览器上,做快速、确定性的自动化。
Chrome DevTools MCP:把 Agent 挂到你的 Chrome 上。
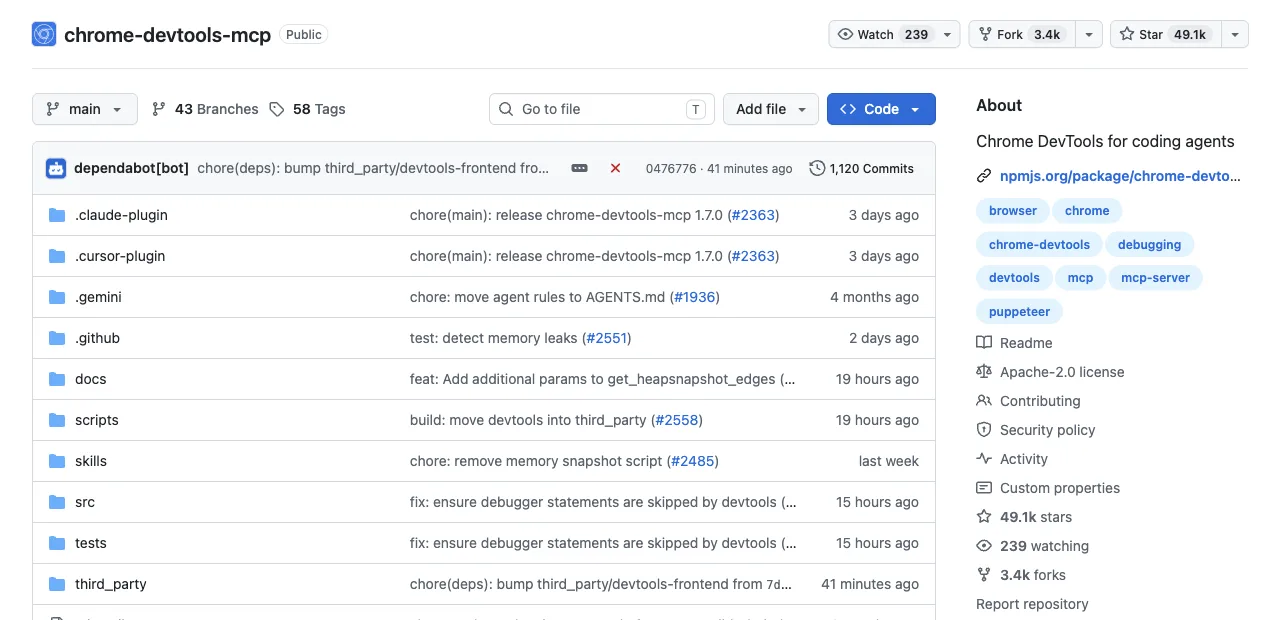
一个 MCP 服务器,封装了 DevTools 协议的诊断能力:带 Core Web Vitals 的性能追踪、V8 堆快照、跨页面跳转的网络检查、设备模拟。配合Chrome 144+ 上的自动连接,它会在你已登录的浏览器里工作,前提是通过一个授权弹窗。它的设计目标是让 Agent 看到你所看到的一切,包括你登录之后才能访问的内容,而且就在你的窗口里。
ego (lite):一款为共享而生的浏览器。
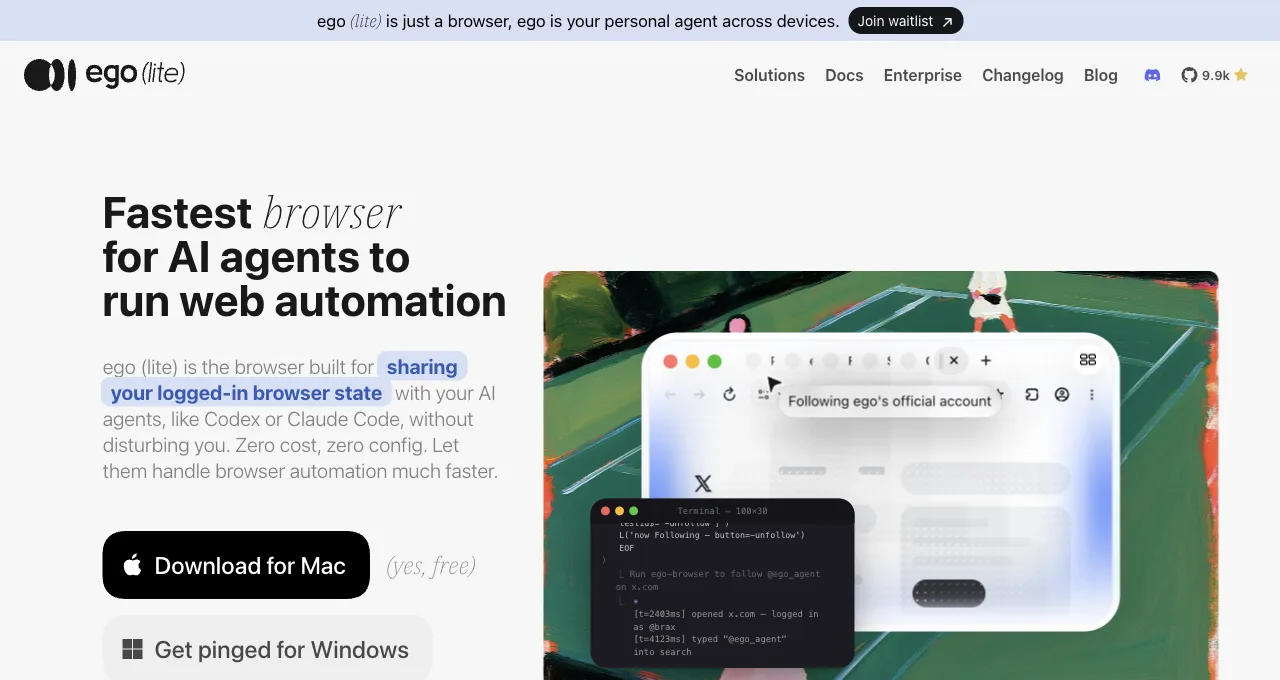
一款免费的桌面浏览器,用来把你的登录态共享给 AI Agent,例如 Codex 或 Claude Code。
在底层,ego-browser skill 通过 CDP 驱动它,这与 agent-browser 的 daemon 说的是同一套协议,只不过指向的是一台为被驱动而打造的浏览器。面向 Agent 的接口是一个 CLI:兼容且能执行 shell 的 Agent 可以写 JavaScript,把整段工作流放在模型上下文之外执行,运行在 Space 中,使用你显式配置好的浏览器状态。窗口隔离和会话范围取决于具体配置。
两种取向,以及它们共同指向的组合。
从任务长什么样就能听出区别。agent-browser:snapshot、click @e2、fill @e3,一个动作一条命令。DevTools MCP:“启动一次性能追踪,告诉我是什么拖慢了 LCP。”ego (lite):一次性传入十行脚本,Agent 只读回结果。
这种区别放到真实环境里跑一遍:下面这个会话是在 2026 年 8 月 15 日针对 GitHub Trending 执行的,目标不是搭好的演示页面。抓取本周最热门的 Python 仓库,正是下文评分所依据的 31 个基准任务之一(rwb-github-trending-py-01)。
ego (lite),定向提取
ego-browser nodejs <<'EOF'
const task = await egoBrowser.newTaskSpace('article demo evidence 0820')
console.log({ taskSpaceId: task.id })
await task.page.goto('https://github.com/trending/python?since=weekly', { waitUntil: 'load', timeout: 30000 })
const repo = await task.page.locator('article.Box-row h2 a').first().innerText()
const stars = await task.page.locator('article.Box-row .float-sm-right').first().innerText().catch(() => null)
console.log(JSON.stringify({ url: task.page.url(), topRepo: repo.replace(/\s+/g, ' ').trim(), starsThisWeek: (stars || '').trim() }))
EOF

# output:
{ "taskSpaceId": 10 }
{"url":"https://github.com/trending/python?since=weekly","topRepo":"cactus-compute / needle","starsThisWeek":"3,772 stars this week"}
一个 JSON 对象,约 130 个字符,来自单次执行回合。再看对比的另一面:我们通过 Chrome DevTools MCP 在 Hacker News 上测得的 take_snapshot,单个页面返回了 38,285 个字符的无障碍树,这就是基于快照的设计在每个动作上的观测成本。回传给模型的数据量差距,正是本节所描述的这种差异的形态。
第四种架构 OpenAI Atlas 又是什么情况?
OpenAI 的 ChatGPT Atlas 是第四种架构,如今已不复存在。它于 2025 年 10 月 21 日发布,是一款仅支持 macOS 的 Chromium 内核浏览器,侧边栏内置 ChatGPT,可以就当前页面回答问题、总结内容、改写选中文本(Wikipedia)。付费的 Plus 和 Pro 订阅用户可以启用可选的 Agent 模式,让 ChatGPT 与网站交互,代为完成任务(Wikipedia)。
Atlas 是一款集成式桌面浏览器,既不像 agent-browser 那样是一次性 CLI 浏览器,也不像 Chrome DevTools MCP 那样是附加的诊断界面,更不像 ego (lite) 那样是共享的本地浏览器。它管理自己的浏览器状态,运行在自己的窗口里,与用户日常浏览相互独立。2026 年 3 月,OpenAI 表示会把 Atlas、ChatGPT 桌面应用和 Codex 合并为一个应用;2026 年 8 月 9 日,Atlas 正式关停(Wikipedia)。
MIT Technology Review 的一位评测者认为该 Agent 表现很差,会挑出用户已经买过或已经决定不买的商品,内置的 ChatGPT 有时还会引用错误的页面(MIT Technology Review)。架构选择上的教训是:一个试图包办一切的集成式浏览器可能会消失,而针对特定任务的专业工具可能更有生命力。
它们在各维度上如何对比?
有五个维度决定实际使用效果。每个单元格既写优势也写限制,因为决策往往就发生在限制上。
| 维度 | agent-browser | Chrome DevTools MCP | ego (lite) |
|---|---|---|---|
| 登录态 | 按设计就是隔离会话;除非你写脚本导入,否则你的账号不在里面 | 通过自动连接获得完整访问权限,在你自己的窗口内 | 需要显式配置浏览器状态;过期时间和权限限制依然适用 |
| 窗口归属 | 自己的浏览器;你的浏览器不受影响 | 共用你正在使用的窗口;需要轮流操作 | 配置后有自己的 Space(隔离空间);并发和窗口边界限制依然适用 |
| Real-World Bench,31 个任务 | 31 个任务中 62.9% 完美完成;平均成本 $2.66,每个完成任务 $4.23 | 31 个任务中 61.3% 完美完成,测的是 chrome-devtools-cli,不是 MCP 服务器;平均 $4.95,每个完成任务 $8.08 | 31 个任务中 93.5% 完美完成;平均 $1.64,每个完成任务 $1.75 |
| 调试 | 控制台、网络拦截、Web Vitals;没有完整的 trace 分析 | 深度诊断工具集:trace、堆快照、模拟 | 没有调试面板;这不是它的职责 |
| 价格与许可 | 免费,Apache-2.0 | 免费,开源 | 浏览器免费下载;闭源 |
Atlas 的架构在关键维度上表现如何?
Atlas 已经下线,但它的架构仍值得用决定实际使用的同一批维度来打分。下表陈述的是关于 Atlas 有据可查的内容,而不是我们实测的结果。
| 维度 | agent-browser | Chrome DevTools MCP | ego (lite) | OpenAI Atlas(已关停) |
|---|---|---|---|---|
| 登录态 | 按设计就是隔离会话;除非你写脚本导入,否则你的账号不在里面 | 通过自动连接获得完整访问权限,在你自己的窗口内 | 需要显式配置浏览器状态;过期时间和权限限制依然适用 | 在浏览器内部管理自己的状态;没有文档说明可以导入你现有的配置文件 |
| 窗口归属 | 自己的浏览器;你的浏览器不受影响 | 共用你正在使用的窗口;需要轮流操作 | 配置后有自己的 Space(隔离空间);并发和窗口边界限制依然适用 | 使用自己独立的窗口;你必须在 Atlas 和日常浏览器之间来回切换 |
| 数据隐私 | 你的数据留在它的一次性浏览器里 | 你的数据留在你自己的 Chrome 配置文件里 | 你的数据留在本地你自己的 Chromium 配置文件里 | 你的浏览和 Agent 任务都要经过 OpenAI 的服务器;隐私影响令人担忧 |
| 任务可靠性 | 在 Real-World Bench 的 31 项任务中,62.9% 完美完成 | 在 31 项任务中 61.3% 完美完成,以 chrome-devtools-cli 测量 | 在 Real-World Bench 的 31 项任务中,93.5% 完美完成 | 有评测者发现,Agent 会挑选用户已经购买或已经决定不买的商品,而且助手有时会引用错误的页面(MIT Technology Review) |
Atlas 的 Agent 模式只对 Plus 和 Pro 订阅用户开放,所以免费用户只能用侧边栏助手,用不了自主任务(Wikipedia)。它在 2026 年 8 月 9 日关停后,这个选项彻底消失了(Wikipedia)。
在同样的 31 个任务上,三者得分如何?
Real-World Bench 用同一套 31 项任务,跑在真实生产站点(X、Expedia、Redfin、Amazon、政府数据门户)以及用于有状态流程的确定性本地站点上。五个工具使用同一个模型 gpt-5.6-sol,均为 max effort,并由同一个独立评审依据原始会话日志和截图给每项任务打分。每项任务最多包含 6 条二元评分项(31 项任务共 154 条);只有全部评分项通过,任务才算完美完成,没有部分得分。
在给出数字前先说明一处命名问题:该测试框架测的是 chrome-devtools-cli,也就是通往同一套 DevTools 协议接口的命令行方式,而不是本文讨论的 DevTools MCP 服务器。诊断工具集相同,传输方式不同;请把它的那一行看作最接近的实测参照,而不是 DevTools MCP 服务器本身的得分。
Real-World Bench 完美完成率(31 项任务)
Perfect = every binary rubric passes; 31-task benchmark configuration, run 2026-08-19
这些任务不是玩具式的抓取。任务集中的例子包括:在登录状态下从 x.com/OpenAI 拉取一周的互动指标,排除置顶帖和回复;在 cars.com 上估算一辆二手 Camry 的月供;把 2048 玩到 256 方块且不重置。正是这种混合任务上的评分项打分,拉开了完成率的差距。
Completion rate sets the real bill, because average cost per task counts the failed attempts too. agent-browser averaged $2.76 per task; divide by its 74.2% completion and each completed task cost $3.72. chrome-devtools-cli averaged $4.95, which at 61.3% completion is $8.08 per completed task. ego (lite) averaged $1.92: $1.64 divided by 93.5% completion is $1.98 per completed task.
The turn counts explain the gap better than any engine detail. agent-browser needed 45.6 model turns per task and chrome-devtools-cli 44.9, against ego (lite)'s 30.3: one command per model round trip means many round trips, and every round trip is another chance to misread a snapshot or derail. On rubric average, which credits partial completion, ego (lite) scored 99.3%; chrome-devtools-cli's 82.6% edges agent-browser's 80.6% there, meaning it partially completed more of the tasks it failed. And with the fewest round trips, ego (lite) was also the fastest of the five tools measured, at 518 seconds per task on average against 587 to 648 for the rest.
各自会在哪里出问题?
每个工具的失败模式,都出现在它设计押注不再奏效的地方。在2026 年 1 月的 YouTube 对比中,开发者 Cole Medin 测得的首次尝试任务完成率为:agent-browser 95%,Playwright MCP 80%,Chrome DevTools MCP 75%。注意他的对比阵容:本文三个工具中的两个,加上 Playwright MCP,没有 ego (lite)。差距源于机制:agent-browser 把站点压缩成稳定的 ref,由 Agent 直接点击,而基于 MCP 的工具依赖无障碍树搜索,元素找不到时就会失败。Real-World Bench 的 31 项任务集保持了相同的相对排序(agent-browser 完美完成率 62.9%,DevTools CLI 路线 61.3%),但绝对数值低得多,这正是多评分项、真实站点任务对首次尝试数据的影响。来自公开 issue tracker 和文档的具体情况:
agent-browser: 登录墙。会话被刻意隔离,而试图沿用认证状态的用户确实遇到了实际阻力:GitHub tracker 上有报告称 --profile 会话会丢失当前页面并回退到 about:blank,跨源 iframe 也被记录为阻塞项,这会让 Apple ID、Google SSO 这类嵌入式登录流程失效。
此外还有首次使用前必须下载 Chrome for Testing 的安装成本。这些对无状态抓取都不重要;但当你的任务需要账号时,每一条都重要。
Chrome DevTools MCP: 共享窗口。自动连接需要 Chrome 144+、启用远程调试,以及每次会话的权限弹窗,而你得到的是一个在你正想使用的浏览器里操作的 Agent。Chrome 136+ 还会在默认配置文件上屏蔽调试 flag,所以较早的基于端口的方式需要专用配置文件。对调试会话来说是极好的取舍;对应该在你工作时运行的任务来说则形态不对。
ego (lite): 它不做的事。没有性能 trace、堆快照或 Lighthouse,所以诊断仍归 DevTools MCP。它是桌面浏览器,因此无头 CI 容器不在范围内,而断言密集的测试套件属于Playwright。而且它是闭源的,这对一些团队来说是政策问题,与功能无关。
针对你的任务应该选哪个?
三个问题几乎能筛掉所有情况。按顺序回答,遇到第一个匹配就停下。
数据是公开的,工作是无状态的吗? agent-browser。抓取文档站点、查价格、批量截图:它原生 Rust 的速度和一次性会话正合适,登录态反而是累赘。
任务是诊断页面吗? Chrome DevTools MCP。LCP 慢、内存增长、只在你的登录会话里复现的 bug:这三个工具里只有它握有这些工具。
是你登录态背后的日常工作,且不该打断你吗? ego (lite)。在你已授权账号的站点上拉取仪表盘、填表单、收集列表,配置后可用 Space 隔离任务工作。这就是它瞄准的用例,浏览器可免费下载;模型、主机和审核成本仍需自付。
很多配置会保留三者中的两个:按登录是否重要,用 agent-browser 或 ego (lite) 执行,同时启用 DevTools MCP,以备某天需要 trace。OpenAI Atlas 的兴衰说明了把所有 Agent 任务押在单一集成浏览器上的风险。它在 2026 年 8 月 9 日关停,说明针对特定工作的专用工具,比如用于登录态工作的本地浏览器,可能比一刀切的 AI 浏览器更有韧性(Wikipedia)。
查看完整的 ego (lite) 与 agent-browser 对比,或 下载 Mac 版 ego (lite) 并在你当前的配置旁边运行一个需要登录态的任务。
如何让浏览器 Agent 在长时间运行中保持可靠?
长时间运行的可靠性来自对状态的控制,而不是让模型记住更多东西。为每个任务分配一个全新的或具名的会话,明确定义就绪状态和完成状态,限制动作次数与重试次数,对已接受的结果做检查点,并在每次页面跳转后重新校验。过期的标签页、失效的会话、变化的布局、上下文污染,是各自独立的失败模式,需要各自独立的信号来发现;没有任何浏览器工具能自动消除它们。
- 隔离状态。 为每个工作流使用具名的 Space 或浏览器配置文件(Profile),清理过期的标签页;除非任务明确要求有人监督下的共享,否则绝不要让并行的 Agent 共用 Cookie 或同一个活动窗口。
- 让进度可持久化。 每批处理完成后,持久化保存任务 ID、来源 URL、游标、时间戳和已接受的记录。浏览器重启后应当从检查点继续,而不是重复执行每一个副作用。
- 衡量最终结果。 要评估通过校验的数据行、已提交的状态和证据,而不是 Agent 声称自己完成了。除了完成率,还要跟踪恢复时间和人工介入次数。
在演示中能跑通的模型,到了生产环境可能会跑偏,因为账户状态、数据量、时序和频率限制都变了。在更换模型、浏览器版本、提示词、并发数或网络之后,重新跑一组有代表性的冒烟用例。
Agent 应该用直接工具调用,还是截图?
当页面暴露了语义化控件和结构化字段时,使用直接的 DOM 调用或无障碍工具调用;当需要判断的是视觉布局、canvas、图表,或者无障碍树缺失时,使用截图。最好的生产级 Agent 能在两种模式间切换,但不应该为每次点击都付出整张截图的代价,也不应该信任一份遗漏了渲染状态的 DOM 快照。
| 接口 | 优势 | 需要警惕的失败 |
|---|---|---|
| DOM / accessibility tree | 紧凑、语义化、易于断言 | 缺失虚拟化内容或 canvas 内容 |
| Screenshot / vision | 视觉状态、布局与像素 | Token 消耗更高;坐标与 OCR 出错 |
| Page API / network response | 在获得授权时快速获取结构化数据 | 隐藏状态或策略边界 |
直接调用工具并不自动意味着更安全或更真实:选择器可能指向错误的重复按钮,而截图可能显示出 DOM 查询漏掉的确认横幅。返回一小段提取出的值,加上 URL 和时间戳,只有在需要诊断时才使用截图或 trace。
Agent 应如何处理反爬检查和登录墙?
把 Cloudflare、Akamai、DataDome、验证码(CAPTCHA)、401、403 和登录墙视为访问边界。在有条件时,使用官方 API、已授权的数据源、未登录的公开路径,或经人工批准的登录。真实浏览器会话可以让已授权用户访问自己的账户,但没有任何工具能保证网站不会对自动化施加频率限制或限制。
- 停下来并分类。 记录状态码、挑战类型、账户和 URL。不要把挑战当作临时超时来重试。
- 使用已批准的会话。 对于你自己需要登录态的工作,优先使用受支持的浏览器配置文件(Profile)或 Space,并亲自完成两步验证(2FA)。绝不要导出 Cookie、重放 Token、伪造指纹或轮换身份。
- 显式交接。 让人类解决被允许的挑战,或接管浏览器,然后从检查点继续。把挑战和账户状态保留在审计记录中。
如何观测和调试生产环境中的浏览器 Agent?
记录足够的证据来解释决策,而不是永久保存整个私有会话:任务 ID 和 trace ID、工具调用、定位器或坐标、URL、响应状态、控制台错误、网络失败、截图或 DOM 片段、模型、耗时以及最终校验结果。上线日志前先脱敏密钥并设置保留期限。
- 浏览器侧证据。 记录页面 URL、可见状态、控制台异常、失败的请求以及最后一次成功的操作。当问题出在网络、性能或运行时诊断时,Chrome DevTools MCP 更有用。
- Agent 侧证据。 记录模型提出的动作、工具 schema、参数、审批结果以及返回结果。这样即使工具选错或字段填错,也能解释清楚,而不用把责任推给页面。
- 运行侧证据。 跟踪队列深度、重试次数、频率限制、浏览器崩溃、会话过期和成本。告警要覆盖心跳丢失和状态长时间不变,而不只是进程退出。
实时画面和人工接管是有用的恢复手段,但必须做访问控制。一个公网可达的 VNC 或 CDP 端点不是可观测性功能,而是凭证和浏览器控制权的暴露面。
如何安全地管理持久会话和登录态?
持久化要刻意选择。agent-browser 的默认会话是一次性的;Chrome DevTools MCP 可以在获得批准后附加到正在运行的浏览器配置文件(Profile);ego (lite) 使用隔离的 Space(隔离空间),继承已授权的浏览器状态。无论哪种方式,浏览器配置文件(Profile)都是凭证边界:给它命名、限制可访问的域名,并且除非工作流和账号所有者明确授权,否则绝不要把收件箱或 OTP 通道交给 Agent。
- 优先使用官方支持的登录方式。 在浏览器里完成 OAuth、MFA 和设备校验。不要通过注入 Cookie、复制 auth.json 或导出 refresh token 来让无头会话看起来是持久的。
- 隔离身份。 为每个账号和每类任务使用专用的 Space 或浏览器配置文件(Profile)。把个人邮件、支付、管理后台和测试身份分开。
- 设置过期并主动吊销。 定期检查会话时长、账号告警、扩展程序权限和机器访问权限。任务结束或主机易手时,吊销对应的浏览器配置文件(Profile)或凭证。
什么时候该用 Agent、工作流脚本或自动化工具?
选择器稳定、转换可重复、需要断言的场景用确定性脚本;触发器、队列、审批和 API 连接器用 Zapier、Make 或 n8n;页面含义模糊、布局经常变化、需要判断力来恢复的场景用 Agent。浏览器 Agent 应该是工作流中一个范围很窄的自适应步骤,而不是无限制地替换掉每一个节点。
| 需求 | 推荐首选 | 原因 |
|---|---|---|
| Stable regression in CI | Playwright or Selenium | 确定性断言和可重复的报告 |
| Scheduled API and approvals | n8n, Make, or Zapier | 可见的路由、重试和连接器归属 |
| Changing authenticated UI | 在受限会话中运行 Agent 浏览器 | 自适应操作并支持人工交接 |
如果 Agent 需要人一直盯着,就加上检查点、告警和队列,或者把稳定的部分改写成代码。“自主”应该描述一个有边界、有恢复机制和复核流程的服务,而不是一个操作员无法叫停的进程。
布局变化后,如何定位稳定的 DOM 元素?
先对准用户的语义,再对准页面的坐标:可访问角色、label、可见文本、test ID 或稳定的 data 属性。把定位器限定到相关的卡片或表单范围内,断言其唯一性,并等待你需要的状态出现。避免使用依赖生成类名、nth-child 位置的长 CSS/XPath 链,也不要依赖会随视口和语言变化的截图坐标。
- 优先使用语义化定位器。 角色、label 和 test ID 定位器能让意图可见,并且在很多视觉改版后依然有效。写动作之前,先用 DOM 快照检查实际的可访问名称。
- 等待具名状态。 等待 hydration 完成、网络结果返回、某一行可见,或某个按钮变为可用。“页面已加载”不等于“数据已就绪”。
- 显式处理歧义。 如果两个按钮共用同一个标签,就缩小容器范围,或者停下来等待人工确认。不要让 Agent 去猜哪个重复的控件会改动账户数据。
本地、云端、无头浏览器,哪种运行时最好?
根据会话、规模和审核需求来选择运行时。本地真实浏览器最适合已授权账户和人工接管;云浏览器最适合公开、突发性的任务,前提是服务商的政策和区域都合适;无头 worker 最适合没有个人配置文件、需要确定性 CI 的场景。持久会话和高并发在运维方向上彼此拉扯,所以要把这种取舍写清楚,而不是断言某一种运行时在任何情况下都最好。
| 运行时 | 适用场景 | 注意事项 |
|---|---|---|
| Local real browser | 已登录状态下的操作与可见的人工接管 | 机器在线时长、配置文件安全、规模受限 |
| Cloud browser | 公开任务、突发容量、按区域执行 | 服务商政策、计量计费、数据驻留、登录限制 |
| Headless CI | 可重复的测试与隔离构建 | 没有个人会话、视觉盲区、验证页 |
部署时遵循最小权限原则,加密 trace,限制并发,加入健康检查,并保留人工恢复路径。绝不要在缺乏强访问控制的情况下暴露浏览器调试端点或远程桌面,也绝不要把云服务商的“stealth”标签当作访问受保护内容的许可。
FAQ
agent-browser 和 Browser Use 是同一个东西吗?
不是。agent-browser 是 Vercel Labs 的 CLI 工具:由你的 Agent 决定每一步,CLI 负责执行。Browser Use 是一个自主框架,运行自己的 LLM 循环。两者完全处于技术栈的不同层。
agent-browser 能用我已登录的 Chrome 吗?
它可以连接到 CDP 端点(agent-browser --cdp 9222),从而接入你用调试端口打开的 Chrome,但这条路径一贯的注意事项同样适用:Chrome 136+ 的配置文件限制、端口安全,以及 Agent 会在该浏览器真实的标签页中操作。它自己的会话按设计保持隔离。
为什么 ego (lite) 在复杂任务上比 agent-browser 更快?
差别在执行模型,而不是引擎速度。agent-browser 每完成一次模型往返只执行一条命令;ego (lite) 的 Agent 会把整个工作流写成一个 JavaScript 程序,在浏览器运行时中一次执行到底,所以一个 20 步的任务只需一次往返,而不是 20 次。在 Real-World Bench 上,这体现为 ego (lite) 每个任务平均 30.3 次模型轮次,而 agent-browser 为 45.6 次。另一项 heredoc 与 REPL 的独立测量则单独量化了同一机制:相比逐条命令执行,执行轮次减少 44%,工具调用减少 35.5%,成本降低 21.6%。
Real-World Bench 的数据是怎么测出来的?
31 个任务的测试套件,针对线上生产站点,五个工具,使用同一个模型(gpt-5.6-sol,max effort)。执行与评判是两个独立阶段:一个独立的 judge agent 只使用只读工具,根据原始会话日志、真实工具结果和截图对每次运行打分,且负面判定不会触发重跑。每个任务最多包含 6 条二元评分项(31 个任务的套件共 154 条);满分意味着所有评分项都通过。这里三个工具的结果是:ego (lite) 在 31 个任务中 93.5% 达到满分,agent-browser 在 31 个任务中为 62.9%,而 chrome-devtools-cli(用来替代 DevTools MCP 服务器进行测量)在 31 个任务中为 61.3%。测试框架、任务和原始判定结果都公开在 citrolabs/ego-browser-benchmark-framework 仓库中。
这三个都能配合 Claude Code、Cursor 和 Codex 使用吗?
它们可以通过不同机制协同工作:agent-browser 以 CLI 形式安装,任何支持 shell 的兼容 Agent 都能运行它(另外还有可选的 MCP 模式);DevTools MCP 通过各客户端的 MCP 配置注册;ego (lite) 则在 onboarding 期间把 /ego-browser skill 安装到受支持的 Agent 中。部署前请确认各项目当前的兼容性。
这三个真的都免费吗?
软件本身可能可以免费安装:agent-browser 采用 Apache-2.0 许可,Chrome DevTools MCP 是开源的,ego (lite) 可以免费下载但闭源。托管、浏览器服务商、模型用量、存储、维护和人工审核仍然会带来运行成本。
OpenAI Atlas 是什么?
OpenAI Atlas 是一款面向 macOS 的 Chromium 内核浏览器,于 2025 年 10 月 21 日发布,侧边栏内置了 ChatGPT,可以回答当前页面的问题、总结内容并改写选中的文本(Wikipedia)。付费的 Plus 和 Pro 订阅用户可以启用可选的 Agent 模式,让 ChatGPT 与网站交互,代为完成任务(Wikipedia)。
OpenAI Atlas 现在还能用吗?
不能。OpenAI 在 2026 年 3 月宣布将把 Atlas、ChatGPT 桌面应用和 Codex 合并为一个应用,随后于 2026 年 8 月 9 日关停了 ChatGPT Atlas(Wikipedia)。这款浏览器已不再提供下载,也无法继续使用。
Atlas 与 ego (lite) 相比如何?
Atlas 是一款集成式桌面浏览器,自己管理状态,运行在自己的窗口中;而 ego (lite) 是一个完整的 Chromium,不会把你锁定在单一的助手或单一的桌面应用上。Atlas 的 Agent 模式只对付费订阅用户开放,其可靠性也在一篇评测中受到质疑;而 ego (lite) 免费,并且是为经过授权的登录态工作而设计的(Wikipedia,MIT Technology Review)。
不用 OpenAI Atlas 的话,我该用什么?
如果你要在自己的登录态下处理日常工作,ego (lite) 提供了一个本地共享浏览器,带隔离的 Space(隔离空间),可在 macOS 上免费下载。对于无状态的公开数据任务,agent-browser 提供了一个用完即弃的 CLI 浏览器;而要诊断线上页面,Chrome DevTools MCP 在获得授权后可以连接到你自己正在使用的 Chrome。每个工具都针对一项具体工作,而不是试图做成一个集成式浏览器。