Lohnt sich für Browser-Agenten ein Wechsel zu Claude Fable 5.2?

Wenn Ihr Browser-Agent derzeit mit 5.1 läuft, würden wir einen Wechsel zu Claude Fable 5.2 empfehlen. Es ist schneller, günstiger und genauer. In unserem Vergleich von Claude Fable 5.2 und 5.1 führten wir jedes Modell einmal auf denselben 28 Web-Aufgaben aus. Fable 5.2 bestand 89.3% davon und Fable 5.1 82.1%. Bei den Aufgaben, die beide Modelle bestanden, brauchte Fable 5.2 418.5 Sekunden und $2.63 pro Aufgabe, gegenüber 450.6 Sekunden und $3.28 für Fable 5.1.
- Beim Sammeln derselben Angaben von mehreren offiziellen Websites hatte Fable 5.2 niedrigere Durchschnittskosten und eine etwas höhere Erfolgsquote.
- Bei Abläufen innerhalb einer einzelnen Web-Anwendung waren bei jedem der beiden Modelle alle 4 Versuche erfolgreich, und Fable 5.2 kostete pro Aufgabe weniger.
- Wenn Ihre Hauptaufgabe jedoch offene Recherche ist, kostete Fable 5.1 etwas weniger und hielt dabei dieselbe Erfolgsquote wie Fable 5.2.
| Modell | Erfolgsquote | Zeit pro bestandener Aufgabe | Kosten pro bestandener Aufgabe | Kosten pro erfolgreichem Versuch |
|---|---|---|---|---|
| Claude Fable 5.2 | 89.3% (25/28) | 418.5 s | $2.63 | $3.13 |
| Claude Fable 5.1 | 82.1% (23/28) | 450.6 s | $3.28 | $4.85 |
Wo Fable 5.2 zu Ende bringt, was sein Vorgänger nicht schaffte
Beide Fable-Modelle sind leistungsfähige Browser-Agenten. Deshalb testeten wir sie mit Alltagsaufgaben, die hohe Anforderungen stellen. Eine davon war die Wahl eines Arbeitstelefons: eine Spezifikationstabelle für neun Flaggschiff-Smartphones mit vielen Feldern pro Gerät, jeweils anhand der Website des Herstellers erstellen. Auf der Übersichtsseite des OnePlus 15 stehen die IP-Schutzarten nur in einem Produktbild ohne Alternativtext. Beide Modelle öffneten diese Seite in ego(lite). Fable 5.2 machte einen Screenshot des Bildes und las alle vier Schutzarten: IP66, IP68, IP69 und IP69K.
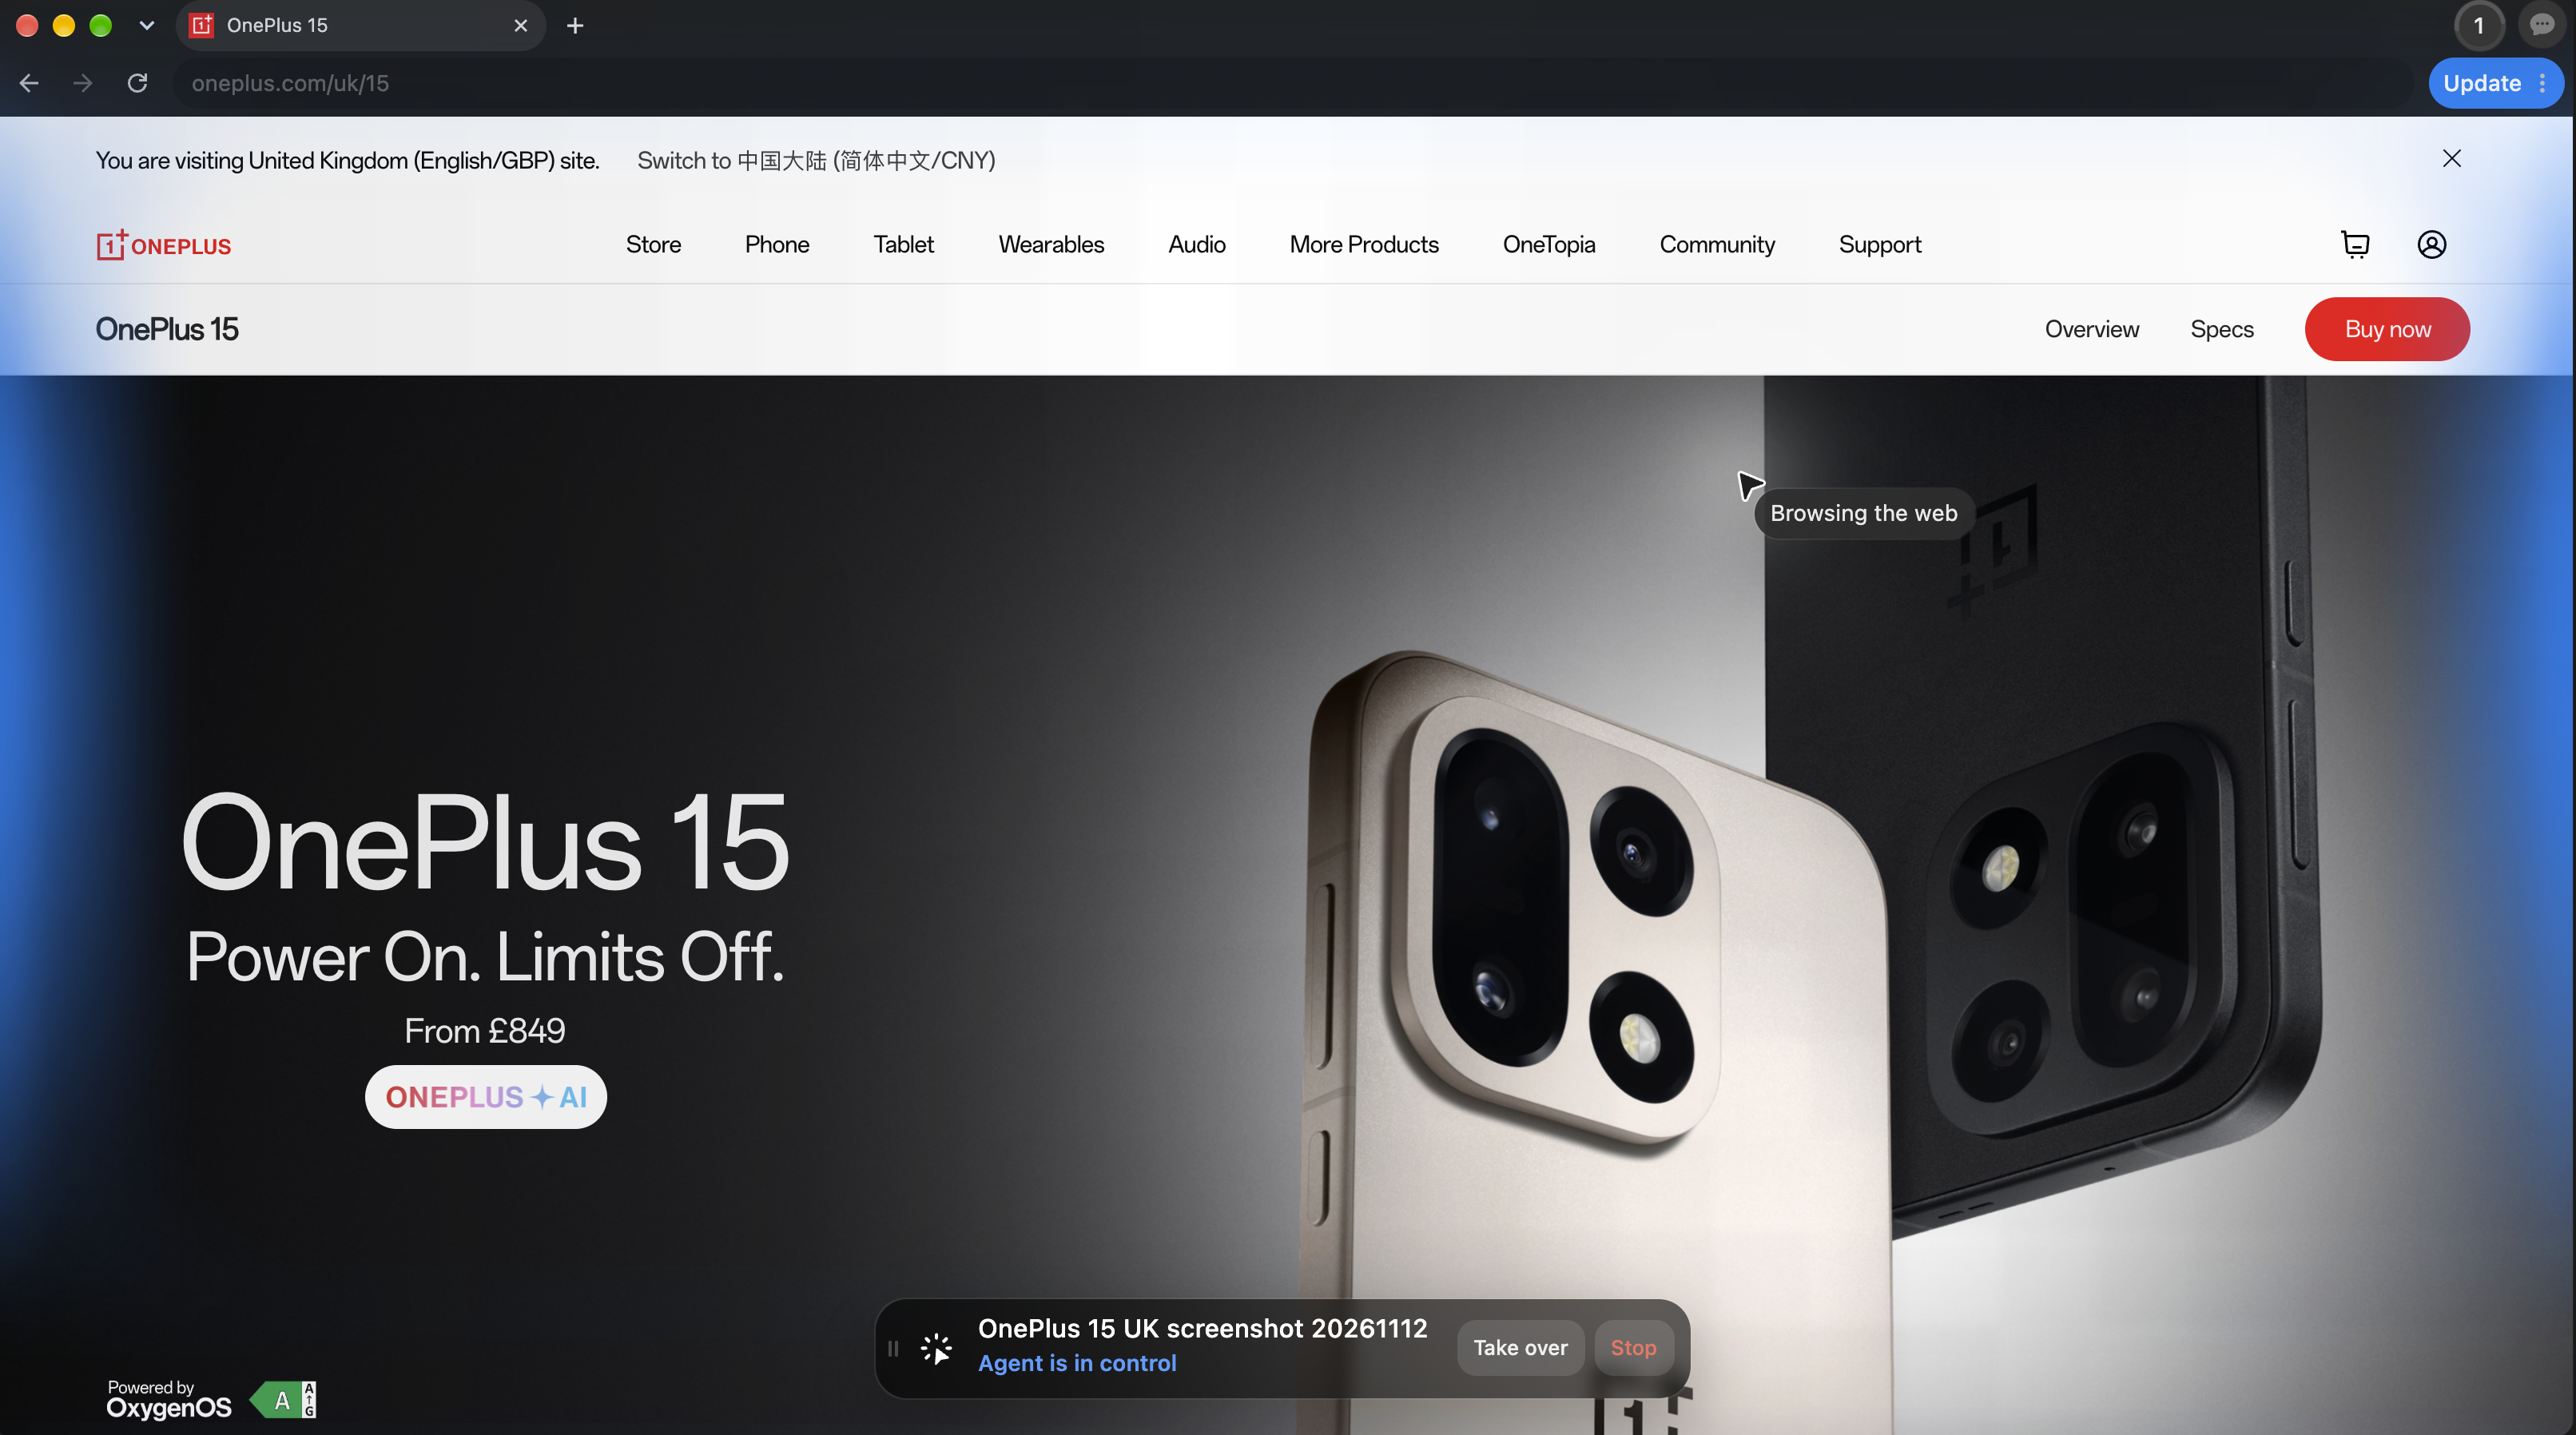
Fable 5.1 suchte im Text derselben Seite nach IP-Codes und fand keine. Anschließend entnahm es IP68 einer Ökodesign-Zeile auf der Spezifikationsseite. Seine endgültige Tabelle nannte für das OnePlus 15 nur eine Schutzart; deshalb fehlte das Telefon auch in seiner Liste der IP69-Geräte. Fable 5.2 machte bei dieser Aufgabe 65 Tool-Aufrufe und Fable 5.1 31. Die richtige Antwort kostete daher $6.04 gegenüber $3.13.
Wo Fable 5.1 bereits gut genug arbeitet
Fable 5.1 ist ein fähiger Browser-Agent, und es bleibt sinnvoll, dabei zu bleiben. Es bestand jeden Ablauf in Web-Anwendungen und jede Rechercheaufgabe, etwa Reisebuchungen, das Ausfüllen von Bestellungen und das Zurückverfolgen von Informationsquellen. Wenn Ihr Agent hauptsächlich solche Aufgaben erledigt, bringt ein Wechsel keinen deutlichen Anstieg der abgeschlossenen Aufgaben. Der tatsächliche Gewinn wäre ein um etwa 20% niedrigerer Preis. Fable 5.2 bleibt jedoch die bessere Wahl, wenn Ihr Agent häufig lange Spezifikationstabellen oder Vergleichstabellen über mehrere Websites ausfüllt. In solchen Fällen ist ein fehlender oder falscher Wert meist schwer zu erkennen.
Warum Fable 5.2 günstiger ist
Fable 5.2 ist vor allem günstiger, weil Anthropic den Preis gesenkt hat. Seine Listenpreise liegen für jede Token-Art 20% unter denen von Fable 5.1. Das ist auch der wichtigste Grund, warum wir einen Wechsel empfehlen. Bei der Effizienz erledigten die beiden etwa gleich viel Arbeit, um eine Aufgabe zu beenden. Fable 5.2 erzeugte pro Aufgabe etwa 18% weniger Ausgabe-Tokens, machte aber ein paar mehr Tool-Aufrufe, 35 gegenüber 32. Beide Effekte gleichen sich aus. Zu den Tarifen von Fable 5.1 wäre die Rechnung gleich hoch.
Bei einem Browser-Agenten bezahlen Sie das Modell hauptsächlich fürs Lesen, nicht fürs Schreiben. Etwa 70% der Ausgaben von Fable 5.2 entfielen auf seinen Kontext: die abgerufenen Seitentexte, Snapshots und Screenshots sowie seine früheren Schritte. Diesen Kontext liest es in jeder Runde erneut. Deshalb kosten Arbeiten, die sich über zu viele Websites erstrecken, oft am meisten. Das Sammeln derselben Angaben von 8 bis 12 offiziellen Websites kostete mit Fable 5.2 $4.65 pro Aufgabe, eine Suche auf höchstens drei Websites hingegen $1.35. Wir würden das Budget nach der Art der Arbeit Ihres Agenten planen, nicht allein nach dem Preis des Modells.
Die größere Ersparnis zeigt sich pro verwendbarem Ergebnis. Wenn eine Aufgabe schiefging, gab Fable 5.1 vor dem Abbruch mehr aus. Deshalb entfiel etwa ein Drittel seiner Gesamtausgaben auf fehlgeschlagene Versuche, gegenüber einem Achtel bei Fable 5.2. Rechnet man diese Fehlschläge ein, kostete jeder erfolgreiche Versuch mit Fable 5.1 $4.85 und mit Fable 5.2 $3.13. Diese Kennzahl würden wir beim Kostenvergleich genauer ansehen.
Als Tabelle anzeigen
| Tätigkeitsart | Fable 5.2 erfolgreich | Fable 5.1 erfolgreich | Fable 5.2: Kosten pro Aufgabe | Fable 5.1: Kosten pro Aufgabe | Aufgaben in der Kostenberechnung |
|---|---|---|---|---|---|
| Alle Tätigkeitsarten | 25/28 | 23/28 | $2.63 | $3.28 | 23 |
| Datensammlung über mehrere Websites | 9/10 | 8/10 | $4.65 | $5.77 | 8 |
| Suche und Vergleich | 8/8 | 7/8 | $1.35 | $1.84 | 7 |
| Automatisierung von Web-Anwendungen | 4/4 | 4/4 | $1.44 | $1.84 | 4 |
| Recherche und Zusammenführung | 3/3 | 3/3 | $2.02 | $1.87 | 3 |
| Social-Media-Verifikation | 1/3 | 1/3 | $1.96 | $3.32 | 1 |
So führen Sie es aus
Wir führten claude-fable-5-2 in Claude Code mit der Reasoning-Einstellung high und den Werkzeugen Bash, Read, Write, Edit und Skill aus. Der Agent lädt die Skill-Datei von ego-browser und steuert ego(lite) über ego-browser. Er schreibt kurze JavaScript-Skripte, die ego-browser ausführt, um Seiten in ego(lite) zu steuern.
Häufige Fragen
Ist Claude Fable 5.2 für Browser-Agenten besser als Fable 5.1?
In unseren Tests ja: Claude Fable 5.2 bestand jede Aufgabe, die Fable 5.1 bestand, und zwei weitere. Bei 28 Web-Aufgaben, jeweils einmal im selben Agenten-Framework und mit demselben Browser-Tool ausgeführt, waren bei Fable 5.2 25 von 28 Versuchen (89.3%) und bei Fable 5.1 23 von 28 (82.1%) erfolgreich. Eine der zusätzlich bestandenen Aufgaben war eine Spezifikationstabelle, bei der Fable 5.2 IP-Codes aus einem Produktbild las.
Lohnt sich ein Upgrade von Fable 5.1 auf Claude Fable 5.2?
Ja, für Browser-Agenten lohnt sich das Upgrade auf Claude Fable 5.2, weil es für dieselbe Arbeit weniger kostete und jede Aufgabe ebenfalls bestand, die Fable 5.1 bestanden hatte. Bei ihm waren 25 von 28 Versuchen erfolgreich, bei Fable 5.1 23 von 28. Bei den 23 Aufgaben, die beide Modelle bestanden, kostete es $2.63 pro Aufgabe gegenüber $3.28. Diese Ersparnis entspricht der Preissenkung von Anthropic um 20%.
Ist Claude Fable 5.2 pro Aufgabe günstiger als Fable 5.1 oder nur pro Token?
Claude Fable 5.2 ist sowohl pro Aufgabe als auch pro Token günstiger: $2.63 gegenüber $3.28 bei den 23 Web-Aufgaben, die beide Modelle bestanden. Seine Listenpreise sind für jede Token-Art 20% niedriger. Zu den Tarifen von Fable 5.1 würde sein Verbrauch bei diesen Aufgaben etwa $3.28 kosten. Die Ersparnis pro Aufgabe bei abgeschlossener Arbeit ist also die Preissenkung.
Verbraucht Claude Fable 5.2 weniger Tokens als Fable 5.1?
Über alle 28 Versuche verbrauchte Claude Fable 5.2 29% weniger Ausgabe-Tokens: 20 138 pro Versuch gegenüber 28 481 für Fable 5.1. Bei den 23 Aufgaben, die beide Modelle bestanden, erzeugte es weiterhin weniger Ausgabe-Tokens, 18 581 pro Aufgabe gegenüber 22 607. Bei gleichen Tarifen würde sein gesamter Verbrauch bei diesen Aufgaben ungefähr genauso viel kosten wie der von Fable 5.1.
Ist Claude Fable 5.2 bei Browser-Aufgaben schneller als Fable 5.1?
Ja, etwas: Bei den 23 Web-Aufgaben, die beide Modelle bestanden, benötigte Claude Fable 5.2 418.5 Sekunden pro Aufgabe und Fable 5.1 450.6 Sekunden. Fable 5.2 war bei 13 dieser 23 Aufgaben schneller. Beide liefen im selben Agenten-Framework und mit demselben Browser-Tool. Die Zeit schließt das Warten auf die Modell-API ein.
Was kostet es, Claude Fable 5.2 als Browser-Agenten einzusetzen?
In unseren Tests kostete Claude Fable 5.2 bei den 23 Web-Aufgaben, die beide Modelle bestanden, durchschnittlich $2.63 pro Aufgabe und unter Einbeziehung aller 28 Versuche $3.13 pro erfolgreichem Versuch. Fable 5.1 kostete $3.28 pro Aufgabe und $4.85 pro erfolgreichem Versuch. Datensammlung über mehrere Websites war die teuerste Tätigkeitsart, mit $4.65 pro Aufgabe für Fable 5.2.
Was kann Claude Fable 5.2 bei der Browser-Automatisierung gut?
Claude Fable 5.2 war in unseren Tests bei jedem Versuch zur Automatisierung von Web-Anwendungen, zu Suche und Vergleich sowie zur Recherche erfolgreich. Bei der Datensammlung über mehrere Websites waren es 9 von 10 Versuchen. Fable 5.1 bestand 8 von 10 Versuchen über mehrere Websites und 7 von 8 bei Suche und Vergleich. Die beiden zusätzlich bestandenen Aufgaben von Fable 5.2 lagen in diesen zwei Tätigkeitsarten.
Wo kann Claude Fable 5.1 weiterhin mit Fable 5.2 mithalten?
Claude Fable 5.1 hielt bei Abläufen in Web-Anwendungen und bei offener Recherche mit Fable 5.2 mit. Bei jedem der beiden Modelle waren alle 4 Versuche zur Automatisierung von Web-Anwendungen und alle 3 Versuche zu Recherche und Zusammenführung erfolgreich. Bei der Recherche kostete Fable 5.1 $1.87 pro Aufgabe gegenüber $2.02. Bei Abläufen in Web-Anwendungen war dagegen Fable 5.2 mit $1.44 gegenüber $1.84 günstiger.
Hört Claude Fable 5.2 auf, bevor mehrstufige Browser-Aufgaben fertig sind?
In unseren Tests nicht: Jeder Versuch von Claude Fable 5.2 endete mit einer endgültigen Antwort, und keiner brauchte das Budget von 100 Schritten auf. Seine drei Fehlschläge waren endgültige Antworten, die nicht jeden erforderlichen Wert korrekt angaben.
Kann Claude Fable 5.2 Browser-Aufgaben unbeaufsichtigt ausführen?
Claude Fable 5.2 erledigte die meisten Aufgaben selbstständig und war in 25 von 28 Versuchen erfolgreich. Aber auch jeder seiner drei Fehlschläge endete mit einer endgültigen Antwort, die Fehler enthielt. Zweimal übernahm es Werte aus der falschen Quelle, etwa einer späteren Sicherheitsversion oder einer anderen regionalen Pressemitteilung. Prüfen Sie bei Veröffentlichungs- oder Preisdaten, von welcher Seite jeder Wert stammt.
Wie kann Claude Fable 5.2 einen Browser nutzen?
Claude Fable 5.2 kann einen Browser über ein Agenten-Framework und ein Browser-Tool steuern. In unseren Tests lief es in Claude Code und steuerte ego(lite) über ego-browser. Dazu schrieb es kurze JavaScript-Skripte, die ego-browser zur Steuerung der Seiten ausführte. Mit dieser Konfiguration war es bei Web-Aufgaben in 25 von 28 Versuchen erfolgreich.
Unser Testverfahren
Wir verglichen Claude Fable 5.2 (claude-fable-5-2) und Claude Fable 5.1 (claude-fable-5-1), beide mit der Reasoning-Einstellung high, im selben Agenten-Framework: Claude Code mit den Werkzeugen Bash, Read, Write, Edit und Skill. Beide steuerten ego(lite) über ego-browser. Je nach Anforderung des Modellskripts stellt ego-browser die Seite als Accessibility-Snapshot, Seitentext oder Screenshot bereit. Wir führten die Tests am 12. November 2026 unter Linux aus.
Die 28 Aufgaben decken fünf Tätigkeitsarten ab. Automatisierung von Web-Anwendungen bezeichnet Abläufe in geschäftlichen Testanwendungen, etwa den Abgleich von Rechnungen mit Zahlungen. „Suche und Vergleich“ umfasst eine bis drei Websites, etwa die Prüfung der Browser-Unterstützung auf MDN und Can I use. Bei der Datensammlung über mehrere Websites werden dieselben Felder auf 8 bis 12 offiziellen Websites erhoben, etwa Zinsentscheidungen von 12 Zentralbanken. „Recherche und Zusammenführung“ ist offen angelegt, etwa das Zurückverfolgen einer Wikipedia-Tabelle zu ihren Quellen. Die Überprüfung sozialer Medien gleicht X-Beiträge mit offiziellen Seiten ab. Jede Aufgabe gehört einer Tätigkeitsart an.
Jedes Modell führte jede Aufgabe einmal aus; ein Durchlauf einer Aufgabe ist ein Versuch. Ein Versuch ist erfolgreich, wenn seine endgültige Antwort jeden erforderlichen Wert richtig angibt. Für jeden Versuch galten maximal 100 Schritte und 60 Minuten. Ein Schritt ist eine Runde des Modells, ein Tool-Aufruf ein Aufruf des Modells an ein Tool und ein Browser-Befehl ein an ego-browser übergebenes Skript. Die Zeit ist die tatsächlich verstrichene Dauer pro Versuch, einschließlich der Wartezeit auf die Modell-API. Die Kosten sind in US-Dollar angegeben und werden aus dem Token-Verbrauch jedes Versuchs zu den Listenpreisen von Anthropic berechnet. Cache-Lese- und Cache-Schreibvorgänge werden jeweils zu ihren eigenen Tarifen berücksichtigt. Zeit und Kosten pro bestandener Aufgabe werden bei den 23 Aufgaben verglichen, die beide Modelle bestanden. Die Kosten pro erfolgreichem Versuch ergeben sich aus den Kosten sämtlicher Versuche geteilt durch die Zahl der erfolgreichen Versuche.
Vollständige Ergebnisse
Jede Zelle zeigt, ob der einzelne Versuch des Modells erfolgreich war, wie viele Sekunden er einschließlich der Wartezeit auf die Modell-API dauerte und was er in US-Dollar kostete. Die Durchschnittswerte an anderer Stelle verwenden ungerundete Kosten.
| Aufgabe | Tätigkeitsart | Claude Fable 5.2 | Claude Fable 5.1 |
|---|---|---|---|
| Flüge, Sitzplätze und ein Hotel nach einer Reiserichtlinie in einer Buchungsanwendung buchen | Automatisierung von Web-Anwendungen | Erfolgreich · 220.0 s · $1.66 | Erfolgreich · 208.2 s · $2.19 |
| Dienstmonitore in einer Monitoring-Anwendung an einen schriftlichen Standard anpassen | Automatisierung von Web-Anwendungen | Erfolgreich · 140.7 s · $1.02 | Erfolgreich · 158.2 s · $1.60 |
| Bestellungen anhand von Lagerbeständen in einer Lageranwendung erstellen | Automatisierung von Web-Anwendungen | Erfolgreich · 163.0 s · $1.06 | Erfolgreich · 128.2 s · $1.29 |
| Februarrechnungen mit Zahlungen abgleichen und Streitfälle in einer Finanzanwendung eröffnen | Automatisierung von Web-Anwendungen | Erfolgreich · 316.3 s · $2.02 | Erfolgreich · 308.8 s · $2.28 |
| Kapitel eines Vorlesungsvideos anhand des zugehörigen GitHub-Codes und arXiv-Papers prüfen | Suche und Vergleich | Erfolgreich · 136.3 s · $1.14 | Erfolgreich · 221.8 s · $1.57 |
| Inflationswerte anhand von FRED berechnen und bei BLS bestätigen | Suche und Vergleich | Erfolgreich · 122.7 s · $1.03 | Erfolgreich · 93.3 s · $1.11 |
| Browser-Unterstützung für sechs Web-Funktionen auf MDN und Can I use gegenprüfen | Suche und Vergleich | Erfolgreich · 179.2 s · $1.14 | Erfolgreich · 239.1 s · $2.13 |
| Die günstigsten Nonstop-Tarife für drei Städte auf einer Flugsuchseite finden | Suche und Vergleich | Erfolgreich · 683.0 s · $2.24 | Fehlgeschlagen · 768.3 s · $4.41 |
| Phase-3-Studien auf ClinicalTrials.gov mit ihren DailyMed-Arzneimittelinformationen abgleichen | Suche und Vergleich | Erfolgreich · 178.6 s · $1.52 | Erfolgreich · 267.6 s · $2.24 |
| Preise von drei Laptop-Konfigurationen im US-Shop eines Herstellers ermitteln und vergleichen | Suche und Vergleich | Erfolgreich · 378.2 s · $2.46 | Erfolgreich · 392.0 s · $3.17 |
| Kinokassenumsätze von sechs Filmen zwischen einer Datenbank für Kinokassenumsätze und Wikipedia abgleichen | Suche und Vergleich | Erfolgreich · 102.2 s · $1.09 | Erfolgreich · 87.6 s · $1.12 |
| Vier britische Unternehmen bei Companies House prüfen | Suche und Vergleich | Erfolgreich · 101.2 s · $1.09 | Erfolgreich · 185.4 s · $1.52 |
| Eine Compliance-Matrix aus 9 SaaS-Trust-Centern erstellen | Datensammlung über mehrere Websites | Erfolgreich · 1110.0 s · $6.16 | Erfolgreich · 737.9 s · $5.56 |
| Fünf Spezifikationen für 8 Kameras von Herstellerseiten sammeln | Datensammlung über mehrere Websites | Erfolgreich · 482.4 s · $3.49 | Erfolgreich · 480.9 s · $4.35 |
| Fünf Spezifikationen für 9 Flaggschiff-Smartphones von den britischen Websites der Hersteller sammeln | Datensammlung über mehrere Websites | Erfolgreich · 992.6 s · $6.04 | Fehlgeschlagen · 467.5 s · $3.13 |
| Details zu den Eröffnungsvorträgen von 9 Entwicklerkonferenzen sammeln | Datensammlung über mehrere Websites | Erfolgreich · 920.8 s · $4.85 | Erfolgreich · 1168.4 s · $8.85 |
| Reichweiten- und Ladedaten für 9 Elektro-SUVs von den US-Websites der Hersteller sammeln | Datensammlung über mehrere Websites | Erfolgreich · 1120.9 s · $6.91 | Erfolgreich · 1261.0 s · $6.91 |
| Spezifikationen und Lizenzen von 9 Modellen mit offenen Gewichten auf Hugging Face und Anbieterseiten sammeln | Datensammlung über mehrere Websites | Erfolgreich · 758.7 s · $5.24 | Erfolgreich · 1059.6 s · $6.26 |
| Gesetzliche Mindestlöhne von 9 Arbeitsbehörden sammeln | Datensammlung über mehrere Websites | Erfolgreich · 567.0 s · $4.25 | Erfolgreich · 640.1 s · $5.32 |
| Die erste Zinsentscheidung des Jahres 2026 von 12 Zentralbankseiten sammeln | Datensammlung über mehrere Websites | Erfolgreich · 525.9 s · $3.51 | Erfolgreich · 435.1 s · $4.52 |
| Kostenlose Tarife von 9 Serverless-Plattformen vergleichen | Datensammlung über mehrere Websites | Erfolgreich · 501.1 s · $2.77 | Erfolgreich · 665.2 s · $4.40 |
| Den Eintrag eines Albums bei 9 Musikdiensten vergleichen | Datensammlung über mehrere Websites | Fehlgeschlagen · 408.6 s · $1.98 | Fehlgeschlagen · 292.4 s · $2.22 |
| Modelle oberhalb der EU-Schwellenwerte für den Rechenaufwand in einer öffentlichen Modelldatenbank zählen | Recherche und Zusammenführung | Erfolgreich · 195.2 s · $1.64 | Erfolgreich · 80.4 s · $1.08 |
| Kosten- und Punktwerte aus einer interaktiven Ranglistengrafik ablesen | Recherche und Zusammenführung | Erfolgreich · 317.1 s · $2.39 | Erfolgreich · 327.3 s · $2.41 |
| 10 Zellen einer Wikipedia-Tabelle zu ihren Quellen zurückverfolgen | Recherche und Zusammenführung | Erfolgreich · 382.2 s · $2.03 | Erfolgreich · 342.7 s · $2.12 |
| Produktbeiträge von 8 Marken auf X mit ihren Pressemitteilungen abgleichen | Social-Media-Verifikation | Fehlgeschlagen · 1132.7 s · $3.79 | Fehlgeschlagen · 2200.8 s · $14.22 |
| Sicherheitsbeiträge von 8 Open-Source-Projekten auf X mit deren eigenen Ankündigungen abgleichen | Social-Media-Verifikation | Fehlgeschlagen · 750.8 s · $3.75 | Fehlgeschlagen · 3302.8 s · $12.30 |
| Die Beiträge einer Woche über SpaceX-Starts auf X mit den Wikipedia-Listen zu Starts abgleichen | Social-Media-Verifikation | Erfolgreich · 706.2 s · $1.96 | Erfolgreich · 875.8 s · $3.32 |