
Paginar en web scraping no consiste solo en llegar a la página siguiente. Lo difícil es saber si aún queda más dato que recoger y cuándo la lista ha terminado de verdad. La mayoría de los sitios usan uno de tres patrones, páginas numeradas, Load More o scroll infinito, y cada uno pide una estrategia de navegación, una condición de espera y una regla de parada distintas. Si se equivoca, un crawler puede detenerse pronto sin lanzar nunca un error.
Si los datos ya están en el HTML o en un endpoint JSON, por lo general no hace falta ningún navegador; HTTP simple es más sencillo y más rápido. El navegador resulta útil cuando la lista depende de renderizado en el cliente, de una sesión autenticada, de tokens generados en la página o de un desplazamiento real. Y cuando esos datos dependen de un navegador en el que ya ha iniciado sesión, ego (lite) permite que un agente de IA ejecute la misma lógica de paginación dentro de esa sesión existente, en lugar de reconstruir el estado de inicio de sesión.
En las secciones siguientes comprobamos páginas numeradas, Load More y scroll infinito con una sola pregunta: ¿la lista terminó de verdad, o el crawler simplemente dejó de pedir más? Los ejemplos usan un fixture local repetible con 135 filas en páginas numeradas, 81 filas renderizadas detrás de Load More y un feed infinito de 60 ítems. Al final, el crawler no solo pagina: también registra dónde se detuvo, trata duplicados y filas perdidas y comprueba que los datos recogidos estén completos.
Cómo saber qué modo de paginación tiene delante
Tres observaciones cierran la clasificación. Cambiar la URL o hacer clic en un enlace numerado altera el conjunto de resultados: eso es paginación numerada. Un botón cuyo rótulo promete más contenido añade filas sin cambiar la URL: eso es cargar más. Filas que aparecen al desplazarse, sin control en el que hacer clic, son scroll infinito. Cuando una página mezcla patrones, trate cada transición como un modo propio, en lugar de forzar un solo bucle a cubrir ambos.
Una comprobación rápida en el navegador lo resuelve antes que leer el código: abra DevTools, observe el panel de red e interactúe una vez. Una solicitud de navegación con un parámetro de página es paginación numerada. Una solicitud JSON o HTML en segundo plano disparada por un clic es cargar más. Solicitudes que se repiten al desplazarse son scroll infinito, y la respuesta suele traer el siguiente offset, un regalo para un crawler.
Páginas numeradas: derive la regla de URL y deténgase en el momento correcto
La paginación numerada es el modo más amable porque el estado vive en la URL. Derive la regla de las tres primeras páginas: qué parámetro cambia, si es un número de página o un offset, y si el tamaño de página es fijo. La regla debe poder expresarse como una función, y una función correcta produce la página 4 a partir de la 3 sin visitar nada en medio.
// Derive once, then verify against page 2 and page 3 before trusting it.
const pageUrl = (n) => `https://example.com/listings?page=${n}`;

let page = 1;
const rows = [];
while (true) {
  await browserPage.goto(pageUrl(page));
  const batch = await browserPage.locator("tr.row").evaluateAll((nodes) =>
    nodes.map((node) => ({
      id: node.dataset.id,
      title: node.querySelector(".title").textContent.trim(),
      price: Number(node.querySelector(".price").textContent.replace(/[^0-9.]/g, "")),
    })),
  );
  if (batch.length === 0) break;
  rows.push(...batch);

  const hasNext = (await browserPage.locator("a#next").count()) > 0;
  if (!hasNext) break;
  page += 1;
}
El final merece más cuidado del que suele recibir. Un enlace next ausente y un lote vacío son señales reales de fin; un total fijo de páginas no lo es, porque las listas crecen y el número grabado hoy estará mal el mes que viene. En la ejecución del fixture, el crawler recorrió las páginas 1 a 5, recogió 135 filas en 80 milliseconds y se detuvo cuando desapareció el enlace next. Una de esas cinco solicitudes devolvió un 503 en el primer intento, el crawler reintentó la misma página una vez y el reintento funcionó.
Dos reglas mantienen el bucle honesto. Primero, pause entre solicitudes de página en lugar de dispararlas lo más rápido posible, y respete los términos del sitio y el protocolo de exclusión robots descrito en RFC 9309. Segundo, trate una página repetida como señal de parada cuando la lista debería estar ordenada, porque una paginación que ignora sus propios parámetros puede, si no, girar para siempre.
Cargar más: haga clic, espere y deduplique
Cargar más esconde el estado detrás de un botón, así que el crawler tiene que crear el crecimiento: hacer clic, esperar a que el recuento de filas suba de verdad, recoger lo nuevo y repetir hasta que el botón desaparezca o deje de cambiar nada. La espera es donde fallan la mayoría de las implementaciones. Una pausa fija suele funcionar en una conexión rápida y recorta la lista en silencio en una lenta.
await browserPage.goto("https://example.com/listings");

while (true) {
  const button = browserPage.locator("#load-more");
  if ((await button.count()) === 0) break;

  const before = await browserPage.locator("tr.row").count();
  await button.click();
  await browserPage.waitForFunction(
    (n) => document.querySelectorAll("tr.row").length > n,
    before,
    { timeout: 10000 },
  );
}

const rows = await browserPage.locator("tr.row").evaluateAll((nodes) =>
  nodes.map((node) => ({ id: node.dataset.id, title: node.textContent.trim() })),
);
En la ejecución del fixture, cuatro lotes de veinte filas llegaron en 273 milliseconds, y la lista visible tenía 81 filas frente a un dataset de 80. La fila extra era un duplicado que el fixture planta para modelar una realidad habitual: el mismo registro llega dos veces entre lotes. La línea de estado de la propia página leía "Loaded 81 of 80", un buen recordatorio de que el contador que renderiza el sitio no es una fuente de validación. Deduplique con un identificador estable como el record id de la fila, no con el título visible, y quitará exactamente ese duplicado.
Scroll infinito: disparadores, estabilidad de altura y reglas de parada
El scroll infinito no tiene botón ni URL, así que el disparador y la condición de parada hay que inferirlos. El disparador suele ser un elemento centinela que entra en el viewport o un umbral de posición de desplazamiento. La condición de parada es donde hace falta criterio, porque la lista no anuncia el fin de un modo en el que se pueda hacer clic.
Vale la pena mostrar un fallo medido porque es el fallo con el que salen de fábrica la mayoría de los crawlers. Desplazarse al final una vez y comprobar si creció el recuento de filas, sin esperar a que se renderice el siguiente lote, informa "no growth" al instante: el fixture se detuvo en 15 of 60 filas, un lote adentro, mientras la red ya había pedido el lote siguiente. La comprobación no se equivocó de instante; se equivocó al tratar un momento quieto como el fin de la lista.
La versión fiable espera una condición observable y luego confirma el fin en varias comprobaciones, no en una. Desplácese, espere a que crezca el recuento de ítems o a que la página declare que el feed terminó, y solo cuando no ocurra ninguna de las dos cosas durante tres comprobaciones consecutivas trate la lista como terminada. En el fixture, los mismos 60 ítems se completaron en cuatro rondas de desplazamiento con cero paradas falsas, y la línea de estado final leía "End of feed (60 of 60)".
let stableChecks = 0;
while (stableChecks < 3) {
  const items = await browserPage.locator("article.post").count();
  await browserPage.evaluate(() => window.scrollTo(0, document.body.scrollHeight));

  const grew = await browserPage
    .waitForFunction(
      (n) =>
        document.querySelectorAll("article.post").length > n ||
        /end of feed/i.test(document.body.innerText),
      items,
      { timeout: 3000 },
    )
    .then(() => true)
    .catch(() => false);

  stableChecks = grew ? 0 : stableChecks + 1;
  if (!grew) await browserPage.waitForTimeout(700);
}
Dos detalles marcan la diferencia entre un bucle estable y uno inestable. La estabilidad de altura debe juzgarse por el recuento de ítems extraídos, no por la altura del documento, porque las imágenes diferidas y los anuncios cambian la altura sin añadir registros. Y el desplazamiento debe volver a disparar de verdad el cargador del sitio: las implementaciones construidas sobre la Intersection Observer API se disparan ante cambios de intersección, así que alternar las posiciones de desplazamiento es más fiable que dejar la página fija al final.
Guarde el estado del crawl y reanude tras un fallo
Los tres modos comparten un requisito: una ejecución tiene que sobrevivir a su propia interrupción. Escriba un checkpoint después de cada lote completado, con el modo, la posición y los registros recogidos hasta entonces, y haga que reanudar sea el camino por defecto, no uno especial. En el fixture, el crawl numerado se interrumpió después de la página 2 con 54 filas en el checkpoint. Un proceso nuevo leyó el checkpoint, siguió desde la página 3 y terminó con las mismas 135 filas y 133 ids únicos que una ejecución sin interrupción.
import { readFileSync, writeFileSync } from "node:fs";

const CHECKPOINT = "./crawl-state.json";
const save = (state) => writeFileSync(CHECKPOINT, JSON.stringify(state));
const load = () => {
  try {
    return JSON.parse(readFileSync(CHECKPOINT, "utf8"));
  } catch {
    return { mode: "numbered", lastPage: 0, rows: [] };
  }
};

const state = load();
for (let page = state.lastPage + 1; page <= 5; page += 1) {
  state.rows.push(...(await crawlPage(page)));
  state.lastPage = page;
  save(state); // checkpoint after every page
}
El checkpoint también cambia la depuración. Cuando un crawl produce un recuento incorrecto, puede inspeccionar el archivo de estado en lugar de volver a ejecutar todo el trabajo, y la posición guardada ahí indica qué lote volver a pedir.
Duplicados, filas perdidas y falsas últimas páginas
Tres síntomas cubren la mayoría de los fallos de paginación, y cada uno deja firma en los datos, no en el código. Los duplicados aparecen cuando un lote se solapa con el vecino, lo que ocurre cuando la lista de fondo reordena entre solicitudes y el identificador estable se repite. El fixture lo reprodujo exactamente: el mismo id apareció una vez en la página 2, otra en la página 3 y otra vez dentro de la página 5. Ambos duplicados desaparecieron con un dedupe basado en id.
Las filas perdidas suelen significar una espera demasiado corta o una página saltada. Si el total falta exactamente un lote, mire la interacción anterior al hueco; si falta una página, mire el incremento del bucle. El 503 transitorio del fixture es la otra cara de este fallo: sin reintento, la página 3 no habría aportado nada y la ejecución habría informado 106 filas sin error alguno.
Una falsa última página es la más peligrosa, porque el crawl informa éxito con menos datos. Ocurre cuando una página devuelve cero filas por un problema de sesión o de renderizado, no porque la lista haya terminado, y el bucle trata ambos casos igual. Distíngalos sondeando otra vez: pida de nuevo la página siguiente tras una breve pausa, y exija un marcador real de fin o dos respuestas vacías consecutivas antes de aceptar el final.
Valide recuentos y la integridad de los campos
Validar son dos comprobaciones que tardan segundos y pillan la mayoría de los fallos silenciosos. La comprobación de recuento compara lo recogido con cada cifra independiente que encuentre: el propio "page 5 of 5" de la última página numerada, un total en un encabezado o la suma de los recuentos por página vistos por el camino. La comprobación de campos confirma que cada registro lleva los campos que prometió el trabajo, y cuenta las excepciones en lugar de ignorarlas.
const unique = new Map(rows.map((row) => [row.id, row]));
const missing = rows.filter((row) => !row.title || !Number.isFinite(row.price));

console.log({
  raw: rows.length,
  unique: unique.size,
  removedDuplicates: rows.length - unique.size,
  missingFields: missing.length,
});
En las 135 filas numeradas del fixture, la comprobación informó cero campos faltantes, dos duplicados eliminados y 133 registros únicos, coincidiendo con el dataset. En la lista de cargar más informó un duplicado de 81. Ninguna cifra es interesante por sí sola; lo que importa es que un cambio en cualquiera se ve al instante, en lugar de aparecer luego en un informe con un hueco misterioso.
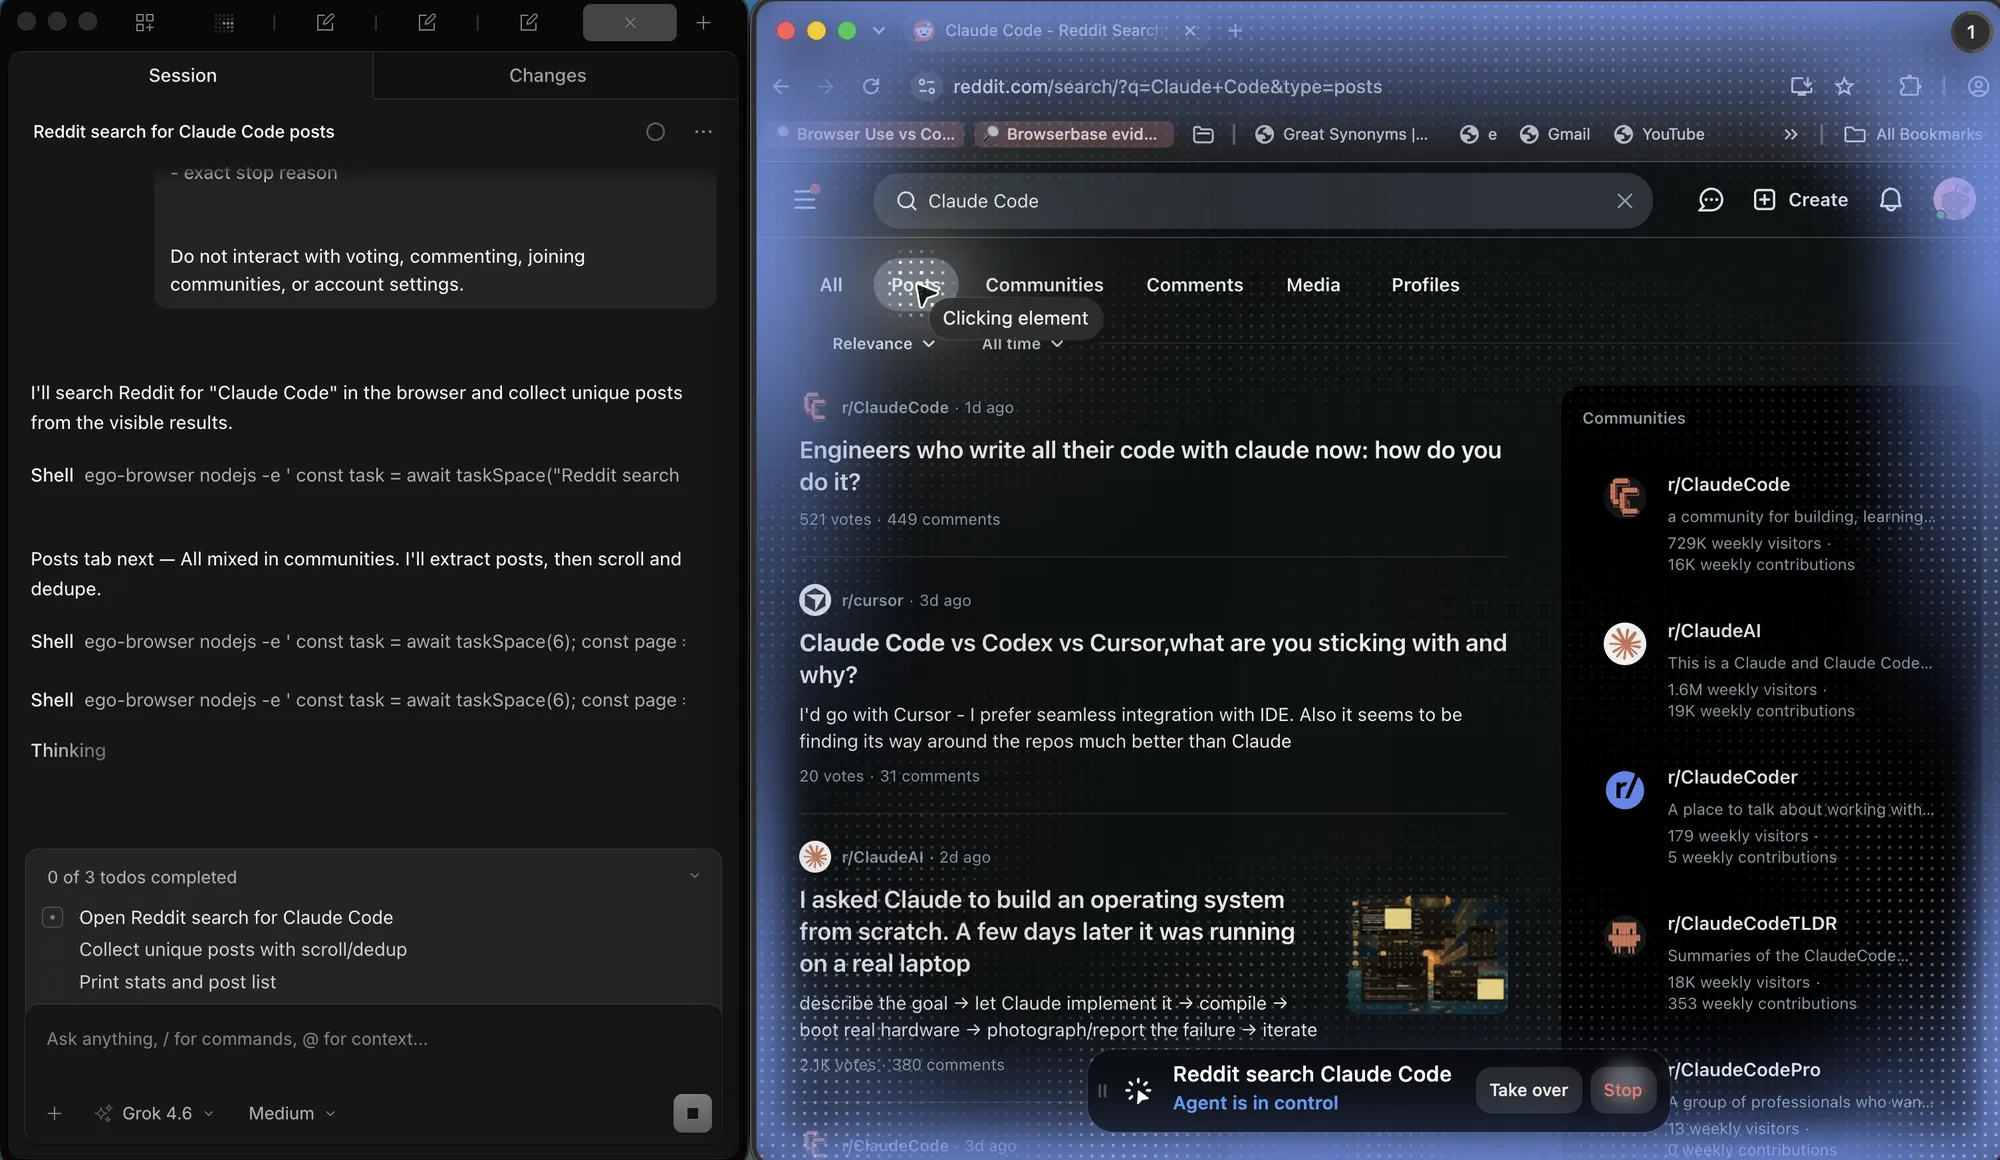
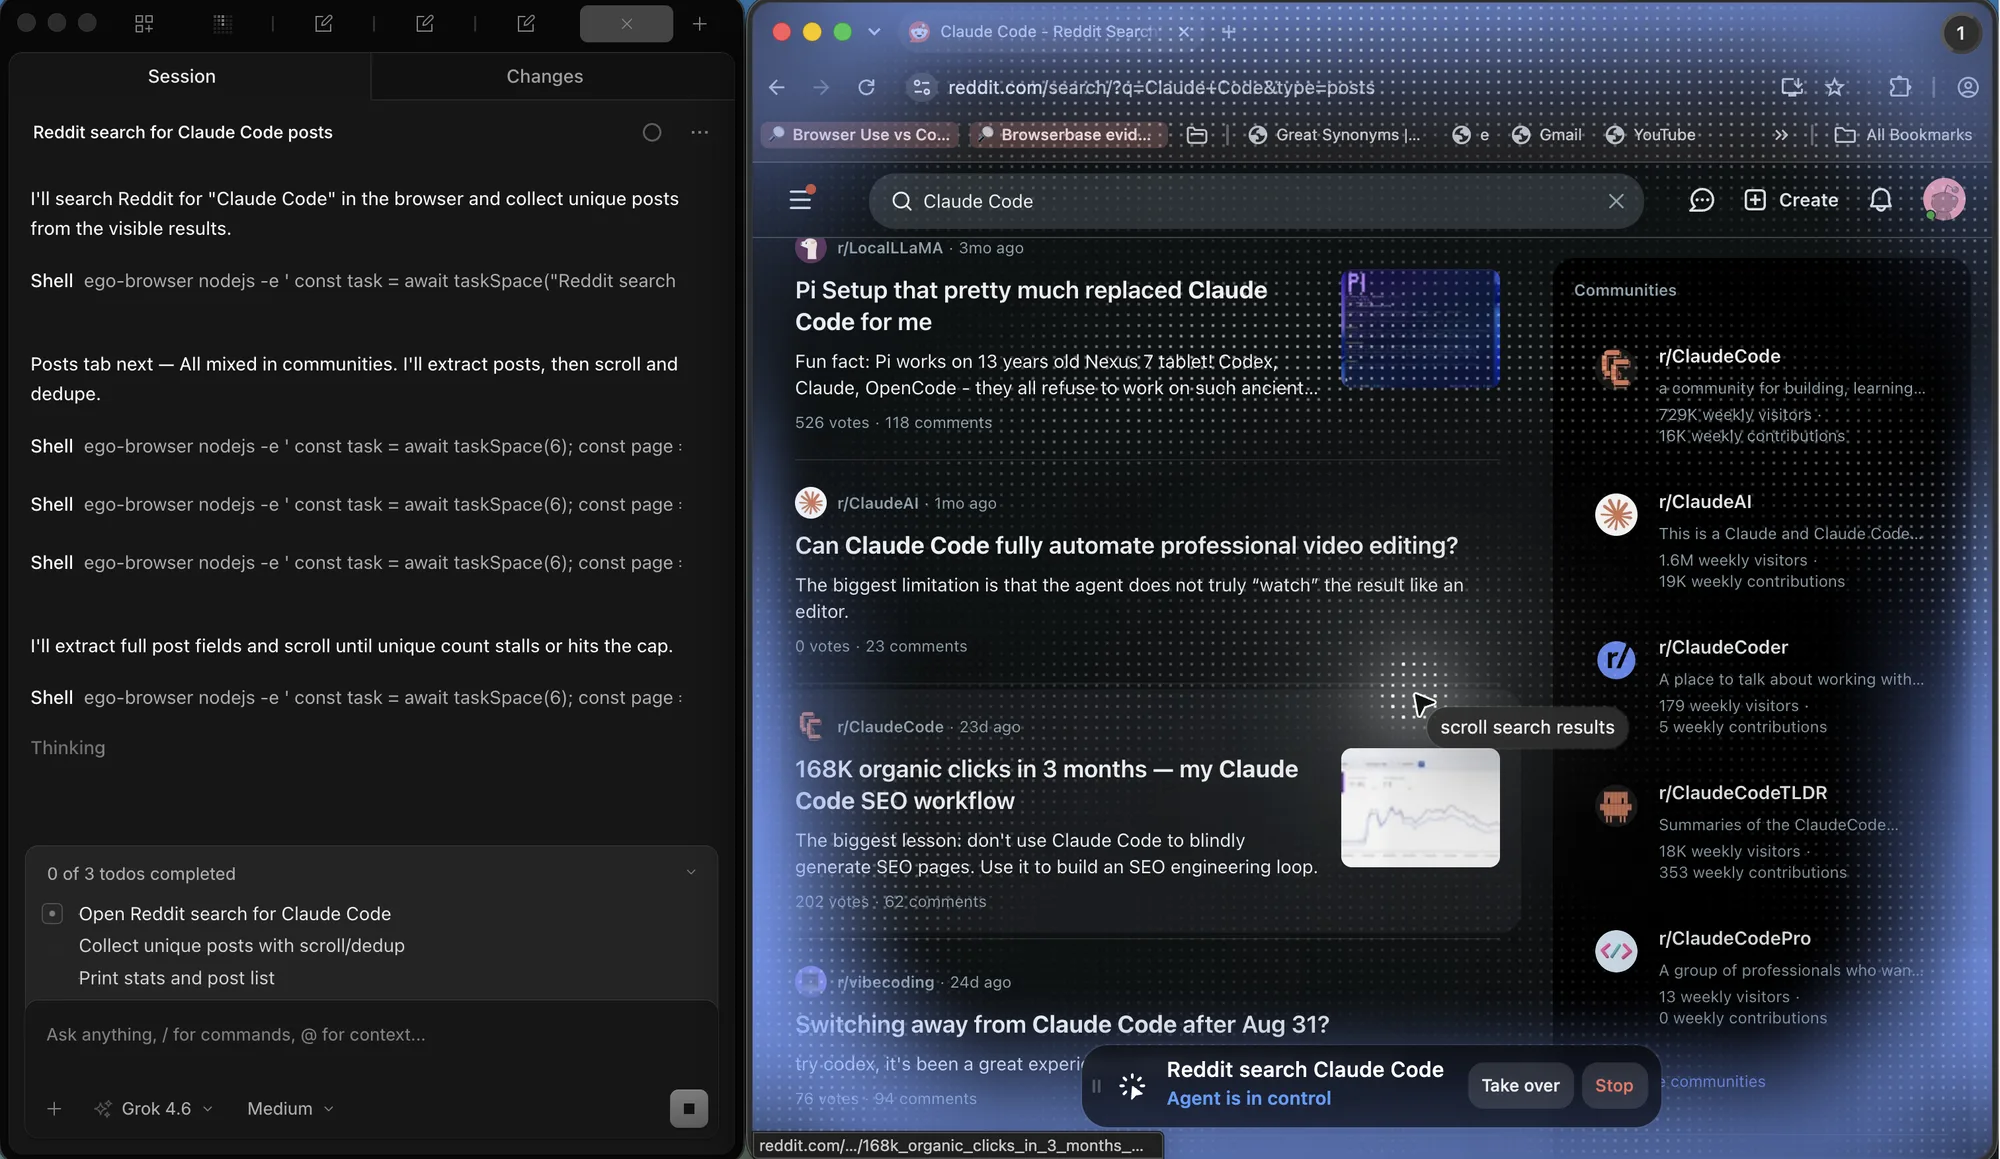
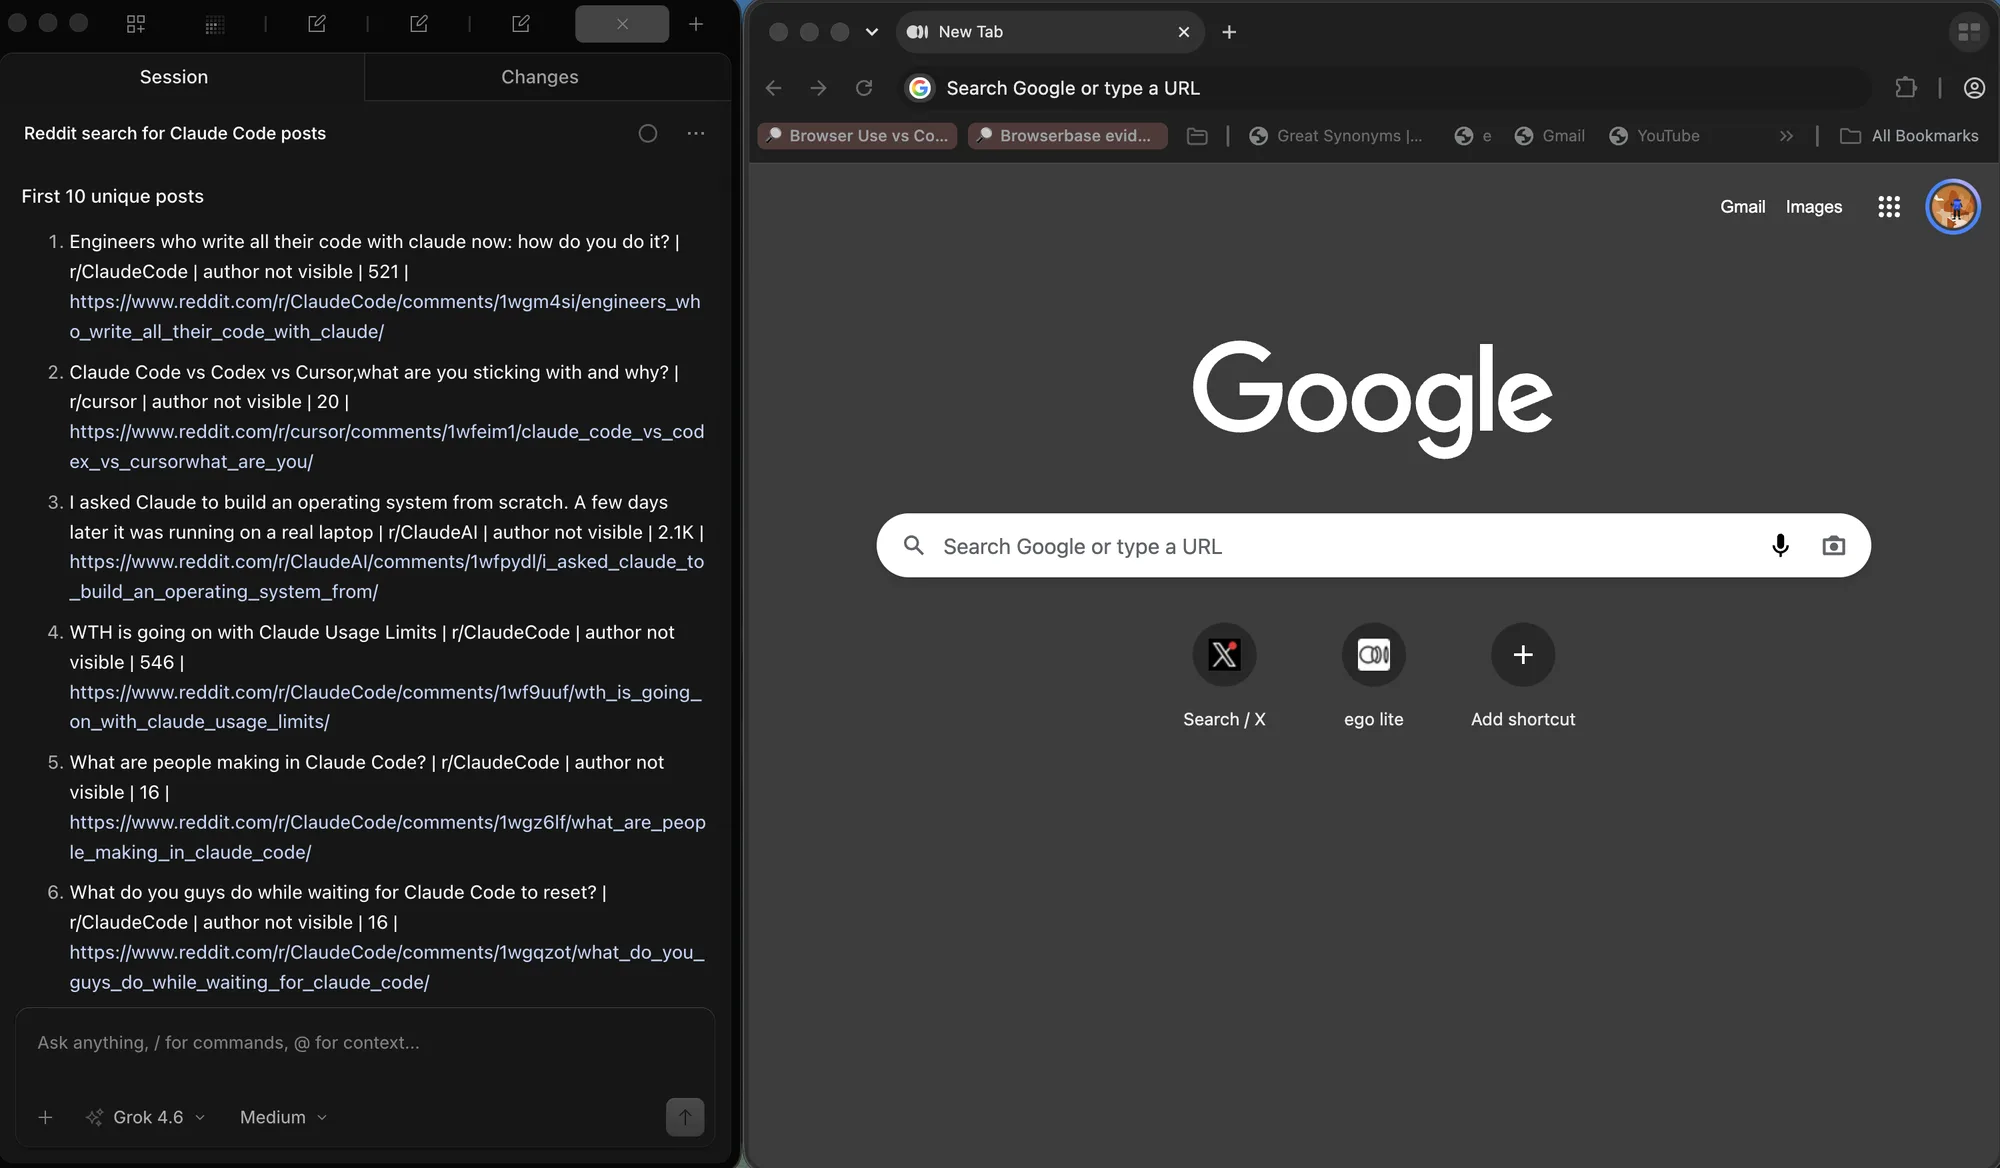
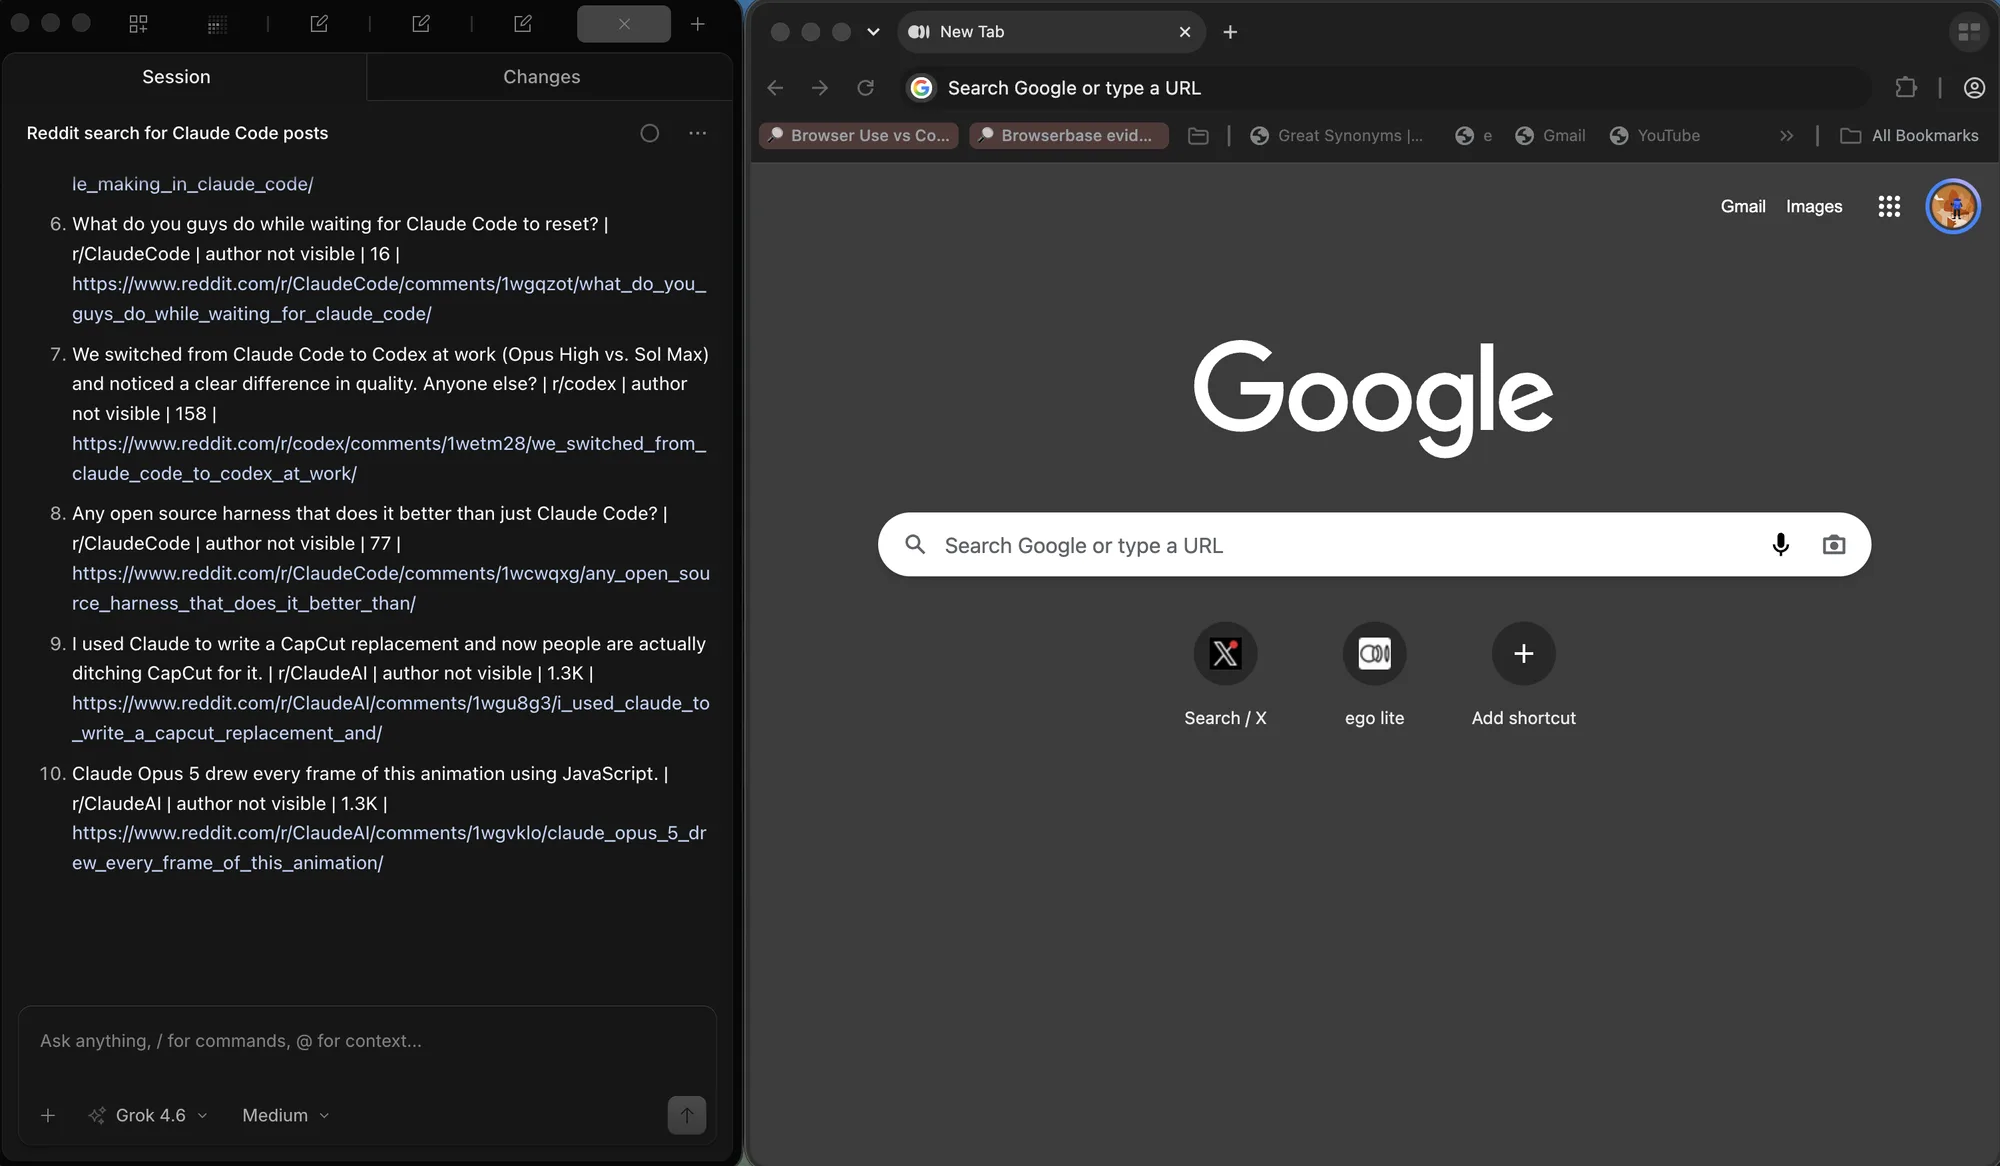
La ejecucion de Reddit uso la misma comprobacion sobre una lista unica en vivo, no sobre el fixture de 135 filas. Cada fila pedia titulo, subreddit, votos y URL. La salida numerada es lo que se valida despues del scroll.
Cuándo basta HTTP simple, y cuándo no
Los mismos datos del fixture se alcanzan sin navegador, y medir ambos caminos es la forma honesta de decidir qué necesita el trabajo. Un cliente HTTP simple recorrió las páginas numeradas por URL, pidió los lotes de cargar más a su endpoint JSON y tiró del feed infinito por offset, recogiendo las 135, 81 y 60 filas en 24 milliseconds combinados. Sin renderizado, sin esperas, sin desplazamiento.
Esa es la recomendación por defecto, y conviene decirla sin rodeos: si existe una API oficial, úsela. Si la lista numerada se renderiza en el servidor, pida las páginas directamente. Si los modos de cargar más o infinito se apoyan en un endpoint JSON sin firma, pida ese endpoint y pagine por el offset. Un framework como Playwright no hace falta para nada de eso, y el camino HTTP es más rápido y más barato de ejecutar. El recorrido de paginación de Apify, la documentación de selectores de paginación de Web Scraper y el flujo del panel de red en la guía de red de Playwright cubren el mismo terreno desde puntos de partida distintos.
Un navegador está justificado cuando los datos solo existen tras el renderizado en el cliente, cuando las solicitudes llevan una firma o un token generado en la página, cuando la lista exige inicio de sesión, o cuando el endpoint responde distinto sin una sesión real y un user agent real. En ese punto el navegador no es una preferencia de scraping, es el único camino honesto, y las secciones anteriores se aplican igual.
ego (lite) entra solo después de que ese camino HTTP falle. Si la lista necesita una cookie con sesión, un token generado en la página o un desplazamiento que nunca ocurre sin un viewport real, ejecute el mismo bucle numbered / load-more / infinite dentro de un navegador que ya sostiene la sesión. No empiece por ahí. El fixture ya mostró la respuesta más barata: 135, 81 y 60 filas por HTTP simple en 24 ms.
Cuando de verdad necesite el navegador, conserve la lógica de crawl de las secciones anteriores. ego (lite) aporta la página con sesión y un Space que puede observar; no inventa un algoritmo de paginación nuevo. Si un paso necesita a una persona, deténgase. Si curl o una API oficial ya devuelven las filas, quédese en HTTP.
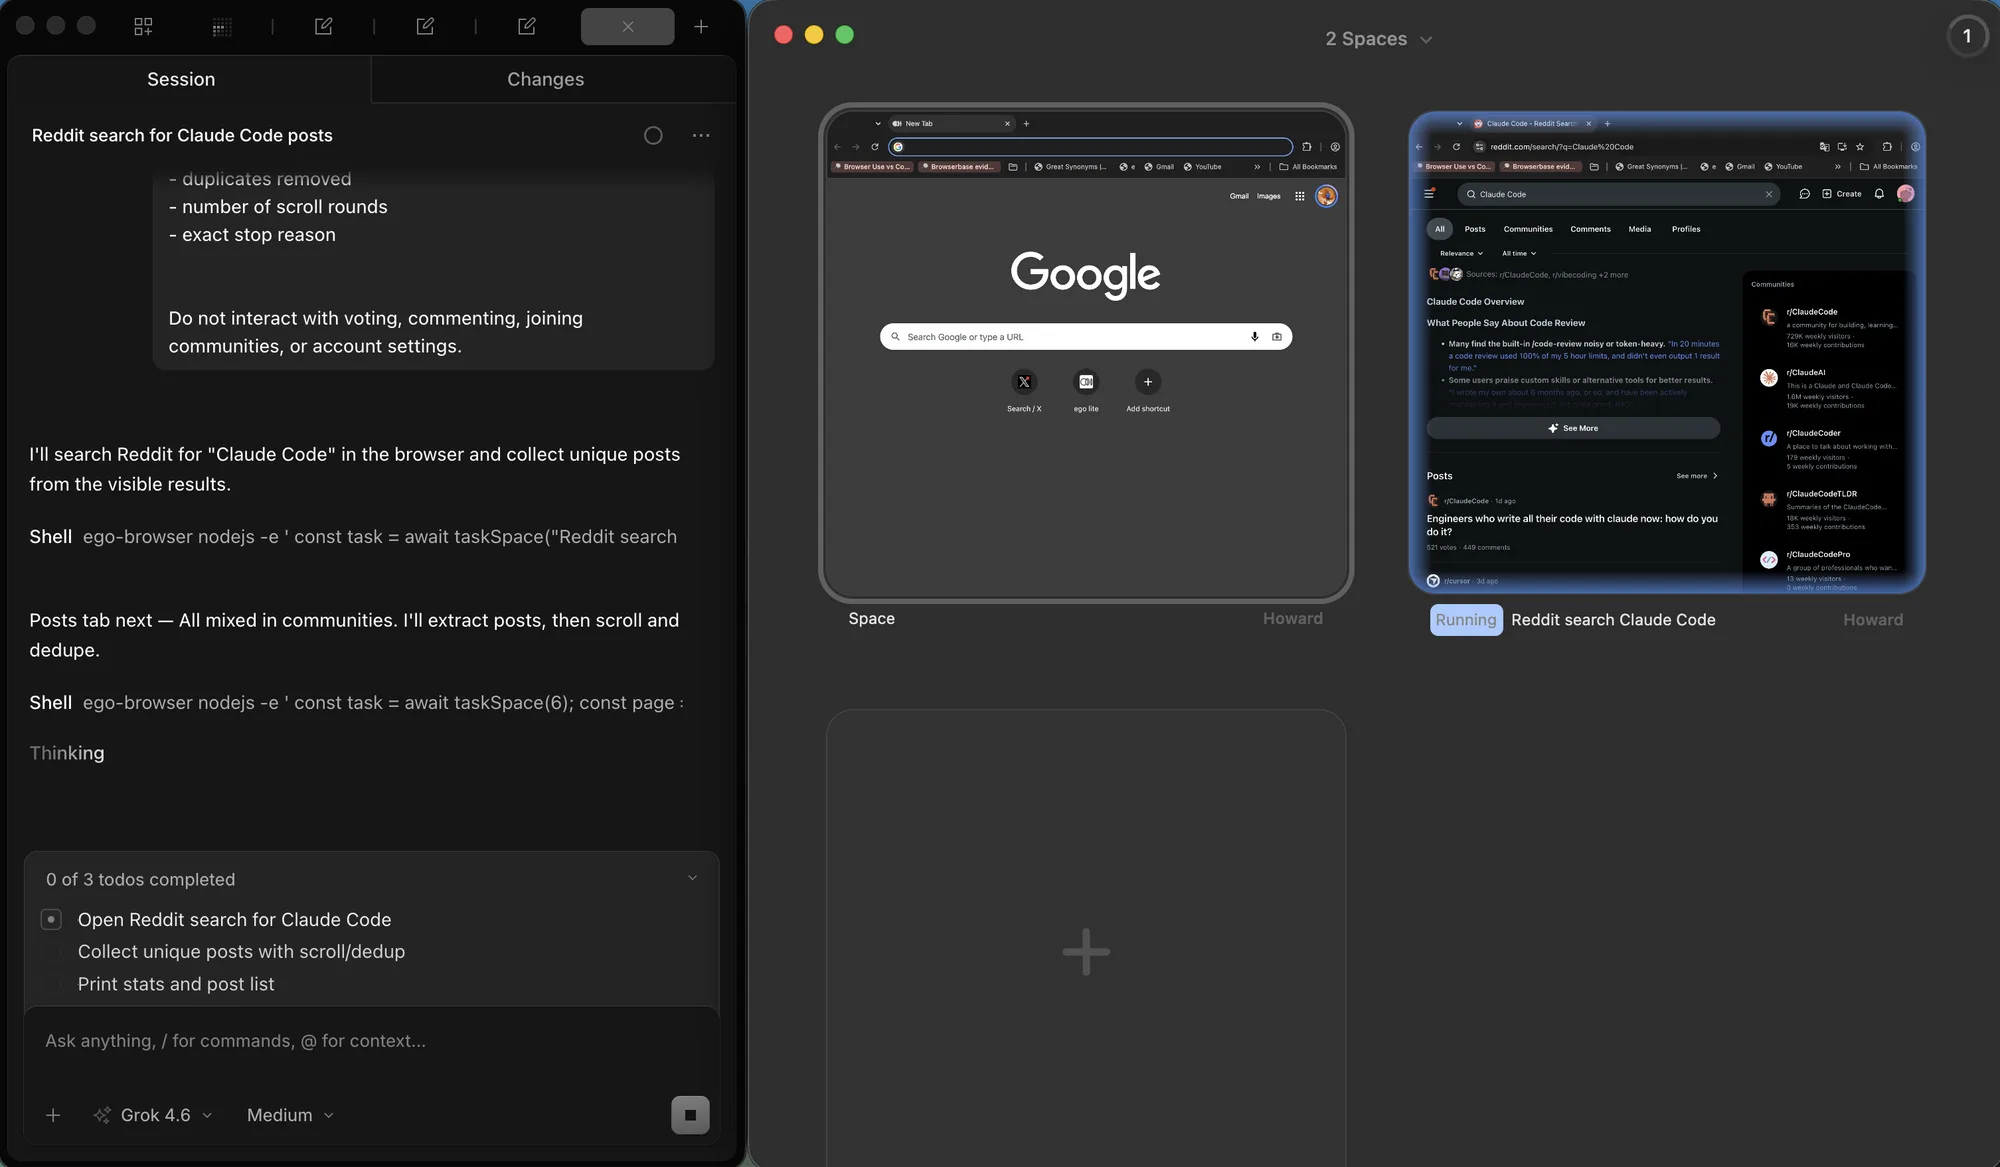
La regla de aislamiento de las paginas numeradas sigue valiendo. Dos crawlers que comparten una ventana pelean por la posicion de scroll y se pisan la ultima fila vista. En el mismo navegador, dos Spaces equivalen a dos contextos de Playwright: uno puede quedar idle en Google mientras el otro sigue haciendo scroll en Reddit. El punto es el aislamiento. La vista general solo permite ver ambos a la vez.
La versión 0.5.0.32 consta en el registro de cambios (2026-09-12). Vuelva a comprobar esa página, la guía de inicio rápido y el repositorio de GitHub antes de citar un build más nuevo. La guía vecina Web scraping con JavaScript aborda la decisión entre estático y renderizado desde el otro lado.
FAQ
¿Cómo sé cuántas páginas tiene una lista numerada?
Sabe cuántas páginas tiene una lista numerada leyendo el control de última página, dividiendo un total del encabezado entre el tamaño de página y recorriendo hasta el final una vez. Trate esa estimación como una comprobación, no como la condición de parada del bucle.
¿Por qué mi scraper recoge duplicados entre páginas?
Los scrapers recogen duplicados entre páginas cuando la lista de fondo reordena y un registro pasa de un lote al siguiente. Deduplique con un record id estable, no con el título visible, y anote cuántos duplicados quitó.
¿Cuánto debo esperar después de hacer clic en cargar más?
Hasta que una condición observable sea verdadera: el recuento de filas subió, el estado disabled del botón se despejó o apareció una fila conocida del siguiente lote. Un retraso fijo es una conjetura que funciona hasta que la red es lenta, que es exactamente cuando falla.
¿Cómo detecto el final de un feed infinito?
Prefiera una señal explícita cuando el sitio ofrezca una, como un mensaje de fin renderizado o un indicador has-more en la respuesta. Sin ninguna de las dos, exija varias comprobaciones seguidas sin ítems nuevos y sin cambio de altura en el contenido cargado antes de detenerse, no un solo momento quieto.
¿Debo usar un navegador headless para scraping con paginación?
Solo cuando los datos exijan renderizado, una sesión o tokens en la página. Las listas renderizadas en el servidor y los endpoints JSON se sirven mejor con HTTP simple, más rápido y más sencillo de ejecutar. Mida ambos caminos una vez; la comparación suele dejar la decisión clara.
¿Qué hace que un crawl paginado se detenga pronto?
Tres sospechosos habituales: una espera que terminó antes de que se renderizara el lote, un error transitorio tratado como página vacía, y una sesión que caducó a mitad de ejecución de modo que la página siguiente mostró el formulario de inicio de sesión en lugar de filas. Cada uno tiene un arreglo distinto, por eso el motivo de la parada debe anotarse junto al recuento.
¿Cómo reanudo un crawl después de un fallo?
Haga checkpoint después de cada lote completado con el modo, la posición y las filas recogidas hasta entonces. Reanudar lee ese archivo y vuelve a entrar en el modo en la posición registrada. Vuelva a pedir una vez el lote inmediatamente anterior a la posición del checkpoint, para confirmar que la fuente no se ha desplazado bajo el estado guardado.
¿Cómo valido que un crawl está completo?
Compare el recuento de registros únicos con al menos dos cifras independientes, como el total de la propia última página y la suma de los recuentos por página, luego compruebe la integridad de campos en cada fila e informe las excepciones. Un recuento que coincide y campos todos presentes es una señal fuerte; cualquiera de los dos por separado es débil.
¿Necesito desplazarme despacio para disparar la carga diferida?
Por lo general no, pero vuelva a disparar el cargador en lugar de quedarse al final. Los sitios usan observadores de intersección que se disparan con el cambio, así que alternar la posición o desplazarse a tramos es más fiable que un salto grande, y da sentido a la comprobación de crecimiento.
¿Puedo hacer scraping de una lista paginada detrás de un inicio de sesión?
Sí, con una sesión real y las mismas reglas: pagine con cortesía, mantenga viva la sesión y trate una redirección a la página de inicio de sesión como un problema de sesión, no como el fin de la lista. Un navegador que ya lleva su sesión, como ego (lite), elimina por completo el paso de reconstruir la sesión. La guía de sesión persistente cubre el manejo del estado, y el caso de uso de scraping de precios muestra cómo se ve una recogida completa con sesión iniciada.
