
Webスクレイピングのページネーションは、次のページへ進むことだけではありません。難しいのは、まだ取るべきデータがあるか、リストが本当に終わったかを判断することです。多くのサイトは番号ページ、Load More(もっと見る)、無限スクロールのいずれかで、それぞれ別の遷移、待ち条件、停止規則が要ります。ここを誤ると、エラーを出さずにクローラーが早く止まってしまいます。
データがHTMLやJSONエンドポイントに直接あるなら、ブラウザは通常不要です。素のHTTPの方が単純で速いからです。ブラウザが役立つのは、リストがクライアント側レンダリング、認証済みセッション、ページ内で生成されるToken、実際のスクロールに依存する場合です。そのデータが、すでにログインしているブラウザに依存するなら、ego (lite) はログイン状態を組み立て直す代わりに、既存セッションの中で同じページネーション論理を AI Agent に実行させます。
以降の節では、番号ページ、もっと見る、無限スクロールを同じ問いの下で試します。リストは本当に終わったのか、クローラーが追加の要求をやめただけなのか。例は再現可能なローカルフィクスチャで、番号ページに135行、もっと見るの裏に81行、無限フィードに60件あります。最後には、ページ送りだけでなく、停止位置の記録、重複と取りこぼしの処理、収集データの完全性確認まで行います。
どのページネーションモードかを見分ける
分類は3つの観察で決まります。URLを変えるか番号リンクをクリックすると結果集合が変わるなら番号ページネーションです。もっとあると約束するボタンが、URLを変えずに行を足すならもっと見るです。クリックする操作がなく、スクロールすると行が出るなら無限スクロールです。ページが混在しているときは、1つのループで両方を覆わず、遷移ごとに別モードとして扱います。
コードを読むより、ブラウザでの短い確認の方が早いです。DevToolsを開き、ネットワークパネルを見て、一度操作します。pageパラメータ付きの遷移は番号ページネーション、クリックで飛ぶ背景のJSONやHTMLはもっと見る、スクロールのたびに繰り返すリクエストは無限スクロールです。応答には次のoffsetが入っていることが多く、クローラーには都合のよい手がかりです。
番号ページ:URL規則を導き、正しく止める
番号ページネーションは扱いやすいです。状態がURLにあるからです。最初の3ページから規則を導きます。どのパラメータが変わるか、ページ番号かoffsetか、ページサイズは固定か。規則は関数として書けなければならず、正しい関数は3ページ目から4ページ目を、間を訪れることなく作れます。
// Derive once, then verify against page 2 and page 3 before trusting it.
const pageUrl = (n) => `https://example.com/listings?page=${n}`;

let page = 1;
const rows = [];
while (true) {
  await browserPage.goto(pageUrl(page));
  const batch = await browserPage.locator("tr.row").evaluateAll((nodes) =>
    nodes.map((node) => ({
      id: node.dataset.id,
      title: node.querySelector(".title").textContent.trim(),
      price: Number(node.querySelector(".price").textContent.replace(/[^0-9.]/g, "")),
    })),
  );
  if (batch.length === 0) break;
  rows.push(...batch);

  const hasNext = (await browserPage.locator("a#next").count()) > 0;
  if (!hasNext) break;
  page += 1;
}
終了条件は、普段より丁寧に扱う価値があります。次へリンクの欠落と空バッチはどちらも本物の終了信号です。固定の総ページ数はそうではありません。リストは増え、今日埋め込んだ数字は来月には外れます。フィクスチャ実行では、クローラーは1ページから5ページまで歩き、80 millisecondsで135行を集め、次へリンクが消えた時点で止まりました。5回のリクエストのうち1回は初回が503で、同じページを一度再試行して成功しています。
ループを誠実に保つ規則は2つです。第一に、ページ要求を最速で連射せず間を空け、サイトの規約と RFC 9309 に書かれた robots 除外プロトコルを守ること。第二に、並びが保たれるはずのリストでは、同じページの再出現を停止信号にすること。自分のパラメータを無視するページネーションは、そうしなければ永遠に回り続けます。
もっと見る:クリック、待機、重複排除
もっと見るは状態をボタンの裏に隠すので、クローラー自身が増分を作らねばなりません。クリックし、行数が本当に増えるまで待ち、新しい分を集め、ボタンが消えるか何も変えなくなるまで繰り返します。失敗の大半は待ちにあります。固定の休止は速い回線ではたまたま通り、遅い回線ではリストを静かに切り詰めます。
await browserPage.goto("https://example.com/listings");

while (true) {
  const button = browserPage.locator("#load-more");
  if ((await button.count()) === 0) break;

  const before = await browserPage.locator("tr.row").count();
  await button.click();
  await browserPage.waitForFunction(
    (n) => document.querySelectorAll("tr.row").length > n,
    before,
    { timeout: 10000 },
  );
}

const rows = await browserPage.locator("tr.row").evaluateAll((nodes) =>
  nodes.map((node) => ({ id: node.dataset.id, title: node.textContent.trim() })),
);
フィクスチャ実行では、20行ずつの4バッチが273 millisecondsで届き、見えるリストは81行、データセットは80行でした。余分な1行は、バッチをまたいで同じレコードが2回来るというよくある現実を模して、フィクスチャが埋め込んだ重複です。ページ自身の状態行は "Loaded 81 of 80" と出ており、サイトが描くカウンタは検証源にならない、というよい注意になります。見えるタイトルではなく、行の record id のような安定した識別子で重複排除すれば、その1件だけが消えます。
無限スクロール:トリガー、高さの安定、停止条件
無限スクロールにはボタンもURLもないので、トリガーも停止条件も推定が必要です。トリガーは多くの場合、番兵要素がビューポートに入ることか、スクロール位置の閾値です。停止条件こそ判断が要ります。リストはクリックできる形で終わりを告げないからです。
実測した失敗は示す価値があります。多くのクローラーが出荷時から抱える失敗だからです。一度だけ最下部までスクロールし、次バッチの描画を待たずに行数が増えたかを見ると、すぐ "no growth" と出ます。フィクスチャは60行中15行、1バッチ目で止まりましたが、ネットワークにはすでに次バッチが要求されていました。その瞬間の観察は間違っていません。静かな一瞬をリストの終わりと見なしたことが間違いです。
信頼できる版は、観察できる条件を待ち、終わりを1回ではなく複数回で確認します。スクロールし、件数が増えるか、ページがフィード終了と述べるまで待ち、どちらも3回連続で起きないときだけリストを終わったと見なします。フィクスチャでは同じ60件が4回のスクロールで完了し、誤停止はゼロ、最終の状態行は "End of feed (60 of 60)" でした。
let stableChecks = 0;
while (stableChecks < 3) {
  const items = await browserPage.locator("article.post").count();
  await browserPage.evaluate(() => window.scrollTo(0, document.body.scrollHeight));

  const grew = await browserPage
    .waitForFunction(
      (n) =>
        document.querySelectorAll("article.post").length > n ||
        /end of feed/i.test(document.body.innerText),
      items,
      { timeout: 3000 },
    )
    .then(() => true)
    .catch(() => false);

  stableChecks = grew ? 0 : stableChecks + 1;
  if (!grew) await browserPage.waitForTimeout(700);
}安定したループと不安定なループの差は、2つの細部にあります。高さの安定は文書の高さではなく、抽出した件数で判断します。遅延画像と広告は、レコードを足さずに高さを変えるからです。スクロールはサイトのローダーを本当に再起動しなければなりません。Intersection Observer API に基づく実装は交差の変化で発火するので、最下部に固定するよりスクロール位置を交互に動かす方が確実です。
クロール状態を記録し、クラッシュ後に再開する
3つのモードに共通する要件は1つです。実行は自分の中断に耐えねばなりません。完了したバッチごとにチェックポイントを書き、モード、位置、これまでに集めたレコードを含め、再開を特別扱いではなく既定の経路にします。フィクスチャでは、番号クロールは2ページの後に殺され、チェックポイントには54行がありました。新しいプロセスがそれを読み、3ページ目から続け、途切れない実行と同じ135行と133個の一意idで終わりました。
import { readFileSync, writeFileSync } from "node:fs";

const CHECKPOINT = "./crawl-state.json";
const save = (state) => writeFileSync(CHECKPOINT, JSON.stringify(state));
const load = () => {
  try {
    return JSON.parse(readFileSync(CHECKPOINT, "utf8"));
  } catch {
    return { mode: "numbered", lastPage: 0, rows: [] };
  }
};

const state = load();
for (let page = state.lastPage + 1; page <= 5; page += 1) {
  state.rows.push(...(await crawlPage(page)));
  state.lastPage = page;
  save(state); // checkpoint after every page
}
チェックポイントはデバッグも変えます。件数が間違っていたとき、仕事全体をやり直さず状態ファイルを見られ、そこに記録された位置が、どのバッチを取り直すべきかを示します。
重複、取りこぼし、偽の最終ページ
ページネーションの不具合の大半は3つの症状で覆え、それぞれコードではなくデータに署名があります。重複はバッチが隣と重なるときに出ます。下層のリストがリクエストの間に並び替わり、安定した識別子が繰り返されるからです。フィクスチャはこれを正確に再現しました。同じidが2ページ目に一度、3ページ目に再び、5ページ目の中でもう一度現れ、idに基づく重複排除で両方消えました。
取りこぼしは、待ちが短すぎたか、ページが飛ばされたことがほとんどです。合計がちょうど1バッチ足りなければ、不足の直前の操作を見ます。1ページ分足りなければ、ループの増分を見ます。フィクスチャの一時的な503は、この不具合の別の味です。再試行がなければ3ページ目は何も足さず、実行はエラーなしで106行と報告していたでしょう。
偽の最終ページが最も危険です。データが少ないまま成功と報告するからです。リストが終わったのではなく、セッションや描画の問題で0行が返ったときに起き、ループは両方を同じ扱いにします。もう一度探って区別します。短い待ちのあと次ページを再要求し、本物の終了印か、連続する2回の空応答があるまで終わりを認めません。
件数とフィールドの欠落を検証する
検証は数秒で済み、静かな失敗の大半を拾う2つの検査です。件数検査は、集めた数を、見つけられる独立した数字と照合します。最後の番号ページ自身の "page 5 of 5"、見出しの合計、途中で見たページごとの件数の和です。フィールド検査は、仕事が約束したフィールドを全レコードが持つかを確認し、例外を無視せず数えます。
const unique = new Map(rows.map((row) => [row.id, row]));
const missing = rows.filter((row) => !row.title || !Number.isFinite(row.price));

console.log({
  raw: rows.length,
  unique: unique.size,
  removedDuplicates: rows.length - unique.size,
  missingFields: missing.length,
});
フィクスチャの番号ページ135行では、欠落フィールド0、除去した重複2、一意レコード133と出て、データセットと完全に一致しました。もっと見る側では81件中1件の重複でした。数字そのものは面白くありません。重要なのは、どちらかが変わればすぐ見えることであり、下流の報告で原因不明の欠けとして出ないことです。
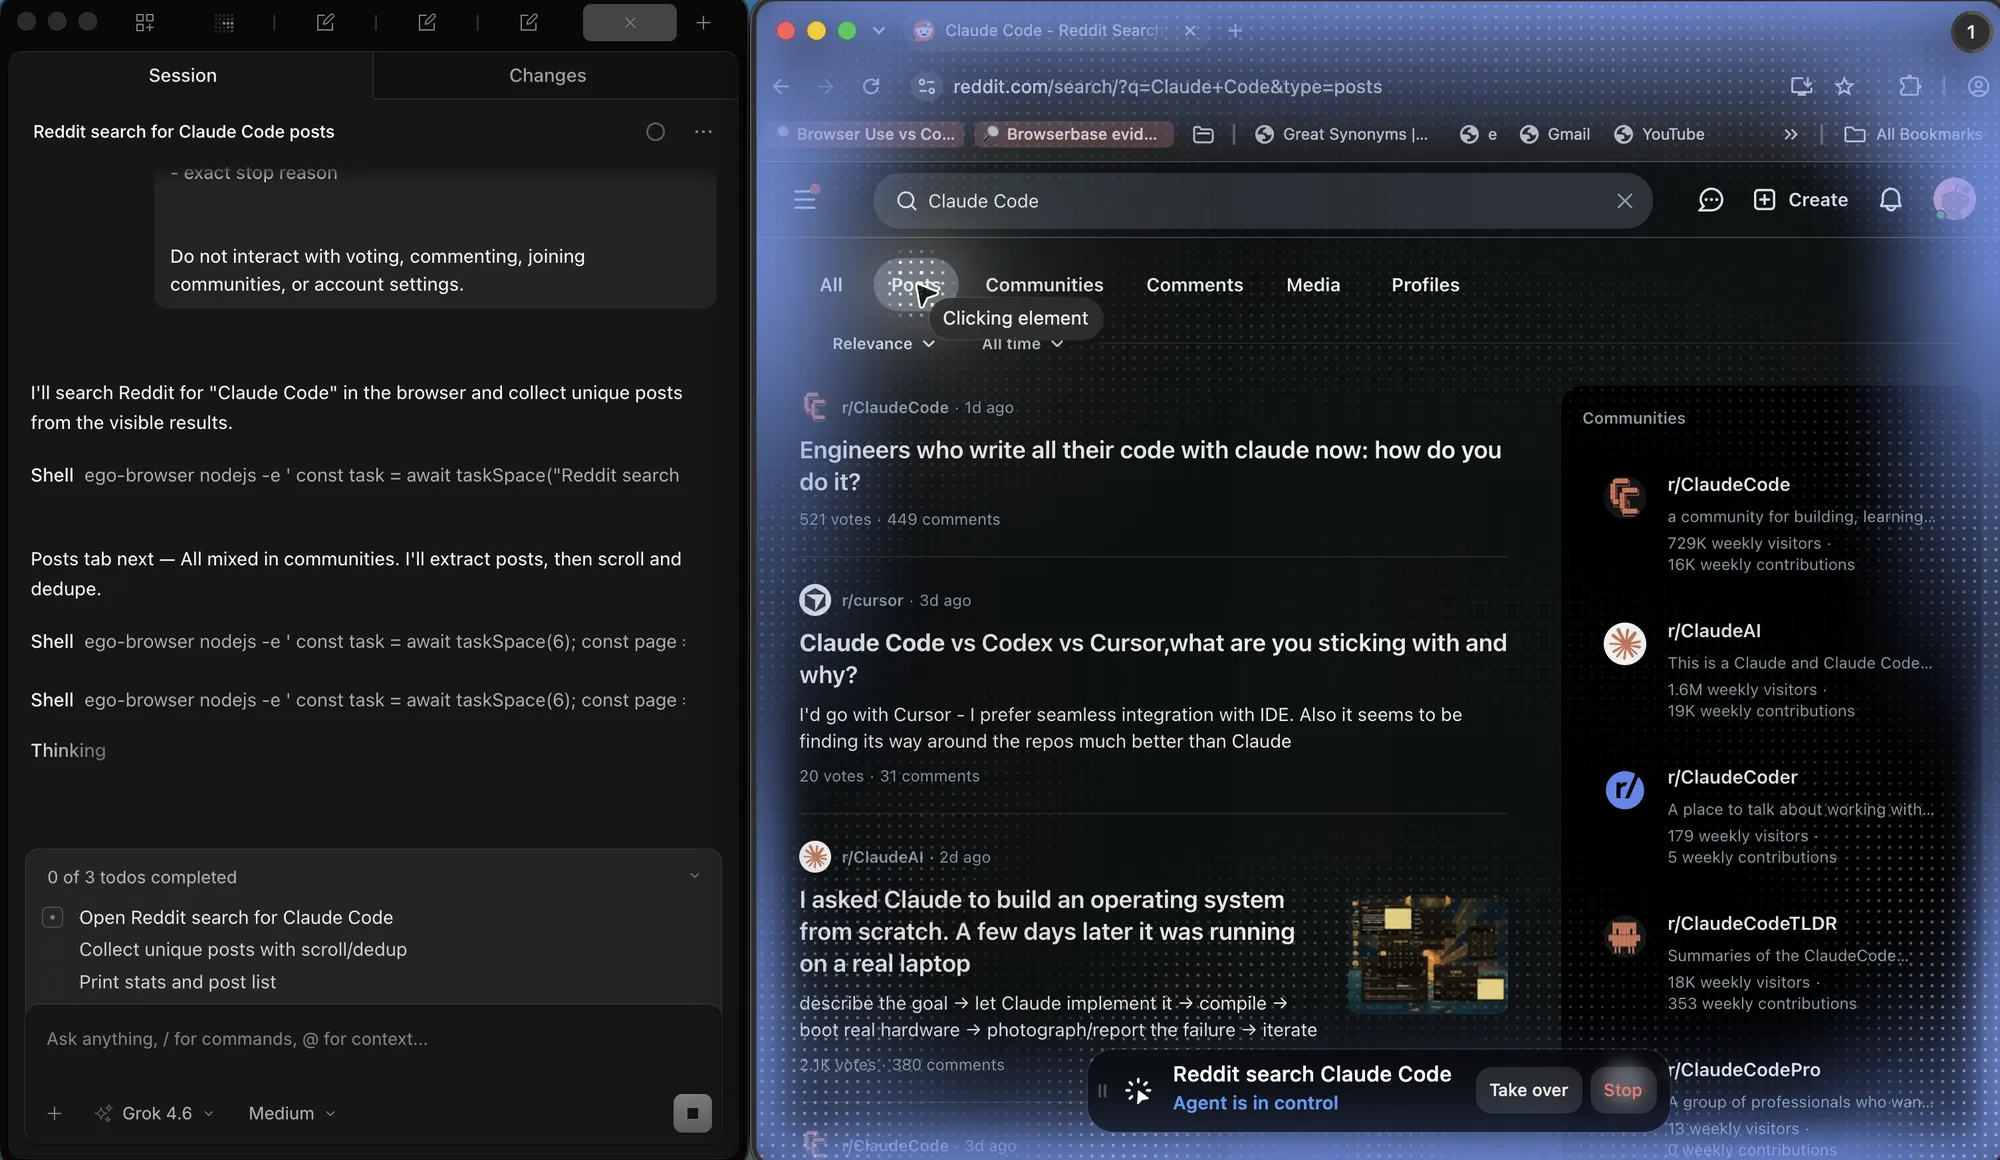
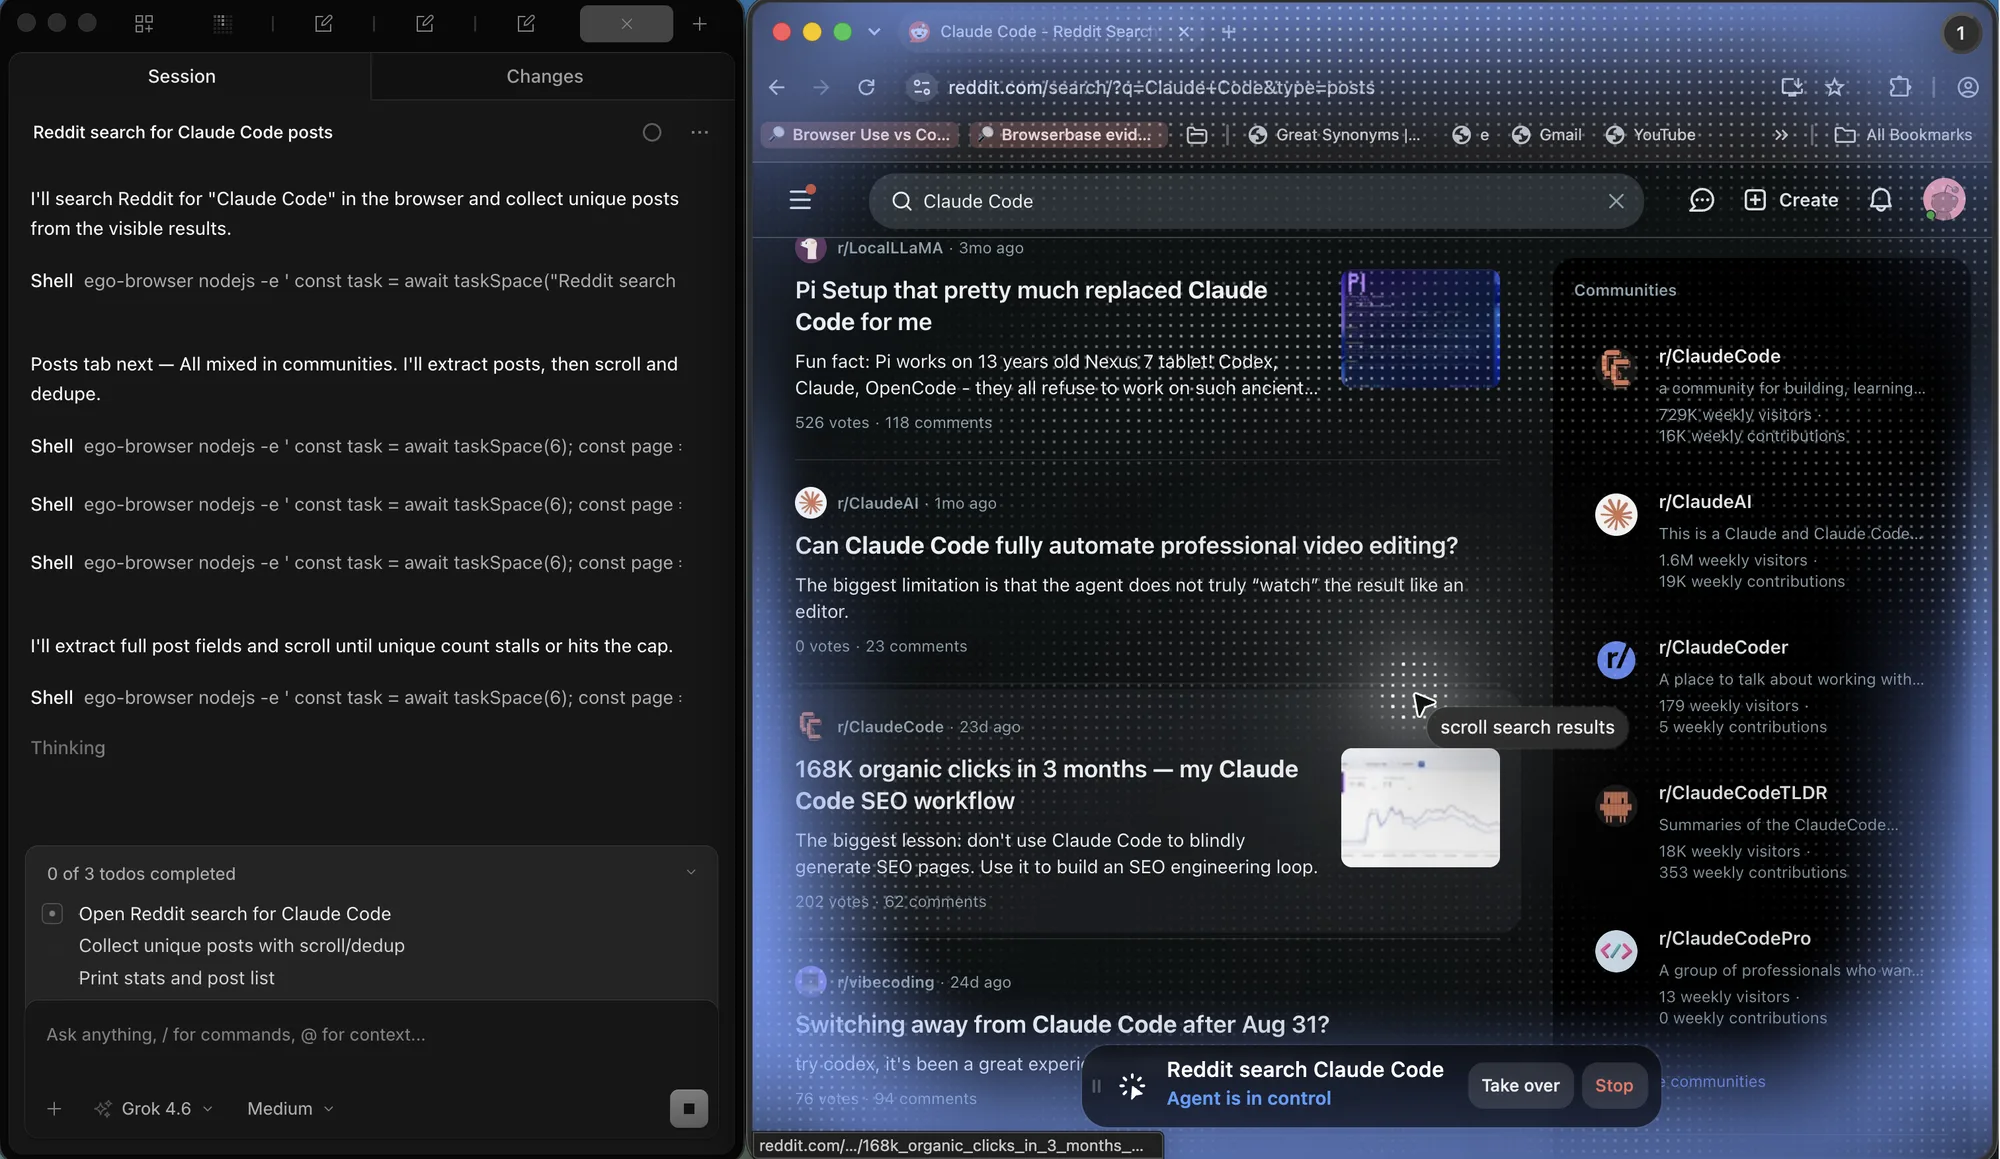
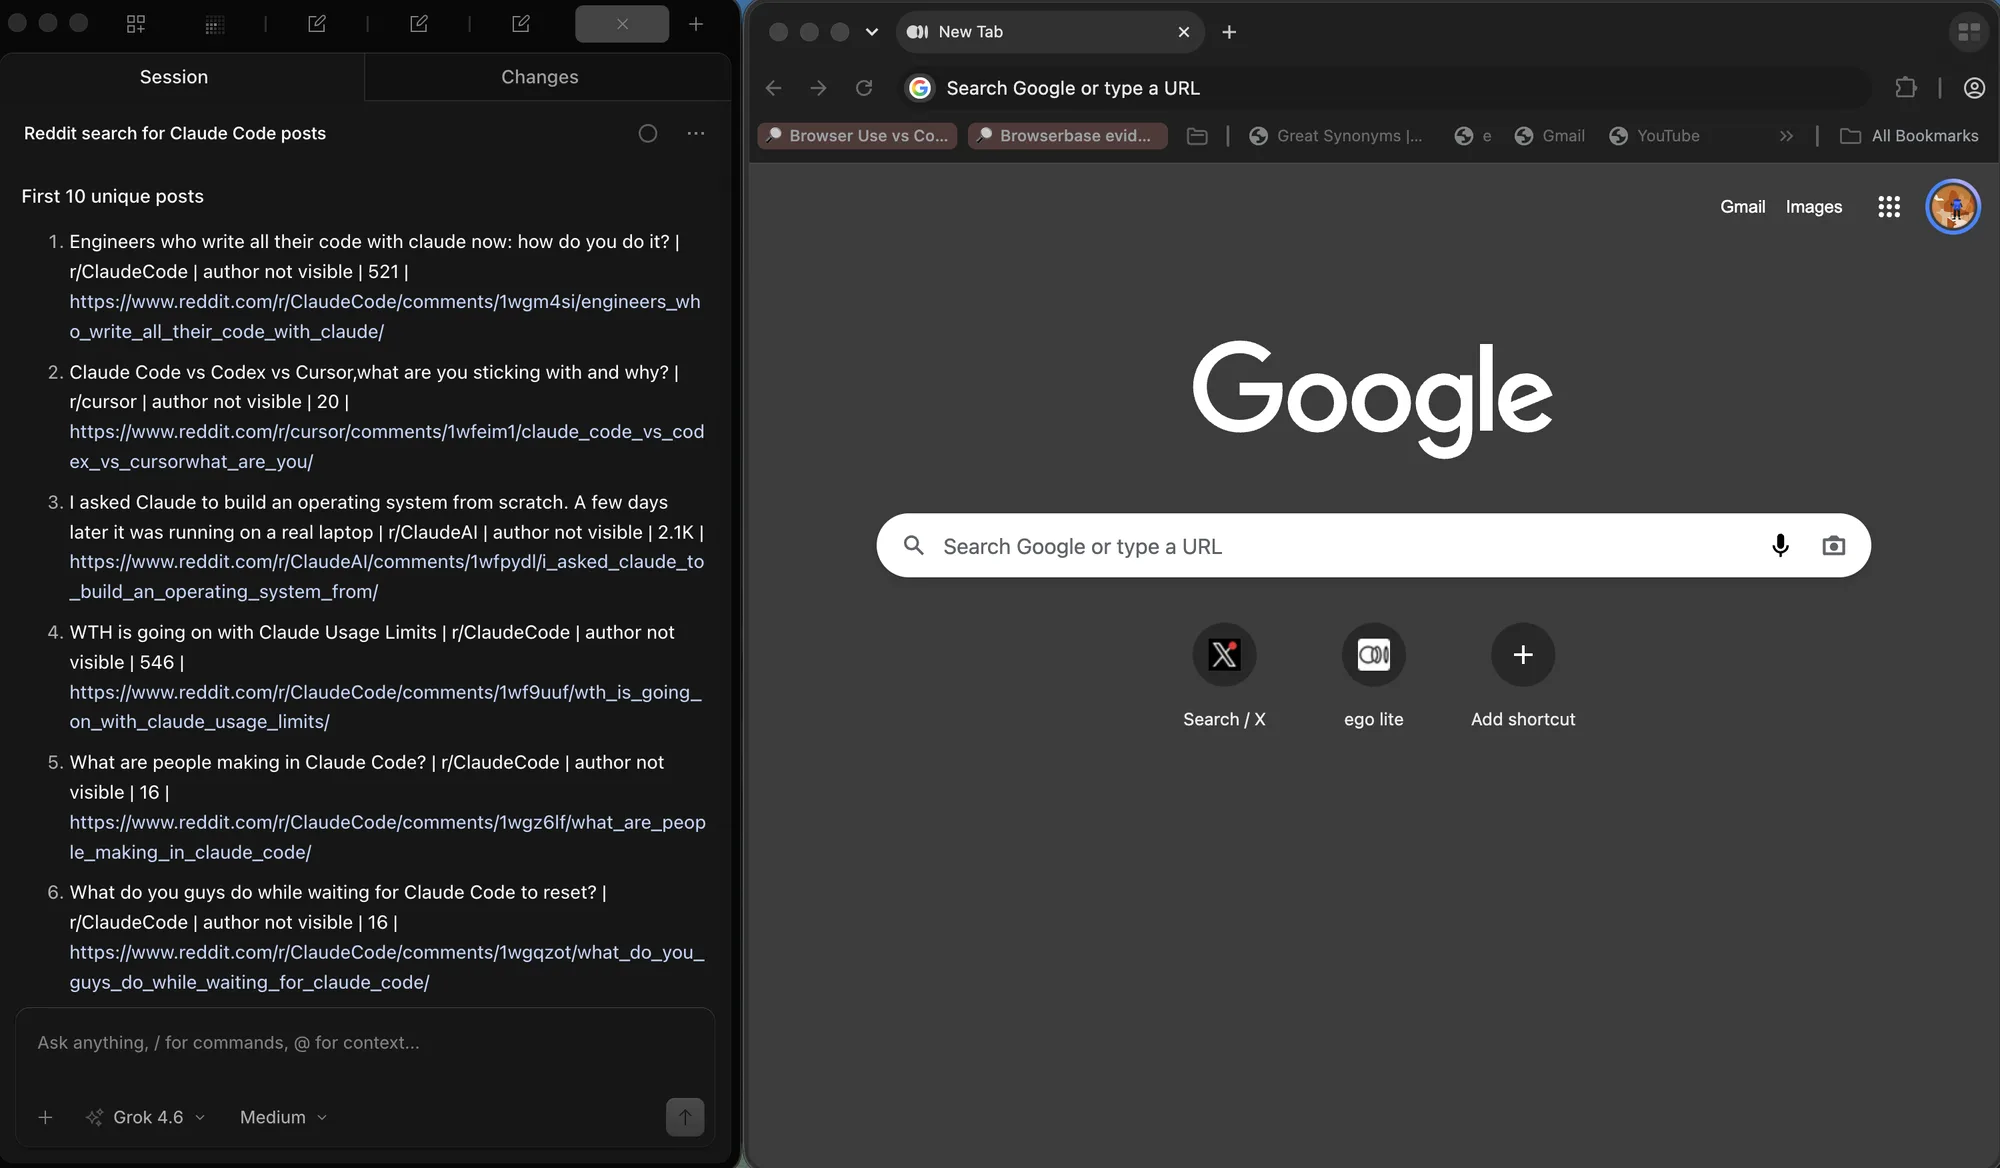
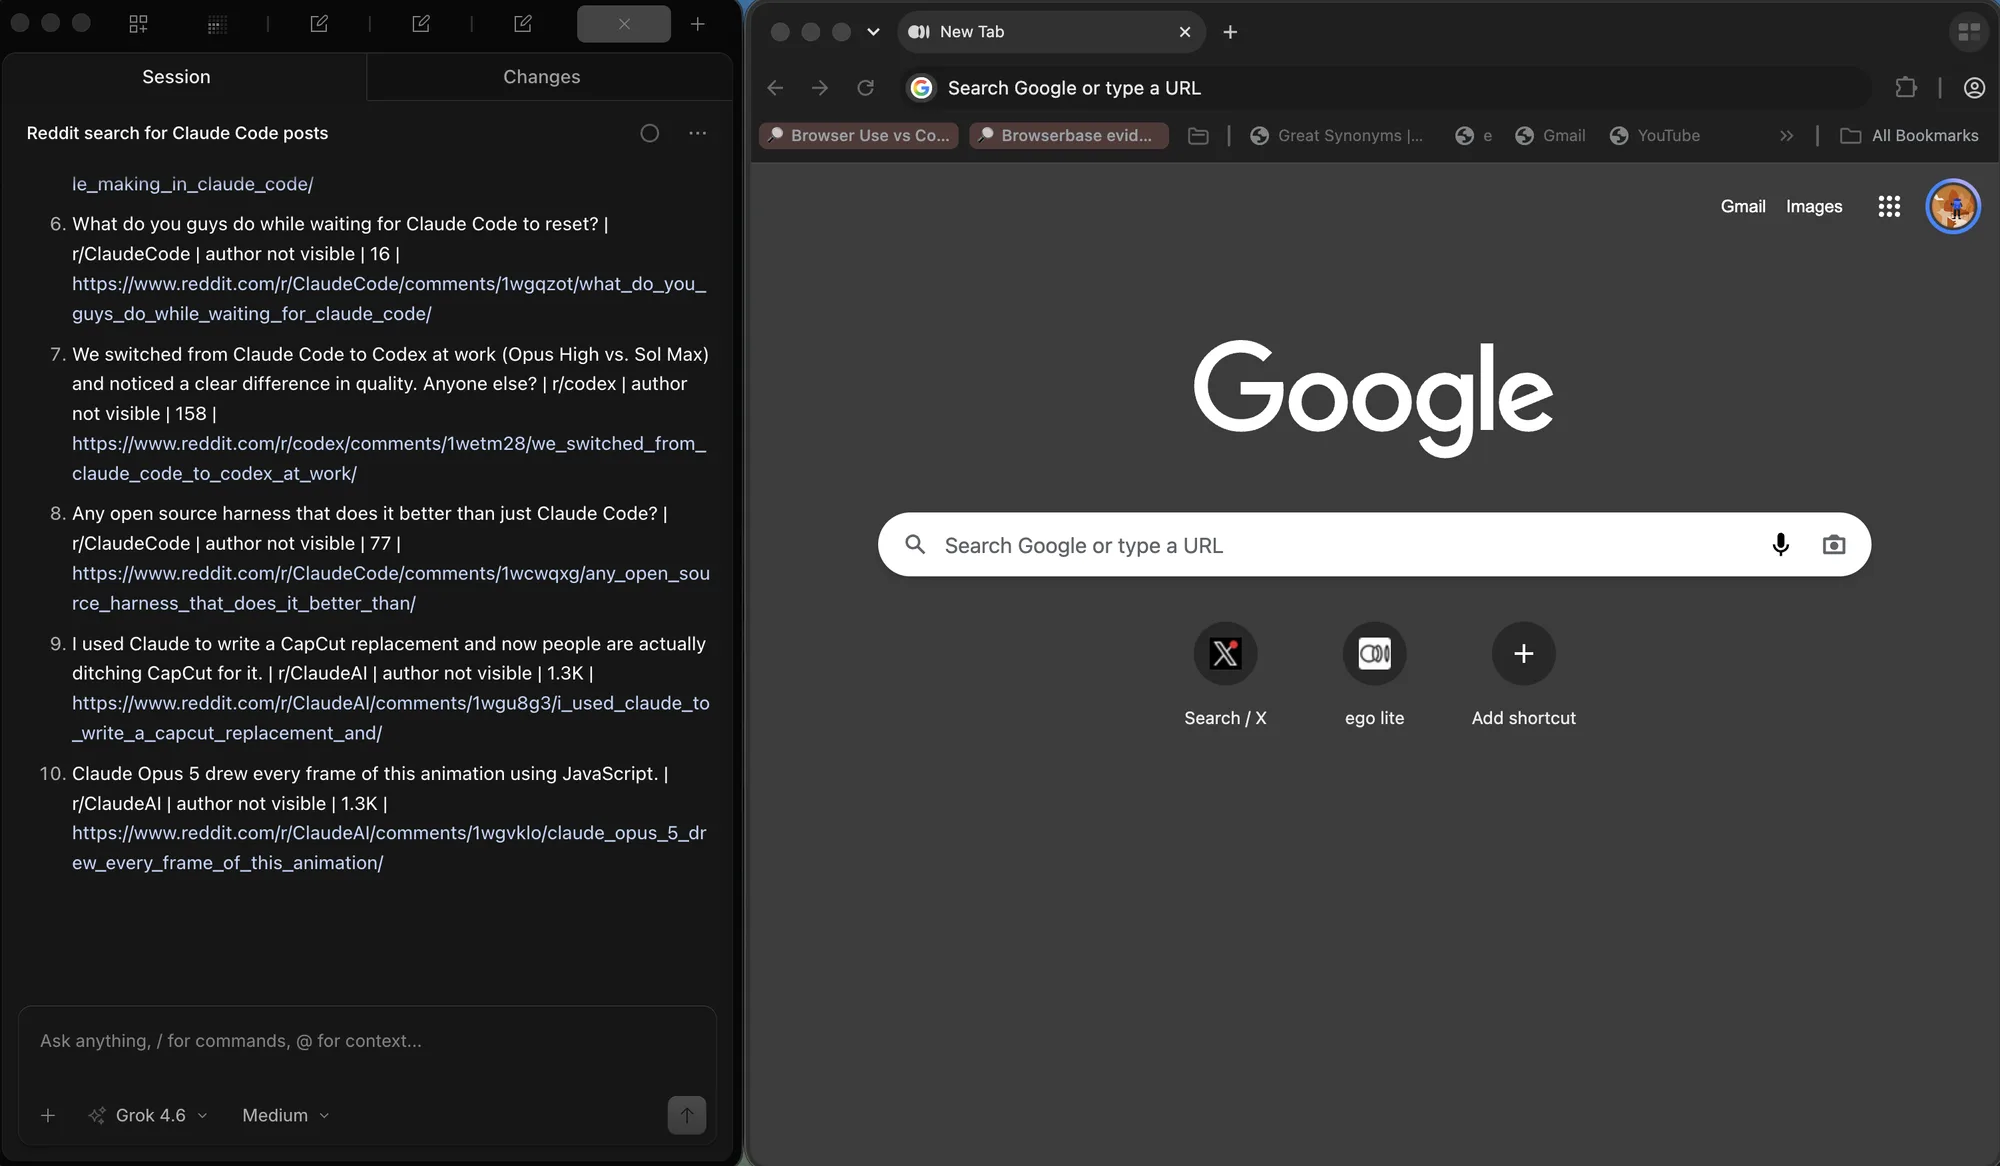
Reddit の実行は 135 行のフィクスチャではなく、ライブの一意リストに同じ検査を使いました。各行にはタイトル、subreddit、票数、URL が必要でした。スクロール後に検証するのは番号付き出力です。
素のHTTPで足りる場合、足りない場合
同じフィクスチャデータはブラウザなしでも取れます。両方の経路を測るのが、仕事に何が要るかを決める正直な方法です。素のHTTPクライアントはURLで番号ページを歩き、JSONエンドポイントからもっと見るのバッチを取り、offsetで無限フィードを引き、135、81、60行を合わせて24 millisecondsで集めました。描画も待ちもスクロールもありません。
それが既定の推奨であり、はっきり書くべきです。公式APIがあるなら使います。番号リストがサーバー描画なら、ページを直接要求します。もっと見るや無限モードの裏が署名不要のJSONエンドポイントなら、そのエンドポイントを要求し、offsetでページ送りします。Playwrightのような枠組みはどれにも不要で、HTTP経路の方が速く安く回せます。Apify のページネーション解説、Web Scraper のページネーションセレクタ文書、および Playwright ネットワークガイド のネットワークパネル手順は、別の起点から同じ範囲をカバーしています。
ブラウザが正当化されるのは、データがクライアント描画のあとでしか存在しないとき、ページ内で生成された署名やTokenをリクエストが運ぶとき、リストにログインが要るとき、本物のセッションと本物の user agent がなければエンドポイントの応答が変わるときです。その時点でブラウザは好みではなく、唯一の正直な経路であり、先の節はそのまま適用されます。
ego (lite) は、そのHTTP経路が失敗したあとで初めて登場します。リストにログイン済みcookie、ページ生成のToken、本物のビューポートがなければ起きないスクロールが要るなら、すでにセッションを持つブラウザの中で、同じ番号 / もっと見る / 無限のループを回します。そこから始めないでください。フィクスチャはすでに安い答えを示しています。素のHTTPで135、81、60行を24 msです。
ブラウザが本当に要るときも、先の節のクロール論理はそのまま使います。ego (lite) が渡すのはログイン済みのページと、見ていられる Space であり、新しいページネーション算法を発明しません。人手が要る段階なら止めます。curl や公式APIがすでに行を返すなら、HTTPに留まります。
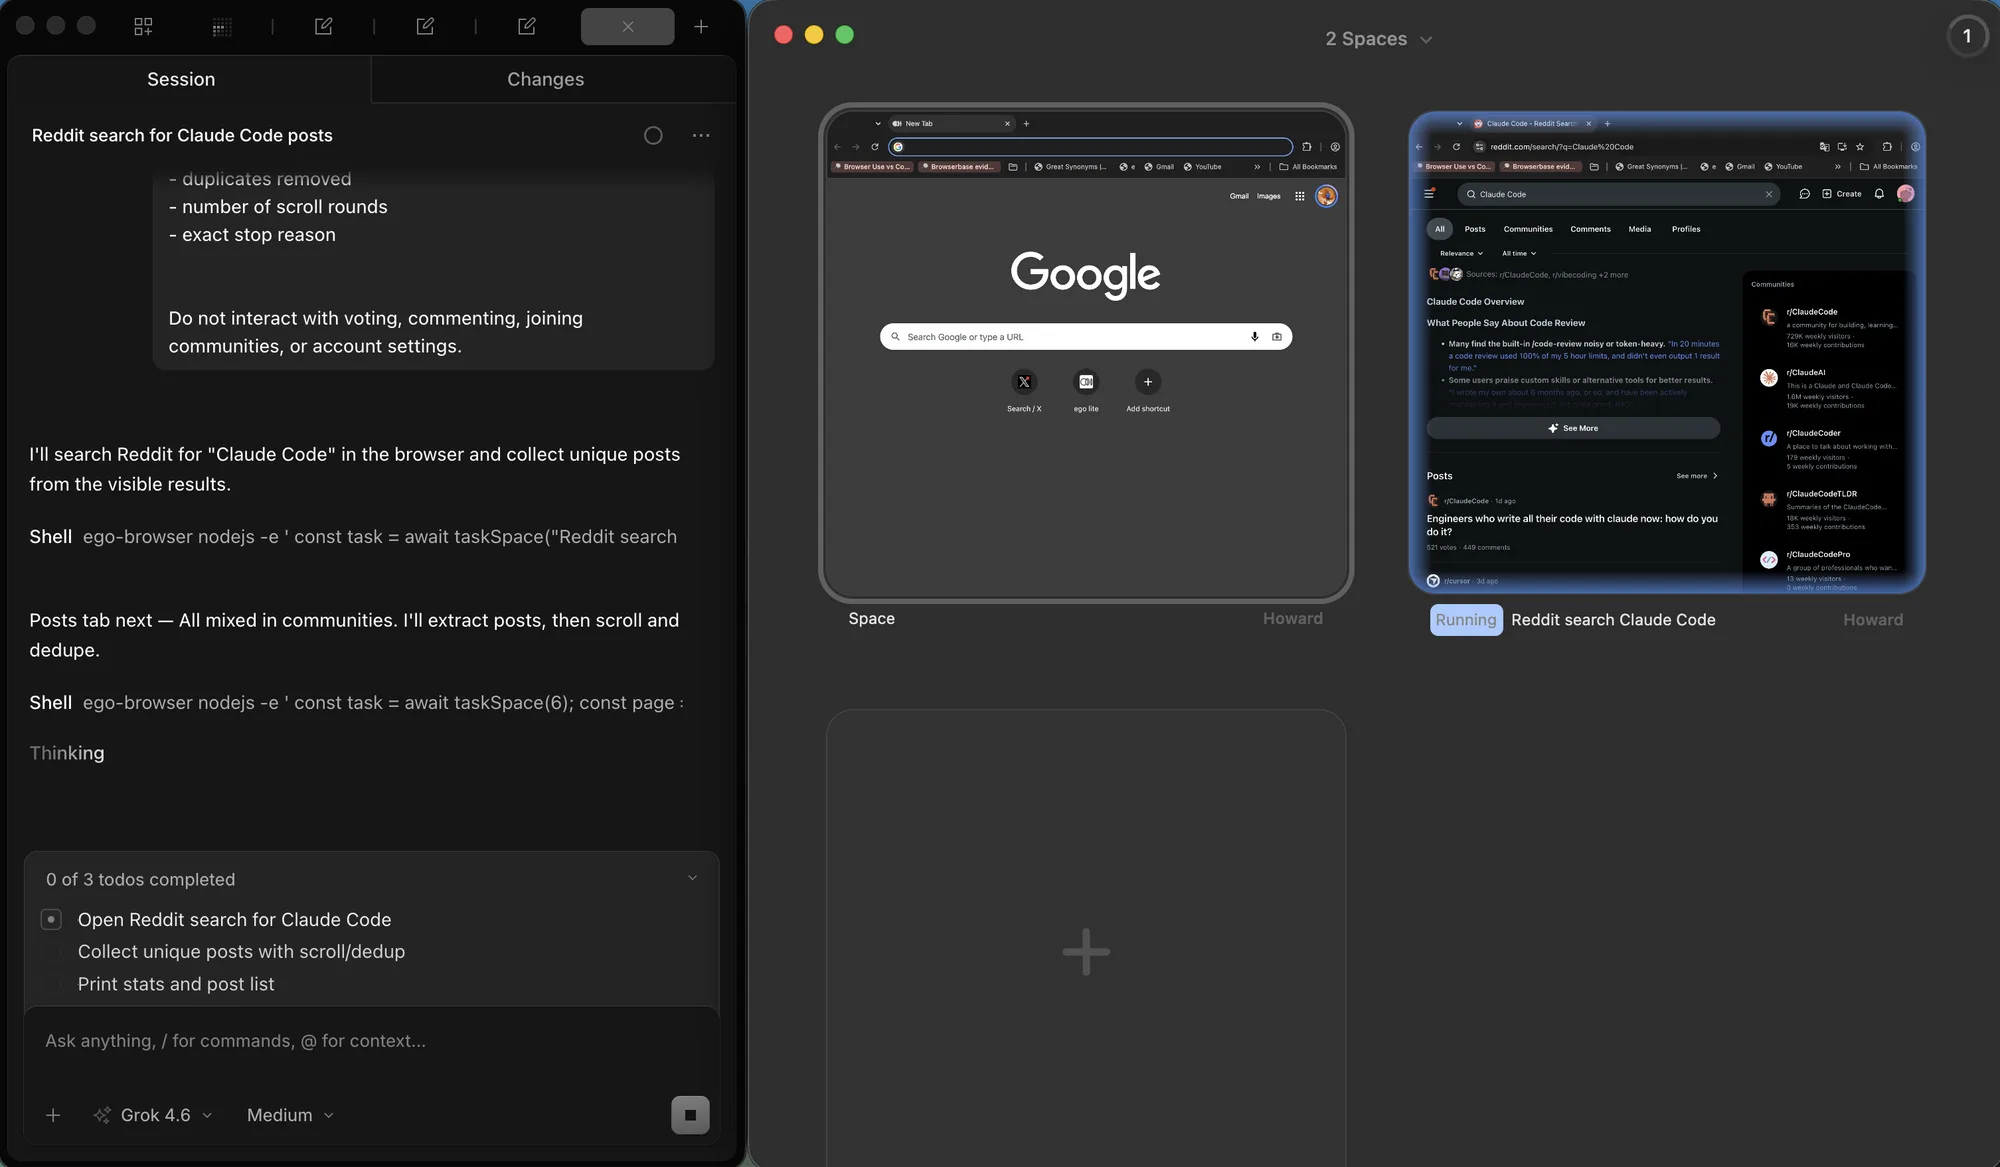
番号ページの隔離規則はまだ有効です。同じウィンドウを共有する 2 つのクローラはスクロール位置を奪い合い、最後に見た行を上書きします。同じブラウザでは 2 つの Space が 2 つの Playwright context に相当します。一方は Google で idle、他方は Reddit をスクロールし続けられます。要点は隔離です。概要は両方を同時に見る手段にすぎません。
バージョン 0.5.0.32 は changelog(2026-09-12)に記録されています。新しいビルドを引用する前に、そのページ、クイックスタート、および GitHub リポジトリ を再確認してください。隣接するガイド JavaScriptによるWebスクレイピング は、静的か描画かの判断を別の側から扱います。
FAQ
番号リストの総ページ数はどう知るか
最終ページの操作、見出し合計をページサイズで割った値、そして実際に末尾まで一度歩くことで、番号リストのページ数が分かります。その見積もりは検査であり、ループの停止条件ではありません。
ページをまたいで重複が集まるのはなぜか
下層のリストが並び替わり、レコードが次のバッチへ移ると、スクレイパーはページ間で重複を集めます。見えるタイトルではなく安定した record id で重複排除し、除いた件数を記録します。
もっと見るをクリックしたあと、どれだけ待つか
観察できる条件が真になるまでです。行数が増えた、ボタンの disabled が解けた、次バッチの既知の行が出た、のいずれかです。固定遅延は推測であり、ネットワークが遅くなったときに通り、そのときに失敗します。
無限フィードの終わりをどう検出するか
サイトが明示信号を出すならそれを優先します。描画された終了メッセージや、応答の has-more フラグです。どちらもなければ、新しい項目がなく、読み込み済み内容の高さも変わらない検査を連続して何度か満たしてから止め、静かな一瞬では止めません。
ページネーションのスクレイピングにヘッドレスブラウザは要るか
データが描画、セッション、ページ内Tokenを必要とするときだけです。サーバー描画のリストとJSONエンドポイントは素のHTTPの方が向いており、速く単純に回せます。両方の経路を一度測れば、比較で判断はたいてい明らかになります。
ページ送りのクロールが早く止まる原因は何か
よくある容疑者は3つです。バッチの描画前に終わった待ち、空ページとして扱った一時エラー、実行中に切れたセッションで次ページが行ではなくログインフォームを描いたこと。直し方はそれぞれ違うので、停止理由は件数と一緒に残します。
クラッシュ後にクロールを再開するには
完了したバッチごとに、モード、位置、これまでに集めた行をチェックポイントします。再開はそのファイルを読み、記録された位置で同じモードに入り直します。保存状態の下でソースが動いていないことを確かめるため、チェックポイント位置の1つ前のバッチを一度取り直します。
クロールが完了したことをどう検証するか
一意レコード数を、少なくとも2つの独立した数字、たとえば最終ページ自身の合計とページごとの件数の和と照合し、全行のフィールド欠落を見て例外を報告します。件数が合い、フィールドもすべて揃っているのは強い信号です。片方だけでは弱いです。
遅延読み込みを起こすためにゆっくりスクロールする必要があるか
通常は不要ですが、最下部に止めるのではなくローダーを再起動してください。サイトは変化で発火する intersection observer を使うので、大きな一跳びより位置を交互に動かすか段階的にスクロールする方が確実で、増加検査にも意味が出ます。
ログインの向こうにあるページ送りリストは取れるか
できます。本物のセッションと同じ規則です。礼儀正しくページ送りし、セッションを生かし、ログインページへのリダイレクトはリストの終わりではなくセッションの問題と見なします。ego (lite) のようにすでにログインを持つブラウザなら、セッション再構築そのものが不要になります。永続セッションのガイド が状態の扱いを説明し、価格スクレイピングのユースケース が、ログイン済みの完全な収集がどう見えるかを示します。
