
Uma página renderizada com JavaScript pode devolver uma resposta de sucesso e ainda deixar seu scraper com zero linhas. O HTML já carregou, mas os cards que alguém vê no navegador podem ainda não existir no DOM. Com o ego (lite), esse descompasso fica visível. Sua tarefa roda dentro de um Space de Chromium acompanhado, então você vê se a página ainda está renderizando, se o seletor não bate ou se os dados de que você precisa nunca apareceram.
O Playwright transforma esse comportamento já confirmado em um fluxo de scraping estável e repetível. Ele pode esperar os cards-alvo renderizarem, extrair campos do DOM ao vivo e validar que o resultado traz os dados que você esperava. Quando o seletor e a condição de espera já são conhecidos, o Playwright é o jeito natural de colocá-los em um script confiável. Quando a tarefa ainda pede inspeção visual, uma sessão já logada ou uma pessoa assumindo em um passo específico, o ego (lite) mantém o estado do navegador visível e interativo, para que um script que sai com sucesso não esconda que, na prática, não raspou nada.
O que é web scraping com Playwright?
Web scraping com Playwright é dirigir um navegador de verdade para o JavaScript pintar a página e depois ler os nós renderizados. O navegador é o scraper. A resposta HTML é só o casco até os scripts rodarem.
O Playwright lança Chromium, Firefox ou WebKit, abre um contexto e te dá page.goto, esperas, locators e page.evaluate. Essas APIs existem para testes. Também funcionam para extração, porque os dois trabalhos pedem a mesma coisa: um DOM igual ao que uma pessoa vê.
Os trabalhos vizinhos ficam fora desta página.
A escolha entre fetch e um navegador em JavaScript está em web scraping com JavaScript. Reaproveitar uma sessão logada entre execuções está em sessões persistentes de navegador. Muros de login no X e no LinkedIn estão em scraping com IA atrás de muros de login. Páginas numeradas, Load More e infinite scroll esperam esta página avulsa já devolver as linhas certas.
Quando fazer scrape com Playwright em vez de HTTP?
Use o Playwright quando um GET da URL não contém os nós que você quer raspar. Use HTTP quando os valores já estão no corpo da resposta, ou quando a página já expõe um endpoint JSON documentado.
quotes.toscrape.com/js é feito assim de propósito. Um GET da URL devolve HTML sem nós class="quote". As citações ficam em um array inline var data, e o jQuery pinta os cards. Um parser CSS apontado para .quote contra a resposta crua não salva nada e parece bug de seletor.
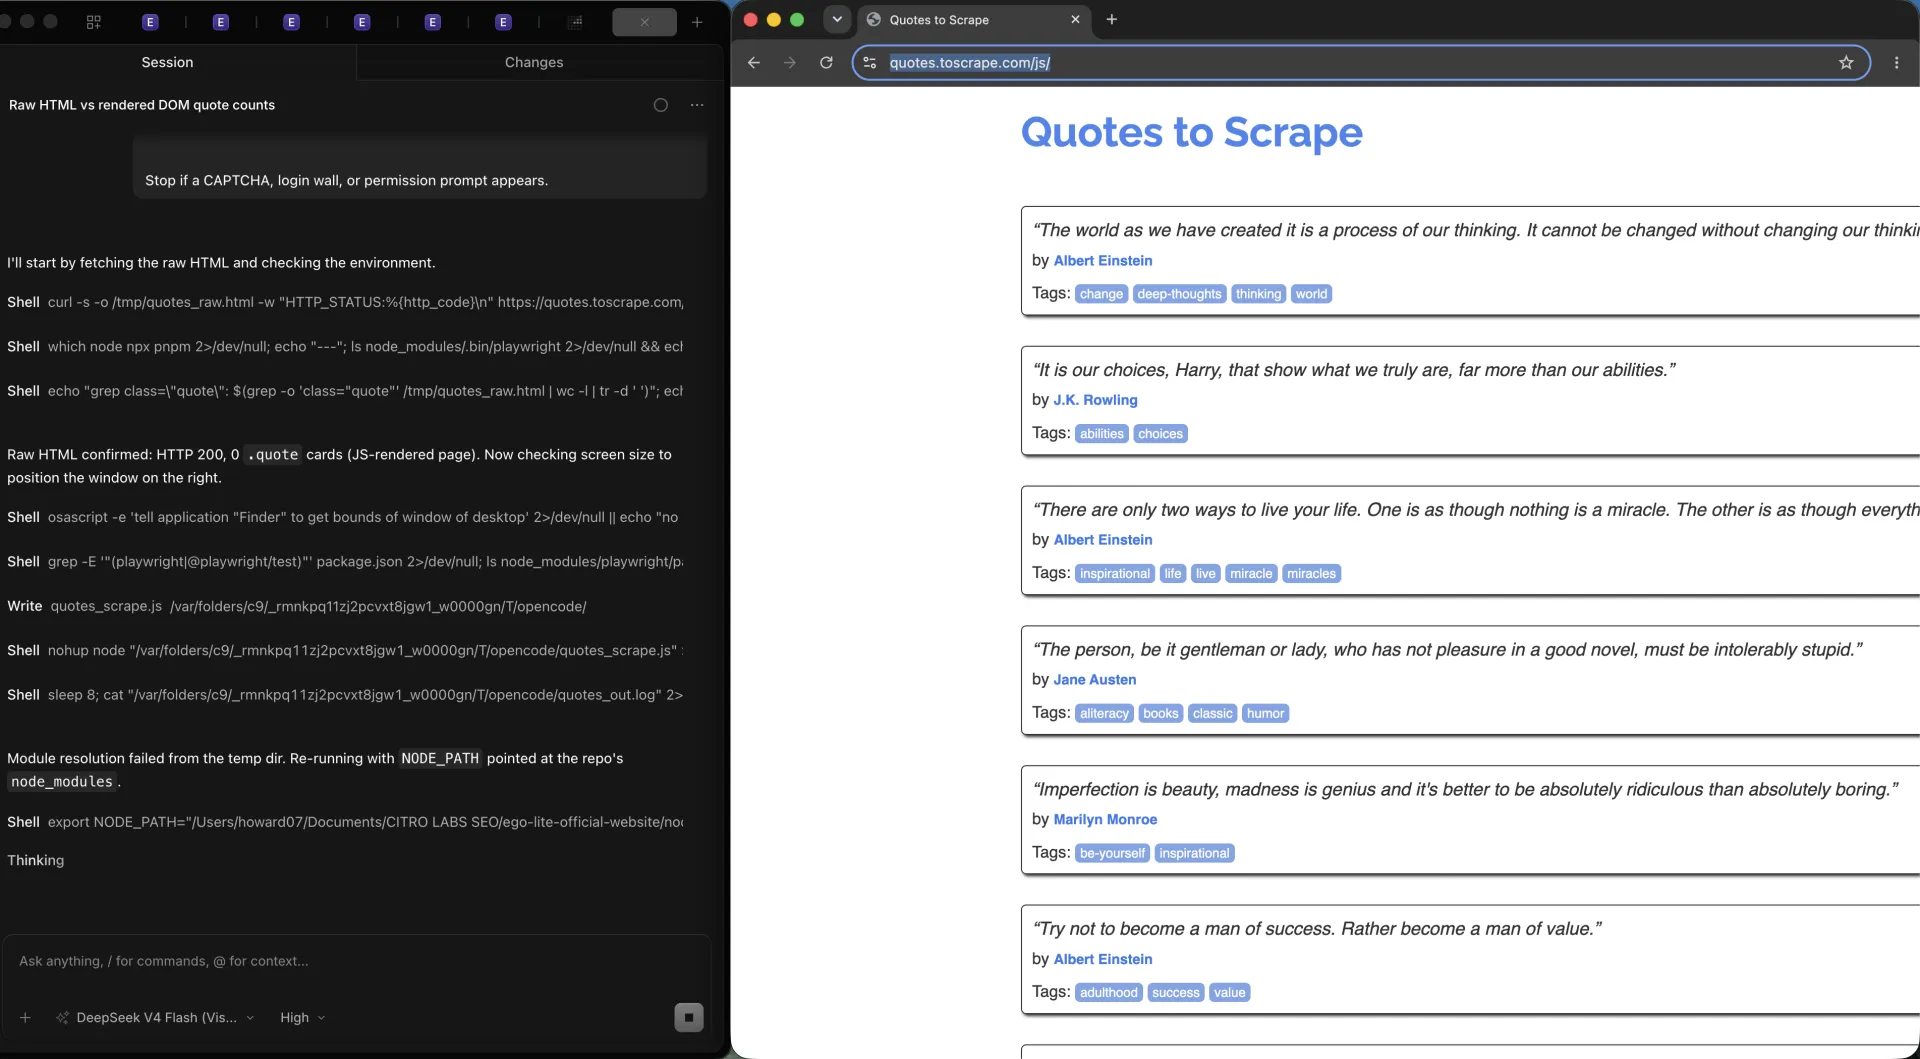
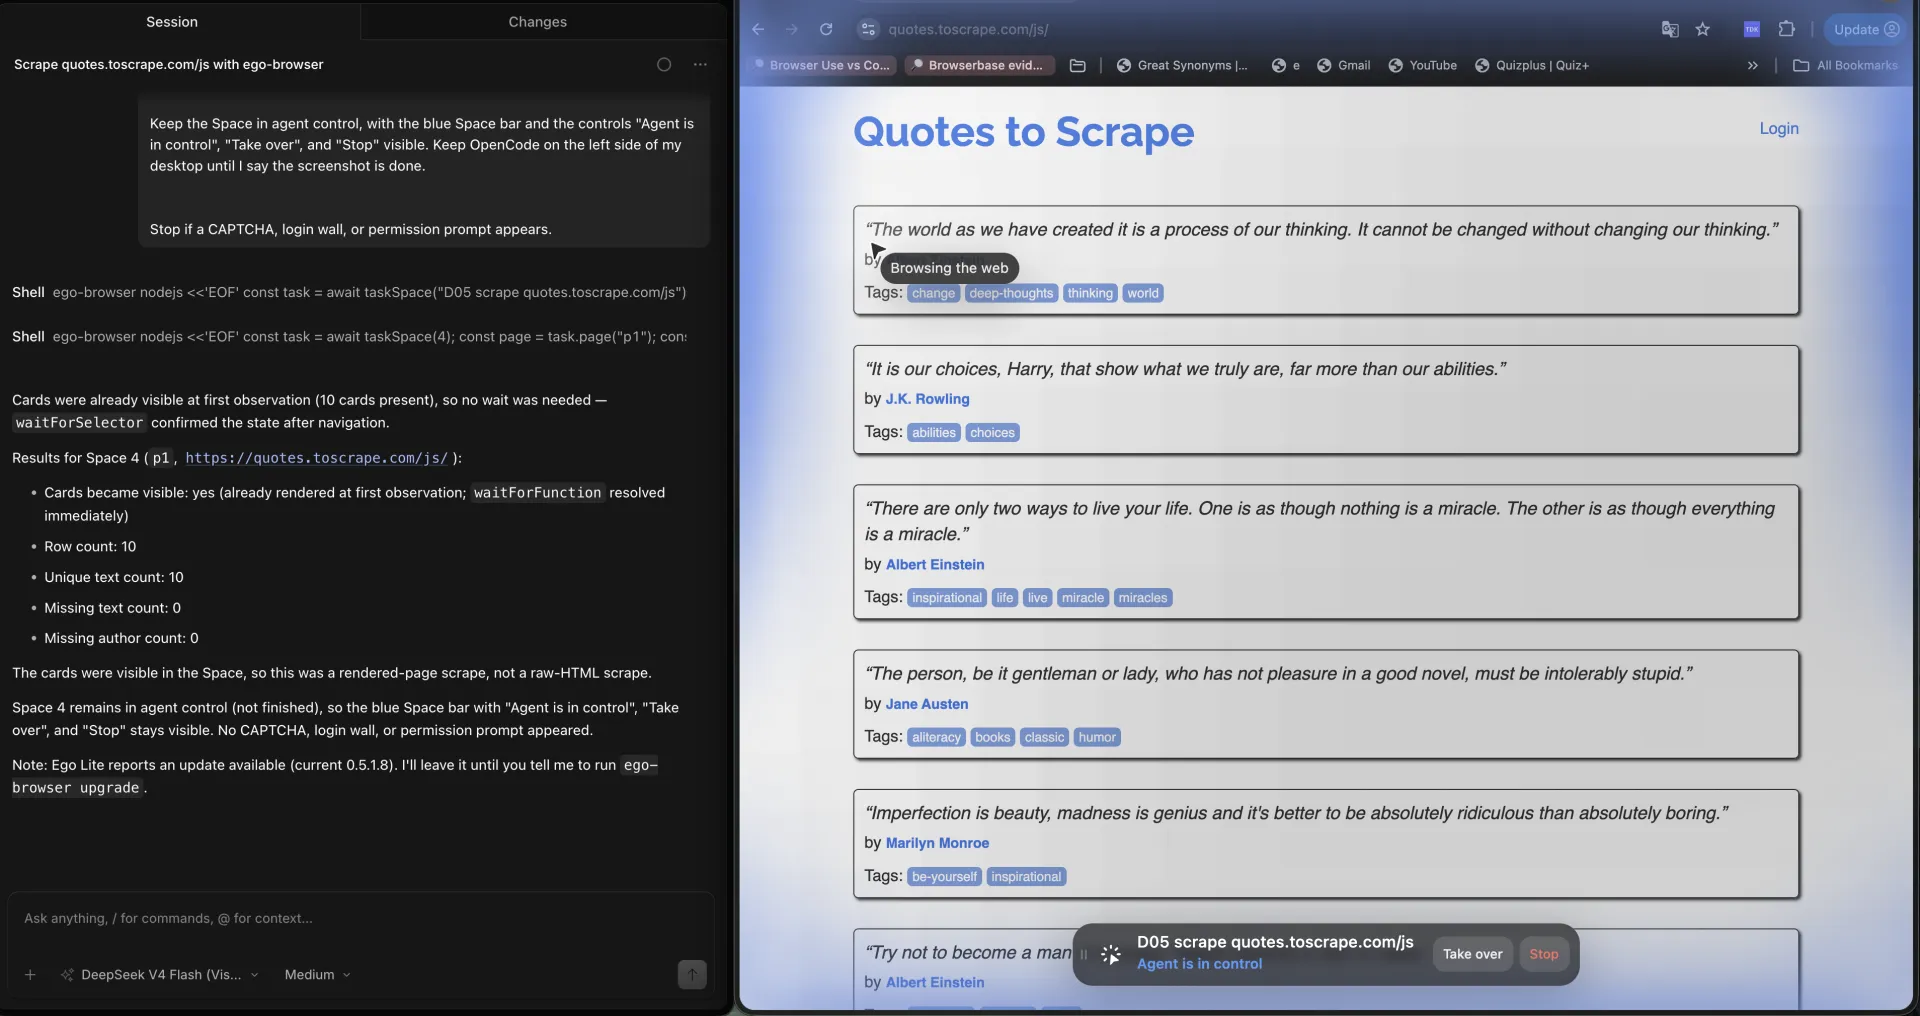
Testamos essa cisão em 2026-09-18 a partir do OpenCode. Um GET de quotes.toscrape.com/js devolveu HTTP 200 e 0 cards .quote no HTML cru, enquanto a janela do Chromium headed à direita já mostrava a lista pintada.
Olhe a cisão deste jeito.
| Rota | O que consegue fazer | O que não consegue fazer |
|---|---|---|
| HTTP GET + parser de HTML | Ler os bytes que o servidor enviou. Barato, rápido e suficiente quando os cards já estão na marcação. | Rodar os scripts da página ou esperar nós que aparecem depois. Contra quotes.toscrape.com/js não vê cards .quote no HTML cru. |
| Analisar o payload inline | Em quotes.toscrape.com/js, um regex mais JSON.parse de var data recupera as citações do mesmo HTML, sem navegador. | Sobreviver a um redesign que pare de embutir o array. Payloads internos não são contrato de API. |
| DOM renderizado com Playwright | Executar o JavaScript da página, esperar .quote e extrair os cards que uma pessoa vê. | Continuar barato. Cada contexto custa memória, e uma frota deles é a ferramenta errada para HTML estático. |
O extra honesto desta demo: o Playwright não é obrigatório se var data for analisado direto. A maioria dos sites JS não deixa um array nomeado na primeira resposta. O Playwright é a rota que ainda funciona quando eles não deixam.
Como lançar, navegar e esperar o conteúdo?
O scrape mínimo com Playwright é launch, contexto novo, goto, esperar o seletor do card, extrair e fechar. Pular a espera é como você ganha um arquivo vazio que parece sucesso.
No Playwright, page.goto pode parar em commit, domcontentloaded, load ou networkidle. waitForSelector é a checagem de que aquilo que você veio buscar realmente existe. Em quotes.toscrape.com/js, goto({ waitUntil: 'domcontentloaded' }) já pode bastar porque o script inline roda naquele HTML. Isso é sorte, não regra.
import { chromium } from "playwright";

const browser = await chromium.launch();
const context = await browser.newContext();
const page = await context.newPage();

try {
  await page.goto("https://quotes.toscrape.com/js/", {
    waitUntil: "domcontentloaded",
  });
  await page.waitForSelector(".quote");
  const rows = await page.evaluate(() =>
    [...document.querySelectorAll(".quote")].map((el) => ({
      text: el.querySelector(".text")?.textContent?.trim() ?? "",
      author: el.querySelector(".author")?.textContent?.trim() ?? "",
      tags: [...el.querySelectorAll(".tag")].map((tag) =>
        tag.textContent?.trim(),
      ),
    })),
  );
  console.log(rows.length);
} finally {
  await context.close();
  await browser.close();
}
Para ver o scrape vazio, extraia em commit antes de os cards existirem, ou atrase o script que os pinta. Essa extração cedo devolve 0 linhas. Depois de waitForSelector('.quote'), a mesma página devolve os cards renderizados. No caso vazio nada é lançado.
| Espera | O que prova | Como falha |
|---|---|---|
| só commit | A navegação começou. Serve como teste negativo. | Os scripts podem não ter rodado. Uma extração em commit, antes de o pintor pintar, devolve 0 citações. |
| domcontentloaded | O HTML inicial foi analisado. Nesta fixture basta porque var data roda naquele HTML. | Cards de um XHR tardio ainda podem faltar. Não trate isso como 'o conteúdo está pronto'. |
| waitForSelector('.quote') | Pelo menos um card existe no DOM. Essa é a espera que transforma esta demo em linhas raspáveis. | Uma classe velha pode casar com a lista anterior. Espere um campo que muda com os dados, não um wrapper que nunca some. |
Feche o contexto no finally. Contextos seguram a memória. Um scrape que lança erro no meio da extração ainda precisa soltar o Chromium.
Como extrair campos de uma página renderizada?
Extraia dentro da página com page.evaluate, ou com locators quando você precisa de um controle e não de uma lista. Os dois leem o DOM renderizado. Nenhum lê o snapshot HTML original do goto.
Mapeie cada .quote para text, author e tags. A demo pública pinta dez cards. Os campos obrigatórios são text e author. A chave única é o texto da citação, não o autor, porque Einstein aparece mais de uma vez.
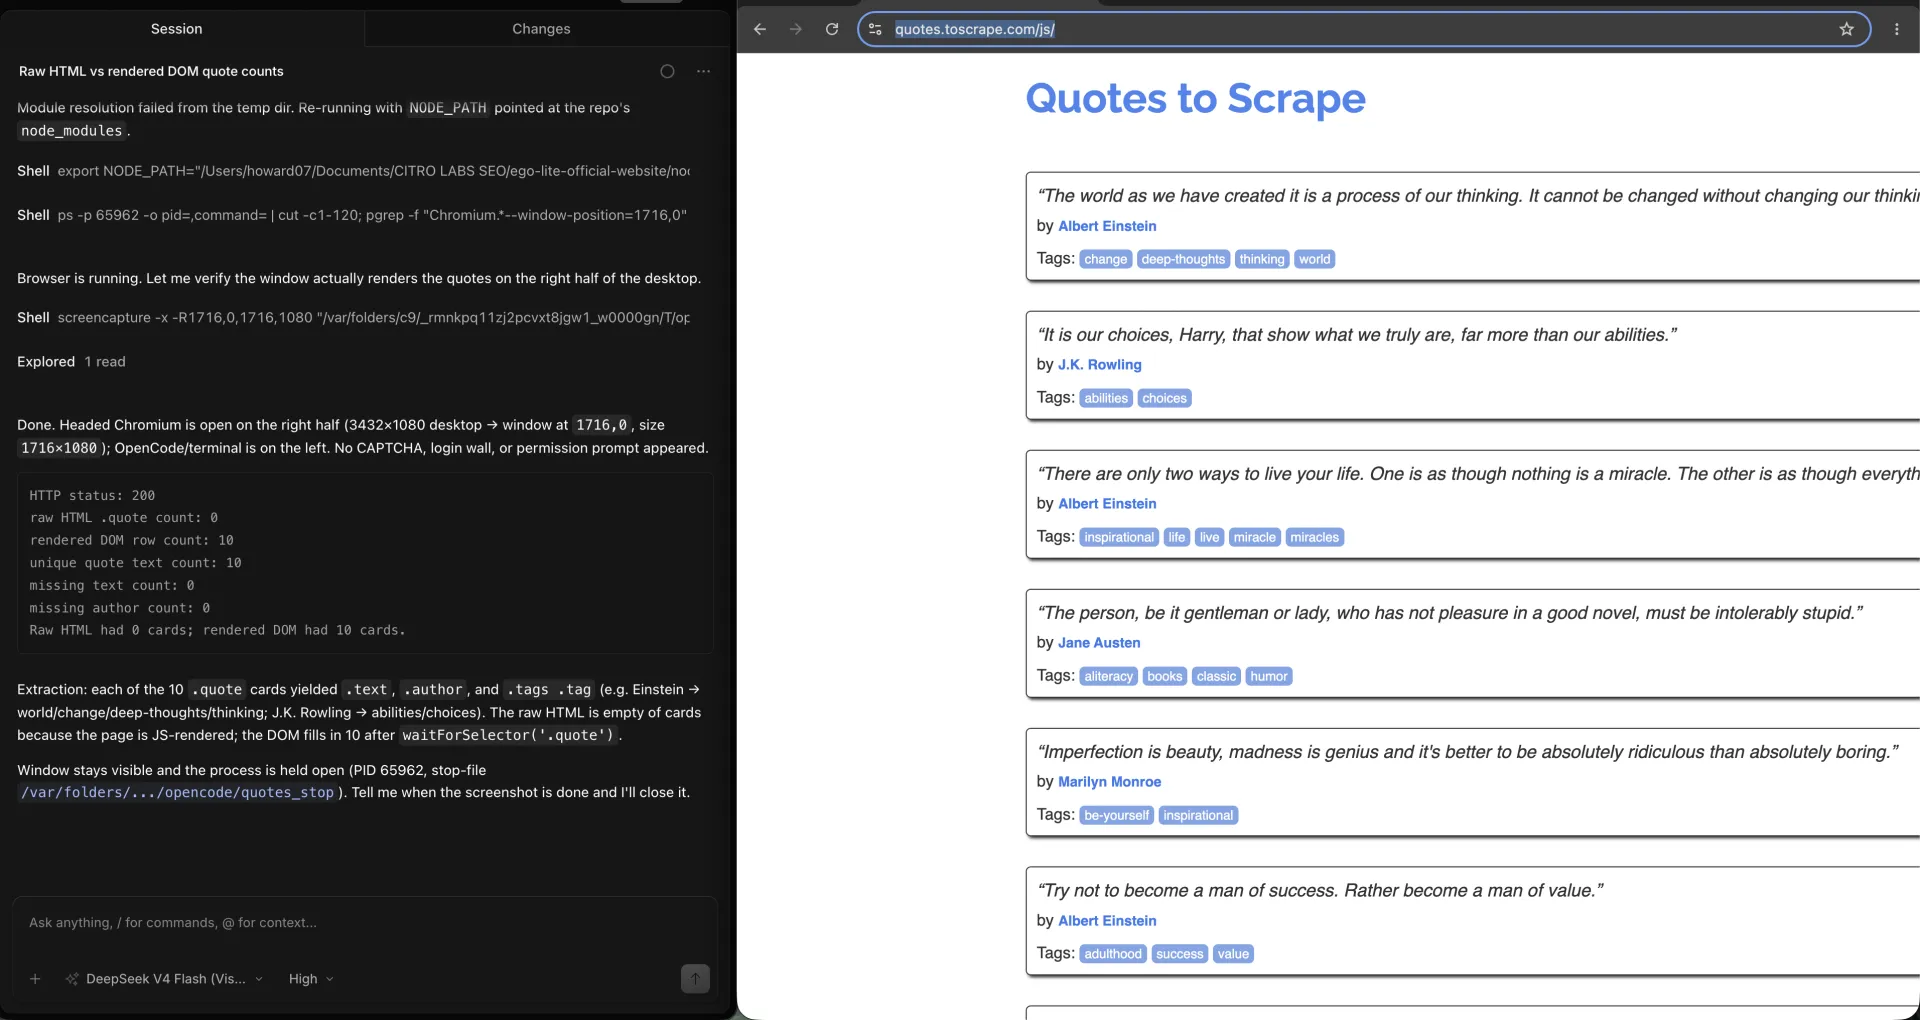
Testamos essa extração na mesma sessão do OpenCode. Depois de waitForSelector('.quote'), a execução headed imprimiu 10 linhas, 10 textos únicos e 0 autores faltando. O HTML cru ainda tinha 0 cards.
Locators são o caminho mais limpo para um único campo. Os locators do Playwright consultam de novo antes de cada ação, e por isso sobrevivem a um re-render que quebra um element handle guardado.
const title = await page.locator(".quote .text").first().innerText();
const author = await page.locator(".quote .author").first().innerText();
page.evaluate é a extração melhor para listas. Ele roda na página e devolve JSON. Mantenha o mapper pequeno. Puxe text, author, tags e uma chave única. Deixe screenshots e PDFs fora do loop de scrape.
Texto escondido com CSS continua no DOM. innerText segue o layout. textContent não. Se um site corta um título com CSS, textContent ainda te dá a string inteira. Decida qual você está coletando antes de escrever o validador.
Como interceptar os dados que a própria página já pede?
Interceptar ajuda quando a página já busca JSON que dá para salvar em vez de parsear dos cards. Em quotes.toscrape.com/js essa requisição nunca dispara, e esse é o ponto.
As citações dessa demo não vêm de uma API. Elas estão embutidas como var data no HTML e depois pintadas em nós .quote pelo jQuery. Um listener de response procurando JSON não vê nada útil.
No Playwright, os docs de rede mostram page.route e listeners de response. Use-os. Depois registre o que a página de fato enviou, inclusive nada.
const jsonResponses = [];
page.on("response", async (response) => {
  const type = response.headers()["content-type"] || "";
  if (type.includes("json")) {
    jsonResponses.push({
      url: response.url(),
      status: response.status(),
    });
  }
});
await page.goto(url, { waitUntil: "domcontentloaded" });
await page.waitForSelector(".quote");
console.log(jsonResponses.length);
Quando não há corpo JSON, volte aos cards renderizados ou analise o script inline que você já baixou. Não invente um endpoint porque tutoriais sempre mostram um. Oxylabs, BrowserStack e ScraperAPI todos demonstram intercept. Eles não dizem o que acontece quando o site nunca dispara a requisição.
Como validar campos, duplicatas e contagens?
Um scrape não termina quando o script sai com 0. Termina quando o arquivo tem a contagem esperada, cada campo obrigatório está presente e a chave única não esmaga duas linhas em uma.
Uma extração que passa nesta demo grava dez linhas com textos únicos e nenhum autor faltando. Uma extração antes de os cards existirem grava 0 linhas com o mesmo logger feliz, a menos que a contagem seja checada.
function validate(rows, expectedCount) {
  const missing = rows.filter((row) => !row.text || !row.author);
  const unique = new Set(rows.map((row) => row.text));
  if (rows.length !== expectedCount) {
    throw new Error(`expected ${expectedCount}, got ${rows.length}`);
  }
  if (missing.length) {
    throw new Error(`${missing.length} rows missing text or author`);
  }
  if (unique.size !== rows.length) {
    throw new Error("duplicate texts");
  }
}
Use uma checklist curta e falhe alto.
| Checagem | Passa | Modo de falha a conservar |
|---|---|---|
| Contagem esperada | Dez cards depois de waitForSelector('.quote') | 0 linhas se a extração rodar antes do pintor |
| Campos obrigatórios | text e author em cada linha | Um seletor que casa com o card mas perde .author |
| Chave única | Textos de citação únicos, não autores únicos | Deduplicar por autor, o que esmagaria Einstein |
Guarde a extração vazia. O resultado de 0 linhas é a prova de que a espera importa. Apagá-lo faz uma extração completa depois parecer o padrão.
O que quebra um scrape com Playwright?
As falhas que importam aqui são renders vazios, seletores velhos e limites de taxa. Nenhuma delas parece um stack trace vermelho se você só registra o comprimento das linhas depois de um catch que engole erros.
Render vazio: a navegação deu certo, o seletor nunca casou, você salvou []. Conserte a espera. Não tente de novo a mesma extração contra o mesmo DOM inacabado.
Seletor velho: .quote ainda existe, mas o texto mudou de lugar. A execução devolve 10 linhas de ontem. Espere um campo que muda com o conteúdo e depois compare as chaves únicas com o arquivo anterior.
Limite de taxa: um 429 é sinal de pare. Leia Retry-After quando vier, recue e limite as tentativas. Martelar a mesma URL é como um IP acaba bloqueado, e este guia não cobre contornar isso.
async function gotoWithRetry(page, url, attempt = 0) {
  const response = await page.goto(url, { waitUntil: "domcontentloaded" });
  const status = response?.status() ?? 0;
  if (status === 429 || status >= 500) {
    if (attempt >= 3) throw new Error(`giving up on ${url}: ${status}`);
    const retryAfter = Number(response?.headers()["retry-after"]);
    const waitMs = Number.isFinite(retryAfter)
      ? retryAfter * 1000
      : 2 ** attempt * 1000;
    await page.waitForTimeout(waitMs);
    return gotoWithRetry(page, url, attempt + 1);
  }
  if (status && status >= 400) throw new Error(`${status} for ${url}`);
  return response;
}Quando um agente de navegador visível é o caminho melhor?
Um agente de navegador visível é o caminho melhor quando a espera está errada, o seletor se moveu ou uma pessoa precisa olhar a página e assumir. Não substitui um loop de Playwright já congelado em que você confia no CI.
Isso é o complemento, não o concorrente. O Playwright registra a espera que já se entende. ego (lite) 0.5.0.32 mantém a tarefa em um Space de Chromium acompanhado para que os cards sejam vistos conforme aparecem, o agente possa ser parado ou uma pessoa assuma quando a espera está mentindo. Reaproveita um perfil real quando o próximo scrape precisa de um login que já existe. Não deixa uma página HTML estática mais barata e não contorna um bloqueio. O changelog dessa versão está datado de 2026-09-12 no changelog do ego (lite).
Testamos esse isolamento no ego (lite) a partir do OpenCode. A visão de Spaces manteve o scrape de citações no próprio Space em execução, com o resto do trabalho em outro Space em vez de compartilhar uma única janela de Chromium headed.
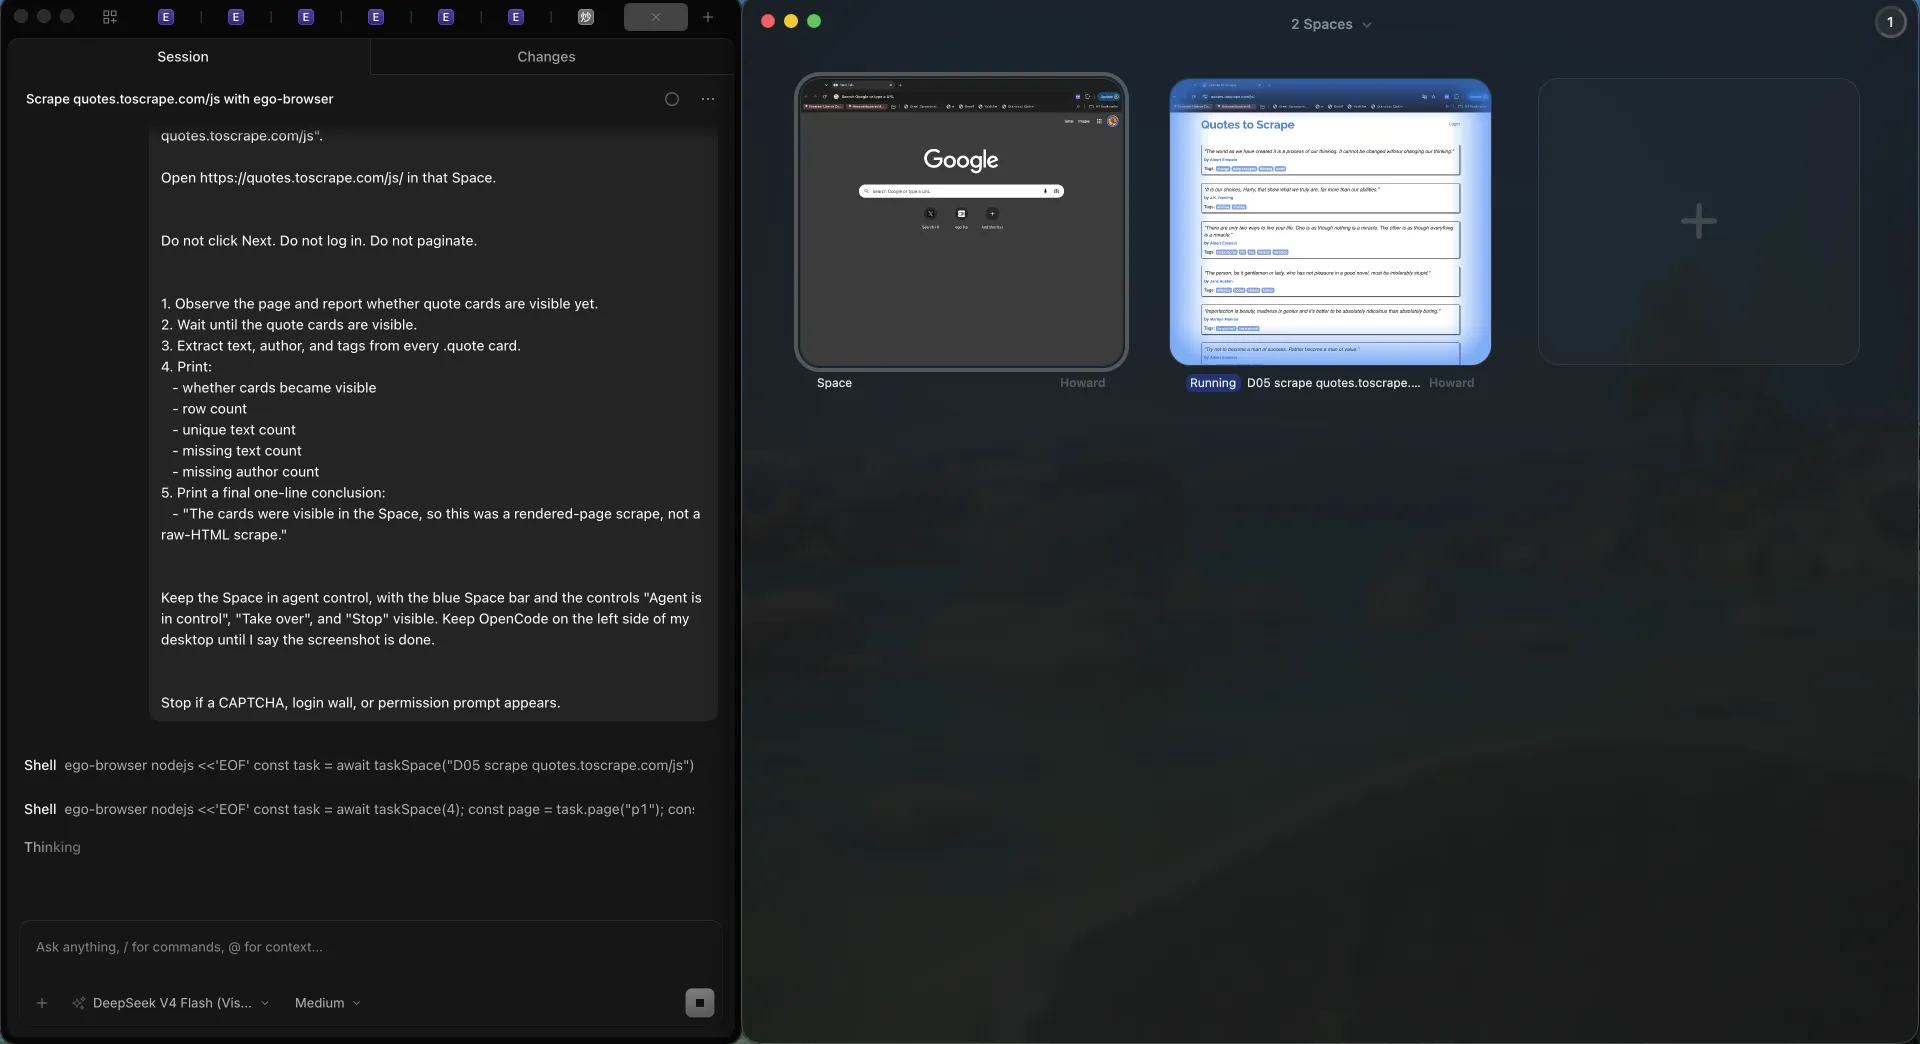
Testamos a mesma URL pública dentro de um desses Spaces. O Space 4 ficou em controle do agente em quotes.toscrape.com/js, com Take over e Stop visíveis, e imprimiu 10 cards únicos.
As trocas entre headless e headed estão em navegador headless vs navegador real para agentes de IA. A escolha de biblioteca está em Playwright vs Puppeteer para scraping. O contraste em nível de produto está em ego (lite) vs Playwright.
Quais são os desafios e as limitações?
O scraping com Playwright falha de jeitos mais silenciosos do que o scraping HTTP, porque o navegador pode parecer bem enquanto o arquivo está errado.
O primeiro limite é custo. Um contexto de Chromium não é um GET. Se os cards já estão no HTML, você está pagando por um navegador de que não precisa.
O segundo é honestidade sobre intercept. Tutoriais tratam capturar XHR como o passo avançado. Nesta demo o passo avançado é admitir que o payload está inline.
O terceiro são as páginas seguintes, e aqui isso fica em um limite de uma linha. Quando uma página renderizada já valida, páginas numeradas, Load More e infinite scroll viram outro trabalho. Misturar esses loops nesta página de esperar e extrair esconderia a falha do DOM vazio.
O quarto é permissão. Regras robots, termos e a lei de dados pessoais ainda valem. Um navegador headed não cria o direito de coletar.
Se o scrape está vazio e a página parece cheia, espere o card e depois conte as linhas. Uma janela headed não é prova. Nesta fixture o intercept também não achou XHR JSON; as citações já estavam inline como var data.
Perguntas frequentes
Playwright é bom para web scraping?
O Playwright é bom para scraping quando os cards visíveis não estão no HTML cru e o scraper consegue esperá-los em um navegador real. quotes.toscrape.com/js é o exemplo público: um GET não devolve nós .quote, e uma espera por .quote lê os cards pintados. É o padrão errado para HTML estático ou uma API documentada.
Quando usar HTTP em vez de Playwright?
Use HTTP quando os valores já estão no corpo da resposta. A demo de JavaScript ainda contém var data com as citações, mesmo sem cards .quote. Se um parser desse payload for estável, pule o navegador.
Por que meu scrape com Playwright devolveu zero linhas?
Zero linhas em geral significa que a extração rodou antes de os cards existirem. Ler o DOM em commit, antes de o pintor pintar, devolve 0 citações nesta demo, e os cards renderizados depois de waitForSelector('.quote'), sem exceção no caso vazio.
Devo esperar networkidle?
Espere o seletor que representa os dados, não uma rede quieta. networkidle pode travar em beacons de analytics. A espera que passa nesta demo é .quote, não networkidle.
Como interceptar JSON com Playwright?
Escute respostas cujo content-type inclua json, ou faça route da URL que a página já chama. Em quotes.toscrape.com/js as citações estão inline, então não há XHR JSON para capturar. Intercept é opcional. A espera do DOM continua funcionando.
Como raspar listas com várias páginas no Playwright?
Primeiro feche uma única página renderizada: espere, extraia, valide a contagem. Páginas numeradas, Load More e infinite scroll são outro trabalho. Esta página não implementa esses loops.
Como reaproveitar um login em um scrape com Playwright?
Salve o storage state depois de um login que você tem permissão de usar e carregue-o em um contexto posterior. Trate o arquivo como segredo e espere que ele expire.
O que fazer com um 429?
Pare, honre Retry-After quando vier, recue e falhe depois de um teto pequeno de tentativas. Um 429 é sinal de taxa, não problema de seletor.
Preciso do ego (lite) para scraping com Playwright?
Não. Use o Playwright quando a espera e o seletor já são conhecidos. Use o ego (lite) quando o scrape precisa de um Space acompanhado, de um perfil real já logado ou de uma pessoa assumindo. Em 2026-09-18 os dois caminhos extraíram 10 cards únicos de quotes.toscrape.com/js; o Space manteve Take over e Stop visíveis.
Scraping com um navegador real é legal?
Depende do site, dos dados, da jurisdição e do que você faz com o arquivo. Regras robots e termos ainda valem em um navegador headed. Isto não é aconselhamento jurídico.
Playwright ou Puppeteer para scraping?
Os dois conseguem renderizar a mesma página. A escolha de biblioteca são locators, esperas e language bindings. A decisão HTTP versus navegador desta página vem primeiro.
Se o próximo scrape precisa de um navegador acompanhado em vez de outra espera já programada, o ego (lite) é gratuito para baixar. O scraper de preços percorre um trabalho concreto nesse Space.
