网页抓取里的分页,难点不只是翻到下一页。更难的是判断后面还有没有数据,以及列表是不是真的结束了。多数站点会用三种模式之一:数字页、Load More(加载更多),或无限滚动。每一种都需要不同的导航策略、等待条件和停抓规则。一旦判断错了,爬虫可能提前停住,却从不抛错。
如果数据直接写在 HTML 里,或能从一个 JSON 接口拿到,通常根本不需要浏览器;纯 HTTP 更简单,也更快。只有当列表依赖客户端渲染、已登录会话、页面生成的 Token,或真实滚动行为时,浏览器才变得有用。而如果这些数据还依赖你已经登录的那只浏览器,ego (lite) 可以让 AI Agent 在现有浏览器会话里跑同一套分页逻辑,而不必重建登录态。
下面各节会用同一个问题去测数字页、加载更多和无限滚动:列表是真的结束了,还是爬虫只是不再继续要数据?示例用一套可重复的本地夹具:数字页共 135 行,加载更多背后渲染出 81 行,无限信息流有 60 条。读完之后,爬虫不仅会翻页,还会记下停在哪里、处理重复和漏行,并确认采集到的数据是完整的。
如何判断当前是哪一种分页模式
三条观察就能定分类。改 URL 或点带页码的链接会换掉结果集,这是数字分页。按钮文案承诺还有更多内容,点完只追加行、URL 不变,这是加载更多。滚动时行自己冒出来、没有可点的控件,这是无限滚动。页面如果混用几种模式,就把每一次切换当成独立模式,不要硬用一个循环同时覆盖。
在浏览器里快速核对,往往比读代码更快:打开 DevTools,盯着网络面板,操作一次。带 page 参数的导航请求是数字分页。点击触发的后台 JSON 或 HTML 请求是加载更多。滚动时反复发出的请求是无限滚动,响应里通常带着下一个 offset,这对爬虫是现成的礼物。
数字页:推导 URL 规则,并在正确的位置停住
数字分页最好相处,因为状态就写在 URL 里。从前三页推导规则:哪个参数在变,它是页码还是 offset,以及每页条数是否固定。规则应能写成一个函数;正确的函数能从第 3 页直接得到第 4 页,中间什么都不用访问。
// Derive once, then verify against page 2 and page 3 before trusting it.
const pageUrl = (n) => `https://example.com/listings?page=${n}`;

let page = 1;
const rows = [];
while (true) {
  await browserPage.goto(pageUrl(page));
  const batch = await browserPage.locator("tr.row").evaluateAll((nodes) =>
    nodes.map((node) => ({
      id: node.dataset.id,
      title: node.querySelector(".title").textContent.trim(),
      price: Number(node.querySelector(".price").textContent.replace(/[^0-9.]/g, "")),
    })),
  );
  if (batch.length === 0) break;
  rows.push(...batch);

  const hasNext = (await browserPage.locator("a#next").count()) > 0;
  if (!hasNext) break;
  page += 1;
}
终止条件值得比平时多花一点心思。下一页链接消失,和这一批是空的,都是真正的结束信号;写死的总页数不是,因为列表会变长,今天硬编码的数字下个月就错。夹具运行里,爬虫走完第 1 到第 5 页,用 80 毫秒收齐 135 行,并在下一页链接消失时停住。五次请求里有一次首次返回 503,爬虫对同一页重试一次后成功。
要让循环诚实,先守两条规则。第一,页面请求之间要停顿,不要能多快就多快,并遵守站点条款以及 RFC 9309 里描述的 robots 排除协议。第二,列表本应有序时,把“又拿到同一页”当成停抓信号,因为忽略自身参数的分页否则会永远转下去。
加载更多:点击、等待、去重
加载更多把状态藏在按钮后面,所以爬虫得自己制造增长:点击,等到行数真正增加,收走新增部分,再重复,直到按钮消失或再点也不改变任何东西。失败几乎都出在等待上。固定停顿在快网络上碰巧能用,在慢网络上会静悄悄截断列表。
await browserPage.goto("https://example.com/listings");

while (true) {
  const button = browserPage.locator("#load-more");
  if ((await button.count()) === 0) break;

  const before = await browserPage.locator("tr.row").count();
  await button.click();
  await browserPage.waitForFunction(
    (n) => document.querySelectorAll("tr.row").length > n,
    before,
    { timeout: 10000 },
  );
}

const rows = await browserPage.locator("tr.row").evaluateAll((nodes) =>
  nodes.map((node) => ({ id: node.dataset.id, title: node.textContent.trim() })),
);
夹具运行里,四批、每批二十行,在 273 毫秒内到达,可见列表是 81 行,数据集本身是 80 行。多出来的那一行是夹具故意埋的重复,用来模拟常见现实:同一条记录跨批次出现两次。页面自己的状态行写着 "Loaded 81 of 80",这正好提醒你:站点渲染出来的计数器不是校验依据。按稳定标识去重,例如行的 record id,而不是可见标题,你就会刚好去掉那一条重复。
无限滚动:触发条件、高度稳定与停抓规则
无限滚动没有按钮,也没有 URL,触发条件和停抓条件都得推断。触发通常是哨兵元素进入视口,或滚动位置越过某个阈值。停抓才需要判断,因为列表不会用一种你可以点击的方式宣布结束。
有一次测到的失败值得单独拿出来,因为多数爬虫出厂就带着它。滚到底一次,立刻看行数有没有增加,不等下一批渲染,就会马上报告 "no growth":夹具停在 15 of 60 行,才进了一批,而网络其实已经被要过下一批。检查对那一瞬间没有说错;错的是把一次安静当成列表结束。
可靠的写法是等待一个可观察条件,再用多次检查确认结束,而不是只看一次。滚动,等到条目数增长,或页面声明信息流已结束;只有连续三次检查两者都没发生,才把列表当成结束。夹具里同样 60 条在四轮滚动后收齐,零次误停,最后的状态行是 "End of feed (60 of 60)"。
let stableChecks = 0;
while (stableChecks < 3) {
  const items = await browserPage.locator("article.post").count();
  await browserPage.evaluate(() => window.scrollTo(0, document.body.scrollHeight));

  const grew = await browserPage
    .waitForFunction(
      (n) =>
        document.querySelectorAll("article.post").length > n ||
        /end of feed/i.test(document.body.innerText),
      items,
      { timeout: 3000 },
    )
    .then(() => true)
    .catch(() => false);

  stableChecks = grew ? 0 : stableChecks + 1;
  if (!grew) await browserPage.waitForTimeout(700);
}
两个细节决定循环是稳定还是发飘。高度是否稳定,要看抽出的条目数,而不是文档高度,因为懒加载图片和广告会改高度却不增加记录。滚动还必须真正再次触发站点的加载器:基于 Intersection Observer API 的实现会在交叉变化时触发,所以交替滚动位置比把页面停在底部更可靠。
记录抓取状态,崩溃后从断点续跑
三种模式共用一个要求:一次运行必须扛得住自己被打断。每完成一批就写检查点,记下模式、位置和目前收到的记录,并把续跑当成默认路径,而不是特殊路径。夹具里,数字页抓取在第 2 页之后被杀掉,检查点里有 54 行。新进程读入检查点,从第 3 页继续,最终得到与不间断运行相同的 135 行和 133 个唯一 id。
import { readFileSync, writeFileSync } from "node:fs";

const CHECKPOINT = "./crawl-state.json";
const save = (state) => writeFileSync(CHECKPOINT, JSON.stringify(state));
const load = () => {
  try {
    return JSON.parse(readFileSync(CHECKPOINT, "utf8"));
  } catch {
    return { mode: "numbered", lastPage: 0, rows: [] };
  }
};

const state = load();
for (let page = state.lastPage + 1; page <= 5; page += 1) {
  state.rows.push(...(await crawlPage(page)));
  state.lastPage = page;
  save(state); // checkpoint after every page
}
检查点也会改变调试方式。抓取如果真的给出错误条数,你可以先看状态文件,而不必整份任务重跑;那里记下的位置会告诉你该重抓哪一批。
重复行、漏行,以及假的最后一页
三种症状覆盖了大多数分页 bug,而且每一种的签名都在数据里,不在代码里。重复出现在一批与相邻批次重叠时,底层列表在两次请求之间重新排序,稳定标识就会重复。夹具精确复现了这一点:同一个 id 在第 2 页出现一次,第 3 页再出现,第 5 页里又出现。按 id 去重之后,两条重复都消失了。
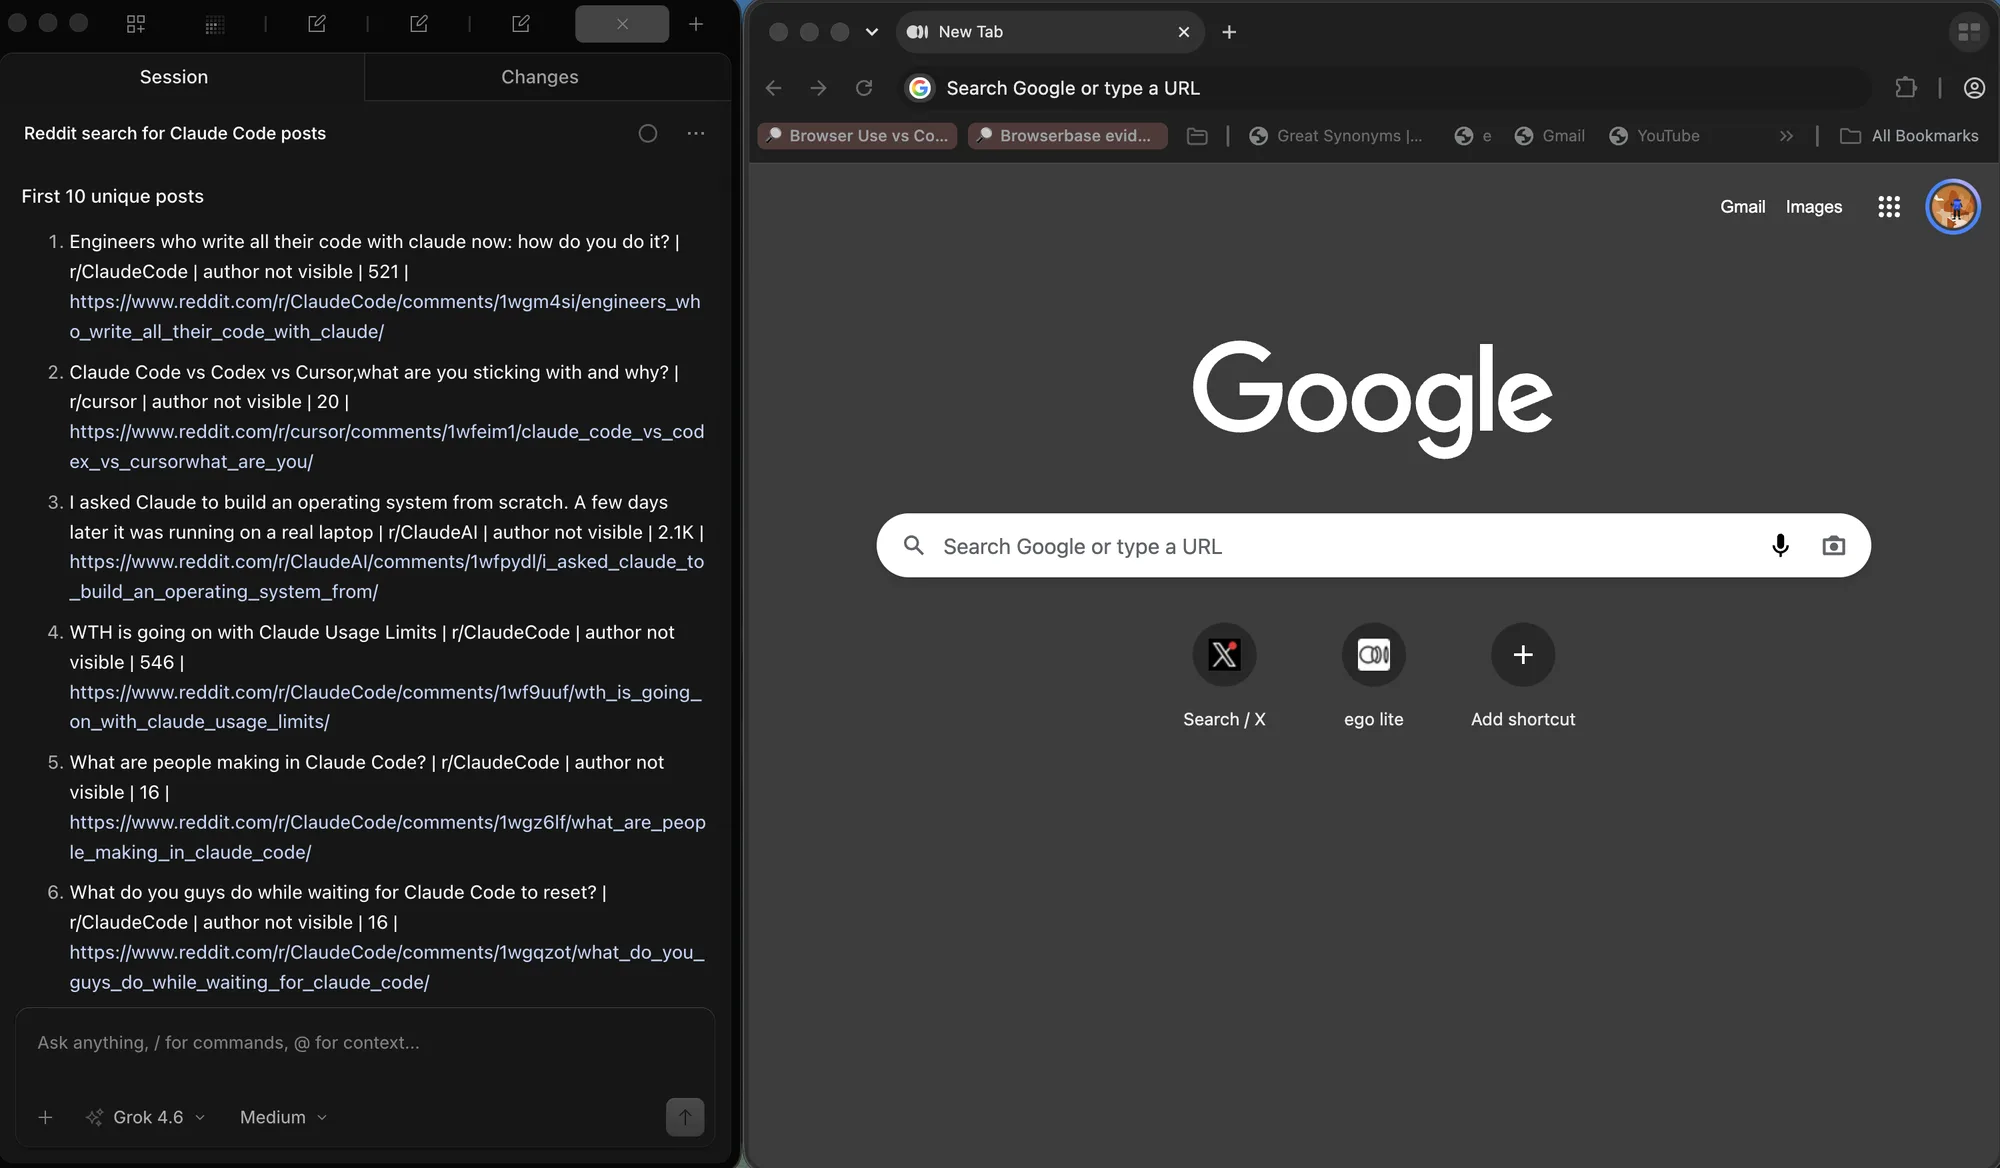
漏行通常意味着等待太短,或某一页被跳过。如果总数刚好少一批,去看出问题前那一次交互;如果少的是一整页,去看循环的增量。夹具里短暂的 503 是另一种味道:没有重试的话,第 3 页会贡献零行,整次运行会报 106 行,却没有任何错误。
假的最后一页最危险,因为抓取会带着更少的数据报告成功。它出现在某一页因会话或渲染问题返回零行,而不是列表真的结束,循环却把两者一视同仁。区分办法是再探一次:稍等之后再请求下一页,必须看到真正的结束标记,或连续两次空响应,才接受结束。
用条数和字段完整度做校验
校验就是两项只需几秒、却能抓住多数静默失败的检查。条数检查把采到的数量,和你能找到的每一个独立数字对照:最后一页自己的 "page 5 of 5" 声明、页头里的总数,或沿途每页条数之和。字段检查确认每条记录都带着任务承诺的字段,并把例外计下来,而不是忽略它们。
const unique = new Map(rows.map((row) => [row.id, row]));
const missing = rows.filter((row) => !row.title || !Number.isFinite(row.price));

console.log({
  raw: rows.length,
  unique: unique.size,
  removedDuplicates: rows.length - unique.size,
  missingFields: missing.length,
});
夹具的 135 条数字页上,检查报告零个缺失字段、去掉两条重复、133 条唯一记录,与数据集完全吻合。加载更多列表则报告 81 条里有 1 条重复。这两个数字单独看都不稀奇;要紧的是其中任何一个变化都会立刻可见,而不是在下游报表里变成一段说不清的缺口。
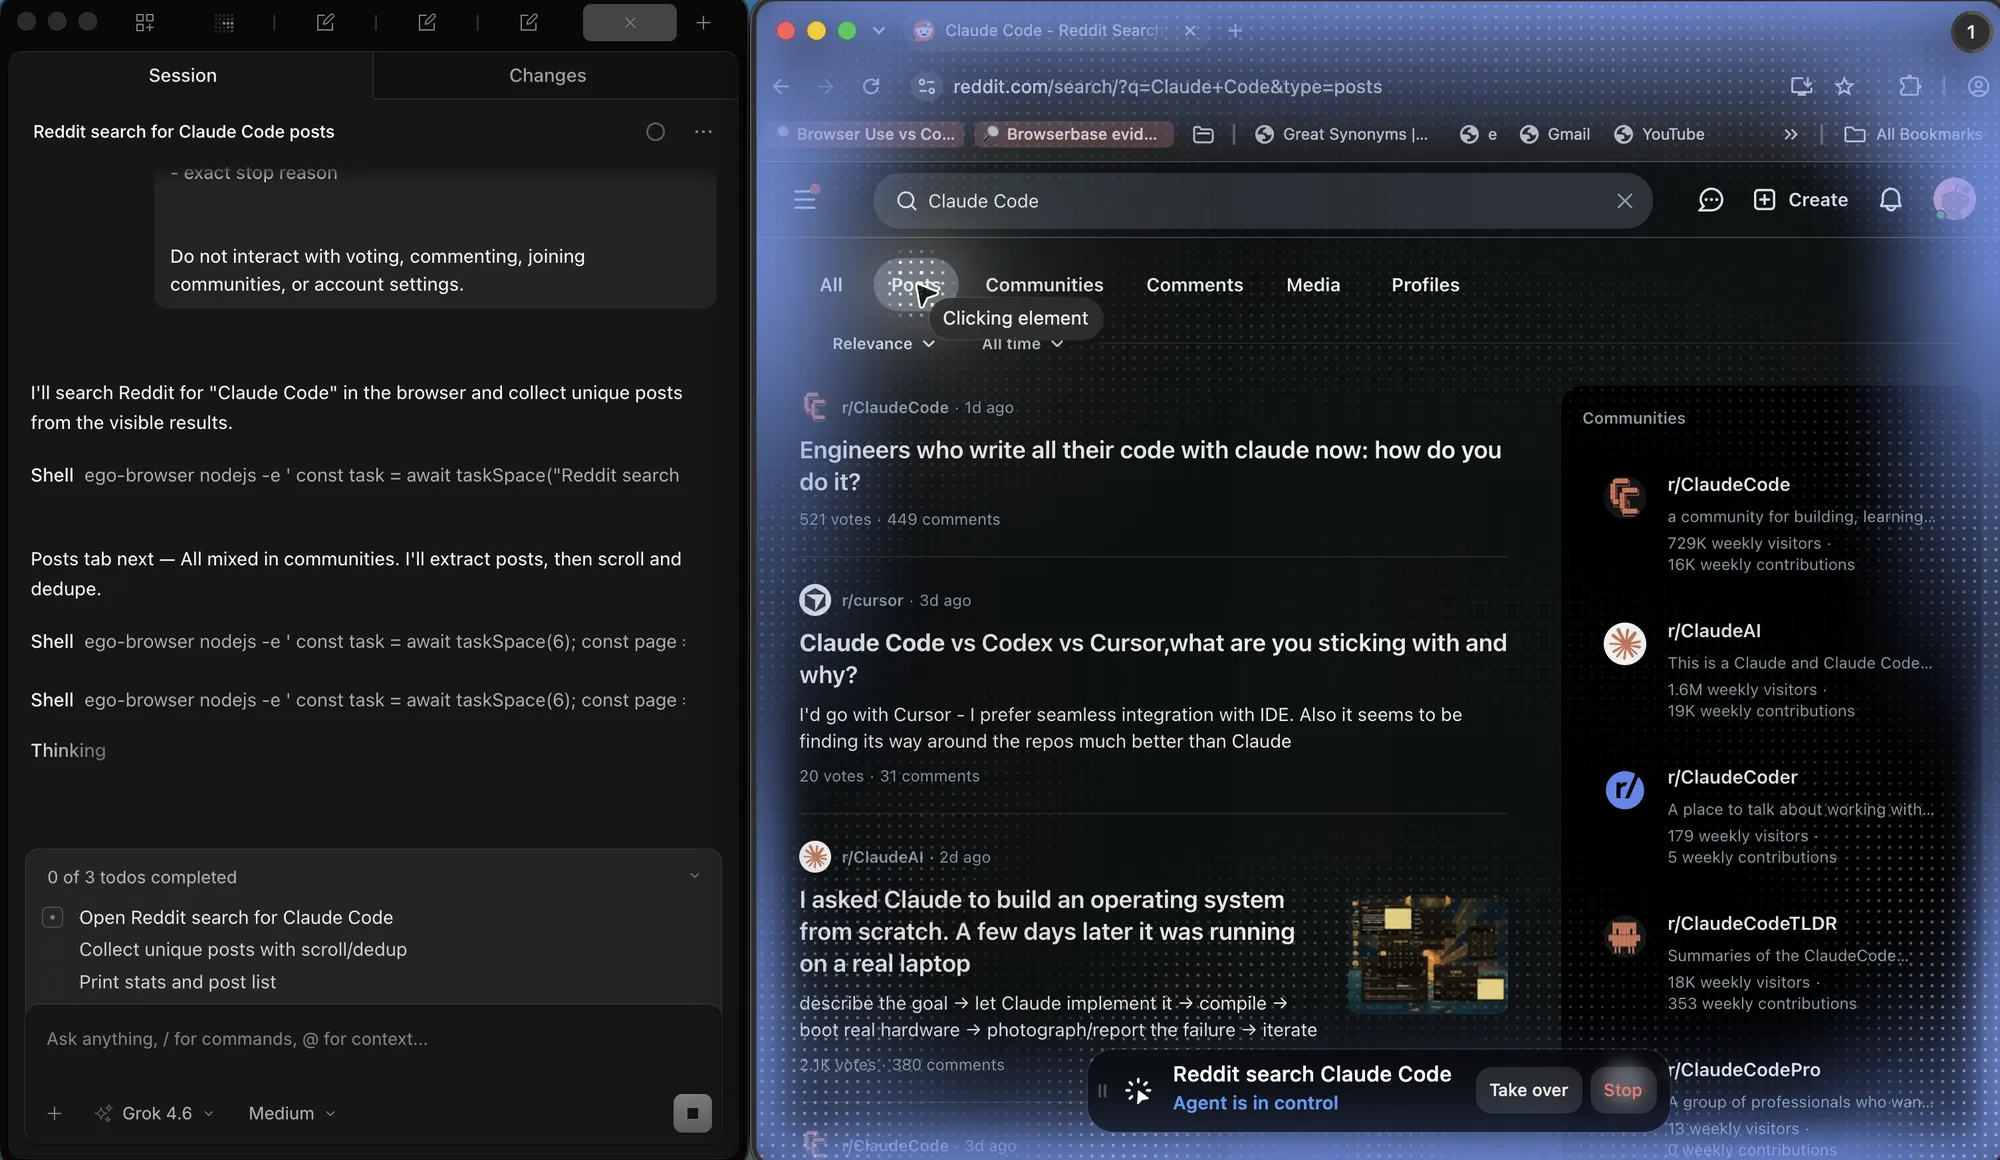
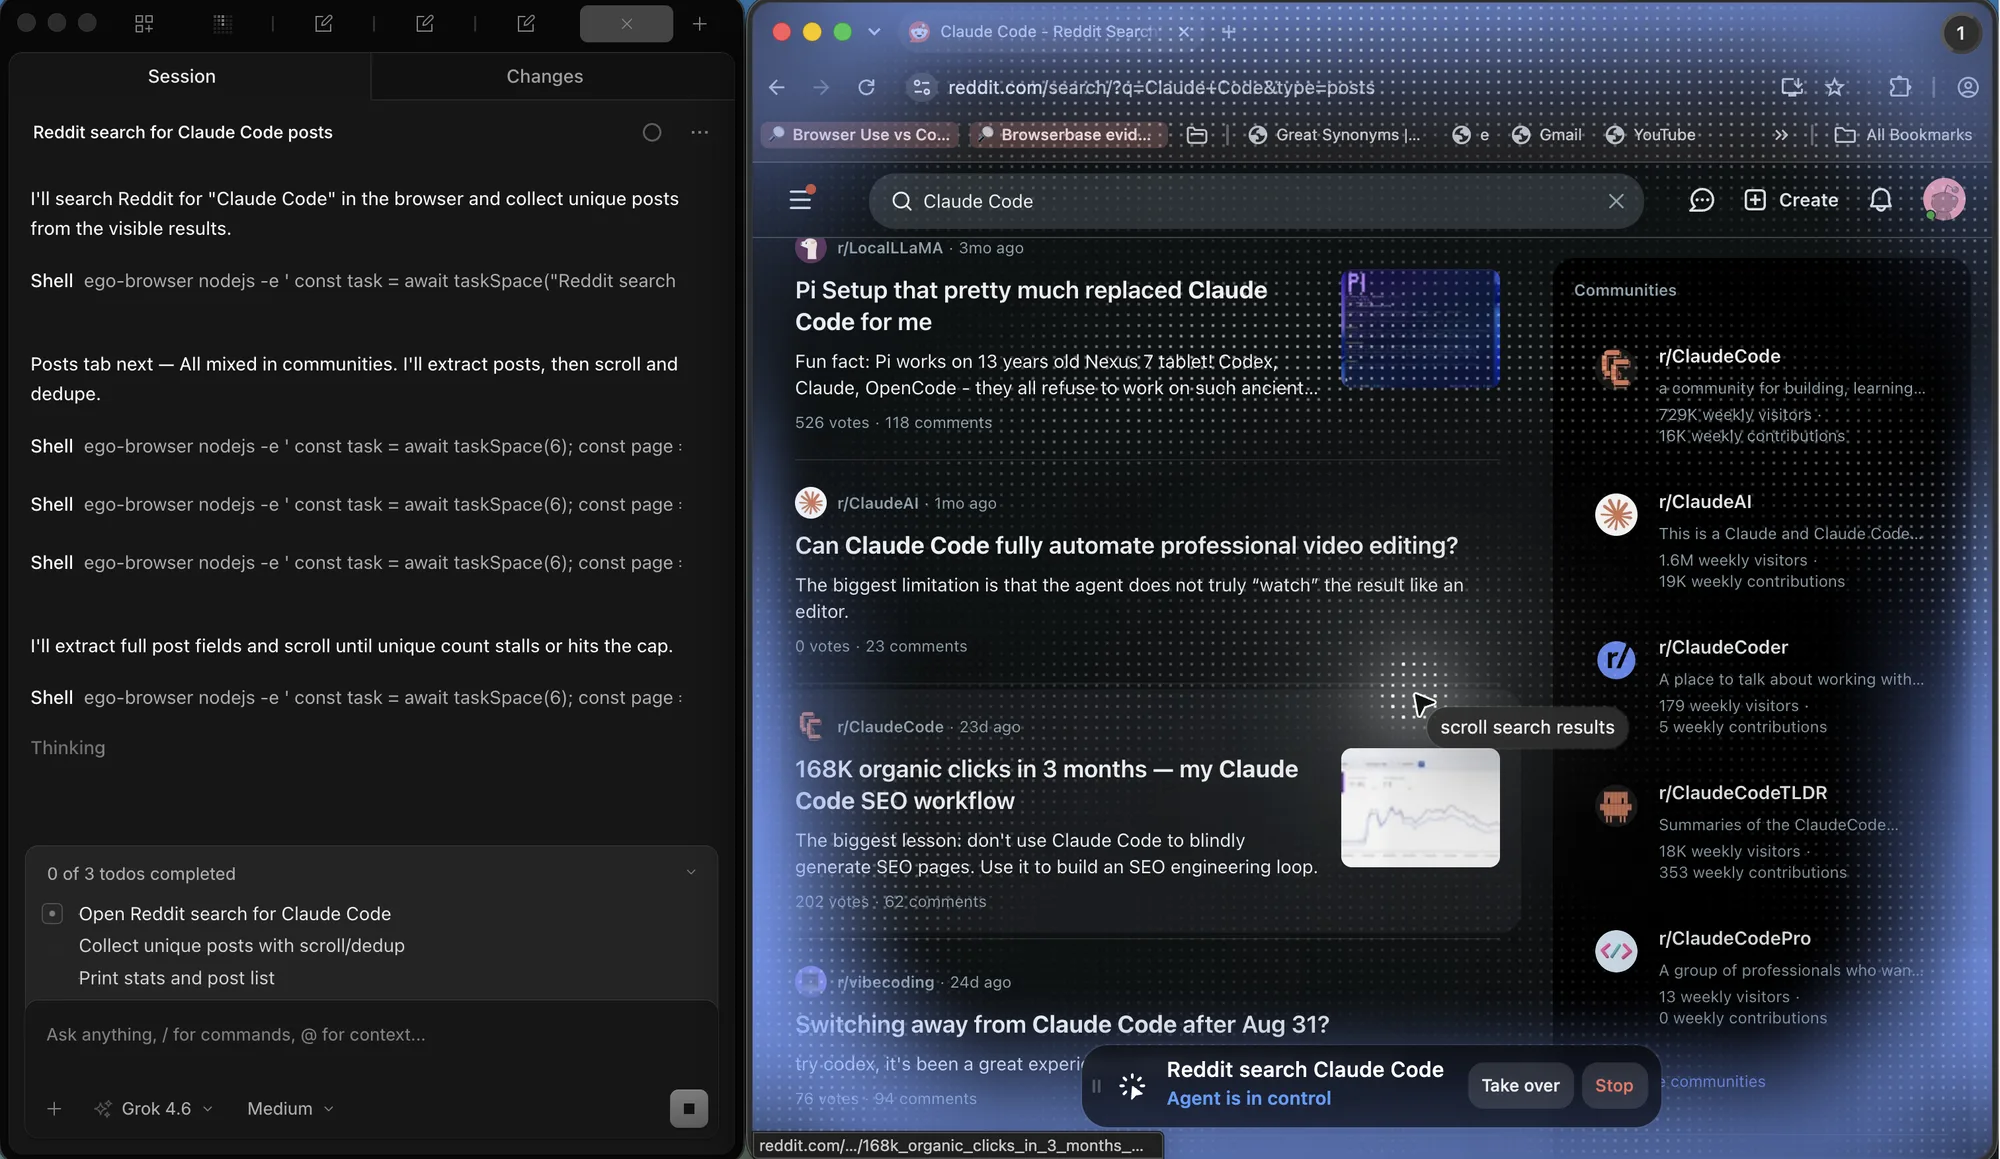
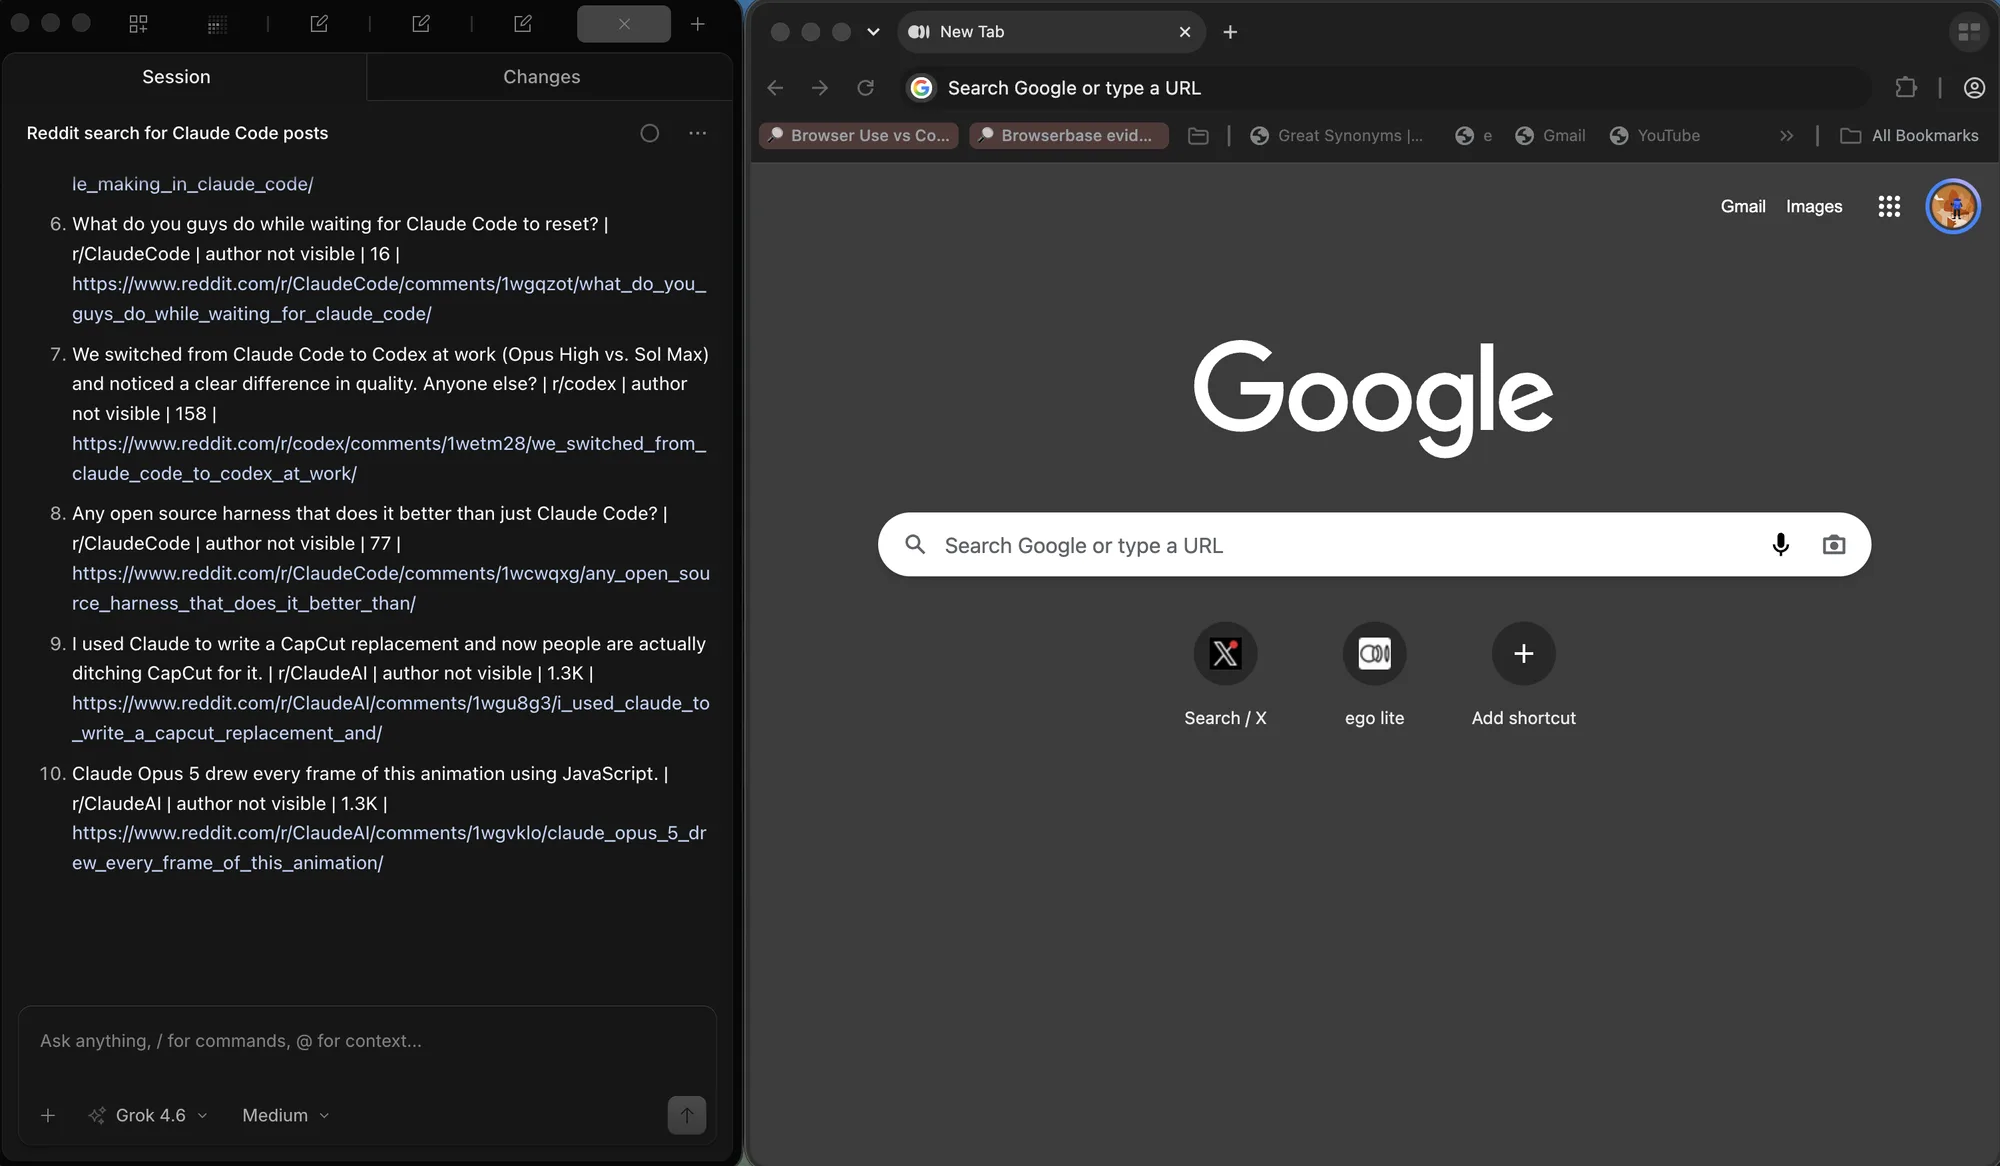
这次 Reddit 运行把同一套检查用在直播去重列表上,不是 135 行夹具。每行都要有标题、subreddit、票数和 URL。滚动之后要核对的是这份编号输出。
什么时候纯 HTTP 就够,什么时候不够
同一套夹具数据不用浏览器也能拿到。两条路径都测一遍,才是判断任务到底需要什么的老实办法。一个纯 HTTP 客户端按 URL 走数字页,从 JSON 接口拉加载更多的批次,再按 offset 拉无限信息流,135、81 和 60 行合计用了 24 毫秒。没有渲染,没有等待,没有滚动。
这就是默认建议,而且应该说清楚:有官方 API 就用官方 API。数字列表如果是服务端渲染,直接请求这些页面。加载更多或无限模式如果背后是不需要签名的 JSON 接口,就请求那个接口,按 offset 分页。这些都不需要 Playwright 这类框架,HTTP 路径跑起来更快、也更便宜。可参考 Apify 分页实操、Web Scraper 分页选择器文档,以及 Playwright 网络指南 里的网络面板流程,它们从不同起点覆盖同一片内容。
只有在这些情况下才有必要上浏览器:数据必须等客户端渲染之后才存在;请求带着页面里生成的签名或 Token;列表需要登录;或者没有真实会话和真实 user agent 时,接口的响应就不一样。到了这一步,浏览器不是抓取偏好,而是唯一老实的路径,前面各节的逻辑原样适用。
ego (lite) 只在这条 HTTP 路径失败之后才进场。如果列表需要已登录 cookie、页面生成的 Token,或没有真实视口就永远不会发生的滚动,就在已经持有会话的浏览器里跑同一套数字页 / 加载更多 / 无限循环。不要从那里起步。夹具已经给出更便宜的答案:纯 HTTP 用 24 ms 拿到 135、81 和 60 行。
真的需要浏览器时,仍沿用前面各节的抓取逻辑。ego (lite) 提供已登录的页面和一个你可以盯着看的 Space;它并不会发明一套新的分页算法。某一步需要人来做,就停。如果 curl 或官方 API 已经能返回这些行,就留在 HTTP 上。
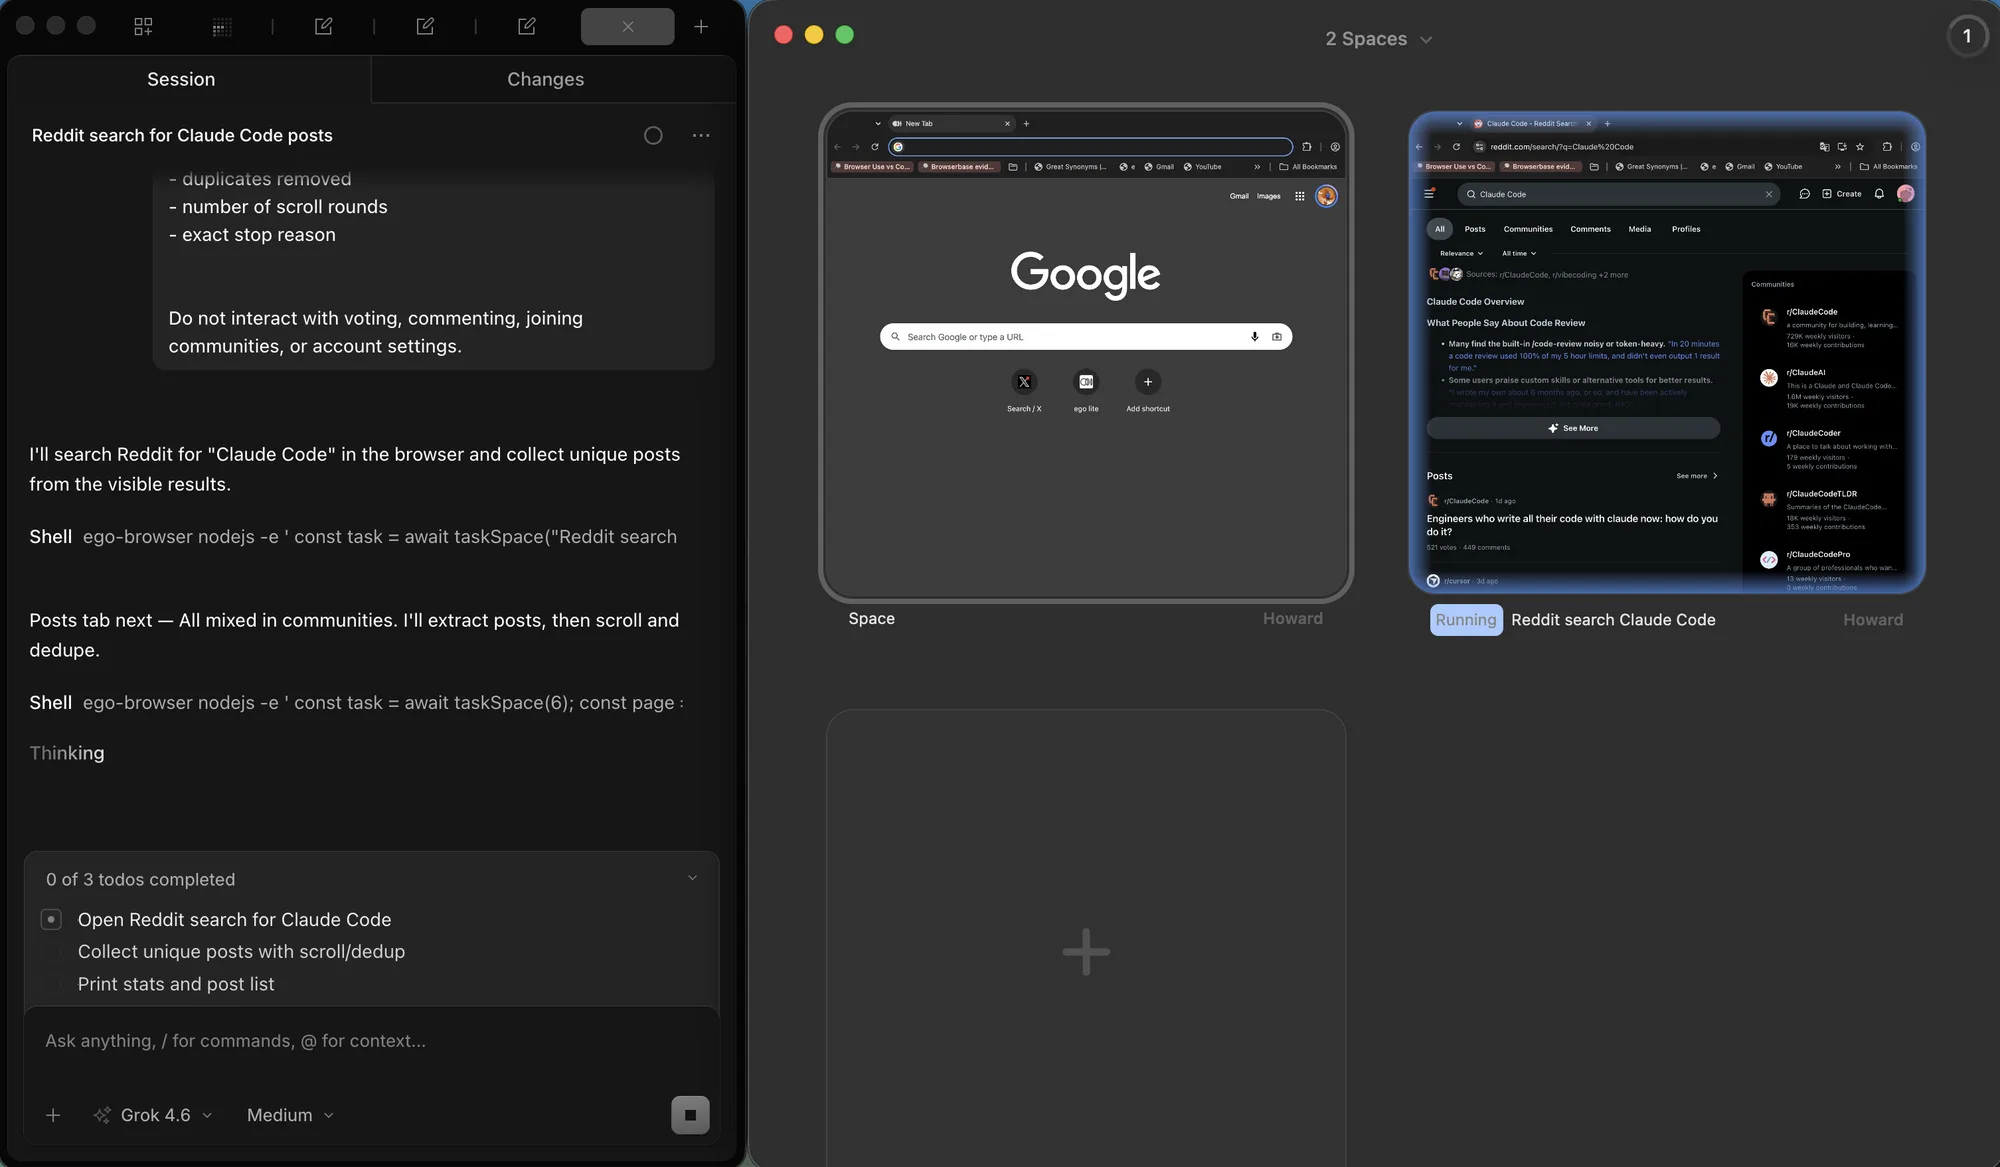
编号页的隔离规则仍然适用。共用一个窗口的两个爬虫会抢滚动位置,互相覆盖对方最后看到的一行。同一浏览器里,两个 Space 相当于两个 Playwright context:一个可以停在 Google 空转,另一个继续滚 Reddit。隔离才是重点。总览只是让你同时看见两者。
版本 0.5.0.32 记在 更新日志(2026-09-12)。引用更新的构建前,请再核对该页、快速开始 和 GitHub 仓库。相邻指南 用 JavaScript 做网页抓取 从另一侧讲静态与渲染的判断。
FAQ
数字列表到底有多少页,怎么知道?
看最后一页控件,用页头总数除以每页条数,再真正走到末尾一次,就能知道数字列表有多少页。把这个估计当核对,而不是循环的停抓条件。
为什么爬虫会在页与页之间收到重复?
底层列表重新排序时,一条记录会从这一批滑到下一批,爬虫就会在页与页之间收到重复。按稳定的 record id 去重,不要按可见标题,并记下去掉了多少条重复。
点击加载更多之后该等多久?
等到一个可观察条件成立:行数增加了,按钮的 disabled 状态解除了,或下一批里已知的某一行出现了。固定延迟只是猜测,网络一慢它就失效,而这正是它会失败的时刻。
无限信息流的尽头怎么判断?
站点如果提供明确信号,就优先用它,例如渲染出来的结束文案,或响应里的 has-more 标志。两者都没有时,要连续多次检查都没有新条目、已加载内容的高度也不再变化,再停,而不是只看一次安静。
分页抓取该用无头浏览器吗?
只有数据需要渲染、会话或页内 Token 时才用。服务端渲染的列表和 JSON 接口更适合纯 HTTP,跑起来更快、也更简单。两条路径都测一次,对比通常会让决定变得显而易见。
分页抓取为什么会提前停住?
三个常见嫌疑人:等待在这一批渲染完之前就结束了;把短暂错误当成了空页;运行中途会话过期,下一页渲染的是登录表单而不是行。每一种修法都不同,所以停抓原因要和条数一起记下来。
崩溃之后怎么续跑抓取?
每完成一批就写检查点,记下模式、位置和目前收到的行。续跑读取该文件,从记录的位置重新进入该模式。在检查点位置之前再抓一批,确认源数据没有在已保存状态底下发生偏移。
怎样确认一次抓取是完整的?
把唯一记录数至少和两个独立数字对照,例如最后一页自己的总数,以及各页条数之和,再检查每一行的字段完整度并报告例外。条数对得上、字段又都在,这是强信号;只满足其中一项则很弱。
要慢慢滚才能触发懒加载吗?
通常不必,但要再次触发加载器,而不是停在底部不动。站点用的 intersection observer 在变化时才会触发,所以交替位置或分步滚动,比一次大跳更可靠,增长检查也才有意义。
登录墙后面的分页列表能抓吗?
可以,前提是真实会话,规则也一样:礼貌分页,保持会话活着,并把跳转到登录页当成会话问题,而不是列表结束。像 ego (lite) 这种已经带着你登录态的浏览器,会把重建会话这一步整个省掉。可参考 持久会话指南 讲状态处理,价格抓取用例 则展示一次完整的登录后采集长什么样。