
JavaScript 渲染页可以返回成功响应,爬虫却仍是 0 行。HTML 已经加载,用户在浏览器里看到的卡片,DOM 里却可能还没出现。用 ego (lite) 时,这个落差看得见。任务跑在可监视的 Chromium Space 里,你能看出页面还在渲染、选择器没对上,或你要的数据根本没出现。
Playwright 把已确认的行为写成稳定、可重跑的抓取流程。它可以等待目标卡片渲染、从实时 DOM 提取字段,并校验结果里有你预期的数据。选择器和等待条件一旦确定,用 Playwright 写进脚本最自然。若任务还需要目视检查、已有的登录态,或某一步要人接管,ego (lite) 会把浏览器状态维持可见、可交互。脚本即使正常退出,也藏不住其实一行都没抓到。
怎么用 Playwright 抓 JS 渲染页?
用 Playwright 做网页抓取,就是驱动真实浏览器让 JavaScript 把页面画出来,再读取渲染后的节点。浏览器本身就是爬虫。HTML 响应在脚本跑完前只是空壳。
Playwright 会启动 Chromium、Firefox 或 WebKit,开一个 context,再给你 page.goto、等待、locator 和 page.evaluate。这些 API 是为测试写的,提取也能用,因为两件事要的是同一样:和肉眼看到的一样的 DOM。
相邻的工作不在这页处理。
在 JavaScript 里该用 fetch 还是浏览器,见 用 JavaScript 做网页抓取。跨次运行复用登录态,见 持久浏览器会话。X 和 LinkedIn 的登录墙,见 登录墙后方的 AI 抓取。编号页、Load More 和无限滚动,要等这一页已经返回正确的行之后再谈。
什么时候该用 Playwright 抓,而不是 HTTP?
对 URL 发 GET 却没有你要抓的节点时,用 Playwright。值已经在响应正文里,或页面已提供有文档的 JSON 接口时,用 HTTP。
quotes.toscrape.com/js 就是故意做成这样。对这个 URL 发 GET,返回的 HTML 没有 class="quote" 节点。名言放在内联的 var data 数组,再由 jQuery 画成卡片。CSS 解析器拿 .quote 去对原始响应,什么都存不到,看起来像选择器写错。
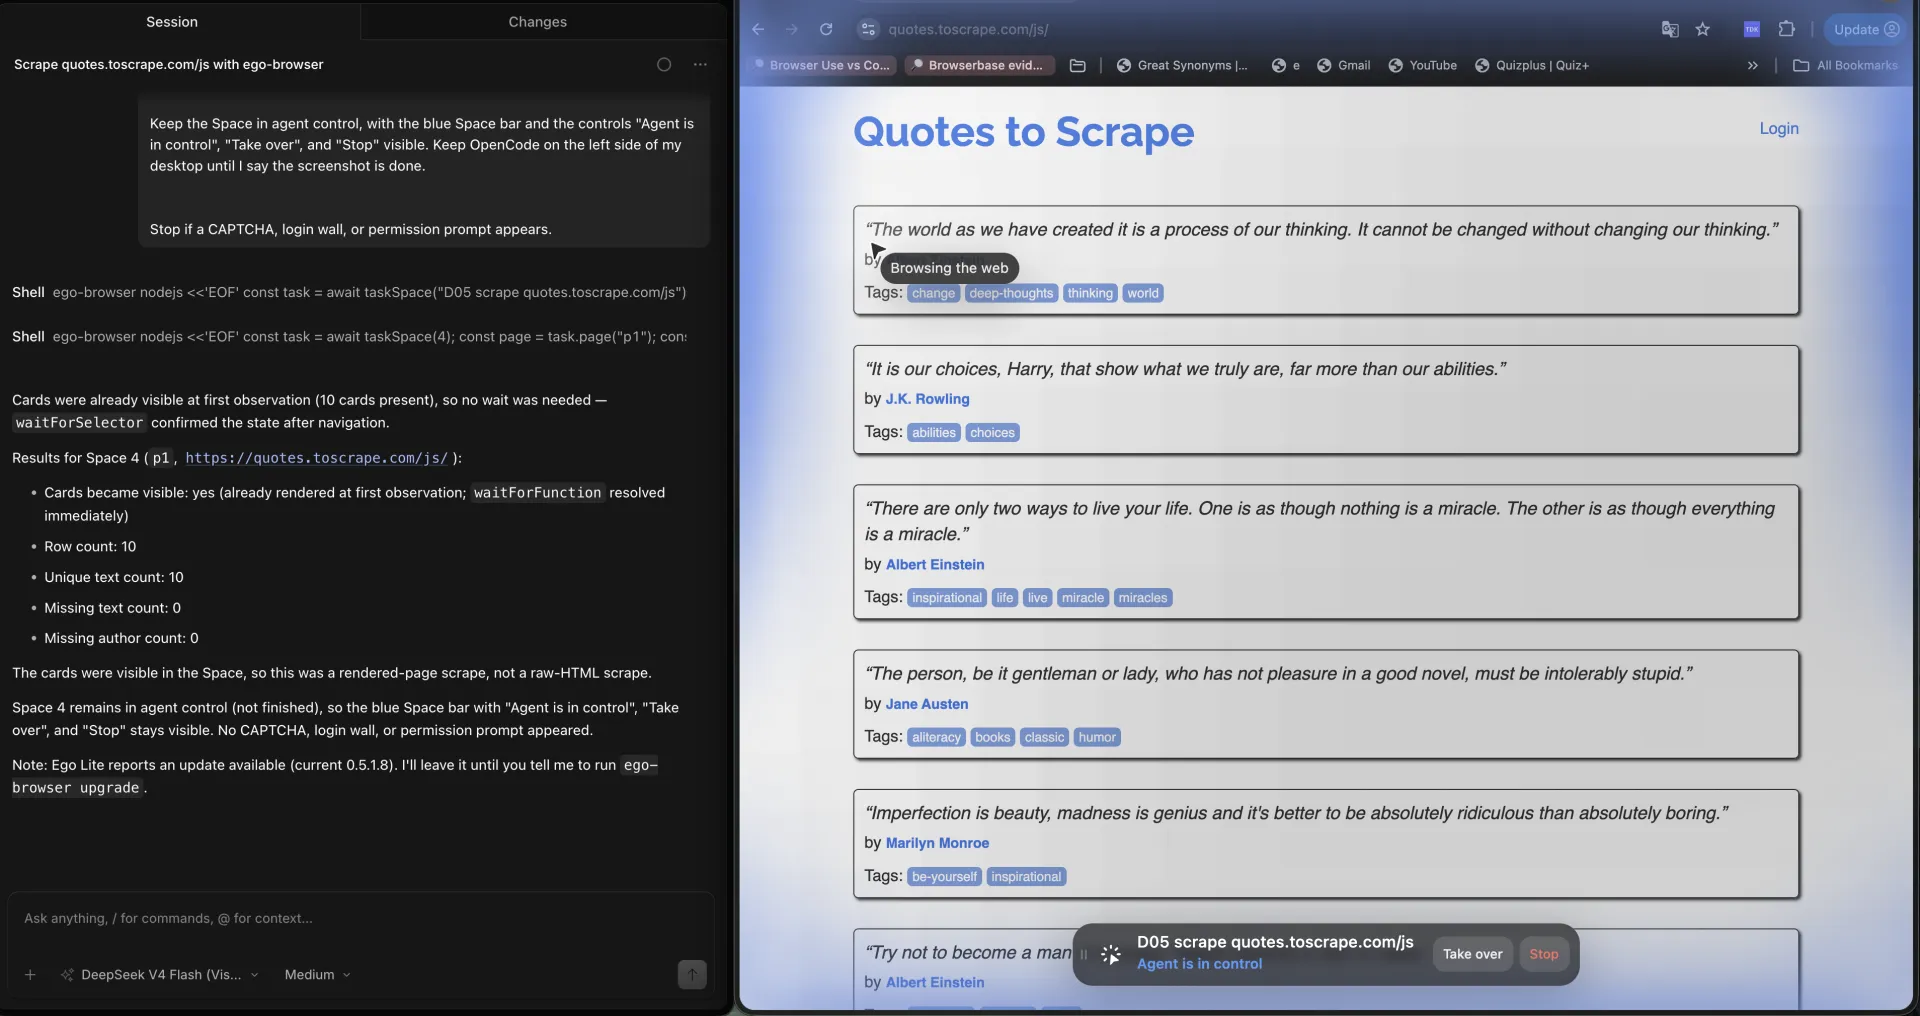
我们在 2026-09-18 从 OpenCode 测过这个落差。对 quotes.toscrape.com/js 发 GET,拿到 HTTP 200,原始 HTML 里 0 张 .quote 卡片;右侧 headed Chromium 窗口却已经显示画好的列表。
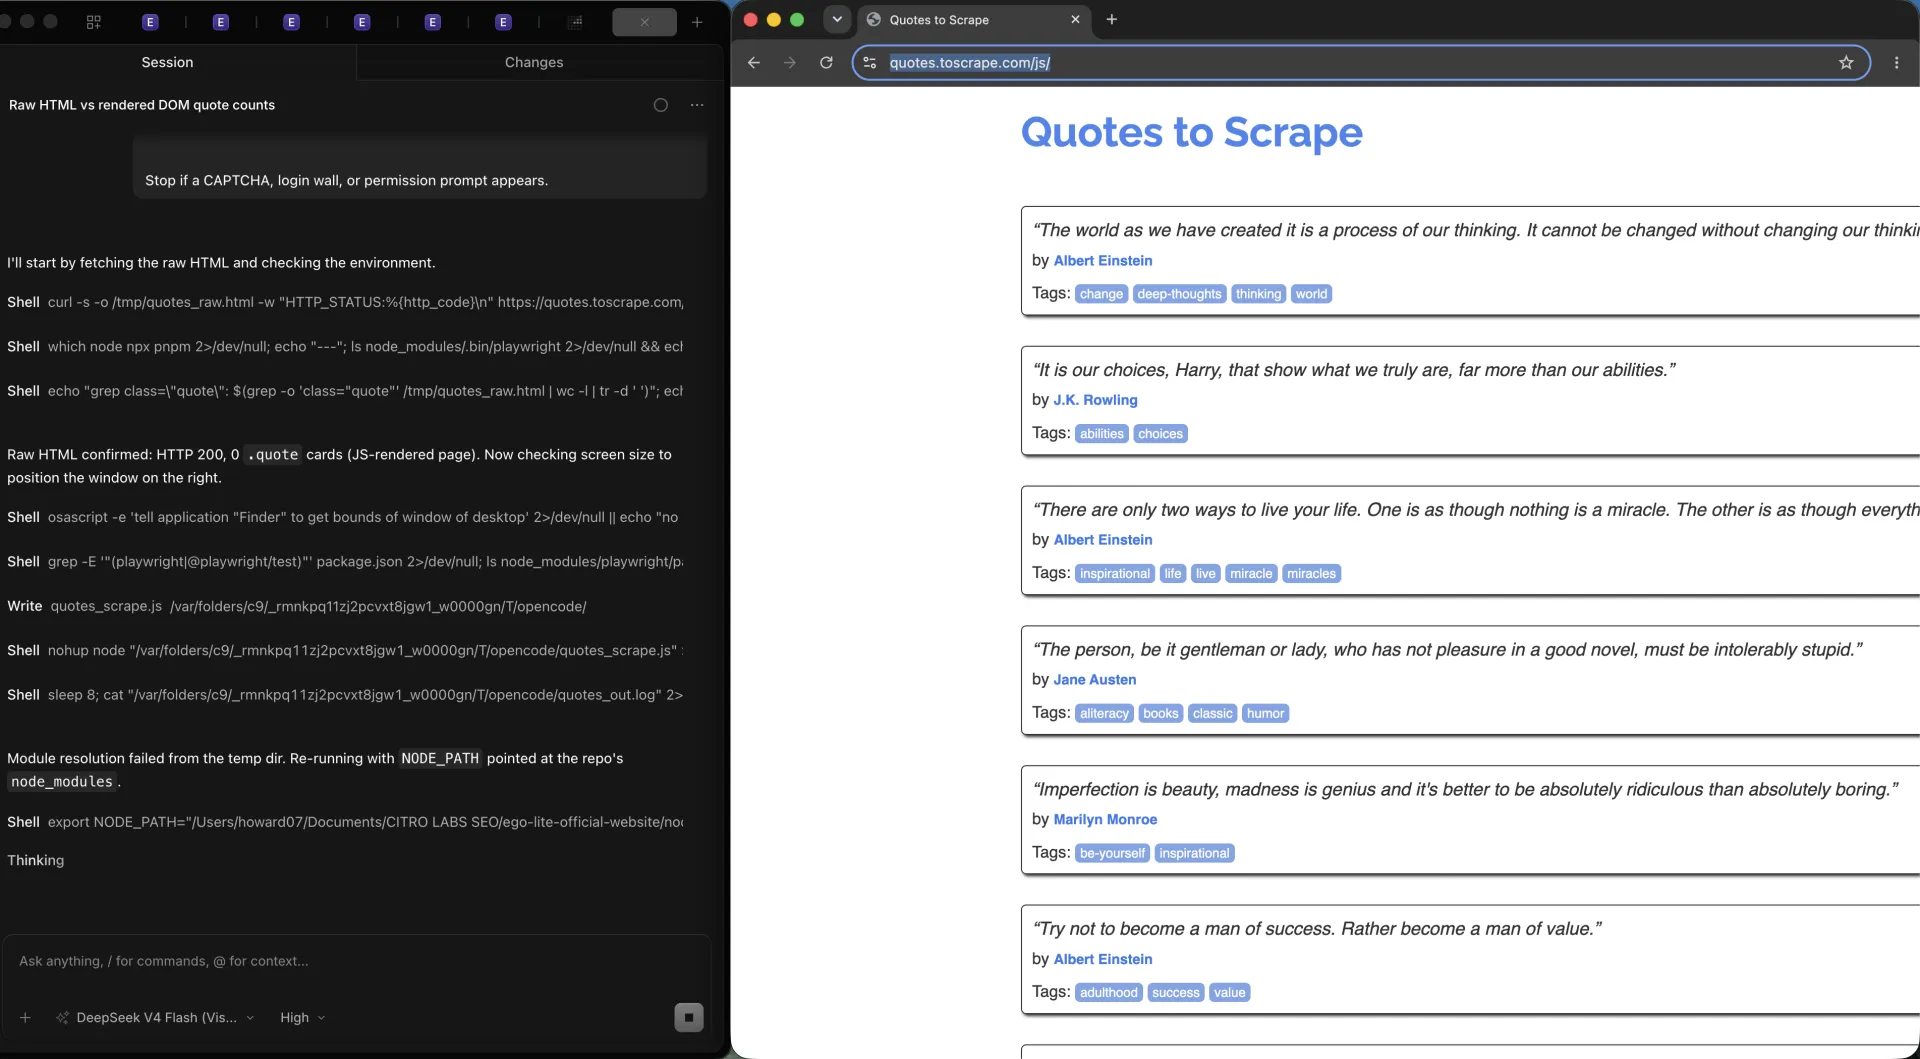
这个落差可以这样看。
| 路线 | 它能做什么 | 它不能做什么 |
|---|---|---|
| HTTP GET + HTML 解析器 | 读服务器送来的字节。便宜、快,卡片已经在标记里时就够用。 | 无法执行页面脚本,也无法等待稍后才出现的节点。对 quotes.toscrape.com/js,它在原始 HTML 里看不到 .quote 卡片。 |
| 解析内联 payload | 在 quotes.toscrape.com/js,用 regex 加上对 var data 做 JSON.parse,就能从同一份 HTML 还原名言,不必开浏览器。 | 站点一改版、不再嵌入这个数组,这条路就断了。内部 payload 不是 API 契约。 |
| Playwright 渲染后的 DOM | 执行页面 JavaScript,等待 .quote,再提取人眼看到的卡片。 | 无法保持便宜。每个 context 都吃内存,拿一整批去打静态 HTML 是错工具。 |
这个演示还有一句实话:直接解析 var data 的话,其实不必 Playwright。多数 JS 站点不会把具名数组留在第一次响应里。它们不留的时候,Playwright 这条路还走得通。
怎么启动、导航,并等待内容出现?
最小的 Playwright 抓取就是启动、new context、goto、等待卡片选择器、提取、再关闭。跳过等待,就会得到一份成功写出的空文件。
Playwright 的 page.goto 可以停在 commit、domcontentloaded、load 或 networkidle。waitForSelector 才是在确认你要的东西真的存在。在 quotes.toscrape.com/js,goto({ waitUntil: 'domcontentloaded' }) 有时就够了,因为内联脚本就写在那份 HTML 里。那是运气,不是规则。
import { chromium } from "playwright";

const browser = await chromium.launch();
const context = await browser.newContext();
const page = await context.newPage();

try {
  await page.goto("https://quotes.toscrape.com/js/", {
    waitUntil: "domcontentloaded",
  });
  await page.waitForSelector(".quote");
  const rows = await page.evaluate(() =>
    [...document.querySelectorAll(".quote")].map((el) => ({
      text: el.querySelector(".text")?.textContent?.trim() ?? "",
      author: el.querySelector(".author")?.textContent?.trim() ?? "",
      tags: [...el.querySelectorAll(".tag")].map((tag) =>
        tag.textContent?.trim(),
      ),
    })),
  );
  console.log(rows.length);
} finally {
  await context.close();
  await browser.close();
}
想看到空抓取,就在 commit、卡片还不存在时提取,或把画卡片的脚本延后。那样提早提取会返回 0 行。等 waitForSelector('.quote') 之后,同一页才返回渲染后的卡片。空结果时什么异常都不抛。
| 等待 | 它证明什么 | 它怎么失败 |
|---|---|---|
| 只等到 commit | 导航已开始。适合当反向测试。 | 脚本可能还没跑。在 commit、绘制代码还没动手前提取,会拿到 0 条名言。 |
| domcontentloaded | 初始 HTML 已解析。这个演示够用,因为 var data 就写在那份 HTML 里。 | 晚到的 XHR 卡片仍可能缺席。别把它当成「内容已就绪」。 |
| waitForSelector('.quote') | DOM 里至少有一张卡片。这次等待才把演示变成可抓的行。 | 过期的 class 可能对到上一份列表。要等待会随数据变动的字段,不要等一个永远不消失的外层。 |
在 finally 里关闭 context。内存是 context 占住的。提取中途抛异常,还是得把 Chromium 放掉。
怎么从渲染后的页面提取字段?
用 page.evaluate 在页面内提取;只要单个控件而不是列表时,改用 locator。两者都读渲染后的 DOM,都不会去读 goto 当下的原始 HTML 快照。
把每张 .quote 对到 text、author、tags。公开演示会画十张卡片。必填字段是 text 和 author。唯一键是名言文本,不是作者,因为 Einstein 会出现不止一次。
同一段 OpenCode 会话里,我们测过这次提取。等 waitForSelector('.quote') 之后,headed 运行印出 10 行、10 条不重复文本、0 行缺作者。原始 HTML 仍是 0 张卡片。
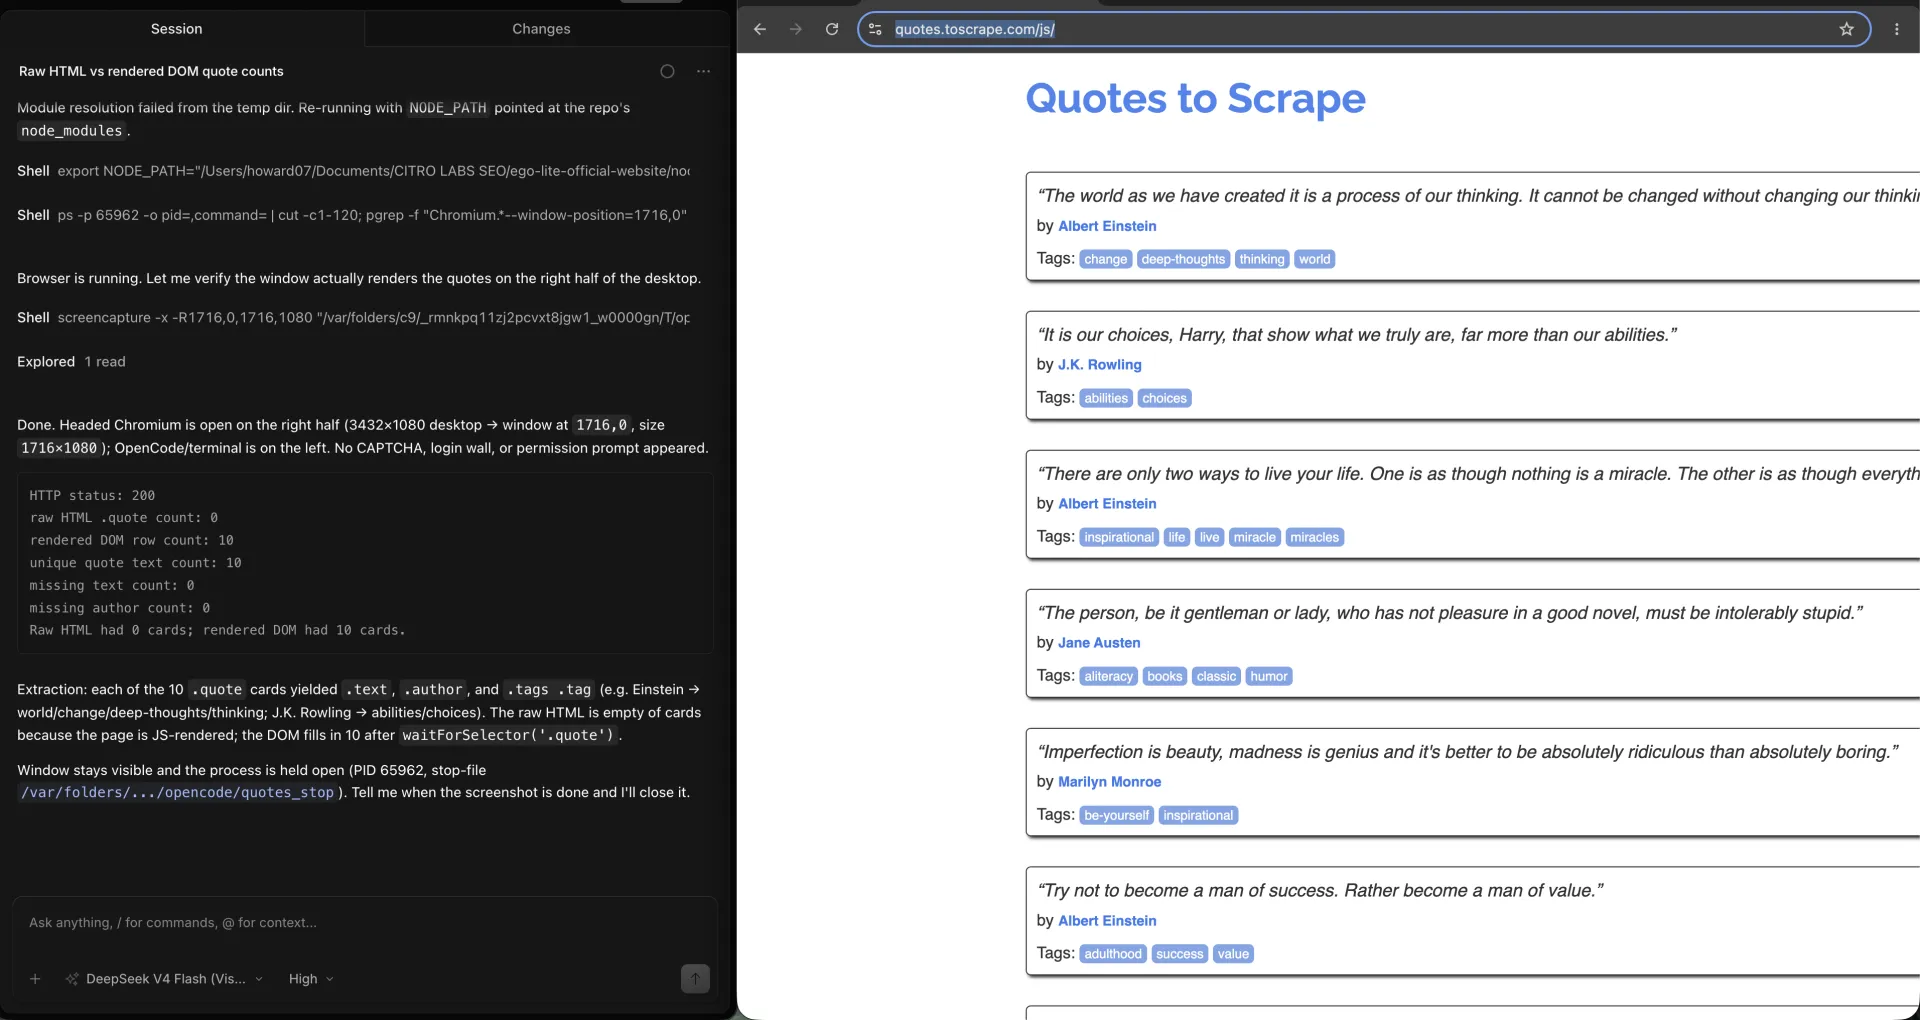
只要单个字段时,locator 更干净。Playwright locator 在每次动作前会重新查询,所以页面重绘时,已存的 element handle 会坏,locator 还在。
const title = await page.locator(".quote .text").first().innerText();
const author = await page.locator(".quote .author").first().innerText();
列表提取更适合 page.evaluate。它跑在页面里,并返回 JSON。mapper 保持精简。只拉 text、author、tags 和唯一键。截图和 PDF 不要放进抓取循环。
被 CSS 藏起来的文本仍在 DOM 里。innerText 跟布局走,textContent 不跟。站点用 CSS 截断标题时,textContent 仍会给你完整字符串。写校验器之前,先决定你要收哪一种。
怎么拦截页面自己的数据?
页面本来就会拉一份可直接存文件的 JSON、不必再从卡片解析时,拦截才有用。quotes.toscrape.com/js 根本不发那个请求,重点就在这里。
那个演示里的名言不是来自 API。它们以 var data 嵌在 HTML 里,再由 jQuery 画成 .quote 节点。专门听 JSON 的 response listener 什么有用的都看不到。
Playwright 的 网络文档 说明了 page.route 和 response listener。去用。然后把页面实际发出的东西记下来,包括什么都没有。
const jsonResponses = [];
page.on("response", async (response) => {
  const type = response.headers()["content-type"] || "";
  if (type.includes("json")) {
    jsonResponses.push({
      url: response.url(),
      status: response.status(),
    });
  }
});
await page.goto(url, { waitUntil: "domcontentloaded" });
await page.waitForSelector(".quote");
console.log(jsonResponses.length);
没有 JSON 正文时,回退到渲染后的卡片,或解析你已经下载的内联脚本。别因为教程总会秀一个接口,就自己发明一个。Oxylabs、BrowserStack、ScraperAPI 都演示拦截。它们没告诉你,站点根本不发请求时会怎样。
怎么校验字段、重复与条数?
脚本以 0 退出,不代表抓取完成。文件有预期条数、每个必填字段都在、唯一键没把两行并成一行,才算完成。
这个演示通过的提取会写出十行、文本不重复、没有缺作者。卡片还不存在就提取,会写出 0 行;若不检查条数,同一个开心 logger 还是会说没事。
function validate(rows, expectedCount) {
  const missing = rows.filter((row) => !row.text || !row.author);
  const unique = new Set(rows.map((row) => row.text));
  if (rows.length !== expectedCount) {
    throw new Error(`expected ${expectedCount}, got ${rows.length}`);
  }
  if (missing.length) {
    throw new Error(`${missing.length} rows missing text or author`);
  }
  if (unique.size !== rows.length) {
    throw new Error("duplicate texts");
  }
}
用一份短清单,失败就明确报错。
| 检查 | 通过 | 要保留的失败模式 |
|---|---|---|
| 预期条数 | waitForSelector('.quote') 之后十张卡片 | 绘制代码还没动手前提取,就是 0 行 |
| 必填字段 | 每一行都有 text 和 author | 对到卡片、却漏掉 .author 的选择器 |
| 唯一键 | 不重复的名言文本,不是不重复的作者 | 用作者去重,会把 Einstein 并掉 |
空提取要留着。0 行结果就是等待很重要的证据。删掉它,后来那次完整提取看起来会像默认值。
Playwright 抓取会栽在哪里?
这里真正要紧的失败是空渲染、过期选择器,以及频率限制。若你只在吞掉错误的 catch 之后打印行数,它们都不会变成红色 stack trace。
空渲染:导航成功,选择器从未对上,你存了 []。去修等待。别对同一个还没完成的 DOM 重跑同一段提取。
过期选择器:.quote 还在,文本却搬走了。这次运行返回昨天的 10 行。等待会随内容变动的字段,再拿唯一键和上一份文件做 diff。
频率限制:429 是停的信号。有 Retry-After 就读它,退避,并给重试设上限。猛打同一个 URL,IP 就会被挡。本指南不谈绕过。
async function gotoWithRetry(page, url, attempt = 0) {
  const response = await page.goto(url, { waitUntil: "domcontentloaded" });
  const status = response?.status() ?? 0;
  if (status === 429 || status >= 500) {
    if (attempt >= 3) throw new Error(`giving up on ${url}: ${status}`);
    const retryAfter = Number(response?.headers()["retry-after"]);
    const waitMs = Number.isFinite(retryAfter)
      ? retryAfter * 1000
      : 2 ** attempt * 1000;
    await page.waitForTimeout(waitMs);
    return gotoWithRetry(page, url, attempt + 1);
  }
  if (status && status >= 400) throw new Error(`${status} for ${url}`);
  return response;
}什么时候改用看得见的浏览器 Agent 更好?
等待不对、选择器搬走,或必须有人看着页面接管时,看得见的浏览器 Agent 更合适。它不是你已在 CI 信任的那段冻结 Playwright 循环的替代品。
这是互补,不是对手。Playwright 把已经搞清楚的等待写进脚本。ego (lite) 0.5.0.32 把任务放在可监视的 Chromium Space,卡片出现时看得见,Agent 可以停,等待在撒谎时也可以由人接管。下一次抓取需要已有登录态时,它复用真实配置文件。它不会让静态 HTML 页变更便宜,也不会绕过封禁。该版本的更新日志日期是 2026-09-12,见 ego (lite) 更新日志。
我们从 OpenCode 在 ego (lite) 测过这层隔离。Spaces 总览把名言抓取放在自己正在跑的 Space,其他工作在另一个 Space,而不是共用同一个 headed Chromium 窗口。
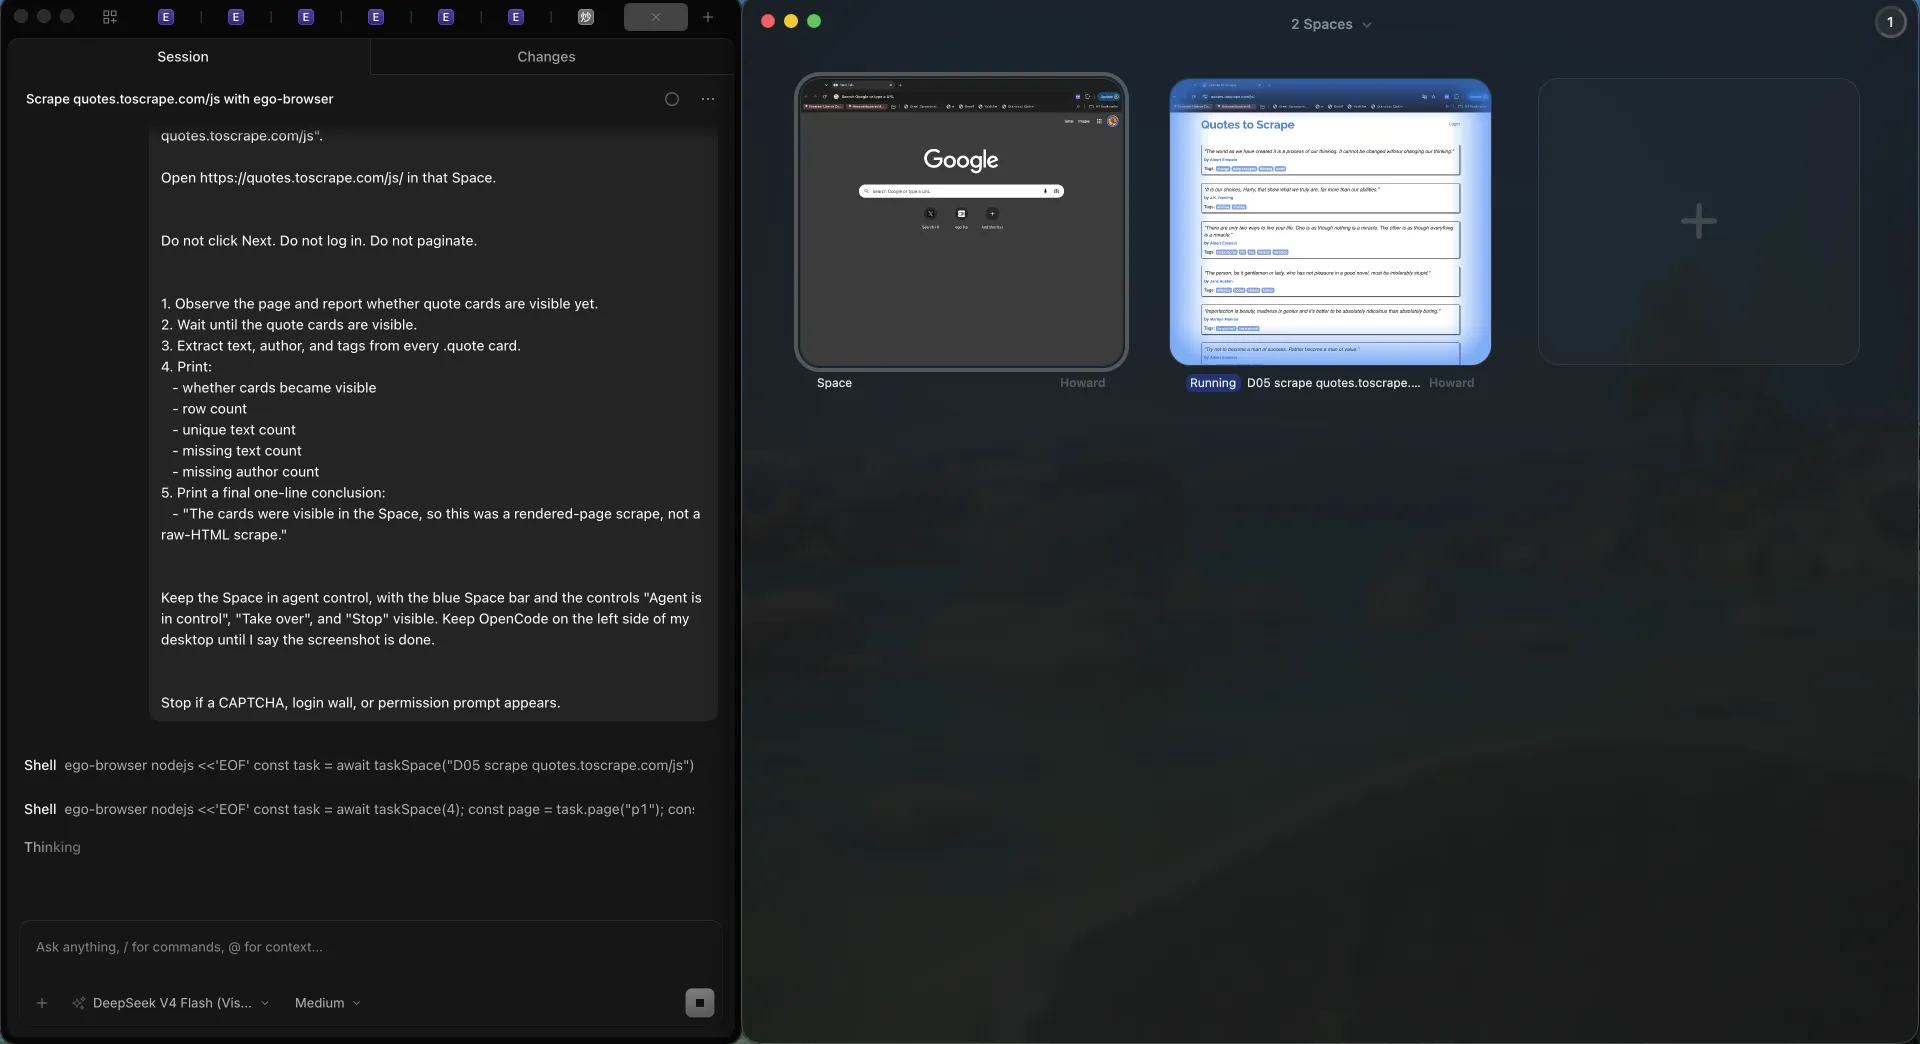
我们在其中一个 Space 里测过同一个公开 URL。Space 4 在 quotes.toscrape.com/js 维持 agent control,Take over 和 Stop 看得见,并印出 10 张不重复卡片。
无头和 headed 的取舍见 面向 AI Agent 的无头浏览器与真实浏览器对比。库怎么选见 用 Playwright 还是 Puppeteer 抓取。产品层面对比见 ego (lite) 与 Playwright 对比。
挑战和限制有哪些?
Playwright 抓取的失败比 HTTP 更安静,因为浏览器看起来正常,文件却是错的。
第一个限制是成本。一个 Chromium context 不是一次 GET。卡片已经在 HTML 里时,你是在为不需要的浏览器付钱。
第二是对拦截要诚实。教程把拦截 XHR 当成进阶招。这个演示里,进阶的是承认 payload 就在内联脚本里。
第三是多页,这里只留一行限制。单个渲染页校验通过后,编号页、Load More 和无限滚动才是另一份工作。把那些循环混进这页的等待和提取,会把空 DOM 失败藏起来。
第四是权限。robots 规则、条款和个人数据法仍然适用。headed 浏览器不会因此取得收集权。
抓取是空的、页面却看起来满的,就先等待卡片,再数行。headed 窗口不是证据。这个演示的拦截也没找到 JSON XHR;名言本来就以 var data 写在内联脚本里。
常见问题
Playwright 适合抓网页吗?
可见卡片不在原始 HTML、爬虫又能在真实浏览器里等待时,Playwright 适合抓。quotes.toscrape.com/js 是公开例子:GET 返回没有 .quote 节点,等待 .quote 就能读到画好的卡片。静态 HTML 或已有文档的 API,不该默认走这条。
什么时候该用 HTTP,而不是 Playwright?
值已经在响应正文里时,用 HTTP。这个 JavaScript 演示仍有带着名言的 var data,即使没有 .quote 卡片。若解析那段 payload 够稳,就别开浏览器。
为什么 Playwright 抓下来是 0 行?
0 行通常代表卡片还没出现就提取了。这个演示在 commit、绘制代码还没动手前读 DOM,会拿到 0 条名言;等 waitForSelector('.quote') 之后才是渲染后的卡片。空结果时没有异常。
该不该等待 networkidle?
等待代表数据的选择器,不要等网络安静。networkidle 可能卡在分析 beacon。这个演示通过的等待是 .quote,不是 networkidle。
怎么用 Playwright 拦截 JSON?
听 content-type 含 json 的响应,或 route 页面本来就会调用的 URL。quotes.toscrape.com/js 的名言在内联脚本里,没有 JSON XHR 可抓。拦截是可选的。DOM 等待仍然有效。
单页抓完后,多页列表怎么办?
先完成单个渲染页:等待、提取、核对条数。编号页、Load More 和无限滚动是另一份工作。这页不写那些循环。
Playwright 抓取要怎么复用登录态?
在你有权使用的登录之后存 storage state,之后的 context 再加载。把文件当密钥,并预期它会过期。
遇到 429 该怎么办?
停。有 Retry-After 就遵守,退避,并在很小的重试上限后失败。429 是频率信号,不是选择器问题。
用 Playwright 抓网页一定要装 ego (lite) 吗?
不必。等待和选择器已经确定时,用 Playwright。抓取需要可监视的 Space、真实已登录配置文件,或人工接管时,用 ego (lite)。2026-09-18 两条路都从 quotes.toscrape.com/js 提取到 10 张不重复卡片;Space 仍看得见 Take over 和 Stop。
用真实浏览器抓取合法吗?
取决于站点、数据、司法辖区,以及你拿文件做什么。headed 浏览器里,robots 规则和条款仍然适用。这不是法律建议。
抓网页该用 Playwright 还是 Puppeteer?
两者都能渲染同一页。库的差异在 locator、等待和语言绑定。这页的 HTTP 对浏览器决策要先做。
若下一次抓取需要可监视的浏览器,而不是再写一段等待,ego (lite) 可以免费下载。价格抓取 演示就是那个 Space 里的一份具体工作。
