
Una página renderizada con JavaScript puede responder bien y dejar tu scraper con cero filas. El HTML ya cargó, pero las tarjetas que ve alguien en el navegador quizá aún no existan en el DOM. Con ego (lite) ese desfase se ve. La tarea corre dentro de un Space de Chromium a la vista, así que distingues si la página sigue pintando, si el selector no coincide o si los datos que buscas no aparecieron nunca.
Playwright convierte ese comportamiento ya comprobado en un flujo de scraping estable y repetible. Puede esperar a que se pinten las tarjetas, extraer campos del DOM en vivo y comprobar que el resultado trae lo que esperabas. Cuando el selector y la condición de espera ya se conocen, Playwright es la forma natural de dejarlos en un script fiable. Si la tarea sigue pidiendo inspección visual, una sesión con login ya abierta o que una persona tome el control en un paso concreto, ego (lite) deja el estado del navegador visible e interactivo, para que un script que sale con éxito no oculte que en realidad no raspó nada.
¿Qué es el web scraping con Playwright?
Hacer web scraping con Playwright es conducir un navegador de verdad para que JavaScript pinte la página y luego leer los nodos renderizados. El navegador es el scraper. La respuesta HTML es solo el cascarón hasta que corren los scripts.
Playwright lanza Chromium, Firefox o WebKit, abre un contexto y te da page.goto, esperas, locators y page.evaluate. Esas APIs nacieron para tests. También sirven para extraer, porque ambos trabajos piden lo mismo: un DOM igual al que ve una persona.
Los trabajos colindantes quedan fuera de esta página.
La elección entre fetch y un navegador en JavaScript se trata en web scraping con JavaScript. Cómo reutilizar una sesión con login entre ejecuciones se trata en sesiones persistentes de navegador. Los muros de login de X y LinkedIn se tratan en scraping con IA detrás de muros de login. Las páginas numeradas, Load More y el scroll infinito esperan a que esta página suelta ya devuelva las filas correctas.
¿Cuándo conviene scrapear con Playwright y no por HTTP?
Usa Playwright cuando un GET a la URL no trae los nodos que quieres extraer. Usa HTTP cuando los valores ya están en el cuerpo de la respuesta, o cuando la página ya expone un endpoint JSON documentado.
quotes.toscrape.com/js está hecha así a propósito. Un GET a la URL devuelve HTML sin nodos class="quote". Las citas viven en un array inline var data y luego jQuery pinta las tarjetas. Un parser CSS apuntado a .quote sobre la respuesta cruda no guarda nada y parece un error de selector.
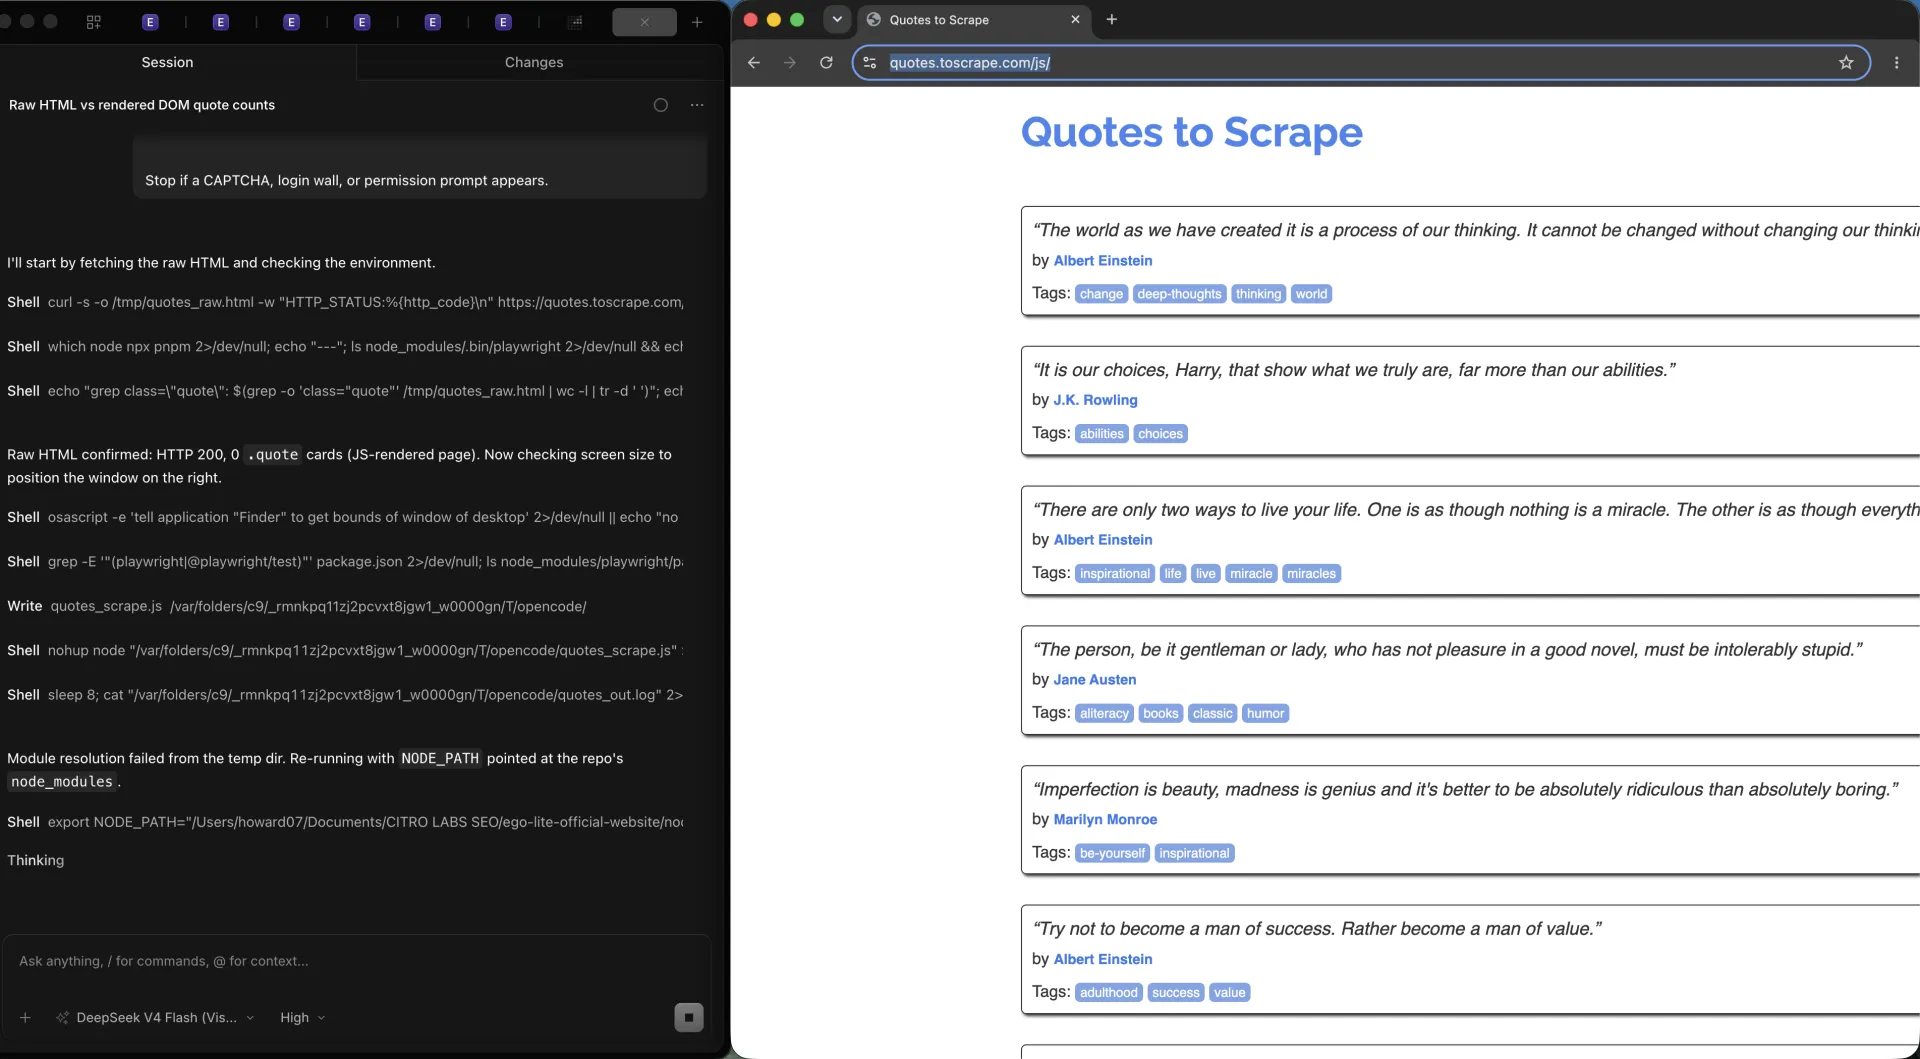
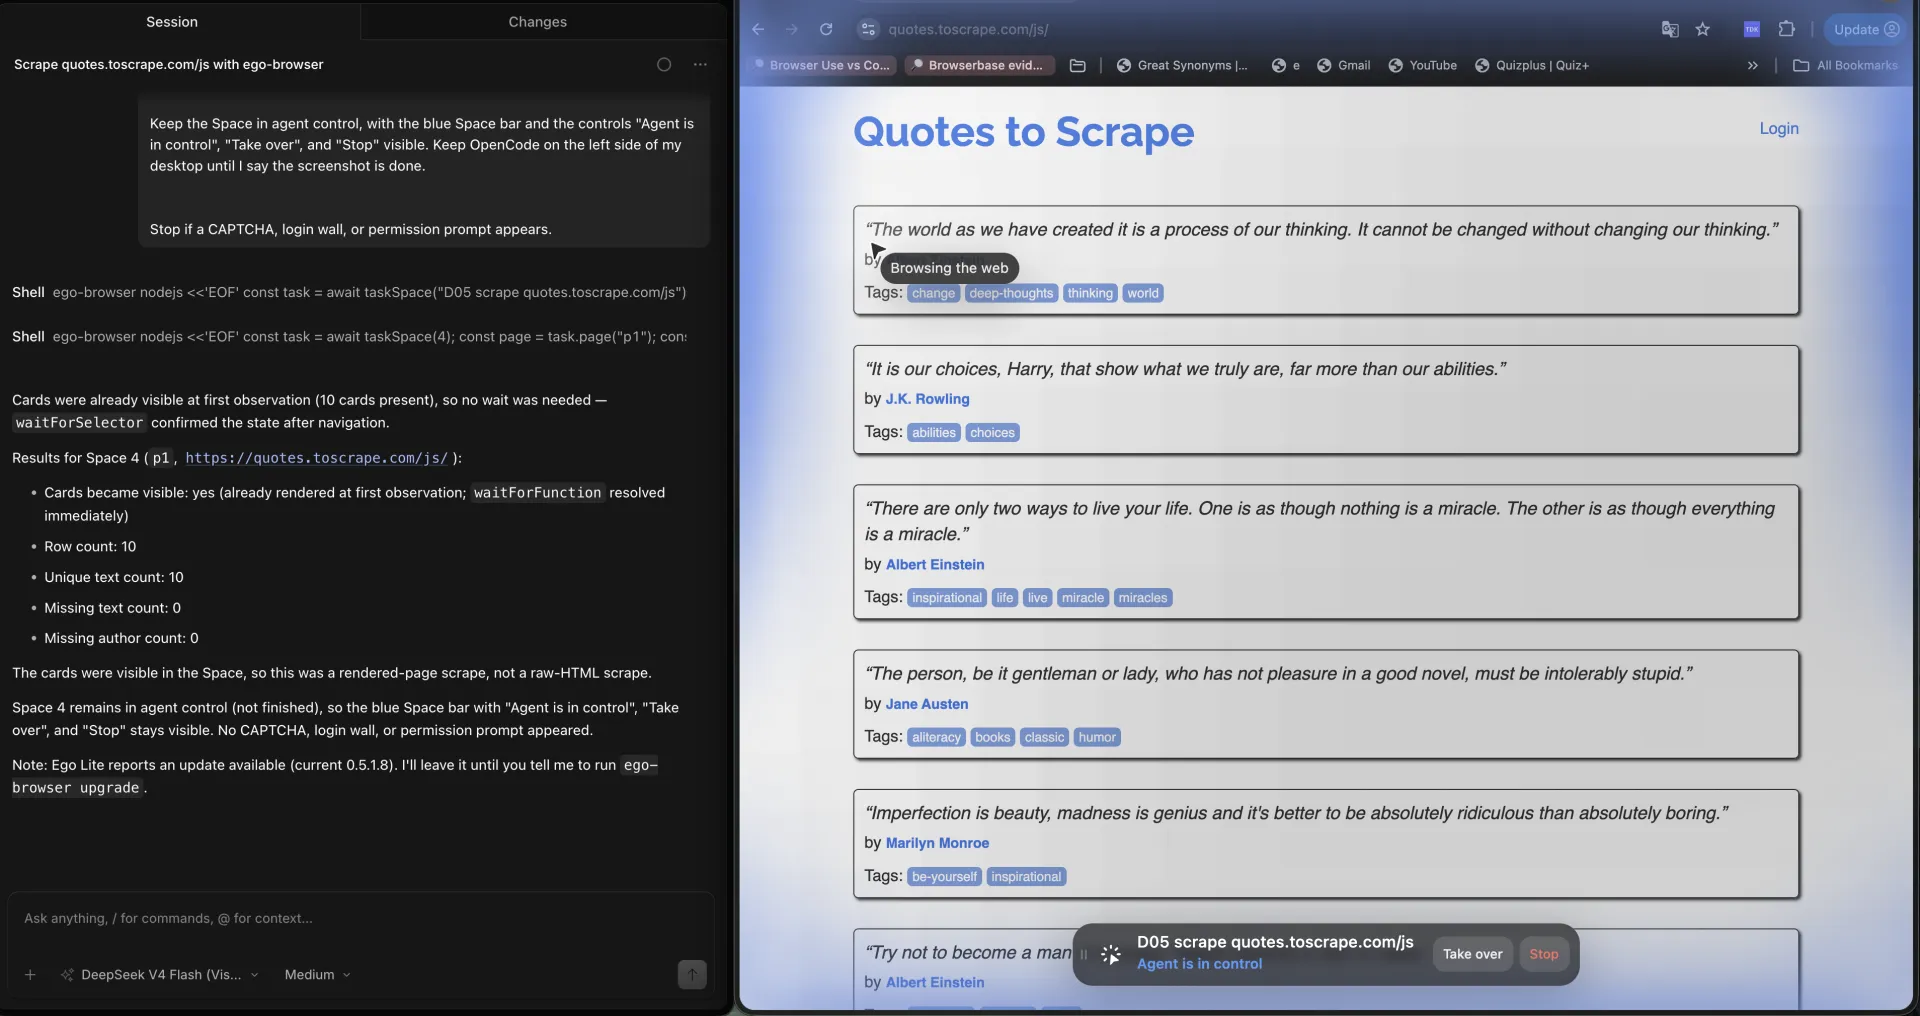
Comprobamos esa separación el 2026-09-18 desde OpenCode. Un GET a quotes.toscrape.com/js devolvió HTTP 200 y 0 tarjetas .quote en el HTML crudo, mientras la ventana de Chromium headed a la derecha ya mostraba la lista pintada.
Mira la separación así.
| Ruta | Lo que puede hacer | Lo que no puede hacer |
|---|---|---|
| HTTP GET + parser de HTML | Leer los bytes que envió el servidor. Barato, rápido y suficiente cuando las tarjetas ya están en el marcado. | Ejecutar los scripts de la página o esperar nodos que aparecen después. Contra quotes.toscrape.com/js no ve tarjetas .quote en el HTML crudo. |
| Parsear el payload inline | En quotes.toscrape.com/js, una regex más JSON.parse de var data recupera las citas del mismo HTML, sin navegador. | Sobrevivir a un rediseño que deje de incrustar el array. Los payloads internos no son un contrato de API. |
| DOM renderizado con Playwright | Ejecutar el JavaScript de la página, esperar .quote y extraer las tarjetas que ve una persona. | Seguir siendo barato. Cada contexto cuesta memoria, y una flota de ellos es la herramienta equivocada para HTML estático. |
El extra honesto de esta demo: Playwright no hace falta si parseas var data a pelo. La mayoría de sitios JS no dejan un array con nombre en la primera respuesta. Playwright es la ruta que sigue funcionando cuando no lo hacen.
¿Cómo se lanza, navega y espera el contenido?
El scrape mínimo con Playwright es launch, contexto nuevo, goto, esperar el selector de la tarjeta, extraer y cerrar. Saltar la espera es cómo obtienes un archivo vacío que parece un éxito.
En Playwright, page.goto puede detenerse en commit, domcontentloaded, load o networkidle. waitForSelector es la comprobación de que existe de verdad aquello por lo que viniste. En quotes.toscrape.com/js, goto({ waitUntil: 'domcontentloaded' }) ya puede bastar porque el script inline corre en ese HTML. Eso es suerte, no una regla.
import { chromium } from "playwright";

const browser = await chromium.launch();
const context = await browser.newContext();
const page = await context.newPage();

try {
  await page.goto("https://quotes.toscrape.com/js/", {
    waitUntil: "domcontentloaded",
  });
  await page.waitForSelector(".quote");
  const rows = await page.evaluate(() =>
    [...document.querySelectorAll(".quote")].map((el) => ({
      text: el.querySelector(".text")?.textContent?.trim() ?? "",
      author: el.querySelector(".author")?.textContent?.trim() ?? "",
      tags: [...el.querySelectorAll(".tag")].map((tag) =>
        tag.textContent?.trim(),
      ),
    })),
  );
  console.log(rows.length);
} finally {
  await context.close();
  await browser.close();
}
Para ver el scrape vacío, extrae en commit antes de que existan las tarjetas, o retrasa el script que las pinta. Esa extracción temprana devuelve 0 filas. Tras waitForSelector('.quote'), la misma página devuelve las tarjetas renderizadas. En el caso vacío no se lanza nada.
| Espera | Qué demuestra | Cómo falla |
|---|---|---|
| solo commit | La navegación empezó. Sirve como prueba negativa. | Los scripts quizá no hayan corrido. Una extracción en commit, antes de que pinte el pintor, devuelve 0 citas. |
| domcontentloaded | El HTML inicial ya está parseado. En esta fixture basta porque var data corre en ese HTML. | Las tarjetas de un XHR tardío aún pueden faltar. No lo trates como 'el contenido está listo'. |
| waitForSelector('.quote') | Hay al menos una tarjeta en el DOM. Esa es la espera que convierte esta demo en filas extraíbles. | Una clase vieja puede coincidir con la lista anterior. Espera un campo que cambie con los datos, no un envoltorio que nunca se va. |
Cierra el contexto en finally. Los contextos retienen la memoria. Un scrape que falla a mitad de la extracción igual tiene que soltar Chromium.
¿Cómo se extraen campos de una página renderizada?
Extrae dentro de la página con page.evaluate, o con locators cuando necesitas un control y no una lista. Ambos leen el DOM renderizado. Ninguno lee la instantánea HTML original de goto.
Mapea cada .quote a text, author y tags. La demo pública pinta diez tarjetas. Los campos obligatorios son text y author. La clave única es el texto de la cita, no el autor, porque Einstein aparece más de una vez.
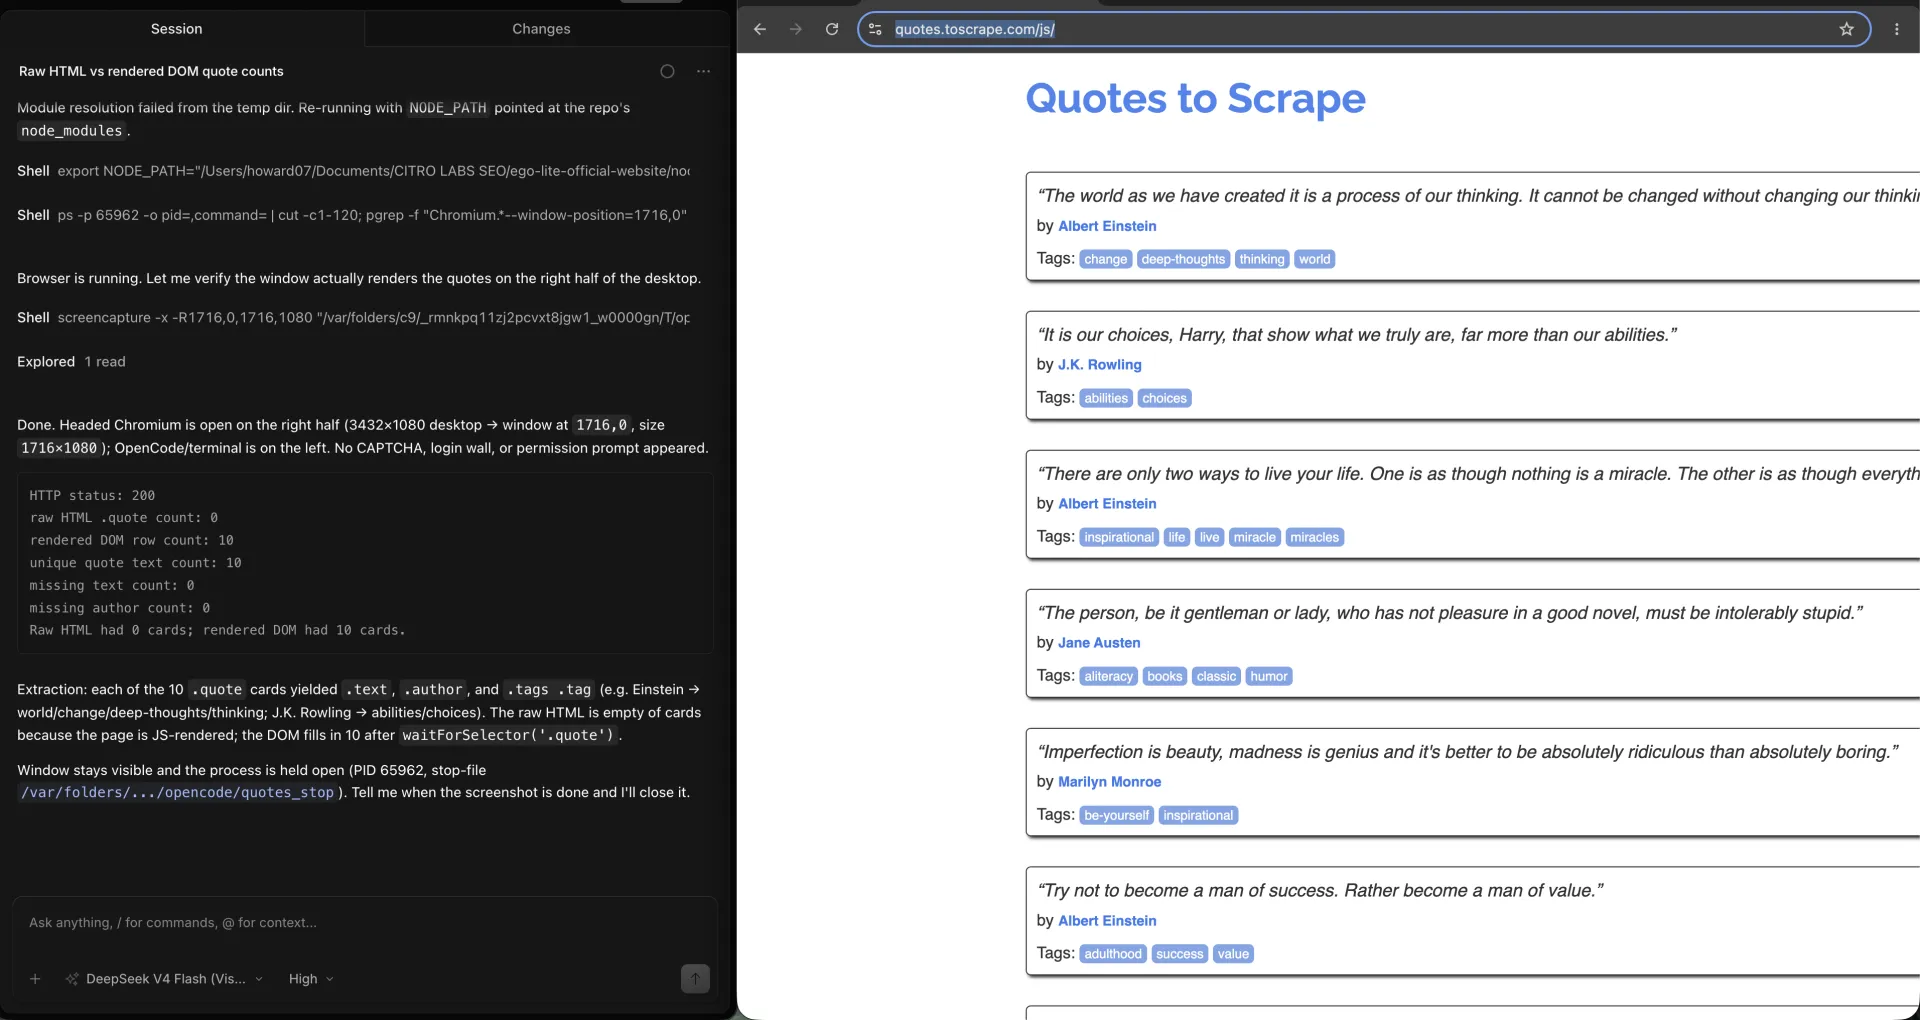
Comprobamos esa extracción en la misma sesión de OpenCode. Tras waitForSelector('.quote'), la ejecución headed imprimió 10 filas, 10 textos únicos y 0 autores faltantes. El HTML crudo seguía con 0 tarjetas.
Los locators son el camino más limpio para un solo campo. Los locators de Playwright vuelven a consultar antes de cada acción, y por eso sobreviven a un re-render que rompe un element handle guardado.
const title = await page.locator(".quote .text").first().innerText();
const author = await page.locator(".quote .author").first().innerText();
page.evaluate encaja mejor para extraer listas. Se ejecuta en la página y devuelve JSON. Deja el mapper pequeño. Saca text, author, tags y una clave única. Deja las capturas y los PDF fuera del bucle de scrape.
El texto oculto con CSS sigue en el DOM. innerText sigue el layout. textContent no. Si un sitio recorta un título con CSS, textContent igual te da la cadena completa. Decide cuál estás recogiendo antes de escribir el validador.
¿Cómo se interceptan los datos que ya pide la página?
Interceptar sirve cuando la página ya pide JSON que se puede guardar en vez de parsearlo de las tarjetas. En quotes.toscrape.com/js esa petición no se dispara nunca, y ese es el punto.
Las citas de esa demo no vienen de una API. Van incrustadas como var data en el HTML y jQuery las pinta en nodos .quote. Un listener de response que busque JSON no verá nada útil.
En Playwright, las docs de red muestran page.route y los listeners de response. Úsalos. Luego anota lo que la página envió de verdad, aunque no envíe nada.
const jsonResponses = [];
page.on("response", async (response) => {
  const type = response.headers()["content-type"] || "";
  if (type.includes("json")) {
    jsonResponses.push({
      url: response.url(),
      status: response.status(),
    });
  }
});
await page.goto(url, { waitUntil: "domcontentloaded" });
await page.waitForSelector(".quote");
console.log(jsonResponses.length);
Cuando no hay cuerpo JSON, vuelve a las tarjetas renderizadas o parsea el script inline que ya descargaste. No inventes un endpoint porque los tutoriales siempre muestran uno. Oxylabs, BrowserStack y ScraperAPI demuestran intercept. No te dicen qué pasa cuando el sitio nunca dispara la petición.
¿Cómo se validan campos, duplicados y recuentos?
Un scrape no termina cuando el script sale con 0. Termina cuando el archivo tiene el recuento esperado, cada campo obligatorio está presente y la clave única no aplasta dos filas en una.
Una extracción correcta en esta demo escribe diez filas con textos únicos y sin autores faltantes. Una extracción antes de que existan las tarjetas escribe 0 filas con el mismo logger feliz, salvo que compruebes el recuento.
function validate(rows, expectedCount) {
  const missing = rows.filter((row) => !row.text || !row.author);
  const unique = new Set(rows.map((row) => row.text));
  if (rows.length !== expectedCount) {
    throw new Error(`expected ${expectedCount}, got ${rows.length}`);
  }
  if (missing.length) {
    throw new Error(`${missing.length} rows missing text or author`);
  }
  if (unique.size !== rows.length) {
    throw new Error("duplicate texts");
  }
}
Usa una lista corta y falla en voz alta.
| Comprobación | Pasa | Modo de fallo a conservar |
|---|---|---|
| Recuento esperado | Diez tarjetas tras waitForSelector('.quote') | 0 filas si la extracción corre antes de que pinte el pintor |
| Campos obligatorios | text y author en cada fila | Un selector que coincide con la tarjeta pero se pierde .author |
| Clave única | Textos de cita únicos, no autores únicos | Deduplicar por autor, lo que aplastaría a Einstein |
Conserva la extracción vacía. El resultado de 0 filas es la prueba de que la espera importa. Borrarlo hace que una extracción completa posterior parezca el valor por defecto.
¿Qué rompe un scrape con Playwright?
Los fallos que importan aquí son renders vacíos, selectores viejos y límites de frecuencia. Ninguno se ve como un stack trace rojo si solo registras la longitud de filas después de un catch que se traga los errores.
Render vacío: la navegación tuvo éxito, el selector no coincidió nunca y guardaste []. Arregla la espera. No reintentes la misma extracción contra el mismo DOM a medias.
Selector viejo: .quote sigue existiendo, pero el texto se movió. La ejecución devuelve 10 filas de ayer. Espera un campo que cambie con el contenido y luego compara las claves únicas con el archivo anterior.
Límite de frecuencia: un 429 es una señal de alto. Lee Retry-After cuando venga, retrocede y pon tope a los reintentos. Machacar la misma URL es cómo una IP acaba bloqueada, y esta guía no cubre eludir eso.
async function gotoWithRetry(page, url, attempt = 0) {
  const response = await page.goto(url, { waitUntil: "domcontentloaded" });
  const status = response?.status() ?? 0;
  if (status === 429 || status >= 500) {
    if (attempt >= 3) throw new Error(`giving up on ${url}: ${status}`);
    const retryAfter = Number(response?.headers()["retry-after"]);
    const waitMs = Number.isFinite(retryAfter)
      ? retryAfter * 1000
      : 2 ** attempt * 1000;
    await page.waitForTimeout(waitMs);
    return gotoWithRetry(page, url, attempt + 1);
  }
  if (status && status >= 400) throw new Error(`${status} for ${url}`);
  return response;
}¿Cuándo encaja mejor un agente de navegador visible?
Un agente de navegador visible encaja mejor cuando la espera está mal, el selector se movió o una persona tiene que mirar la página y tomar el control. No sustituye un bucle de Playwright ya cerrado en el que confías en CI.
Eso es el complemento, no el competidor. Playwright deja escrita la espera que ya se entiende. ego (lite) 0.5.0.32 mantiene la tarea en un Space de Chromium a la vista para que se vean las tarjetas según aparecen, se pueda detener al agente o una persona tome el control cuando la espera miente. Reutiliza un perfil real cuando el siguiente scrape necesita un login que ya existe. No abarata una página HTML estática y no esquiva un bloqueo. El changelog de esa versión está fechado el 2026-09-12 en el changelog de ego (lite).
Comprobamos ese aislamiento en ego (lite) desde OpenCode. La vista de Spaces dejó el scrape de citas en su propio Space en marcha, con el resto del trabajo en otro Space en vez de compartir una sola ventana de Chromium headed.
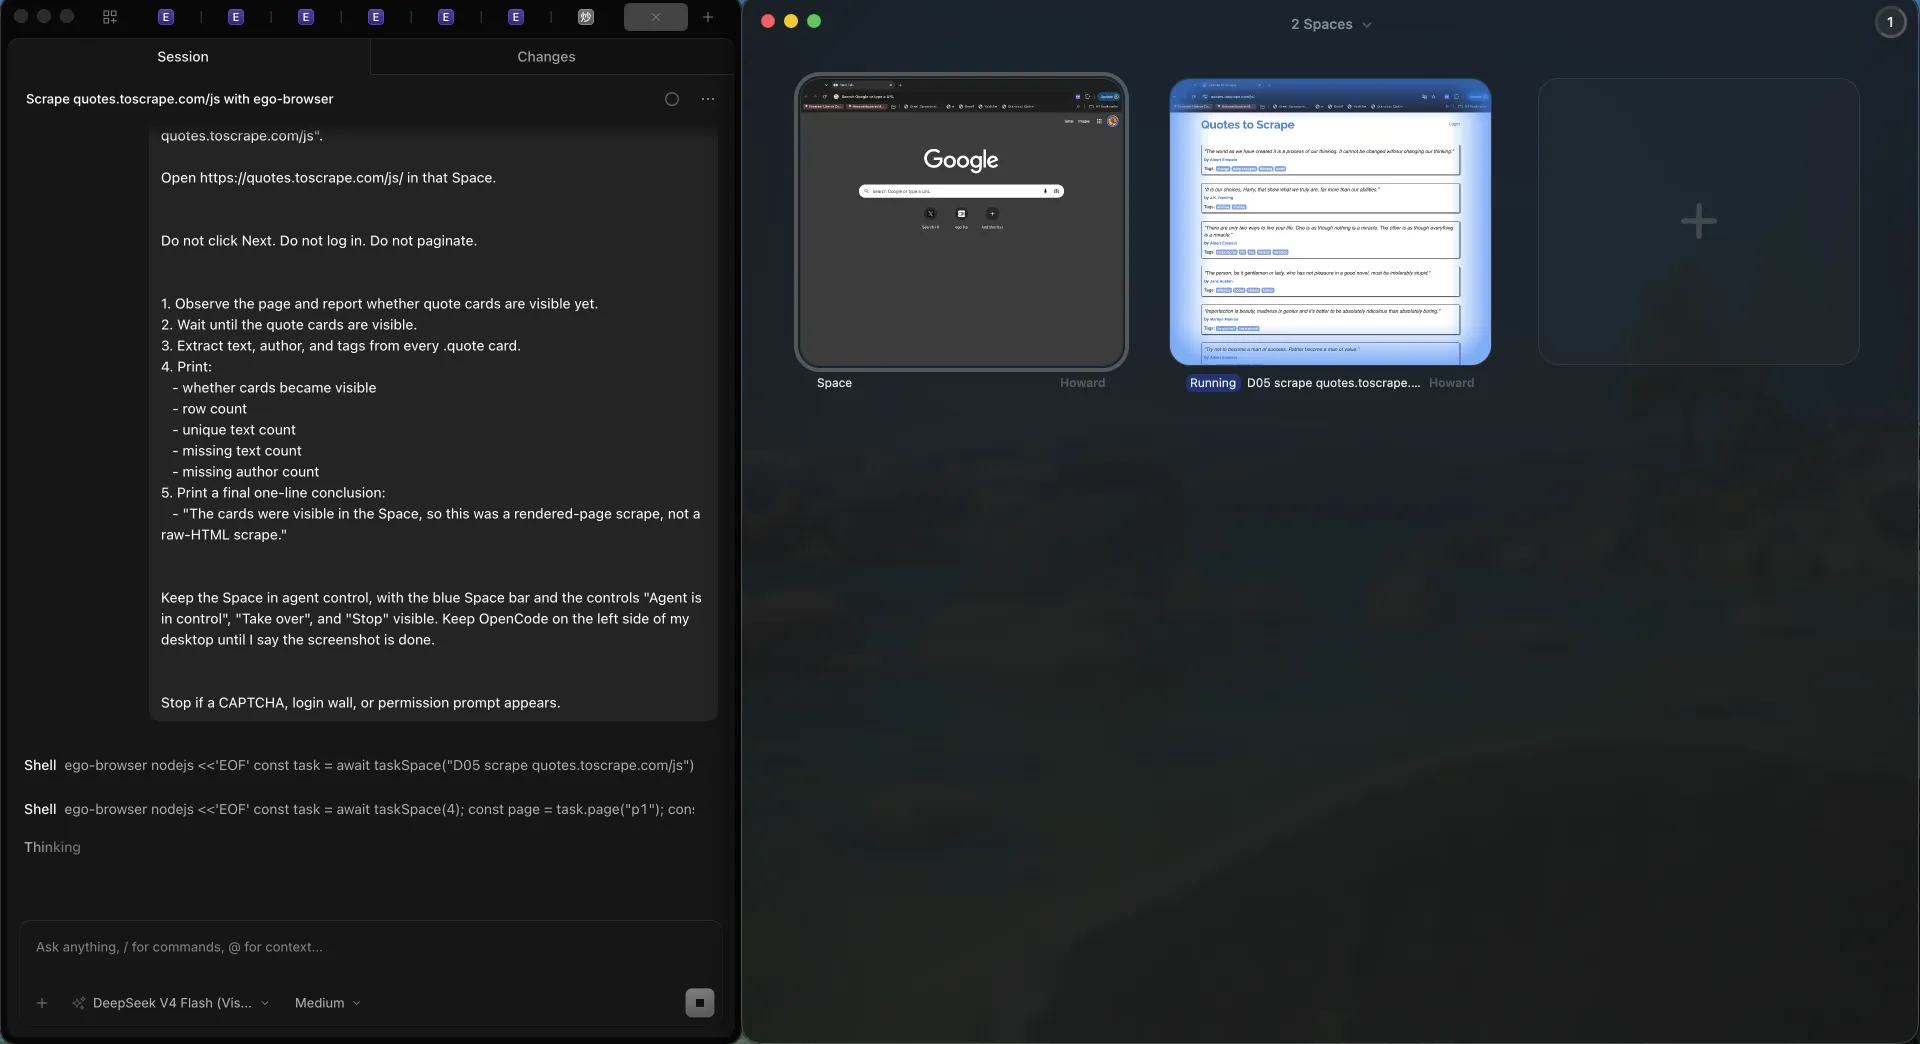
Comprobamos la misma URL pública dentro de uno de esos Spaces. El Space 4 se quedó en control del agente en quotes.toscrape.com/js, con Take over y Stop visibles, e imprimió 10 tarjetas únicas.
Los intercambios entre headless y headed se tratan en navegador sin interfaz vs. navegador real para agentes de IA. La elección de biblioteca se trata en Playwright vs Puppeteer para scraping. El contraste a nivel de producto está en ego (lite) vs Playwright.
¿Cuáles son los desafíos y los límites?
El scraping con Playwright falla de formas más silenciosas que el scraping por HTTP, porque el navegador puede verse bien mientras el archivo está mal.
El primer límite es el coste. Un contexto de Chromium no es un GET. Si las tarjetas ya están en el HTML, estás pagando un navegador que no necesitas.
El segundo es ser honesto con intercept. Los tutoriales tratan capturar XHR como el paso avanzado. En esta demo el paso avanzado es admitir que el payload va inline.
El tercero son las páginas siguientes, y aquí se queda en un límite de una línea. Cuando una página renderizada ya valida, las páginas numeradas, Load More y el scroll infinito pasan a ser otro trabajo. Meter esos bucles en esta página de esperar y extraer ocultaría el fallo del DOM vacío.
El cuarto es el permiso. Las reglas de robots, los términos y la ley de datos personales siguen aplicando. Un navegador headed no crea un derecho a recopilar.
Si el scrape está vacío y la página se ve llena, espera la tarjeta y luego cuenta filas. Una ventana headed no es prueba. En esta fixture, intercept tampoco encontró XHR JSON; las citas ya iban inline como var data.
Preguntas frecuentes
¿Playwright sirve para web scraping?
Playwright sirve para scrapear cuando las tarjetas visibles no están en el HTML crudo y el scraper puede esperarlas en un navegador real. quotes.toscrape.com/js es el ejemplo público: un GET no devuelve nodos .quote, y una espera a .quote lee las tarjetas pintadas. Es el default equivocado para HTML estático o una API documentada.
¿Cuándo usar HTTP en vez de Playwright?
Usa HTTP cuando los valores ya están en el cuerpo de la respuesta. La demo de JavaScript sigue trayendo var data con las citas, aunque no traiga tarjetas .quote. Si un parser de ese payload es estable, sáltate el navegador.
¿Por qué mi scrape con Playwright devolvió cero filas?
Cero filas suele significar que la extracción corrió antes de que existieran las tarjetas. Leer el DOM en commit, antes de que pinte el pintor, devuelve 0 citas en esta demo, y las tarjetas renderizadas tras waitForSelector('.quote'), sin excepción en el caso vacío.
¿Hay que esperar a networkidle?
Espera el selector que representa los datos, no una red en silencio. networkidle puede colgarse con beacons de analítica. La espera que pasa en esta demo es .quote, no networkidle.
¿Cómo interceptar JSON con Playwright?
Escucha respuestas cuyo content-type incluya json, o enruta la URL que la página ya llama. En quotes.toscrape.com/js las citas van inline, así que no hay XHR JSON que capturar. Intercept es opcional. La espera del DOM sigue funcionando.
¿Cómo scrapear listados con varias páginas en Playwright?
Primero termina una sola página renderizada: espera, extrae, valida el recuento. Las páginas numeradas, Load More y el scroll infinito son otro trabajo. Esta página no implementa esos bucles.
¿Cómo reutilizar un login en un scrape con Playwright?
Guarda storage state después de un login que tienes permitido usar y cárgalo en un contexto posterior. Trata el archivo como un secreto y cuenta con que caducará.
¿Qué hago con un 429?
Para, respeta Retry-After cuando venga, retrocede y falla tras un tope pequeño de reintentos. Un 429 es una señal de frecuencia, no un problema de selector.
¿Necesito ego (lite) para scraping con Playwright?
No. Usa Playwright cuando la espera y el selector ya se conocen. Usa ego (lite) cuando el scrape necesita un Space vigilado, un perfil real con sesión o que una persona tome el control. El 2026-09-18 ambas rutas extrajeron 10 tarjetas únicas de quotes.toscrape.com/js; el Space dejó Take over y Stop visibles.
¿Es legal scrapear con un navegador real?
Depende del sitio, de los datos, de la jurisdicción y de lo que hagas con el archivo. Las reglas de robots y los términos siguen aplicando en un navegador headed. Esto no es asesoramiento legal.
¿Playwright o Puppeteer para scraping?
Ambos pueden renderizar la misma página. La elección de biblioteca son locators, esperas y language bindings. La decisión HTTP frente a navegador de esta página va primero.
Si el siguiente scrape necesita un navegador a la vista en vez de otra espera ya programada, ego (lite) es gratis para descargar. El scraper de precios recorre un trabajo concreto en ese Space.
