Paginer en web scraping, ce n’est pas seulement atteindre la page suivante. Le plus dur est de savoir s’il reste encore des données à collecter et quand la liste est vraiment terminée. La plupart des sites utilisent l’un des trois schémas, pages numérotées, Load More ou scroll infini, et chacun exige une stratégie de navigation, une condition d’attente et une règle d’arrêt différentes. Si vous vous trompez, un crawler peut s’arrêter trop tôt sans jamais lever d’erreur.
Si les données sont déjà dans le HTML ou sur un point d’accès JSON, vous n’avez en général pas besoin de navigateur ; le HTTP simple est plus simple et plus rapide. Un navigateur devient utile lorsque la liste dépend d’un rendu côté client, d’une session authentifiée, de jetons générés dans la page ou d’un vrai défilement. Et lorsque ces données dépendent d’un navigateur dans lequel vous êtes déjà connecté, ego (lite) permet à un agent IA d’exécuter la même logique de pagination dans cette session existante, au lieu de reconstruire l’état de connexion.
Dans les sections suivantes, nous testons les pages numérotées, Load More et le scroll infini avec une seule question : la liste s’est-elle vraiment terminée, ou le crawler a-t-il simplement cessé de demander la suite ? Les exemples s’appuient sur un fixture local reproductible avec 135 lignes sur des pages numérotées, 81 lignes rendues derrière Load More et un fil infini de 60 éléments. À la fin, le crawler ne se contentera pas de paginer : il enregistrera où il s’est arrêté, traitera les doublons et les lignes manquées, et vérifiera que les données collectées sont complètes.
Comment savoir quel mode de pagination vous avez sous les yeux
Trois observations tranchent la classification. Changer l’URL ou cliquer un lien numéroté modifie l’ensemble de résultats : c’est de la pagination numérotée. Un bouton dont le libellé promet davantage de contenu ajoute des lignes sans changer l’URL : c’est load more. Des lignes qui apparaissent au défilement, sans contrôle à cliquer, c’est du scroll infini. Quand une page mélange les schémas, traitez chaque transition comme un mode à part, au lieu de forcer une seule boucle à tout couvrir.
Un contrôle rapide dans le navigateur tranche plus vite que la lecture du code : ouvrez les DevTools, observez le panneau réseau et interagissez une fois. Une requête de navigation portant un paramètre de page est de la pagination numérotée. Une requête JSON ou HTML en arrière-plan déclenchée par un clic est load more. Des requêtes qui se répètent au défilement sont du scroll infini, et la réponse contient en général le prochain offset, un cadeau pour un crawler.
Pages numérotées : dériver la règle d’URL et s’arrêter au bon moment
La pagination numérotée est le mode le plus accueillant parce que l’état vit dans l’URL. Dérivez la règle des trois premières pages : quel paramètre change, s’il s’agit d’un numéro de page ou d’un offset, et si la taille de page est fixe. La règle doit pouvoir s’exprimer comme une fonction, et une fonction correcte produit la page 4 à partir de la page 3 sans visiter quoi que ce soit entre les deux.
// Derive once, then verify against page 2 and page 3 before trusting it.
const pageUrl = (n) => `https://example.com/listings?page=${n}`;

let page = 1;
const rows = [];
while (true) {
  await browserPage.goto(pageUrl(page));
  const batch = await browserPage.locator("tr.row").evaluateAll((nodes) =>
    nodes.map((node) => ({
      id: node.dataset.id,
      title: node.querySelector(".title").textContent.trim(),
      price: Number(node.querySelector(".price").textContent.replace(/[^0-9.]/g, "")),
    })),
  );
  if (batch.length === 0) break;
  rows.push(...batch);

  const hasNext = (await browserPage.locator("a#next").count()) > 0;
  if (!hasNext) break;
  page += 1;
}
L’arrêt mérite plus de soin qu’on ne lui en accorde. Un lien next manquant et un lot vide sont de vrais signaux de fin ; un total de pages figé ne l’est pas, parce que les listes grandissent et que le chiffre codé en dur aujourd’hui sera faux le mois prochain. Dans l’exécution du fixture, le crawler a parcouru les pages 1 à 5, collecté 135 lignes en 80 milliseconds, et s’est arrêté quand le lien next a disparu. L’une de ces cinq requêtes a renvoyé un 503 au premier essai, le crawler a réessayé la même page une fois, et le nouvel essai a réussi.
Deux règles gardent la boucle honnête. D’abord, marquez une pause entre les requêtes de page plutôt que de les envoyer aussi vite que possible, et respectez les conditions du site ainsi que le protocole d’exclusion robots décrit dans RFC 9309. Ensuite, traitez une page répétée comme un signal d’arrêt lorsque la liste est censée être ordonnée, parce qu’une pagination qui ignore ses propres paramètres peut sinon boucler indéfiniment.
Load more : cliquer, attendre et dédupliquer
Load more cache l’état derrière un bouton, donc le crawler doit créer la croissance lui-même : cliquer, attendre que le nombre de lignes augmente vraiment, collecter ce qui est nouveau, et répéter jusqu’à ce que le bouton disparaisse ou ne change plus rien. L’attente est l’endroit où la plupart des implémentations échouent. Une pause fixe marche par hasard sur une connexion rapide et tronque la liste en silence sur une connexion lente.
await browserPage.goto("https://example.com/listings");

while (true) {
  const button = browserPage.locator("#load-more");
  if ((await button.count()) === 0) break;

  const before = await browserPage.locator("tr.row").count();
  await button.click();
  await browserPage.waitForFunction(
    (n) => document.querySelectorAll("tr.row").length > n,
    before,
    { timeout: 10000 },
  );
}

const rows = await browserPage.locator("tr.row").evaluateAll((nodes) =>
  nodes.map((node) => ({ id: node.dataset.id, title: node.textContent.trim() })),
);
Dans l’exécution du fixture, quatre lots de vingt lignes sont arrivés en 273 milliseconds, et la liste visible contenait 81 lignes contre un jeu de 80. La ligne en trop était un doublon que le fixture plante pour modéliser une réalité fréquente : le même enregistrement arrive deux fois d’un lot à l’autre. La ligne d’état de la page elle-même lisait "Loaded 81 of 80", un bon rappel que le compteur rendu par le site n’est pas une source de validation. Dédupliquez sur un identifiant stable comme le record id de la ligne, pas sur le titre visible, et vous retirerez exactement ce doublon.
Scroll infini : déclencheurs, stabilité de hauteur et règles d’arrêt
Le scroll infini n’a ni bouton ni URL, donc le déclencheur et la condition d’arrêt doivent être déduits. Le déclencheur est en général un élément sentinelle qui entre dans le viewport, ou un seuil de position de défilement. La condition d’arrêt est l’endroit où le jugement est requis, parce que la liste n’annonce pas la fin d’une manière que l’on puisse cliquer.
Un échec mesuré mérite d’être montré, parce que c’est l’échec avec lequel la plupart des crawlers sont livrés. Défiler une fois jusqu’en bas et vérifier si le nombre de lignes a grandi, sans attendre le rendu du lot suivant, signale "no growth" tout de suite : le fixture s’est arrêté à 15 of 60 lignes, un lot plus loin, alors que le réseau avait déjà été interrogé pour le lot suivant. Le contrôle n’avait pas tort sur l’instant ; il avait tort de traiter un moment calme comme la fin de la liste.
La version fiable attend une condition observable, puis confirme la fin sur plusieurs contrôles plutôt qu’un seul. Défilez, attendez que le nombre d’éléments grandisse ou que la page déclare la fin du fil, et seulement lorsque ni l’un ni l’autre n’arrive pendant trois contrôles consécutifs, traitez la liste comme terminée. Dans le fixture, les mêmes 60 éléments se sont achevés en quatre tours de défilement sans faux arrêts, et la dernière ligne d’état lisait "End of feed (60 of 60)".
let stableChecks = 0;
while (stableChecks < 3) {
  const items = await browserPage.locator("article.post").count();
  await browserPage.evaluate(() => window.scrollTo(0, document.body.scrollHeight));

  const grew = await browserPage
    .waitForFunction(
      (n) =>
        document.querySelectorAll("article.post").length > n ||
        /end of feed/i.test(document.body.innerText),
      items,
      { timeout: 3000 },
    )
    .then(() => true)
    .catch(() => false);

  stableChecks = grew ? 0 : stableChecks + 1;
  if (!grew) await browserPage.waitForTimeout(700);
}
Deux détails font la différence entre une boucle stable et une boucle capricieuse. La stabilité de hauteur doit se juger sur le nombre d’éléments extraits, pas sur la hauteur du document, parce que les images en chargement différé et les publicités changent la hauteur sans ajouter d’enregistrements. Et le défilement doit vraiment redéclencher le chargeur du site : les implémentations fondées sur l’Intersection Observer API se déclenchent sur les changements d’intersection, donc alterner les positions de défilement est plus fiable que de laisser la page collée en bas.
Enregistrer l’état du crawl et reprendre après un plantage
Les trois modes partagent une exigence : une exécution doit survivre à sa propre interruption. Écrivez un point de contrôle après chaque lot terminé, avec le mode, la position et les enregistrements déjà collectés, et faites de la reprise le chemin par défaut plutôt qu’un cas spécial. Sur le fixture, le crawl numéroté a été interrompu après la page 2 avec 54 lignes dans le point de contrôle. Un nouveau processus a lu ce point, a continué à partir de la page 3 et a fini avec les mêmes 135 lignes et 133 ids uniques qu’une exécution ininterrompue.
import { readFileSync, writeFileSync } from "node:fs";

const CHECKPOINT = "./crawl-state.json";
const save = (state) => writeFileSync(CHECKPOINT, JSON.stringify(state));
const load = () => {
  try {
    return JSON.parse(readFileSync(CHECKPOINT, "utf8"));
  } catch {
    return { mode: "numbered", lastPage: 0, rows: [] };
  }
};

const state = load();
for (let page = state.lastPage + 1; page <= 5; page += 1) {
  state.rows.push(...(await crawlPage(page)));
  state.lastPage = page;
  save(state); // checkpoint after every page
}
Le point de contrôle change aussi le débogage. Quand un crawl produit vraiment un mauvais comptage, vous pouvez inspecter le fichier d’état au lieu de relancer tout le travail, et la position enregistrée là vous dit quel lot redemander.
Doublons, lignes manquées et fausses dernières pages
Trois symptômes couvrent la plupart des bogues de pagination, et chacun a une signature dans les données plutôt que dans le code. Les doublons apparaissent lorsqu’un lot chevauche son voisin, ce qui arrive lorsque la liste sous-jacente se réordonne entre les requêtes, donc l’identifiant stable se répète. Le fixture l’a reproduit exactement : le même id est apparu une fois à la page 2, de nouveau à la page 3, et encore à l’intérieur de la page 5. Les deux doublons ont disparu avec une déduplication basée sur l’id.
Des lignes manquées veulent en général dire qu’une attente était trop courte ou qu’une page a été sautée. Si le total manque d’exactement un lot, regardez l’interaction avant le manque ; s’il manque une page, regardez l’incrément de la boucle. Le 503 transitoire du fixture est l’autre visage de ce bogue : sans nouvel essai, la page 3 n’aurait rien apporté et l’exécution aurait déclaré 106 lignes sans aucune erreur.
Une fausse dernière page est la plus dangereuse, parce que le crawl déclare un succès avec moins de données. Cela arrive lorsqu’une page renvoie zéro ligne à cause d’un problème de session ou de rendu, et non parce que la liste est terminée, et que la boucle traite les deux cas de la même façon. Distinguez-les en sondant encore une fois : redemandez la page suivante après une courte pause, et exigez soit un vrai marqueur de fin, soit deux réponses vides consécutives avant d’accepter la fin.
Valider les comptages et la complétude des champs
La validation, ce sont deux contrôles qui prennent quelques secondes et attrapent la plupart des échecs silencieux. Le contrôle de comptage compare ce qui a été collecté à chaque chiffre indépendant que vous trouvez : la propre mention "page 5 of 5" de la dernière page numérotée, un total dans un en-tête, ou la somme des comptages par page vus en chemin. Le contrôle de champs confirme que chaque enregistrement porte les champs promis par le travail, et compte les exceptions au lieu de les ignorer.
const unique = new Map(rows.map((row) => [row.id, row]));
const missing = rows.filter((row) => !row.title || !Number.isFinite(row.price));

console.log({
  raw: rows.length,
  unique: unique.size,
  removedDuplicates: rows.length - unique.size,
  missingFields: missing.length,
});
Sur les 135 lignes numérotées du fixture, le contrôle a déclaré zéro champ manquant, deux doublons retirés et 133 enregistrements uniques, en accord exact avec le jeu. Sur la liste load more, il a déclaré un doublon sur 81. Aucun des deux chiffres n’est intéressant tout seul ; ce qui compte, c’est qu’un changement dans l’un ou l’autre soit visible tout de suite, au lieu d’apparaître plus tard dans un rapport avec un trou mystérieux.
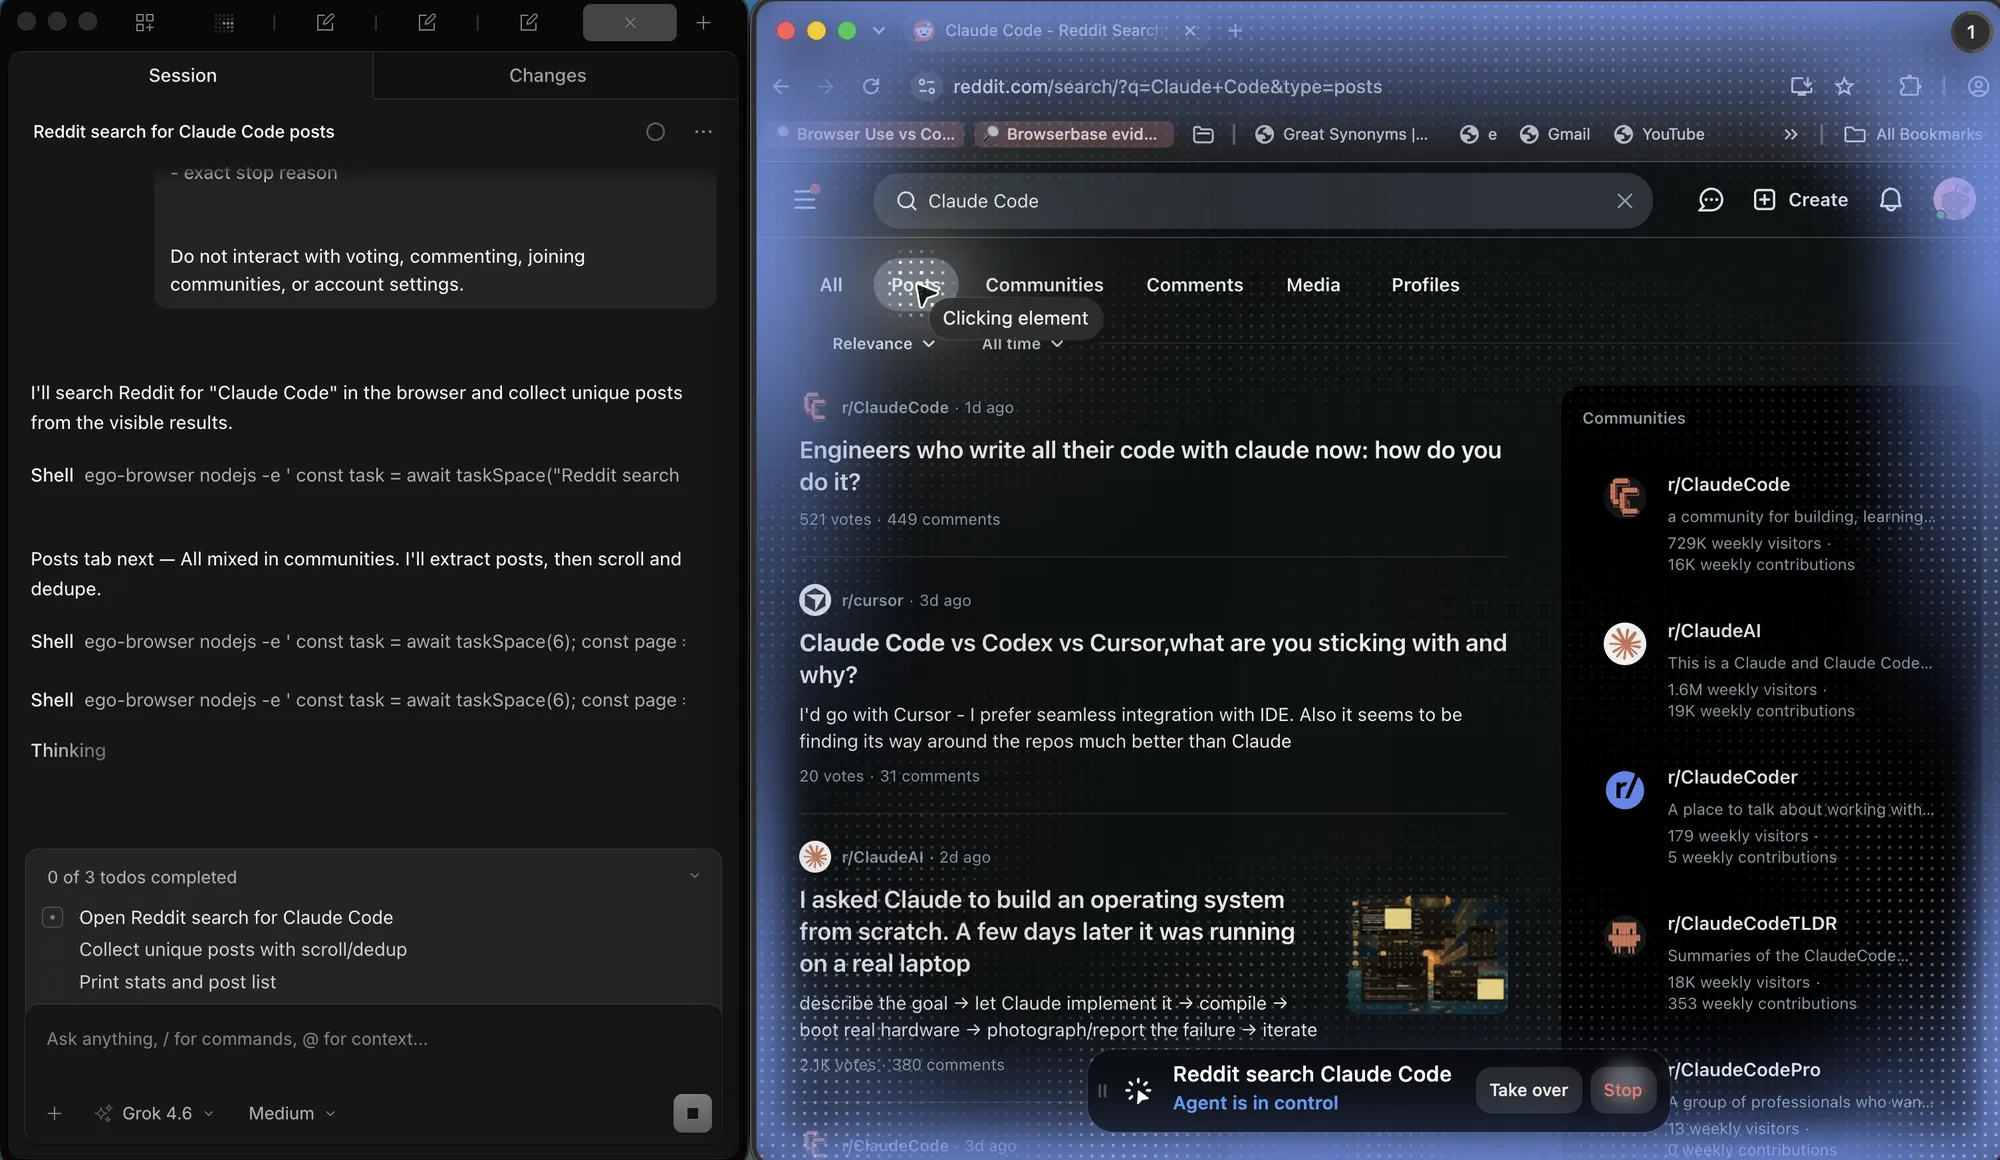
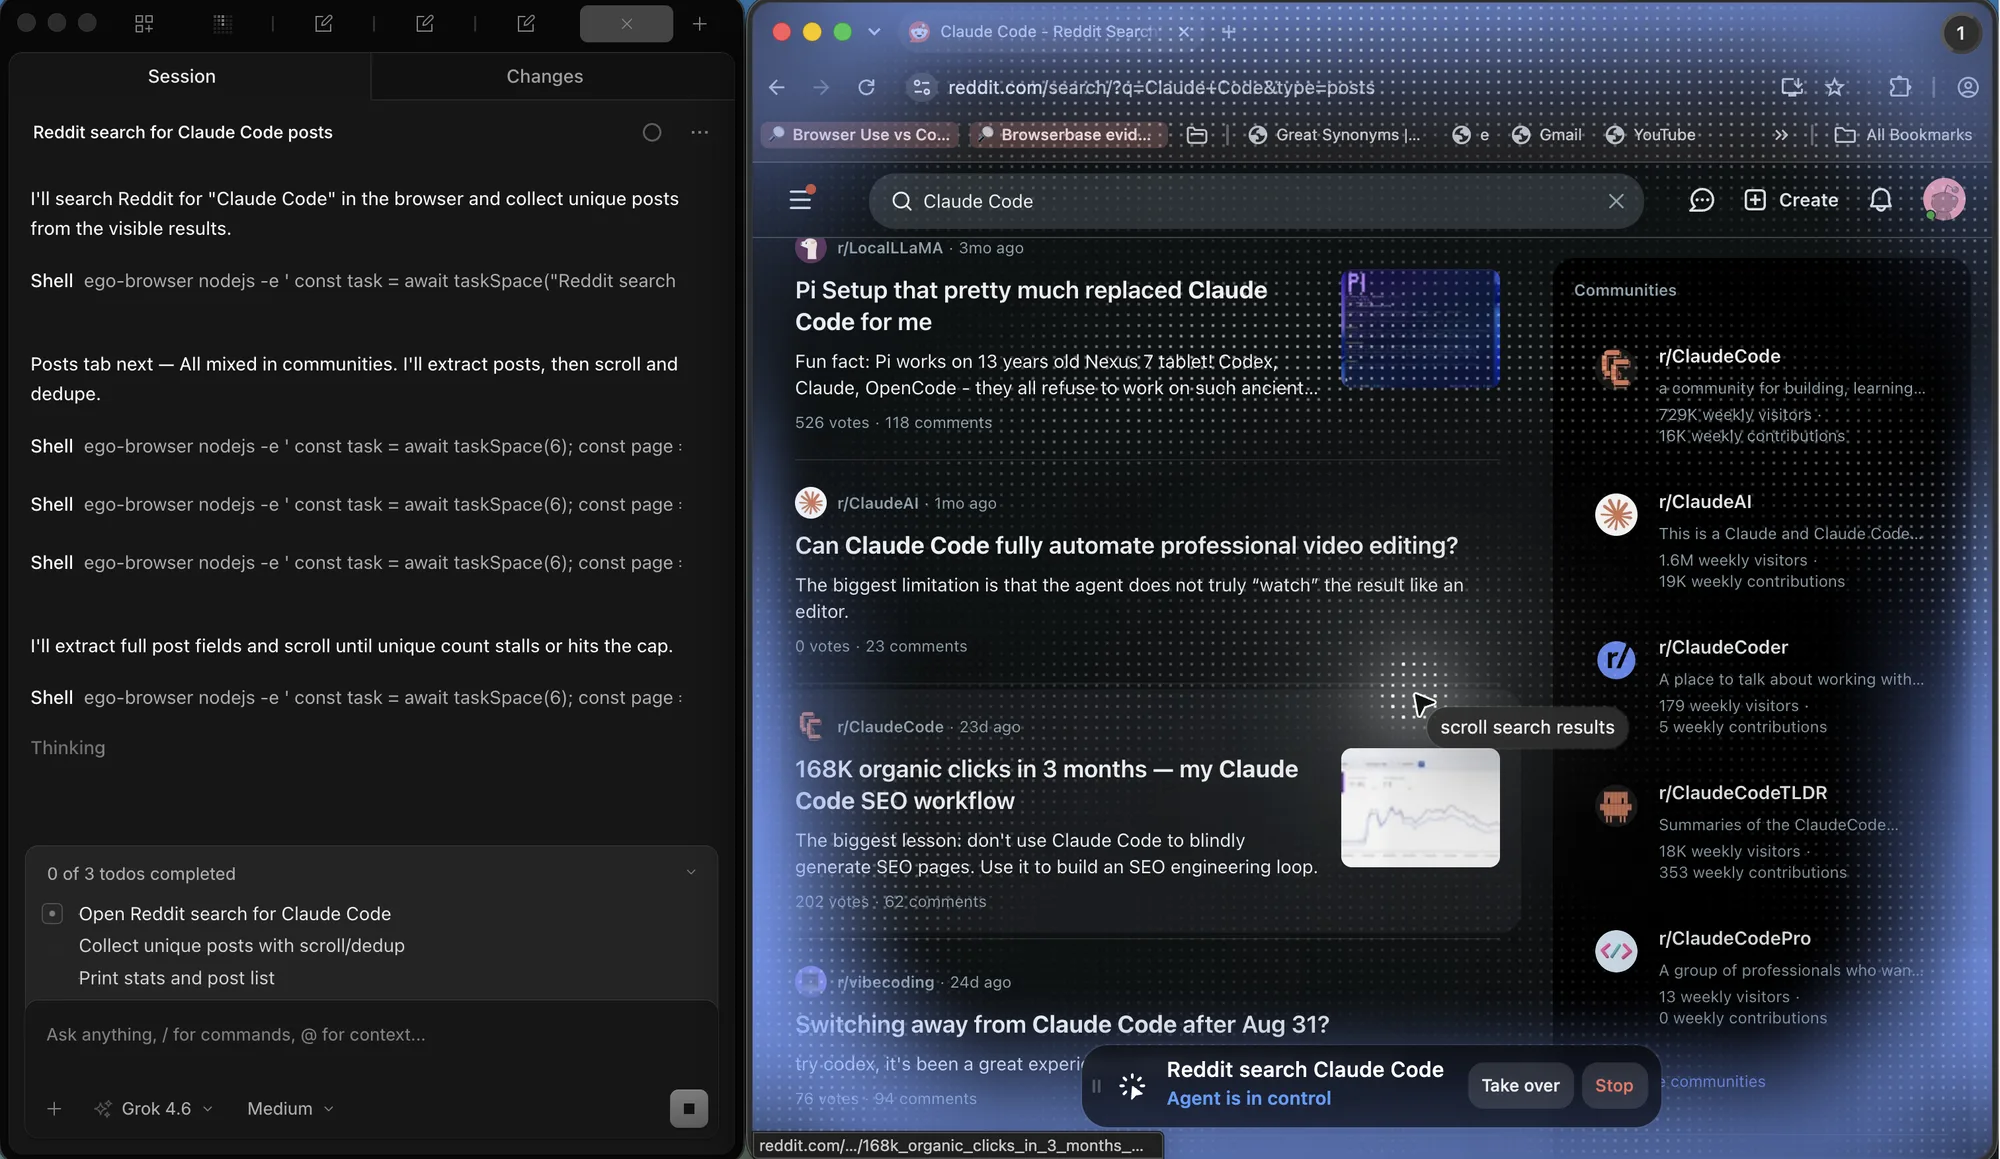
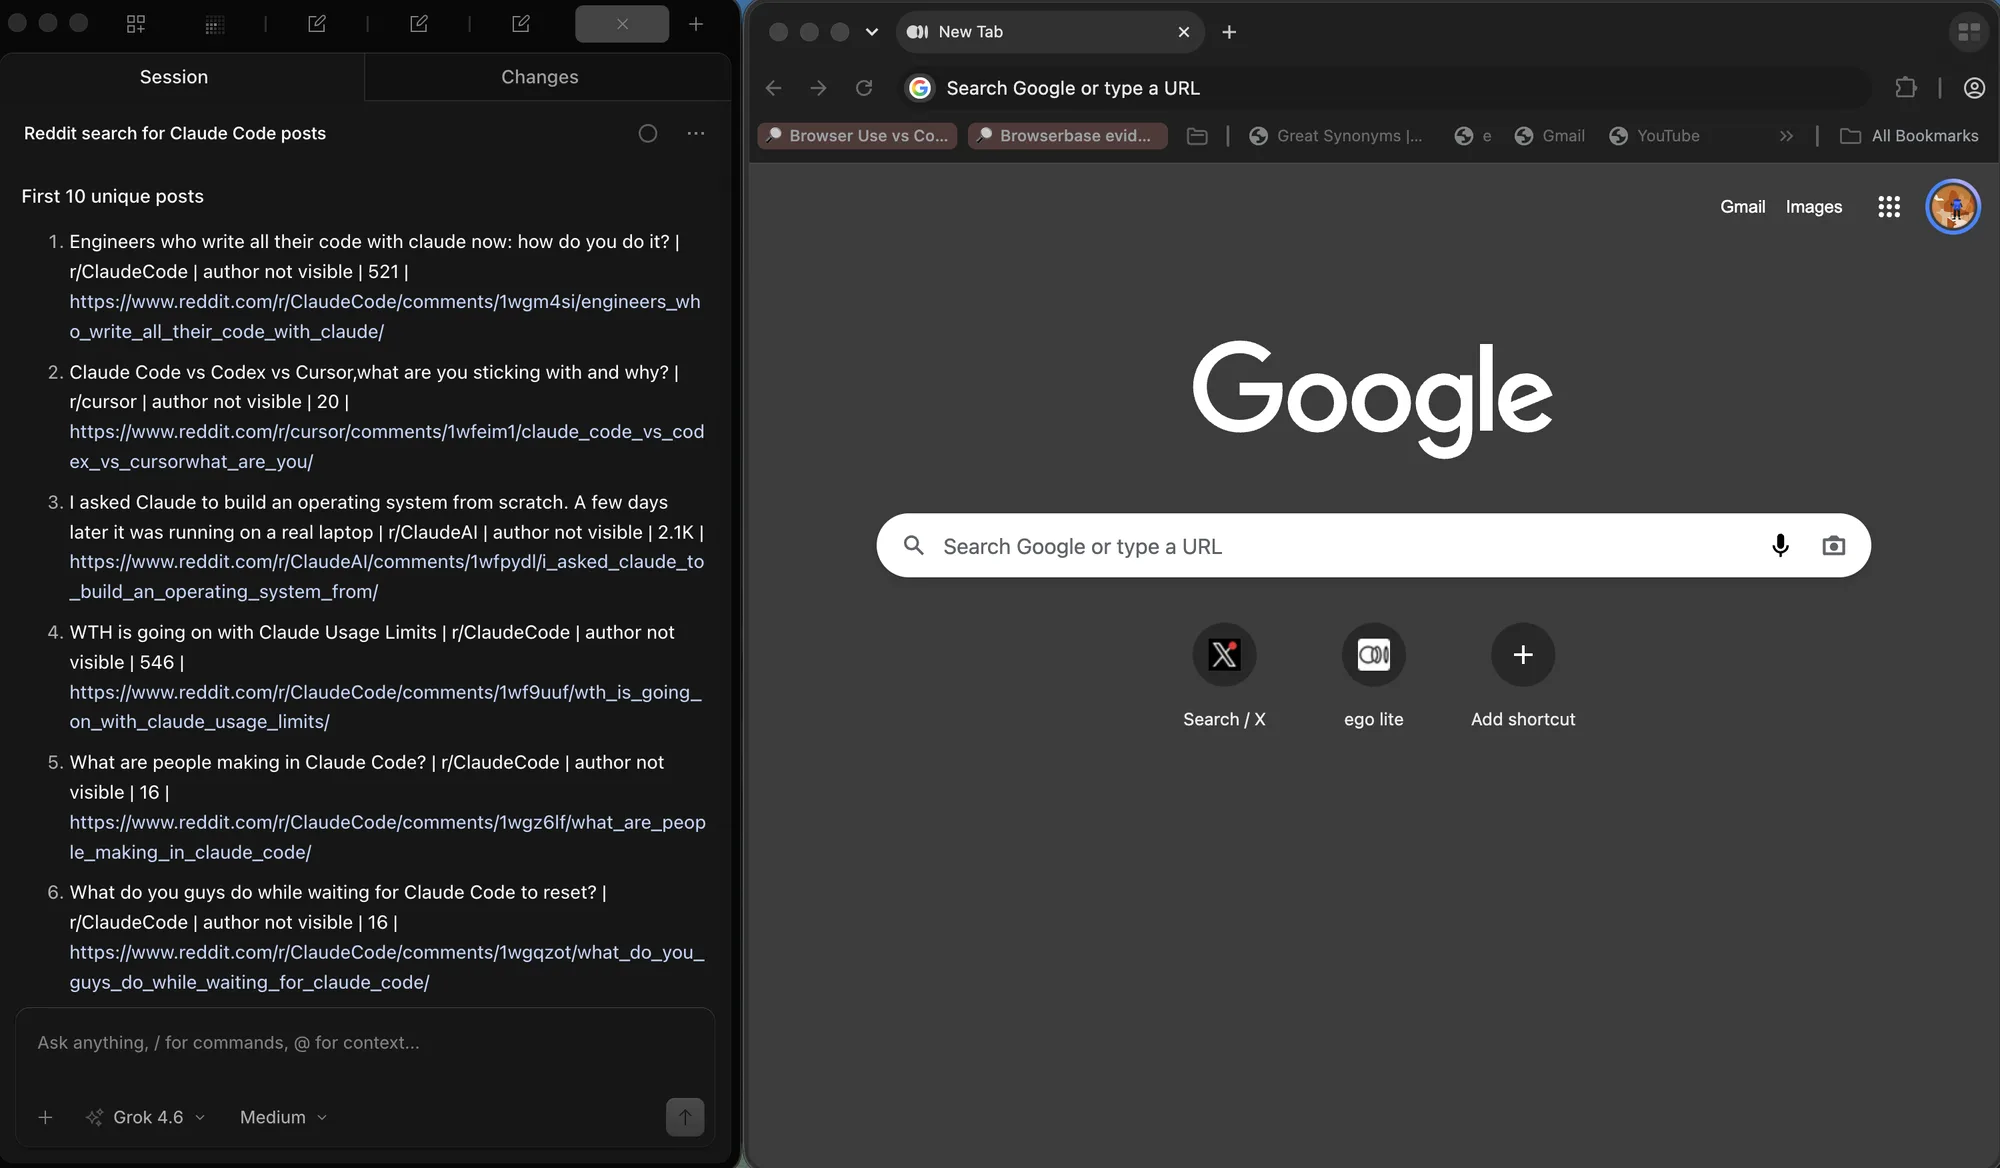
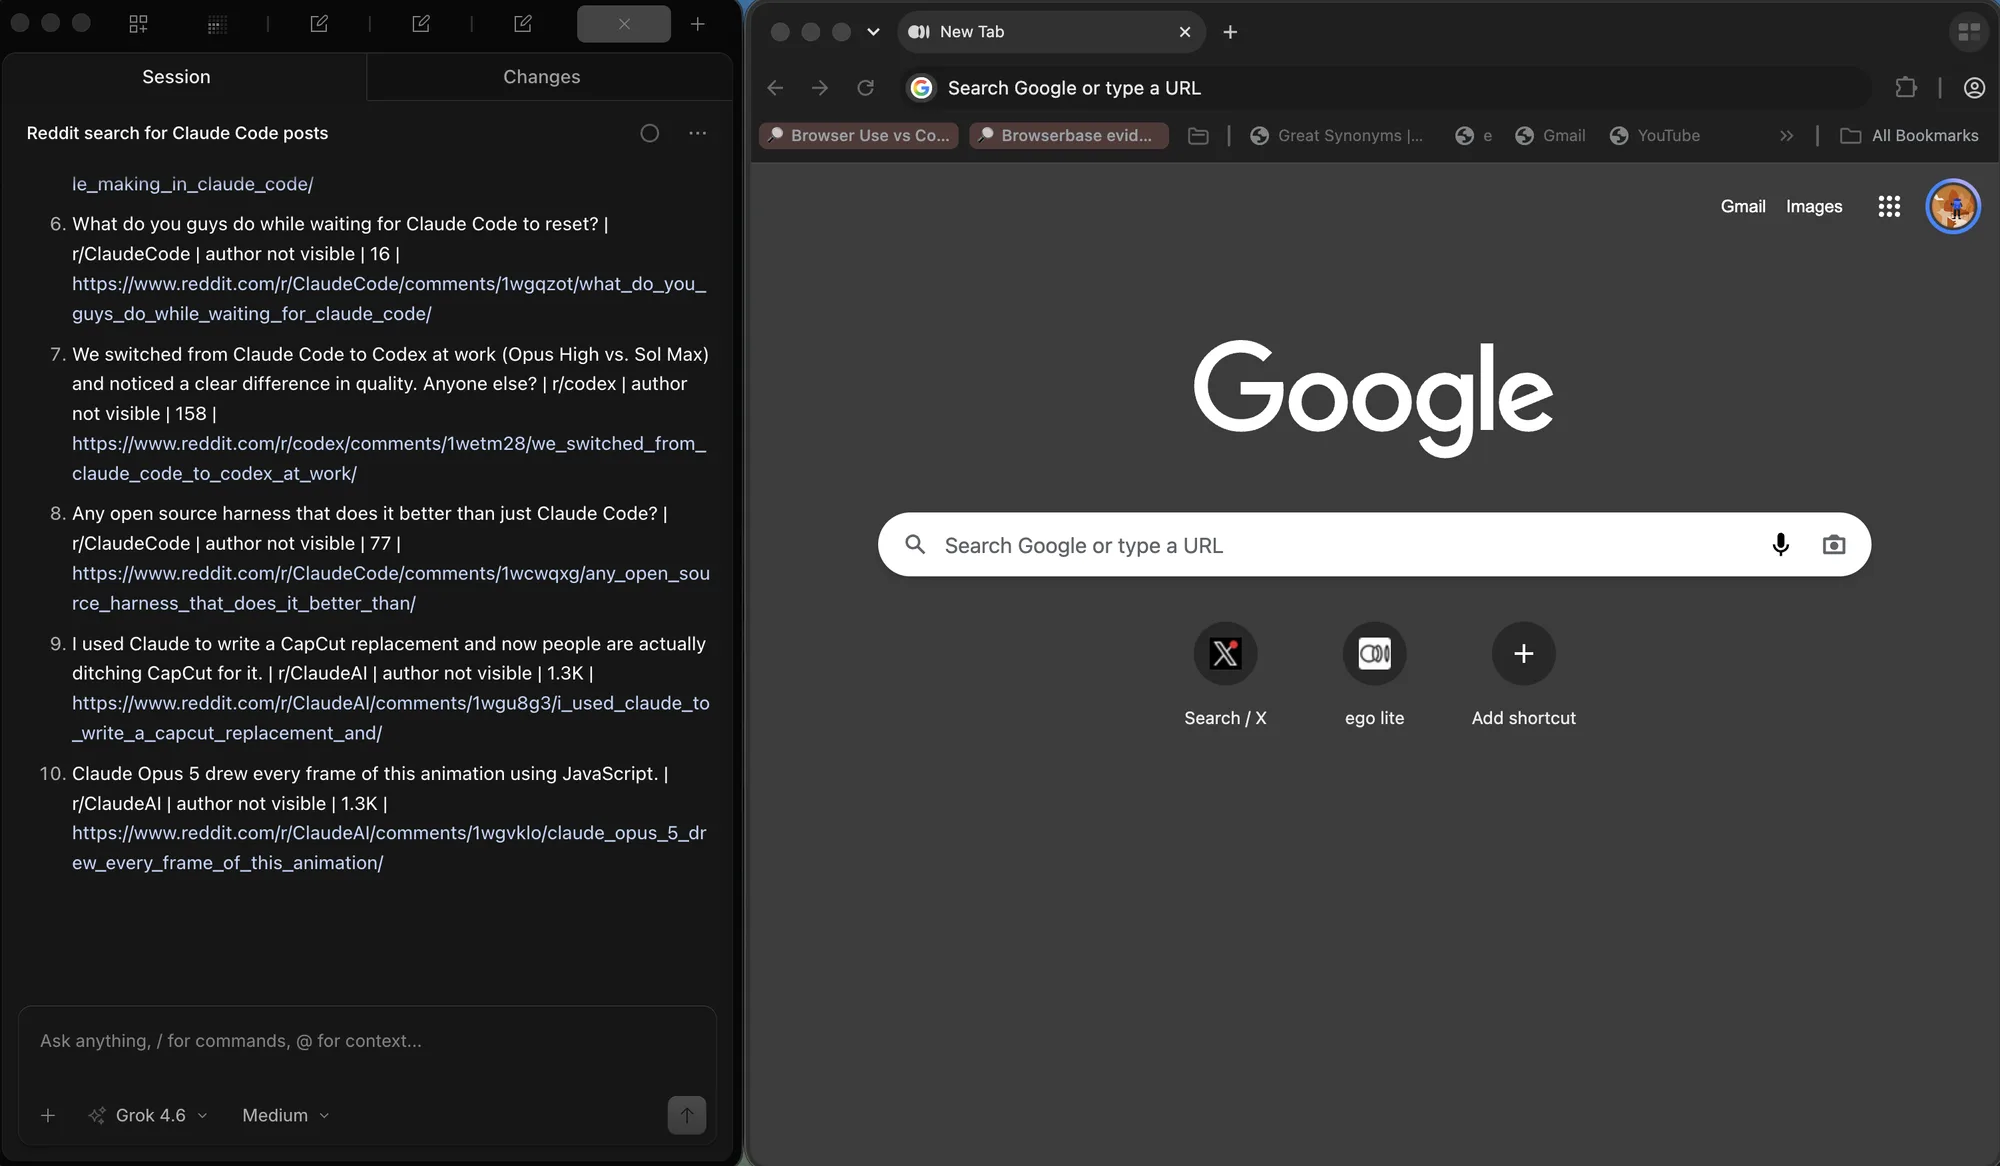
L execution Reddit a utilise le meme controle sur une liste unique en direct, pas sur le fixture de 135 lignes. Chaque ligne exigeait un titre, un subreddit, un nombre de votes et une URL. La sortie numerotee est ce que vous validez apres le defilement.
Quand le HTTP simple suffit, et quand il ne suffit pas
Les mêmes données du fixture sont accessibles sans navigateur, et mesurer les deux chemins est la façon honnête de décider ce dont le travail a besoin. Un client HTTP simple a parcouru les pages numérotées par URL, récupéré les lots load more depuis leur point d’accès JSON et tiré le fil infini par offset, collectant les 135, 81 et 60 lignes en 24 milliseconds au total. Pas de rendu, pas d’attentes, pas de défilement.
C’est la recommandation par défaut, et il faut la dire clairement : si une API officielle existe, utilisez-la. Si la liste numérotée est rendue côté serveur, demandez les pages directement. Si les modes load more ou infini s’appuient sur un point d’accès JSON sans signature, demandez ce point d’accès et paginez sur l’offset. Un framework comme Playwright n’est requis pour rien de tout cela, et le chemin HTTP est plus rapide et moins cher à exécuter. Le tutoriel de pagination Apify, la documentation des sélecteurs de pagination Web Scraper et le flux du panneau réseau dans le guide réseau Playwright couvrent le même terrain à partir de points de départ différents.
Un navigateur se justifie lorsque les données n’existent qu’après un rendu côté client, lorsque les requêtes portent une signature ou un jeton généré dans la page, lorsque la liste exige une connexion, ou lorsque le point d’accès répond autrement sans une vraie session et un vrai user agent. À ce stade, le navigateur n’est plus une préférence de scraping, c’est le seul chemin honnête, et les sections précédentes s’appliquent sans changement.
ego (lite) n’intervient qu’après l’échec de ce chemin HTTP. Si la liste a besoin d’un cookie de connexion, d’un jeton généré dans la page, ou d’un défilement qui n’arrive jamais sans un vrai viewport, exécutez la même boucle numbered / load-more / infinite dans un navigateur qui détient déjà la session. Ne commencez pas par là. Le fixture a déjà montré la réponse moins chère : 135, 81 et 60 lignes en HTTP simple en 24 ms.
Lorsque vous avez vraiment besoin du navigateur, conservez la logique de crawl des sections précédentes. ego (lite) fournit la page connectée et un Space que vous pouvez observer ; il n’invente pas un nouvel algorithme de pagination. Si une étape a besoin d’une personne, arrêtez-vous. Si curl ou une API officielle renvoie déjà les lignes, restez en HTTP.
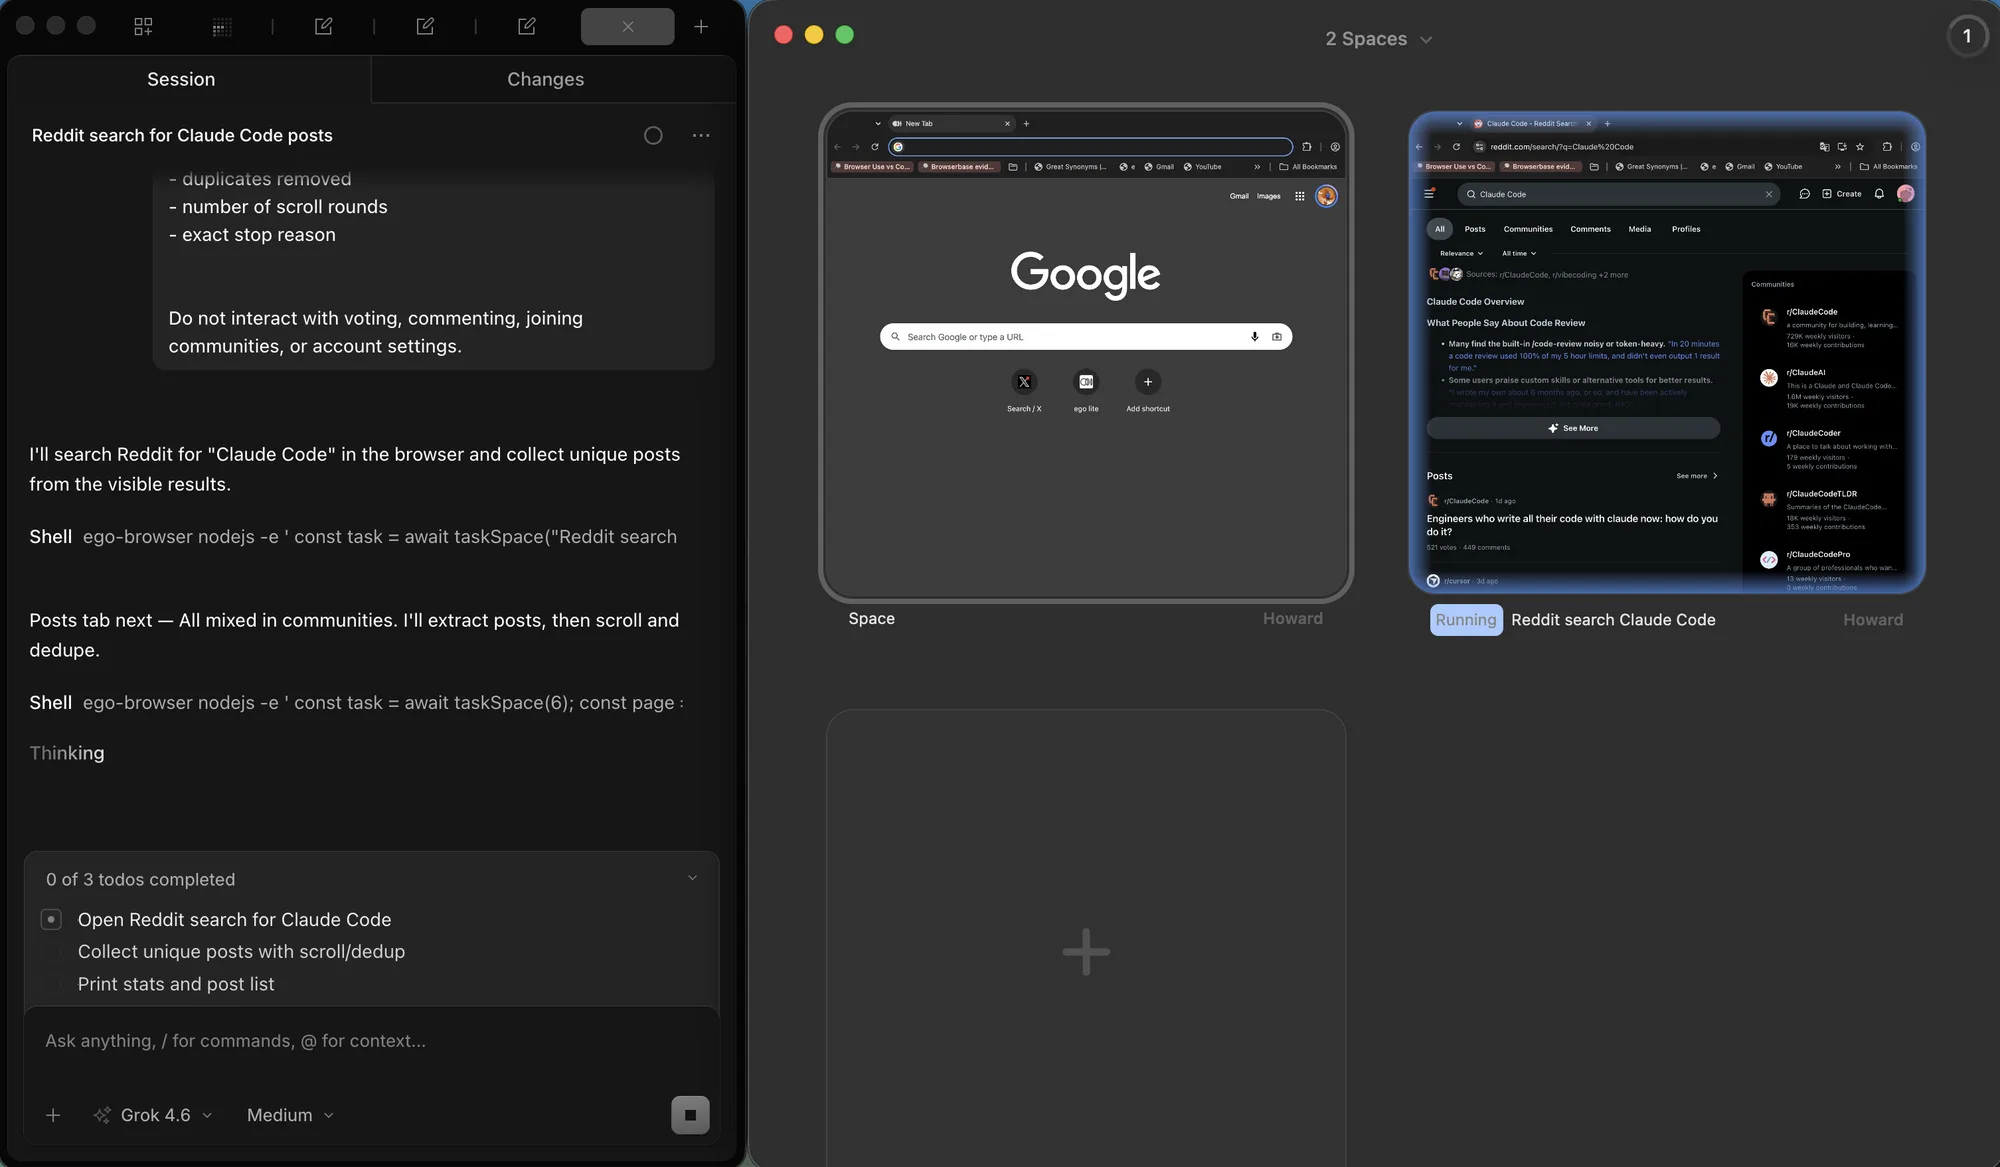
La regle d isolation des pages numerotees s applique encore. Deux crawlers qui partagent une fenetre se disputent la position de defilement et ecrasent la derniere ligne vue. Dans le meme navigateur, deux Spaces equivalent a deux contextes Playwright : l un peut rester idle sur Google pendant que l autre continue a defiler sur Reddit. L isolation est le point. L apercu montre seulement les deux a la fois.
La version 0.5.0.32 est consignée dans le journal des modifications (2026-09-12). Revérifiez cette page, le démarrage rapide et le dépôt GitHub avant de citer une version plus récente. Le guide voisin Web scraping en JavaScript traite la décision statique contre rendu de l’autre côté.
FAQ
Comment savoir combien de pages une liste numérotée contient ?
Vous savez combien de pages une liste numérotée contient en lisant le contrôle de dernière page, en divisant un total d’en-tête par la taille de page, puis en parcourant jusqu’à la fin une fois. Traitez cette estimation comme un contrôle, pas comme la condition d’arrêt de la boucle.
Pourquoi mon scraper collecte-t-il des doublons entre les pages ?
Les scrapers collectent des doublons entre les pages lorsque la liste sous-jacente se réordonne, donc un enregistrement passe d’un lot au suivant. Dédupliquez sur un record id stable, pas sur le titre visible, et consignez le nombre de doublons retirés.
Combien de temps dois-je attendre après un clic sur load more ?
Jusqu’à ce qu’une condition observable soit vraie : le nombre de lignes a augmenté, l’état disabled du bouton s’est levé, ou une ligne connue du lot suivant est apparue. Un délai fixe est une estimation qui marche jusqu’à ce que le réseau soit lent, et c’est précisément là qu’elle échoue.
Comment détecter la fin d’un fil infini ?
Préférez un signal explicite lorsque le site en fournit un, comme un message de fin rendu ou un indicateur has-more dans la réponse. Sans l’un ni l’autre, exigez plusieurs contrôles consécutifs sans nouvel élément et sans changement de hauteur du contenu chargé avant de vous arrêter, pas un seul moment calme.
Dois-je utiliser un navigateur headless pour scraper de la pagination ?
Seulement lorsque les données exigent un rendu, une session ou des jetons dans la page. Les listes rendues côté serveur et les points d’accès JSON sont mieux servis par le HTTP simple, plus rapide et plus simple à exécuter. Mesurez les deux chemins une fois ; la comparaison rend en général la décision évidente.
Qu’est-ce qui fait qu’un crawl paginé s’arrête trop tôt ?
Trois suspects habituels : une attente qui s’est terminée avant le rendu du lot, une erreur transitoire traitée comme une page vide, et une session expirée en cours d’exécution, de sorte que la page suivante a rendu le formulaire de connexion au lieu des lignes. Chacun a une correction différente, c’est pourquoi la raison d’arrêt doit être consignée avec le comptage.
Comment reprendre un crawl après un plantage ?
Posez un point de contrôle après chaque lot terminé, avec le mode, la position et les lignes déjà collectées. La reprise lit ce fichier et réentre dans le mode à la position enregistrée. Redemandez une fois le lot immédiatement avant la position du point de contrôle, pour confirmer que la source n’a pas bougé sous l’état enregistré.
Comment valider qu’un crawl est complet ?
Comparez le nombre d’enregistrements uniques à au moins deux chiffres indépendants, comme le total propre de la dernière page et la somme des comptages par page, puis contrôlez la complétude des champs sur chaque ligne et signalez les exceptions. Un comptage qui concorde et des champs tous présents forment un signal fort ; l’un ou l’autre seul est faible.
Dois-je défiler lentement pour déclencher le chargement différé ?
En général non, mais redéclenchez le chargeur plutôt que de rester collé en bas. Les sites utilisent des observateurs d’intersection qui se déclenchent au changement, donc alterner la position ou défiler par paliers est plus fiable qu’un grand saut, et cela rend le contrôle de croissance significatif.
Puis-je scraper une liste paginée derrière une connexion ?
Oui, avec une vraie session et les mêmes règles : paginez poliment, gardez la session vivante, et traitez une redirection vers la page de connexion comme un problème de session, pas comme la fin de la liste. Un navigateur qui porte déjà votre connexion, comme ego (lite), supprime entièrement l’étape de reconstruction de session. Le guide de session persistante couvre la gestion de l’état, et le cas d’usage de scraping de prix montre à quoi ressemble une collecte complète déjà connectée.