

Le web scraping en JavaScript échoue souvent, non pas parce que le code est faux, mais parce que la mauvaise voie d'accès a été choisie. Si les données figurent déjà dans le HTML initial, fetch de Node.js et un parser HTML suffisent. Un navigateur ne devient nécessaire que lorsque la page doit exécuter du JavaScript, paginer, cliquer ou interagir d'une autre manière avant que les données n'apparaissent, ce qui marque la ligne de démarcation entre le HTML statique et les pages rendues.
Playwright est parfaitement adapté aux workflows connus à l'avance et répétés souvent : ouvrir la page, attendre un élément, cliquer sur un contrôle, extraire les champs et rejouer le même parcours. Les problèmes commencent lorsque la structure de la page, la pagination ou le flux d'interaction changent et qu'une séquence figée de sélecteurs et d'actions se met à casser.
C'est là qu'un navigateur piloté par un agent comme ego (lite) convient mieux. Au lieu de supposer que le parcours d'origine existe toujours, l'agent peut inspecter la page telle qu'elle est rendue, décider de la suite et continuer à travailler de manière fiable après une navigation ou un changement dynamique.
Qu'est-ce qui détermine vraiment si un scraper JavaScript fonctionne ?
La voie d'accès détermine le résultat. Un même site cible peut être trivialement scrapable en HTTP ou totalement opaque en HTTP, selon que les données arrivent dans la réponse HTML initiale ou sont récupérées puis affichées ensuite par du JavaScript exécuté dans un navigateur.
La première tâche n'est donc pas d'écrire un scraper. Elle consiste à ouvrir la page cible, à consulter le code source plutôt que le DOM rendu, et à déterminer où se trouvent réellement les valeurs recherchées. Tout le reste de ce guide découle de cette réponse.
De laquelle des trois voies d'accès votre cible a-t-elle besoin ?
Trois voies couvrent presque tous les projets de scraping, et elles se classent par coût. Le HTML statique est le moins cher et le plus rapide. Un point d'accès JSON que la page appelle déjà fournit souvent les données les plus propres. Un vrai navigateur est le plus capable et le plus coûteux en CPU, en mémoire et en fragilité.
| Voie | Ce qu'elle peut faire | Ce qu'elle ne peut pas faire |
|---|---|---|
| Requête HTTP + parser HTML | Récupère n'importe quelle URL directement, lit le corps de la réponse et interroge le balisage renvoyé. Traite des milliers de pages par minute et par processus, sans binaire de navigateur. | Exécuter les scripts de la page, cliquer, faire défiler ou remplir des formulaires. Sur une page rendue côté client, elle renvoie la coquille vide, car les données n'ont jamais été dans la réponse. |
| Point d'accès JSON direct | Renvoie des données structurées sans parsing de balisage : les noms de champs survivent aux refontes de la mise en page. Charge utile minimale, parsing le plus rapide. | Rester stable au fil des mises à jour du site. Ces points d'accès sont internes, non documentés, et peuvent changer ou se mettre à rejeter les requêtes sans préavis. |
| Automatisation d'un vrai navigateur | Exécuter le JavaScript de la page, attendre l'apparition du contenu et interagir avec le résultat rendu exactement comme le ferait une personne. | Monter en charge à moindre coût. Chaque contexte de navigateur consomme de la mémoire réelle, et une flotte de contextes demande plus d'infrastructure qu'une boucle HTTP. |
Comment récupérer et parser du HTML statique dans Node.js ?
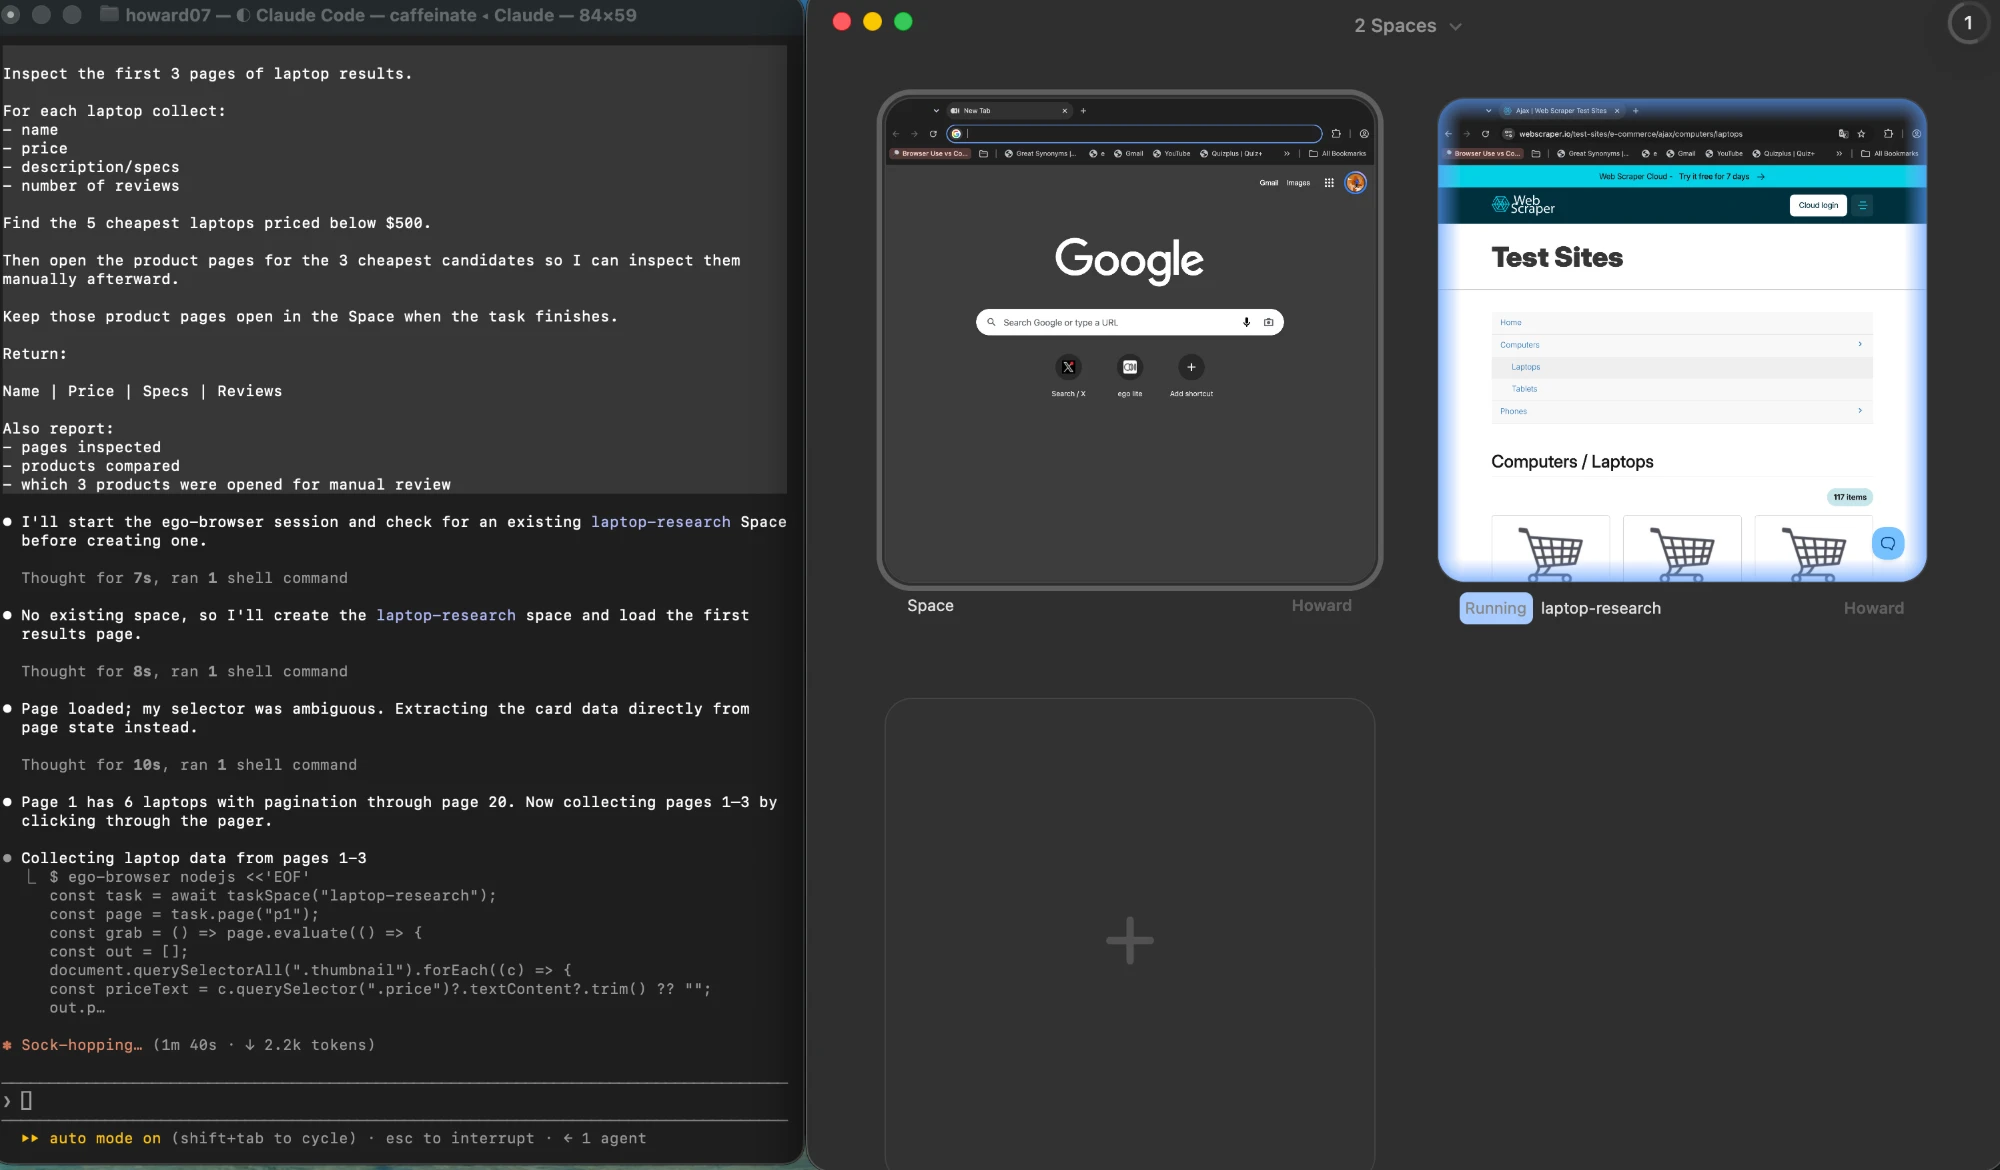
Commencez par la plateforme. Node.js expose l'API Fetch comme globale, donc une requête ne demande aucune dépendance. Le schéma ci-dessous constitue toute la première voie : requête, vérification du statut, lecture du texte, puis transmission du balisage à un parser.
La requête elle-même n'a besoin de rien d'autre que la plateforme, car l'API Fetch est fournie comme globale de Node.js, donc une simple requête GET n'a aucune bibliothèque HTTP à installer.
La vérification du statut est la partie que l'on supprime en premier et qui manque le plus. Une page 404 ou une page de blocage anti-bot renvoie quand même un corps, et ce corps se parse sans erreur en zéro élément correspondant, ce qui ressemble exactement à un bug de sélecteur.
const res = await fetch(url, {
  headers: { "user-agent": "my-scraper/1.0 (+contact@example.com)" },
});

if (!res.ok) {
  throw new Error(`${res.status} ${res.statusText} for ${url}`);
}

const html = await res.text();
La limitation de débit fait partie de la même boucle, elle ne se rajoute pas après coup. Un délai attendu entre les requêtes garde un petit traitement courtois et votre adresse hors des listes de blocage :
const sleep = (ms) => new Promise((r) => setTimeout(r, ms));

for (const url of urls) {
  const html = await getHtml(url);
  await parse(html);
  await sleep(1000);
}
Voici ce que renvoie réellement cette première voie. Le tableau ci-dessous présente la sortie réelle d'une simple requête HTTP associée à une bibliothèque de sélecteurs, sur un catalogue de test public d'ordinateurs portables : pas de navigateur, pas d'étape de rendu, trois pages récupérées comme trois réponses statiques.
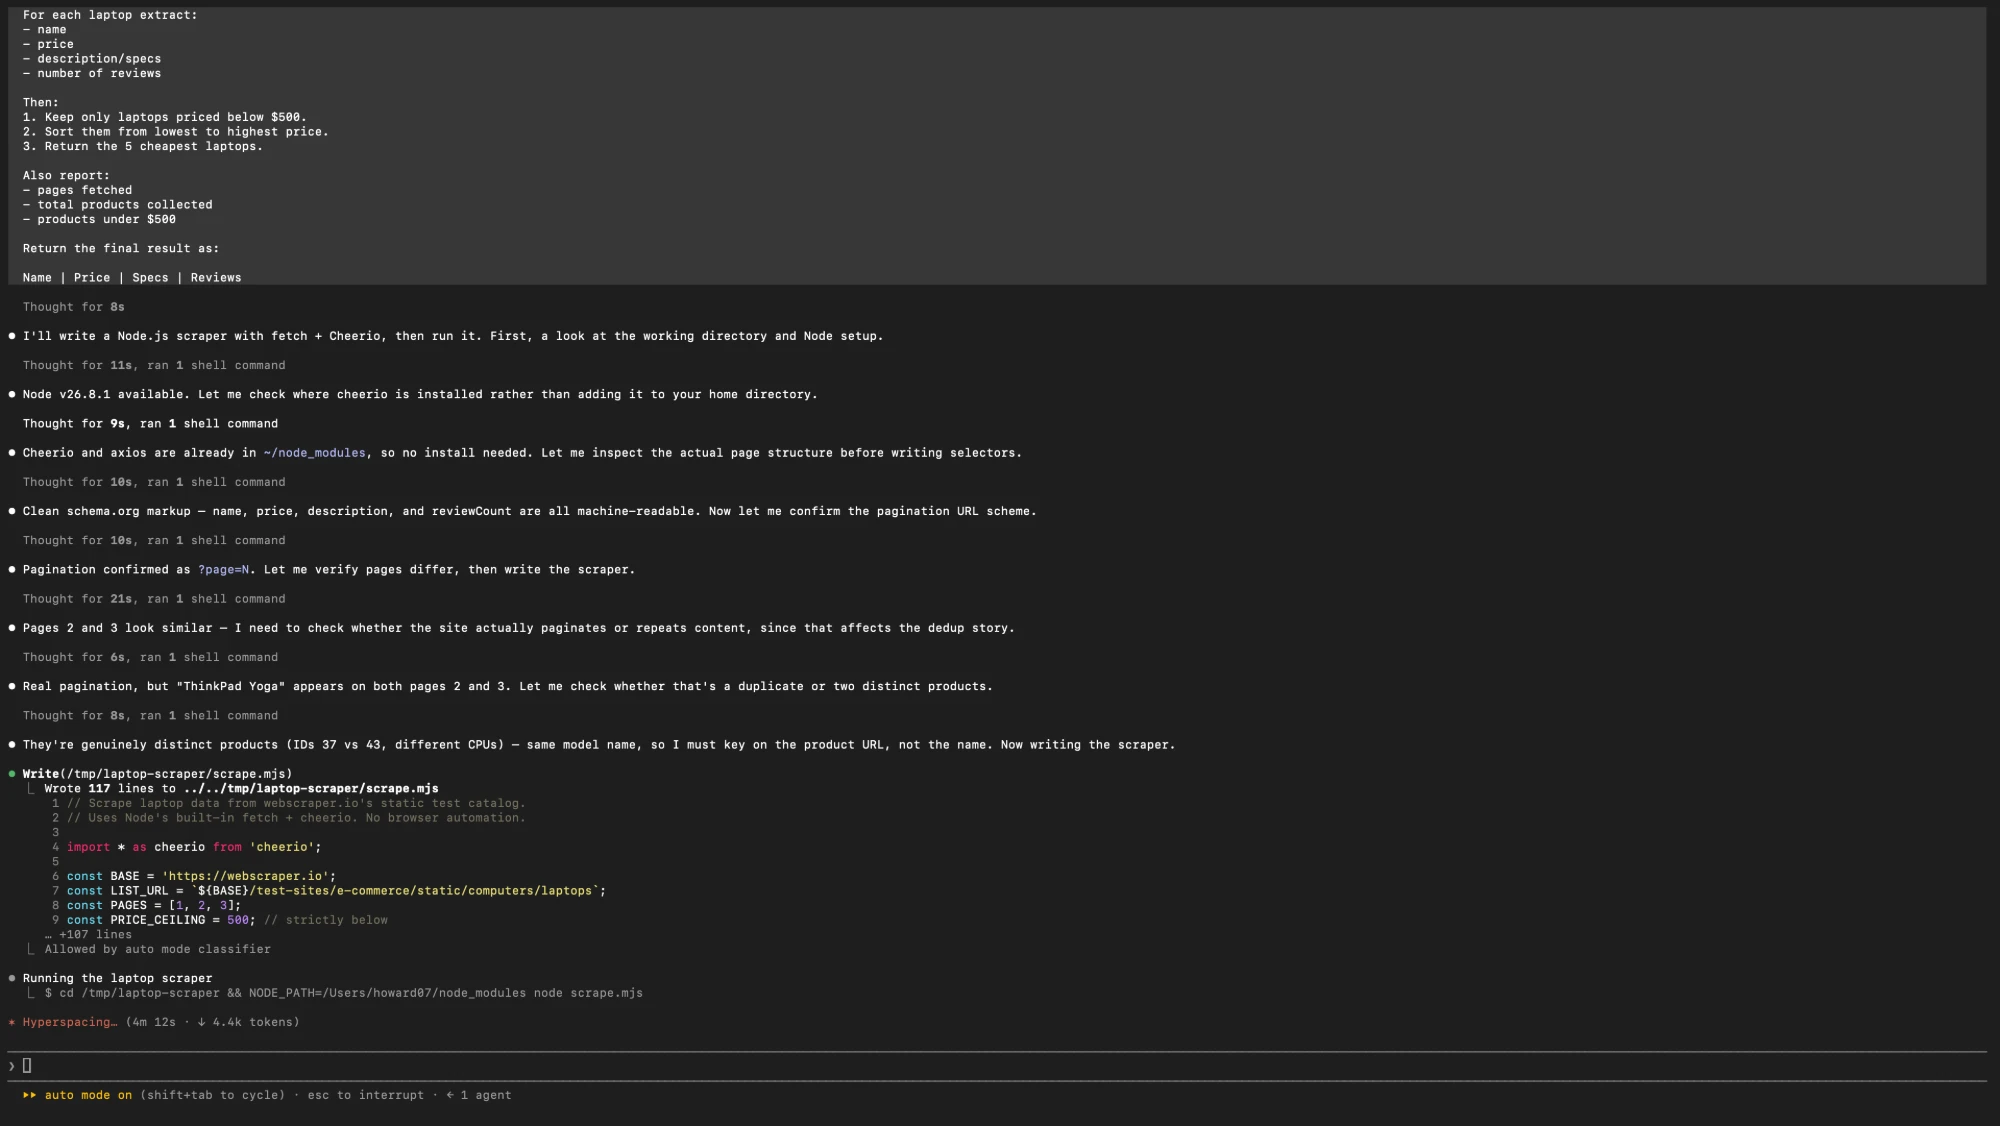
| ID | Nom | Prix | Caractéristiques | Avis |
|---|---|---|---|---|
| 32 | Aspire E1-510 | $306.99 | 15.6", Pentium N3520 2.16GHz, 4GB, 500GB, Linux | 2 |
| 45 | Asus VivoBook Max | $399 | 15.6" HD, Pentium N4200 1.1GHz, 4GB, 500GB, Windows 10 Home | 4 |
| 31 | Packard 255 G2 | $416.99 | 15.6", AMD E2-3800 1.3GHz, 4GB, 500GB, Windows 8.1 | 2 |
| 46 | Dell Vostro 15 | $488.78 | 15.6" FHD, Core i5-7200U, 4GB, 128GB SSD, Radeon R5 M420 2GB, Linux | 14 |
Quatre produits sur dix-huit coûtent moins de 500 $. C'est tout le résultat de la première voie sur ce catalogue : trois requêtes, aucun rendu, aucun processus de navigateur. Et c'est aussi là que commence la partie honnête, car ce tableau omet quelque chose qu'un lecteur s'attendrait à voir.
Cheerio, DOMParser ou jsdom : quel parser choisir ?
Ces trois bibliothèques sont souvent comparées comme si elles étaient interchangeables. Elles ne le sont pas, car leurs promesses diffèrent : deux d'entre elles parsent du balisage pour l'interroger, et l'une implémente un DOM avec exécution de scripts.
Le parser sur lequel s'appuie ce guide est documenté sur cheerio.js.org, qui précise que Cheerio parse et interroge le balisage plutôt que d'exécuter les scripts de la page.
| Option | Ce qu'elle peut faire | Ce qu'elle ne peut pas faire |
|---|---|---|
| Cheerio | Parse rapidement une chaîne HTML et l'interroge avec des sélecteurs de style jQuery. Dépendance légère, pas de navigateur, idéal pour quelques centaines de champs extraits d'un corps de réponse. | Exécuter les scripts de la page, rendre des composants ou calculer la mise en page. Il parse du balisage ; il ne se comporte pas comme un navigateur. |
| jsdom | Fournir une implémentation du DOM dans Node.js avec document, window et l'exécution de scripts, afin que du code écrit pour les API du navigateur tourne sans modification. | Égaler un vrai navigateur en rendu ou en fidélité, et il est bien plus lourd par page. C'est un substitut de DOM, pas Chrome. |
| DOMParser | Transformer une chaîne en document interrogeable grâce à une API de navigateur intégrée, sans ajouter la moindre dépendance au projet. | Être attendu avec await : il est synchrone et bloquant, et dans Node.js, il n'est devenu une globale que dans les versions récentes. |
La lecture avec Cheerio utilise l'API de sélecteurs bien connue. Notez que le texte extrait est rogné aux extrémités, car un balisage scrapé transporte indentation et retours à la ligne qui, sinon, se retrouveront dans votre jeu de données :
import * as cheerio from "cheerio";

const $ = cheerio.load(html);
const items = $(".product-card").map((i, el) => ({
  name: $(el).find(".name").text().trim(),
  price: $(el).find(".price").text().trim(),
})).get();
La même extraction avec DOMParser ressemble à ceci, et elle ne fonctionne que là où cette globale existe :
const doc = new DOMParser().parseFromString(html, "text/html");
const rows = [...doc.querySelectorAll("table tbody tr")].map((tr) => ({
  cells: [...tr.querySelectorAll("td")].map((td) => td.textContent.trim()),
}));
Comment trouver le point d'accès JSON que la page utilise déjà ?
Avant d'écrire le moindre sélecteur, ouvrez le panneau réseau du navigateur, filtrez sur fetch et XHR, rechargez la page et regardez ce qui remonte. Beaucoup de sites pilotés par les données assemblent la page visible à partir d'un petit nombre de réponses JSON, bien plus faciles à exploiter que le balisage.
Une fois trouvé, la requête a généralement besoin des mêmes en-têtes que la page, et parfois d'un cookie de session. Rejouez-la avec la sortie « copier en fetch » du panneau réseau plutôt que de la reconstituer à la main.
const res = await fetch("https://example.com/api/listings?page=1", {
  headers: { accept: "application/json" },
});

if (!res.ok) throw new Error(`${res.status} for listings page 1`);

const { items } = await res.json();Pourquoi une page rendue côté client renvoie-t-elle une coquille vide ?
Une page rendue côté client envoie un balisage presque vide. La réponse initiale contient un élément racine, un paquet de scripts et parfois un état de chargement. Le texte qu'une personne voit à l'écran est créé par JavaScript après l'arrivée de la réponse, si bien qu'une requête HTTP qui se contente de lire la réponse n'a rien à lire.
La situation se diagnostique plutôt qu'elle ne relève du mystère. Deux vérifications couvrent la plupart des cas : le texte visible dans la réponse ne représente qu'une petite fraction de ce que montre le navigateur, et le balisage est dominé par les balises script :
const text = html.replace(/<script[\s\S]*?<\/script>/g, "").replace(/<[^>]+>/g, " ").replace(/\s+/g, " ").trim();

console.log({
  textLength: text.length,
  scriptCount: (html.match(/<script\b/g) ?? []).length,
  hasRoot: /id="(root|app|__next)"/.test(html),
});
Texte court, nombreux scripts et div racine vide signifient ensemble que la troisième voie est la réponse honnête. Quelques dizaines de caractères de texte sans aucune balise script signifient en général quelque chose de plus simple : la requête a été bloquée ou vous avez demandé la mauvaise URL.
À quoi ressemble la différence en pratique :
| Signal dans la réponse HTTP | Ce que cela signifie généralement | Étape suivante |
|---|---|---|
| Contenu complet, vrai balisage | Le serveur a rendu la page. Rien d'autre n'est nécessaire. | Parsez-la avec une bibliothèque de sélecteurs. |
| Div racine plus de nombreux scripts | Rendu côté client. Le contenu arrive après la réponse. | Cherchez le point d'accès JSON ou rendez la page. |
| Texte très court, aucun script | Bloqué, redirigé ou mauvaise URL. | Journalisez le statut, l'URL finale et les en-têtes avant de parser. |
Comment Playwright scrape-t-il une page dans un vrai navigateur ?
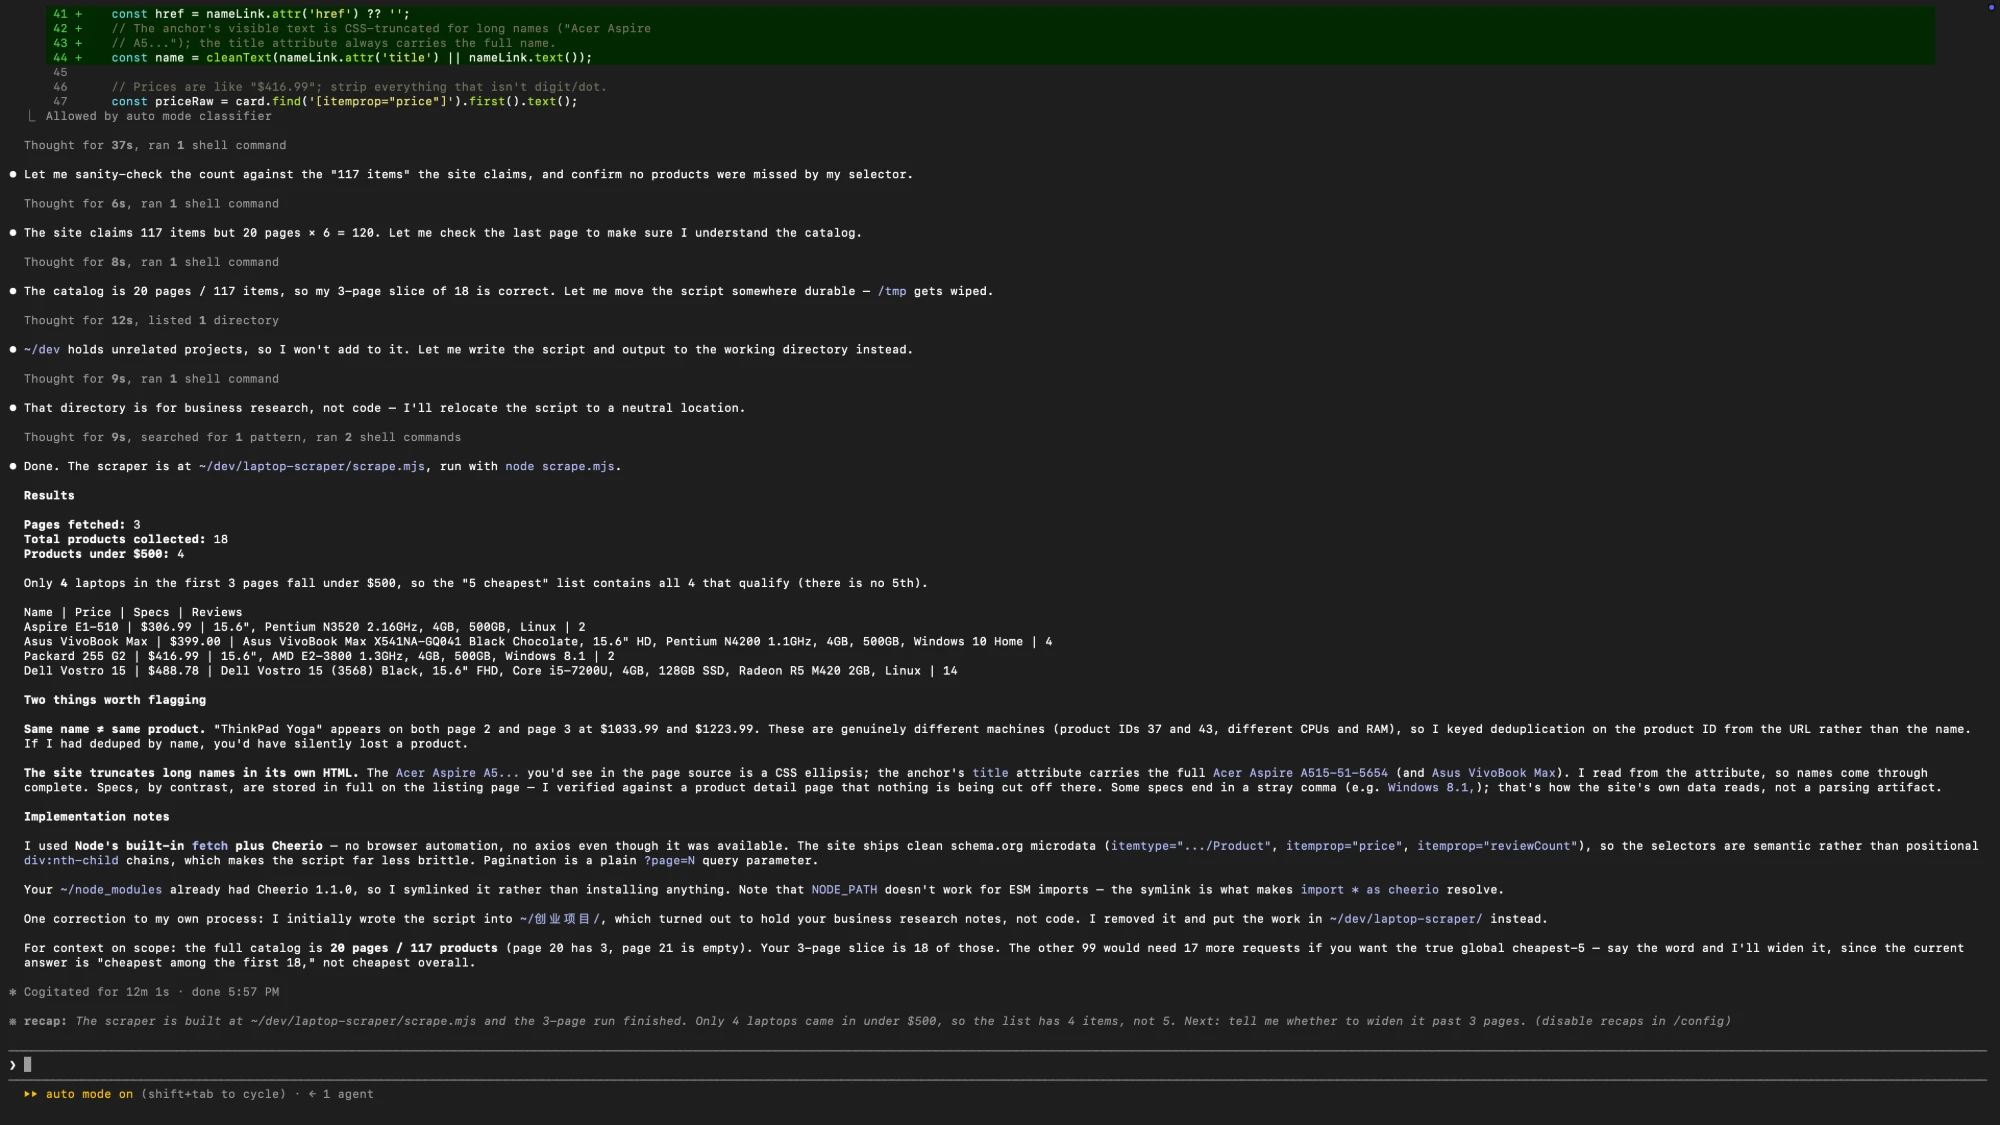
Playwright pilote un vrai navigateur, donc la page s'exécute exactement comme pour un visiteur. La mécanique de scraping est plus légère qu'on ne l'imagine : ouvrir un contexte, aller à l'URL, attendre précisément l'élément voulu, puis l'extraire.
La surface d'API utilisée ici est documentée sur playwright.dev, la référence canonique pour lancer des navigateurs, des contextes et des locators.
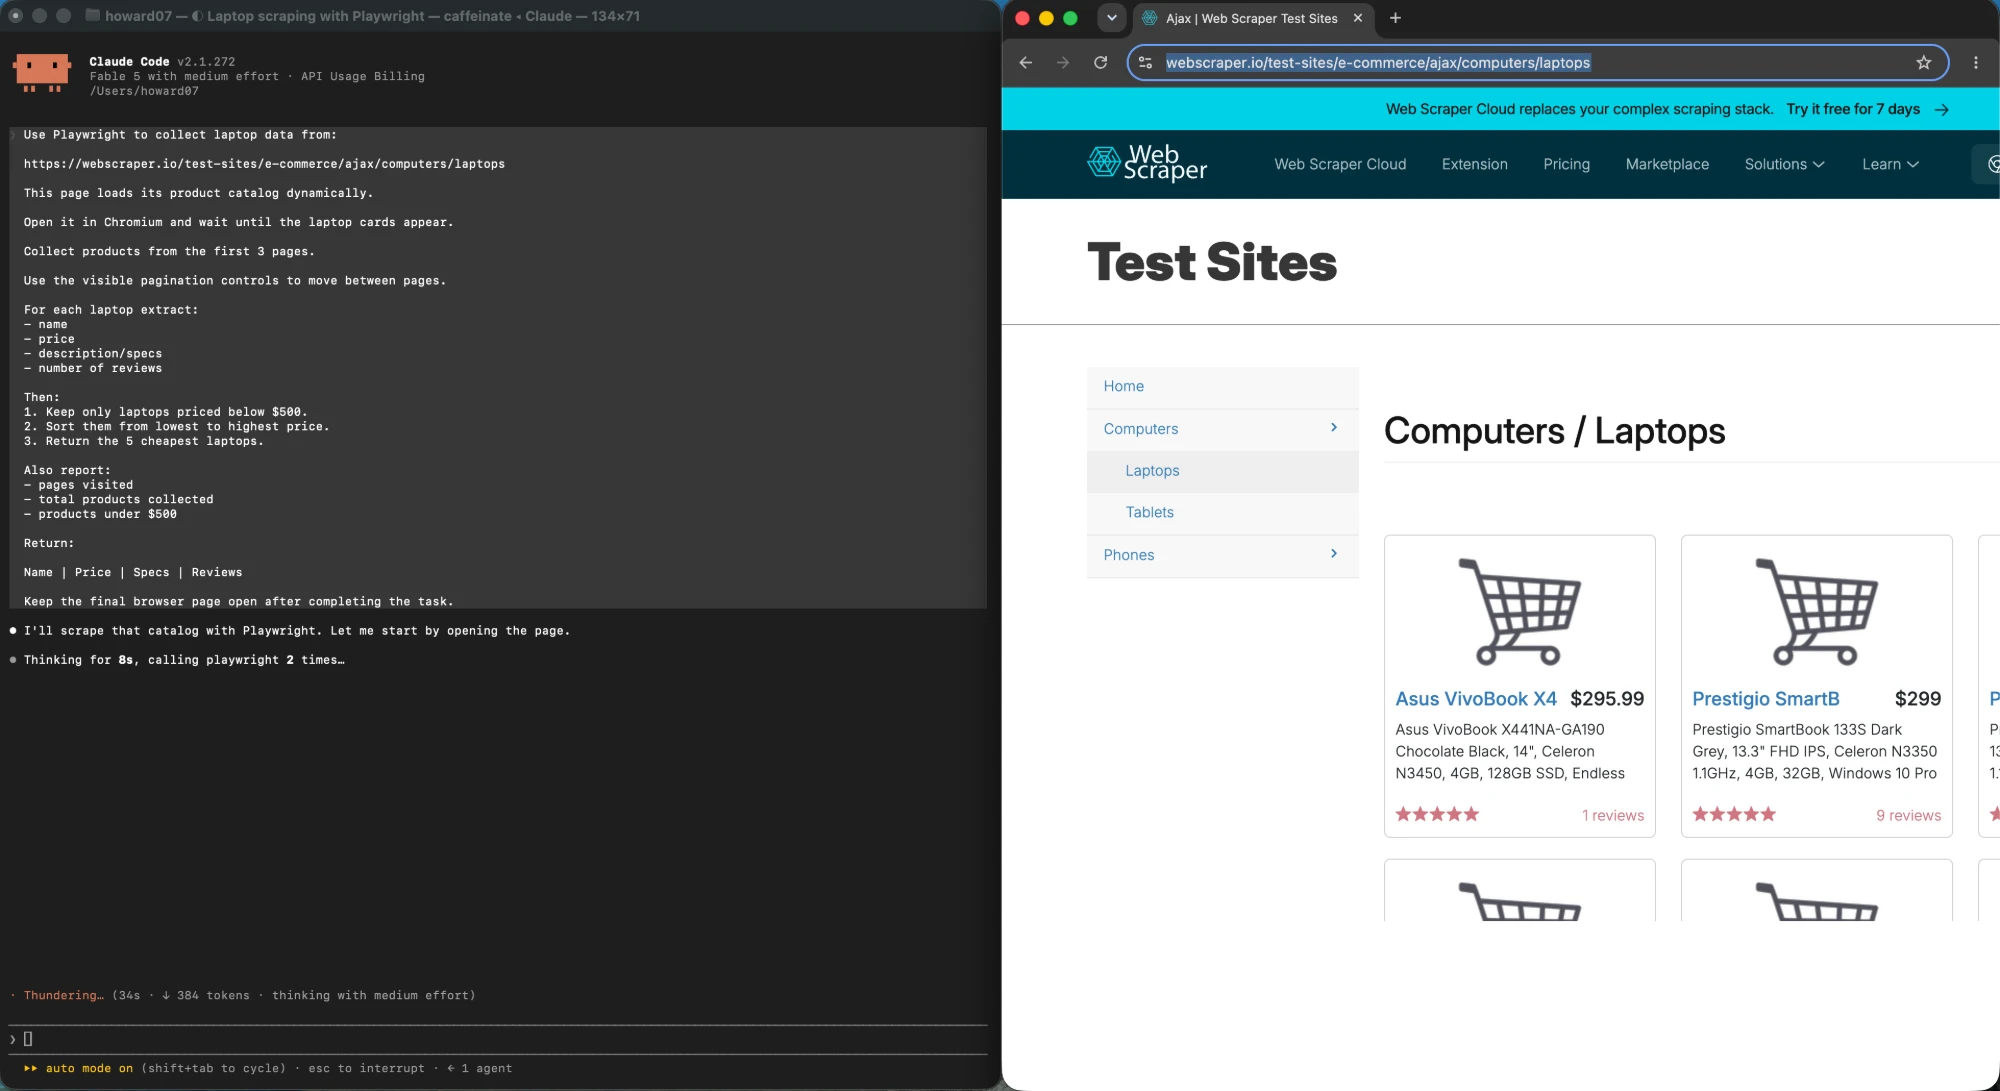
Le schéma de récupération ci-dessous attend un sélecteur puis extrait via page.evaluate, qui exécute votre fonction dans la page et renvoie un résultat sérialisable :
import { chromium } from "playwright";

const browser = await chromium.launch();
const context = await browser.newContext();

try {
  const page = await context.newPage();
  await page.goto(url, { waitUntil: "domcontentloaded" });
  await page.waitForSelector(".product-card");

  const rows = await page.evaluate(() =>
    [...document.querySelectorAll(".product-card")].map((el) => ({
      name: el.querySelector(".name")?.textContent?.trim() ?? null,
      price: el.querySelector(".price")?.textContent?.trim() ?? null,
    })),
  );

  console.log(rows);
} finally {
  // contexts hold the memory; close it even when the scrape throws
  await context.close();
  await browser.close();
}
Deux détails de cycle de vie comptent plus que les sélecteurs. Le contexte est l'unité jetable et peu coûteuse : un seul navigateur peut donc servir plusieurs exécutions isolées, et chacune se termine par une fermeture. Le second est que l'extraction de texte dans la page renvoie des nœuds de texte, pas des valeurs rendues : un contenu masqué par CSS reste dans le DOM et apparaîtra quand même dans votre sortie.
Quand la cible est un élément précis plutôt que toute la liste, les locators sont la voie d'extraction la plus propre. La documentation des locators de Playwright rappelle qu'aucune attente n'est nécessaire pour les boutons, les liens et les champs, ce qu'il vaut mieux garder en tête avant d'envelopper chaque interaction dans une attente explicite :
const title = await page.getByRole("heading", { level: 1 }).innerText();
const price = await page.locator("[data-testid=price]").innerText();
Comment les sessions, le risque de blocage et les CAPTCHA changent-ils le plan ?
Dès qu'une cible exige une connexion, le scraper cesse d'être un exercice de données pour devenir un problème de gestion de sessions. Playwright le prend en charge directement : authentifiez-vous une fois, enregistrez l'état de stockage du navigateur dans un fichier et réutilisez-le lors des exécutions suivantes au lieu de scripter une saisie d'identifiants à chaque fois.
// once, interactively
await context.storageState({ path: "auth.json" });

// later runs
const context = await browser.newContext({ storageState: "auth.json" });
Deux conséquences opérationnelles en découlent. Un état de session enregistré est un identifiant : il appartient à un coffre de secrets, pas au dépôt. Et une session enregistrée expire : une exécution qui se met soudain à renvoyer des pages de connexion signale un problème de session, pas de sélecteur.
Maintenir cet état en vie d'un lancement à l'autre est un sujet à part entière : les sessions de navigateur persistantes entre exécutions d'agents y sont détaillées.
Pour le trafic automatisé en général, trois contraintes décident si vous avez un travail de scraping ou un combat perdu d'avance : ce que les directives robots et les conditions du site autorisent, le débit que le site publie ou tolère, et si la réponse obtenue est le contenu ou une page de défi. Ce sont des questions de politique à trancher avant d'écrire du code, et elles sont approfondies dans notre guide sur le scraping derrière les murs de connexion.
Qu'est-ce qui casse un scraper JavaScript en production ?
Les scrapers échouent rarement parce qu'un sélecteur était faux. Ils échouent à la deuxième exécution, sur la centième URL, quand une page est plus lente, qu'une réponse est une redirection ou que le site commence à limiter le débit. Les correctifs sont sans éclat et précis.
async function getWithRetry(url, attempt = 0) {
  const res = await fetch(url);
  if (res.status === 429 || res.status >= 500) {
    if (attempt >= 3) throw new Error(`giving up on ${url}`);
    const retryAfter = Number(res.headers.get("retry-after"));
    const waitMs = Number.isFinite(retryAfter)
      ? retryAfter * 1000
      : 2 ** attempt * 1000;
    await new Promise((r) => setTimeout(r, waitMs));
    return getWithRetry(url, attempt + 1);
  }
  if (!res.ok) throw new Error(`${res.status} for ${url}`);
  return res.text();
}
La concurrence est le deuxième piège. Dix contextes de navigateur en parallèle sur une même machine se disputent surtout le même CPU : le gain de débit est donc inférieur au coût en mémoire, et le site reçoit une rafale plutôt qu'un filet continu. Commencez en séquentiel, mesurez, et n'augmentez le nombre que si la cible le tolère.
Troisième point : tout scraper qui lit un point d'accès sans engagement a besoin d'une solution de repli. Conservez dans le code le parsing par sélecteurs de la page visible et laissez un appel JSON en échec retomber dessus, afin qu'un changement discret en amont dégrade l'exécution au lieu de la vider.
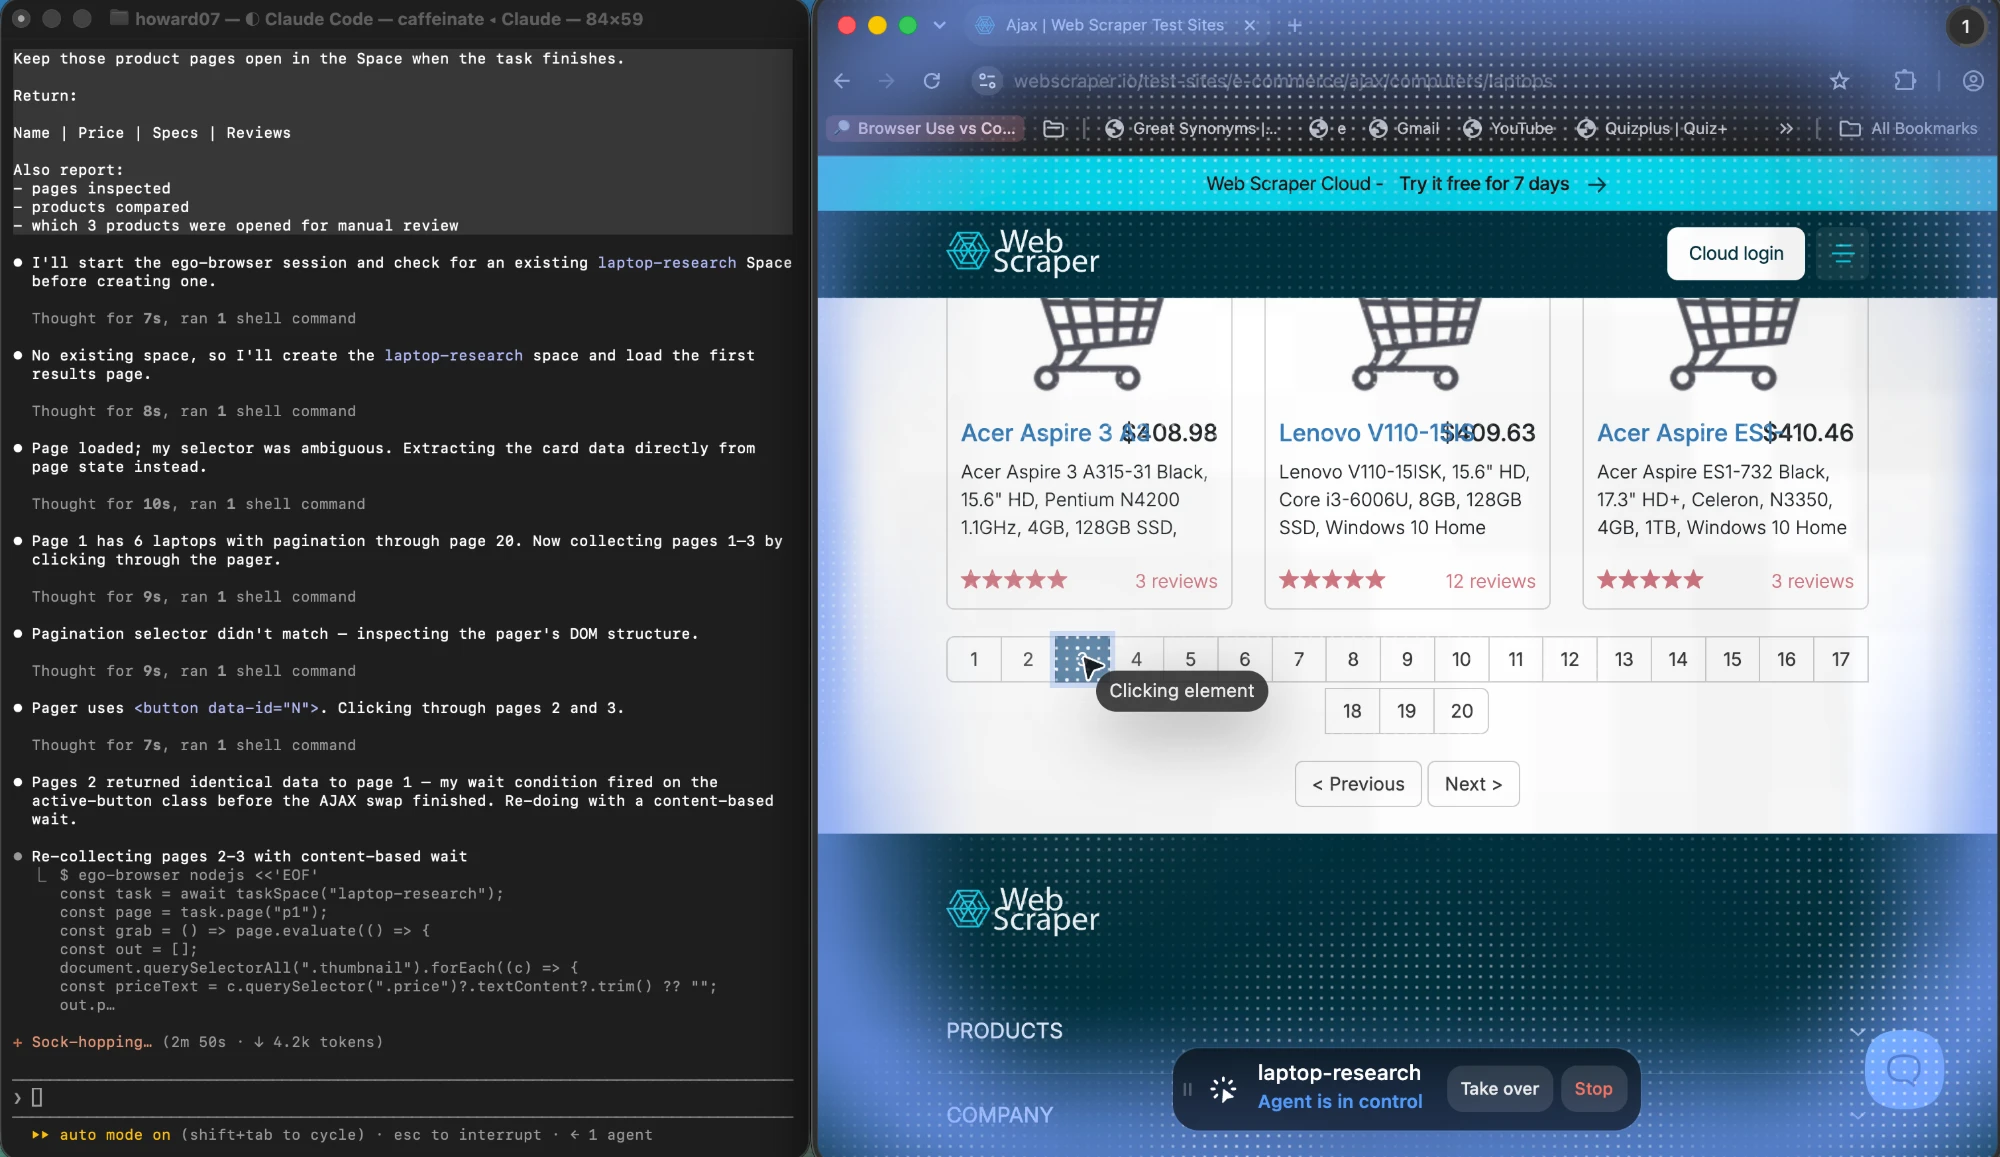
Quand un vrai navigateur est-il réellement nécessaire ?
Un vrai navigateur est la bonne réponse quand la tâche exige ce que seul un navigateur peut fournir : une session authentifiée déjà présente sur votre machine, un contenu qui n'apparaît qu'après une interaction, un flux où une personne doit intervenir en cours de route, ou un résultat qu'il faut observer pendant qu'il se produit plutôt que récupérer. En dehors de ces cas, HTTP avec un parser est plus rapide, moins cher et plus simple à maintenir en marche.
Le compromis entre un navigateur headless et un vrai navigateur est traité dans navigateur headless vs navigateur réel pour les agents IA.
C'est la situation où un agent de navigateur piloté par les tâches mérite d'être introduit. ego (lite) est un navigateur conçu pour le travail piloté par un agent : vous décrivez l'objectif, et il opère dans un vrai navigateur, y compris les sessions déjà ouvertes sur lesquelles vous êtes connecté, avec une interface visible que vous pouvez reprendre quand une étape demande un jugement humain. Pour les tâches de scraping qui nécessitent un vrai état de connexion, une page dynamique, une exécution visible ou une reprise en main humaine, cela supprime le travail de câblage de session décrit plus haut. Ce n'est pas un remplacement de Playwright, et il ne promet rien pour tous les sites : les pages qui répondent par un défi, ou qui interdisent l'accès automatisé, sont hors de portée pour lui comme pour n'importe quelle autre voie. Là où une simple requête HTTP ou une API officielle renvoie déjà ce qu'il vous faut, ajouter un agent de navigateur ne ferait que ralentir le travail.
Pour une comparaison plus approfondie des outils de navigateur une fois qu'un navigateur est vraiment la réponse, notre comparatif du scraping avec Playwright et Puppeteer traite du choix de bibliothèque lui-même, et les workflows de scraper web assistés par IA indique la place des agents dans un pipeline de scraping.
Quels sont les principaux défis et limites ?
Chaque voie de ce cadre a un mode de défaillance qu'aucune ingénierie ne peut éliminer, et les connaître à l'avance distingue un scraper qui tourne un an d'un scraper qui tourne une semaine.
Le parsing statique casse quand le site refait son balisage. Il n'a aucun moyen de s'en apercevoir : un champ qui devient silencieusement null est plus fréquent qu'un plantage franc. Validez un échantillon à chaque exécution plutôt que de faire confiance au pipeline.
Les points d'accès JSON internes cassent sans aucun avertissement, et ce sont les éléments les moins contractuels d'un site. Une exécution réussie aujourd'hui ne prouve rien pour le mois prochain.
L'automatisation par navigateur est la plus réaliste et la plus fragile à l'échelle. La mémoire croît avec la concurrence, les sessions expirent, et les systèmes anti-bot réagissent à des motifs plutôt qu'à des intentions : une technique qui fonctionne depuis un ordinateur portable peut échouer depuis un datacenter.
Et la limite la plus importante n'est pas technique. Ce que vous êtes autorisé à collecter, à quelle fréquence, et ce que vous pouvez ensuite en faire sont décidés par les conditions du site, par les directives robots et par le droit de votre juridiction, et rien de tout cela ne change parce que le code fonctionne.
La séquence de dépannage qui découle de tout cela est courte. Quand un scraping ne renvoie rien, vérifiez d'abord le code de statut, puis si le contenu figure bien dans la réponse, puis si le sélecteur correspond au DOM rendu plutôt qu'au source. Ce n'est qu'après ces trois étapes qu'il faut envisager le navigateur.
FAQ
Ai-je besoin d'une bibliothèque pour faire des requêtes HTTP dans Node.js ?
Non. Node.js expose l'API Fetch comme globale : fetch est donc disponible sans rien installer, avec l'objet response et ses membres ok, status et text(). Ce dont vous avez besoin, en revanche, c'est d'un parser, car fetch renvoie une chaîne, et rechercher des motifs dans du HTML casse dès que le balisage change.
Pourquoi mon scraper renvoie-t-il une liste vide sur une page qui s'affiche bien dans le navigateur ?
La cause la plus probable est que la page est rendue côté client et que les données n'ont jamais été dans la réponse HTTP. Confirmez-le en comparant le texte visible de la réponse brute avec ce que montre le navigateur, et en comptant les balises script par rapport au contenu. Si la réponse est une coquille, passez au point d'accès JSON du site ou rendez la page dans un vrai navigateur.
Cheerio remplace-t-il un navigateur headless ?
Non. Cheerio parse le HTML et permet de l'interroger avec des sélecteurs. Il n'exécute pas de JavaScript, donc il ne peut pas produire le contenu que la page génère après le chargement. C'est le bon outil pour la première voie et le mauvais pour la troisième, et recourir à un navigateur quand Cheerio suffirait est le coût inutile le plus courant dans le code de scraping.
Comment savoir si une page est rendue côté serveur ou côté client ?
Demandez l'URL et examinez la réponse brute plutôt que le DOM rendu. Si les valeurs recherchées sont présentes dans le corps de la réponse, la page est rendue côté serveur et la voie économique fonctionne. Si le corps contient un élément racine, des bundles de scripts et peu de texte, le contenu est assemblé dans le navigateur.
Comment scraper une page qui exige une connexion ?
Connectez-vous une fois dans un contexte de navigateur, enregistrez l'état de stockage dans un fichier et chargez cet état lors des exécutions suivantes. Considérez ce fichier comme un secret, attendez-vous à ce qu'il expire et privilégiez une session que vous êtes autorisé à utiliser. Si une cible exige de contourner un CAPTCHA ou une vérification de propriété, arrêtez-vous et passez par une voie officielle.
Playwright ou Puppeteer : lequel est le meilleur pour le scraping ?
Les deux pilotent un vrai navigateur et peuvent scraper les mêmes pages. Le choix porte sur des détails de bibliothèque comme la prise en charge des locators, le comportement d'attente et les bindings de langage, et non sur les voies d'accès ; il est traité dans notre comparatif Playwright vs Puppeteer. Quel que soit votre choix, la décision de voie décrite dans cet article vient en premier.
Combien de pages puis-je scraper en même temps ?
Commencez en séquentiel et mesurez avant d'augmenter la concurrence. Les requêtes HTTP montent en charge bien plus économiquement que les contextes de navigateur, et des navigateurs parallèles sur une même machine se disputent surtout le même CPU tout en envoyant une rafale de trafic à la cible. Pour le scraping HTTP, quatre à huit requêtes en vol avec un délai constituent un point de départ plus sûr que des dizaines.
Que faire lorsque je reçois une réponse 429 ?
Lisez l'en-tête Retry-After et attendez au moins ce délai, puis réessayez avec un backoff exponentiel jusqu'à une petite limite et échouez bruyamment au-delà. Un 429 est un signal de débit, pas une erreur à forcer dans une boucle de retry serrée, et l'ignorer est le meilleur moyen de finir sur une liste de blocage.
Le scraping est-il légal ?
Cela dépend du site, des données, de la juridiction et de l'usage que vous faites du résultat. Les directives robots et les conditions d'utilisation indiquent ce qu'un site autorise, et les règles sur les données personnelles et les droits des bases de données varient selon les pays. Rien dans cet article ne constitue un conseil juridique ; vérifiez les conditions et le droit applicable avant de collecter quoi que ce soit à grande échelle.
Quand utiliser une API officielle plutôt que le scraping ?
Chaque fois qu'il en existe une qui couvre les champs dont vous avez besoin. Une API documentée est un contrat stable, elle a généralement des limites de débit explicites et elle ne casse pas quand la mise en page change. Le scraping est la solution de repli pour des données publiées dans un navigateur sans voie d'accès prise en charge, pas le choix par défaut.
Ai-je besoin d'un agent de navigateur pour le scraping ?
Uniquement pour les tâches qui exigent un vrai état de connexion, un contenu qui n'apparaît qu'après interaction, une exécution visible ou une reprise en main humaine en cours de flux. Pour les pages qui renvoient leur contenu en HTTP, ou les sites dotés d'une API officielle, un agent de navigateur ajoute du coût sans apporter de capacité.
Si vous voulez essayer la voie de l'agent de navigateur sur une tâche de scraping qui la nécessite vraiment, ego (lite) est gratuit à télécharger, et les pages scraper de prix et scraper SERP décrivent deux cas concrets de bout en bout.