

JavaScript वेब स्क्रैपिंग अक्सर इसलिए फेल नहीं होती कि कोड गलत है, बल्कि इसलिए होती है कि गलत एक्सेस रूट चुना गया। अगर डेटा पहले से शुरुआती HTML में मौजूद है, तो Node.js fetch और एक HTML पार्सर काफी है। ब्राउज़र की ज़रूरत तभी पड़ती है जब डेटा दिखने से पहले पेज को JavaScript चलाना, पेजिनेट करना, क्लिक करना या किसी और तरह से इंटरैक्ट करना पड़े। यही स्टैटिक HTML और रेंडर किए गए पेजों के बीच की विभाजक रेखा है।
Playwright उन वर्कफ़्लो के लिए बहुत उपयुक्त है जो पहले से तय हों और बार-बार दोहराए जाते हों: पेज खोलें, किसी एलिमेंट का इंतज़ार करें, किसी कंट्रोल पर क्लिक करें, फ़ील्ड निकालें और वही रास्ता फिर चलाएँ। दिक्कत तब शुरू होती है जब पेज की संरचना, पेजिनेशन या इंटरैक्शन फ़्लो बदल जाता है और सेलेक्टर तथा एक्शन का तय क्रम टूटने लगता है।
यहीं ego (lite) जैसा एजेंट-चालित ब्राउज़र ज़्यादा बेहतर बैठता है। यह मानने के बजाय कि पुराना रास्ता अब भी मौजूद है, एजेंट मौजूदा रेंडर किए गए पेज को देख सकता है, तय कर सकता है कि आगे क्या करना है, और नेविगेशन या गतिशील बदलावों के बाद भी विश्वसनीय तरीके से काम जारी रख सकता है।
आखिर क्या तय करता है कि JavaScript स्क्रैपर काम करेगा या नहीं?
नतीजा एक्सेस रूट तय करता है। एक ही टारगेट साइट HTTP से तुच्छ स्तर पर स्क्रैप हो सकती है और HTTP के लिए पूरी तरह अपारदर्शी भी हो सकती है, यह इस बात पर निर्भर करता है कि डेटा शुरुआती HTML प्रतिक्रिया में आता है या ब्राउज़र में चल रही JavaScript बाद में उसे fetch करके पेंट करती है।
इसलिए पहला काम स्क्रैपर लिखना नहीं है। पहला काम है टारगेट पेज खोलना, रेंडर किए गए DOM के बजाय सोर्स देखना, और यह पता लगाना कि जो वैल्यू आप चाहते हैं वे असल में कहाँ रहती हैं। इस गाइड का बाकी सब कुछ इसी जवाब से निकलता है।
आपके टारगेट को तीन एक्सेस रूट में से कौन सा चाहिए?
तीन रूट लगभग हर स्क्रैपिंग काम को कवर कर लेते हैं, और ये लागत के क्रम में हैं। स्टैटिक HTML सबसे सस्ता और सबसे तेज़ है। पेज जिस JSON एंडपॉइंट को पहले से कॉल करता है, वह अक्सर सबसे साफ़ डेटा देता है। असली ब्राउज़र सबसे सक्षम है और CPU, मेमोरी तथा नाज़ुकपन के लिहाज़ से सबसे महँगा।
| रूट | यह क्या कर सकता है | यह क्या नहीं कर सकता |
|---|---|---|
| HTTP अनुरोध + HTML पार्सर | किसी भी URL को सीधे fetch करें, प्रतिक्रिया का बॉडी पढ़ें और लौटाए गए मार्कअप को क्वेरी करें। एक प्रोसेस में प्रति मिनट हज़ारों पेज निपटाता है और इसे ब्राउज़र बाइनरी की ज़रूरत नहीं होती। | पेज की स्क्रिप्ट चलाना, क्लिक करना, स्क्रॉल करना या फ़ॉर्म भरना संभव नहीं। क्लाइंट-रेंडर पेज पर यह खाली शेल लौटाता है, क्योंकि डेटा प्रतिक्रिया में कभी था ही नहीं। |
| सीधा JSON एंडपॉइंट | बिना मार्कअप पार्सिंग के संरचित डेटा लौटाता है, इसलिए पेज का लेआउट नया सिरे से बनने पर भी फ़ील्ड नाम बचे रहते हैं। सबसे छोटा पेलोड, सबसे तेज़ पार्स। | साइट अपडेट के साथ स्थिर नहीं रहता। ये एंडपॉइंट आंतरिक और अनडॉक्युमेंटेड होते हैं, और बिना सूचना के बदल सकते हैं या अनुरोध ठुकराने लग सकते हैं। |
| असली ब्राउज़र ऑटोमेशन | पेज की JavaScript चलाता है, कंटेंट आने का इंतज़ार करता है, और रेंडर किए गए नतीजे के साथ ठीक वैसे ही इंटरैक्ट करता है जैसे कोई व्यक्ति करता। | सस्ते में स्केल करना संभव नहीं। हर ब्राउज़र कॉन्टेक्स्ट असली मेमोरी लेता है, और इनका झुंड HTTP लूप से कहीं ज़्यादा इंफ़्रास्ट्रक्चर माँगता है। |
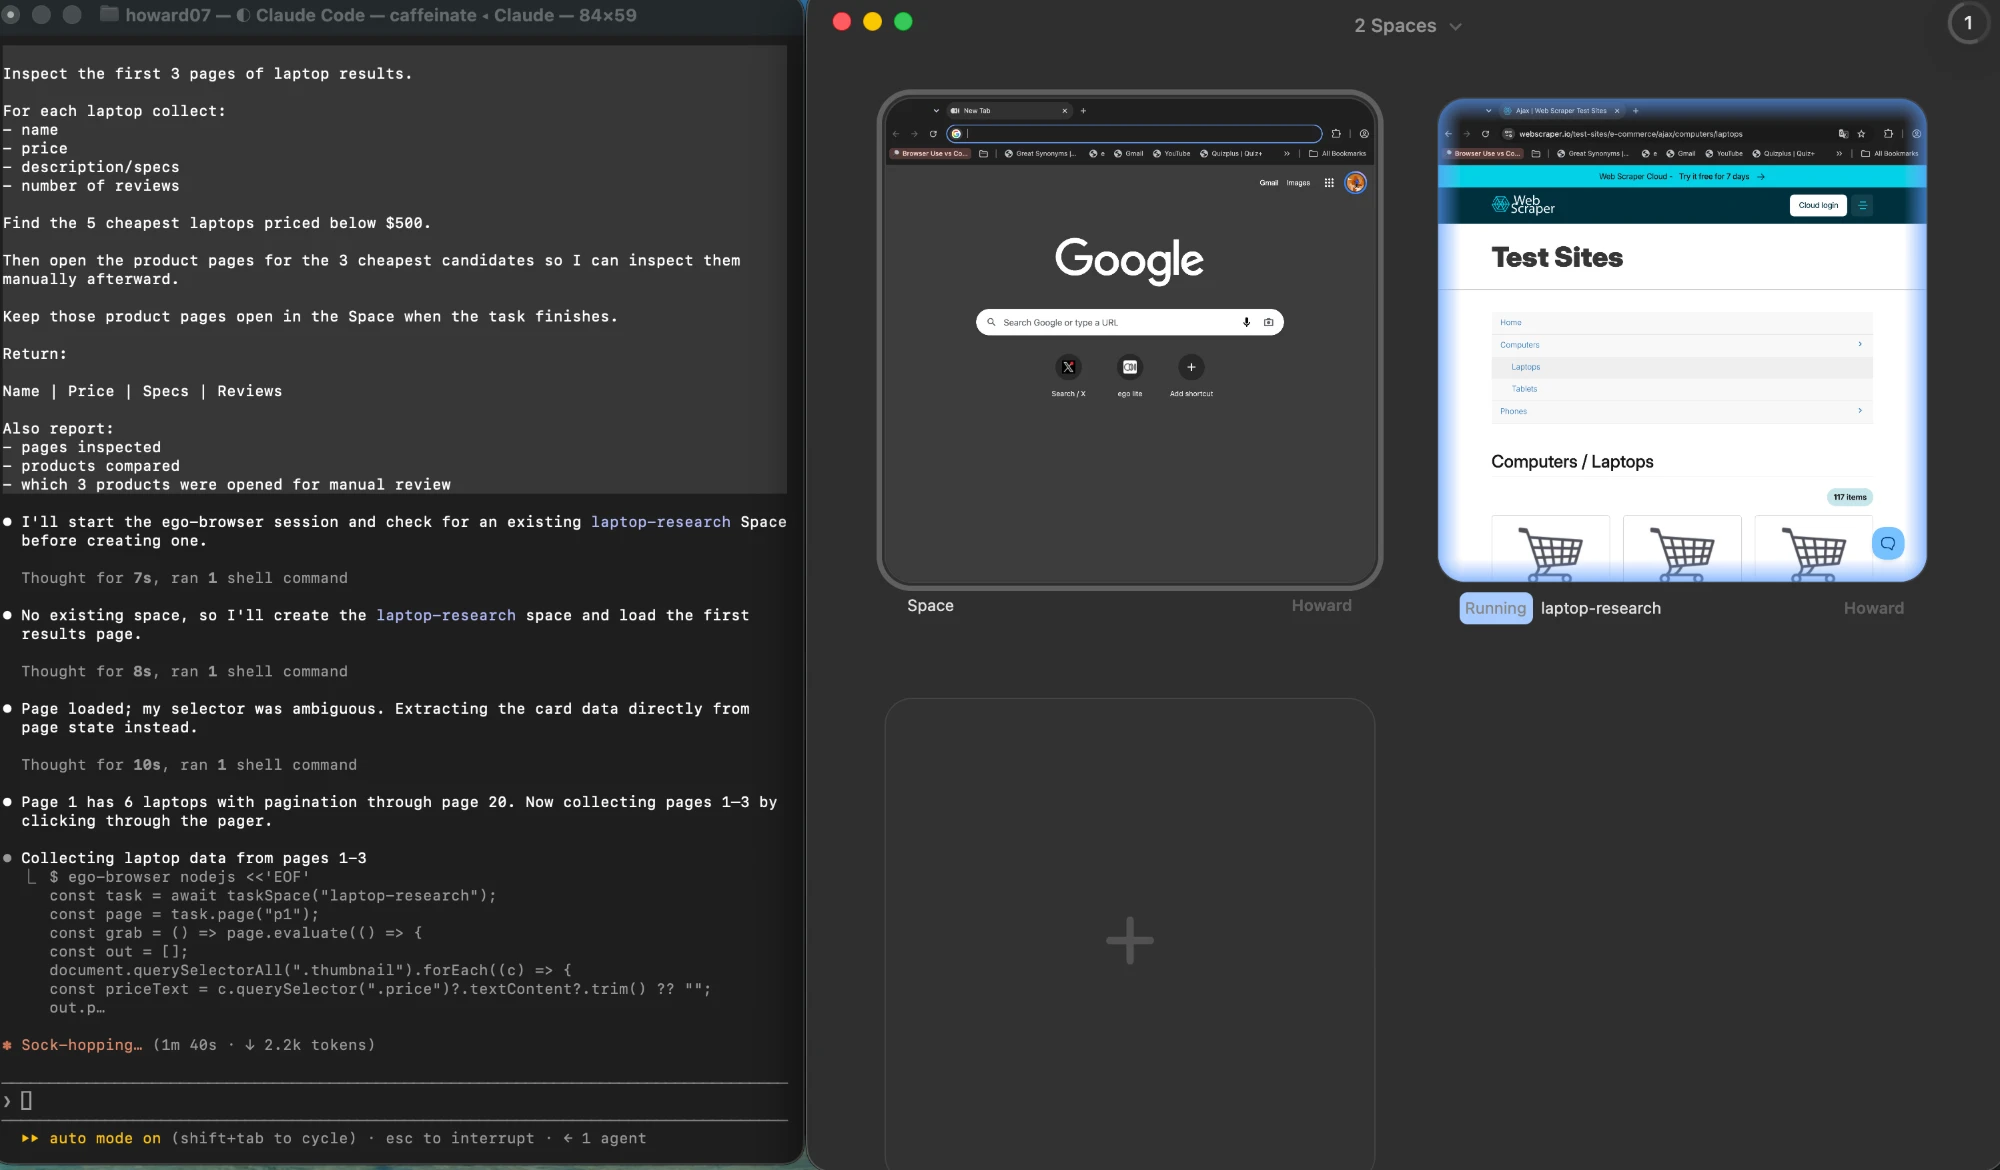
Node.js में स्टैटिक HTML को fetch और पार्स कैसे करें?
प्लेटफ़ॉर्म से शुरू करें। Node.js, Fetch API को ग्लोबल के रूप में देता है, इसलिए एक अनुरोध के लिए किसी डिपेंडेंसी की ज़रूरत ही नहीं। नीचे का पैटर्न पूरा पहला रूट है: अनुरोध करें, स्टेटस जाँचें, टेक्स्ट पढ़ें, फिर मार्कअप पार्सर को सौंप दें।
अनुरोध को खुद प्लेटफ़ॉर्म से आगे कुछ नहीं चाहिए, क्योंकि Fetch API, Node.js में ग्लोबल के रूप में पहले से मौजूद है, इसलिए एक सामान्य GET के लिए इंस्टॉल करने वाली कोई HTTP लाइब्रेरी नहीं होती।
स्टेटस जाँच वह हिस्सा है जिसे लोग सबसे पहले हटाते हैं और सबसे ज़्यादा भूलते हैं। 404 या bot-block पेज भी बॉडी लौटाता है, और वह बॉडी आराम से शून्य मैचिंग एलिमेंट में पार्स हो जाती है, जो बिल्कुल सेलेक्टर बग जैसा दिखता है।
const res = await fetch(url, {
  headers: { "user-agent": "my-scraper/1.0 (+contact@example.com)" },
});

if (!res.ok) {
  throw new Error(`${res.status} ${res.statusText} for ${url}`);
}

const html = await res.text();
रेट लिमिटिंग उसी लूप का हिस्सा होनी चाहिए, बाद में जोड़ी गई चीज़ नहीं। अनुरोधों के बीच एक awaited विराम छोटे काम को शिष्ट बनाए रखता है और आपके एड्रेस को blocklist से बाहर रखता है:
const sleep = (ms) => new Promise((r) => setTimeout(r, ms));

for (const url of urls) {
  const html = await getHtml(url);
  await parse(html);
  await sleep(1000);
}
पहला रूट असल में क्या लौटाता है, यह रहा। नीचे की टेबल लैपटॉप की एक सार्वजनिक टेस्ट कैटलॉग पर सामान्य HTTP अनुरोध और एक सेलेक्टर लाइब्रेरी से मिला असली आउटपुट है: कोई ब्राउज़र नहीं, कोई रेंडरिंग चरण नहीं, तीन पेज तीन स्टैटिक प्रतिक्रियाओं के रूप में fetch किए गए।
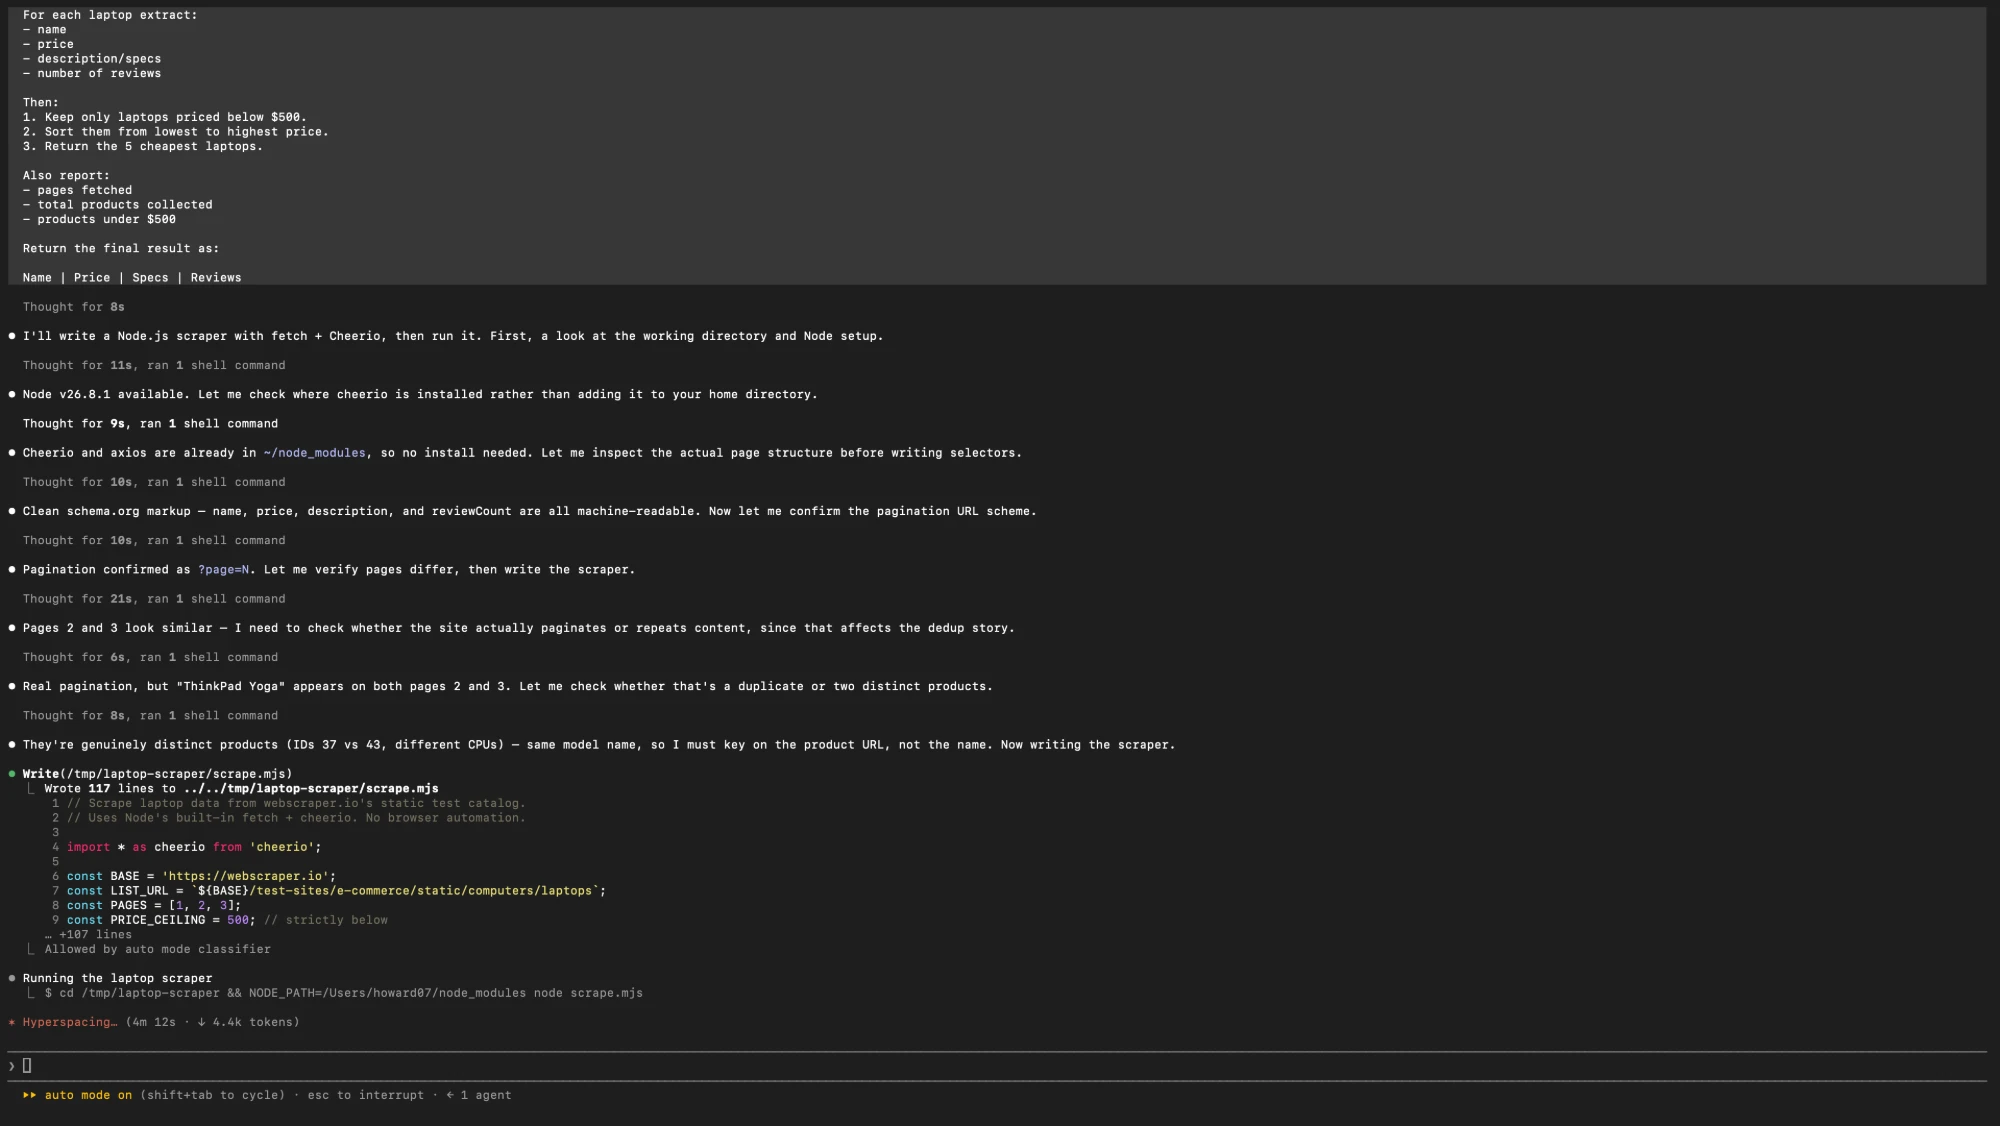
| ID | नाम | कीमत | विनिर्देश | समीक्षाएँ |
|---|---|---|---|---|
| 32 | Aspire E1-510 | $306.99 | 15.6", Pentium N3520 2.16GHz, 4GB, 500GB, Linux | 2 |
| 45 | Asus VivoBook Max | $399 | 15.6" HD, Pentium N4200 1.1GHz, 4GB, 500GB, Windows 10 Home | 4 |
| 31 | Packard 255 G2 | $416.99 | 15.6", AMD E2-3800 1.3GHz, 4GB, 500GB, Windows 8.1 | 2 |
| 46 | Dell Vostro 15 | $488.78 | 15.6" FHD, Core i5-7200U, 4GB, 128GB SSD, Radeon R5 M420 2GB, Linux | 14 |
अठारह में से चार प्रोडक्ट $500 से कम में आते हैं। इस कैटलॉग पर रूट एक का पूरा नतीजा यही है: तीन अनुरोध, कोई रेंडरिंग नहीं, कोई ब्राउज़र प्रोसेस नहीं। और ईमानदारी यहीं से शुरू होती है, क्योंकि इस टेबल में वह चीज़ नहीं है जिसे पाठक देखने की उम्मीद करेगा।
Cheerio, DOMParser या jsdom: कौन सा पार्सर फिट बैठता है?
इन तीनों की तुलना ऐसे की जाती है जैसे ये एक-दूसरे की जगह ले सकने वाली लाइब्रेरी हों। ये नहीं हैं, क्योंकि इनके वादे अलग-अलग हैं: इनमें से दो क्वेरी के लिए मार्कअप पार्स करती हैं, और एक स्क्रिप्ट एग्ज़िक्यूशन के साथ DOM लागू करती है।
इस गाइड में जिस पार्सर का सहारा लिया गया है, उसका डॉक्यूमेंटेशन cheerio.js.org पर है, जहाँ साफ़ लिखा है कि Cheerio पेज स्क्रिप्ट चलाने के बजाय मार्कअप पार्स और क्वेरी करता है।
| विकल्प | यह क्या कर सकता है | यह क्या नहीं कर सकता |
|---|---|---|
| Cheerio | HTML स्ट्रिंग को तेज़ी से पार्स करें और jQuery-शैली सेलेक्टर से क्वेरी करें। छोटी डिपेंडेंसी, कोई ब्राउज़र नहीं, प्रतिक्रिया के बॉडी से कुछ सौ फ़ील्ड निकालने के लिए आदर्श। | पेज की स्क्रिप्ट चलाना, कंपोनेंट रेंडर करना या लेआउट हल करना संभव नहीं। यह मार्कअप पार्स करता है; ब्राउज़र की तरह व्यवहार नहीं करता। |
| jsdom | Node.js में document, window और स्क्रिप्ट एग्ज़िक्यूशन के साथ एक DOM इम्प्लीमेंटेशन देता है, इसलिए ब्राउज़र APIs के लिए लिखा कोड बिना बदलाव चलता है। | रेंडरिंग या फ़िडेलिटी में असली ब्राउज़र की बराबरी नहीं करता, और हर पेज पर कहीं ज़्यादा भारी है। यह DOM का विकल्प है, Chrome नहीं। |
| DOMParser | इनबिल्ट ब्राउज़र API की मदद से स्ट्रिंग को क्वेरी करने योग्य document में बदलें, और प्रोजेक्ट में कोई डिपेंडेंसी जोड़नी ही न पड़े। | इसे await नहीं किया जा सकता: यह सिंक्रोनस और ब्लॉकिंग है, और Node.js में यह हाल के वर्शनों में ही ग्लोबल बना है। |
Cheerio से पढ़ने में परिचित सेलेक्टर API काम आता है। ध्यान दें कि निकाला गया टेक्स्ट किनारों से trim किया जाता है, क्योंकि स्क्रैप किए गए मार्कअप में इंडेंटेशन और newline होते हैं जो वरना आपके डेटासेट में दिखने लगेंगे:
import * as cheerio from "cheerio";

const $ = cheerio.load(html);
const items = $(".product-card").map((i, el) => ({
  name: $(el).find(".name").text().trim(),
  price: $(el).find(".price").text().trim(),
})).get();
वही एक्सट्रैक्शन DOMParser के साथ ऐसा दिखता है, और यह सिर्फ वहीं चलता है जहाँ वह ग्लोबल मौजूद हो:
const doc = new DOMParser().parseFromString(html, "text/html");
const rows = [...doc.querySelectorAll("table tbody tr")].map((tr) => ({
  cells: [...tr.querySelectorAll("td")].map((td) => td.textContent.trim()),
}));
पेज पहले से जिस JSON एंडपॉइंट का उपयोग करता है, उसे कैसे खोजें?
एक भी सेलेक्टर लिखने से पहले ब्राउज़र का network panel खोलें, fetch और XHR पर फ़िल्टर करें, पेज रीलोड करें और देखें कि वापस क्या आया। कई डेटा-चालित साइटें दिखने वाला पेज कुछ ही JSON प्रतिक्रियाओं से जोड़ती हैं, जिन्हें मार्कअप की तुलना में कहीं आसानी से इस्तेमाल किया जा सकता है।
जब कोई एंडपॉइंट मिल जाए, तो उस अनुरोध को अक्सर वही headers चाहिए जो पेज ने भेजे थे, और कभी-कभी एक सत्र कुकी भी। इसे हाथ से दोबारा जोड़ने के बजाय network panel के copy-as-fetch आउटपुट से दोहराएँ।
const res = await fetch("https://example.com/api/listings?page=1", {
  headers: { accept: "application/json" },
});

if (!res.ok) throw new Error(`${res.status} for listings page 1`);

const { items } = await res.json();क्लाइंट-रेंडर पेज खाली शेल क्यों लौटाता है?
क्लाइंट-रेंडर पेज ऐसा मार्कअप भेजता है जिसमें लगभग कोई कंटेंट नहीं होता। शुरुआती प्रतिक्रिया में एक root एलिमेंट, स्क्रिप्ट का बंडल और शायद एक loading state होता है। व्यक्ति को स्क्रीन पर जो टेक्स्ट दिखता है वह प्रतिक्रिया आने के बाद JavaScript बनाती है, इसलिए सिर्फ प्रतिक्रिया पढ़ने वाले HTTP अनुरोध के पास पढ़ने को कुछ नहीं होता।
यह रहस्यमय नहीं, पहचानने योग्य है। दो जाँचें ज़्यादातर मामले पकड़ लेती हैं: प्रतिक्रिया में दिखने वाला टेक्स्ट ब्राउज़र जो दिखाता है उसका छोटा-सा हिस्सा है, और मार्कअप में script टैग हावी हैं:
const text = html.replace(/<script[\s\S]*?<\/script>/g, "").replace(/<[^>]+>/g, " ").replace(/\s+/g, " ").trim();

console.log({
  textLength: text.length,
  scriptCount: (html.match(/<script\b/g) ?? []).length,
  hasRoot: /id="(root|app|__next)"/.test(html),
});
कम टेक्स्ट, बहुत सारी स्क्रिप्ट और खाली root div मिलकर बताते हैं कि ईमानदार जवाब तीसरा रूट है। बिना किसी script टैग के कुछ दर्जन कैरेक्टर टेक्स्ट आमतौर पर कुछ ज़्यादा सरल बताता है: अनुरोध ब्लॉक हुआ, या आपने गलत URL माँगा।
व्यवहार में यह फ़र्क कैसा दिखता है:
| HTTP प्रतिक्रिया में संकेत | इसका आमतौर पर क्या मतलब है | अगला कदम |
|---|---|---|
| पूरा कंटेंट, असली मार्कअप | पेज सर्वर ने रेंडर किया है। और कुछ नहीं चाहिए। | इसे सेलेक्टर लाइब्रेरी से पार्स करें। |
| root div और बहुत सारी स्क्रिप्ट | क्लाइंट-साइड रेंडरिंग। कंटेंट प्रतिक्रिया के बाद आता है। | JSON एंडपॉइंट खोजें, या पेज रेंडर करें। |
| बहुत कम टेक्स्ट, कोई स्क्रिप्ट नहीं | ब्लॉक, रीडायरेक्ट, या पूरी तरह गलत URL। | पार्स करने से पहले status, final URL और headers लॉग करें। |
Playwright असली ब्राउज़र पेज को कैसे स्क्रैप करता है?
Playwright असली ब्राउज़र चलाता है, इसलिए पेज ठीक वैसे ही एक्ज़ीक्यूट होता है जैसे किसी विज़िटर के लिए होता। स्क्रैपिंग का ढाँचा ज़्यादातर लोगों की उम्मीद से छोटा है: एक कॉन्टेक्स्ट खोलें, URL पर जाएँ, जो चीज़ चाहिए उसका इंतज़ार करें, फिर उसे पढ़ लें।
यहाँ जिस API सतह का उपयोग किया गया है, उसका डॉक्यूमेंटेशन playwright.dev पर है, जो ब्राउज़र, कॉन्टेक्स्ट और locator लॉन्च करने का प्रामाणिक संदर्भ है।
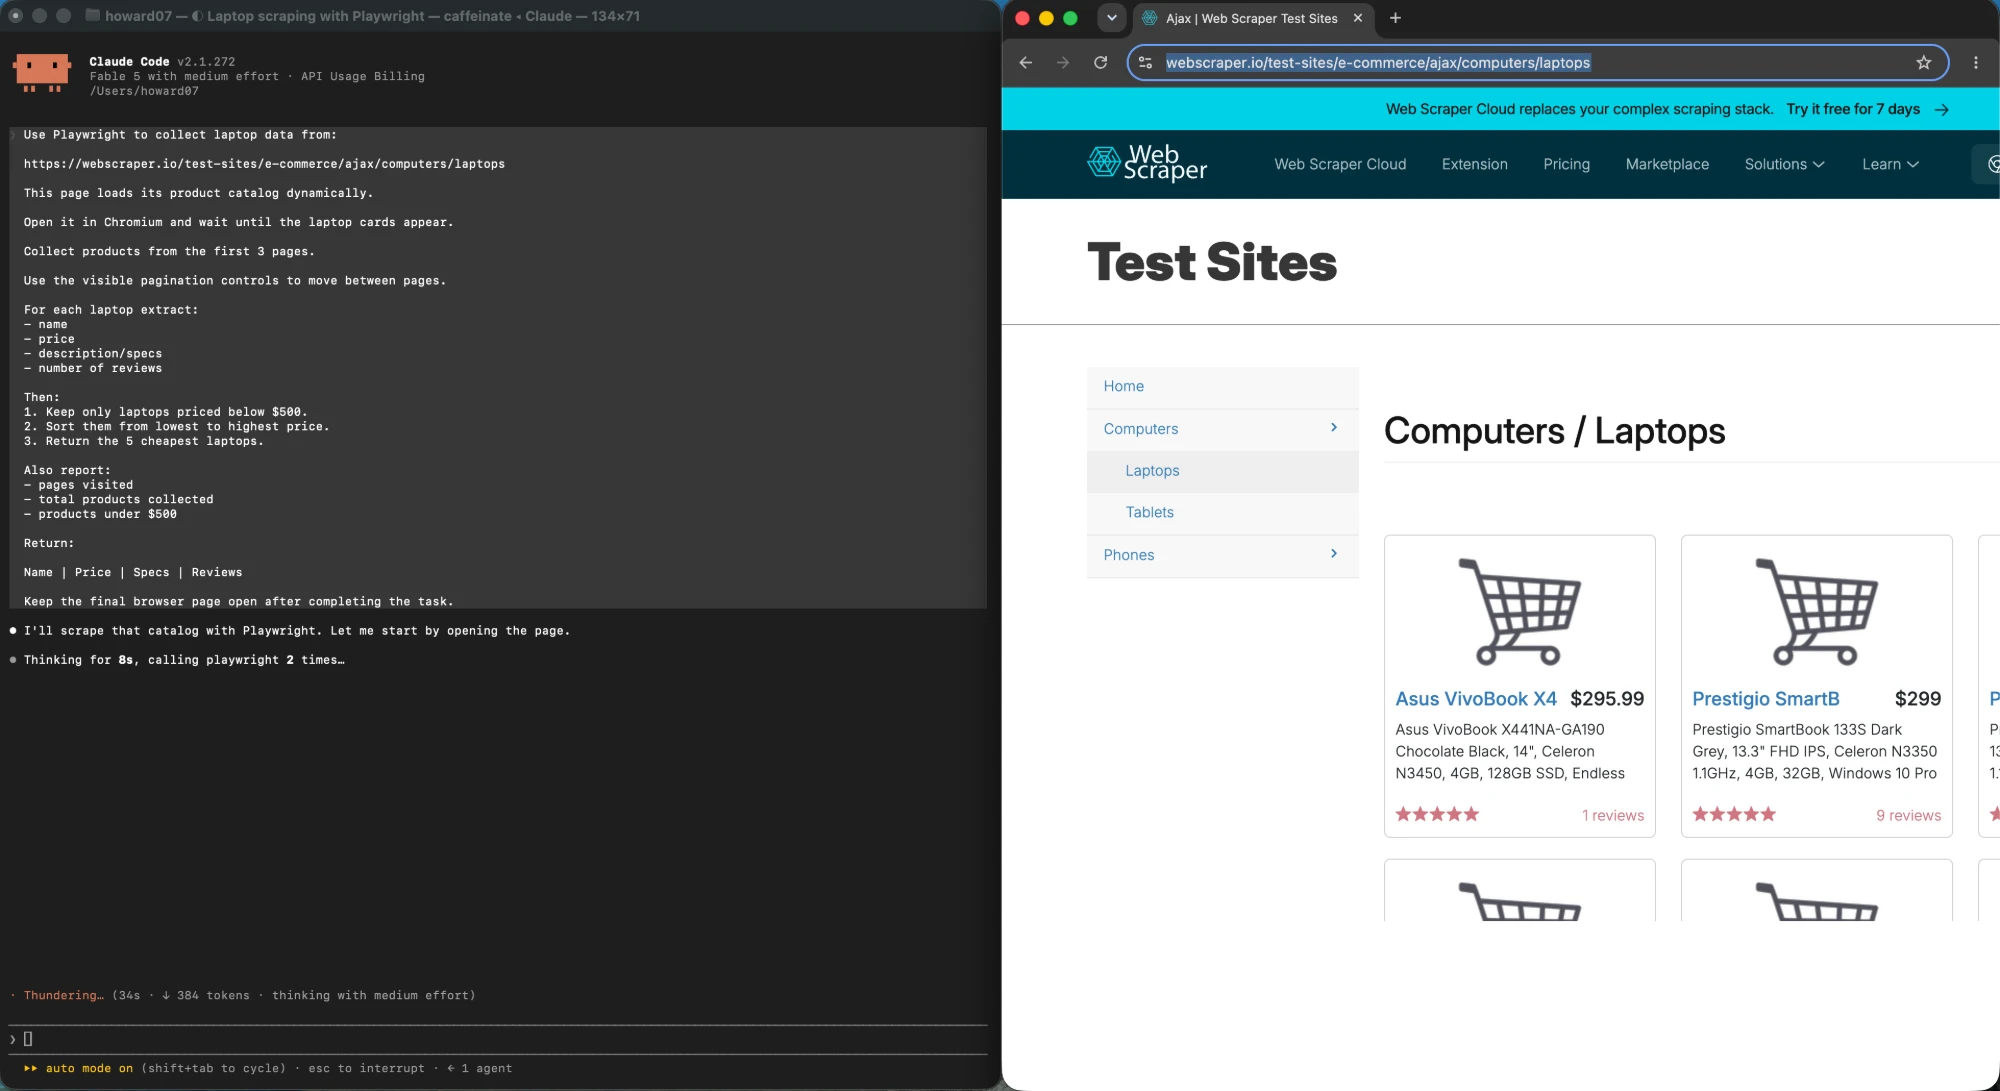
नीचे का retrieval पैटर्न एक सेलेक्टर का इंतज़ार करता है और फिर page.evaluate से डेटा निकालता है, जो आपके फ़ंक्शन को पेज के अंदर चलाता है और serializable नतीजा लौटाता है:
import { chromium } from "playwright";

const browser = await chromium.launch();
const context = await browser.newContext();

try {
  const page = await context.newPage();
  await page.goto(url, { waitUntil: "domcontentloaded" });
  await page.waitForSelector(".product-card");

  const rows = await page.evaluate(() =>
    [...document.querySelectorAll(".product-card")].map((el) => ({
      name: el.querySelector(".name")?.textContent?.trim() ?? null,
      price: el.querySelector(".price")?.textContent?.trim() ?? null,
    })),
  );

  console.log(rows);
} finally {
  // contexts hold the memory; close it even when the scrape throws
  await context.close();
  await browser.close();
}
दो lifecycle बातें सेलेक्टर से ज़्यादा मायने रखती हैं। कॉन्टेक्स्ट सस्ती disposable इकाई है, इसलिए एक ब्राउज़र कई अलग-अलग रन संभाल सकता है, और हर एक का अंत close से होता है। दूसरी बात यह है कि पेज पर टेक्स्ट एक्सट्रैक्शन टेक्स्ट नोड लौटाता है, रेंडर की गई वैल्यू नहीं: CSS से छिपा कंटेंट भी DOM में रहता है और आपके आउटपुट में आता रहेगा।
जब टारगेट पूरी लिस्ट के बजाय कोई खास एलिमेंट हो, तो locators ज़्यादा साफ़ retrieval रास्ता हैं। Playwright का अपना locator डॉक्यूमेंटेशन कहता है कि बटन, लिंक और इनपुट के लिए क्लिक का इंतज़ार ज़रूरी नहीं है, और हर इंटरैक्शन को स्पष्ट wait में लपेटने से पहले यह याद रखना चाहिए:
const title = await page.getByRole("heading", { level: 1 }).innerText();
const price = await page.locator("[data-testid=price]").innerText();
सत्र, ब्लॉक का जोखिम और CAPTCHA योजना को कैसे बदलते हैं?
जिस पल टारगेट को लॉगिन चाहिए, स्क्रैपर डेटा का अभ्यास नहीं रह जाता और सत्र-प्रबंधन की समस्या बन जाता है। Playwright इसे सीधे सपोर्ट करता है: एक बार authenticate करें, ब्राउज़र की storage state किसी फ़ाइल में सेव करें, और हर बार क्रेडेंशियल entry स्क्रिप्ट करने के बजाय आगे के रनों में उसे दोबारा इस्तेमाल करें।
// once, interactively
await context.storageState({ path: "auth.json" });

// later runs
const context = await browser.newContext({ storageState: "auth.json" });
इससे दो ऑपरेशनल बातें निकलती हैं। सेव की गई session state एक क्रेडेंशियल है, इसलिए उसकी जगह secrets store है, रिपॉज़िटरी नहीं। और सेव किया सत्र समाप्त हो जाता है, इसलिए अचानक login पेज लौटाने लगा रन सत्र की समस्या है, सेलेक्टर की नहीं।
उस state को लॉन्च के बीच जीवित रखना अपने आप में एक अलग विषय है: एजेंट रनों में बने रहने वाले पर्सिस्टेंट ब्राउज़र सत्र में इस पर विस्तार से बात की गई है।
आम तौर पर ऑटोमेटेड ट्रैफ़िक के लिए तीन बाधाएँ तय करती हैं कि आपका यह स्क्रैपिंग का काम है या हारी हुई लड़ाई: साइट के robots निर्देश और शर्तें क्या इजाज़त देते हैं, साइट कौन सी दर प्रकाशित करती है या सहती है, और आपको वापस जो प्रतिक्रिया मिलती है वह कंटेंट है या challenge पेज। ये कोड लिखने से पहले तय करने वाले policy सवाल हैं, और इन्हें हमारी गाइड में ज़्यादा गहराई से समझाया गया है: लॉगिन दीवारों के पीछे की स्क्रैपिंग.
प्रोडक्शन में JavaScript स्क्रैपर को क्या तोड़ता है?
स्क्रैपर शायद ही इसलिए फेल होते हैं कि सेलेक्टर गलत था। वे दूसरे रन पर, सौवें URL पर फेल होते हैं, जब कोई पेज धीमा हो, कोई प्रतिक्रिया रीडायरेक्ट हो, या साइट throttle करने लगे। इसके समाधान बिना तड़क-भड़क वाले और बहुत खास होते हैं।
async function getWithRetry(url, attempt = 0) {
  const res = await fetch(url);
  if (res.status === 429 || res.status >= 500) {
    if (attempt >= 3) throw new Error(`giving up on ${url}`);
    const retryAfter = Number(res.headers.get("retry-after"));
    const waitMs = Number.isFinite(retryAfter)
      ? retryAfter * 1000
      : 2 ** attempt * 1000;
    await new Promise((r) => setTimeout(r, waitMs));
    return getWithRetry(url, attempt + 1);
  }
  if (!res.ok) throw new Error(`${res.status} for ${url}`);
  return res.text();
}
कंकरेंसी दूसरा जाल है। एक मशीन पर दस समानांतर ब्राउज़र कॉन्टेक्स्ट ज़्यादातर एक ही CPU के लिए होड़ करेंगे, इसलिए throughput का फ़ायदा मेमोरी की लागत से कम होगा, और साइट को बूँद-बूँद के बजाय एक झटका दिखेगा। क्रम से शुरू करें, नापें, और तभी संख्या बढ़ाएँ जब टारगेट सह ले।
तीसरी बात यह है कि बिना वादे वाले एंडपॉइंट को पढ़ने वाले हर स्क्रैपर को fallback चाहिए। दिखने वाले पेज का सेलेक्टर-आधारित पार्स कोडबेस में रखें, और फेल हुई JSON कॉल को उस पर गिरने दें, ताकि ऊपर की कोई चुपचाप हुई तब्दीली रन को खाली करने के बजाय उसकी गुणवत्ता थोड़ी घटाए।
असली ब्राउज़र की असल में ज़रूरत कब होती है?
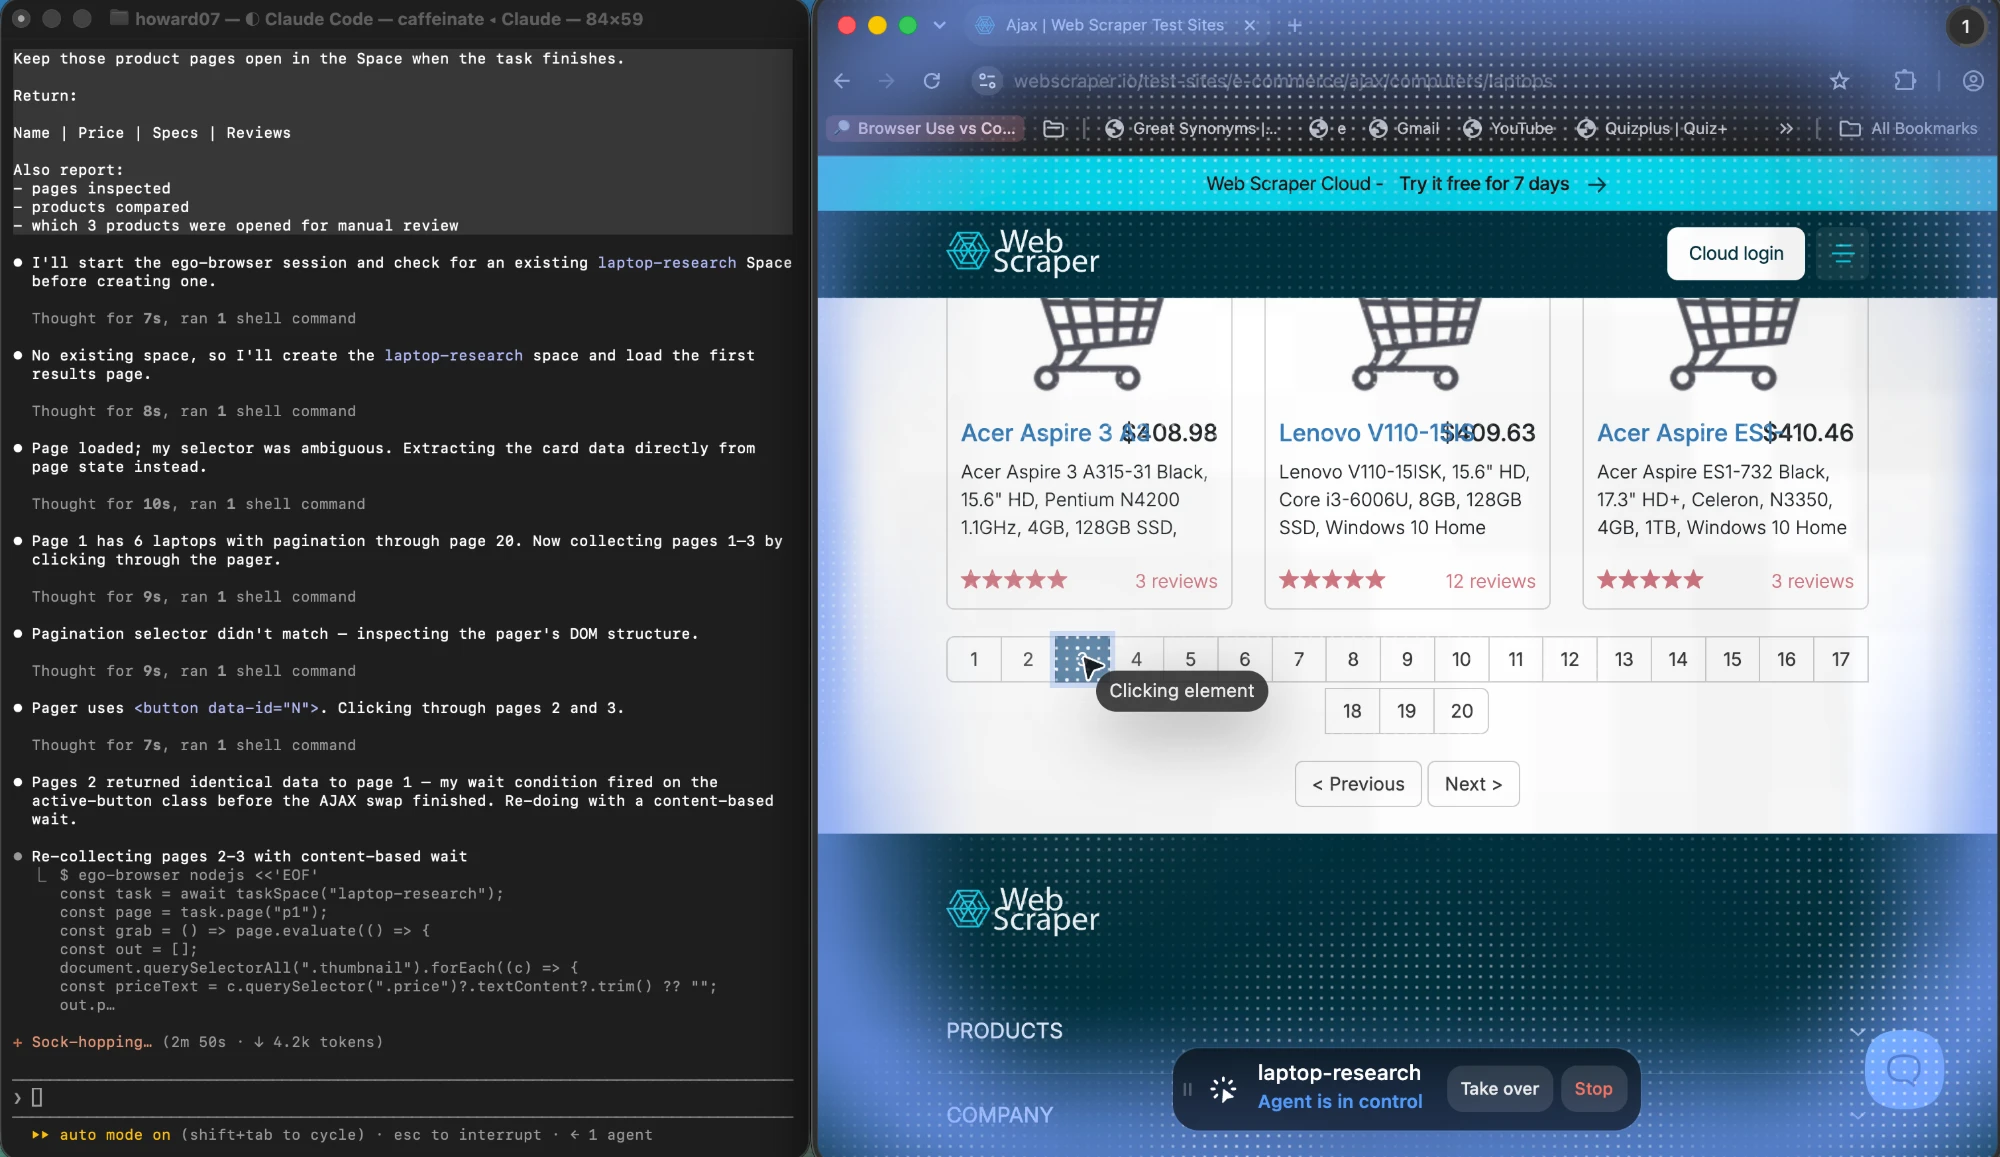
असली ब्राउज़र तब सही जवाब है जब काम को ऐसी चीज़ चाहिए जो सिर्फ ब्राउज़र दे सकता है: आपकी मशीन पर पहले से मौजूद authenticated सत्र, ऐसा कंटेंट जो इंटरैक्शन के बाद ही दिखता है, ऐसा फ़्लो जिसमें बीच में किसी व्यक्ति को आना पड़े, या ऐसा नतीजा जिसे fetch करने के बजाय होते हुए देखना पड़े। इन मामलों के बाहर, पार्सर के साथ HTTP तेज़, सस्ता और चलाए रखने में आसान है।
हेडलेस ब्राउज़र और असली ब्राउज़र के बीच के ट्रेड-ऑफ़ को यहाँ समझाया गया है: AI एजेंट्स के लिए हेडलेस ब्राउज़र बनाम असली ब्राउज़र.
यही वह स्थिति है जहाँ कार्य-चालित ब्राउज़र एजेंट लाना लायक बनता है। ego (lite) एजेंट-चालित काम के लिए बना ब्राउज़र है: आप मकसद बताते हैं, और यह असली ब्राउज़र में काम करता है, उन लॉगिन किए गए सत्रों सहित जो आपने पहले से खुले रखे हैं, और एक दिखने वाले इंटरफ़ेस के साथ जिसे आप तब अपने हाथ में ले सकते हैं जब किसी चरण में मानवीय फ़ैसला चाहिए। ऐसे स्क्रैपिंग कामों के लिए जिन्हें असली login state, गतिशील पेज, दिखती हुई execution या मानवीय हैंडऑफ़ चाहिए, यह ऊपर बताई गई सत्र जोड़ने की मेहनत हटा देता है। यह Playwright का विकल्प नहीं है, और हर साइट के बारे में कोई वादा नहीं करता: challenge के साथ जवाब देने वाले, या ऑटोमेटेड एक्सेस मना करने वाले पेज इसके लिए भी वैसे ही वर्जित हैं जैसे किसी और रूट के लिए। जहाँ सामान्य HTTP अनुरोध या आधिकारिक API पहले से वह दे देता है जो आपको चाहिए, वहाँ ब्राउज़र एजेंट जोड़ना काम को सिर्फ धीमा करेगा।
जब ब्राउज़र वाकई जवाब हो, तो ब्राउज़र टूलिंग की गहरी तुलना के लिए हमारा Playwright बनाम Puppeteer स्क्रैपिंग विश्लेषण लाइब्रेरी के चुनाव को खुद कवर करता है, और AI वेब स्क्रैपर वर्कफ़्लो बताता है कि स्क्रैपर पाइपलाइन में एजेंट कहाँ फिट होते हैं।
मुख्य चुनौतियाँ और सीमाएँ क्या हैं?
इस ढाँचे के हर रूट में एक ऐसा failure mode है जिसे इंजीनियरिंग से दूर नहीं किया जा सकता, और इन्हें पहले से जानना ही उस स्क्रैपर को अलग करता है जो साल भर चलता है उससे जो हफ़्ता भर चलता है।
जब साइट अपना मार्कअप नया सिरे से बनाती है तो स्टैटिक पार्सिंग टूट जाती है। उसके पास इसे नोटिस करने का कोई तरीका नहीं होता, इसलिए खुलकर क्रैश होने से ज़्यादा आम है कोई फ़ील्ड चुपचाप null बन जाना। पाइपलाइन पर भरोसा करने के बजाय हर रन पर एक सैंपल वैलिडेट करें।
आंतरिक JSON एंडपॉइंट बिना किसी चेतावनी के टूट जाते हैं, और किसी भी साइट का सबसे कम वादा वाला हिस्सा यही होता है। आज का सफल रन अगले महीने के बारे में कोई सबूत नहीं है।
ब्राउज़र ऑटोमेशन सबसे वास्तविक है और बड़े पैमाने पर सबसे नाज़ुक भी। मेमोरी कंकरेंसी के साथ बढ़ती है, सत्र समाप्त होते हैं, और anti-bot सिस्टम इरादे के बजाय पैटर्न पर प्रतिक्रिया देते हैं, इसलिए जो तरीका लैपटॉप से चलता है ज़रूरी नहीं वह डेटासेंटर से चले।
और सबसे बड़ी सीमा तकनीकी नहीं है। आप क्या इकट्ठा कर सकते हैं, कितनी बार, और उसके बाद उसका क्या कर सकते हैं, यह साइट की शर्तें, robots निर्देश और आपके क्षेत्राधिकार का कानून तय करते हैं, और कोड चलने भर से इसमें से कुछ नहीं बदलता।
इस सब से निकलने वाला troubleshooting क्रम छोटा है। जब स्क्रैप कुछ न लौटाए, तो पहले status code देखें, फिर देखें कि कंटेंट प्रतिक्रिया में है भी या नहीं, फिर देखें कि सेलेक्टर सोर्स के बजाय रेंडर किए गए DOM से मैच करता है या नहीं। इन तीनों के बाद ही ब्राउज़र पर विचार करना चाहिए।
अक्सर पूछे जाने वाले प्रश्न
क्या Node.js में HTTP अनुरोध करने के लिए किसी लाइब्रेरी की ज़रूरत है?
नहीं। Node.js, Fetch API को ग्लोबल के रूप में देता है, इसलिए fetch बिना कुछ इंस्टॉल किए उपलब्ध है, साथ में response ऑब्जेक्ट और उसके ok, status तथा text() मेंबर भी। जिसकी ज़रूरत पड़ती है वह पार्सर है, क्योंकि fetch एक स्ट्रिंग लौटाता है और HTML पर स्ट्रिंग मैचिंग मार्कअप बदलते ही टूट जाती है।
ब्राउज़र में ठीक दिखने वाले पेज से मेरा स्क्रैपर खाली लिस्ट क्यों लौटाता है?
सबसे संभावित कारण यह है कि पेज क्लाइंट-रेंडर है और डेटा HTTP प्रतिक्रिया में कभी था ही नहीं। पुष्टि के लिए raw प्रतिक्रिया के दिखने वाले टेक्स्ट की तुलना ब्राउज़र जो दिखाता है उससे करें, और कंटेंट के मुकाबले script टैग गिनें। अगर प्रतिक्रिया एक शेल है, तो साइट के JSON एंडपॉइंट पर जाएँ या पेज को असली ब्राउज़र में रेंडर करें।
क्या Cheerio, हेडलेस ब्राउज़र का विकल्प है?
नहीं। Cheerio HTML पार्स करता है और आपको सेलेक्टर से क्वेरी करने देता है। यह JavaScript नहीं चलाता, इसलिए वह कंटेंट नहीं बना सकता जो पेज लोड के बाद जनरेट करता है। यह पहले रूट के लिए सही टूल है और तीसरे के लिए गलत, और जहाँ Cheerio काफी हो वहाँ ब्राउज़र की ओर हाथ बढ़ाना स्क्रैपिंग कोड की सबसे आम गैर-ज़रूरी लागत है।
मुझे कैसे पता चले कि पेज सर्वर-रेंडर है या क्लाइंट-रेंडर?
URL का अनुरोध करें और रेंडर किए गए DOM के बजाय raw प्रतिक्रिया देखें। अगर आपकी चाही हुई वैल्यू प्रतिक्रिया के बॉडी में मौजूद हैं, तो पेज सर्वर-रेंडर है और सस्ता रूट चल जाएगा। अगर बॉडी में एक root एलिमेंट, स्क्रिप्ट बंडल और बहुत कम टेक्स्ट है, तो कंटेंट ब्राउज़र में जोड़ा जा रहा है।
जिस पेज पर लॉगिन ज़रूरी हो उसे कैसे स्क्रैप करें?
ब्राउज़र कॉन्टेक्स्ट में एक बार लॉगिन करें, storage state किसी फ़ाइल में सेव करें, और आगे के रनों में वह state लोड करें। उस फ़ाइल को सीक्रेट की तरह रखें, यह मानकर चलें कि वह समाप्त हो जाएगी, और ऐसा सत्र चुनें जिसके उपयोग की आपको अनुमति है। अगर किसी टारगेट को CAPTCHA या ownership check बायपास करना पड़े, तो रुक जाएँ और इसके बजाय कोई आधिकारिक रूट इस्तेमाल करें।
स्क्रैपिंग के लिए Playwright बेहतर है या Puppeteer?
दोनों असली ब्राउज़र चलाते हैं और वही पेज स्क्रैप कर सकते हैं। फ़ैसला लाइब्रेरी की बारीकियों का है, जैसे locator सपोर्ट, इंतज़ार का व्यवहार और language bindings, एक्सेस रूट का नहीं, और यह हमारे Playwright बनाम Puppeteer तुलना में कवर किया गया है। आप जो भी चुनें, इस लेख का रूट फ़ैसला पहले आता है।
मैं एक बार में कितने पेज स्क्रैप कर सकता हूँ?
कंकरेंसी बढ़ाने से पहले क्रम से शुरू करें और नापें। HTTP अनुरोध ब्राउज़र कॉन्टेक्स्ट से कहीं सस्ते में स्केल होते हैं, और एक मशीन पर समानांतर ब्राउज़र ज़्यादातर एक ही CPU के लिए होड़ करते हैं जबकि टारगेट साइट को ट्रैफ़िक का झटका देते हैं। HTTP स्क्रैपिंग के लिए, दर्जनों की तुलना में विराम के साथ चार से आठ एक साथ चलाना ज़्यादा सुरक्षित शुरुआत है।
429 प्रतिक्रिया मिलने पर मुझे क्या करना चाहिए?
Retry-After header पढ़ें और कम से कम उतनी देर इंतज़ार करें, फिर exponential backoff के साथ एक छोटी सीमा तक retry करें और उसके बाद साफ़ तौर पर फेल हो जाएँ। 429 एक रेट संकेत है, ऐसी गलती नहीं जिसे तंग retry लूप में पीटकर पार किया जाए, और इसे नज़रअंदाज़ करने से ही कोई एड्रेस blocklisted हो जाता है।
क्या स्क्रैपिंग कानूनी है?
यह साइट, डेटा, क्षेत्राधिकार और इस पर निर्भर करता है कि आप नतीजे का क्या करते हैं। robots निर्देश और सेवा की शर्तें बताते हैं कि साइट क्या इजाज़त देती है, और व्यक्तिगत डेटा तथा database rights के नियम देश-देश में अलग हैं। इस लेख में कुछ भी कानूनी सलाह नहीं है; बड़े पैमाने पर कुछ भी इकट्ठा करने से पहले शर्तें और लागू कानून देखें।
स्क्रैपिंग के बजाय आधिकारिक API का उपयोग कब करना चाहिए?
जब भी कोई मौजूद हो और आपको चाहिए वाले फ़ील्ड कवर करता हो। डॉक्युमेंटेड API एक स्थिर अनुबंध है, उसमें आमतौर पर स्पष्ट रेट लिमिट होती हैं, और पेज का लेआउट बदलने पर वह नहीं टूटता। स्क्रैपिंग ऐसे डेटा के लिए fallback है जो ब्राउज़र में प्रकाशित होता है और जिसका कोई सपोर्टेड एक्सेस रास्ता नहीं, यह डिफ़ॉल्ट नहीं है।
क्या स्क्रैपिंग के लिए ब्राउज़र एजेंट चाहिए?
सिर्फ उन कामों के लिए जिन्हें असली login state, इंटरैक्शन के बाद दिखने वाला कंटेंट, दिखती हुई execution, या बीच में मानवीय नियंत्रण चाहिए। जो पेज अपना कंटेंट HTTP से लौटाते हैं, या जिन साइटों के पास आधिकारिक API है, उनके लिए ब्राउज़र एजेंट क्षमता बढ़ाए बिना लागत बढ़ाता है।
अगर आप किसी ऐसे स्क्रैपिंग काम पर ब्राउज़र-एजेंट रूट आज़माना चाहते हैं जिसे वाकई उसकी ज़रूरत हो, तो ego (lite) मुफ़्त डाउनलोड करें, और कीमत स्क्रैपर और SERP स्क्रैपर पेज दो ठोस काम शुरू से आख़िर तक समझाते हैं।