Paginare nel web scraping non significa solo arrivare alla pagina successiva. La parte più difficile è sapere se restano ancora dati da raccogliere e quando l'elenco è davvero finito. La maggior parte dei siti usa uno di tre schemi, pagine numerate, Load More o scroll infinito, e ciascuno richiede una strategia di navigazione, una condizione di attesa e una regola di stop diverse. Se sbagli, un crawler può fermarsi in anticipo senza mai lanciare un errore.
Se i dati sono già nell'HTML o in un endpoint JSON, di solito non serve affatto un browser; HTTP semplice è più semplice e più veloce. Un browser diventa utile quando l'elenco dipende dal rendering lato client, da una sessione autenticata, da token generati nella pagina o da uno scorrimento reale. E quando quei dati dipendono da un browser in cui sei già autenticato, ego (lite) consente a un agente AI di eseguire la stessa logica di paginazione dentro quella sessione esistente, invece di ricostruire lo stato di login.
Nelle sezioni seguenti mettiamo alla prova pagine numerate, Load More e scroll infinito con una sola domanda: l'elenco è davvero finito, o il crawler ha semplicemente smesso di chiedere altro? Gli esempi usano un fixture locale ripetibile con 135 righe su pagine numerate, 81 righe renderizzate dietro Load More e un feed infinito di 60 elementi. Alla fine il crawler non si limiterà a paginare: registrerà dove si è fermato, gestirà duplicati e righe mancate e verificherà che i dati raccolti siano completi.
Come capire quale modo di paginazione hai davanti
Tre osservazioni chiudono la classificazione. Cambiare l'URL o fare clic su un link numerato cambia l'insieme dei risultati: è paginazione numerata. Un pulsante la cui etichetta promette altro contenuto aggiunge righe senza cambiare l'URL: è load more. Righe che compaiono mentre scorri, senza un controllo su cui fare clic, sono scroll infinito. Quando una pagina mescola gli schemi, tratta ogni transizione come un modo proprio, invece di costringere un solo ciclo a coprire entrambi.
Un controllo rapido nel browser lo risolve prima che leggere il codice: apri DevTools, osserva il pannello di rete e interagisci una volta. Una richiesta di navigazione con un parametro di pagina è paginazione numerata. Una richiesta JSON o HTML in background scatenata da un clic è load more. Richieste che si ripetono mentre scorri sono scroll infinito, e la risposta di solito contiene il next offset, un dono per un crawler.
Pagine numerate: deriva la regola di URL e fermati nel momento giusto
La paginazione numerata è il modo più amichevole perché lo stato vive nell'URL. Deriva la regola dalle prime tre pagine: quale parametro cambia, se è un numero di pagina o un offset, e se la dimensione di pagina è fissa. La regola deve potersi esprimere come una funzione, e una funzione corretta produce la pagina 4 dalla pagina 3 senza visitare nulla in mezzo.
// Derive once, then verify against page 2 and page 3 before trusting it.
const pageUrl = (n) => `https://example.com/listings?page=${n}`;

let page = 1;
const rows = [];
while (true) {
  await browserPage.goto(pageUrl(page));
  const batch = await browserPage.locator("tr.row").evaluateAll((nodes) =>
    nodes.map((node) => ({
      id: node.dataset.id,
      title: node.querySelector(".title").textContent.trim(),
      price: Number(node.querySelector(".price").textContent.replace(/[^0-9.]/g, "")),
    })),
  );
  if (batch.length === 0) break;
  rows.push(...batch);

  const hasNext = (await browserPage.locator("a#next").count()) > 0;
  if (!hasNext) break;
  page += 1;
}
La fine merita più attenzione di quella che di solito riceve. Un link next assente e un batch vuoto sono entrambi veri segnali di fine; un totale fisso di pagine no, perché gli elenchi crescono e il numero cablato oggi sarà sbagliato il mese prossimo. Nell'esecuzione del fixture, il crawler ha percorso le pagine da 1 a 5, ha raccolto 135 righe in 80 milliseconds e si è fermato quando il link next è scomparso. Una di quelle cinque richieste ha restituito un 503 al primo tentativo, il crawler ha ritentato la stessa pagina una volta e il retry è riuscito.
Due regole tengono onesto il ciclo. Prima, fai una pausa tra le richieste di pagina invece di spararle il più in fretta possibile, e rispetta i termini del sito e il protocollo di esclusione robots descritto in RFC 9309. Seconda, tratta una pagina ripetuta come segnale di stop quando l'elenco dovrebbe essere ordinato, perché una paginazione che ignora i propri parametri può altrimenti girare per sempre.
Load more: fai clic, attendi e deduplica
Load more nasconde lo stato dietro un pulsante, quindi il crawler deve creare da solo la crescita: fai clic, attendi che il conteggio delle righe aumenti davvero, raccogli ciò che è nuovo e ripeti finché il pulsante scompare o smette di cambiare qualsiasi cosa. L'attesa è dove falliscono la maggior parte delle implementazioni. Una pausa fissa capita di funzionare su una connessione veloce e taglia in silenzio l'elenco su una lenta.
await browserPage.goto("https://example.com/listings");

while (true) {
  const button = browserPage.locator("#load-more");
  if ((await button.count()) === 0) break;

  const before = await browserPage.locator("tr.row").count();
  await button.click();
  await browserPage.waitForFunction(
    (n) => document.querySelectorAll("tr.row").length > n,
    before,
    { timeout: 10000 },
  );
}

const rows = await browserPage.locator("tr.row").evaluateAll((nodes) =>
  nodes.map((node) => ({ id: node.dataset.id, title: node.textContent.trim() })),
);
Nell'esecuzione del fixture, quattro batch da venti righe sono arrivati in 273 milliseconds, e l'elenco visibile teneva 81 righe contro un dataset di 80. La riga in più era un duplicato che il fixture pianta per modellare una realtà comune: lo stesso record arriva due volte tra i batch. La riga di stato della pagina stessa leggeva "Loaded 81 of 80", un buon promemoria che il contatore renderizzato dal sito non è una fonte di validazione. Deduplica su un identificatore stabile come il record id della riga, non sul titolo visibile, e rimuoverai esattamente quel duplicato.
Scroll infinito: trigger, stabilità dell'altezza e regole di stop
Lo scroll infinito non ha pulsante né URL, quindi sia il trigger sia la condizione di stop vanno inferiti. Il trigger di solito è un elemento sentinella che entra nel viewport o una soglia di posizione di scorrimento. La condizione di stop è dove serve giudizio, perché l'elenco non annuncia la fine in un modo su cui puoi fare clic.
Vale la pena mostrare un fallimento misurato, perché è il fallimento con cui escono di fabbrica la maggior parte dei crawler. Scorrere una volta fino in fondo e controllare se il conteggio delle righe è cresciuto, senza attendere il rendering del batch successivo, segnala "no growth" subito: il fixture si è fermato a 15 of 60 righe, un batch dentro, mentre la rete aveva già chiesto il batch successivo. Il controllo non sbagliava l'istante; sbagliava a trattare un momento quieto come la fine dell'elenco.
La versione affidabile attende una condizione osservabile, poi conferma la fine su diversi controlli invece che su uno. Scorri, attendi che il conteggio degli elementi cresca o che la pagina dichiari la fine del feed, e solo quando nessuna delle due cose accade per tre controlli consecutivi tratta l'elenco come finito. Nel fixture gli stessi 60 elementi si sono completati in quattro giri di scorrimento con zero stop falsi, e la riga di stato finale leggeva "End of feed (60 of 60)".
let stableChecks = 0;
while (stableChecks < 3) {
  const items = await browserPage.locator("article.post").count();
  await browserPage.evaluate(() => window.scrollTo(0, document.body.scrollHeight));

  const grew = await browserPage
    .waitForFunction(
      (n) =>
        document.querySelectorAll("article.post").length > n ||
        /end of feed/i.test(document.body.innerText),
      items,
      { timeout: 3000 },
    )
    .then(() => true)
    .catch(() => false);

  stableChecks = grew ? 0 : stableChecks + 1;
  if (!grew) await browserPage.waitForTimeout(700);
}
Due dettagli fanno la differenza tra un ciclo stabile e uno instabile. La stabilità dell'altezza va giudicata sul conteggio degli elementi estratti, non sull'altezza del documento, perché immagini lazy e annunci cambiano l'altezza senza aggiungere record. E lo scorrimento deve davvero riattivare il loader del sito: le implementazioni costruite sulla Intersection Observer API scattano sui cambiamenti di intersezione, quindi alternare le posizioni di scorrimento è più affidabile che tenere la pagina in fondo.
Registra lo stato del crawl e riprendi dopo un crash
Tutti e tre i modi condividono un requisito: un'esecuzione deve sopravvivere alla propria interruzione. Scrivi un checkpoint dopo ogni batch completato, con il modo, la posizione e i record raccolti finora, e fai della ripresa il percorso predefinito invece di uno speciale. Sul fixture, il crawl numerato è stato interrotto dopo la pagina 2 con 54 righe nel checkpoint. Un processo nuovo ha letto il checkpoint, ha continuato dalla pagina 3 e ha finito con le stesse 135 righe e 133 id unici di un'esecuzione ininterrotta.
import { readFileSync, writeFileSync } from "node:fs";

const CHECKPOINT = "./crawl-state.json";
const save = (state) => writeFileSync(CHECKPOINT, JSON.stringify(state));
const load = () => {
  try {
    return JSON.parse(readFileSync(CHECKPOINT, "utf8"));
  } catch {
    return { mode: "numbered", lastPage: 0, rows: [] };
  }
};

const state = load();
for (let page = state.lastPage + 1; page <= 5; page += 1) {
  state.rows.push(...(await crawlPage(page)));
  state.lastPage = page;
  save(state); // checkpoint after every page
}
Il checkpoint cambia anche il debug. Quando un crawl produce davvero un conteggio sbagliato, puoi ispezionare il file di stato invece di rieseguire tutto il lavoro, e la posizione registrata lì ti dice quale batch richiedere di nuovo.
Duplicati, righe mancate e false ultime pagine
Tre sintomi coprono la maggior parte dei bug di paginazione, e ciascuno ha una firma nei dati invece che nel codice. I duplicati compaiono quando un batch si sovrappone al vicino, il che accade quando l'elenco sottostante si riordina tra le richieste, così l'identificatore stabile si ripete. Il fixture l'ha riprodotto esattamente: lo stesso id è apparso una volta a pagina 2, di nuovo a pagina 3 e ancora dentro pagina 5. Entrambi i duplicati sono scomparsi con una deduplica basata su id.
Le righe mancate di solito significano un'attesa troppo breve o una pagina saltata. Se il totale manca di esattamente un batch, guarda l'interazione prima del buco; se manca una pagina, guarda l'incremento del ciclo. Il 503 transitorio del fixture è l'altra faccia di questo bug: senza retry, la pagina 3 non avrebbe contribuito nulla e l'esecuzione avrebbe riportato 106 righe senza alcun errore.
Una falsa ultima pagina è la più pericolosa, perché il crawl riporta successo con meno dati. Accade quando una pagina restituisce zero righe per un problema di sessione o di rendering, non perché l'elenco è finito, e il ciclo tratta i due casi allo stesso modo. Distinguili sondando ancora: richiedi di nuovo la pagina successiva dopo una breve pausa, ed esigi o un vero marcatore di fine o due risposte vuote consecutive prima di accettare la fine.
Valida i conteggi e la completezza dei campi
La validazione sono due controlli che richiedono secondi e catturano la maggior parte dei fallimenti silenziosi. Il controllo di conteggio confronta quanto raccolto con ogni cifra indipendente che trovi: la dichiarazione "page 5 of 5" della stessa ultima pagina numerata, un totale in un'intestazione o la somma dei conteggi per pagina visti lungo il percorso. Il controllo dei campi conferma che ogni record porta i campi promessi dal lavoro, e conta le eccezioni invece di ignorarle.
const unique = new Map(rows.map((row) => [row.id, row]));
const missing = rows.filter((row) => !row.title || !Number.isFinite(row.price));

console.log({
  raw: rows.length,
  unique: unique.size,
  removedDuplicates: rows.length - unique.size,
  missingFields: missing.length,
});
Sulle 135 righe numerate del fixture il controllo ha riportato zero campi mancanti, due duplicati rimossi e 133 record unici, in accordo esatto con il dataset. Sull'elenco load more ha riportato un duplicato su 81. Nessuna delle due cifre è interessante da sola; conta che un cambiamento in ciascuna sia visibile subito, invece di comparire dopo in un report con un buco misterioso.
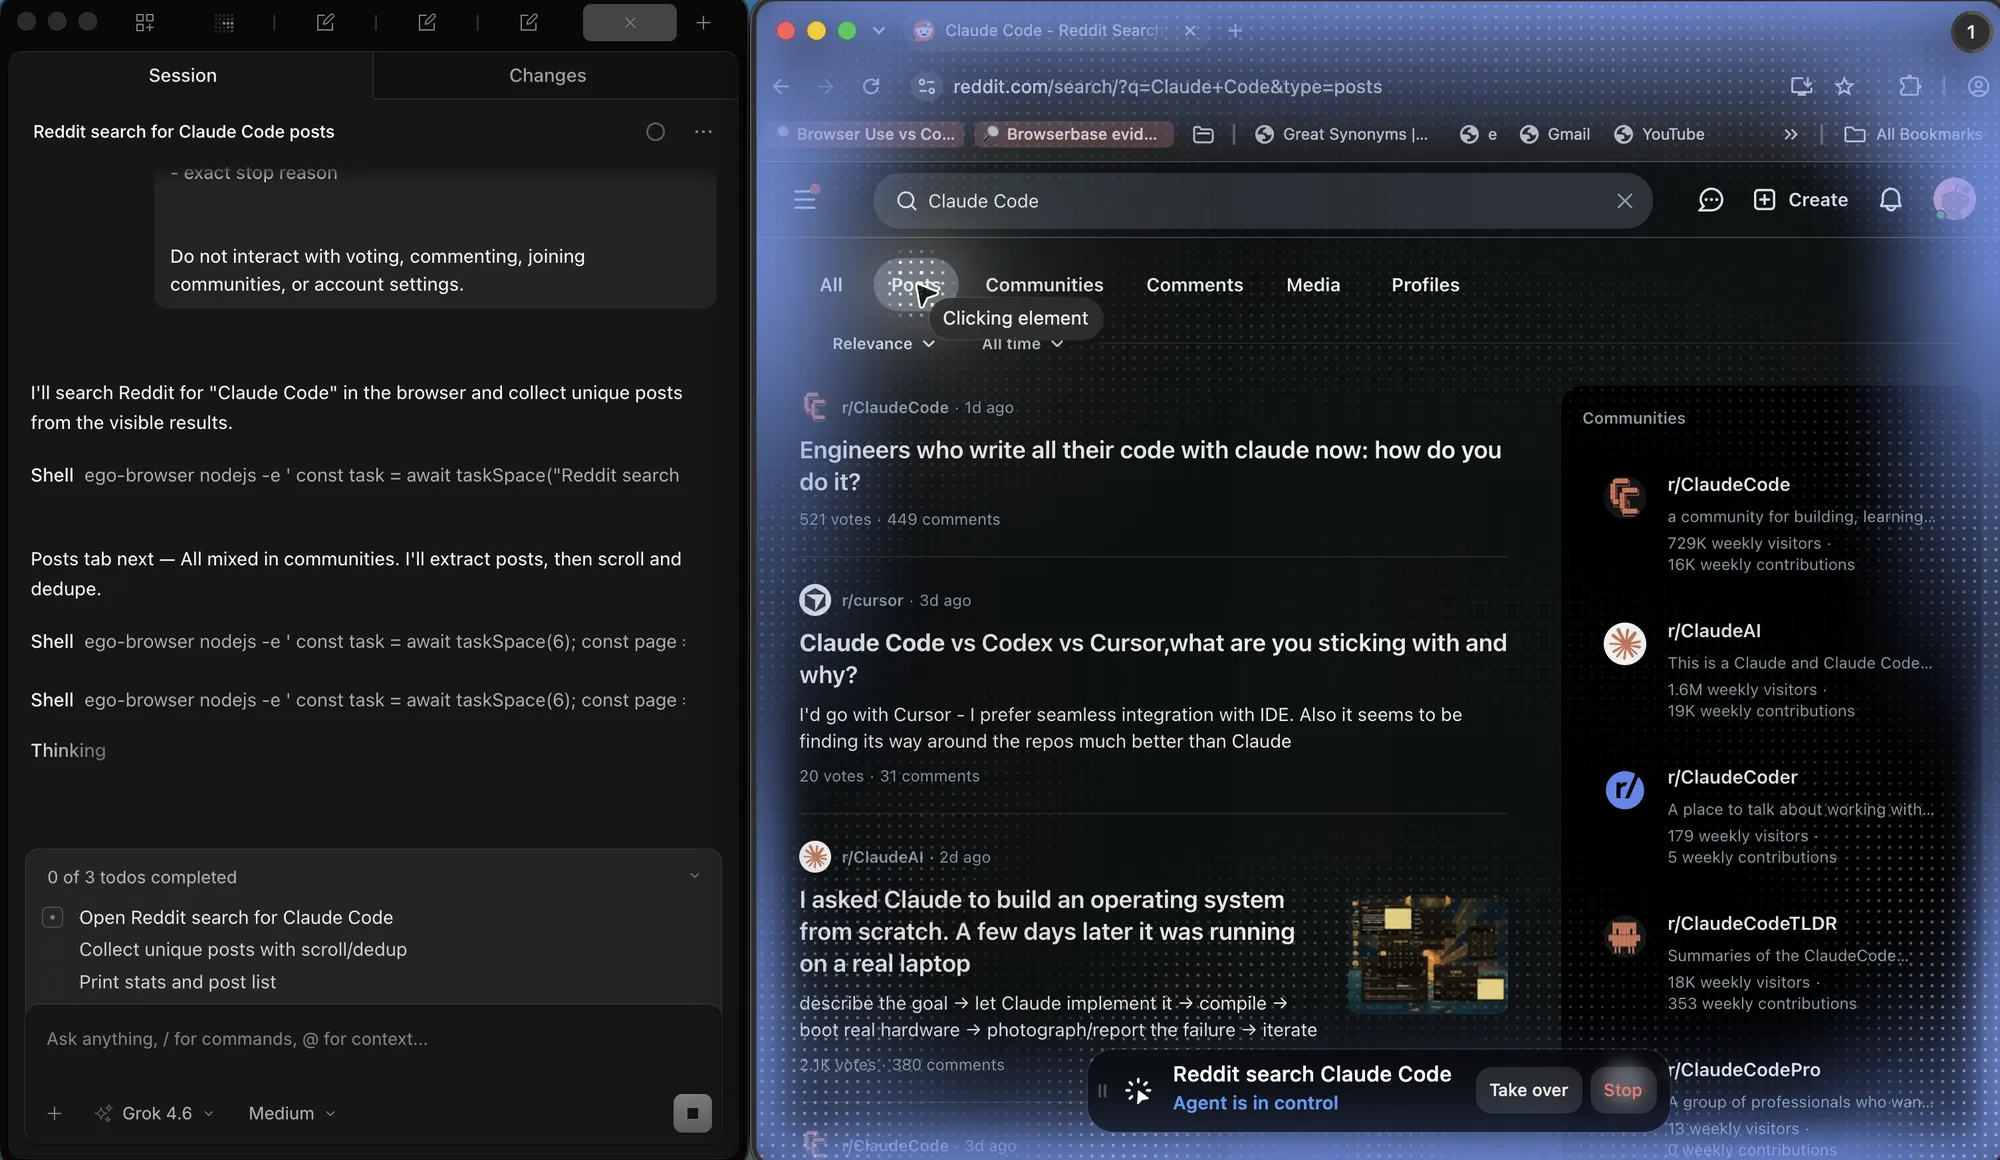
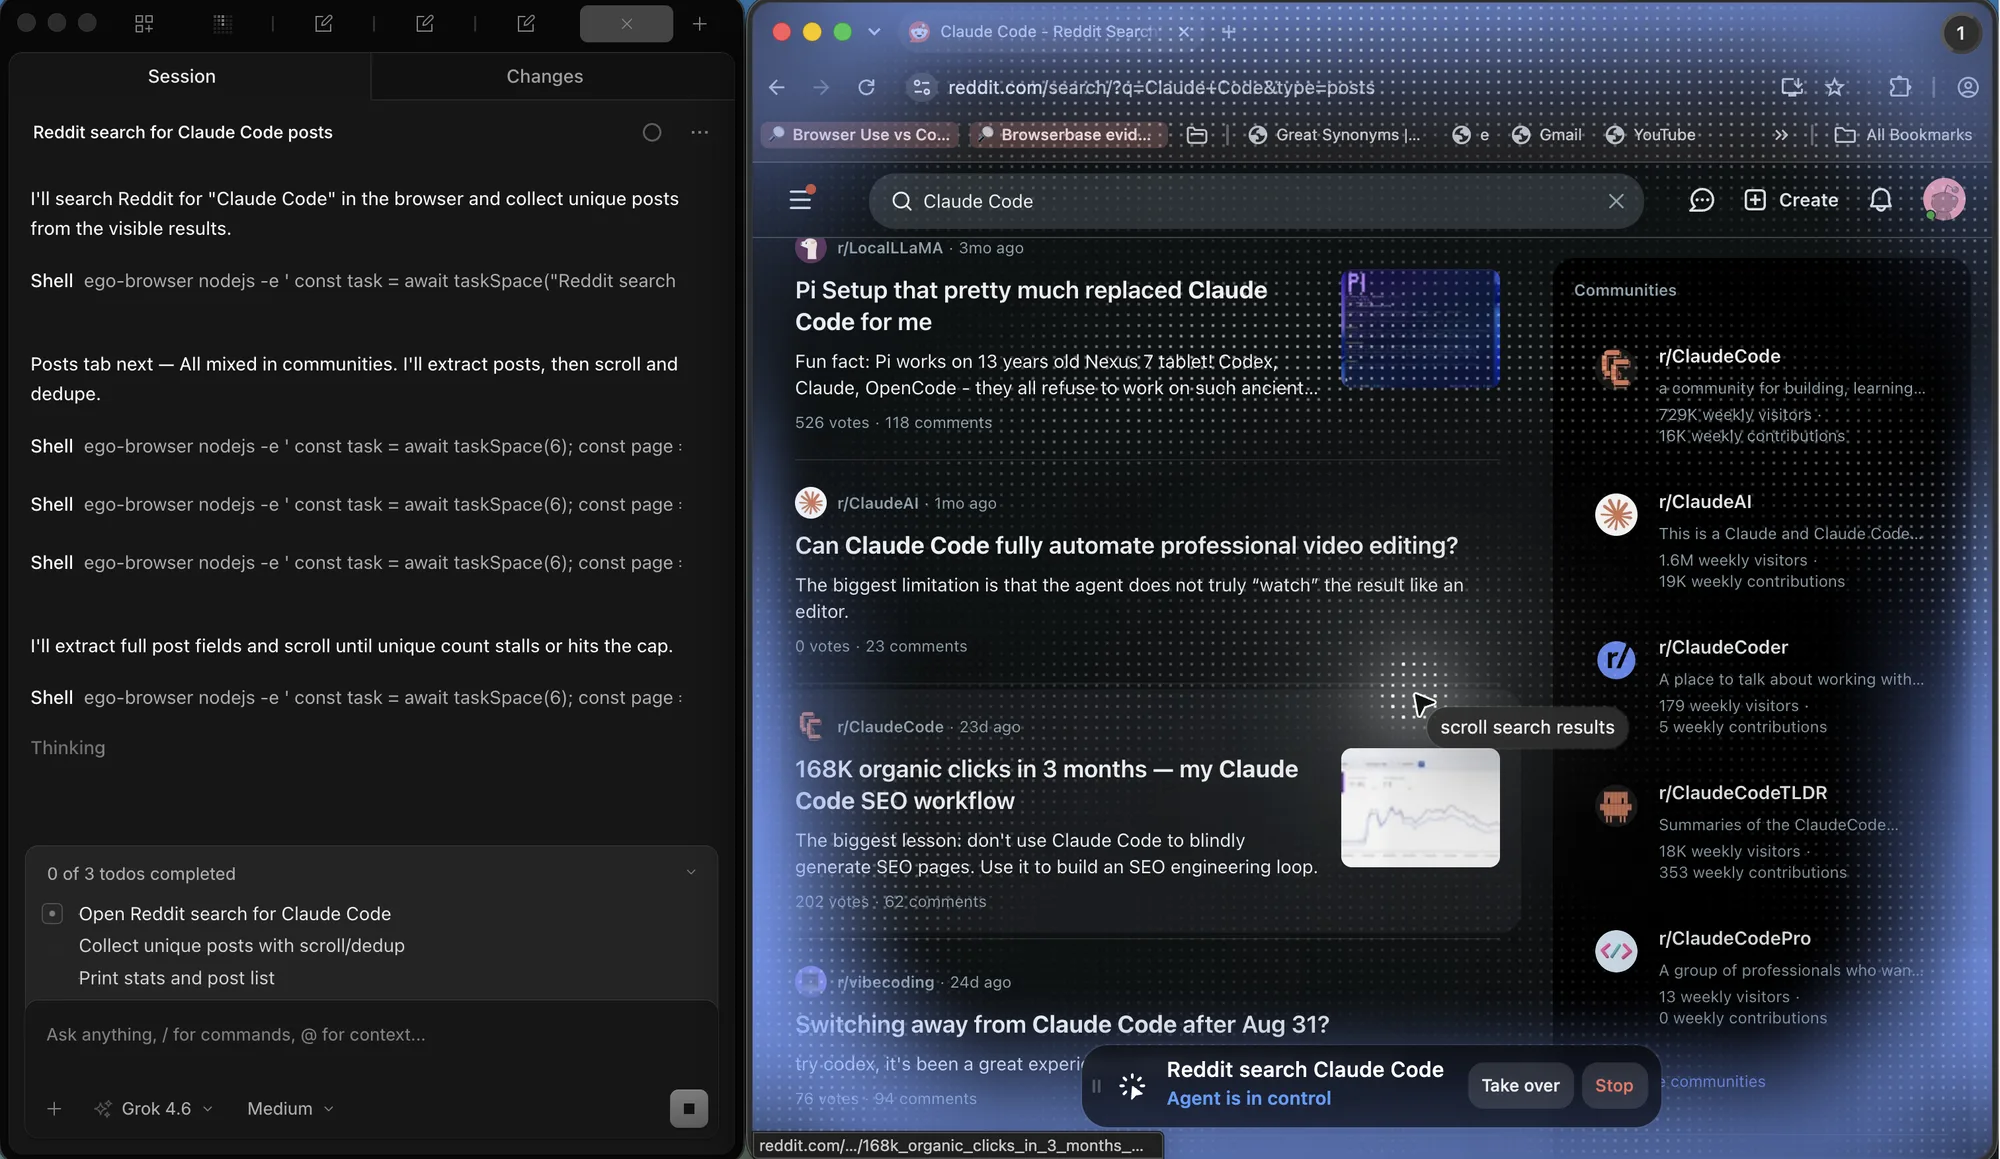
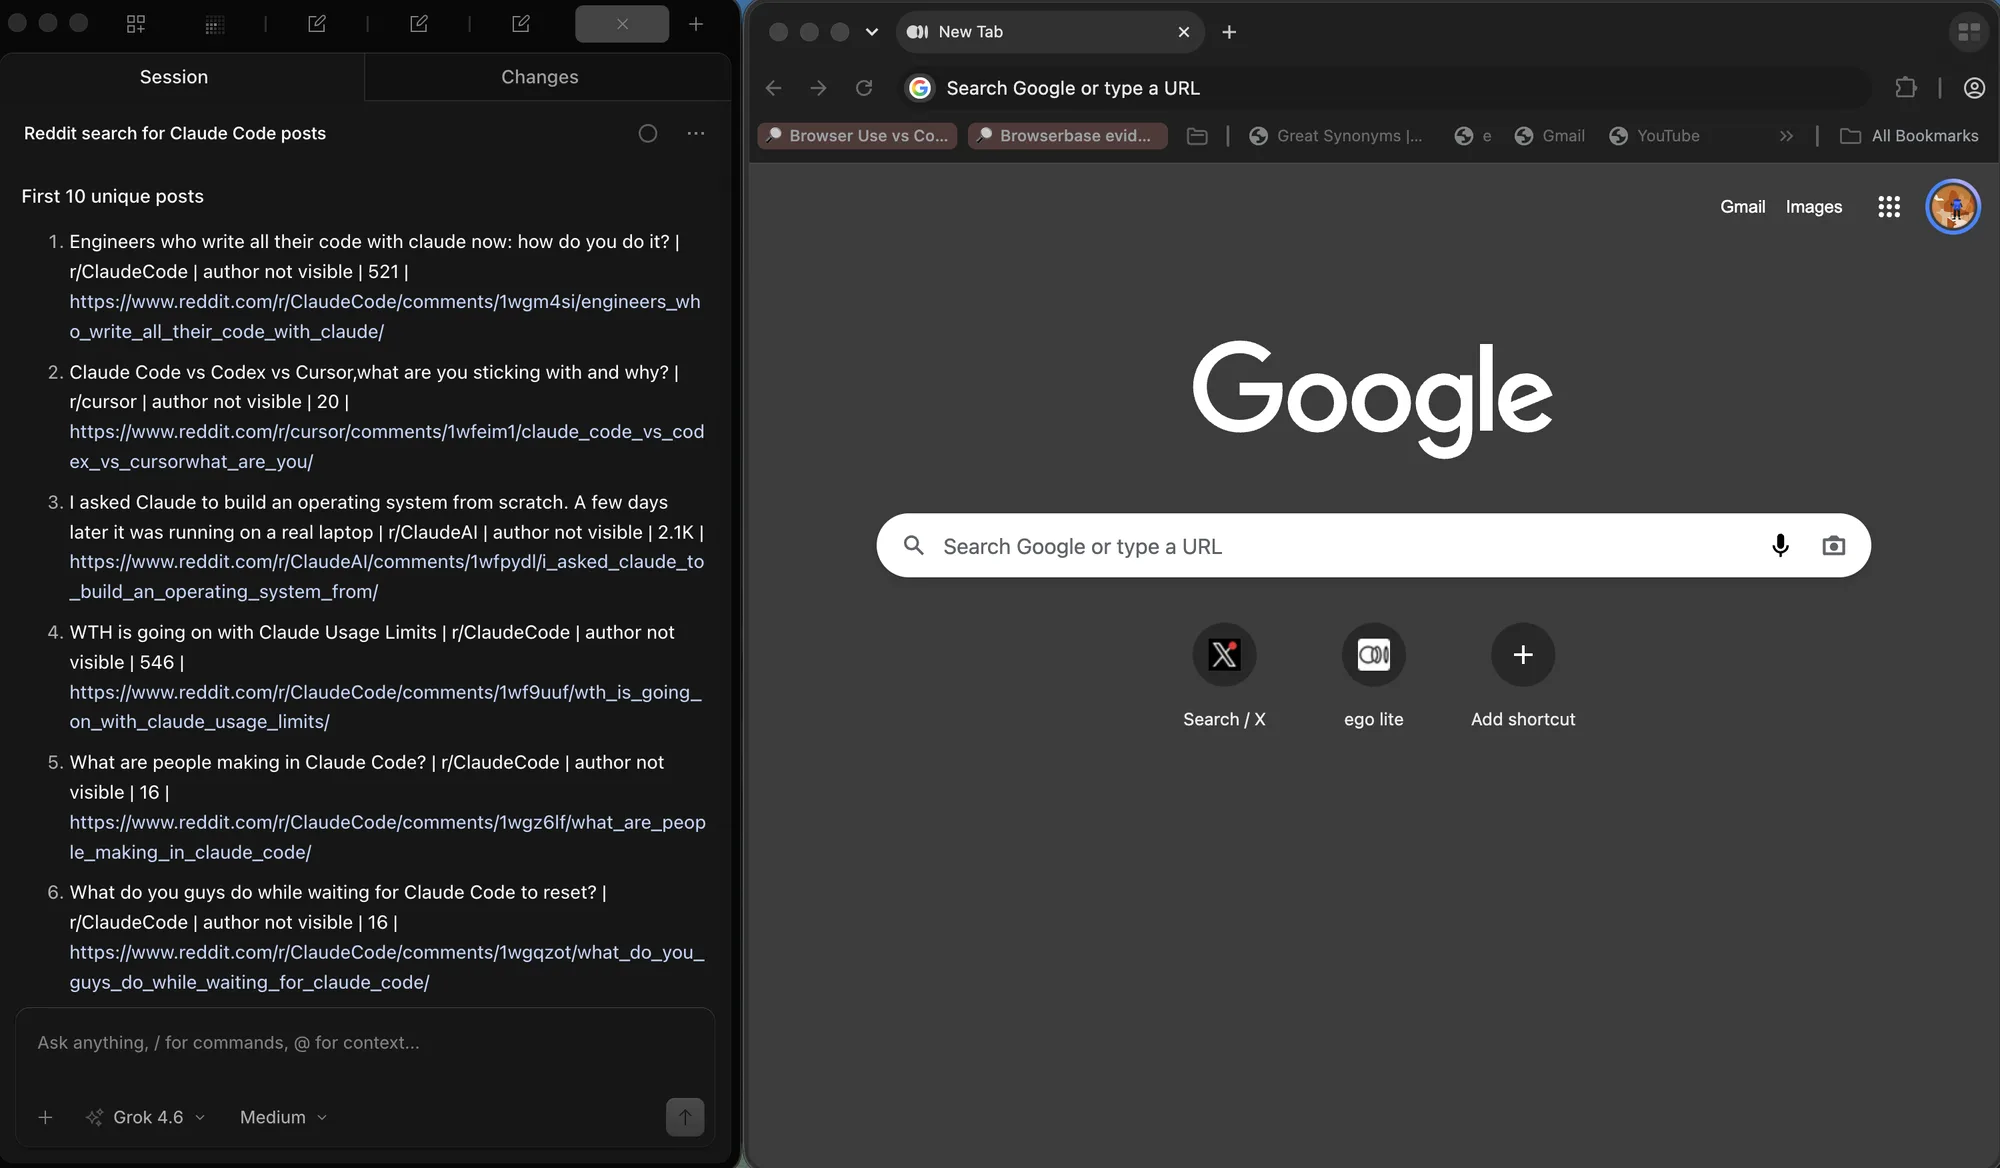
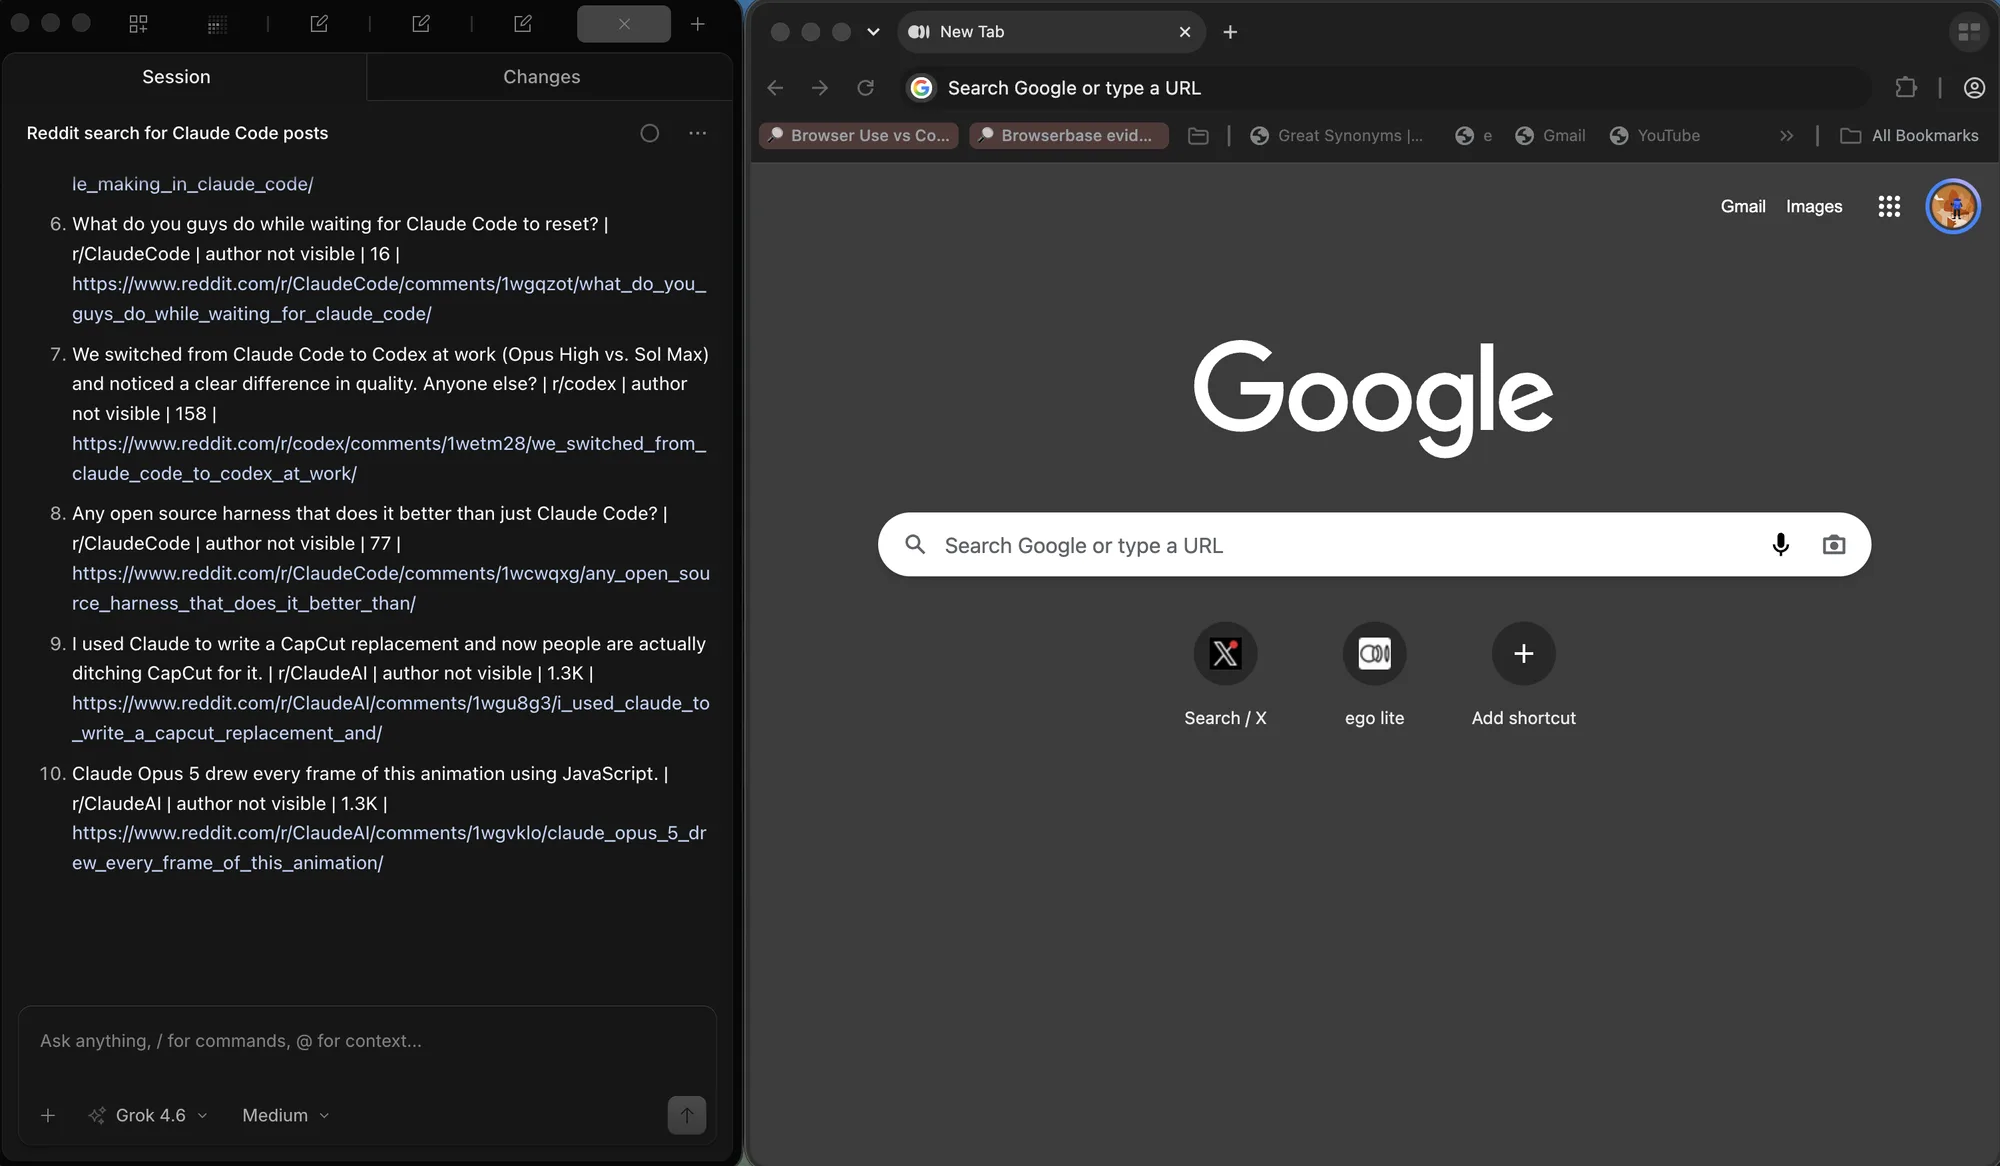
L esecuzione Reddit ha usato lo stesso controllo su una lista unica live, non sul fixture da 135 righe. Ogni riga richiedeva titolo, subreddit, voti e URL. L output numerato e cio che si valida dopo lo scroll.
Quando basta HTTP semplice, e quando non basta
Gli stessi dati del fixture sono raggiungibili senza browser, e misurare entrambi i percorsi è il modo onesto per decidere di che cosa ha bisogno il lavoro. Un client HTTP semplice ha percorso le pagine numerate per URL, ha preso i batch load more dal loro endpoint JSON e ha tirato il feed infinito per offset, raccogliendo tutte le 135, 81 e 60 righe in 24 milliseconds complessivi. Nessun rendering, nessuna attesa, nessuno scorrimento.
Questa è la raccomandazione predefinita, e va detta senza giri di parole: se esiste un'API ufficiale, usala. Se l'elenco numerato è renderizzato dal server, richiedi le pagine direttamente. Se i modi load more o infinito sono sostenuti da un endpoint JSON senza firma, richiedi quell'endpoint e pagina sull'offset. Un framework come Playwright non è richiesto per nulla di tutto questo, e il percorso HTTP è più veloce e più economico da eseguire. Il tutorial di paginazione Apify, la documentazione dei selettori di paginazione di Web Scraper e il flusso del pannello di rete nella guida di rete di Playwright coprono lo stesso terreno da punti di partenza diversi.
Un browser è giustificato quando i dati esistono solo dopo il rendering lato client, quando le richieste portano una firma o un token generato nella pagina, quando l'elenco richiede un login, o quando l'endpoint risponde in modo diverso senza una sessione reale e un user agent reale. A quel punto il browser non è una preferenza di scraping, è l'unico percorso onesto, e le sezioni precedenti valgono invariate.
ego (lite) entra solo dopo che quel percorso HTTP fallisce. Se l'elenco ha bisogno di un cookie autenticato, di un token generato nella pagina o di uno scorrimento che non avviene mai senza un viewport reale, esegui lo stesso ciclo numbered / load-more / infinite dentro un browser che già detiene la sessione. Non partire da lì. Il fixture ha già mostrato la risposta più economica: 135, 81 e 60 righe su HTTP semplice in 24 ms.
Quando ti serve davvero il browser, tieni la logica di crawl delle sezioni precedenti. ego (lite) fornisce la pagina autenticata e uno Space che puoi osservare; non inventa un nuovo algoritmo di paginazione. Se un passo ha bisogno di una persona, fermati. Se curl o un'API ufficiale restituiscono già le righe, resta su HTTP.
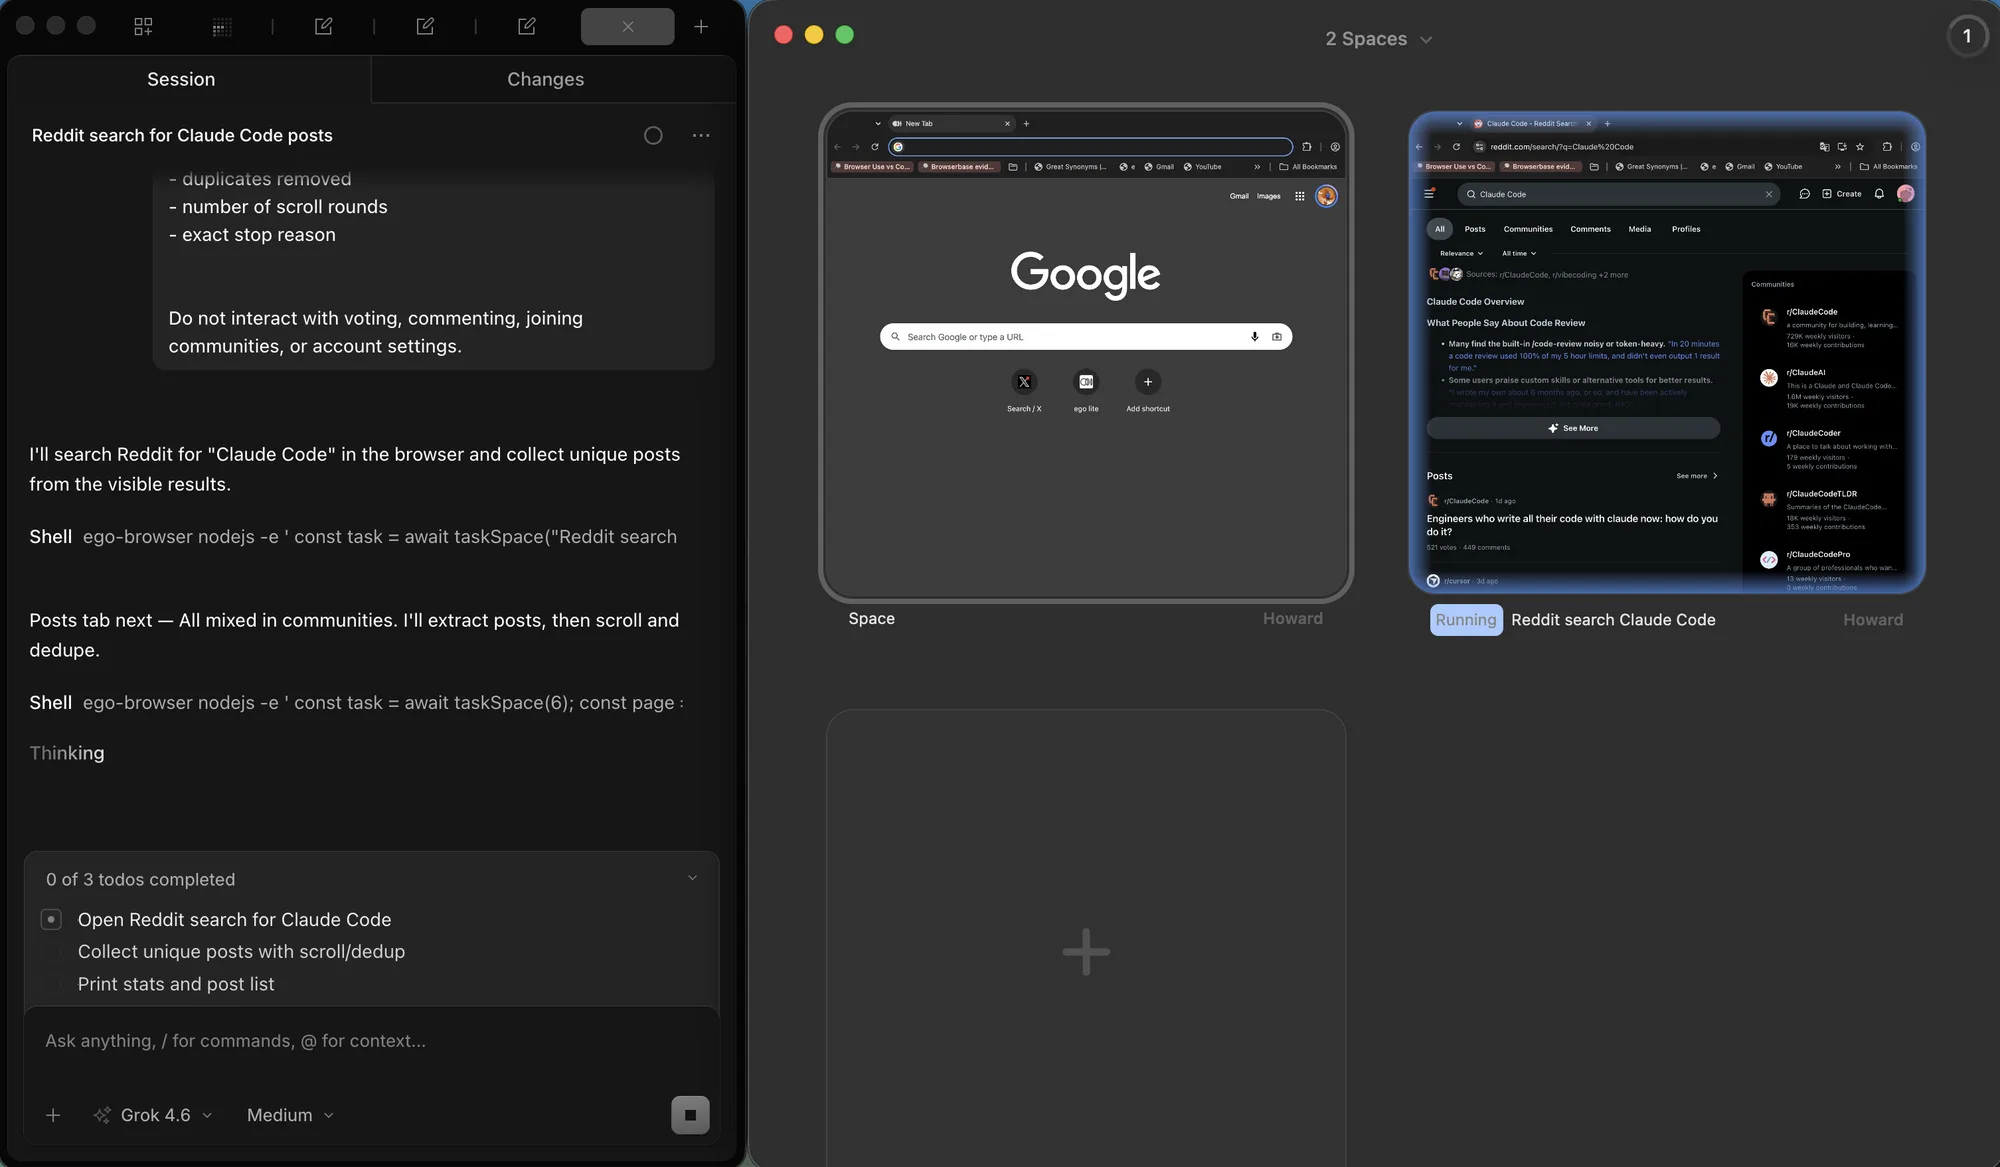
La regola di isolamento delle pagine numerate vale ancora. Due crawler che condividono una finestra litigano sulla posizione di scroll e si sovrascrivono l ultima riga vista. Nello stesso browser due Space equivalgono a due contesti Playwright: uno puo restare idle su Google mentre l altro continua a scorrere Reddit. Il punto e l isolamento. La panoramica serve solo a vederli insieme.
La versione 0.5.0.32 è registrata nel changelog (2026-09-12). Ricontrolla quella pagina, la guida rapida e il repository GitHub prima di citare una build più recente. La guida adiacente Web scraping con JavaScript affronta la decisione tra statico e renderizzato dall'altro lato.
FAQ
Come faccio a sapere quante pagine ha un elenco numerato?
Sai quante pagine ha un elenco numerato leggendo il controllo dell'ultima pagina, dividendo un totale dell'intestazione per la dimensione di pagina e poi percorrendo fino in fondo una volta. Tratta quella stima come un controllo, non come condizione di stop del ciclo.
Perché il mio scraper raccoglie duplicati tra le pagine?
Gli scraper raccolgono duplicati tra le pagine quando l'elenco sottostante si riordina, così un record passa da un batch al successivo. Deduplica su un record id stabile, non sul titolo visibile, e registra quanti duplicati hai rimosso.
Quanto devo attendere dopo aver fatto clic su load more?
Finché una condizione osservabile è vera: il conteggio delle righe è aumentato, lo stato disabled del pulsante si è azzerato, o è comparsa una riga nota del batch successivo. Un ritardo fisso è una stima che funziona finché la rete è lenta, ed è esattamente allora che fallisce.
Come rilevo la fine di un feed infinito?
Preferisci un segnale esplicito quando il sito ne fornisce uno, come un messaggio di fine renderizzato o un flag has-more nella risposta. Senza nessuno dei due, esigi diversi controlli consecutivi senza nuovi elementi e senza cambio di altezza nel contenuto caricato prima di fermarti, non un solo momento quieto.
Devo usare un browser headless per lo scraping con paginazione?
Solo quando i dati richiedono rendering, una sessione o token nella pagina. Elenchi renderizzati dal server ed endpoint JSON sono meglio serviti da HTTP semplice, più veloce e più semplice da eseguire. Misura entrambi i percorsi una volta; il confronto di solito rende ovvia la decisione.
Che cosa fa fermare in anticipo un crawl paginato?
Tre sospetti abituali: un'attesa finita prima del rendering del batch, un errore transitorio trattato come pagina vuota, e una sessione scaduta a metà esecuzione così che la pagina successiva ha renderizzato il modulo di login invece delle righe. Ciascuno ha una correzione diversa, ed è per questo che il motivo dello stop va registrato insieme al conteggio.
Come riprendo un crawl dopo un crash?
Fai un checkpoint dopo ogni batch completato con il modo, la posizione e le righe raccolte finora. La ripresa legge quel file e rientra nel modo alla posizione registrata. Richiedi una volta il batch immediatamente precedente alla posizione del checkpoint, per confermare che la fonte non si è spostata sotto lo stato salvato.
Come valido che un crawl è completo?
Confronta il conteggio dei record unici con almeno due cifre indipendenti, come il totale della stessa ultima pagina e la somma dei conteggi per pagina, poi controlla la completezza dei campi su ogni riga e segnala le eccezioni. Un conteggio che coincide e campi tutti presenti è un segnale forte; ciascuno da solo è debole.
Devo scorrere piano per attivare il lazy loading?
Di solito no, ma riattiva il loader invece di restare fermo in fondo. I siti usano observer di intersezione che scattano al cambiamento, quindi alternare la posizione o scorrere a scatti è più affidabile di un salto grande, e rende significativo il controllo di crescita.
Posso fare scraping di un elenco paginato dietro un login?
Sì, con una sessione reale e le stesse regole: pagina con cortesia, tieni viva la sessione e tratta un redirect alla pagina di login come un problema di sessione, non come la fine dell'elenco. Un browser che già porta il tuo login, come ego (lite), elimina del tutto il passo di ricostruzione della sessione. La guida alla sessione persistente copre la gestione dello stato, e il caso d'uso di scraping dei prezzi mostra com'è una raccolta completa già autenticata.