
JavaScriptで描画されるページは、レスポンスが成功でもスクレイパーの行数が0件のまま、ということが起きます。HTMLは読み込み済みでも、ブラウザで人が見ているカードがまだDOMにないことがあります。ego (lite)なら、その差が見えます。タスクは見守れるChromium Spaceの中で動くので、まだ描画中なのか、セレクタが当たっていないのか、欲しいデータが一度も現れなかったのかを目で確認できます。
Playwrightは、その確認済みの挙動を、安定して繰り返せるスクレイピングに落とし込みます。対象カードの描画を待ち、ライブDOMから項目を抽出し、結果に期待したデータが入っているかを検証できます。セレクタと待ち条件が分かっていれば、それを信頼できるスクリプトにするのは自然です。まだ目視が要る、既存のログイン済みセッションが要る、特定のステップで人が引き継ぐ必要がある、という作業では、ego (lite)がブラウザ状態を見えるまま操作可能に保ちます。終了コード0のスクリプトが、実は何も取れていなかった事実を隠せなくなります。
PlaywrightによるWebスクレイピングとは
PlaywrightによるWebスクレイピングとは、実ブラウザを動かしてJavaScriptにページを描かせ、描画済みノードを読むことです。スクレイパーはブラウザです。HTMLレスポンスは、スクリプトが走るまでの殻にすぎません。
PlaywrightはChromium、Firefox、WebKitを起動し、contextを開き、page.goto、待ち、locator、page.evaluateを提供します。これらのAPIはテスト用です。抽出にも使えます。どちらも必要なのは、人が見ているものに一致するDOMだからです。
隣接する作業はこのページでは扱いません。
JavaScriptでfetchとブラウザのどちらを選ぶかは、JavaScriptによるWebスクレイピングで扱っています。実行をまたいでログイン済みセッションを再利用する方法は、永続ブラウザセッションで扱っています。XやLinkedInのログイン壁は、ログイン壁の向こうのAIスクレイピングで扱っています。番号付きページ、Load More、無限スクロールは、この1ページが正しい行を返すようになってから着手します。
HTTPではなくPlaywrightでスクレイピングすべきなのはどんなときか
スクレイピングしたいノードがURLのGETに含まれていないときにPlaywrightを使います。値がすでにレスポンスボディにある、あるいはページが文書化されたJSONエンドポイントを出しているなら、HTTPを使います。
quotes.toscrape.com/jsは、その分かれ目を意図して作られています。URLのGETが返すHTMLにはclass="quote"のノードがありません。引用はインラインのvar data配列にあり、jQueryがカードを描きます。生レスポンスの.quoteに向けたCSSパーサーは何も保存できず、セレクタのバグのように見えます。
その分かれ目は2026-09-18にOpenCodeから確認しました。quotes.toscrape.com/jsのGETはHTTP 200で、生HTMLの.quoteカードは0件でした。右側のheaded Chromiumウィンドウには、すでに描画済みのリストが出ていました。
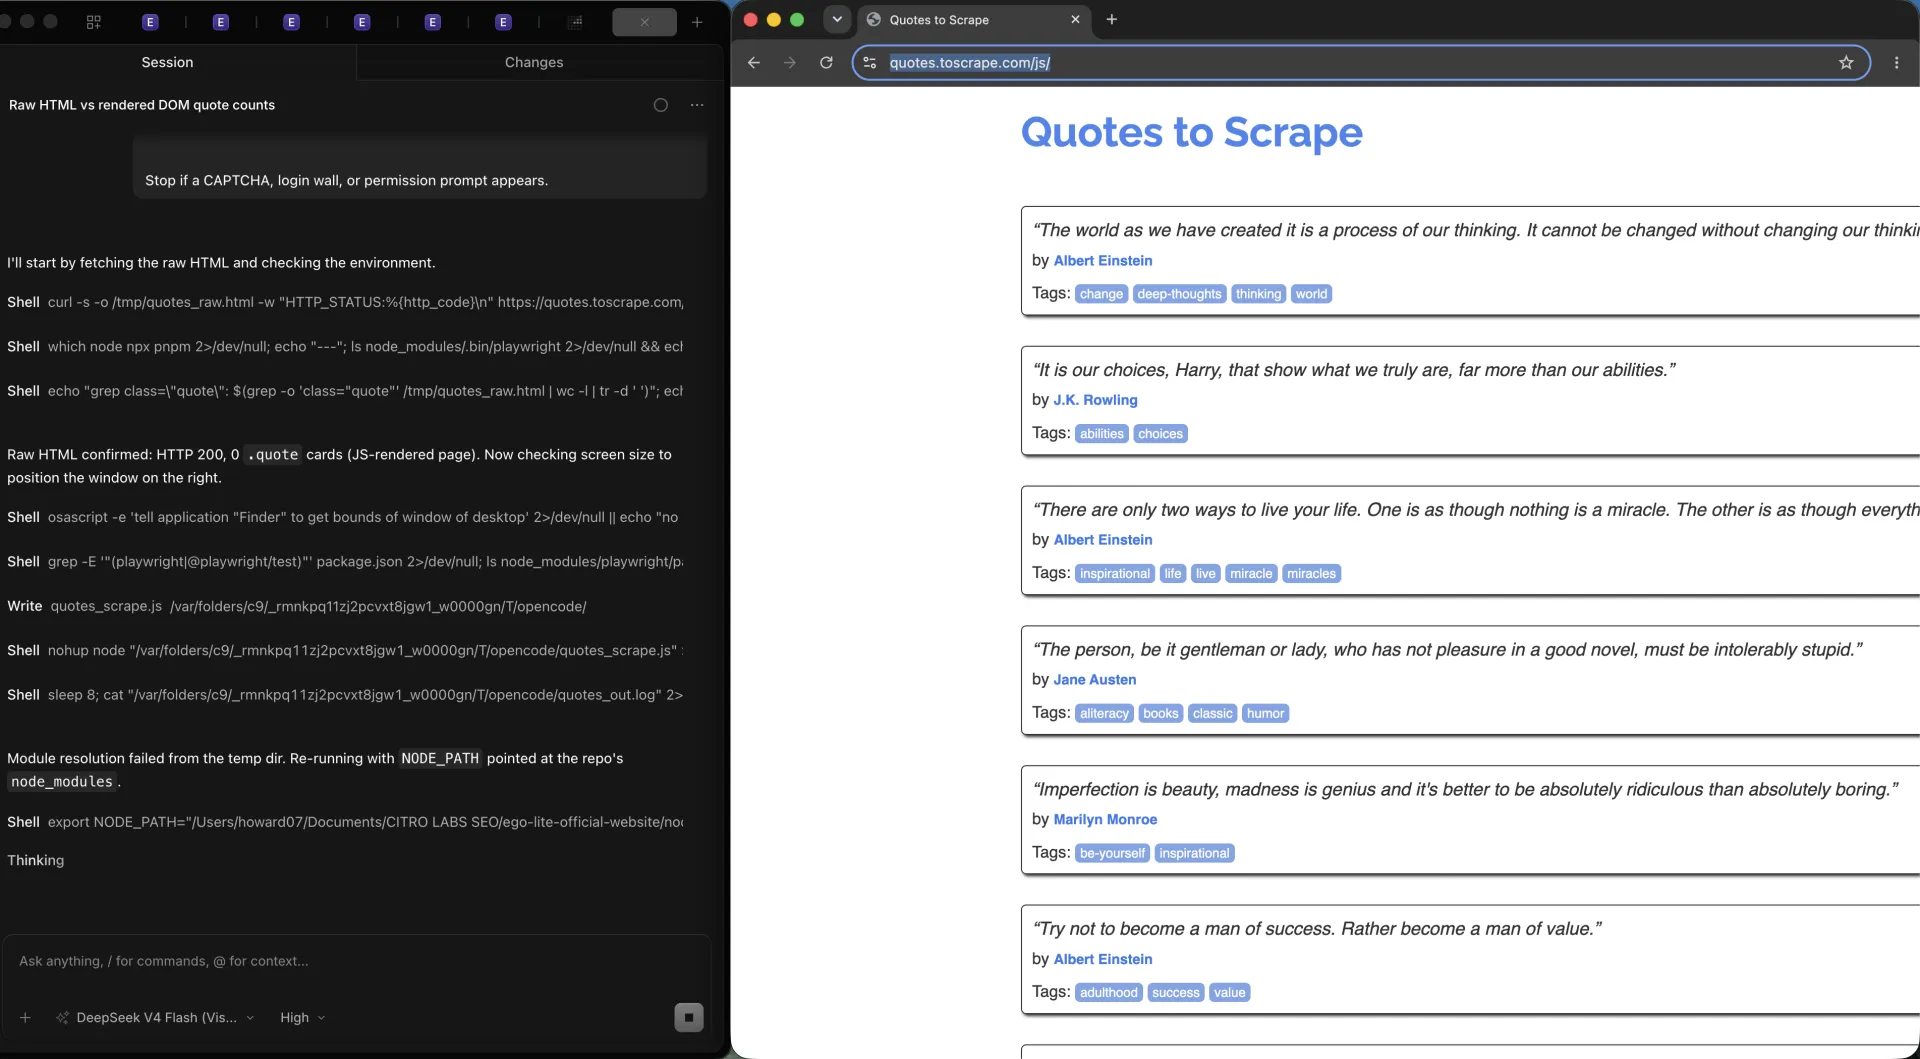
分かれ目は、次の表で見ます。
| 経路 | できること | できないこと |
|---|---|---|
| HTTP GET + HTMLパーサー | サーバーが送ったバイトを読みます。安くて速く、カードがすでにマークアップにあるなら十分です。 | ページのスクリプト実行や、後から現れるノード待ちはできません。quotes.toscrape.com/jsでは、生HTMLに.quoteカードが見えません。 |
| インラインのペイロードを解析する | quotes.toscrape.com/jsでは、var dataを正規表現とJSON.parseすれば、同じHTMLから引用を復元でき、ブラウザは不要です。 | 配列の埋め込みをやめる改修には耐えません。内部ペイロードはAPI契約ではありません。 |
| Playwrightの描画済みDOM | ページのJavaScriptを実行し、.quoteを待ち、人が見ているカードを抽出します。 | 安くは済みません。contextごとにメモリを使い、静的HTMLに対して何台も並べるのは誤った道具です。 |
このデモで正直に足すと、var dataを直接解析するならPlaywrightは不要です。多くのJSサイトは、最初のレスポンスに名前付き配列を残しません。残さない場合でも通る経路がPlaywrightです。
起動、遷移、コンテンツ待ちの手順
Playwrightスクレイピングの最小構成は、起動、新しいcontext、goto、カードセレクタ待ち、抽出、closeです。待ちを飛ばすと、成功した空ファイルができます。
Playwrightの page.gotoはcommit、domcontentloaded、load、networkidleのいずれかで止められます。waitForSelectorは、目的のものが実際に存在するかを確認するチェックです。quotes.toscrape.com/jsでは、インラインスクリプトがそのHTML内で動くため、goto({ waitUntil: 'domcontentloaded' })だけでも足りることがあります。それは運であり、ルールではありません。
import { chromium } from "playwright";

const browser = await chromium.launch();
const context = await browser.newContext();
const page = await context.newPage();

try {
  await page.goto("https://quotes.toscrape.com/js/", {
    waitUntil: "domcontentloaded",
  });
  await page.waitForSelector(".quote");
  const rows = await page.evaluate(() =>
    [...document.querySelectorAll(".quote")].map((el) => ({
      text: el.querySelector(".text")?.textContent?.trim() ?? "",
      author: el.querySelector(".author")?.textContent?.trim() ?? "",
      tags: [...el.querySelectorAll(".tag")].map((tag) =>
        tag.textContent?.trim(),
      ),
    })),
  );
  console.log(rows.length);
} finally {
  await context.close();
  await browser.close();
}
空のスクレイピングを見るには、カードが存在する前のcommitで抽出するか、描画するスクリプトを遅らせます。その早い抽出は0行を返します。waitForSelector('.quote')の後なら、同じページが描画済みカードを返します。空の場合でも例外は出ません。
| 待ち | 証明できること | 失敗の形 |
|---|---|---|
| commitのみ | 遷移が始まったこと。ネガティブテストとしては使えます。 | スクリプトがまだ走っていないことがあります。描画前のcommitで抽出すると、引用は0件です。 |
| domcontentloaded | 最初のHTMLが解析されたこと。このフィクスチャでは、var dataがそのHTML内で走るため足りることがあります。 | 遅いXHRのカードはまだ欠けていることがあります。「コンテンツ準備完了」だと思わないでください。 |
| waitForSelector('.quote') | DOMにカードが少なくとも1枚あること。このデモを抽出可能な行にする待ちです。 | 古いclassが前のリストに当たることがあります。待つのはデータとともに変わる項目であり、消えないラッパーではありません。 |
contextはfinallyで閉じます。メモリを握っているのはcontextです。抽出の途中で例外が出ても、Chromiumは手放す必要があります。
描画済みページから項目を抽出する方法
抽出はpage.evaluateでページ内から行うか、リストではなく1つのコントロールが要るならlocatorを使います。どちらも描画済みDOMを読みます。goto時点の元HTMLスナップショットは読みません。
各.quoteをtext、author、tagsへ写します。公開デモはカードを10枚描きます。必須項目はtextとauthorです。一意キーはauthorではなく引用文です。Einsteinが複数回出るからです。
その抽出も、同じOpenCodeセッションで確認しました。waitForSelector('.quote')の後、headed実行は10行、一意のtextが10件、欠けたauthorは0件と出力しました。生HTMLのカードは依然0件でした。
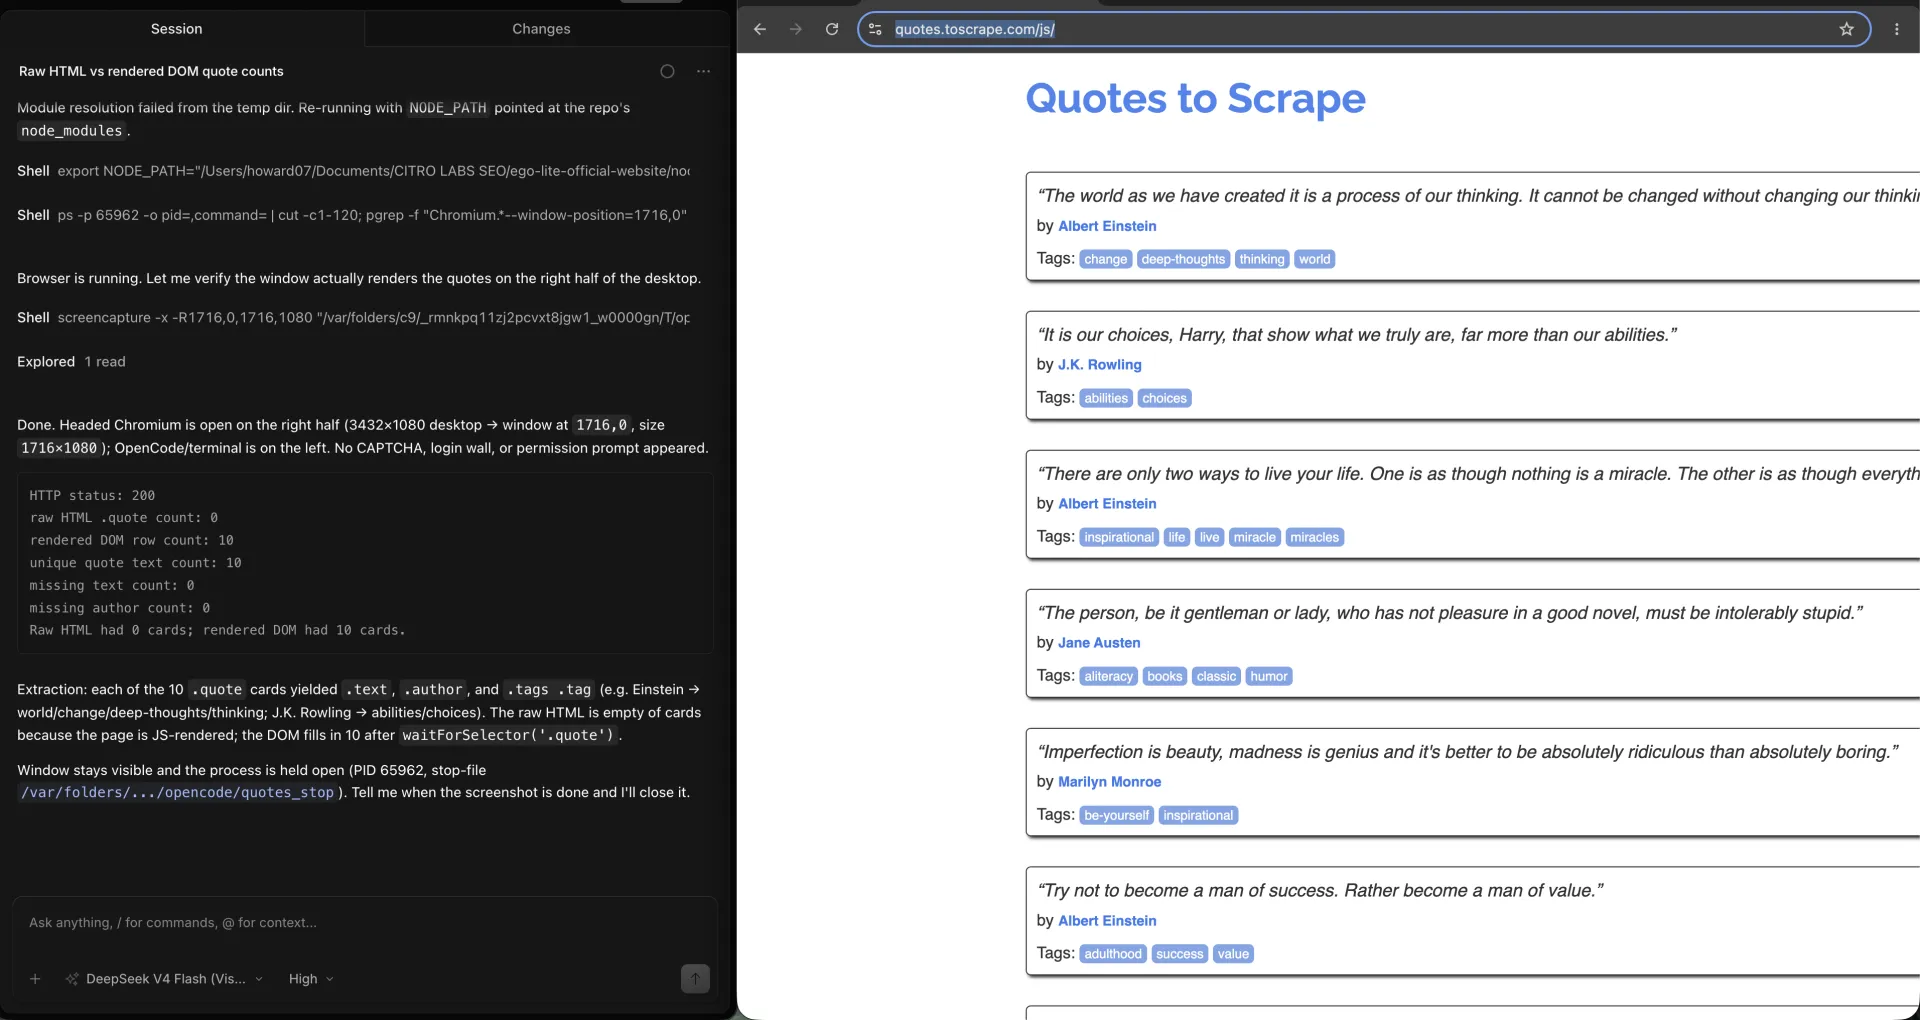
単一フィールドならlocatorのほうがきれいです。Playwright locatorsは各操作の前に再クエリするため、保存したelement handleが壊れる再描画にも耐えます。
const title = await page.locator(".quote .text").first().innerText();
const author = await page.locator(".quote .author").first().innerText();リスト抽出ならpage.evaluateのほうが向いています。実行はin the pageで行われ、JSONを返します。mapperは小さく保ち、text、author、tags、一意キーだけを取り出します。スクリーンショットやPDFはスクレイピングのループに入れないでください。
CSSで隠したテキストもDOMには残っています。innerTextはレイアウトに従い、textContentは従いません。サイトがCSSでタイトルを切っていても、textContentは全文を返します。検証を書く前に、どちらを集めるかを決めてください。
ページ自身のデータをインターセプトする方法
カードから解析する代わりに保存できるJSONを、ページがすでに取得しているなら、インターセプトは有効です。quotes.toscrape.com/jsではそのリクエストは一度も飛ばず、そこが要点です。
そのデモの引用はAPIから来ていません。HTMLにvar dataとして埋め込まれ、jQueryが.quoteノードへ描きます。JSONを探すresponse listenerは、役に立つものを見ません。
Playwrightの network docsはpage.routeとresponse listenerを示しています。使いましょう。そのうえで、ページが実際に送ったもの(何も送っていない場合も含む)を記録します。
const jsonResponses = [];
page.on("response", async (response) => {
  const type = response.headers()["content-type"] || "";
  if (type.includes("json")) {
    jsonResponses.push({
      url: response.url(),
      status: response.status(),
    });
  }
});
await page.goto(url, { waitUntil: "domcontentloaded" });
await page.waitForSelector(".quote");
console.log(jsonResponses.length);
JSONボディがなければ、描画済みカードに戻るか、すでにダウンロードしたインラインスクリプトを解析します。チュートリアルが必ず出すからといって、エンドポイントを捏造しないでください。Oxylabs、BrowserStack、ScraperAPIはいずれもインターセプトを示します。サイトがリクエストを一度も飛ばないときに何が起きるとは書いていません。
項目、重複、件数の検証方法
スクレイピングの完了は、スクリプトが終了コード0で終わることではありません。ファイルが期待件数を持ち、必須項目がすべてあり、一意キーが2行を1行に潰していないことです。
このデモで通る抽出は、一意のtextを持つ10行を書き、欠けたauthorはありません。カードが存在する前の抽出は、件数を見なければ同じ明るいログのまま0行を書きます。
function validate(rows, expectedCount) {
  const missing = rows.filter((row) => !row.text || !row.author);
  const unique = new Set(rows.map((row) => row.text));
  if (rows.length !== expectedCount) {
    throw new Error(`expected ${expectedCount}, got ${rows.length}`);
  }
  if (missing.length) {
    throw new Error(`${missing.length} rows missing text or author`);
  }
  if (unique.size !== rows.length) {
    throw new Error("duplicate texts");
  }
}
短いチェックリストを使い、失敗は大きく出します。
| 確認 | 合格 | 残すべき失敗の形 |
|---|---|---|
| 期待件数 | waitForSelector('.quote')の後にカード10枚 | 描画前に抽出すると0行 |
| 必須項目 | すべての行にtextとauthor | カードには当たるが.authorを外すセレクタ |
| 一意キー | 一意なのは引用文であり、authorではない | authorで重複排除するとEinsteinが潰れる |
空の抽出は残します。0行という結果が、待ちが効いている証拠です。消すと、後の完全な抽出が既定値のように見えます。
Playwrightスクレイピングが壊れる原因
ここで効く失敗は、空の描画、古いセレクタ、レート制限です。例外を飲み込むcatchのあとで行数だけログしていると、どれも赤いスタックトレースには見えません。
空の描画。遷移は成功し、セレクタは一度も当たらず、[]を保存しています。直すのは待ちです。未完了の同じDOMに対して、同じ抽出を再試行しないでください。
古いセレクタ。.quoteは残っていますが、テキストが移動しています。実行は昨日の10行を返します。コンテンツとともに変わる項目を待ち、一意キーを前回のファイルと差分してください。
レート制限。429は止まれの合図です。Retry-Afterがあれば読み、バックオフし、再試行に上限を付けます。同じURLを叩き続けるとIPがブロックされます。回避はこのガイドの対象外です。
async function gotoWithRetry(page, url, attempt = 0) {
  const response = await page.goto(url, { waitUntil: "domcontentloaded" });
  const status = response?.status() ?? 0;
  if (status === 429 || status >= 500) {
    if (attempt >= 3) throw new Error(`giving up on ${url}: ${status}`);
    const retryAfter = Number(response?.headers()["retry-after"]);
    const waitMs = Number.isFinite(retryAfter)
      ? retryAfter * 1000
      : 2 ** attempt * 1000;
    await page.waitForTimeout(waitMs);
    return gotoWithRetry(page, url, attempt + 1);
  }
  if (status && status >= 400) throw new Error(`${status} for ${url}`);
  return response;
}見えるブラウザエージェントのほうが向くのはどんなときか
待ちが間違っている、セレクタが動いた、人がページを見て引き継ぐ必要がある、そういうときに見えるブラウザエージェントのほうが向きます。CIですでに信じている固まったPlaywrightループの代替ではありません。
補完関係であり、競合ではありません。Playwrightは、すでに分かっている待ちをコードに落とします。ego (lite) 0.5.0.32は、カードが現れる様子を見守れるChromium Spaceにタスクを置き、エージェントを止めたり、待ちが嘘をついているときに人が引き継いだりできます。次のスクレイピングで既存のログインが必要なら、実プロファイルを再利用します。静的HTMLを安くすることはなく、ブロックの回避もしません。このバージョンのChangelog日付は2026-09-12です。詳細はego (lite)の更新履歴。
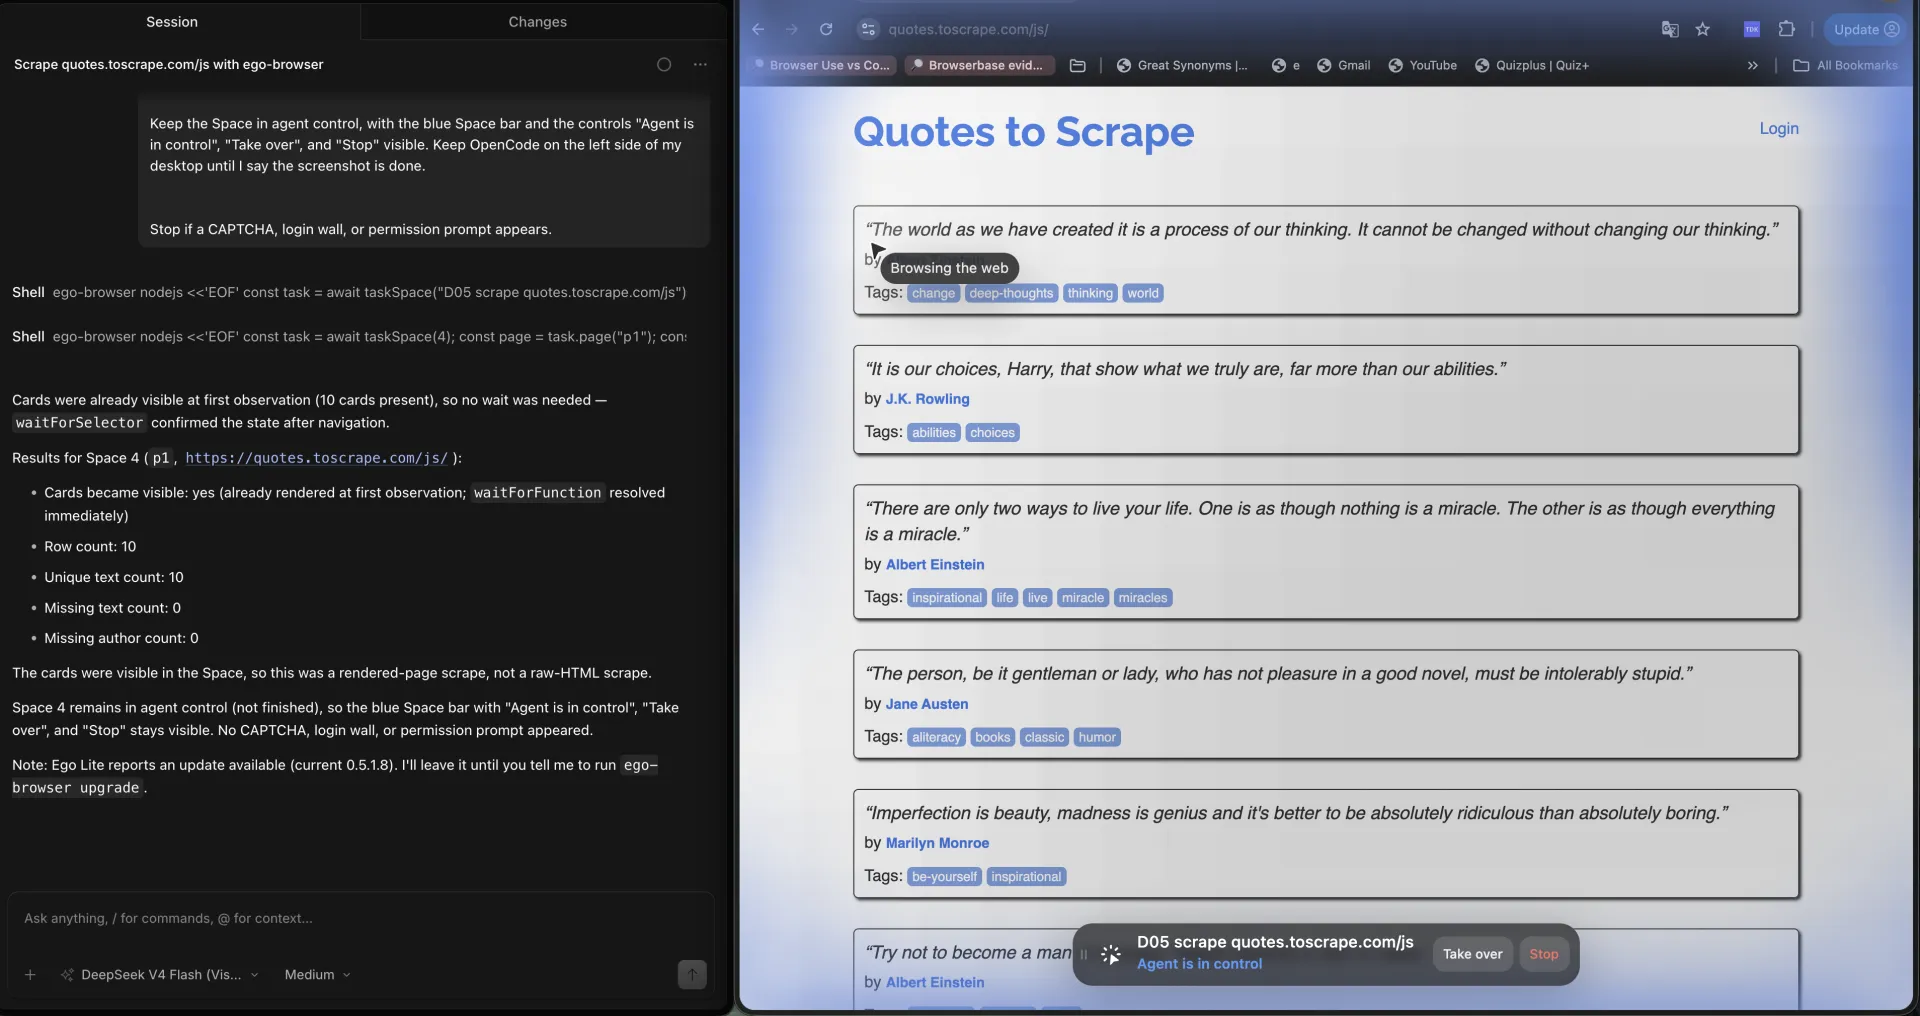
その分離は、OpenCodeからego (lite)で確認しました。Spacesの概要は、quotesのスクレイピングを単独の実行中Spaceに置き、他の作業は別Spaceへ分けていました。headed Chromiumウィンドウを1つ共有してはいません。
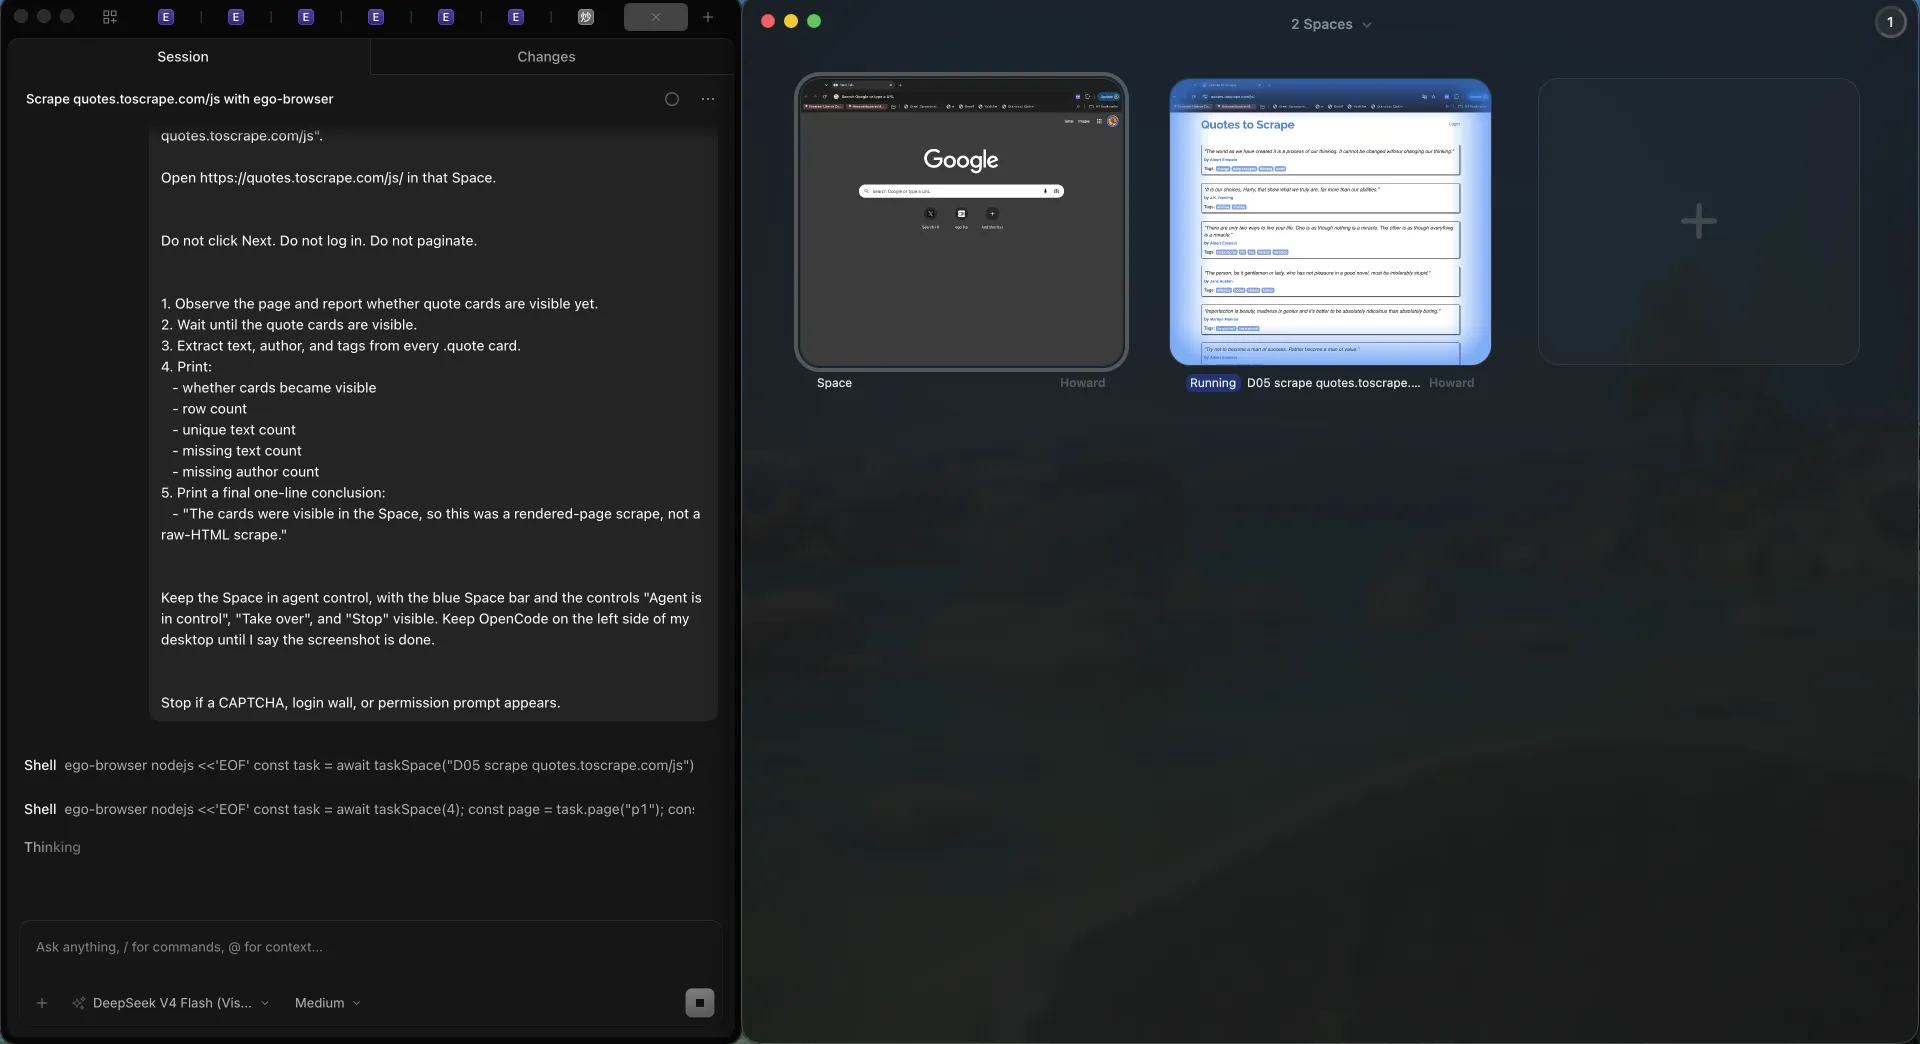
同じ公開URLを、そうしたSpaceの1つで確認しました。Space 4はquotes.toscrape.com/jsでエージェント制御のままで、Take overとStopが見え、一意カードを10件出力しました。
ヘッドレスとheadedのトレードオフは、AIエージェント向けのヘッドレスブラウザと実ブラウザの比較で扱っています。ライブラリの選定は、スクレイピングにおけるPlaywrightとPuppeteerで扱っています。製品レベルの対比は、ego (lite) vs Playwright。
課題と制限
Playwrightのスクレイピングは、HTTPより静かに失敗します。ブラウザは問題なさそうに見えても、ファイルが間違っていることがあるからです。
最初の制限はコストです。Chromiumのcontext 1つはGET 1回ではありません。カードがすでにHTMLにあるなら、不要なブラウザ代を払っています。
2つ目は、インターセプトについての正直さです。チュートリアルはXHRの捕捉を上級技として扱います。このデモでの上級技は、ペイロードがインラインだと認めることです。
3つ目はページ送りで、ここでは1行の制限のままにします。描画済みの1ページが検証できてから、番号付きページ、Load More、無限スクロールは別の仕事になります。待ちと抽出のこのページにそれらのループを混ぜると、空DOMの失敗が隠れます。
4つ目は許可です。robots規則、規約、個人データ法は依然として適用されます。headedブラウザでも、収集する権利は生まれません。
スクレイピングが空で、ページは埋まって見えるなら、カードを待ってから行数を数えます。headedウィンドウは証拠ではありません。このフィクスチャではインターセプトもJSON XHRを見つけず、引用はすでにvar dataとしてインラインにありました。
よくある質問
PlaywrightはWebスクレイピングに向いているか
人が見ているカードが生HTMLになく、実ブラウザで待てるなら、Playwrightはスクレイピングに向いています。quotes.toscrape.com/jsが公開例です。GETは.quoteノードを返さず、.quote待ちで描画済みカードを読めます。静的HTMLや文書化されたAPIの既定手段としては誤りです。
PlaywrightではなくHTTPを使うべきなのはどんなとき
値がすでにレスポンスボディにあるならHTTPを使います。JavaScriptデモには.quoteカードがなくても、引用を持つvar dataは残っています。そのペイロードのパーサーが安定しているなら、ブラウザは不要です。
Playwrightのスクレイピングが0件になる原因
0件はたいてい、カードが存在する前に抽出した、という意味です。このデモでは、描画前のcommitでDOMを読むと引用は0件、waitForSelector('.quote')の後なら描画済みカードが返り、空の場合でも例外は出ません。
networkidleを待つべきか
待つのはデータを表すセレクタであり、静かなネットワークではありません。networkidleは分析ビーコンで止まり得ます。このデモで通る待ちは.quoteであり、networkidleではありません。
PlaywrightでJSONをインターセプトする方法
content-typeにjsonを含むレスポンスを聞くか、ページがすでに呼んでいるURLをrouteします。quotes.toscrape.com/jsでは引用がインラインなので、捕捉するJSON XHRはありません。インターセプトは任意です。DOM待ちはそれでも動きます。
Playwrightでページ送りのあるリストをスクレイピングする方法
まず描画済みの1ページを仕上げます。待ち、抽出、件数の検証です。番号付きページ、Load More、無限スクロールは別の仕事です。このページはそれらのループを実装していません。
Playwrightスクレイピングでログインを再利用する方法
使ってよいログインのあとでストレージ状態を保存し、後のcontextで読み込みます。ファイルはシークレットとして扱い、期限切れを前提にしてください。
429が返ってきたときの対処
止まり、Retry-Afterがあれば守り、バックオフし、小さな再試行上限のあとで失敗させます。429はレートの合図であり、セレクタの問題ではありません。
Playwrightスクレイピングにego (lite)は必要か
いいえ。待ちとセレクタがすでに分かっているならPlaywrightです。見守れるSpace、実際のログイン済みプロファイル、人の引き継ぎが要るならego (lite)です。2026-09-18、どちらの経路もquotes.toscrape.com/jsから一意カードを10件抽出し、SpaceではTake overとStopが見えたままでした。
実ブラウザでのスクレイピングは合法か
サイト、データ、法域、ファイルの使い方によります。headedブラウザでもrobots規則と規約は適用されます。これは法的助言ではありません。
スクレイピングはPlaywrightとPuppeteerのどちらか
どちらも同じページを描画できます。ライブラリの選定はlocator、待ち、言語バインディングです。このページのHTTP対ブラウザの判断が先です。
次のスクレイピングが、また待ちをコードに落とすのではなく、見守れるブラウザを必要とするなら、ego (lite) は無料でダウンロードできます。価格スクレイパーの手順は、そのSpaceでの具体的な作業の1つです。
