

JavaScript-Web-Scraping scheitert oft nicht am Code, sondern an der falschen Zugangsroute. Stehen die Daten bereits im initialen HTML, genügen Node.js fetch und ein HTML-Parser. Ein Browser wird erst nötig, wenn die Seite JavaScript ausführen, blättern, klicken oder anderweitig interagieren muss, bevor die Daten erscheinen, was die Trennlinie zwischen statischem HTML und gerenderten Seiten ist.
Playwright eignet sich gut für Abläufe, die im Voraus bekannt und häufig wiederholt werden: Seite öffnen, auf ein Element warten, ein Steuerelement anklicken, die Felder extrahieren und denselben Pfad erneut durchlaufen. Zum Problem wird es, wenn sich Seitenstruktur, Paginierung oder Interaktionsablauf ändern und eine feste Folge aus Selektoren und Aktionen zu brechen beginnt.
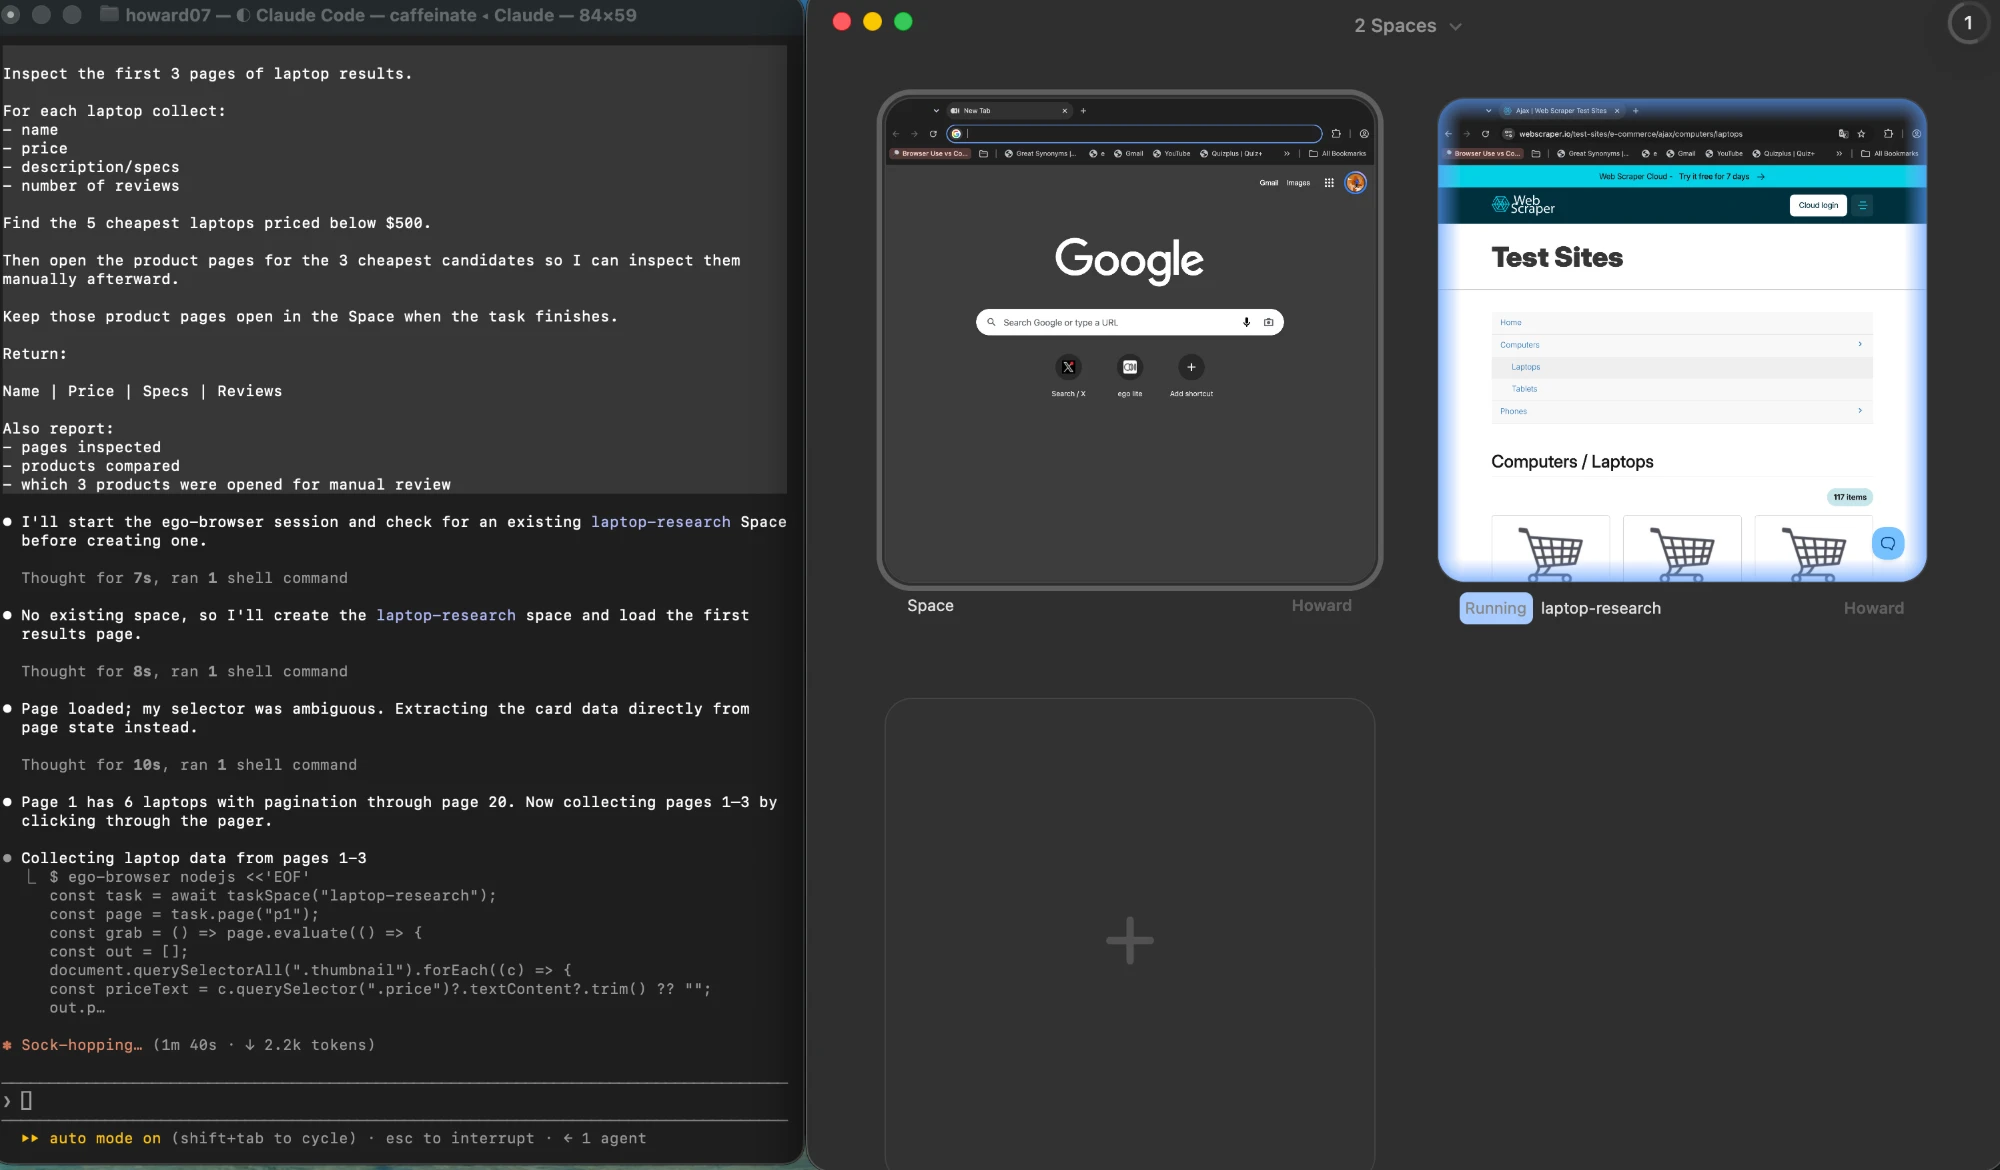
Hier passt ein agentengesteuerter Browser wie ego (lite) besser. Statt anzunehmen, dass der ursprüngliche Pfad noch existiert, kann der Agent die aktuell gerenderte Seite prüfen, den nächsten Schritt entscheiden und nach Navigation oder dynamischen Änderungen zuverlässig weiterarbeiten.
Was entscheidet tatsächlich, ob ein JavaScript-Scraper funktioniert?
Die Zugangsroute entscheidet über das Ergebnis. Dieselbe Zielseite kann über HTTP trivial scrapbar und für HTTP völlig undurchsichtig sein, je nachdem, ob die Daten bereits in der initialen HTML-Antwort ankommen oder erst danach von JavaScript in einem Browser geladen und gerendert werden.
Die erste Aufgabe ist also nicht das Schreiben eines Scrapers. Sie besteht darin, die Zielseite zu öffnen, den Quelltext statt des gerenderten DOM anzusehen und herauszufinden, wo die gewünschten Werte tatsächlich liegen. Alles Weitere in diesem Leitfaden folgt aus dieser Antwort.
Welche der drei Zugangsrouten braucht Ihr Ziel?
Drei Routen decken fast jede Scraping-Aufgabe ab, und sie sind nach Kosten geordnet. Statisches HTML ist am günstigsten und schnellsten. Ein JSON-Endpunkt, den die Seite bereits aufruft, liefert oft die saubersten Daten. Ein echter Browser ist am leistungsfähigsten und verursacht die höchsten Kosten bei CPU, Speicher und Anfälligkeit.
| Route | Was möglich ist | Was nicht möglich ist |
|---|---|---|
| HTTP-Anfrage + HTML-Parser | Ruft jede URL direkt ab, liest den Response-Body und fragt das zurückgegebene Markup ab. Schafft Tausende Seiten pro Minute und Prozess und braucht keine Browser-Binary. | Seitenskripte ausführen, klicken, scrollen oder Formulare ausfüllen. Bei einer client-gerenderten Seite liefert er nur die leere Hülle, weil die Daten nie in der Antwort standen. |
| Direkter JSON-Endpunkt | Liefert strukturierte Daten ohne Markup-Parsing, sodass Feldnamen auch ein Redesign des Seitenlayouts überstehen. Kleinste Nutzlast, schnellstes Parsing. | Über Website-Updates hinweg stabil bleiben. Diese Endpunkte sind intern, undokumentiert und können sich ändern oder Anfragen ohne Vorwarnung ablehnen. |
| Echte Browser-Automatisierung | Führt das JavaScript der Seite aus, wartet auf das Erscheinen von Inhalten und interagiert mit dem gerenderten Ergebnis genau wie ein Mensch. | Günstig skalieren. Jeder Browser-Kontext kostet echten Speicher, und eine ganze Flotte davon braucht mehr Infrastruktur als eine HTTP-Schleife. |
Wie rufen Sie statisches HTML in Node.js ab und parsen es?
Beginnen Sie mit der Plattform. Node.js stellt die Fetch API als global bereit, sodass eine Anfrage überhaupt keine Abhängigkeit braucht. Das folgende Muster ist die gesamte erste Route: anfragen, den Status prüfen, den Text lesen und das Markup an einen Parser übergeben.
Die Anfrage selbst braucht nichts außer der Plattform, denn die Fetch API als globales Node.js-Objekt mitgeliefert wird, sodass ein einfacher GET keine HTTP-Bibliothek zu installieren braucht.
Die Statusprüfung ist der Teil, den man am ehesten entfernt und am meisten vermisst. Eine 404- oder Bot-Block-Seite liefert trotzdem einen Body, und dieser Body parst fröhlich zu null passenden Elementen, was genau wie ein Selektor-Fehler aussieht.
const res = await fetch(url, {
  headers: { "user-agent": "my-scraper/1.0 (+contact@example.com)" },
});

if (!res.ok) {
  throw new Error(`${res.status} ${res.statusText} for ${url}`);
}

const html = await res.text();
Rate Limiting gehört in dieselbe Schleife und wird nicht später angeflanscht. Eine gewartete Pause zwischen den Anfragen hält einen kleinen Auftrag höflich und Ihre Adresse aus einer Blockliste:
const sleep = (ms) => new Promise((r) => setTimeout(r, ms));

for (const url of urls) {
  const html = await getHtml(url);
  await parse(html);
  await sleep(1000);
}
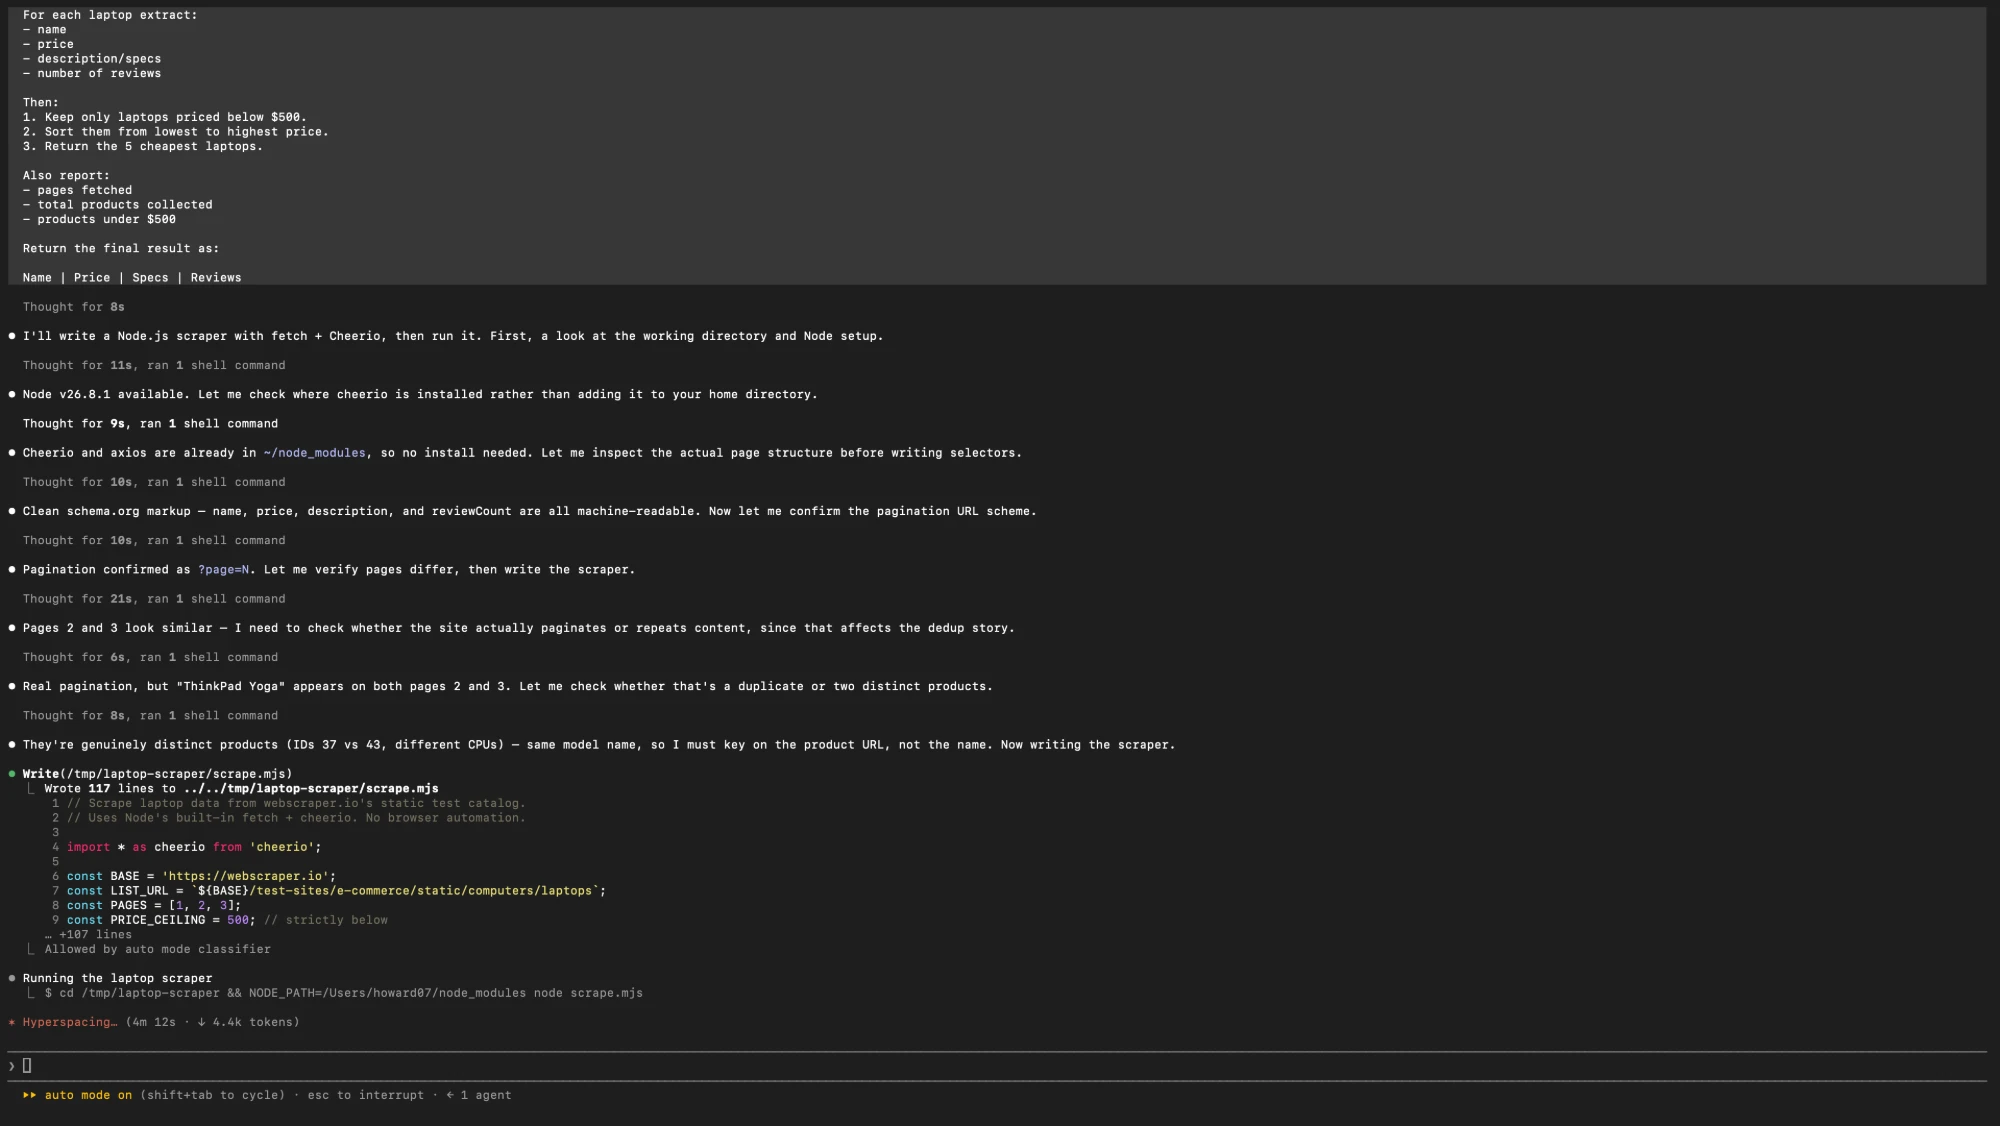
Das liefert die erste Route tatsächlich. Die folgende Tabelle ist echte Ausgabe einer einfachen HTTP-Anfrage plus einer Selektor-Bibliothek gegen einen öffentlichen Testkatalog von Laptops: kein Browser, kein Rendering-Schritt, drei Seiten als drei statische Antworten abgerufen.
| ID | Name | Preis | Technische Daten | Bewertungen |
|---|---|---|---|---|
| 32 | Aspire E1-510 | $306.99 | 15.6", Pentium N3520 2.16GHz, 4GB, 500GB, Linux | 2 |
| 45 | Asus VivoBook Max | $399 | 15.6" HD, Pentium N4200 1.1GHz, 4GB, 500GB, Windows 10 Home | 4 |
| 31 | Packard 255 G2 | $416.99 | 15.6", AMD E2-3800 1.3GHz, 4GB, 500GB, Windows 8.1 | 2 |
| 46 | Dell Vostro 15 | $488.78 | 15.6" FHD, Core i5-7200U, 4GB, 128GB SSD, Radeon R5 M420 2GB, Linux | 14 |
Vier von achtzehn Produkten kosten unter $500. Das ist das gesamte Ergebnis der ersten Route auf diesem Katalog: drei Anfragen, kein Rendering, kein Browser-Prozess. Und hier beginnt der ehrliche Teil, denn dieser Tabelle fehlt etwas, das ein Leser erwarten würde.
Cheerio, DOMParser oder jsdom: Welcher Parser passt?
Diese drei werden verglichen, als wären sie austauschbare Bibliotheken. Sind sie nicht, denn sie geben unterschiedliche Versprechen: Zwei von ihnen parsen Markup für Abfragen, und eine implementiert ein DOM mit Skriptausführung.
Der Parser, auf den sich dieser Leitfaden stützt, ist dokumentiert unter cheerio.js.org, wo ausdrücklich steht, dass Cheerio Markup parst und abfragt, statt Seitenskripte auszuführen.
| Option | Was möglich ist | Was nicht möglich ist |
|---|---|---|
| Cheerio | Parst einen HTML-String schnell und fragt ihn mit Selektoren im jQuery-Stil ab. Kleine Abhängigkeit, kein Browser, ideal für ein paar hundert Felder aus einem Response-Body. | Seitenskripte ausführen, Komponenten rendern oder Layout auflösen. Es parst Markup; es verhält sich nicht wie ein Browser. |
| jsdom | Stellt in Node.js eine DOM-Implementierung mit document, window und Skriptausführung bereit, sodass gegen Browser-APIs geschriebener Code unverändert läuft. | Bei Rendering und Genauigkeit mit einem echten Browser mithalten, und es ist pro Seite deutlich schwerer. Es ist ein DOM-Ersatz, nicht Chrome. |
| DOMParser | Verwandelt einen String mithilfe einer eingebauten Browser-API in ein abfragbares Dokument, ohne überhaupt eine Abhängigkeit zum Projekt hinzuzufügen. | Mit await verwendet werden: Es arbeitet synchron und blockierend, und in Node.js wurde es erst in neueren Versionen zu einem globalen Objekt. |
Das Auslesen aus Cheerio verwendet die vertraute Selektor-API. Beachten Sie, dass der extrahierte Text an den Rändern getrimmt wird, weil gescraptes Markup Einrückungen und Zeilenumbrüche enthält, die sonst in Ihrem Datensatz auftauchen:
import * as cheerio from "cheerio";

const $ = cheerio.load(html);
const items = $(".product-card").map((i, el) => ({
  name: $(el).find(".name").text().trim(),
  price: $(el).find(".price").text().trim(),
})).get();
Dieselbe Extraktion mit DOMParser sieht so aus und funktioniert nur dort, wo dieses globale Objekt existiert:
const doc = new DOMParser().parseFromString(html, "text/html");
const rows = [...doc.querySelectorAll("table tbody tr")].map((tr) => ({
  cells: [...tr.querySelectorAll("td")].map((td) => td.textContent.trim()),
}));
Wie finden Sie den JSON-Endpunkt, den die Seite bereits verwendet?
Bevor Sie einen einzigen Selektor schreiben, öffnen Sie das Netzwerk-Panel des Browsers, filtern Sie auf fetch und XHR, laden Sie die Seite neu und sehen Sie sich an, was zurückkam. Viele datengetriebene Websites setzen die sichtbare Seite aus wenigen JSON-Antworten zusammen, die sich viel leichter nutzen lassen als das Markup.
Wenn Sie einen finden, braucht die Anfrage meist dieselben Header, die die Seite gesendet hat, und manchmal ein Session-Cookie. Spielen Sie ihn mit der copy-as-fetch-Ausgabe des Netzwerk-Panels nach, statt ihn von Hand nachzubauen.
const res = await fetch("https://example.com/api/listings?page=1", {
  headers: { accept: "application/json" },
});

if (!res.ok) throw new Error(`${res.status} for listings page 1`);

const { items } = await res.json();Warum liefert eine client-gerenderte Seite nur eine leere Hülle?
Eine client-gerenderte Seite sendet Markup, das fast keinen Inhalt enthält. Die initiale Antwort enthält ein Root-Element, ein Bündel Skripte und vielleicht einen Ladezustand. Den Text, den eine Person auf dem Bildschirm sieht, erzeugt JavaScript erst nach dem Eintreffen der Antwort, sodass eine HTTP-Anfrage, die nur die Antwort liest, nichts zu lesen hat.
Das ist diagnostizierbar und nicht mysteriös. Zwei Prüfungen erfassen die meisten Fälle: Der sichtbare Text in der Antwort ist nur ein Bruchteil dessen, was der Browser zeigt, und das Markup wird von script-Tags dominiert:
const text = html.replace(/<script[\s\S]*?<\/script>/g, "").replace(/<[^>]+>/g, " ").replace(/\s+/g, " ").trim();

console.log({
  textLength: text.length,
  scriptCount: (html.match(/<script\b/g) ?? []).length,
  hasRoot: /id="(root|app|__next)"/.test(html),
});
Kurzer Text, viele Skripte und ein leeres Root-div zusammen bedeuten, dass die dritte Route die ehrliche Antwort ist. Ein paar Dutzend Zeichen Text ganz ohne script-Tag bedeuten meist etwas Einfacheres: Die Anfrage wurde blockiert, oder Sie haben die falsche URL angefragt.
Wie der Unterschied in der Praxis aussieht:
| Signal in der HTTP-Antwort | Was es meist bedeutet | Nächster Schritt |
|---|---|---|
| Vollständiger Inhalt, echtes Markup | Der Server hat die Seite gerendert. Mehr ist nicht nötig. | Mit einer Selektor-Bibliothek parsen. |
| Root-div plus viele Skripte | Clientseitiges Rendering. Der Inhalt kommt nach der Antwort. | Den JSON-Endpunkt suchen oder die Seite rendern. |
| Sehr kurzer Text, keine Skripte | Blockiert, weitergeleitet oder schlicht die falsche URL. | Status, endgültige URL und Header vor dem Parsing protokollieren. |
Wie scrapt Playwright eine Seite in einem echten Browser?
Playwright steuert einen echten Browser, sodass die Seite genauso ausgeführt wird wie für einen Besucher. Die Scraping-Form ist kleiner, als die meisten erwarten: einen Kontext öffnen, zur URL navigieren, auf genau das warten, was Sie brauchen, und es dann auslesen.
Die hier verwendete API-Oberfläche ist dokumentiert unter playwright.dev, der kanonischen Referenz zum Starten von Browsern, Kontexten und Locators.
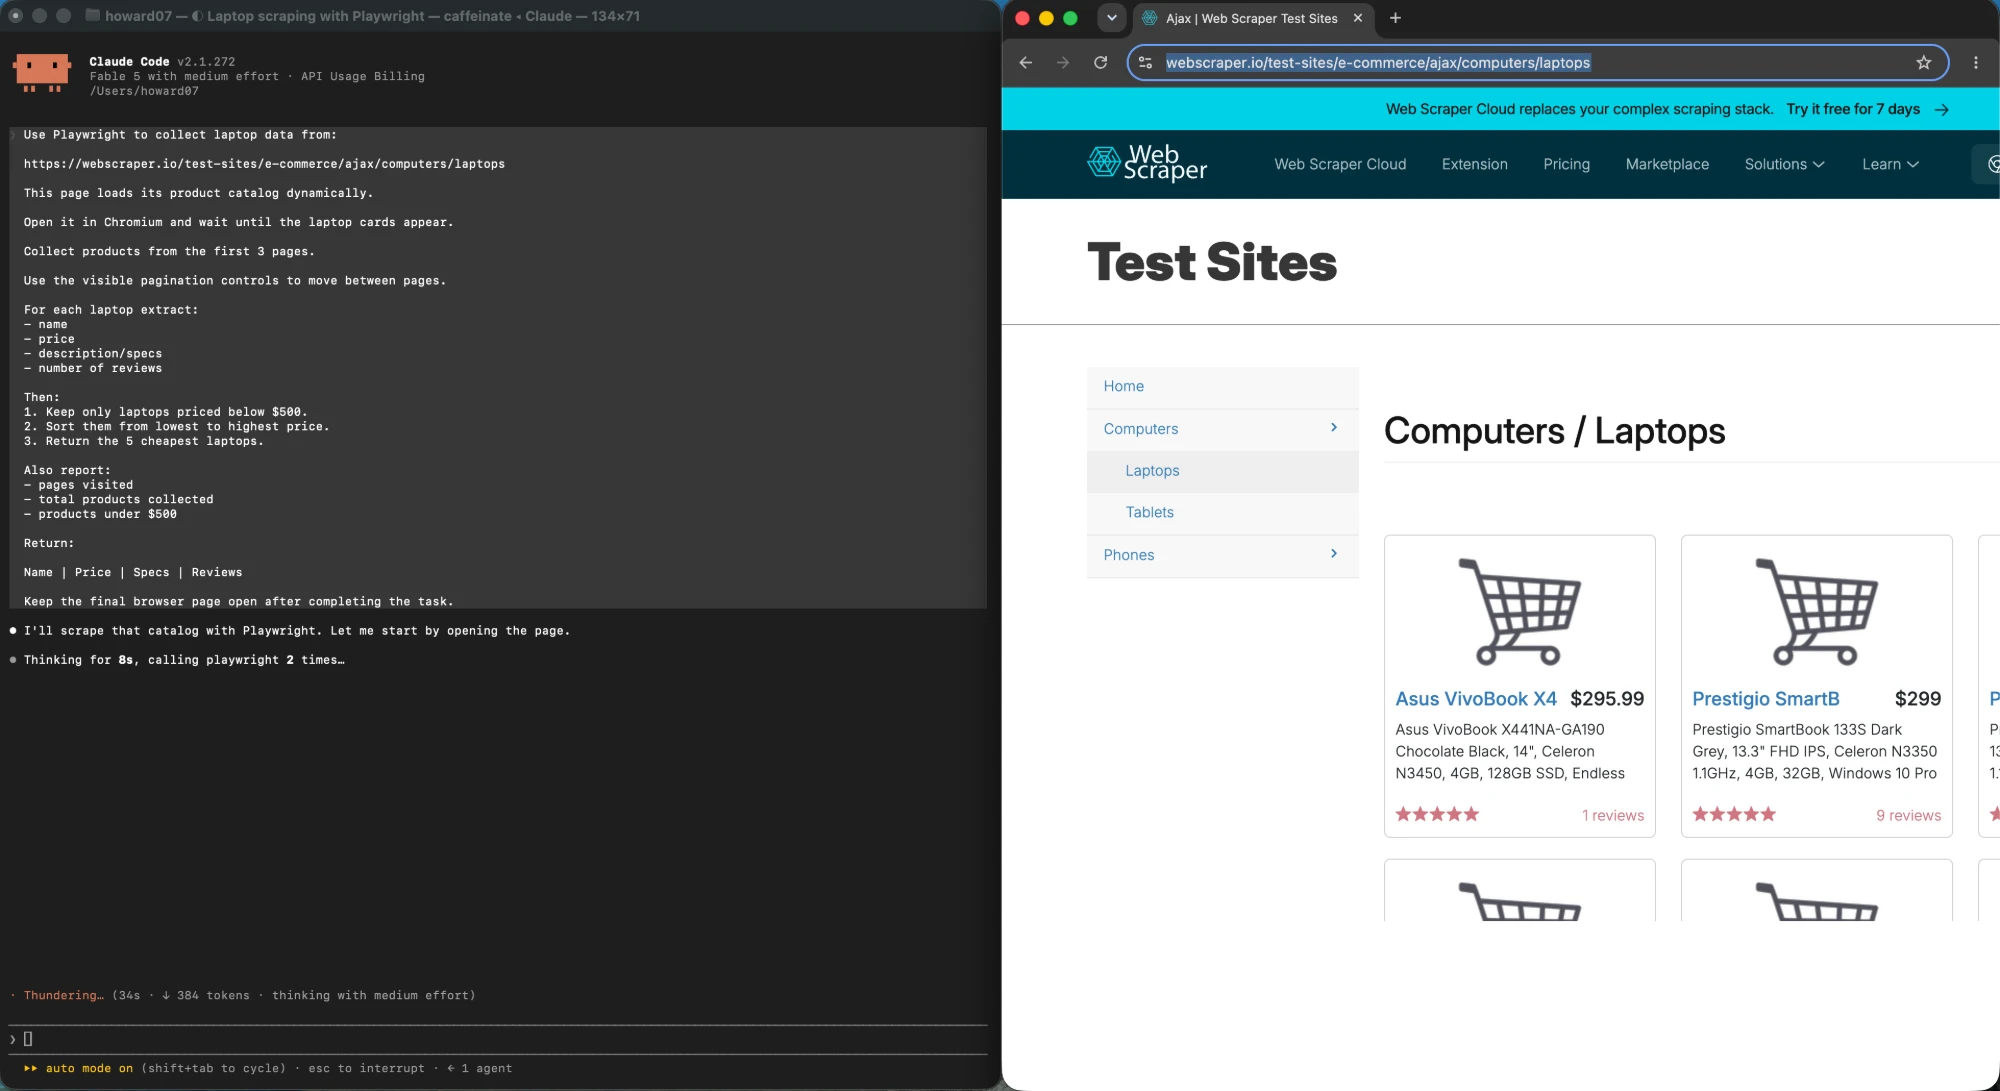
Das folgende Abrufmuster wartet auf einen Selektor und extrahiert dann über page.evaluate, wodurch Ihre Funktion innerhalb der Seite ausgeführt wird und ein serialisierbares Ergebnis zurückkommt:
import { chromium } from "playwright";

const browser = await chromium.launch();
const context = await browser.newContext();

try {
  const page = await context.newPage();
  await page.goto(url, { waitUntil: "domcontentloaded" });
  await page.waitForSelector(".product-card");

  const rows = await page.evaluate(() =>
    [...document.querySelectorAll(".product-card")].map((el) => ({
      name: el.querySelector(".name")?.textContent?.trim() ?? null,
      price: el.querySelector(".price")?.textContent?.trim() ?? null,
    })),
  );

  console.log(rows);
} finally {
  // contexts hold the memory; close it even when the scrape throws
  await context.close();
  await browser.close();
}
Zwei Details des Lebenszyklus sind wichtiger als die Selektoren. Ein Kontext ist die günstige, entbehrliche Einheit, sodass ein Browser mehrere isolierte Läufe bedienen kann, und jeder endet mit einem close. Das zweite: Die Textextraktion auf der Seite liefert Textknoten, keine gerenderten Werte. Durch CSS versteckter Inhalt ist weiterhin im DOM und erscheint weiterhin in Ihrer Ausgabe.
Wenn das Ziel ein bestimmtes Element und nicht die ganze Liste ist, sind Locators der sauberere Abrufweg. Die Playwright-Dokumentation zu Locators merkt an, dass für Buttons, Links und Eingabefelder kein Warten auf einen Klick nötig ist, was man sich merken sollte, bevor man jede Interaktion in ein explizites Warten packt:
const title = await page.getByRole("heading", { level: 1 }).innerText();
const price = await page.locator("[data-testid=price]").innerText();
Wie verändern Sitzungen, Sperrrisiko und CAPTCHA den Plan?
Sobald ein Ziel einen Login erfordert, ist der Scraper keine Datenübung mehr, sondern ein Sitzungsverwaltungsproblem. Playwright unterstützt das direkt: einmal authentifizieren, den Storage State des Browsers in einer Datei speichern und in späteren Läufen wiederverwenden, statt jedes Mal eine Anmeldeeingabe zu skripten.
// once, interactively
await context.storageState({ path: "auth.json" });

// later runs
const context = await browser.newContext({ storageState: "auth.json" });
Daraus folgen zwei betriebliche Fakten. Ein gespeicherter Sitzungszustand ist ein Anmeldedatum und gehört daher in einen Secrets Store statt ins Repository. Und eine gespeicherte Sitzung läuft ab, sodass ein Lauf, der plötzlich Login-Seiten zurückgibt, ein Sitzungsproblem ist und kein Selektorproblem.
Diesen Zustand über Starts hinweg am Leben zu halten, ist ein eigenes Thema: dauerhafte Browser-Sitzungen über Agentenläufe hinweg werden dort im Detail behandelt.
Für automatisierten Verkehr im Allgemeinen entscheiden drei Beschränkungen, ob Sie eine Scraping-Aufgabe oder einen aussichtslosen Kampf haben: was die robots-Richtlinien und Nutzungsbedingungen der Website erlauben, welche Rate die Website veröffentlicht oder toleriert und ob die Antwort, die Sie erhalten, der Inhalt oder eine Challenge-Seite ist. Das sind Grundsatzfragen, die vor dem Schreiben von Code zu klären sind, und sie werden ausführlicher behandelt in unserem Leitfaden zu Scraping hinter Login-Walls.
Was lässt einen JavaScript-Scraper in der Produktion scheitern?
Scraper scheitern selten, weil ein Selektor falsch war. Sie scheitern beim zweiten Lauf, bei der hundertsten URL, wenn eine Seite langsamer ist, eine Antwort eine Weiterleitung ist oder die Website zu drosseln beginnt. Die Korrekturen sind unspektakulär und konkret.
async function getWithRetry(url, attempt = 0) {
  const res = await fetch(url);
  if (res.status === 429 || res.status >= 500) {
    if (attempt >= 3) throw new Error(`giving up on ${url}`);
    const retryAfter = Number(res.headers.get("retry-after"));
    const waitMs = Number.isFinite(retryAfter)
      ? retryAfter * 1000
      : 2 ** attempt * 1000;
    await new Promise((r) => setTimeout(r, waitMs));
    return getWithRetry(url, attempt + 1);
  }
  if (!res.ok) throw new Error(`${res.status} for ${url}`);
  return res.text();
}
Nebenläufigkeit ist die zweite Falle. Zehn parallele Browser-Kontexte auf einer Maschine konkurrieren größtenteils um dieselbe CPU, sodass der Durchsatzgewinn kleiner ist als die Speicherkosten und die Website einen Stoß statt eines Rinnsals sieht. Starten Sie sequenziell, messen Sie, und erhöhen Sie die Zahl erst dann, wenn das Ziel sie toleriert.
Der dritte Punkt: Jeder Scraper, der einen Endpunkt ohne Zusage liest, braucht einen Fallback. Behalten Sie das selektorbasierte Parsing der sichtbaren Seite im Code und lassen Sie einen fehlgeschlagenen JSON-Aufruf darauf zurückfallen, damit eine stille Änderung auf der Gegenseite den Lauf verschlechtert statt ihn zu leeren.
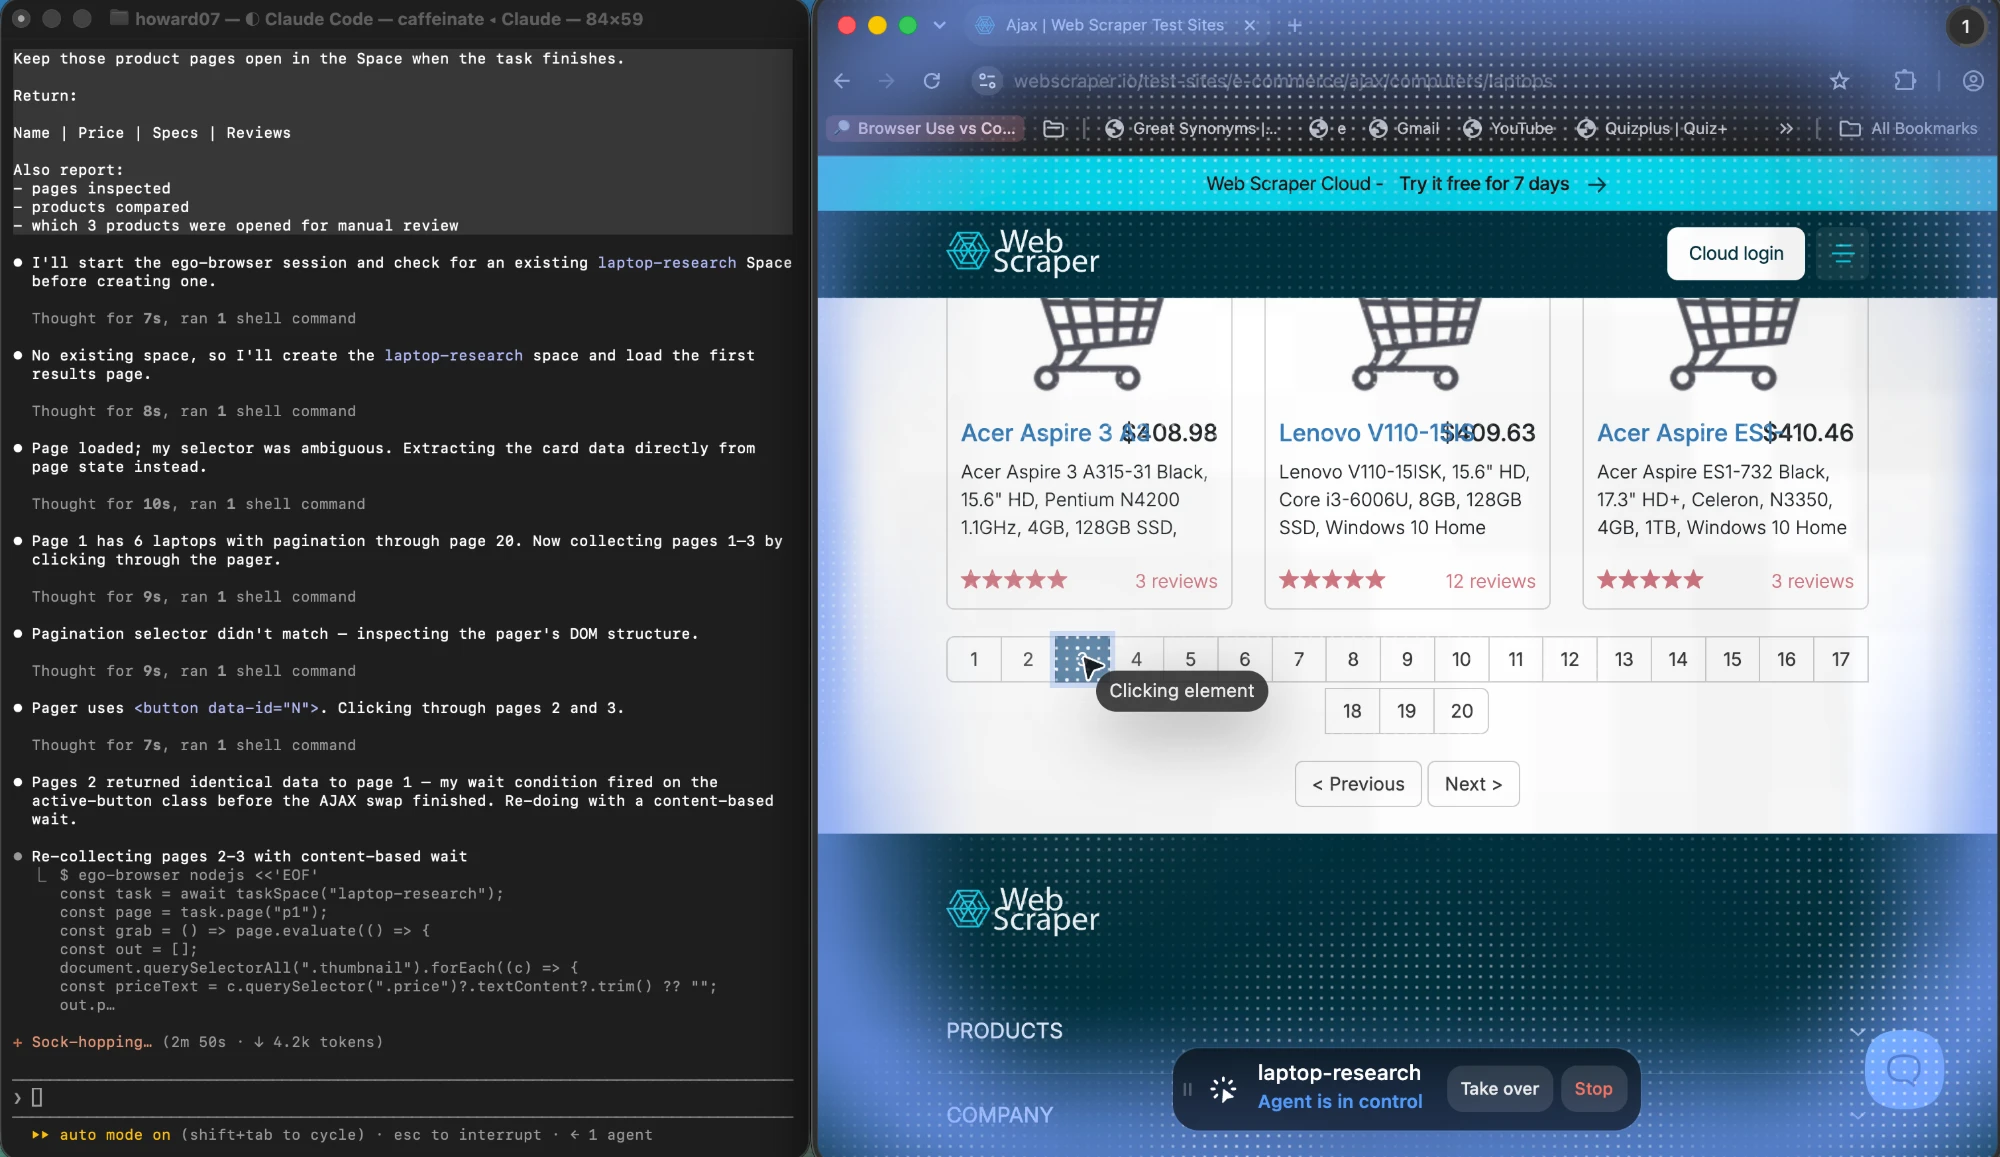
Wann ist ein echter Browser wirklich erforderlich?
Ein echter Browser ist die richtige Antwort, wenn die Aufgabe etwas erfordert, das nur ein Browser bieten kann: eine authentifizierte Sitzung, die bereits auf Ihrem Rechner existiert, Inhalte, die erst nach einer Interaktion erscheinen, ein Ablauf, bei dem eine Person zwischendurch eingreifen muss, oder ein Ergebnis, das beobachtet werden muss, während es entsteht, statt es abzurufen. Außerhalb dieser Fälle ist HTTP mit einem Parser schneller, günstiger und leichter am Laufen zu halten.
Der Kompromiss zwischen einem Headless-Browser und einem echten Browser wird behandelt in Headless-Browser vs. echter Browser für KI-Agenten.
Genau in dieser Situation lohnt es sich, einen aufgabengetriebenen Browser-Agenten einzuführen. ego (lite) ist ein Browser für agentengesteuerte Arbeit: Sie beschreiben das Ziel, und er arbeitet in einem echten Browser, einschließlich der bereits geöffneten angemeldeten Sitzungen, mit einer sichtbaren Oberfläche, die Sie übernehmen können, wenn ein Schritt menschliches Urteilsvermögen erfordert. Bei Scraping-Aufgaben, die einen echten Login-Zustand, eine dynamische Seite, sichtbare Ausführung oder eine menschliche Übergabe brauchen, entfällt damit die oben beschriebene Sitzungsverdrahtung. Er ist kein Ersatz für Playwright und verspricht nichts für jede Website: Seiten, die mit einer Challenge antworten oder automatisierten Zugriff verbieten, sind für ihn genauso tabu wie für jede andere Route. Wo eine einfache HTTP-Anfrage oder eine offizielle API bereits liefert, was Sie brauchen, würde ein Browser-Agent die Aufgabe nur langsamer machen.
Für einen tieferen Vergleich der Browser-Werkzeuge, wenn ein Browser wirklich die Antwort ist, behandelt unser Playwright-vs-Puppeteer-Vergleich zum Scraping die Bibliothekswahl selbst, und KI-Web-Scraper-Workflows zeigt, wo Agenten in einer Scraper-Pipeline hingehören.
Was sind die wichtigsten Herausforderungen und Grenzen?
Jede Route in diesem Framework hat einen Fehlermodus, den Sie nicht wegkonstruieren können, und sie im Voraus zu kennen unterscheidet einen Scraper, der ein Jahr läuft, von einem, der eine Woche läuft.
Statisches Parsing bricht, wenn die Website ihr Markup überarbeitet. Es kann das nicht bemerken, weshalb ein Feld, das stillschweigend null wird, häufiger ist als ein offener Absturz. Validieren Sie bei jedem Lauf eine Stichprobe, statt der Pipeline zu vertrauen.
Interne JSON-Endpunkte brechen ganz ohne Vorwarnung, und sie sind der am wenigsten verbindliche Teil jeder Website. Ein erfolgreicher Lauf heute ist kein Beweis für den nächsten Monat.
Browser-Automatisierung ist die realistischste und zugleich die brüchigste im großen Maßstab. Der Speicher wächst mit der Nebenläufigkeit, Sitzungen laufen ab, und Anti-Bot-Systeme reagieren auf Muster statt auf Absicht, sodass eine Technik, die vom Laptop aus funktioniert, aus einem Rechenzentrum heraus nicht funktionieren muss.
Und die größte Einschränkung ist nicht technisch. Was Sie erheben dürfen, wie oft und was Sie anschließend damit tun dürfen, entscheiden die Nutzungsbedingungen der Website, robots-Richtlinien und das Recht in Ihrer Gerichtsbarkeit, und nichts davon ändert sich, weil der Code funktioniert.
Die Fehlersuche, die sich daraus ergibt, ist kurz. Wenn ein Scrape nichts zurückgibt, prüfen Sie zuerst den Statuscode, dann, ob der Inhalt überhaupt in der Antwort steht, und dann, ob der Selektor zum gerenderten DOM statt zum Quelltext passt. Erst nach diesen drei Schritten sollte der Browser in Betracht gezogen werden.
FAQ
Brauche ich eine Bibliothek für HTTP-Anfragen in Node.js?
Nein. Node.js stellt die Fetch API als global bereit, sodass fetch ohne Installation verfügbar ist, zusammen mit dem Response-Objekt und seinen Mitgliedern ok, status und text(). Was Sie brauchen, ist ein Parser, denn fetch liefert einen String zurück, und String-Abgleich über HTML bricht, sobald sich das Markup ändert.
Warum liefert mein Scraper eine leere Liste von einer Seite, die im Browser in Ordnung aussieht?
Die wahrscheinlichste Ursache ist, dass die Seite client-gerendert wird und die Daten nie in der HTTP-Antwort standen. Bestätigen Sie das, indem Sie den sichtbaren Text in der Rohantwort mit dem vergleichen, was der Browser zeigt, und die script-Tags relativ zum Inhalt zählen. Ist die Antwort eine Hülle, wechseln Sie zum JSON-Endpunkt der Website oder rendern Sie die Seite in einem echten Browser.
Ist Cheerio ein Ersatz für einen Headless-Browser?
Nein. Cheerio parst HTML und lässt Sie es mit Selektoren abfragen. Es führt kein JavaScript aus und kann daher keinen Inhalt erzeugen, den die Seite nach dem Laden generiert. Es ist das richtige Werkzeug für die erste Route und das falsche für die dritte, und zu einem Browser zu greifen, wo Cheerio genügen würde, ist der häufigste unnötige Kostenfaktor in Scraping-Code.
Woran erkenne ich, ob eine Seite serverseitig oder clientseitig gerendert wird?
Fragen Sie die URL an und sehen Sie sich die Rohantwort statt des gerenderten DOM an. Stehen die gewünschten Werte im Response-Body, wird die Seite serverseitig gerendert und die günstige Route funktioniert. Enthält der Body ein Root-Element, Skript-Bündel und wenig Text, wird der Inhalt im Browser zusammengesetzt.
Wie scrape ich eine Seite, die einen Login erfordert?
Melden Sie sich einmal in einem Browser-Kontext an, speichern Sie den Storage State in einer Datei und laden Sie diesen Zustand in späteren Läufen. Behandeln Sie die Datei als Geheimnis, rechnen Sie mit ihrem Ablauf und bevorzugen Sie eine Sitzung, die Sie verwenden dürfen. Wenn ein Ziel das Umgehen eines CAPTCHA oder einer Eigentumsprüfung erfordert, hören Sie auf und nutzen Sie stattdessen eine offizielle Route.
Ist Playwright oder Puppeteer besser zum Scraping?
Beide steuern einen echten Browser und können dieselben Seiten scrapen. Die Entscheidung betrifft Bibliotheksdetails wie Locator-Unterstützung, Warteverhalten und Sprachbindungen und nicht die Zugangsrouten; sie wird behandelt in unserem Playwright-vs-Puppeteer-Vergleich. Welchen Sie auch wählen: Die Routenentscheidung aus diesem Artikel kommt zuerst.
Wie viele Seiten kann ich gleichzeitig scrapen?
Starten Sie sequenziell und messen Sie, bevor Sie die Nebenläufigkeit erhöhen. HTTP-Anfragen skalieren weit günstiger als Browser-Kontexte, und parallele Browser auf einer Maschine konkurrieren größtenteils um dieselbe CPU und bescheren der Zielseite einen Verkehrsstoß. Für HTTP-Scraping sind vier bis acht gleichzeitig mit einer Pause ein sichererer Ausgangspunkt als Dutzende.
Was sollte ich bei einer 429-Antwort tun?
Lesen Sie den Retry-After-Header und warten Sie mindestens so lange, wiederholen Sie dann mit exponentiellem Backoff bis zu einer kleinen Obergrenze und brechen Sie danach mit einem klaren Fehler ab. Eine 429 ist ein Rate-Signal und kein Fehler, den man in einer engen Retry-Schleife durchhämmert; wer sie ignoriert, landet mit seiner Adresse auf einer Blockliste.
Ist Scraping legal?
Das hängt von der Website, den Daten, der Gerichtsbarkeit und davon ab, was Sie mit dem Ergebnis tun. Robots-Richtlinien und Nutzungsbedingungen sagen, was eine Website erlaubt, und Regeln zu personenbezogenen Daten und Datenbankrechten variieren von Land zu Land. Nichts in diesem Artikel ist Rechtsberatung; prüfen Sie die Bedingungen und das anwendbare Recht, bevor Sie in großem Umfang etwas erheben.
Wann sollte ich eine offizielle API statt Scraping verwenden?
Immer wenn eine existiert und die benötigten Felder abdeckt. Eine dokumentierte API ist ein stabiler Vertrag, hat meist explizite Rate Limits und bricht nicht, wenn sich das Seitenlayout ändert. Scraping ist der Fallback für Daten, die in einem Browser ohne unterstützten Zugangsweg veröffentlicht werden, nicht der Standard.
Brauche ich einen Browser-Agenten zum Scraping?
Nur für Aufgaben, die einen echten Login-Zustand, nach einer Interaktion erscheinenden Inhalt, sichtbare Ausführung oder eine menschliche Übernahme mitten im Ablauf brauchen. Für Seiten, die ihren Inhalt über HTTP zurückgeben, oder Websites mit einer offiziellen API verursacht ein Browser-Agent Kosten, ohne Fähigkeiten hinzuzufügen.
Wenn Sie die Browser-Agenten-Route bei einer Scraping-Aufgabe ausprobieren möchten, die sie wirklich braucht, ist ego (lite) kostenlos zum Herunterladen, und die Seiten Preis-Scraper und SERP-Scraper führen zwei konkrete Aufgaben von Anfang bis Ende durch.