
वेब स्क्रैपिंग में पेजिनेशन सिर्फ़ अगले पेज तक पहुँचना नहीं है। मुश्किल हिस्सा यह जानना है कि और डेटा बाकी है या नहीं, और सूची सच में खत्म हुई या नहीं। ज़्यादातर साइटें तीन पैटर्न में से एक इस्तेमाल करती हैं: नंबर पेज, Load More, या इनफिनिट स्क्रॉल, और हर एक की नेविगेशन रणनीति, इंतज़ार की शर्त और रुकने का नियम अलग है। इसमें गलती हुई तो क्रॉलर बिना कोई एरर दिए जल्दी रुक सकता है।
अगर डेटा सीधे HTML या JSON एंडपॉइंट में है, तो आमतौर पर ब्राउज़र की ज़रूरत ही नहीं; सादा HTTP सरल और तेज़ है। ब्राउज़र तब काम आता है जब सूची क्लाइंट-साइड रेंडरिंग, लॉगिन सत्र, पेज पर बने टोकन, या असली स्क्रॉल व्यवहार पर निर्भर हो। और जब वह डेटा उसी ब्राउज़र पर टिका हो जिसमें आप पहले से साइन इन हैं, तो ego (lite) एक AI एजेंट को लॉगिन स्टेट फिर से बनाने के बजाय उसी मौजूदा ब्राउज़र सत्र में वही पेजिनेशन लॉजिक चलाने देता है।
नीचे के खंडों में हम नंबर पेज, Load More और इनफिनिट स्क्रॉल एक ही सवाल के साथ जाँचेंगे: सूची सच में खत्म हुई, या क्रॉलर ने बस और माँगना बंद कर दिया? उदाहरण दोहराए जा सकने वाले लोकल फिक्स्चर पर हैं: नंबर पेज पर 135 पंक्तियाँ, Load More के पीछे 81 रेंडर पंक्तियाँ, और 60 आइटम की इनफिनिट फ़ीड। अंत तक क्रॉलर सिर्फ़ पेजिनेट नहीं करेगा, वह यह भी लिखेगा कि कहाँ रुका, डुप्लिकेट और छूटी पंक्तियाँ संभालेगा, और जाँचेगा कि इकट्ठा डेटा पूरा है।
कैसे पता करें कि आपके पास कौन सा पेजिनेशन मोड है
तीन अवलोकन वर्गीकरण तय कर देते हैं। URL बदलना या नंबर लिंक पर क्लिक करना परिणाम सेट बदलता है, यह नंबर पेजिनेशन है। ऐसा बटन जिसका लेबल और सामग्री का वादा करता है, URL बदले बिना पंक्तियाँ जोड़ता है, यह लोड मोर है। स्क्रॉल करते पंक्तियाँ दिखें और क्लिक करने को कोई कंट्रोल न हो, यह इनफिनिट स्क्रॉल है। पेज पैटर्न मिलाए तो हर संक्रमण को अपना मोड मानें, एक ही लूप से दोनों ढकने की कोशिश न करें।
ब्राउज़र में एक त्वरित जाँच कोड पढ़ने से तेज़ फैसला देती है: DevTools खोलें, नेटवर्क पैनल देखें, और एक बार इंटरैक्ट करें। page पैरामीटर वाली नेविगेशन रिक्वेस्ट नंबर पेजिनेशन है। क्लिक से निकली बैकग्राउंड JSON या HTML रिक्वेस्ट लोड मोर है। स्क्रॉल करते दोहराई जाने वाली रिक्वेस्ट इनफिनिट स्क्रॉल हैं, और प्रतिक्रिया में अक्सर अगला offset होता है, जो क्रॉलर के लिए तोहफा है।
नंबर पेज: URL नियम निकालें और सही जगह रुकें
नंबर पेजिनेशन सबसे सहज मोड है क्योंकि स्टेट URL में रहता है। पहले तीन पेज से नियम निकालें: कौन सा पैरामीटर बदलता है, वह पेज नंबर है या offset, और पेज साइज़ तय है या नहीं। नियम एक फ़ंक्शन की तरह लिखा जा सके, और सही फ़ंक्शन पेज 3 से पेज 4 बना दे, बीच में कुछ देखे बिना।
// Derive once, then verify against page 2 and page 3 before trusting it.
const pageUrl = (n) => `https://example.com/listings?page=${n}`;

let page = 1;
const rows = [];
while (true) {
  await browserPage.goto(pageUrl(page));
  const batch = await browserPage.locator("tr.row").evaluateAll((nodes) =>
    nodes.map((node) => ({
      id: node.dataset.id,
      title: node.querySelector(".title").textContent.trim(),
      price: Number(node.querySelector(".price").textContent.replace(/[^0-9.]/g, "")),
    })),
  );
  if (batch.length === 0) break;
  rows.push(...batch);

  const hasNext = (await browserPage.locator("a#next").count()) > 0;
  if (!hasNext) break;
  page += 1;
}
रुकने पर जितना ध्यान आमतौर पर जाता है, उससे ज़्यादा चाहिए। गायब next लिंक और खाली बैच दोनों असली अंत संकेत हैं; तय पेज कुल नहीं है, क्योंकि सूचियाँ बढ़ती हैं और आज हार्ड-कोड किया नंबर अगले महीने गलत हो जाता है। फिक्स्चर रन में क्रॉलर पेज 1 से 5 तक चला, 80 milliseconds में 135 पंक्तियाँ इकट्ठा कीं, और next लिंक गायब होते ही रुक गया। उन पाँच रिक्वेस्ट में से एक ने पहली कोशिश पर 503 लौटाया, क्रॉलर ने वही पेज एक बार फिर माँगा, और रीट्राई सफल रही।
दो नियम लूप को ईमानदार रखते हैं। पहला, पेज रिक्वेस्ट के बीच स्लीप करें, जितनी तेज़ हो उतनी तेज़ न चलाएँ, और साइट की शर्तों तथा robots exclusion प्रोटोकॉल का सम्मान करें, जिसका वर्णन RFC 9309 में है। दूसरा, सूची क्रमबद्ध होनी चाहिए तो दोहराए गए पेज को रुकने का संकेत मानें, क्योंकि अपने पैरामीटर अनदेखा करने वाला पेजिनेशन वरना हमेशा घूम सकता है।
लोड मोर: क्लिक करें, इंतज़ार करें और डुप्लिकेट हटाएँ
लोड मोर स्टेट को बटन के पीछे छिपाता है, इसलिए क्रॉलर को खुद ग्रोथ बनानी पड़ती है: क्लिक करें, पंक्ति काउंट सच में बढ़ने तक इंतज़ार करें, नया इकट्ठा करें, और तब तक दोहराएँ जब तक बटन गायब न हो या कुछ बदलना बंद न कर दे। इंतज़ार वही जगह है जहाँ ज़्यादातर इम्प्लीमेंटेशन फेल होते हैं। तय पॉज़ तेज़ कनेक्शन पर चल जाता है और धीमे कनेक्शन पर सूची चुपचाप काट देता है।
await browserPage.goto("https://example.com/listings");

while (true) {
  const button = browserPage.locator("#load-more");
  if ((await button.count()) === 0) break;

  const before = await browserPage.locator("tr.row").count();
  await button.click();
  await browserPage.waitForFunction(
    (n) => document.querySelectorAll("tr.row").length > n,
    before,
    { timeout: 10000 },
  );
}

const rows = await browserPage.locator("tr.row").evaluateAll((nodes) =>
  nodes.map((node) => ({ id: node.dataset.id, title: node.textContent.trim() })),
);
फिक्स्चर रन में 20 पंक्तियों के 4 बैच 273 milliseconds में आए, और दिखने वाली सूची में 81 पंक्तियाँ थीं जबकि डेटासेट 80 का था। अतिरिक्त पंक्ति वह डुप्लिकेट है जो फिक्स्चर एक आम हकीकत दिखाने के लिए बोता है: एक ही रिकॉर्ड अलग बैच में दो बार आना। पेज की अपनी स्टेटस लाइन "Loaded 81 of 80" पढ़ती थी, जो याद दिलाती है कि साइट का रेंडर काउंटर सत्यापन स्रोत नहीं है। स्थिर पहचान पर डेडुप करें, जैसे पंक्ति का record id, दिखने वाले टाइटल पर नहीं, और ठीक वही एक डुप्लिकेट हट जाएगा।
इनफिनिट स्क्रॉल: ट्रिगर, ऊँचाई की स्थिरता और रुकने के नियम
इनफिनिट स्क्रॉल में न बटन है न URL, इसलिए ट्रिगर और रुकने की शर्त दोनों अनुमान से निकालने पड़ते हैं। ट्रिगर आमतौर पर व्यूपोर्ट में आने वाला सेंटिनल एलिमेंट या स्क्रॉल स्थिति की सीमा होता है। रुकने की शर्त पर फैसला चाहिए, क्योंकि सूची अंत ऐसे नहीं बताती कि उस पर क्लिक किया जा सके।
एक मापी गई नाकामी दिखाने लायक है, क्योंकि ज़्यादातर क्रॉलर इसी नाकामी के साथ निकलते हैं। एक बार नीचे स्क्रॉल करके, अगले बैच के रेंडर का इंतज़ार किए बिना, पंक्ति काउंट बढ़ा या नहीं जाँचना तुरंत "no growth" बताता है: फिक्स्चर 15 of 60 पंक्तियों पर रुक गया, एक बैच के अंदर, जबकि नेटवर्क से अगला बैच पहले ही माँगा जा चुका था। जाँच उस पल पर गलत नहीं थी; गलत यह था कि एक शांत क्षण को सूची का अंत मान लिया।
भरोसेमंद संस्करण देखने योग्य शर्त का इंतज़ार करता है, फिर एक नहीं कई जाँचों से अंत पक्का करता है। स्क्रॉल करें, आइटम काउंट बढ़ने या पेज के फ़ीड खत्म कहने तक इंतज़ार करें, और तभी सूची समाप्त मानें जब तीन लगातार जाँचों में दोनों में से कुछ न हो। फिक्स्चर में वही 60 आइटम चार स्क्रॉल राउंड में पूरे हुए, झूठी रुकावट शून्य, और अंतिम स्टेटस लाइन "End of feed (60 of 60)" पढ़ी।
let stableChecks = 0;
while (stableChecks < 3) {
  const items = await browserPage.locator("article.post").count();
  await browserPage.evaluate(() => window.scrollTo(0, document.body.scrollHeight));

  const grew = await browserPage
    .waitForFunction(
      (n) =>
        document.querySelectorAll("article.post").length > n ||
        /end of feed/i.test(document.body.innerText),
      items,
      { timeout: 3000 },
    )
    .then(() => true)
    .catch(() => false);

  stableChecks = grew ? 0 : stableChecks + 1;
  if (!grew) await browserPage.waitForTimeout(700);
}
दो विवरण स्थिर लूप और अस्थिर लूप में फर्क लाते हैं। ऊँचाई की स्थिरता निकाले गए आइटम की गिनती से आँकें, दस्तावेज़ की ऊँचाई से नहीं, क्योंकि लेज़ी इमेज और विज्ञापन बिना रिकॉर्ड जोड़े ऊँचाई बदल देते हैं। और स्क्रॉल को साइट का लोडर सच में फिर चलाना चाहिए: Intersection Observer API पर बनी इम्प्लीमेंटेशन इंटरसेक्शन बदलने पर चलती हैं, इसलिए स्क्रॉल स्थिति बदलना पेज को नीचे अटकाए रखने से ज़्यादा भरोसेमंद है।
क्रॉल स्टेट सहेजें और क्रैश के बाद फिर शुरू करें
तीनों मोड की एक साझा ज़रूरत है: रन को अपनी रुकावट से बच निकलना चाहिए। हर पूरे बैच के बाद checkpoint लिखें, मोड, स्थिति और अब तक के रिकॉर्ड के साथ, और resume को खास रास्ता नहीं डिफ़ॉल्ट रास्ता बनाएँ। फिक्स्चर पर नंबर क्रॉल पेज 2 के बाद मारा गया, checkpoint में 54 पंक्तियाँ थीं। नई प्रक्रिया ने checkpoint पढ़ा, पेज 3 से जारी रखा, और बिना रुकावट वाले रन जैसी ही 135 पंक्तियाँ तथा 133 यूनिक id पर खत्म हुआ।
import { readFileSync, writeFileSync } from "node:fs";

const CHECKPOINT = "./crawl-state.json";
const save = (state) => writeFileSync(CHECKPOINT, JSON.stringify(state));
const load = () => {
  try {
    return JSON.parse(readFileSync(CHECKPOINT, "utf8"));
  } catch {
    return { mode: "numbered", lastPage: 0, rows: [] };
  }
};

const state = load();
for (let page = state.lastPage + 1; page <= 5; page += 1) {
  state.rows.push(...(await crawlPage(page)));
  state.lastPage = page;
  save(state); // checkpoint after every page
}
Checkpoint डिबगिंग भी बदल देता है। क्रॉल गलत काउंट दे तो पूरा काम फिर चलाने के बजाय स्टेट फ़ाइल देख सकते हैं, और वहाँ लिखी स्थिति बताती है कि कौन सा बैच फिर fetch करना है।
डुप्लिकेट, छूटी पंक्तियाँ और झूठे आखिरी पेज
तीन लक्षण ज़्यादातर पेजिनेशन बग ढक लेते हैं, और हर एक की पहचान डेटा में होती है, कोड में नहीं। डुप्लिकेट तब आते हैं जब बैच पड़ोसी से ओवरलैप करता है, जो तब होता है जब नीचे की सूची रिक्वेस्ट के बीच फिर से सॉर्ट हो और स्थिर पहचान दोहराए। फिक्स्चर ने यही दोहराया: वही id पेज 2 पर एक बार, पेज 3 पर फिर, और पेज 5 के अंदर फिर दिखाई। id आधारित डेडुप से दोनों डुप्लिकेट हट गए।
छूटी पंक्तियाँ आमतौर पर बहुत छोटा इंतज़ार या छूटा पेज बताती हैं। कुल ठीक एक बैच कम हो तो कमी से पहले की इंटरैक्शन देखें; एक पेज कम हो तो लूप का इंक्रीमेंट देखें। फिक्स्चर का अस्थायी 503 इस बग का दूसरा रूप है: रीट्राई के बिना पेज 3 कुछ नहीं देता और रन बिना किसी एरर के 106 पंक्तियाँ बता देता।
झूठा आखिरी पेज सबसे खतरनाक है, क्योंकि क्रॉल कम डेटा के साथ सफलता बताता है। ऐसा तब होता है जब सत्र या रेंडर समस्या से पेज शून्य पंक्तियाँ लौटाता है, सूची खत्म होने से नहीं, और लूप दोनों को एक जैसा मानता है। उन्हें फिर से जाँचकर अलग करें: थोड़ी देर बाद अगला पेज फिर माँगें, और अंत स्वीकारने से पहले असली अंत चिह्न या दो लगातार खाली प्रतिक्रियाएँ माँगें।
काउंट और फ़ील्ड की पूर्णता जाँचें
सत्यापन दो जाँचें हैं जो सेकंड लेती हैं और ज़्यादातर चुप नाकामियाँ पकड़ती हैं। काउंट जाँच इकट्ठा किए गए को हर स्वतंत्र संख्या से मिलाती है: आखिरी नंबर पेज का अपना "page 5 of 5" कथन, हेडर में कुल, या रास्ते में देखे गए प्रति-पेज काउंट का योग। फ़ील्ड जाँच पक्का करती है कि हर रिकॉर्ड में काम ने जो फ़ील्ड वादा किए वे हैं, और अपवादों को अनदेखा करने के बजाय गिनती है।
const unique = new Map(rows.map((row) => [row.id, row]));
const missing = rows.filter((row) => !row.title || !Number.isFinite(row.price));

console.log({
  raw: rows.length,
  unique: unique.size,
  removedDuplicates: rows.length - unique.size,
  missingFields: missing.length,
});
फिक्स्चर की 135 नंबर पंक्तियों पर जाँच ने शून्य गायब फ़ील्ड, 2 हटाए डुप्लिकेट और 133 यूनिक रिकॉर्ड बताए, डेटासेट से बिलकुल मेल। लोड मोर सूची पर उसने 81 में से 1 डुप्लिकेट बताया। कोई भी संख्या अकेले दिलचस्प नहीं; बात यह है कि दोनों में से किसी का बदलाव तुरंत दिखे, न कि बाद के रिपोर्ट में रहस्यमय कमी बनकर आए।
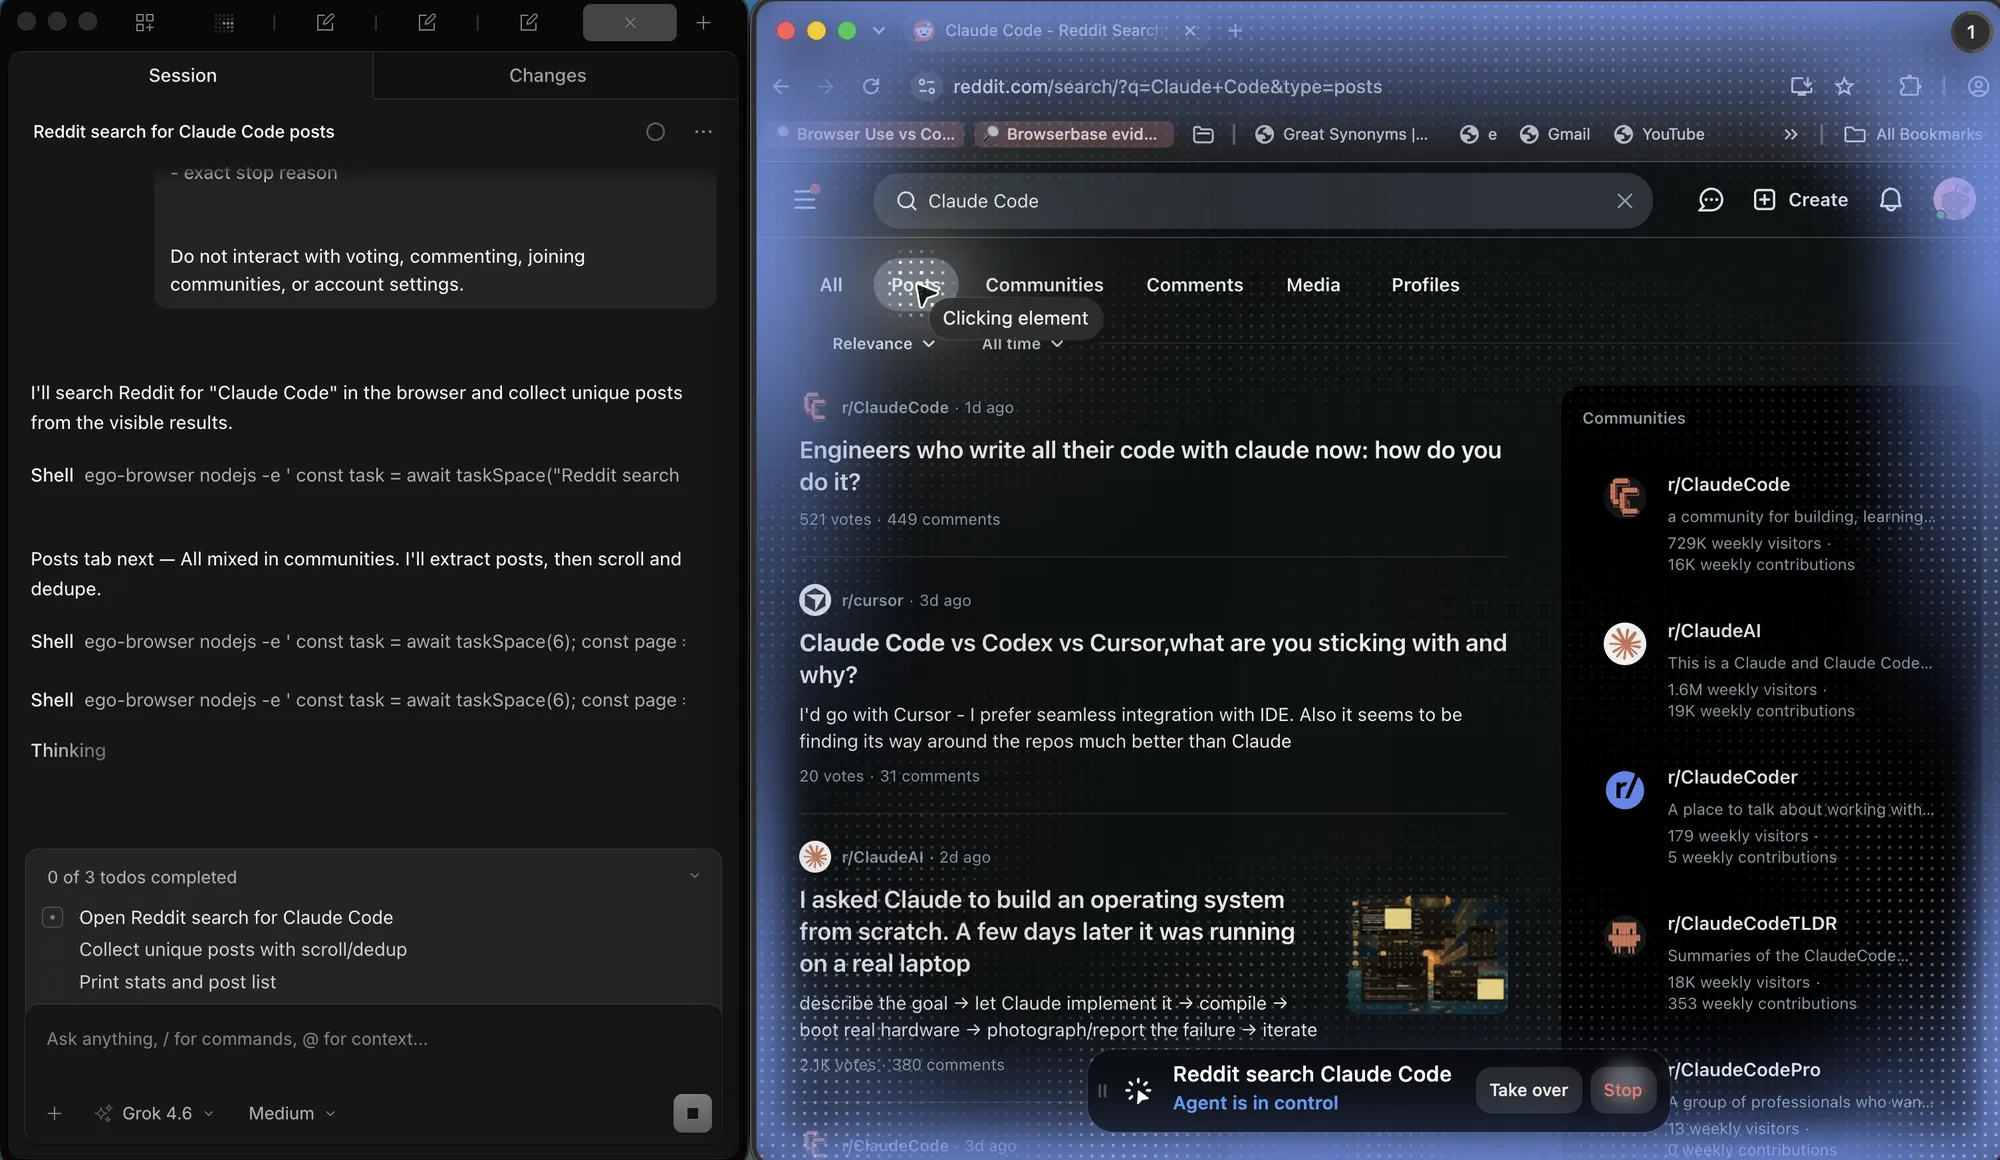
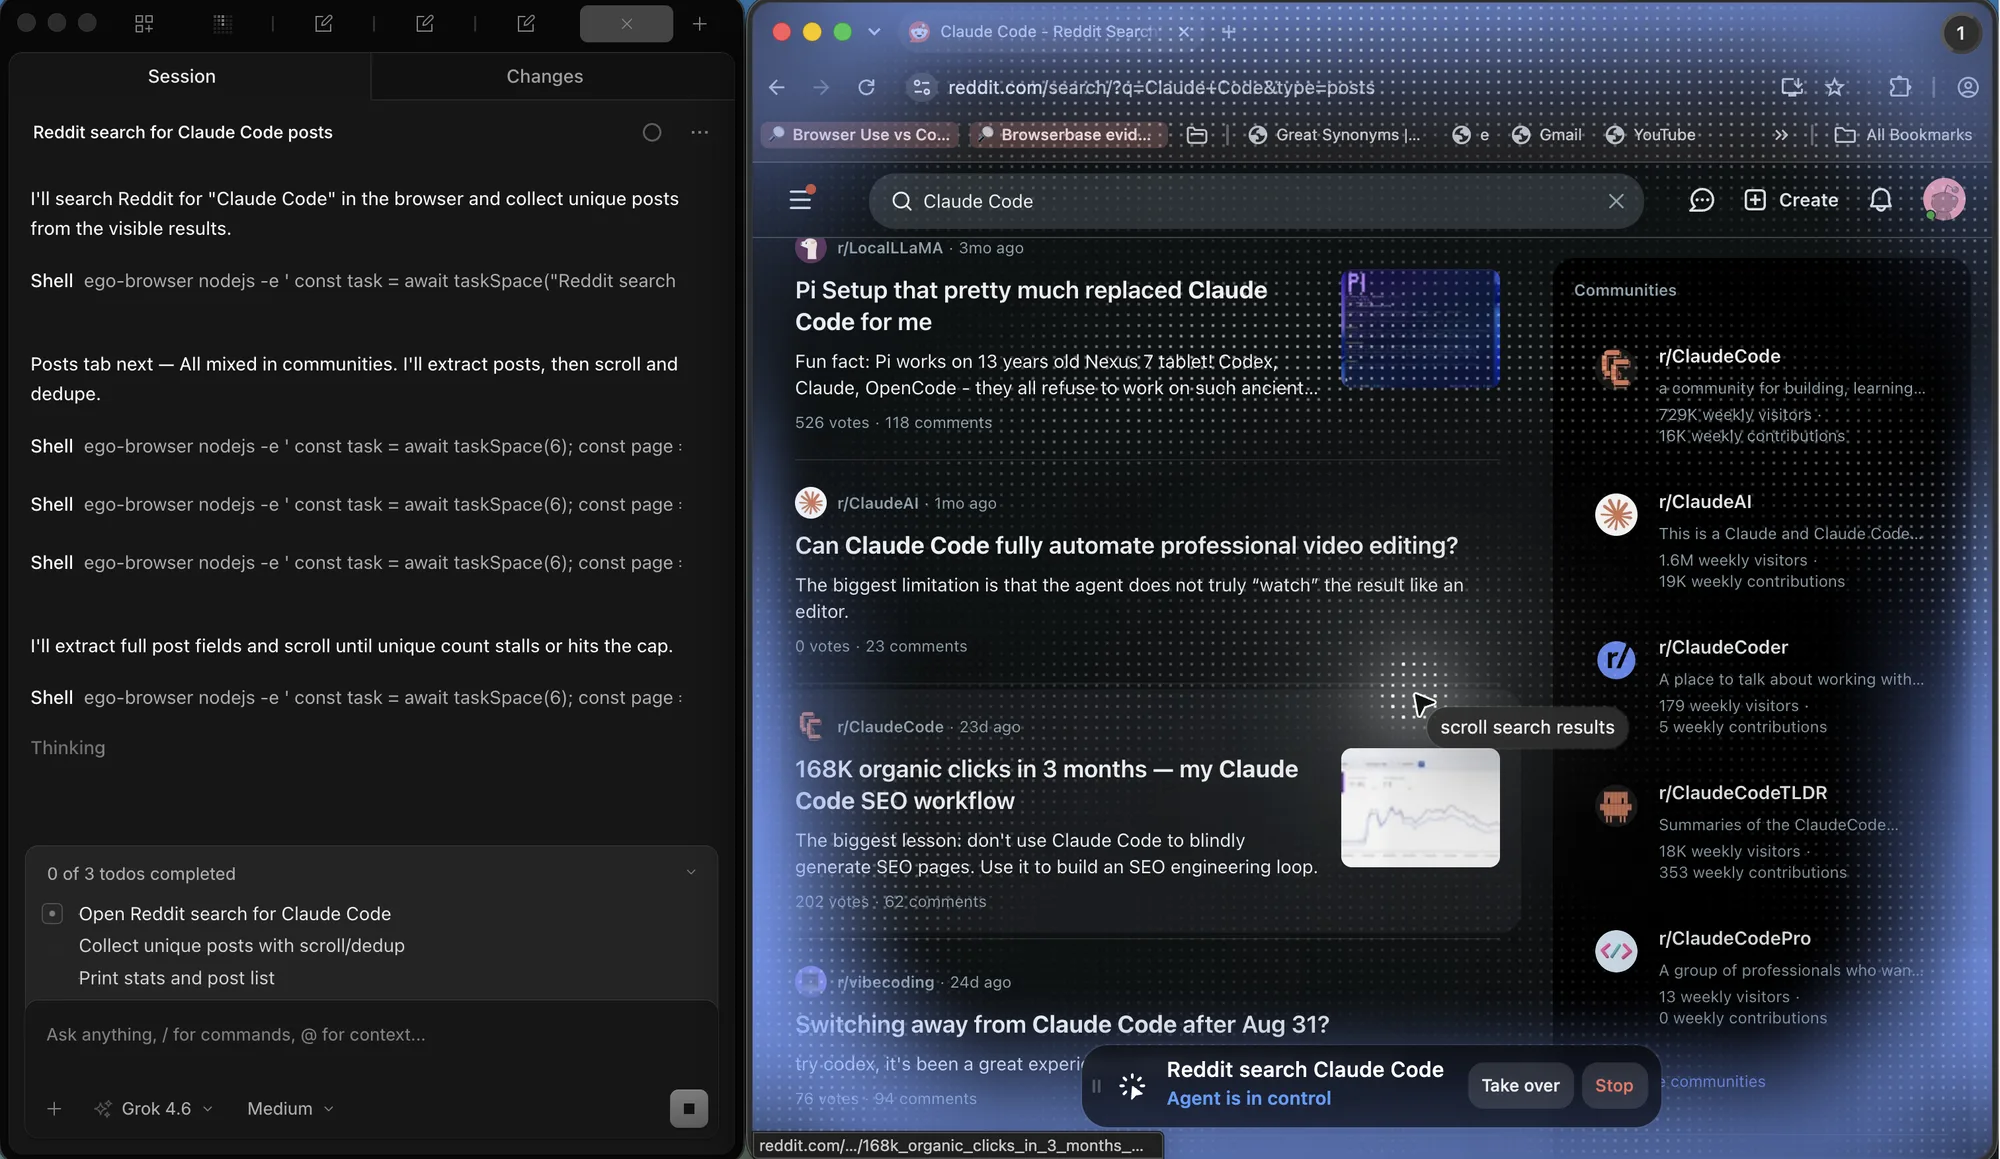
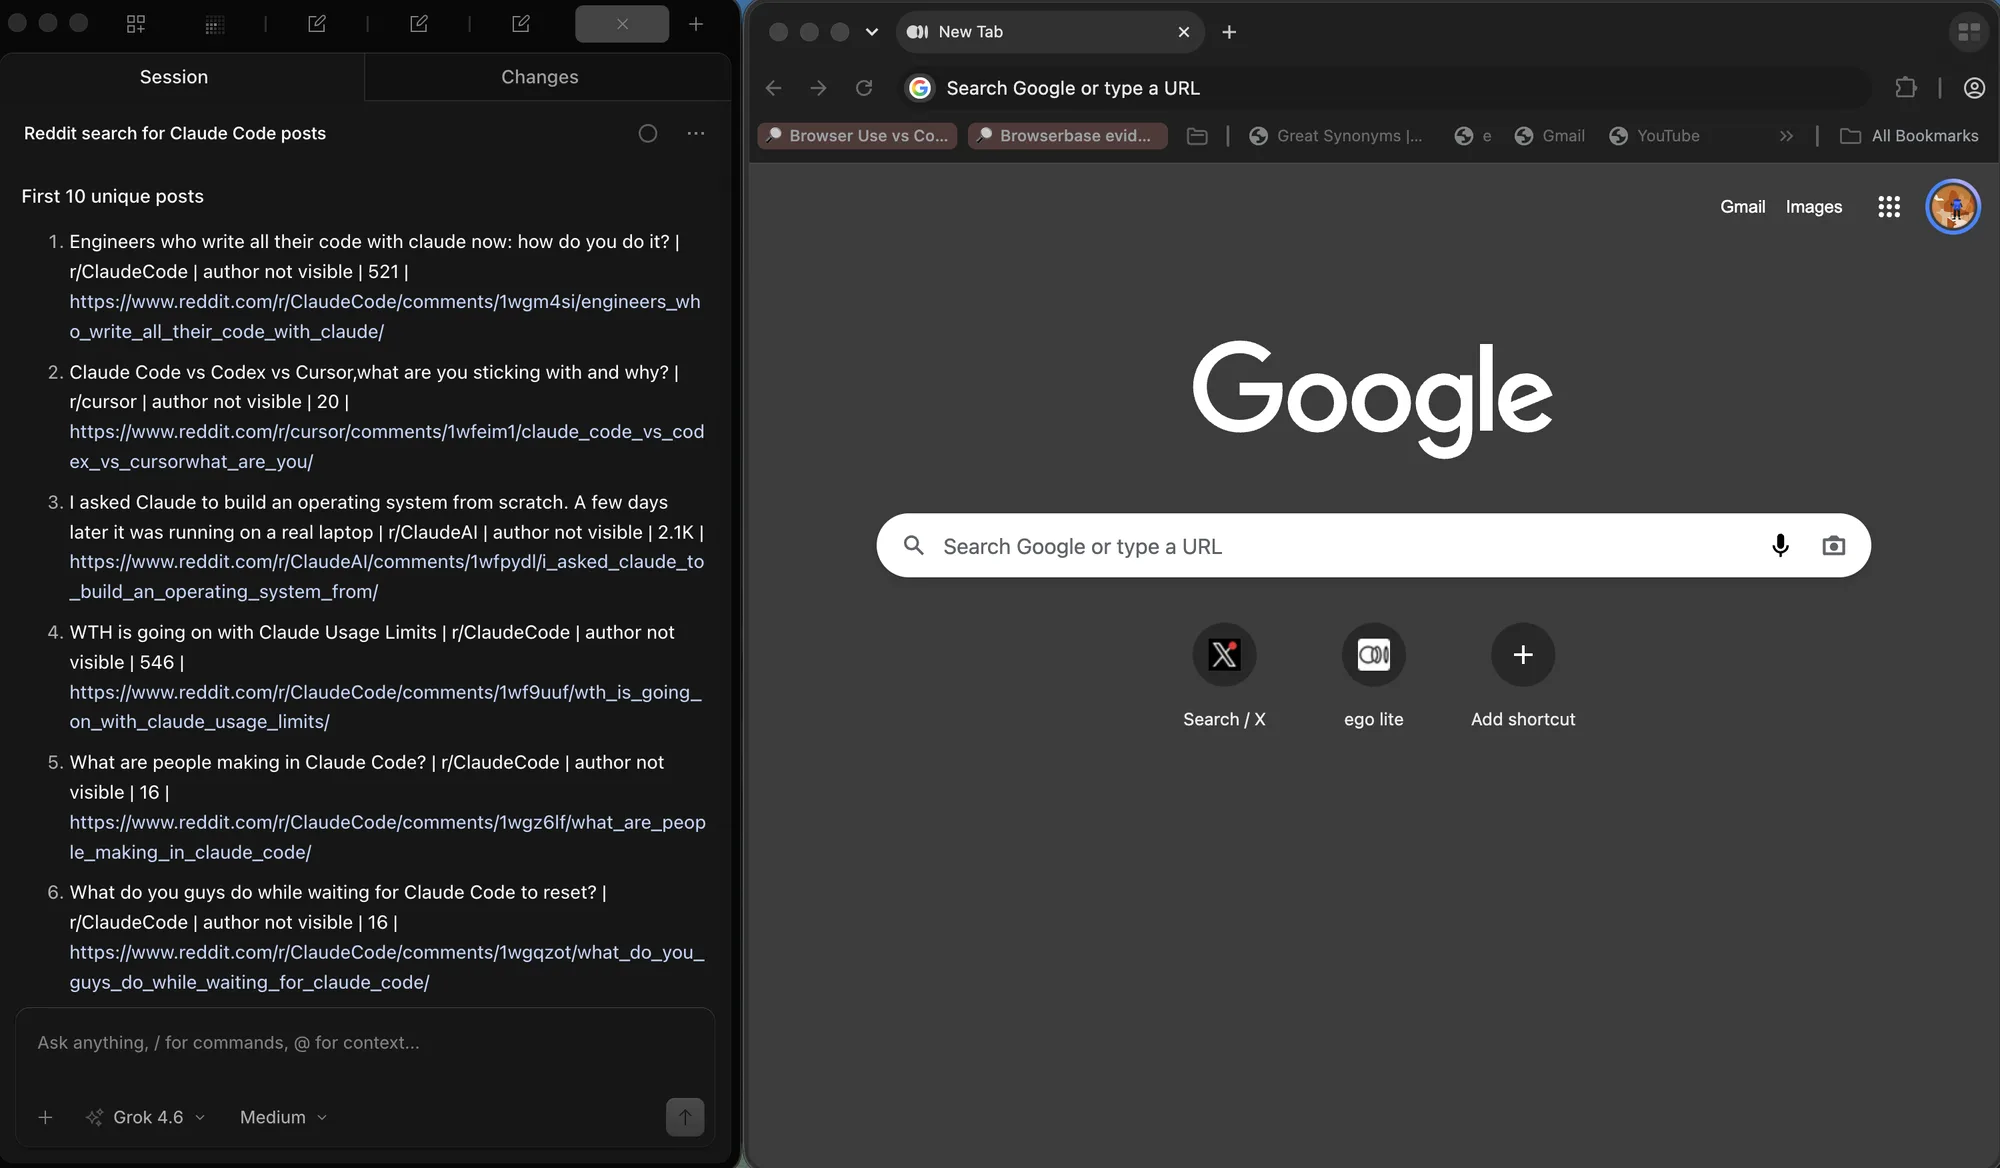
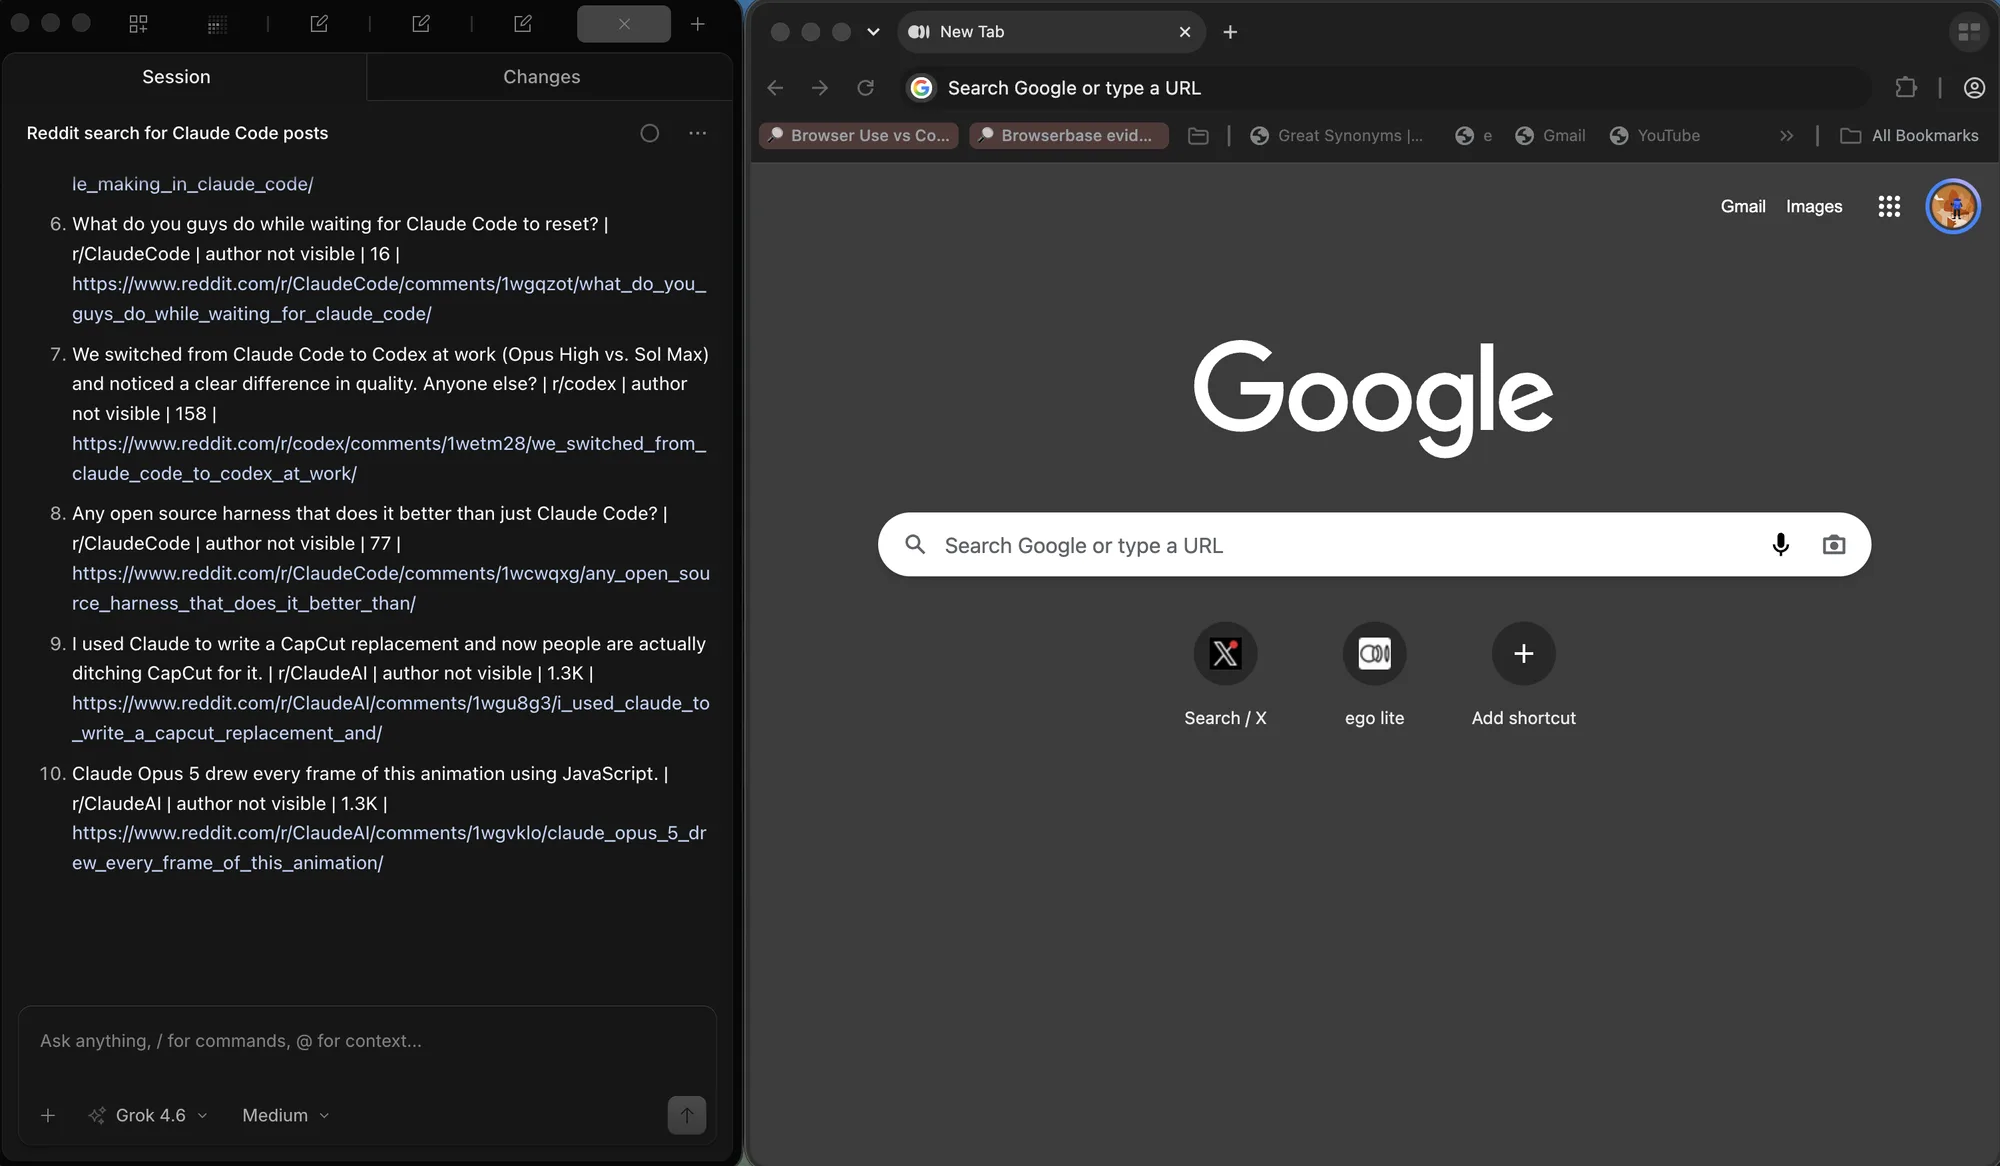
Reddit रन ने 135-पंक्ति fixture पर नहीं, लाइव यूनिक सूची पर वही जाँच की। हर पंक्ति में शीर्षक, subreddit, वोट संख्या और URL चाहिए था। स्क्रॉल के बाद आप नंबर वाला आउटपुट ही सत्यापित करते हैं।
सादा HTTP कब काफी है, और कब नहीं
वही फिक्स्चर डेटा ब्राउज़र के बिना भी मिलता है, और दोनों रास्ते मापना यह तय करने का ईमानदार तरीका है कि काम को क्या चाहिए। एक सादे HTTP क्लाइंट ने नंबर पेज URL से चलाए, लोड मोर बैच उनके JSON एंडपॉइंट से लिए, और इनफिनिट फ़ीड offset से खींची, कुल 135, 81 और 60 पंक्तियाँ 24 milliseconds में इकट्ठा कीं। न रेंडरिंग, न इंतज़ार, न स्क्रॉल।
यही डिफ़ॉल्ट सलाह है, और साफ़ कहनी चाहिए: आधिकारिक API हो तो उसे इस्तेमाल करें। नंबर सूची सर्वर-रेंडर हो तो पेज सीधे माँगें। लोड मोर या इनफिनिट मोड के पीछे बिना सिग्नेचर वाला JSON एंडपॉइंट हो तो वही एंडपॉइंट माँगें और offset पर पेजिनेट करें। Playwright जैसा फ्रेमवर्क इनमें से किसी के लिए ज़रूरी नहीं, और HTTP रास्ता चलाने में तेज़ तथा सस्ता है। Apify पेजिनेशन वॉकथ्रू, Web Scraper पेजिनेशन सेलेक्टर दस्तावेज़, और Playwright नेटवर्क गाइड अलग शुरुआतों से वही ज़मीन कवर करते हैं।
ब्राउज़र तभी जायज़ है जब डेटा क्लाइंट-साइड रेंडरिंग के बाद ही बने, रिक्वेस्ट में पेज पर बना सिग्नेचर या टोकन हो, सूची को लॉगिन चाहिए हो, या असली सत्र और असली user agent के बिना एंडपॉइंट अलग जवाब दे। तब ब्राउज़र स्क्रैपिंग की पसंद नहीं, एकमात्र ईमानदार रास्ता है, और पहले के खंड ज्यों के त्यों लागू होते हैं।
ego (lite) उसी HTTP रास्ते के फेल होने के बाद आता है। सूची को साइन-इन कुकी, पेज पर बना टोकन, या ऐसा स्क्रॉल चाहिए जो असली व्यूपोर्ट के बिना कभी न हो, तो वही numbered / load-more / infinite लूप उस ब्राउज़र में चलाएँ जो सत्र पहले से रखता है। वहीं से शुरू न करें। फिक्स्चर ने सस्ता जवाब पहले दिखा दिया: सादे HTTP पर 135, 81 और 60 पंक्तियाँ 24 ms में।
जब ब्राउज़र सच में चाहिए, पहले खंडों वाला क्रॉल लॉजिक रखें। ego (lite) लॉगिन किया पेज और देखने योग्य Space देता है; नया पेजिनेशन एल्गोरिदम नहीं गढ़ता। किसी चरण को व्यक्ति चाहिए तो रुक जाएँ। curl या आधिकारिक API पहले से पंक्तियाँ लौटाए तो HTTP पर रहें।
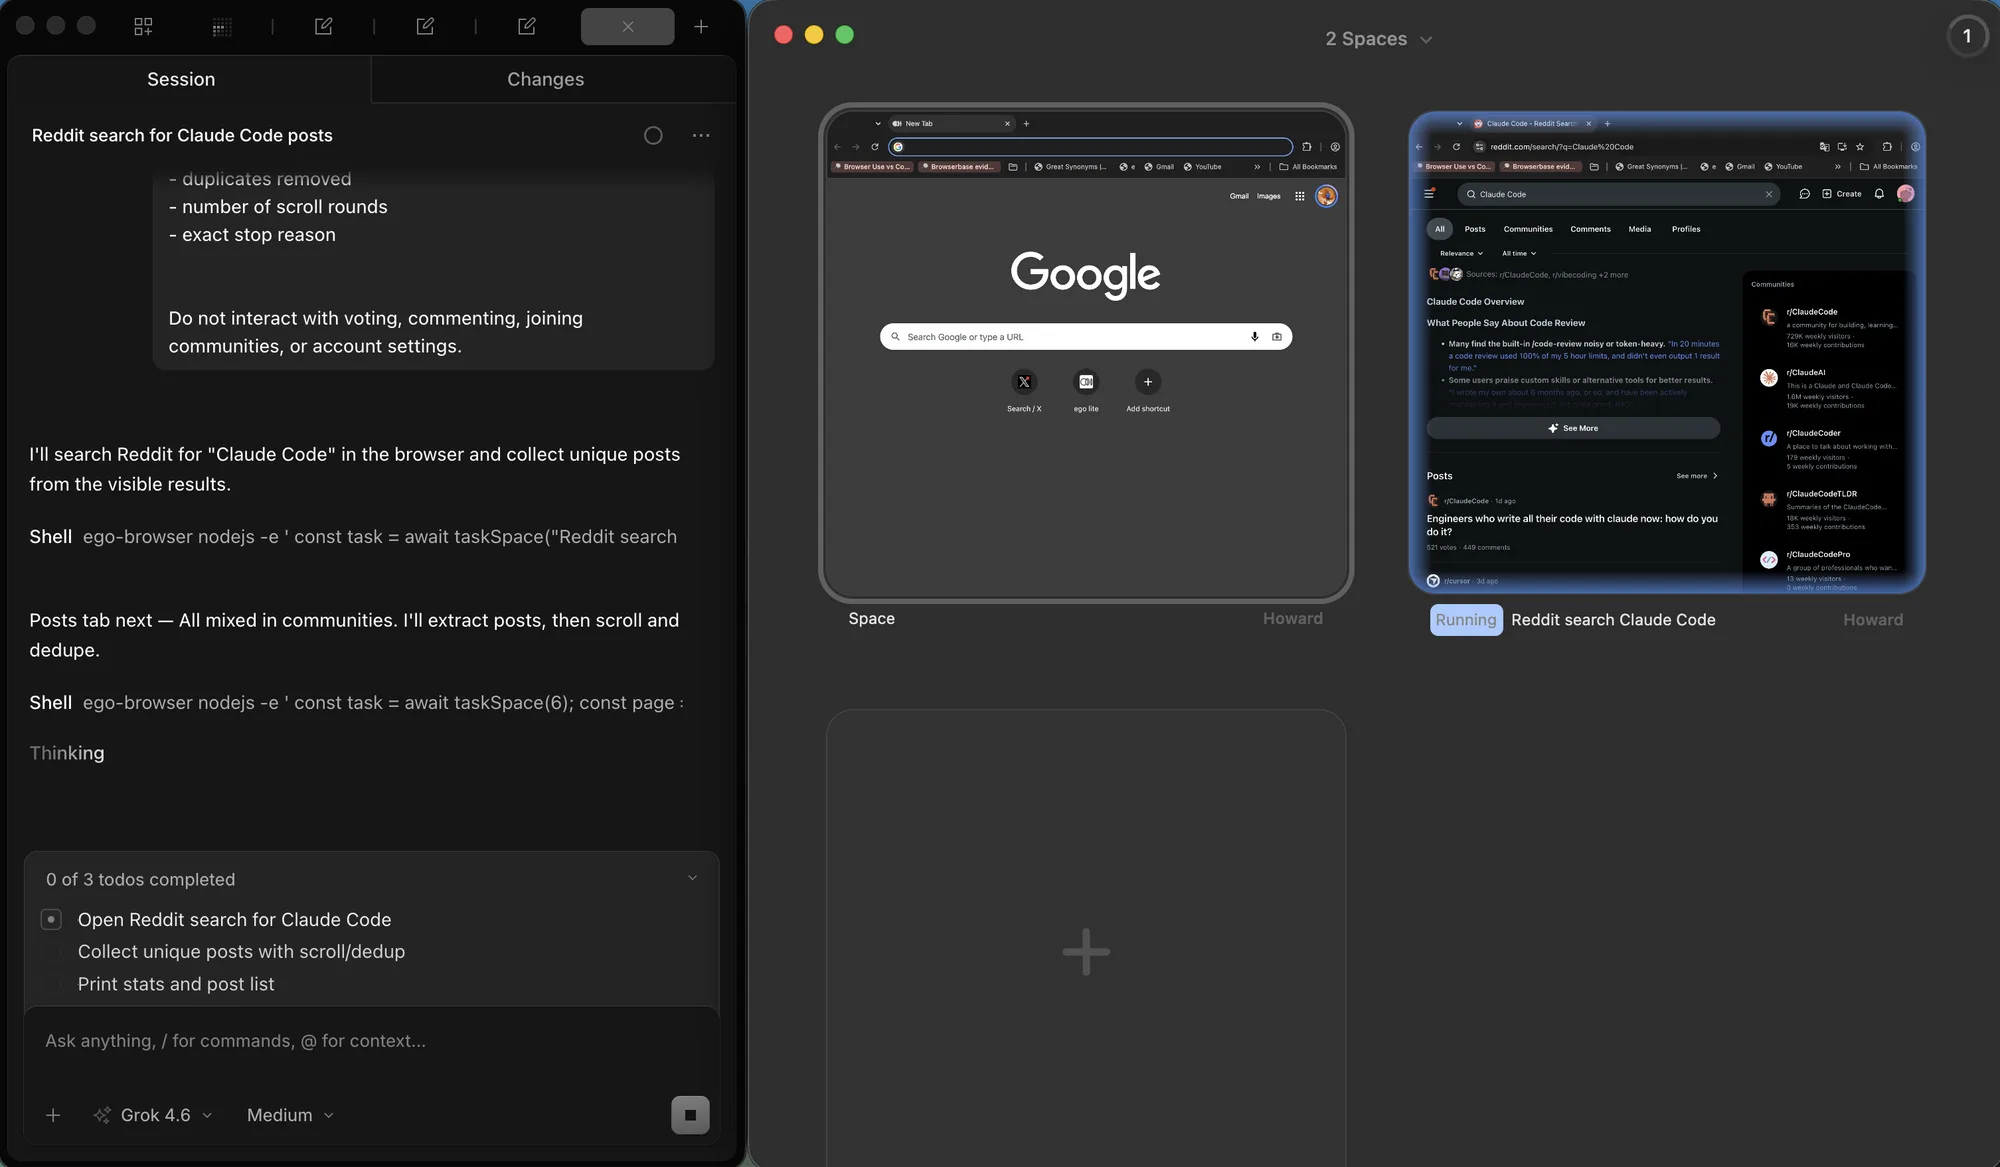
नंबर पेज वाला isolation नियम अभी भी लागू है। एक विंडो साझा करने वाले दो क्रॉलर स्क्रॉल स्थिति के लिए लड़ते हैं और एक-दूसरे की आखिरी पंक्ति ओवरराइट करते हैं। उसी ब्राउज़र में दो Space दो Playwright context के बराबर हैं: एक Google पर idle रह सकता है, दूसरा Reddit स्क्रॉल करता रहे। मुद्दा isolation है। ओवरव्यू सिर्फ़ दोनों को एक साथ दिखाने का तरीका है।
संस्करण 0.5.0.32 changelog में दर्ज है (2026-09-12)। नया बिल्ड उद्धृत करने से पहले उस पेज, क्विक स्टार्ट, और GitHub रेपो फिर जाँचें। पड़ोसी गाइड JavaScript से वेब स्क्रैपिंग स्टैटिक बनाम रेंडर फ़ैसले को दूसरी तरफ़ से कवर करती है।
FAQ
नंबर सूची में कितने पेज हैं, यह कैसे पता चले?
नंबर सूची के पेज आखिरी-पेज कंट्रोल पढ़कर, हेडर कुल को पेज साइज़ से बाँटकर, फिर एक बार अंत तक चलकर पता चलते हैं। उस अनुमान को जाँच मानें, लूप की रुकने की शर्त नहीं।
मेरा स्क्रैपर पेजों के बीच डुप्लिकेट क्यों इकट्ठा करता है?
स्क्रैपर पेजों के बीच डुप्लिकेट तब इकट्ठा करते हैं जब नीचे की सूची फिर सॉर्ट हो और एक रिकॉर्ड एक बैच से अगले में चला जाए। स्थिर record id पर डेडुप करें, दिखने वाले टाइटल पर नहीं, और हटाए गए डुप्लिकेट की संख्या लॉग करें।
लोड मोर क्लिक के बाद कितनी देर इंतज़ार करूँ?
जब तक कोई देखने योग्य शर्त सच न हो: पंक्ति काउंट बढ़ा, बटन की disabled स्थिति साफ़ हुई, या अगले बैच की जानी-पहचानी पंक्ति आई। तय देरी एक अंदाज़ा है जो तब तक चलता है जब तक नेटवर्क धीमा न हो, और फेल भी तभी होता है।
इनफिनिट फ़ीड का अंत कैसे पहचानूँ?
साइट स्पष्ट संकेत दे तो उसे प्राथमिकता दें, जैसे रेंडर हुआ अंत संदेश या प्रतिक्रिया में has-more फ़्लैग। दोनों न हों तो रुकने से पहले कई लगातार जाँच माँगें जिनमें नए आइटम न हों और लोडेड सामग्री की ऊँचाई न बदले, एक शांत क्षण काफी नहीं।
पेजिनेशन स्क्रैपिंग के लिए हेडलेस ब्राउज़र इस्तेमाल करूँ?
तभी जब डेटा को रेंडरिंग, सत्र या पेज पर टोकन चाहिए हों। सर्वर-रेंडर सूचियाँ और JSON एंडपॉइंट सादे HTTP से बेहतर चलते हैं, जो तेज़ और सरल है। दोनों रास्ते एक बार मापें; तुलना आमतौर पर फ़ैसला साफ़ कर देती है।
पेजिनेटेड क्रॉल जल्दी क्यों रुक जाता है?
तीन आम संदिग्ध: ऐसा इंतज़ार जो बैच रेंडर होने से पहले खत्म हो गया, खाली पेज समझा गया अस्थायी एरर, और बीच रन में खत्म सत्र जिससे अगला पेज पंक्तियों की जगह लॉगिन फ़ॉर्म दिखाए। हर एक का सुधार अलग है, इसलिए रुकने की वजह काउंट के साथ लॉग होनी चाहिए।
क्रैश के बाद क्रॉल कैसे फिर शुरू करूँ?
हर पूरे बैच के बाद मोड, स्थिति और अब तक की पंक्तियों के साथ checkpoint बनाएँ। Resume उस फ़ाइल को पढ़ता है और दर्ज स्थिति पर मोड में फिर प्रवेश करता है। सहेजे स्टेट के नीचे स्रोत न खिसका हो, यह पक्का करने के लिए checkpoint स्थिति से ठीक पहले का एक बैच एक बार फिर fetch करें।
क्रॉल पूरा है, यह कैसे सत्यापित करूँ?
यूनिक रिकॉर्ड काउंट को कम से कम दो स्वतंत्र संख्याओं से मिलाएँ, जैसे आखिरी पेज का अपना कुल और प्रति-पेज काउंट का योग, फिर हर पंक्ति पर फ़ील्ड पूर्णता जाँचें और अपवाद बताएँ। मेल खाता काउंट और सभी मौजूद फ़ील्ड मज़बूत संकेत हैं; अकेले कोई भी कमज़ोर है।
लेज़ी लोडिंग चलाने के लिए धीरे स्क्रॉल करना ज़रूरी है?
आमतौर पर नहीं, लेकिन नीचे पार्क करने के बजाय लोडर को फिर चलाएँ। साइटें intersection observer इस्तेमाल करती हैं जो बदलाव पर चलते हैं, इसलिए स्थिति बदलना या कदमों में स्क्रॉल एक बड़े छलांग से ज़्यादा भरोसेमंद है, और ग्रोथ जाँच सार्थक बनती है।
लॉगिन के पीछे पेजिनेटेड सूची स्क्रैप कर सकता हूँ?
हाँ, असली सत्र और उन्हीं नियमों के साथ: विनम्रता से पेजिनेट करें, सत्र जीवित रखें, और लॉगिन पेज पर रीडायरेक्ट को सूची का अंत नहीं सत्र की समस्या मानें। जो ब्राउज़र आपका लॉगिन पहले से रखता है, जैसे ego (lite), सत्र फिर बनाने का चरण पूरी तरह हटा देता है। पर्सिस्टेंट सत्र गाइड स्टेट हैंडलिंग बताती है, और कीमत स्क्रैपिंग यूज़ केस पूरा लॉगिन संग्रह कैसा दिखता है यह दिखाता है।
