
Una pagina renderizzata con JavaScript può rispondere con successo e lasciarti comunque lo scraper a zero righe. L'HTML è già caricato, ma le card che una persona vede nel browser potrebbero non esistere ancora nel DOM. Con ego (lite) quel divario si vede. Il task gira dentro uno Space Chromium osservabile, così distingui se la pagina sta ancora renderizzando, se il selettore non coincide o se i dati che ti servono non sono mai comparsi.
Playwright trasforma quel comportamento già verificato in un flusso di scraping stabile e ripetibile. Può attendere che le card target vengano renderizzate, estrarre i campi dal DOM live e controllare che il risultato contenga i dati che ti aspettavi. Quando selettore e condizione di attesa sono noti, Playwright è il modo naturale di metterli in uno script affidabile. Se il task chiede ancora ispezione visiva, una sessione già autenticata o che una persona prenda il controllo in un passo preciso, ego (lite) tiene lo stato del browser visibile e interattivo, così uno script che esce con successo non può nascondere di non aver estratto nulla.
Che cos'è il web scraping con Playwright?
Fare web scraping con Playwright significa guidare un browser reale così che JavaScript possa dipingere la pagina, poi leggere i nodi renderizzati. Il browser è lo scraper. La risposta HTML è solo il guscio finché gli script non girano.
Playwright avvia Chromium, Firefox o WebKit, apre un contesto e ti dà page.goto, attese, locator e page.evaluate. Quelle API esistono per i test. Funzionano anche per l'estrazione, perché entrambi i lavori chiedono la stessa cosa: un DOM uguale a quello che vede una persona.
I lavori adiacenti restano fuori da questa pagina.
La scelta tra fetch e un browser in JavaScript è in web scraping con JavaScript. Come riutilizzare una sessione autenticata tra un'esecuzione e l'altra è in sessioni browser persistenti. I muri di login su X e LinkedIn sono in scraping con IA dietro i muri di login. Pagine numerate, Load More e infinite scroll aspettano che questa pagina singola restituisca già le righe giuste.
Quando fare scraping con Playwright invece che con HTTP?
Usa Playwright quando una GET dell'URL non contiene i nodi che vuoi estrarre. Usa HTTP quando i valori sono già nel corpo della risposta, o quando la pagina espone già un endpoint JSON documentato.
quotes.toscrape.com/js è costruito così di proposito. Una GET dell'URL restituisce HTML senza nodi class="quote". Le citazioni stanno in un array inline var data, poi jQuery dipinge le card. Un parser CSS puntato su .quote contro la risposta grezza non salva nulla e sembra un bug del selettore.
Abbiamo verificato quella scissione il 2026-09-18 da OpenCode. Una GET di quotes.toscrape.com/js ha restituito HTTP 200 e 0 card .quote nell'HTML grezzo, mentre la finestra Chromium headed a destra mostrava già l'elenco dipinto.
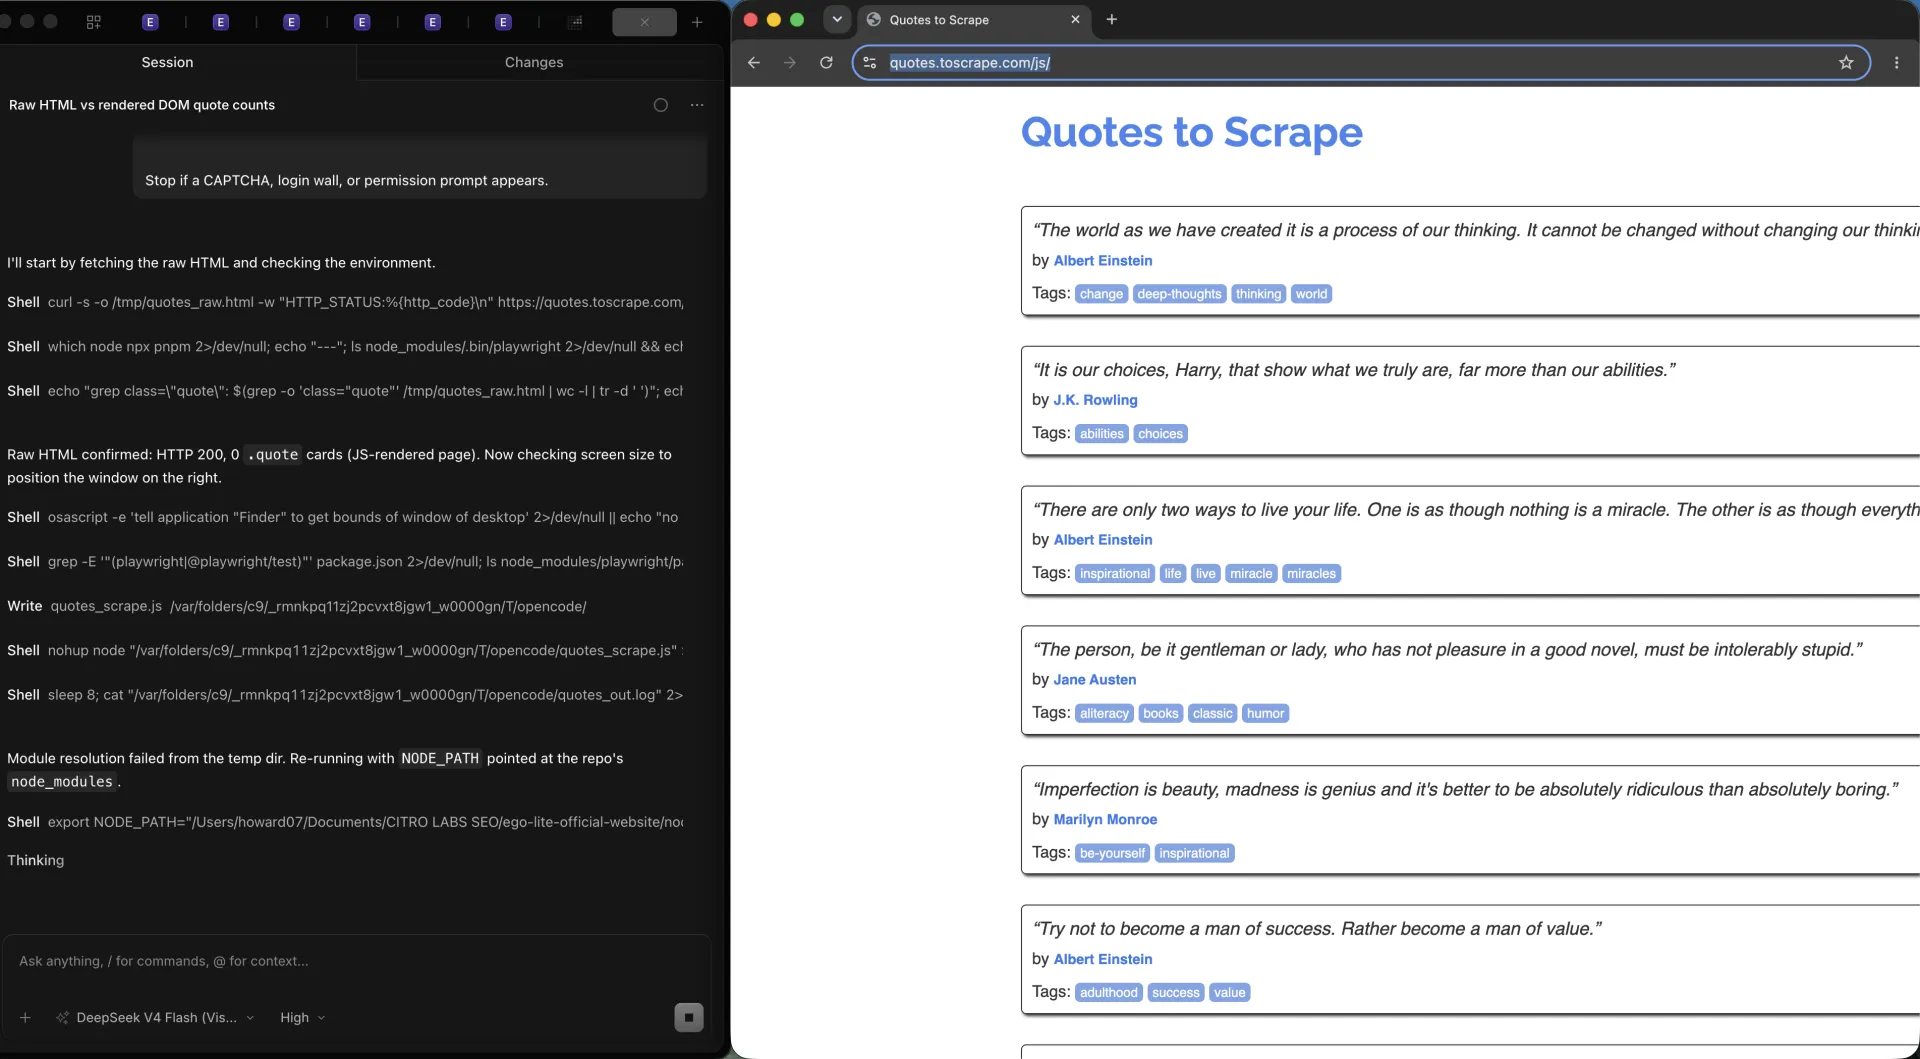
Guarda la scissione in questo modo.
| Percorso | Cosa può fare | Cosa non può fare |
|---|---|---|
| HTTP GET + parser HTML | Leggere i byte inviati dal server. Economico, veloce e sufficiente quando le card sono già nel markup. | Eseguire gli script della pagina o attendere nodi che compaiono dopo. Contro quotes.toscrape.com/js non vede card .quote nell'HTML grezzo. |
| Analizzare il payload inline | Su quotes.toscrape.com/js, una regex più JSON.parse di var data recupera le citazioni dallo stesso HTML, senza browser. | Sopravvivere a un restyling che smette di incorporare l'array. I payload interni non sono un contratto API. |
| DOM renderizzato con Playwright | Eseguire il JavaScript della pagina, attendere .quote ed estrarre le card che una persona vede. | Restare economico. Ogni contesto costa memoria, e una flotta di contesti è lo strumento sbagliato per HTML statico. |
L'extra onesto di questa demo: Playwright non serve se analizzi var data direttamente. La maggior parte dei siti JS non lascia un array nominato nella prima risposta. Playwright è il percorso che funziona ancora quando non lo fanno.
Come si avvia, si naviga e si attende il contenuto?
Lo scrape minimo con Playwright è launch, nuovo contesto, goto, attendere il selettore della card, estrarre, poi chiudere. Saltare l'attesa è il modo in cui ottieni un file vuoto che sembra un successo.
In Playwright, page.goto può fermarsi a commit, domcontentloaded, load o networkidle. waitForSelector è il controllo che ciò per cui sei venuto esista davvero. Su quotes.toscrape.com/js, goto({ waitUntil: 'domcontentloaded' }) può già bastare perché lo script inline gira in quell'HTML. È fortuna, non una regola.
import { chromium } from "playwright";

const browser = await chromium.launch();
const context = await browser.newContext();
const page = await context.newPage();

try {
  await page.goto("https://quotes.toscrape.com/js/", {
    waitUntil: "domcontentloaded",
  });
  await page.waitForSelector(".quote");
  const rows = await page.evaluate(() =>
    [...document.querySelectorAll(".quote")].map((el) => ({
      text: el.querySelector(".text")?.textContent?.trim() ?? "",
      author: el.querySelector(".author")?.textContent?.trim() ?? "",
      tags: [...el.querySelectorAll(".tag")].map((tag) =>
        tag.textContent?.trim(),
      ),
    })),
  );
  console.log(rows.length);
} finally {
  await context.close();
  await browser.close();
}
Per vedere lo scrape vuoto, estrai a commit prima che le card esistano, oppure ritarda lo script che le dipinge. Quell'estrazione precoce restituisce 0 righe. Dopo waitForSelector('.quote'), la stessa pagina restituisce le card renderizzate. Nel caso vuoto non viene lanciato nulla.
| Attesa | Cosa dimostra | Come fallisce |
|---|---|---|
| solo commit | La navigazione è partita. Utile come test negativo. | Gli script potrebbero non essere ancora girati. Un'estrazione a commit, prima che il pittore dipinga, restituisce 0 citazioni. |
| domcontentloaded | L'HTML iniziale è analizzato. Su questa fixture basta perché var data gira in quell'HTML. | Le card di un XHR tardivo possono ancora mancare. Non trattarlo come 'il contenuto è pronto'. |
| waitForSelector('.quote') | Esiste almeno una card nel DOM. È l'attesa che trasforma questa demo in righe estraibili. | Una classe obsoleta può coincidere con l'elenco precedente. Attendi un campo che cambia con i dati, non un wrapper che non se ne va mai. |
Chiudi il contesto nel finally. I contesti trattengono la memoria. Uno scrape che lancia a metà estrazione deve comunque lasciare andare Chromium.
Come si estraggono i campi da una pagina renderizzata?
Estrai dentro la pagina con page.evaluate, o con i locator quando ti serve un controllo e non un elenco. Entrambi leggono il DOM renderizzato. Nessuno legge lo snapshot HTML originale di goto.
Mappa ogni .quote su text, author e tags. La demo pubblica dipinge dieci card. I campi obbligatori sono text e author. La chiave unica è il testo della citazione, non l'autore, perché Einstein compare più di una volta.
Abbiamo verificato quell'estrazione nella stessa sessione OpenCode. Dopo waitForSelector('.quote'), l'esecuzione headed ha stampato 10 righe, 10 testi unici e 0 autori mancanti. L'HTML grezzo aveva ancora 0 card.
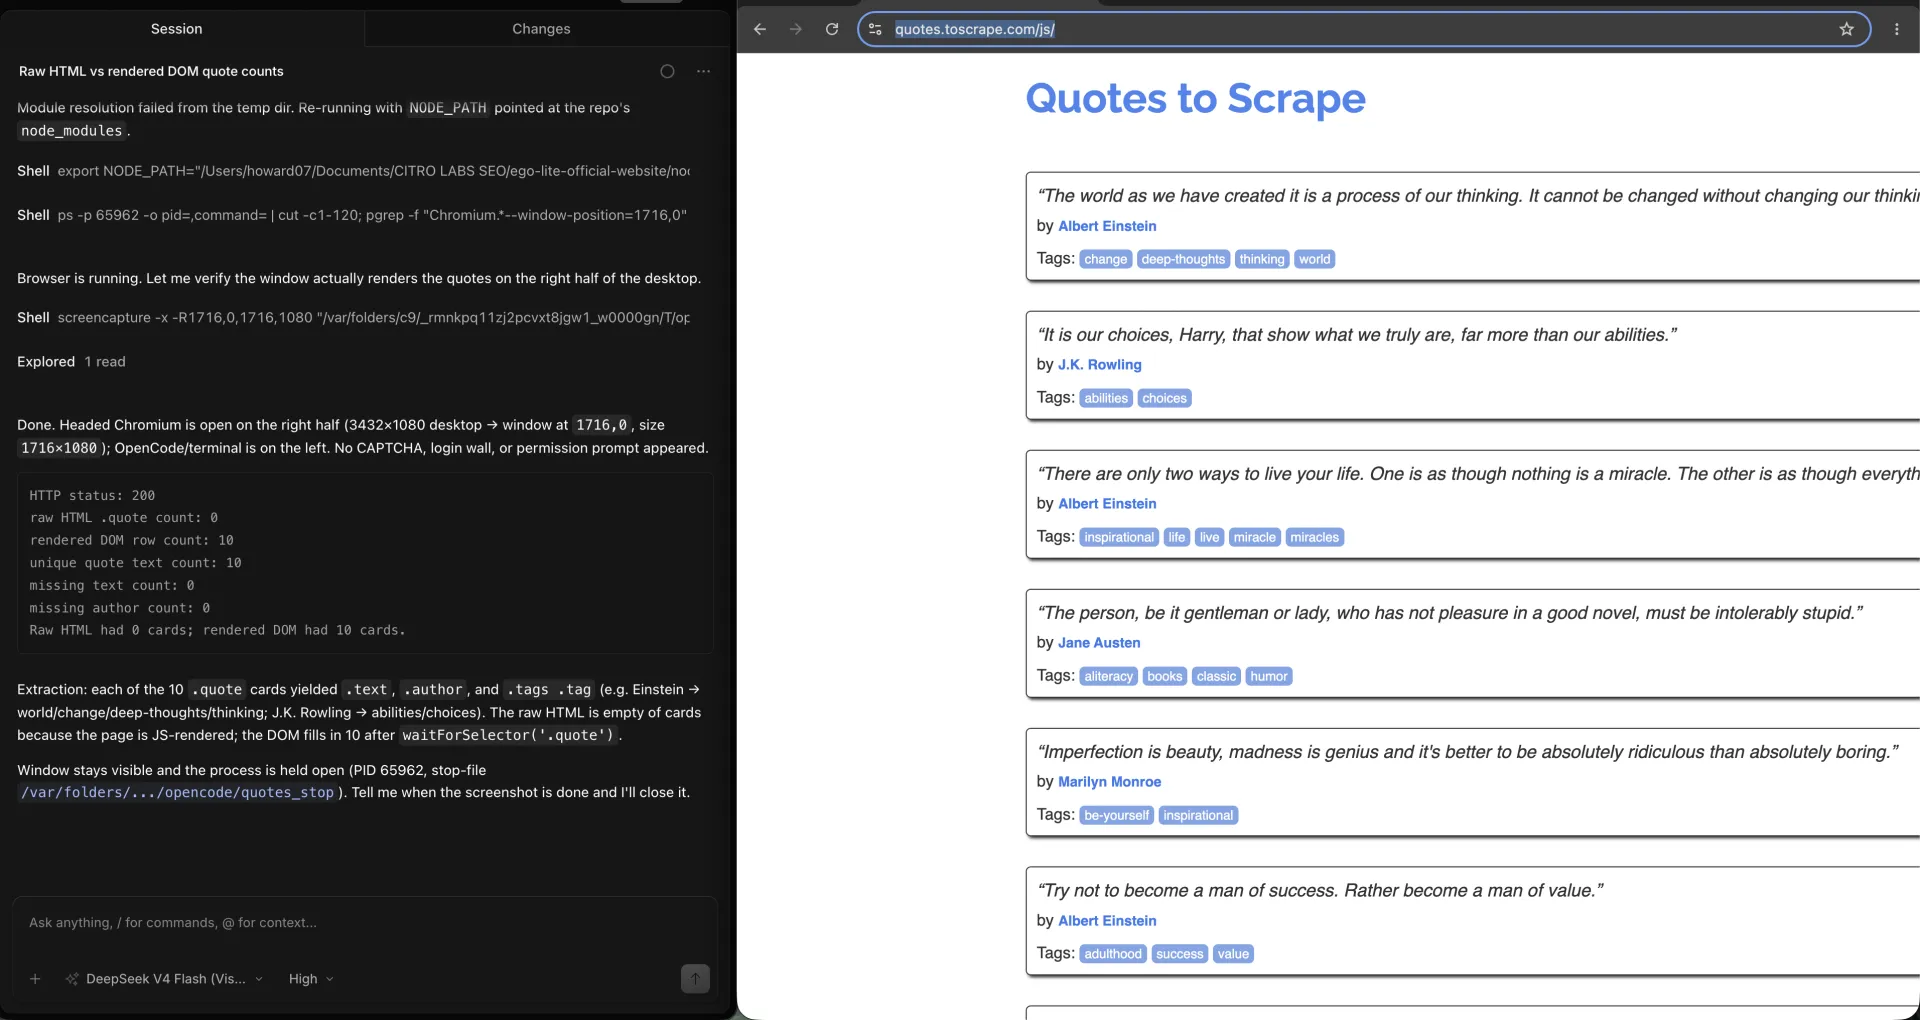
I locator sono la strada più pulita per un singolo campo. I locator di Playwright interrogano di nuovo prima di ogni azione, ed è per questo che sopravvivono a un re-render che rompe un element handle memorizzato.
const title = await page.locator(".quote .text").first().innerText();
const author = await page.locator(".quote .author").first().innerText();
page.evaluate è l'estrazione migliore per gli elenchi. Gira nella pagina e restituisce JSON. Tieni il mapper piccolo. Tira fuori text, author, tags e una chiave unica. Lascia screenshot e PDF fuori dal loop di scrape.
Il testo nascosto con CSS sta comunque nel DOM. innerText segue il layout. textContent no. Se un sito tronca un titolo con CSS, textContent ti dà comunque la stringa intera. Decidi quale stai raccogliendo prima di scrivere il validatore.
Come si intercettano i dati che la pagina già richiede?
L'intercettazione è utile quando la pagina già recupera JSON che si può salvare invece di analizzarlo dalle card. Su quotes.toscrape.com/js quella richiesta non parte mai, ed è questo il punto.
Le citazioni di quella demo non arrivano da un'API. Sono incorporate come var data nell'HTML, poi dipinte in nodi .quote da jQuery. Un listener di response in cerca di JSON non vede nulla di utile.
In Playwright, i docs di rete mostrano page.route e i listener di response. Usali. Poi registra ciò che la pagina ha davvero inviato, compreso il nulla.
const jsonResponses = [];
page.on("response", async (response) => {
  const type = response.headers()["content-type"] || "";
  if (type.includes("json")) {
    jsonResponses.push({
      url: response.url(),
      status: response.status(),
    });
  }
});
await page.goto(url, { waitUntil: "domcontentloaded" });
await page.waitForSelector(".quote");
console.log(jsonResponses.length);
Quando non c'è un corpo JSON, torna alle card renderizzate o analizza lo script inline che hai già scaricato. Non inventare un endpoint perché i tutorial ne mostrano sempre uno. Oxylabs, BrowserStack e ScraperAPI dimostrano tutti intercept. Non ti dicono cosa succede quando il sito non spara mai la richiesta.
Come si validano campi, duplicati e conteggi?
Uno scrape non è finito quando lo script esce con 0. È finito quando il file ha il conteggio atteso, ogni campo obbligatorio è presente e la chiave unica non schiaccia due righe in una.
Un'estrazione che passa su questa demo scrive dieci righe con testi unici e nessun autore mancante. Un'estrazione prima che le card esistano scrive 0 righe con lo stesso logger felice, a meno che non si controlli il conteggio.
function validate(rows, expectedCount) {
  const missing = rows.filter((row) => !row.text || !row.author);
  const unique = new Set(rows.map((row) => row.text));
  if (rows.length !== expectedCount) {
    throw new Error(`expected ${expectedCount}, got ${rows.length}`);
  }
  if (missing.length) {
    throw new Error(`${missing.length} rows missing text or author`);
  }
  if (unique.size !== rows.length) {
    throw new Error("duplicate texts");
  }
}
Usa una checklist breve e fallisci in modo rumoroso.
| Controllo | Passa | Modalità di fallimento da conservare |
|---|---|---|
| Conteggio atteso | Dieci card dopo waitForSelector('.quote') | 0 righe se l'estrazione gira prima del pittore |
| Campi obbligatori | text e author su ogni riga | Un selettore che coincide con la card ma perde .author |
| Chiave unica | Testi di citazione unici, non autori unici | Deduplica sull'autore, che schiaccerebbe Einstein |
Tieni l'estrazione vuota. Il risultato a 0 righe è la prova che l'attesa conta. Cancellarlo fa sembrare un'estrazione piena successiva il valore predefinito.
Che cosa fa fallire uno scrape con Playwright?
I fallimenti che contano qui sono render vuoti, selettori obsoleti e limiti di frequenza. Nessuno di loro sembra uno stack trace rosso se registri solo la lunghezza delle righe dopo un catch che ingoia gli errori.
Render vuoto: la navigazione è riuscita, il selettore non ha mai coinciso, hai salvato []. Sistema l'attesa. Non ritentare la stessa estrazione sullo stesso DOM incompiuto.
Selettore obsoleto: .quote esiste ancora, ma il testo si è spostato. L'esecuzione restituisce 10 righe di ieri. Attendi un campo che cambia con il contenuto, poi confronta le chiavi uniche con il file precedente.
Limite di frequenza: un 429 è uno stop. Leggi Retry-After quando c'è, fai backoff e metti un tetto ai tentativi. Martellare lo stesso URL è il modo in cui un IP finisce bloccato, e questa guida non copre i bypass.
async function gotoWithRetry(page, url, attempt = 0) {
  const response = await page.goto(url, { waitUntil: "domcontentloaded" });
  const status = response?.status() ?? 0;
  if (status === 429 || status >= 500) {
    if (attempt >= 3) throw new Error(`giving up on ${url}: ${status}`);
    const retryAfter = Number(response?.headers()["retry-after"]);
    const waitMs = Number.isFinite(retryAfter)
      ? retryAfter * 1000
      : 2 ** attempt * 1000;
    await page.waitForTimeout(waitMs);
    return gotoWithRetry(page, url, attempt + 1);
  }
  if (status && status >= 400) throw new Error(`${status} for ${url}`);
  return response;
}Quando un agente browser visibile è la strada migliore?
Un agente browser visibile è la strada migliore quando l'attesa è sbagliata, il selettore si è spostato o una persona deve guardare la pagina e prendere il controllo. Non sostituisce un loop Playwright già chiuso di cui ti fidi in CI.
È il complemento, non il concorrente. Playwright mette per iscritto l'attesa già capita. ego (lite) 0.5.0.32 tiene il task in uno Space Chromium osservato così si vedono le card man mano che compaiono, si può fermare l'agente o una persona può prendere il controllo quando l'attesa mente. Riutilizza un profilo reale quando lo scrape successivo serve un login già esistente. Non rende più economica una pagina HTML statica e non aggirare un blocco. Il changelog di quella versione è datato 2026-09-12 sul changelog di ego (lite).
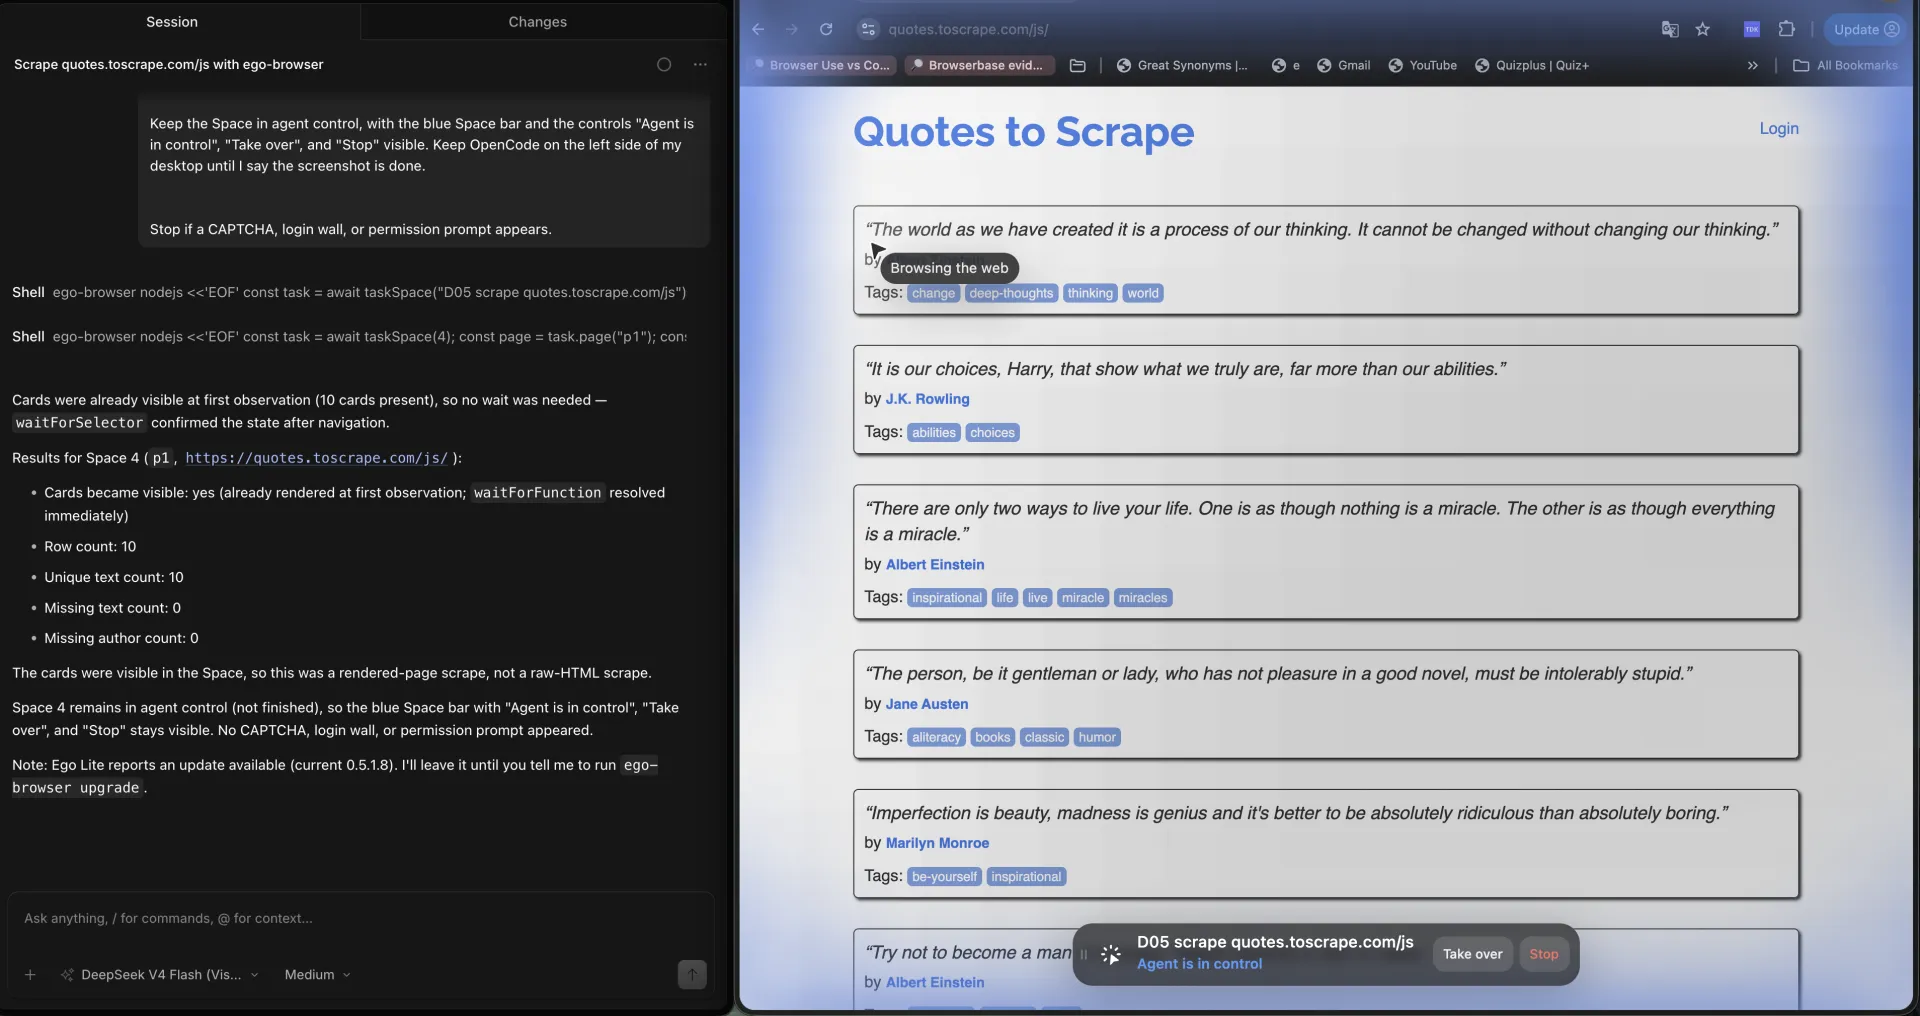
Abbiamo verificato quell'isolamento in ego (lite) da OpenCode. La panoramica Spaces ha tenuto lo scrape delle citazioni nel proprio Space in esecuzione, con il resto del lavoro in un altro Space invece di condividere una sola finestra Chromium headed.
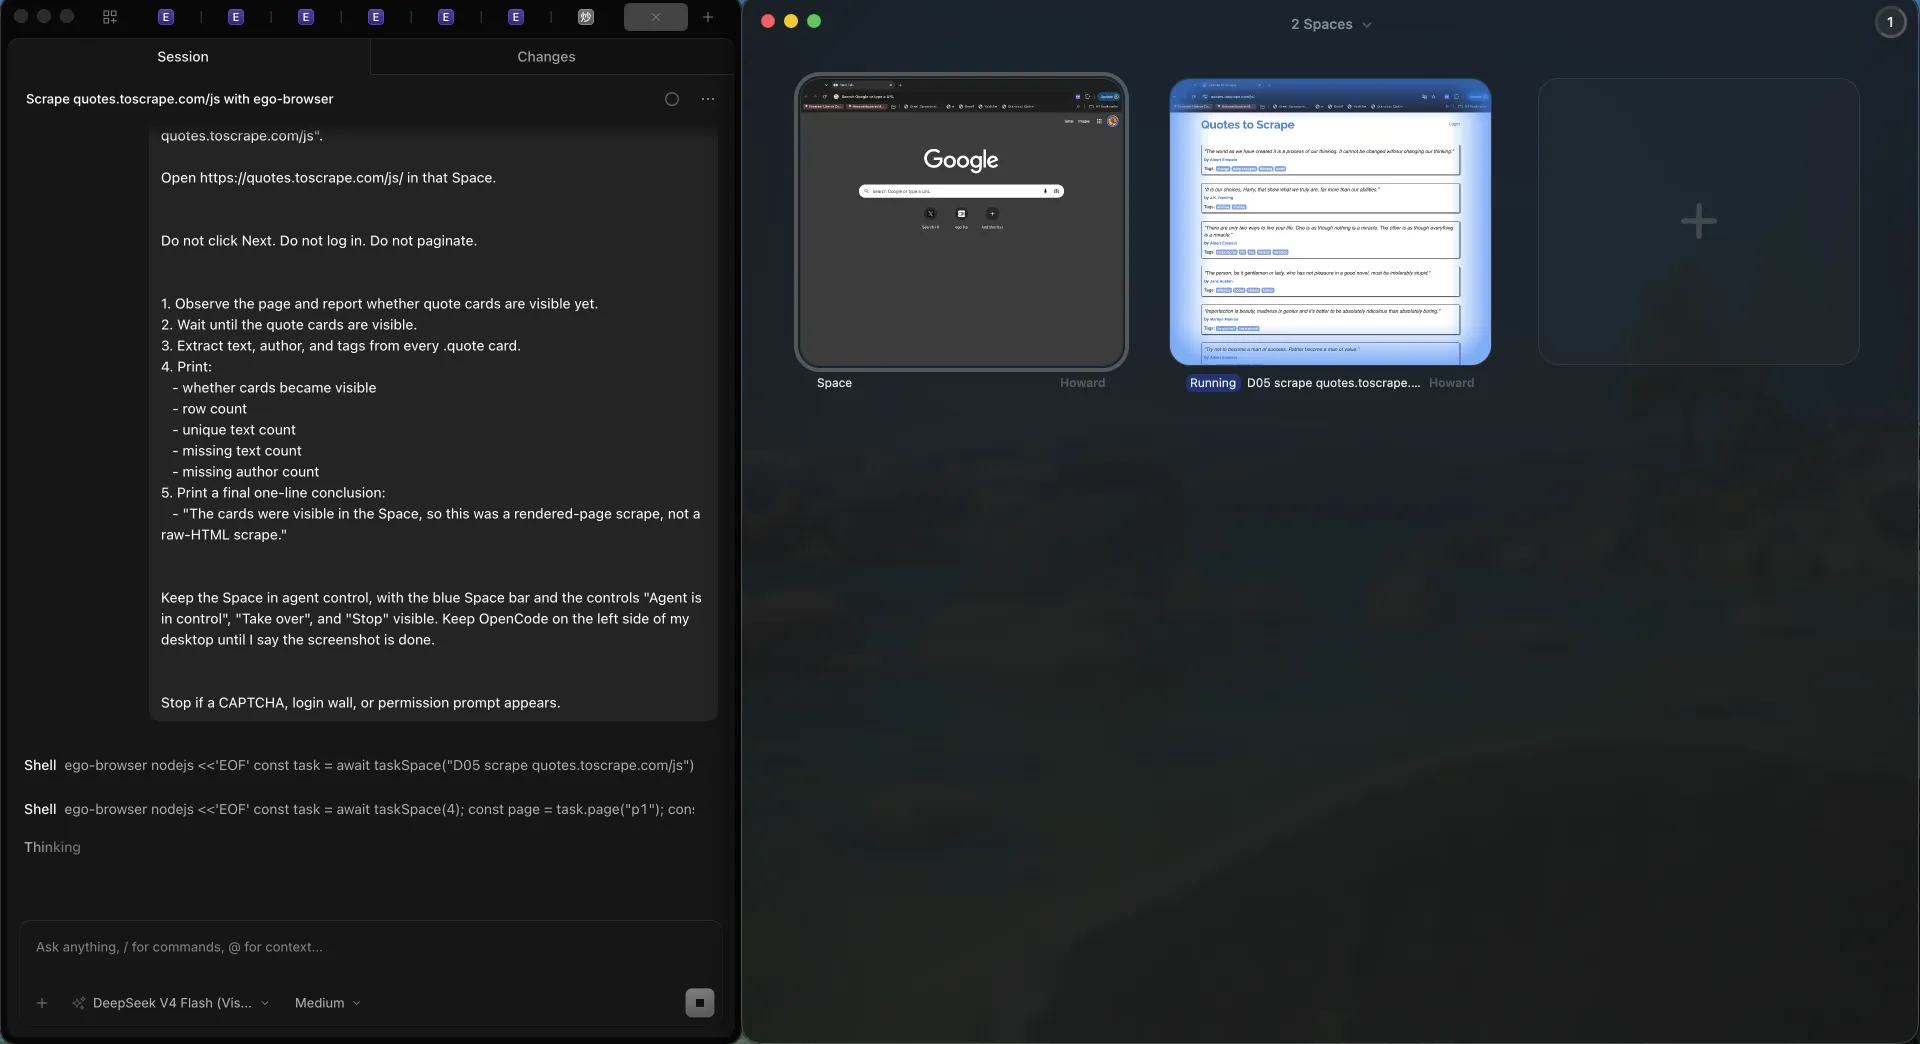
Abbiamo verificato lo stesso URL pubblico dentro uno di quegli Space. Lo Space 4 è rimasto in controllo dell'agente su quotes.toscrape.com/js, con Take over e Stop visibili, e ha stampato 10 card uniche.
I trade-off tra headless e headed sono in browser headless vs browser reale per gli agenti AI. La scelta della libreria è in Playwright vs Puppeteer per lo scraping. Il contrasto a livello di prodotto è su ego (lite) vs Playwright.
Quali sono le sfide e i limiti?
Lo scraping con Playwright fallisce in modi più silenziosi dello scraping HTTP, perché il browser può sembrare a posto mentre il file è sbagliato.
Il primo limite è il costo. Un contesto Chromium non è una GET. Se le card sono già nell'HTML, stai pagando un browser che non ti serve.
Il secondo è l'onestà su intercept. I tutorial trattano la cattura XHR come la mossa avanzata. Su questa demo la mossa avanzata è ammettere che il payload è inline.
Il terzo sono le pagine successive, e qui resta un limite di una riga. Quando una pagina renderizzata già valida, pagine numerate, Load More e infinite scroll diventano un lavoro a parte. Mischiare quei loop in questa pagina di attesa ed estrazione nasconderebbe il fallimento del DOM vuoto.
Il quarto è il permesso. Le regole robots, i termini e la legge sui dati personali restano validi. Un browser headed non crea un diritto a raccogliere.
Se lo scrape è vuoto e la pagina sembra piena, attendi la card, poi conta le righe. Una finestra headed non è una prova. Su questa fixture intercept non ha trovato nemmeno un XHR JSON; le citazioni erano già inline come var data.
FAQ
Playwright va bene per il web scraping?
Playwright va bene per lo scraping quando le card visibili mancano dall'HTML grezzo e lo scraper può attenderle in un browser reale. quotes.toscrape.com/js è l'esempio pubblico: una GET non restituisce nodi .quote, e un'attesa su .quote legge le card dipinte. È il default sbagliato per HTML statico o un'API documentata.
Quando usare HTTP invece di Playwright?
Usa HTTP quando i valori sono già nel corpo della risposta. La demo JavaScript contiene comunque var data con le citazioni, anche se non contiene card .quote. Se un parser di quel payload è stabile, salta il browser.
Perché il mio scrape con Playwright ha restituito zero righe?
Zero righe di solito significa che l'estrazione è girata prima che le card esistessero. Leggere il DOM a commit, prima che il pittore dipinga, restituisce 0 citazioni su questa demo, poi le card renderizzate dopo waitForSelector('.quote'), senza eccezione nel caso vuoto.
Devo aspettare networkidle?
Attendi il selettore che rappresenta i dati, non una rete silenziosa. networkidle può bloccarsi sui beacon di analytics. L'attesa che passa su questa demo è .quote, non networkidle.
Come si intercetta il JSON con Playwright?
Ascolta le risposte il cui content-type include json, oppure fai route dell'URL che la pagina già chiama. Su quotes.toscrape.com/js le citazioni sono inline, quindi non c'è un XHR JSON da catturare. Intercept è opzionale. L'attesa del DOM funziona comunque.
Come si fa scraping di elenchi su più pagine con Playwright?
Prima chiudi una sola pagina renderizzata: attendi, estrai, valida il conteggio. Pagine numerate, Load More e infinite scroll sono un lavoro a parte. Questa pagina non implementa quei loop.
Come si riutilizza un login in uno scrape Playwright?
Salva lo storage state dopo un login che hai il permesso di usare, poi caricalo in un contesto successivo. Tratta il file come un segreto e aspettati che scada.
Cosa fare con un 429?
Fermati, onora Retry-After quando c'è, fai backoff e fallisci dopo un piccolo tetto di tentativi. Un 429 è un segnale di frequenza, non un problema di selettore.
Serve ego (lite) per lo scraping con Playwright?
No. Usa Playwright quando attesa e selettore sono già noti. Usa ego (lite) quando lo scrape serve uno Space osservato, un profilo reale già autenticato o un takeover umano. Il 2026-09-18 entrambi i percorsi hanno estratto 10 card uniche da quotes.toscrape.com/js; lo Space ha tenuto visibili Take over e Stop.
Lo scraping con un browser reale è legale?
Dipende dal sito, dai dati, dalla giurisdizione e da cosa fai con il file. Le regole robots e i termini restano validi in un browser headed. Questo non è un parere legale.
Playwright o Puppeteer per lo scraping?
Entrambi possono renderizzare la stessa pagina. La scelta della libreria sono locator, attese e language binding. La decisione HTTP-contro-browser di questa pagina viene prima.
Se lo scrape successivo serve un browser osservato invece di un'altra attesa già scritta, ego (lite) è scaricabile gratuitamente. Lo scraper di prezzi è un lavoro concreto in quello Space.
