

JavaScript 웹 스크래핑은 코드가 틀려서가 아니라 잘못된 접근 경로를 골랐기 때문에 실패하는 경우가 많습니다. 데이터가 최초 HTML 안에 이미 들어 있다면 Node.js의 fetch와 HTML 파서만으로 충분합니다. 데이터가 나타나기 전에 페이지가 JavaScript를 실행하거나 페이지를 넘기거나 클릭하는 등 상호작용이 필요할 때만 브라우저가 필요해지며, 바로 이 지점이 정적 HTML과 렌더링 페이지를 가르는 기준입니다.
Playwright는 미리 알고 있고 자주 반복하는 워크플로에 잘 맞습니다. 페이지를 열고, 요소를 기다리고, 컨트롤을 클릭하고, 필드를 추출한 뒤 같은 경로를 다시 실행하는 방식입니다. 문제는 페이지 구조나 페이지 넘김, 상호작용 흐름이 바뀌면서 고정된 셀렉터와 동작 순서가 깨지기 시작할 때 생깁니다.
이럴 때 더 잘 맞는 것이 ego (lite) 같은 에이전트 기반 브라우저입니다. 원래 경로가 아직 존재한다고 가정하는 대신, 에이전트가 현재 렌더링된 페이지를 살펴보고 다음에 무엇을 할지 판단하며, 탐색이나 동적 변화가 일어난 뒤에도 안정적으로 실행을 이어갑니다.
JavaScript 스크레이퍼의 성패를 실제로 결정하는 것은 무엇인가요?
결과를 좌우하는 것은 접근 경로입니다. 데이터가 최초 HTML 응답에 담겨 오는지, 아니면 브라우저에서 실행되는 JavaScript가 나중에 가져와 그려내는지에 따라, 같은 대상 사이트가 HTTP로 아주 쉽게 긁히기도 하고 HTTP로는 전혀 보이지 않기도 합니다.
그래서 첫 번째 할 일은 스크레이퍼를 작성하는 것이 아닙니다. 대상 페이지를 열고, 렌더링된 DOM이 아니라 소스를 보고, 원하는 값이 실제로 어디에 있는지 확인하는 것입니다. 이 가이드의 나머지 내용은 모두 그 답에서 출발합니다.
대상 사이트에는 세 가지 접근 경로 중 어느 것이 필요할까요?
세 가지 경로면 거의 모든 스크래핑 작업을 처리할 수 있으며, 비용 순서대로 나열됩니다. 정적 HTML이 가장 저렴하고 빠릅니다. 페이지가 이미 호출하는 JSON 엔드포인트는 대개 가장 깔끔한 데이터를 줍니다. 실제 브라우저는 가장 강력하지만 CPU, 메모리, 취약성 면에서 가장 비쌉니다.
| 경로 | 할 수 있는 일 | 할 수 없는 일 |
|---|---|---|
| HTTP 요청 + HTML 파서 | 어떤 URL이든 직접 가져와 응답 본문을 읽고, 반환된 마크업을 쿼리할 수 있습니다. 프로세스당 분당 수천 페이지를 처리하며 브라우저 바이너리가 필요 없습니다. | 페이지 스크립트 실행, 클릭, 스크롤, 양식 입력은 할 수 없습니다. 클라이언트에서 렌더링되는 페이지에서는 데이터가 응답에 없었기 때문에 빈 껍데기가 반환됩니다. |
| JSON 엔드포인트 직접 호출 | 마크업 파싱 없이 구조화된 데이터를 반환하므로, 페이지 레이아웃이 개편돼도 필드 이름이 유지됩니다. 페이로드가 가장 작고 파싱도 가장 빠릅니다. | 사이트 업데이트 전반에 걸쳐 안정적으로 유지되지는 못합니다. 이런 엔드포인트는 내부용이고 문서화되지 않았으며, 예고 없이 바뀌거나 요청을 거부하기 시작할 수 있습니다. |
| 실제 브라우저 자동화 | 페이지의 JavaScript를 실행하고, 콘텐츠가 나타날 때까지 기다리며, 사람이 하는 것과 똑같이 렌더링된 결과와 상호작용할 수 있습니다. | 저렴하게 확장할 수는 없습니다. 브라우저 컨텍스트마다 실제 메모리를 소모하고, 여러 개를 돌리려면 HTTP 루프보다 더 많은 인프라가 필요합니다. |
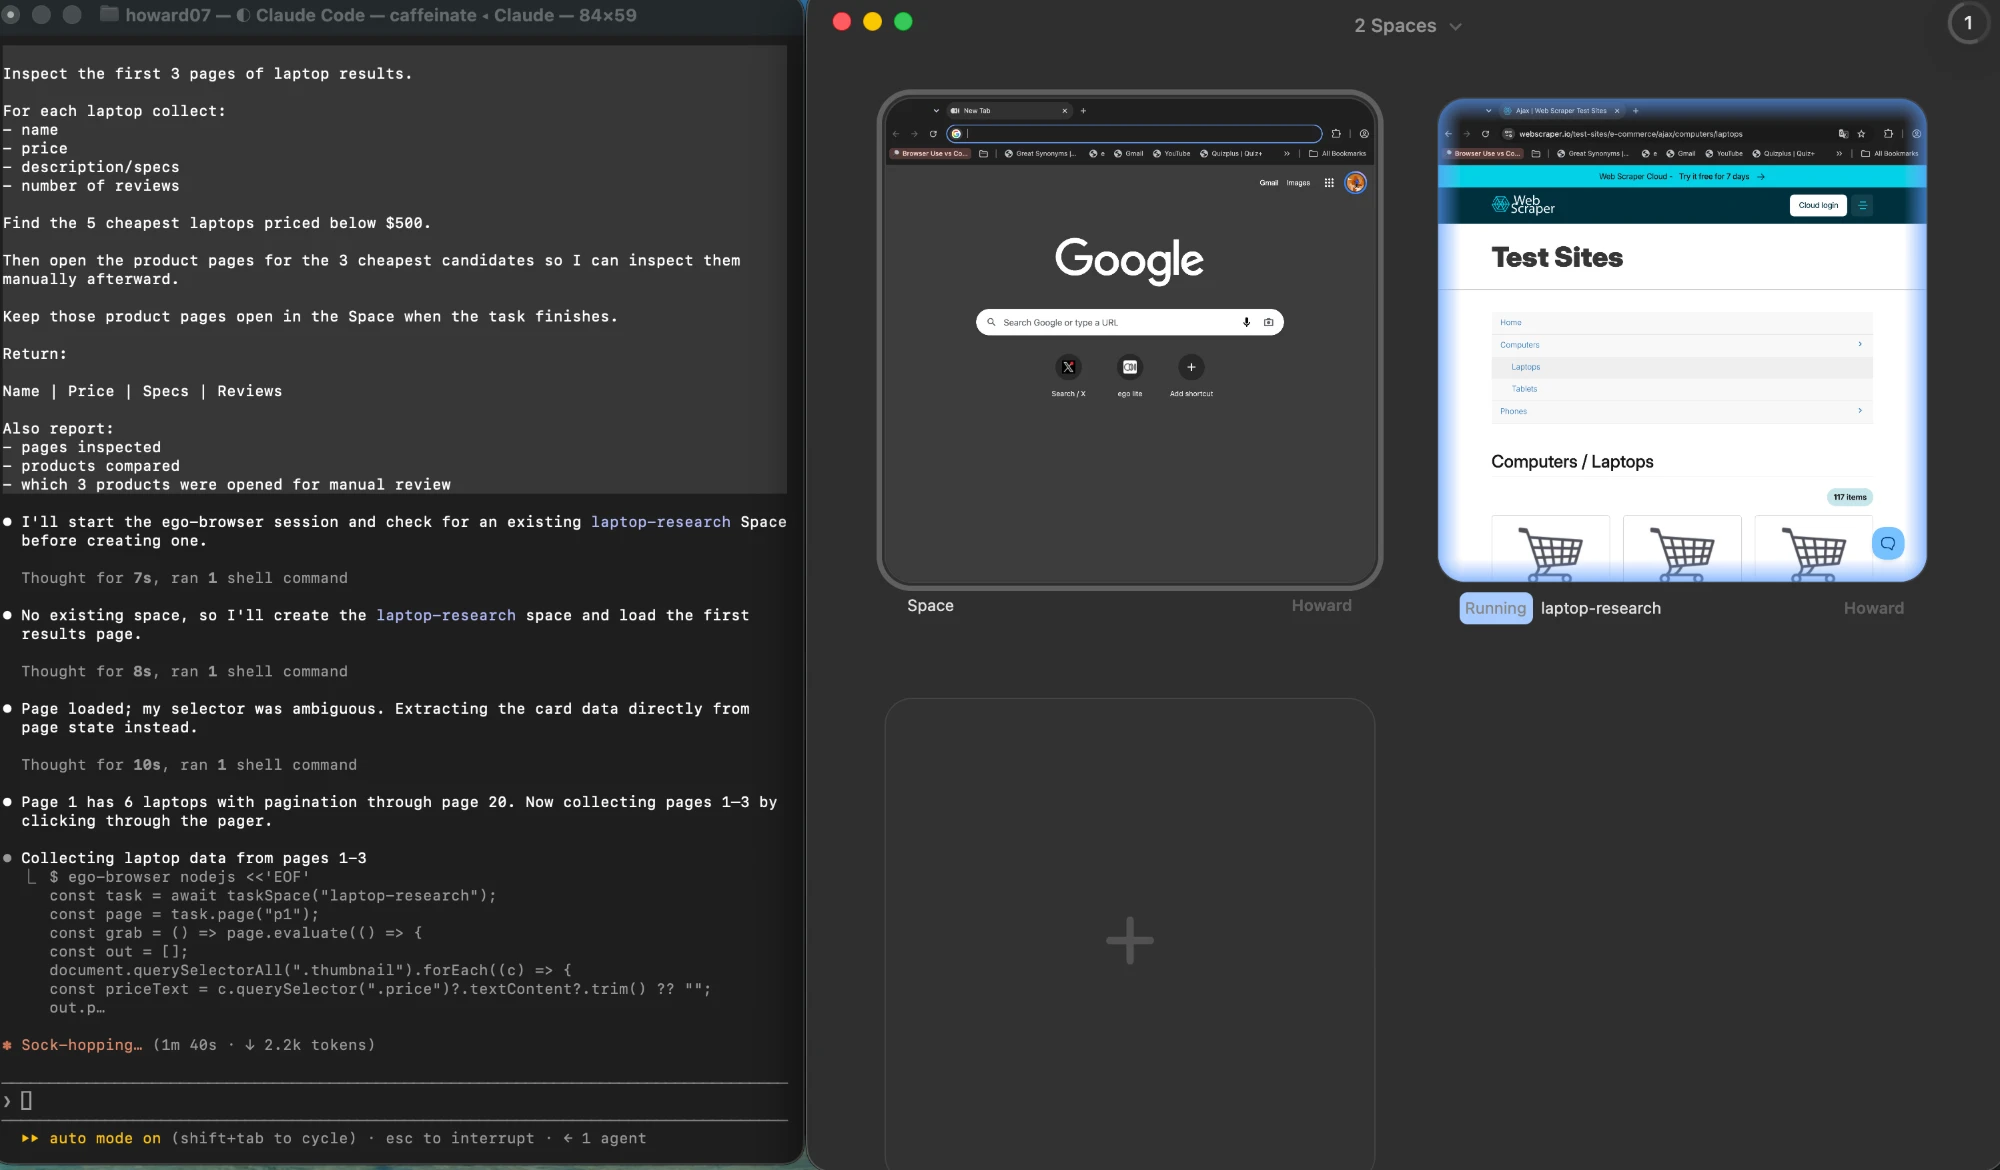
Node.js에서 정적 HTML을 가져와 파싱하는 방법은?
플랫폼부터 시작하세요. Node.js는 Fetch API를 전역으로 노출하므로 요청에 의존성이 전혀 필요 없습니다. 아래 패턴이 첫 번째 경로의 전부입니다. 요청하고, 상태를 확인하고, 텍스트를 읽고, 마크업을 파서에 넘깁니다.
요청 자체는 플랫폼 외에 아무것도 필요로 하지 않습니다. Fetch API가 Node.js 전역으로 제공되기 때문입니다. 따라서 단순한 GET에는 설치할 HTTP 라이브러리가 없습니다.
상태 확인은 사람들이 가장 먼저 빼먹고 가장 크게 후회하는 부분입니다. 404 페이지나 봇 차단 페이지도 본문을 반환하고, 그 본문은 아무 문제 없이 파싱되어 일치하는 요소가 0개가 됩니다. 이는 셀렉터 버그와 똑같이 보입니다.
const res = await fetch(url, {
  headers: { "user-agent": "my-scraper/1.0 (+contact@example.com)" },
});

if (!res.ok) {
  throw new Error(`${res.status} ${res.statusText} for ${url}`);
}

const html = await res.text();
속도 제한은 나중에 덧대는 것이 아니라 같은 루프 안에 넣어야 합니다. 요청 사이에 대기 한 번만 await해도 작은 작업은 예의를 지키고 내 주소가 차단 목록에 오르지 않습니다.
const sleep = (ms) => new Promise((r) => setTimeout(r, ms));

for (const url of urls) {
  const html = await getHtml(url);
  await parse(html);
  await sleep(1000);
}
다음은 첫 번째 경로가 실제로 반환하는 결과입니다. 아래 표는 노트북 공개 테스트 카탈로그를 대상으로 순수 HTTP 요청과 셀렉터 라이브러리로 얻은 실제 출력입니다. 브라우저도, 렌더링 단계도 없이 세 페이지를 세 개의 정적 응답으로 가져왔습니다.
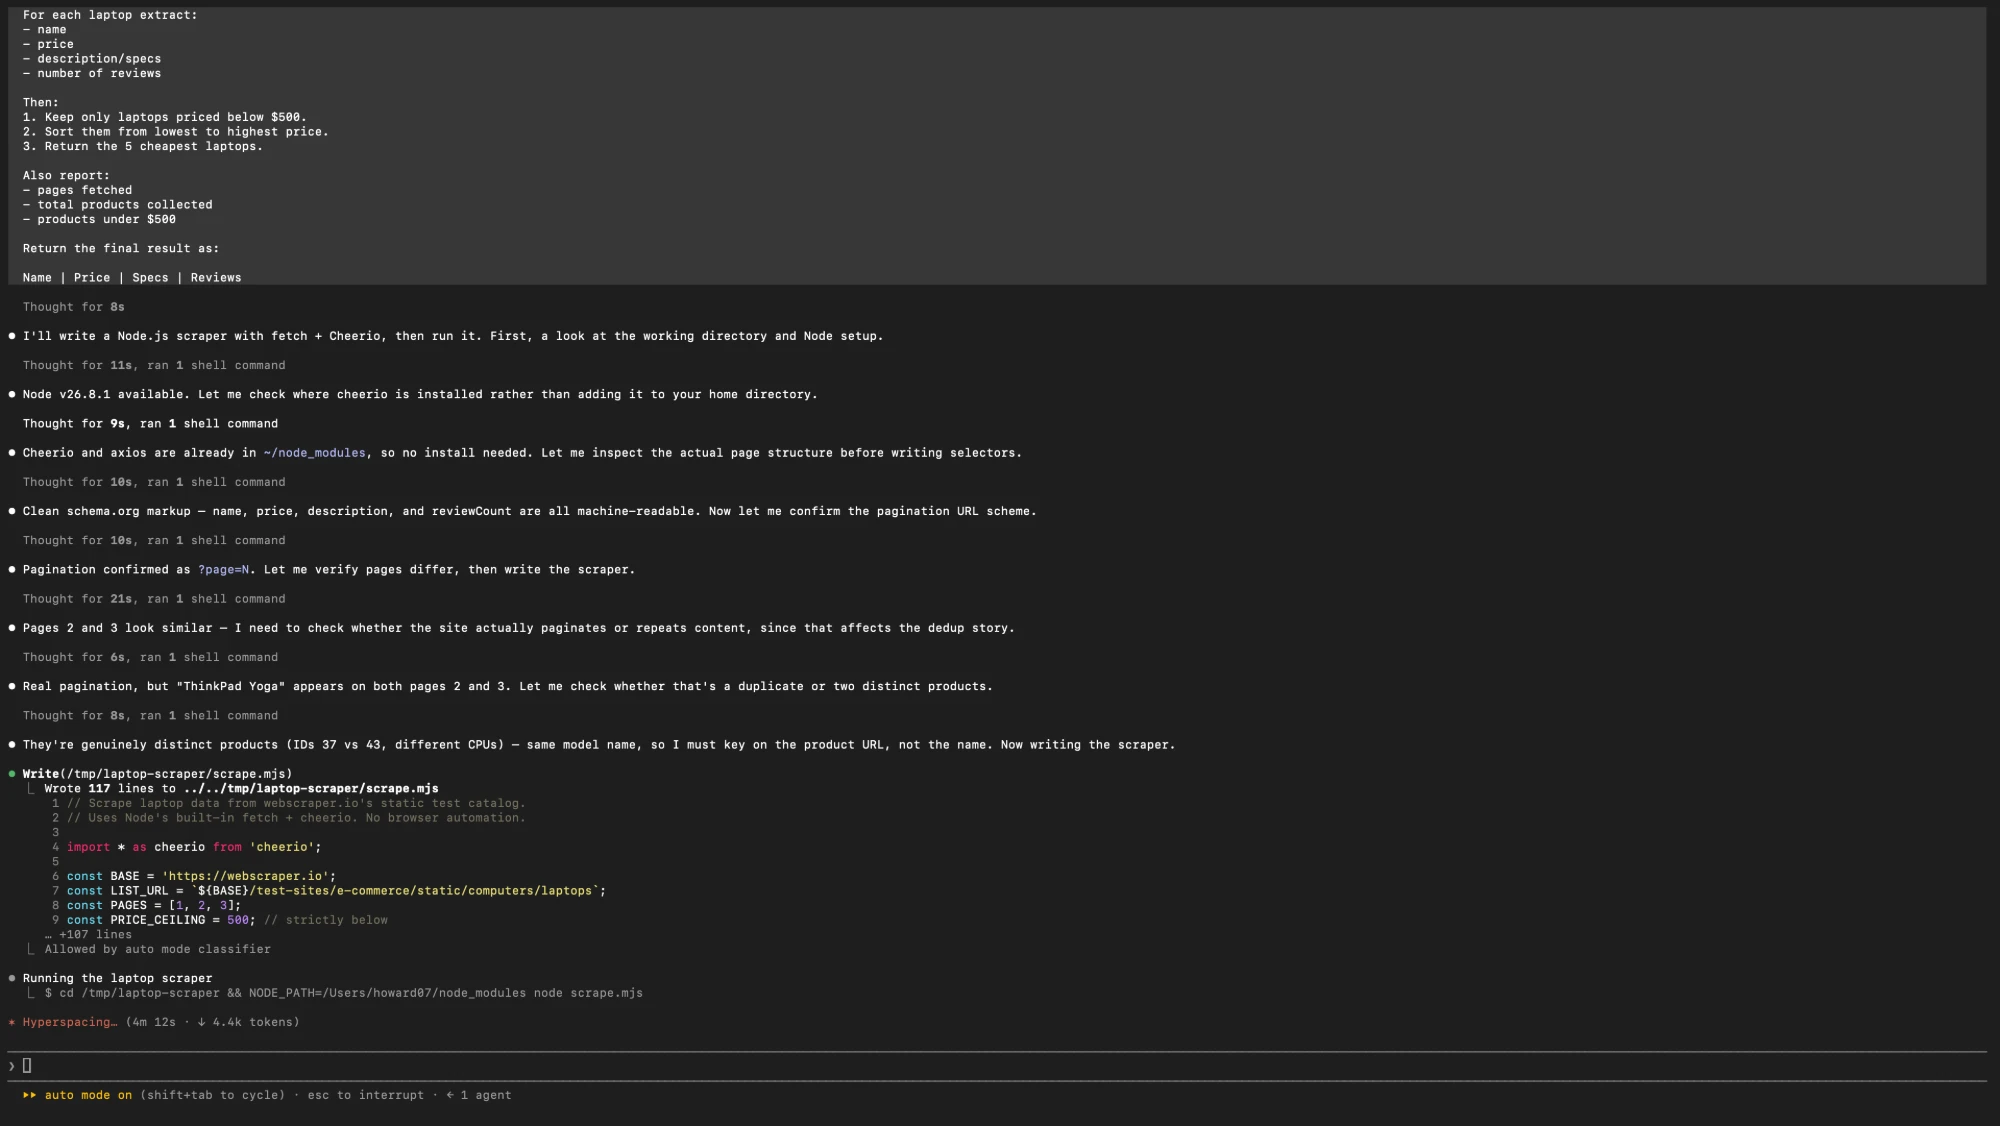
| ID | 이름 | 가격 | 사양 | 리뷰 |
|---|---|---|---|---|
| 32 | Aspire E1-510 | $306.99 | 15.6", Pentium N3520 2.16GHz, 4GB, 500GB, Linux | 2 |
| 45 | Asus VivoBook Max | $399 | 15.6" HD, Pentium N4200 1.1GHz, 4GB, 500GB, Windows 10 Home | 4 |
| 31 | Packard 255 G2 | $416.99 | 15.6", AMD E2-3800 1.3GHz, 4GB, 500GB, Windows 8.1 | 2 |
| 46 | Dell Vostro 15 | $488.78 | 15.6" FHD, Core i5-7200U, 4GB, 128GB SSD, Radeon R5 M420 2GB, Linux | 14 |
18개 제품 중 4개가 500달러 미만입니다. 이것이 이 카탈로그에 대한 첫 번째 경로의 결과 전부입니다. 요청 3회, 렌더링 없음, 브라우저 프로세스 없음입니다. 그런데 여기서부터가 정직한 부분입니다. 이 표에는 독자라면 당연히 있을 것이라 기대할 무언가가 빠져 있습니다.
Cheerio, DOMParser, jsdom 중 어떤 파서를 써야 할까요?
이 셋은 서로 교체 가능한 라이브러리인 것처럼 비교됩니다. 하지만 그렇지 않습니다. 각자 약속하는 바가 다르기 때문입니다. 둘은 쿼리를 위해 마크업을 파싱하고, 하나는 스크립트 실행을 포함한 DOM을 구현합니다.
이 가이드가 활용하는 파서는 다음 문서에 나와 있습니다: cheerio.js.org, 이 문서는 Cheerio가 페이지 스크립트를 실행하기보다 마크업을 파싱하고 쿼리한다는 점을 분명히 밝히고 있습니다.
| 선택지 | 할 수 있는 일 | 할 수 없는 일 |
|---|---|---|
| Cheerio | HTML 문자열을 빠르게 파싱하고 jQuery 스타일 셀렉터로 쿼리할 수 있습니다. 의존성이 작고 브라우저가 필요 없으며, 응답 본문에서 필드 수백 개를 뽑아내기에 이상적입니다. | 페이지 스크립트 실행, 컴포넌트 렌더링, 레이아웃 계산은 할 수 없습니다. 마크업을 파싱할 뿐, 브라우저처럼 동작하지는 않습니다. |
| jsdom | document, window, 스크립트 실행을 갖춘 DOM 구현체를 Node.js에서 제공하므로, 브라우저 API에 맞춰 작성된 코드가 그대로 실행됩니다. | 렌더링이나 충실도 면에서 실제 브라우저에 필적할 수 없고, 페이지당 부담이 훨씬 큽니다. DOM 대체물일 뿐 Chrome이 아닙니다. |
| DOMParser | 내장 브라우저 API를 사용해 문자열을 쿼리 가능한 문서로 바꾸며, 프로젝트에 의존성을 전혀 추가하지 않습니다. | await할 수 없습니다. 동기적이고 블로킹이며, Node.js에서는 최근 버전에서야 전역이 되었습니다. |
Cheerio에서 읽을 때는 익숙한 셀렉터 API를 사용합니다. 추출한 텍스트를 경계에서 trim하는 점에 주목하세요. 스크래핑한 마크업에는 들여쓰기와 줄바꿈이 딸려 있어 그대로 두면 데이터셋에 나타나기 때문입니다.
import * as cheerio from "cheerio";

const $ = cheerio.load(html);
const items = $(".product-card").map((i, el) => ({
  name: $(el).find(".name").text().trim(),
  price: $(el).find(".price").text().trim(),
})).get();
같은 추출을 DOMParser로 하면 다음과 같으며, 이 전역이 존재하는 곳에서만 동작합니다.
const doc = new DOMParser().parseFromString(html, "text/html");
const rows = [...doc.querySelectorAll("table tbody tr")].map((tr) => ({
  cells: [...tr.querySelectorAll("td")].map((td) => td.textContent.trim()),
}));
페이지가 이미 사용하는 JSON 엔드포인트를 찾는 방법은?
셀렉터를 하나라도 쓰기 전에 브라우저의 네트워크 패널을 열고 fetch와 XHR로 필터링한 뒤 페이지를 새로 고쳐 무엇이 돌아오는지 보세요. 데이터 기반 사이트는 대개 눈에 보이는 페이지를 소수의 JSON 응답으로 조립하며, 그쪽이 마크업보다 훨씬 다루기 쉽습니다.
하나를 찾았다면, 그 요청에는 보통 페이지가 보낸 것과 같은 헤더가 필요하고 때로는 세션 쿠키도 필요합니다. 손으로 다시 조립하지 말고 네트워크 패널의 copy-as-fetch 출력으로 재현하세요.
const res = await fetch("https://example.com/api/listings?page=1", {
  headers: { accept: "application/json" },
});

if (!res.ok) throw new Error(`${res.status} for listings page 1`);

const { items } = await res.json();클라이언트에서 렌더링되는 페이지가 빈 껍데기를 반환하는 이유는?
클라이언트에서 렌더링되는 페이지는 내용이 거의 없는 마크업을 보냅니다. 최초 응답에는 루트 요소, 스크립트 묶음, 어쩌면 로딩 상태가 들어 있습니다. 사람이 화면에서 보는 텍스트는 응답이 도착한 뒤 JavaScript가 만들어내므로, 응답만 읽는 HTTP 요청에는 읽을 것이 없습니다.
이것은 불가사의한 일이 아니라 진단할 수 있습니다. 대부분의 경우는 두 가지 확인으로 잡힙니다. 응답 안의 표시 텍스트가 브라우저가 보여주는 양의 극히 일부이고, 마크업이 script 태그 위주라는 점입니다.
const text = html.replace(/<script[\s\S]*?<\/script>/g, "").replace(/<[^>]+>/g, " ").replace(/\s+/g, " ").trim();

console.log({
  textLength: text.length,
  scriptCount: (html.match(/<script\b/g) ?? []).length,
  hasRoot: /id="(root|app|__next)"/.test(html),
});
텍스트가 짧고 스크립트가 많으며 루트 div가 비어 있다면, 정직한 답은 세 번째 경로입니다. script 태그가 전혀 없이 텍스트가 몇십 자뿐이라면 보통 더 단순한 이유입니다. 요청이 차단됐거나 잘못된 URL을 요청한 것입니다.
실제 차이는 다음과 같습니다.
| HTTP 응답에서 보이는 신호 | 보통 의미하는 것 | 다음 단계 |
|---|---|---|
| 온전한 콘텐츠, 실제 마크업 | 서버가 페이지를 렌더링했습니다. 다른 것은 필요하지 않습니다. | 셀렉터 라이브러리로 파싱하세요. |
| 루트 div와 다수의 스크립트 | 클라이언트 사이드 렌더링입니다. 콘텐츠는 응답 이후에 도착합니다. | JSON 엔드포인트를 찾거나 페이지를 렌더링하세요. |
| 아주 짧은 텍스트, 스크립트 없음 | 차단됐거나 리다이렉트됐거나, 아예 잘못된 URL입니다. | 파싱 전에 상태 코드, 최종 URL, 헤더를 로그로 남기세요. |
Playwright는 실제 브라우저 페이지를 어떻게 스크래핑할까요?
Playwright는 실제 브라우저를 구동하므로 페이지는 방문자에게 실행되는 것과 똑같이 동작합니다. 스크래핑의 형태는 대부분의 예상보다 작습니다. 컨텍스트를 열고, URL로 이동하고, 필요한 특정 요소를 기다린 뒤 읽어냅니다.
여기서 사용하는 API는 다음 문서에 나와 있습니다: playwright.dev, 브라우저, 컨텍스트, 로케이터를 실행하기 위한 표준 레퍼런스입니다.
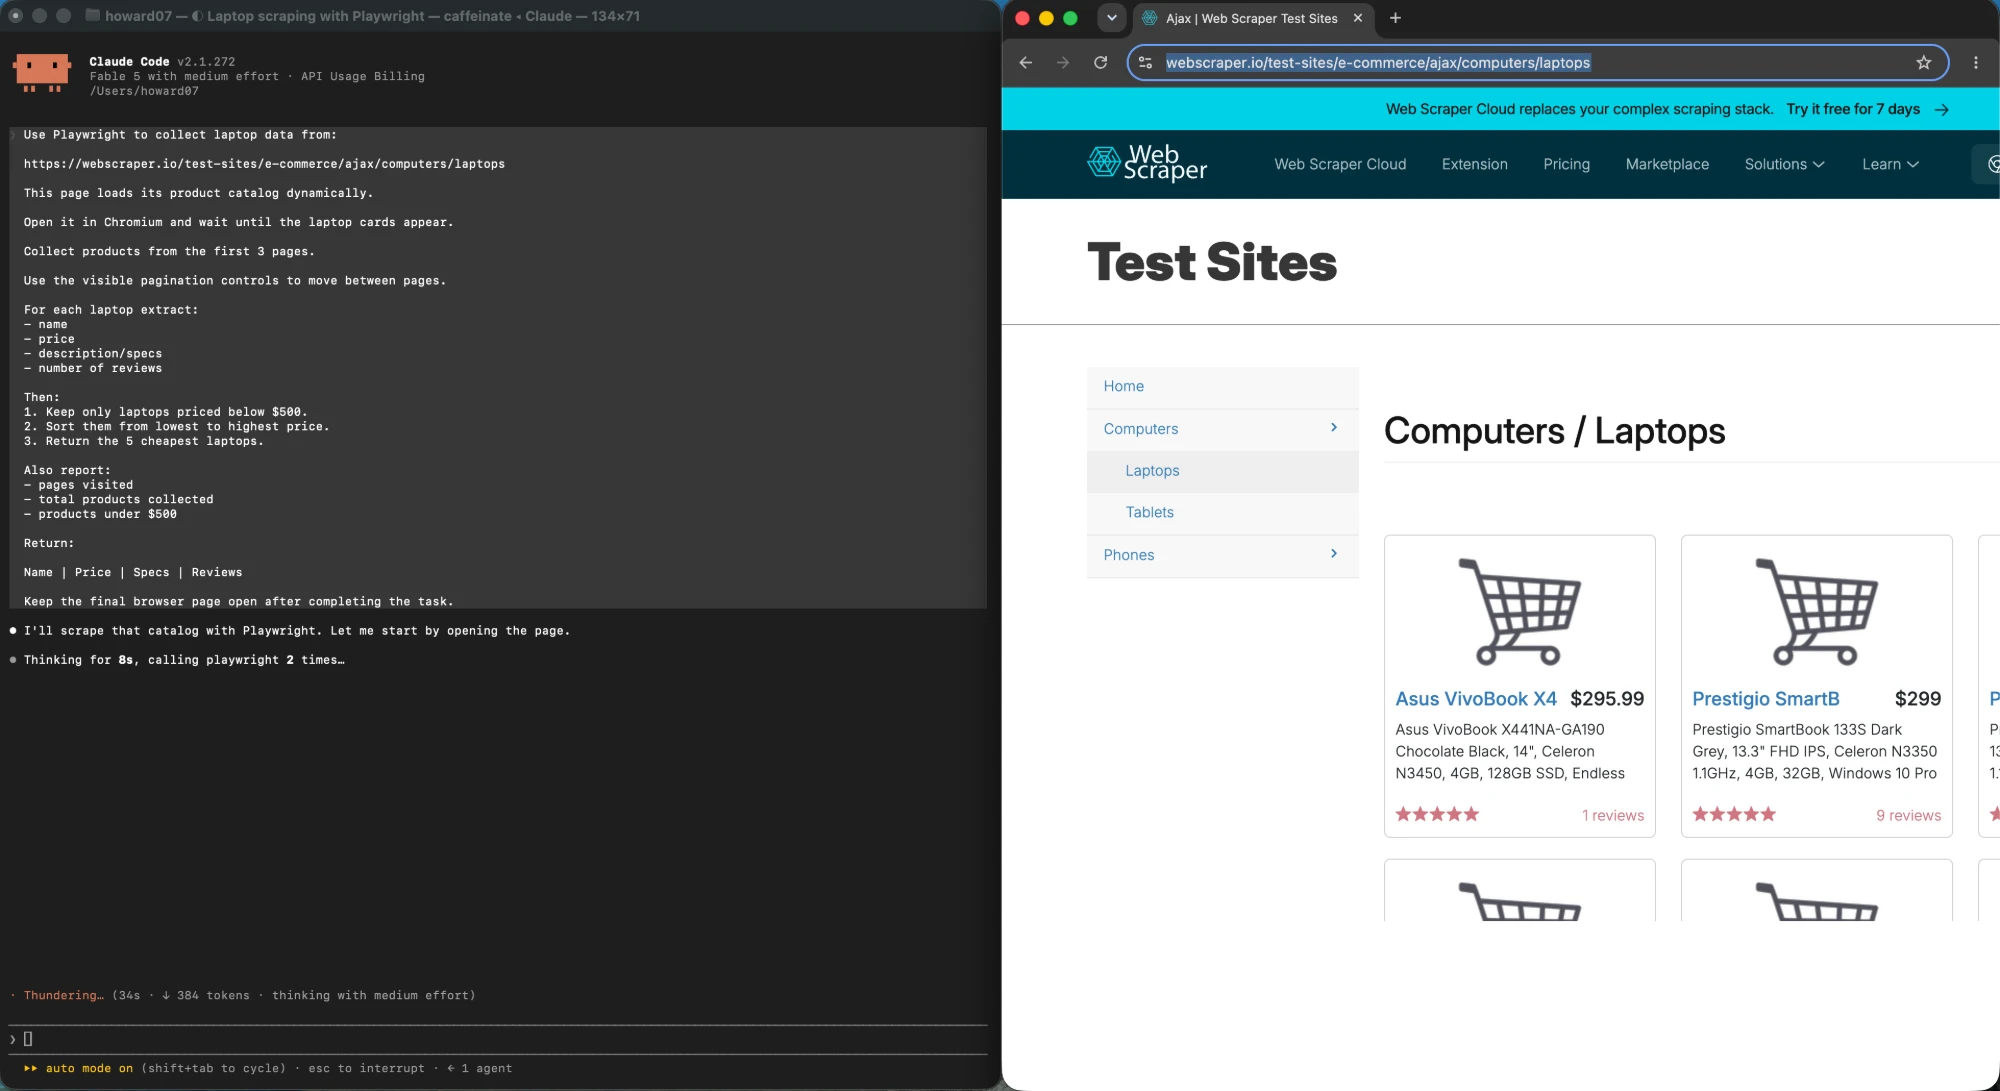
아래 검색 패턴은 셀렉터를 기다린 다음 page.evaluate로 추출합니다. 이 함수는 페이지 안에서 실행되고 직렬화 가능한 결과를 반환합니다.
import { chromium } from "playwright";

const browser = await chromium.launch();
const context = await browser.newContext();

try {
  const page = await context.newPage();
  await page.goto(url, { waitUntil: "domcontentloaded" });
  await page.waitForSelector(".product-card");

  const rows = await page.evaluate(() =>
    [...document.querySelectorAll(".product-card")].map((el) => ({
      name: el.querySelector(".name")?.textContent?.trim() ?? null,
      price: el.querySelector(".price")?.textContent?.trim() ?? null,
    })),
  );

  console.log(rows);
} finally {
  // contexts hold the memory; close it even when the scrape throws
  await context.close();
  await browser.close();
}
셀렉터보다 중요한 라이프사이클 세부 사항이 두 가지 있습니다. 첫째, 컨텍스트는 저렴하게 버릴 수 있는 단위이므로 브라우저 하나가 여러 개의 격리된 실행을 처리할 수 있고, 각 실행은 close로 끝납니다. 둘째, 페이지에서의 텍스트 추출은 렌더링된 값이 아니라 텍스트 노드를 반환합니다. CSS로 숨긴 콘텐츠도 DOM에는 남아 있으므로 출력에도 나타납니다.
대상이 목록 전체가 아니라 특정 요소라면 로케이터가 더 깔끔한 검색 경로입니다. Playwright의 로케이터 문서에는 버튼, 링크, 입력 요소에 클릭 대기가 필요 없다고 적혀 있습니다. 모든 상호작용을 명시적 대기로 감싸기 전에 기억해 둘 만합니다.
const title = await page.getByRole("heading", { level: 1 }).innerText();
const price = await page.locator("[data-testid=price]").innerText();
세션, 차단 위험, CAPTCHA가 계획을 어떻게 바꿀까요?
대상에 로그인이 필요해지는 순간, 스크레이퍼는 데이터 작업이 아니라 세션 관리 문제가 됩니다. Playwright는 이를 직접 지원합니다. 한 번 인증하고 브라우저의 스토리지 상태를 파일로 저장한 뒤, 매번 자격 증명 입력을 스크립트로 작성하는 대신 이후 실행에서 재사용합니다.
// once, interactively
await context.storageState({ path: "auth.json" });

// later runs
const context = await browser.newContext({ storageState: "auth.json" });
여기서 운영상의 사실 두 가지가 따라옵니다. 저장한 세션 상태는 자격 증명이므로 리포지토리가 아니라 시크릿 저장소에 두어야 합니다. 그리고 저장한 세션은 만료되므로, 갑자기 로그인 페이지를 반환하기 시작한 실행은 셀렉터가 아니라 세션 문제입니다.
그 상태를 실행 사이에도 살려 두는 일은 그 자체로 하나의 주제입니다: 에이전트 실행 간 지속되는 브라우저 세션 항목에서 자세히 다룹니다.
자동화된 트래픽 전반에서는 세 가지 제약이 이것이 스크래핑 작업인지 지는 싸움인지를 결정합니다. 사이트의 robots 지시문과 약관이 허용하는 범위, 사이트가 공개하거나 감내하는 속도, 그리고 돌아오는 응답이 콘텐츠인지 챌린지 페이지인지입니다. 이는 코드를 작성하기 전에 정리해야 할 정책 문제이며, 더 자세한 내용은 다음 가이드에서 다룹니다. 로그인 장벽 뒤의 스크래핑.
운영 환경에서 JavaScript 스크레이퍼를 망가뜨리는 원인은?
스크레이퍼는 셀렉터가 틀려서 실패하는 경우가 드뭅니다. 두 번째 실행, 100번째 URL에서 페이지가 느리거나 응답이 리다이렉트이거나 사이트가 속도 제한을 걸기 시작할 때 실패합니다. 해법은 화려하지 않고 구체적입니다.
async function getWithRetry(url, attempt = 0) {
  const res = await fetch(url);
  if (res.status === 429 || res.status >= 500) {
    if (attempt >= 3) throw new Error(`giving up on ${url}`);
    const retryAfter = Number(res.headers.get("retry-after"));
    const waitMs = Number.isFinite(retryAfter)
      ? retryAfter * 1000
      : 2 ** attempt * 1000;
    await new Promise((r) => setTimeout(r, waitMs));
    return getWithRetry(url, attempt + 1);
  }
  if (!res.ok) throw new Error(`${res.status} for ${url}`);
  return res.text();
}
두 번째 함정은 동시성입니다. 한 머신에서 브라우저 컨텍스트 10개를 병렬로 돌리면 대부분 같은 CPU를 두고 경쟁하므로 처리량 증가는 메모리 비용보다 작고, 사이트는 조금씩이 아니라 한꺼번에 몰리는 트래픽을 봅니다. 순차 실행으로 시작해 측정하고, 대상이 감당할 때에만 숫자를 올리세요.
세 번째는 약속되지 않은 엔드포인트를 읽는 스크레이퍼에는 폴백이 필요하다는 점입니다. 눈에 보이는 페이지를 셀렉터로 파싱하는 코드를 코드베이스에 남겨 두고, JSON 호출이 실패하면 그쪽으로 넘어가게 하세요. 그러면 업스트림의 조용한 변경이 실행을 텅 비게 만드는 대신 품질을 낮추는 데서 그칩니다.
실제 브라우저가 정말로 필요한 경우는 언제일까요?
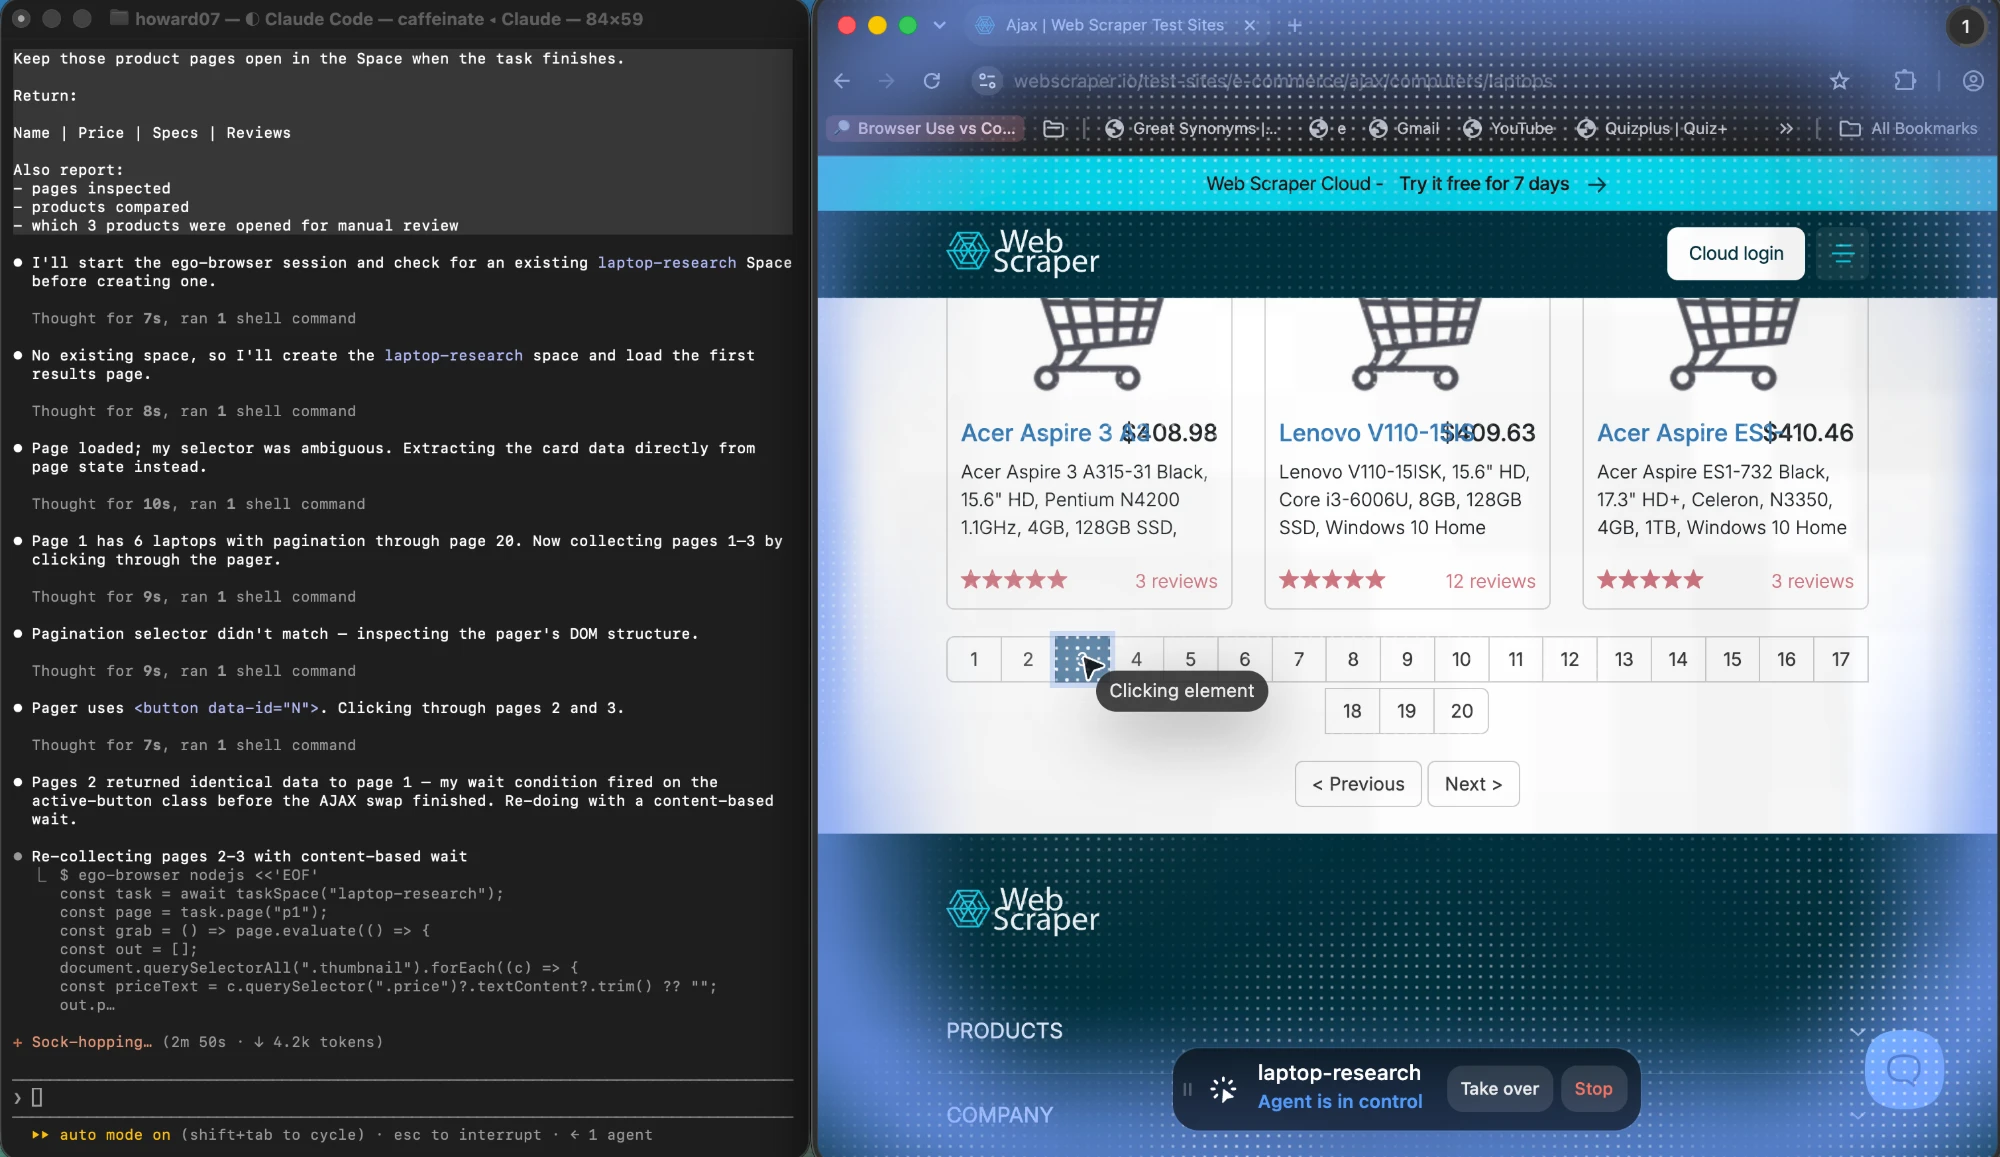
실제 브라우저가 정답인 경우는 오직 브라우저만 제공할 수 있는 것이 필요할 때입니다. 이미 내 머신에 있는 인증된 세션, 상호작용 후에야 나타나는 콘텐츠, 중간에 사람이 개입해야 하는 흐름, 가져오는 것이 아니라 진행되는 동안 지켜봐야 하는 결과 같은 것입니다. 그런 경우가 아니라면 파서를 붙인 HTTP가 더 빠르고 저렴하며 계속 돌리기도 쉽습니다.
헤드리스 브라우저와 실제 브라우저의 트레이드오프는 다음에서 다룹니다: AI 에이전트를 위한 헤드리스 브라우저 vs 실제 브라우저.
이런 상황에서 작업 주도형 브라우저 에이전트를 도입할 가치가 생깁니다. ego (lite)는 에이전트 주도 작업을 위해 만들어진 브라우저입니다. 목표를 설명하면 실제 브라우저에서 동작하며, 이미 열어 둔 로그인 세션도 활용합니다. 사람의 판단이 필요한 단계에서는 직접 조작할 수 있는 눈에 보이는 인터페이스를 제공합니다. 실제 로그인 상태, 동적 페이지, 눈에 보이는 실행, 사람으로의 인계가 필요한 스크래핑 작업이라면 앞서 설명한 세션 연결 작업이 사라집니다. Playwright를 대체하는 것이 아니고 모든 사이트를 보장하지도 않습니다. 챌린지로 응답하는 페이지나 자동 접근을 금지하는 페이지는 다른 어떤 경로와 마찬가지로 이 브라우저에도 허용되지 않습니다. 순수한 HTTP 요청이나 공식 API가 이미 필요한 것을 반환한다면 브라우저 에이전트를 추가하는 것은 작업을 느리게 만들 뿐입니다.
브라우저가 정말로 답이 된 다음 브라우저 도구를 더 깊이 비교하고 싶다면, 저희 Playwright와 Puppeteer 스크래핑 비교에서 라이브러리 선택 자체를 다루고, AI 웹 스크레이퍼 워크플로에서는 에이전트가 스크레이퍼 파이프라인에서 어디에 들어가는지 다룹니다.
주요 과제와 한계는 무엇인가요?
이 프레임워크의 모든 경로에는 엔지니어링으로 없앨 수 없는 실패 유형이 있고, 그것을 미리 아는지가 1년을 버티는 스크레이퍼와 일주일 만에 멈추는 스크레이퍼를 가릅니다.
정적 파싱은 사이트가 마크업을 개편할 때 깨집니다. 알아챌 방법이 없으므로, 완전히 크래시하는 일보다 필드가 조용히 null이 되는 일이 더 흔합니다. 파이프라인을 믿지 말고 실행할 때마다 샘플을 검증하세요.
내부 JSON 엔드포인트는 아무 경고 없이 깨지며, 어떤 사이트에서든 가장 계약성이 낮은 부분입니다. 오늘의 성공은 다음 달에 대한 근거가 되지 않습니다.
브라우저 자동화는 가장 현실적이면서 대규모에서는 가장 잘 부서집니다. 메모리는 동시성과 함께 늘고, 세션은 만료되며, 안티봇 시스템은 의도가 아니라 패턴에 반응합니다. 그래서 노트북에서 통하는 기법이 데이터센터에서는 통하지 않을 수 있습니다.
그리고 가장 큰 한계는 기술적인 것이 아닙니다. 무엇을 수집해도 되는지, 얼마나 자주 해도 되는지, 수집한 뒤 무엇을 해도 되는지는 사이트 약관과 robots 지시문, 그리고 거주 지역의 법이 결정하며, 코드가 동작한다고 해서 그중 무엇도 바뀌지 않습니다.
여기까지의 논의에서 나오는 문제 해결 순서는 짧습니다. 스크래핑이 아무것도 반환하지 않으면 먼저 상태 코드를 확인하고, 그다음 콘텐츠가 응답에 애초에 들어 있는지 확인하고, 그다음 셀렉터가 소스가 아니라 렌더링된 DOM과 일치하는지 확인하세요. 이 세 가지를 거친 뒤에야 브라우저를 고려해야 합니다.
FAQ
Node.js에서 HTTP 요청을 보내려면 라이브러리가 필요한가요?
아니요. Node.js는 Fetch API를 전역으로 노출하므로 아무것도 설치하지 않고 fetch를 쓸 수 있고, response 객체와 그 ok, status, text() 멤버도 함께 사용할 수 있습니다. 정말로 필요한 것은 파서입니다. fetch는 문자열을 돌려주는데, HTML에 대한 문자열 매칭은 마크업이 바뀌는 순간 깨지기 때문입니다.
브라우저에서는 멀쩡해 보이는 페이지인데 스크레이퍼가 빈 목록을 반환하는 이유는 무엇인가요?
가장 가능성 높은 원인은 페이지가 클라이언트에서 렌더링되고 데이터가 HTTP 응답에 애초에 없었던 것입니다. 원시 응답의 표시 텍스트와 브라우저가 보여주는 것을 비교하고, 콘텐츠 대비 script 태그 수를 세어 확인하세요. 응답이 껍데기라면 사이트의 JSON 엔드포인트로 옮기거나 실제 브라우저에서 페이지를 렌더링하세요.
Cheerio는 헤드리스 브라우저를 대체할 수 있나요?
아니요. Cheerio는 HTML을 파싱하고 셀렉터로 쿼리할 수 있게 해줄 뿐입니다. JavaScript를 실행하지 않으므로 페이지가 로딩 후 생성하는 콘텐츠를 만들어낼 수 없습니다. 첫 번째 경로에는 맞는 도구이고 세 번째 경로에는 틀린 도구이며, Cheerio로 충분한 상황에서 브라우저를 찾는 것이 스크래핑 코드에서 가장 흔한 불필요한 비용입니다.
페이지가 서버에서 렌더링되는지 클라이언트에서 렌더링되는지는 어떻게 알 수 있나요?
URL을 요청하고 렌더링된 DOM이 아니라 원시 응답을 보세요. 원하는 값이 응답 본문에 있으면 서버에서 렌더링된 것이고 저렴한 경로가 통합니다. 본문에 루트 요소와 스크립트 묶음만 있고 텍스트가 거의 없으면 콘텐츠는 브라우저에서 조립되는 것입니다.
로그인이 필요한 페이지는 어떻게 스크래핑하나요?
브라우저 컨텍스트에서 한 번 로그인하고, 스토리지 상태를 파일로 저장한 뒤 이후 실행에서 그 상태를 불러옵니다. 파일은 시크릿으로 취급하고, 만료될 것을 전제로 하며, 사용 권한이 있는 세션을 사용하세요. 대상이 CAPTCHA나 소유권 확인 우회를 요구한다면 멈추고 공식 경로를 이용하세요.
스크래핑에는 Playwright와 Puppeteer 중 무엇이 더 좋나요?
둘 다 실제 브라우저를 구동하며 같은 페이지를 스크래핑할 수 있습니다. 판단 기준은 접근 경로가 아니라 로케이터 지원, 대기 동작, 언어 바인딩 같은 라이브러리 세부 사항이며, 이는 저희 Playwright와 Puppeteer 비교에서 다룹니다. 어느 쪽을 고르든 이 글의 경로 결정이 먼저입니다.
한 번에 몇 페이지까지 스크래핑할 수 있나요?
순차 실행으로 시작하고, 동시성을 올리기 전에 측정하세요. HTTP 요청은 브라우저 컨텍스트보다 훨씬 저렴하게 확장되며, 한 머신에서 브라우저를 병렬로 돌리면 대부분 같은 CPU를 두고 경쟁하면서 대상 사이트에는 트래픽이 한꺼번에 몰립니다. HTTP 스크래핑이라면 수십 개보다 딜레이를 두고 동시에 4~8개를 유지하는 편이 더 안전한 출발점입니다.
429 응답을 받으면 어떻게 해야 하나요?
Retry-After 헤더를 읽고 적어도 그만큼 기다린 뒤, 작은 한도까지 지수 백오프로 재시도하고 그 이후에는 분명하게 실패시키세요. 429는 속도 신호이지, 촘촘한 재시도 루프로 밀어붙일 오류가 아닙니다. 이를 무시하면 주소가 차단 목록에 오르게 됩니다.
스크래핑은 합법인가요?
사이트, 데이터, 관할 지역, 그리고 결과를 어떻게 쓰는지에 따라 다릅니다. robots 지시문과 서비스 약관은 사이트가 허용하는 범위를 밝히고, 개인정보와 데이터베이스 권리에 관한 규칙은 국가마다 다릅니다. 이 글은 법률 자문이 아닙니다. 대규모로 수집하기 전에 약관과 적용 법률을 확인하세요.
스크래핑 대신 공식 API를 써야 하는 경우는 언제인가요?
필요한 필드를 포함하는 공식 API가 있다면 언제든 그쪽입니다. 문서화된 API는 안정적인 계약이고, 보통 명시적인 속도 제한이 있으며, 페이지 레이아웃이 바뀌어도 깨지지 않습니다. 스크래핑은 지원되는 접근 경로 없이 브라우저에 공개된 데이터를 위한 폴백이며, 기본값이 아닙니다.
스크래핑에 브라우저 에이전트가 필요한가요?
실제 로그인 상태, 상호작용 후에 나타나는 콘텐츠, 눈에 보이는 실행, 흐름 중간의 사람 인계가 필요한 작업에만 그렇습니다. 콘텐츠를 HTTP로 반환하는 페이지나 공식 API가 있는 사이트에서는 브라우저 에이전트가 역량은 그대로 두고 비용만 더합니다.
정말로 필요한 스크래핑 작업에서 브라우저 에이전트 경로를 시도해 보고 싶다면, ego (lite)는 무료로 내려받을 수 있습니다, 그리고 가격 스크레이퍼와 SERP 스크레이퍼 페이지에서 두 가지 구체적인 작업을 처음부터 끝까지 다룹니다.