
Пагинация в веб-скрапинге это не только переход на следующую страницу. Сложнее понять, остались ли ещё данные и когда список действительно закончился. Большинство сайтов используют один из трёх шаблонов: нумерованные страницы, Load More или бесконечную прокрутку, и каждому нужна своя стратегия навигации, условие ожидания и правило остановки. Ошибётесь, и краулер остановится раньше времени, даже не выбросив ошибку.
Если данные уже лежат в HTML или на JSON-эндпоинте, браузер обычно не нужен: обычный HTTP проще и быстрее. Браузер полезен, когда список зависит от клиентского рендеринга, авторизованной сессии, токенов, которые страница генерирует сама, или настоящей прокрутки. А если эти данные живут в браузере, куда вы уже вошли, ego (lite) позволяет ИИ-агенту прогнать ту же логику пагинации внутри этой готовой сессии, не восстанавливая состояние входа заново.
Ниже мы проверим нумерованные страницы, Load More и бесконечную прокрутку с одним вопросом: список правда закончился или краулер просто перестал просить ещё? Примеры идут на повторяемом локальном стенде: 135 строк на нумерованных страницах, 81 отрисованная строка за Load More и бесконечная лента из 60 элементов. В итоге краулер не только листает, но и записывает, где остановился, обрабатывает дубликаты и пропуски и проверяет, что собранные данные полные.
Как понять, какой у вас режим пагинации
Три наблюдения закрывают классификацию. Смена URL или клик по нумерованной ссылке меняет набор результатов: это нумерованная пагинация. Кнопка, которая обещает ещё контент, дописывает строки, не меняя URL: это load more. Строки, которые появляются при прокрутке без элемента для клика, это бесконечная прокрутка. Если страница смешивает шаблоны, считайте каждый переход отдельным режимом, а не заставляйте один цикл покрывать оба.
Быстрая проверка в браузере закрывает вопрос быстрее, чем чтение кода: откройте DevTools, смотрите панель сети и сделайте одно действие. Навигационный запрос с параметром страницы это нумерованная пагинация. Фоновый JSON или HTML после клика это load more. Запросы, которые повторяются при прокрутке, это бесконечная прокрутка, и в ответе обычно лежит следующий offset, подарок для краулера.
Нумерованные страницы: выведите правило URL и остановитесь вовремя
Нумерованная пагинация самый дружелюбный режим, потому что состояние живёт в URL. Выведите правило по первым трём страницам: какой параметр меняется, это номер страницы или offset, и фиксирован ли размер страницы. Правило должно записываться функцией, и правильная функция получает страницу 4 из страницы 3, не заходя никуда между ними.
// Derive once, then verify against page 2 and page 3 before trusting it.
const pageUrl = (n) => `https://example.com/listings?page=${n}`;

let page = 1;
const rows = [];
while (true) {
  await browserPage.goto(pageUrl(page));
  const batch = await browserPage.locator("tr.row").evaluateAll((nodes) =>
    nodes.map((node) => ({
      id: node.dataset.id,
      title: node.querySelector(".title").textContent.trim(),
      price: Number(node.querySelector(".price").textContent.replace(/[^0-9.]/g, "")),
    })),
  );
  if (batch.length === 0) break;
  rows.push(...batch);

  const hasNext = (await browserPage.locator("a#next").count()) > 0;
  if (!hasNext) break;
  page += 1;
}
Остановке обычно уделяют меньше внимания, чем нужно. Пропавшая ссылка next и пустая пачка оба настоящие сигналы конца; заранее заданное число страниц нет, потому что списки растут, и число, зашитое сегодня, через месяц уже неверно. На стенде краулер прошёл страницы с первой по пятую, собрал 135 строк за 80 milliseconds и остановился, когда ссылка next исчезла. Один из пяти запросов вернул 503 с первой попытки, краулер один раз повторил ту же страницу, и повтор прошёл.
Два правила держат цикл честным. Во-первых, делайте паузу между запросами страниц, а не стреляйте ими на максимальной скорости, и соблюдайте условия сайта и протокол исключения robots, описанный в RFC 9309. Во-вторых, считайте повтор той же страницы сигналом остановки, если список должен быть упорядочен: пагинация, которая игнорирует собственные параметры, иначе может крутиться бесконечно.
«Показать ещё»: клик, ожидание и дедупликация
Load more прячет состояние за кнопкой, поэтому краулер сам должен создавать рост: клик, ждать, пока число строк реально вырастет, забрать новое и повторять, пока кнопка не исчезнет или не перестанет что-либо менять. Именно ожидание ломает большинство реализаций. Фиксированная пауза случайно работает на быстром канале и молча обрезает список на медленном.
await browserPage.goto("https://example.com/listings");

while (true) {
  const button = browserPage.locator("#load-more");
  if ((await button.count()) === 0) break;

  const before = await browserPage.locator("tr.row").count();
  await button.click();
  await browserPage.waitForFunction(
    (n) => document.querySelectorAll("tr.row").length > n,
    before,
    { timeout: 10000 },
  );
}

const rows = await browserPage.locator("tr.row").evaluateAll((nodes) =>
  nodes.map((node) => ({ id: node.dataset.id, title: node.textContent.trim() })),
);
На стенде четыре пачки по двадцать строк пришли за 273 milliseconds, а видимый список держал 81 строку при наборе из 80. Лишняя строка это дубликат, который стенд специально сажает, чтобы показать обычную реальность: одна и та же запись приходит дважды в разных пачках. Строка статуса самой страницы гласила "Loaded 81 of 80", хорошее напоминание, что счётчик, который рисует сайт, не источник проверки. Дедуплицируйте по стабильному идентификатору вроде record id строки, а не по видимому заголовку, и вы уберёте ровно один дубликат.
Бесконечная прокрутка: триггеры, стабильность высоты и правила остановки
У бесконечной прокрутки нет ни кнопки, ни URL, поэтому и триггер, и условие остановки приходится выводить. Триггер обычно это сторожевой элемент, входящий во viewport, или порог позиции прокрутки. Условие остановки требует суждения, потому что список не объявляет конец так, чтобы по нему можно было кликнуть.
Один измеренный сбой стоит показать, потому что именно с ним большинство краулеров выходит в продакшен. Прокрутить вниз один раз и сразу проверить, выросло ли число строк, не дожидаясь отрисовки следующей пачки, сразу даёт "no growth": стенд остановился на 15 of 60 строк, после одной пачки, хотя сеть уже запросила следующую. Проверка не ошиблась в моменте; ошибкой было принять одну тихую секунду за конец списка.
Надёжный вариант ждёт наблюдаемое условие и подтверждает конец несколькими проверками, а не одной. Прокрутите, ждите роста числа элементов или сообщения страницы, что лента закончилась, и только если ни того ни другого нет три проверки подряд, считайте список завершённым. На стенде те же 60 элементов закрылись за четыре круга прокрутки без ложных остановок, а финальная строка статуса гласила "End of feed (60 of 60)".
let stableChecks = 0;
while (stableChecks < 3) {
  const items = await browserPage.locator("article.post").count();
  await browserPage.evaluate(() => window.scrollTo(0, document.body.scrollHeight));

  const grew = await browserPage
    .waitForFunction(
      (n) =>
        document.querySelectorAll("article.post").length > n ||
        /end of feed/i.test(document.body.innerText),
      items,
      { timeout: 3000 },
    )
    .then(() => true)
    .catch(() => false);

  stableChecks = grew ? 0 : stableChecks + 1;
  if (!grew) await browserPage.waitForTimeout(700);
}
Две детали отделяют стабильный цикл от капризного. Стабильность высоты надо судить по числу извлечённых элементов, а не по высоте документа: ленивые картинки и реклама меняют высоту, не добавляя записей. И прокрутка должна реально снова запускать загрузчик сайта: реализации на Intersection Observer API срабатывают на изменении пересечения, поэтому чередовать позиции прокрутки надёжнее, чем держать страницу у нижнего края.
Сохраняйте состояние обхода и продолжайте после сбоя
У всех трёх режимов одно требование: прогон должен переживать собственный обрыв. Пишите checkpoint после каждой завершённой пачки: режим, позицию и уже собранные записи, и сделайте продолжение обычным путём, а не особым. На стенде нумерованный обход убили после второй страницы, в checkpoint лежали 54 строки. Новый процесс прочитал checkpoint, продолжил с третьей страницы и закончил теми же 135 строками и 133 уникальными id, что и непрерывный прогон.
import { readFileSync, writeFileSync } from "node:fs";

const CHECKPOINT = "./crawl-state.json";
const save = (state) => writeFileSync(CHECKPOINT, JSON.stringify(state));
const load = () => {
  try {
    return JSON.parse(readFileSync(CHECKPOINT, "utf8"));
  } catch {
    return { mode: "numbered", lastPage: 0, rows: [] };
  }
};

const state = load();
for (let page = state.lastPage + 1; page <= 5; page += 1) {
  state.rows.push(...(await crawlPage(page)));
  state.lastPage = page;
  save(state); // checkpoint after every page
}
Checkpoint ещё и меняет отладку. Если обход дал неверный счёт, можно смотреть файл состояния вместо полного перезапуска, и записанная там позиция скажет, какую пачку запросить снова.
Дубликаты, пропущенные строки и ложные последние страницы
Три симптома покрывают большую часть багов пагинации, и у каждого подпись в данных, а не в коде. Дубликаты появляются, когда пачка пересекается с соседней: исходный список пересортировался между запросами, и стабильный идентификатор повторяется. Стенд воспроизвёл это точно: тот же id был на второй странице, снова на третьей и ещё внутри пятой. Оба дубликата исчезли после дедупа по id.
Пропущенные строки обычно значат слишком короткое ожидание или пропущенную страницу. Если итого не хватает ровно на одну пачку, смотрите действие перед недостачей; если не хватает страницы, смотрите инкремент цикла. Переходящий 503 на стенде это другой вкус того же бага: без повтора третья страница не дала бы ничего, и прогон отрапортовал бы 106 строк вообще без ошибки.
Ложная последняя страница опаснее всего: обход рапортует успех с меньшим объёмом данных. Так бывает, когда страница возвращает ноль строк из-за сессии или рендеринга, а не потому что список кончился, и цикл считает оба случая одинаково. Различайте их повторным зондом: запросите следующую страницу ещё раз после короткой паузы и требуйте либо настоящий маркер конца, либо два пустых ответа подряд, прежде чем принять конец.
Проверяйте счётчики и полноту полей
Проверка это два контроля, которые занимают секунды и ловят большую часть тихих сбоев. Проверка количества сравнивает собранное с каждым независимым числом, какое найдёте: собственную надпись "page 5 of 5" последней нумерованной страницы, итог в шапке или сумму постраничных счётчиков по пути. Проверка полей подтверждает, что у каждой записи есть обещанные поля, и считает исключения вместо того, чтобы их игнорировать.
const unique = new Map(rows.map((row) => [row.id, row]));
const missing = rows.filter((row) => !row.title || !Number.isFinite(row.price));

console.log({
  raw: rows.length,
  unique: unique.size,
  removedDuplicates: rows.length - unique.size,
  missingFields: missing.length,
});
По 135 нумерованным строкам стенда проверка показала ноль отсутствующих полей, два снятых дубликата и 133 уникальные записи, в точности совпав с набором. По списку load more она показала один дубликат из 81. Само по себе ни одно число не интересно; важно, что изменение любого из них видно сразу, а не всплывает потом в отчёте с загадочной дырой.
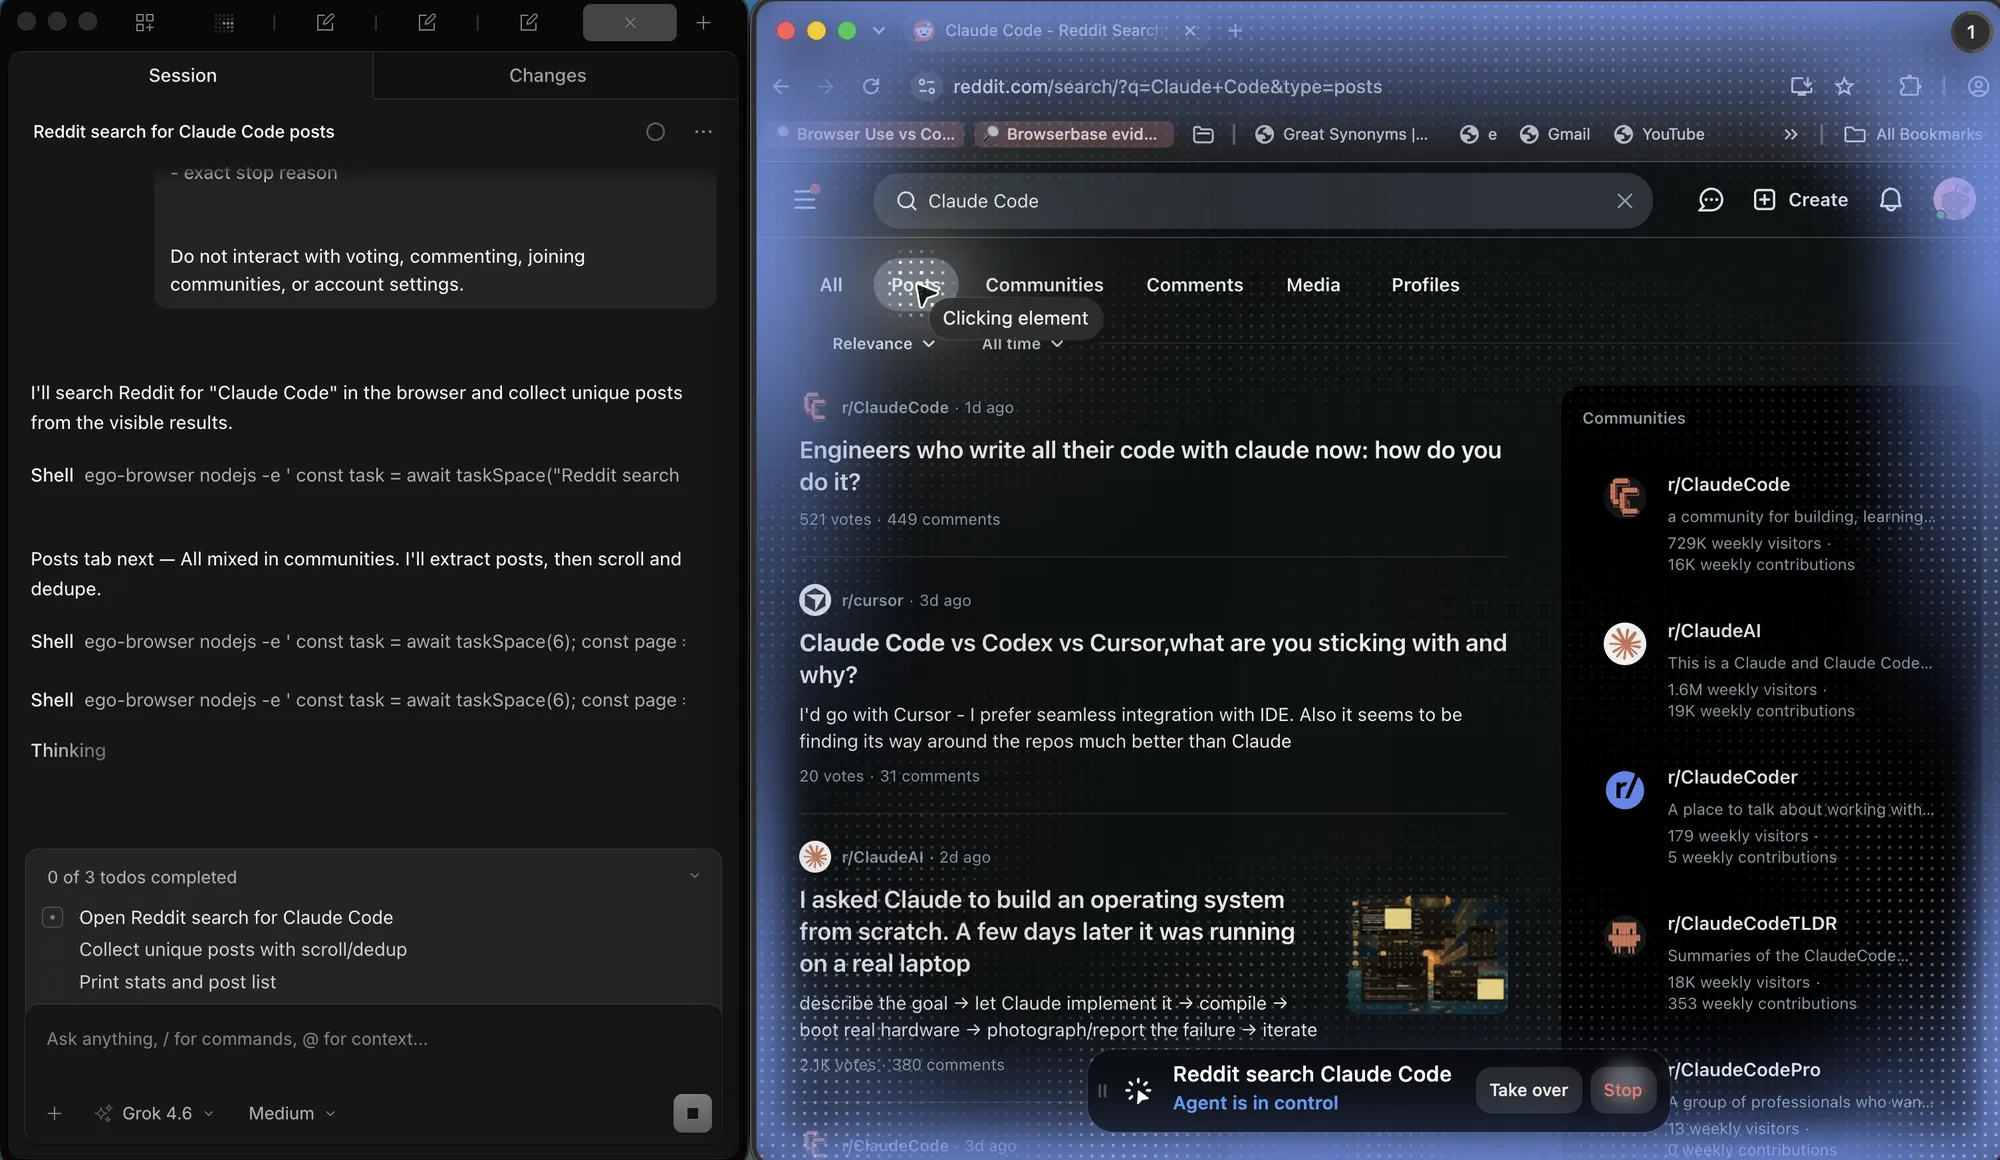
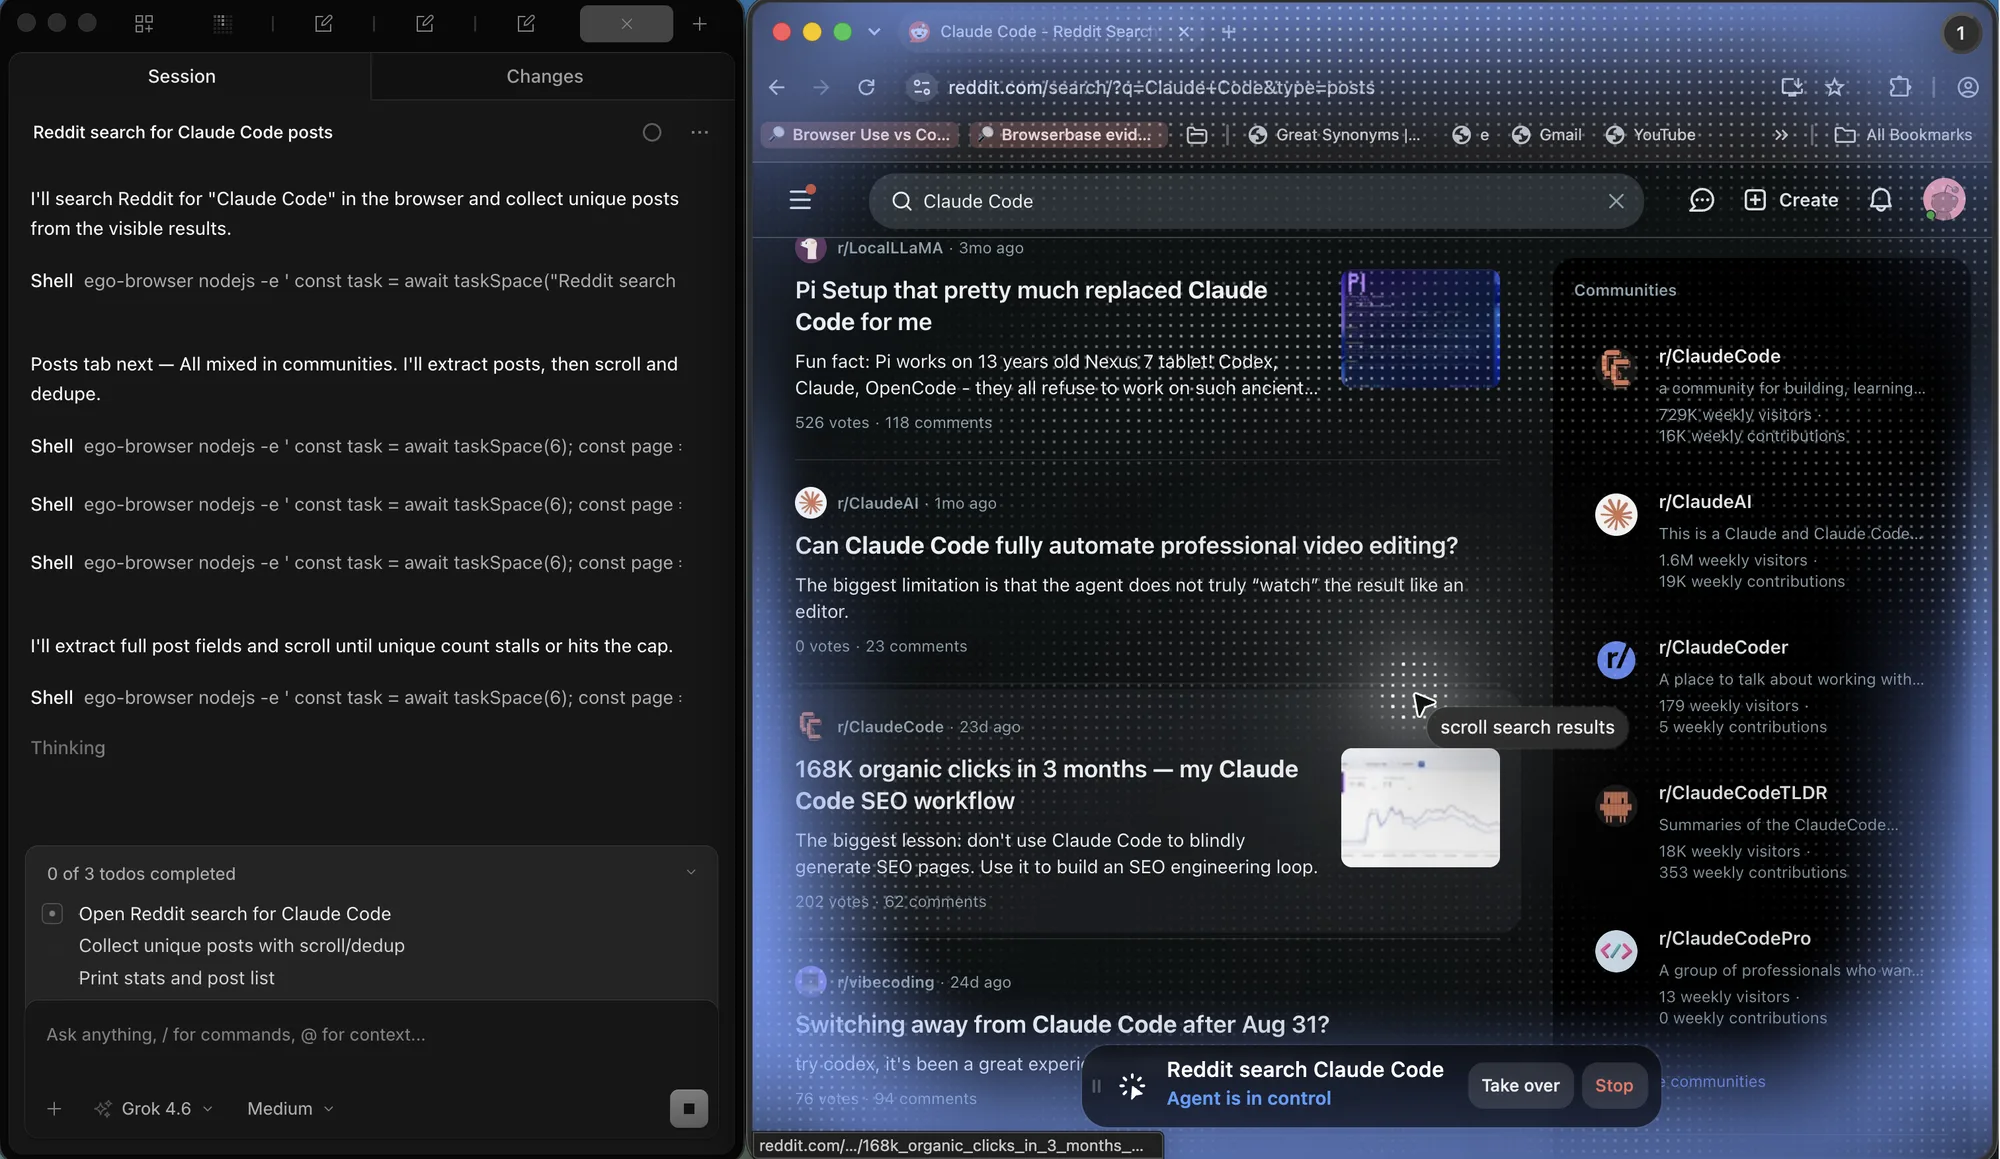
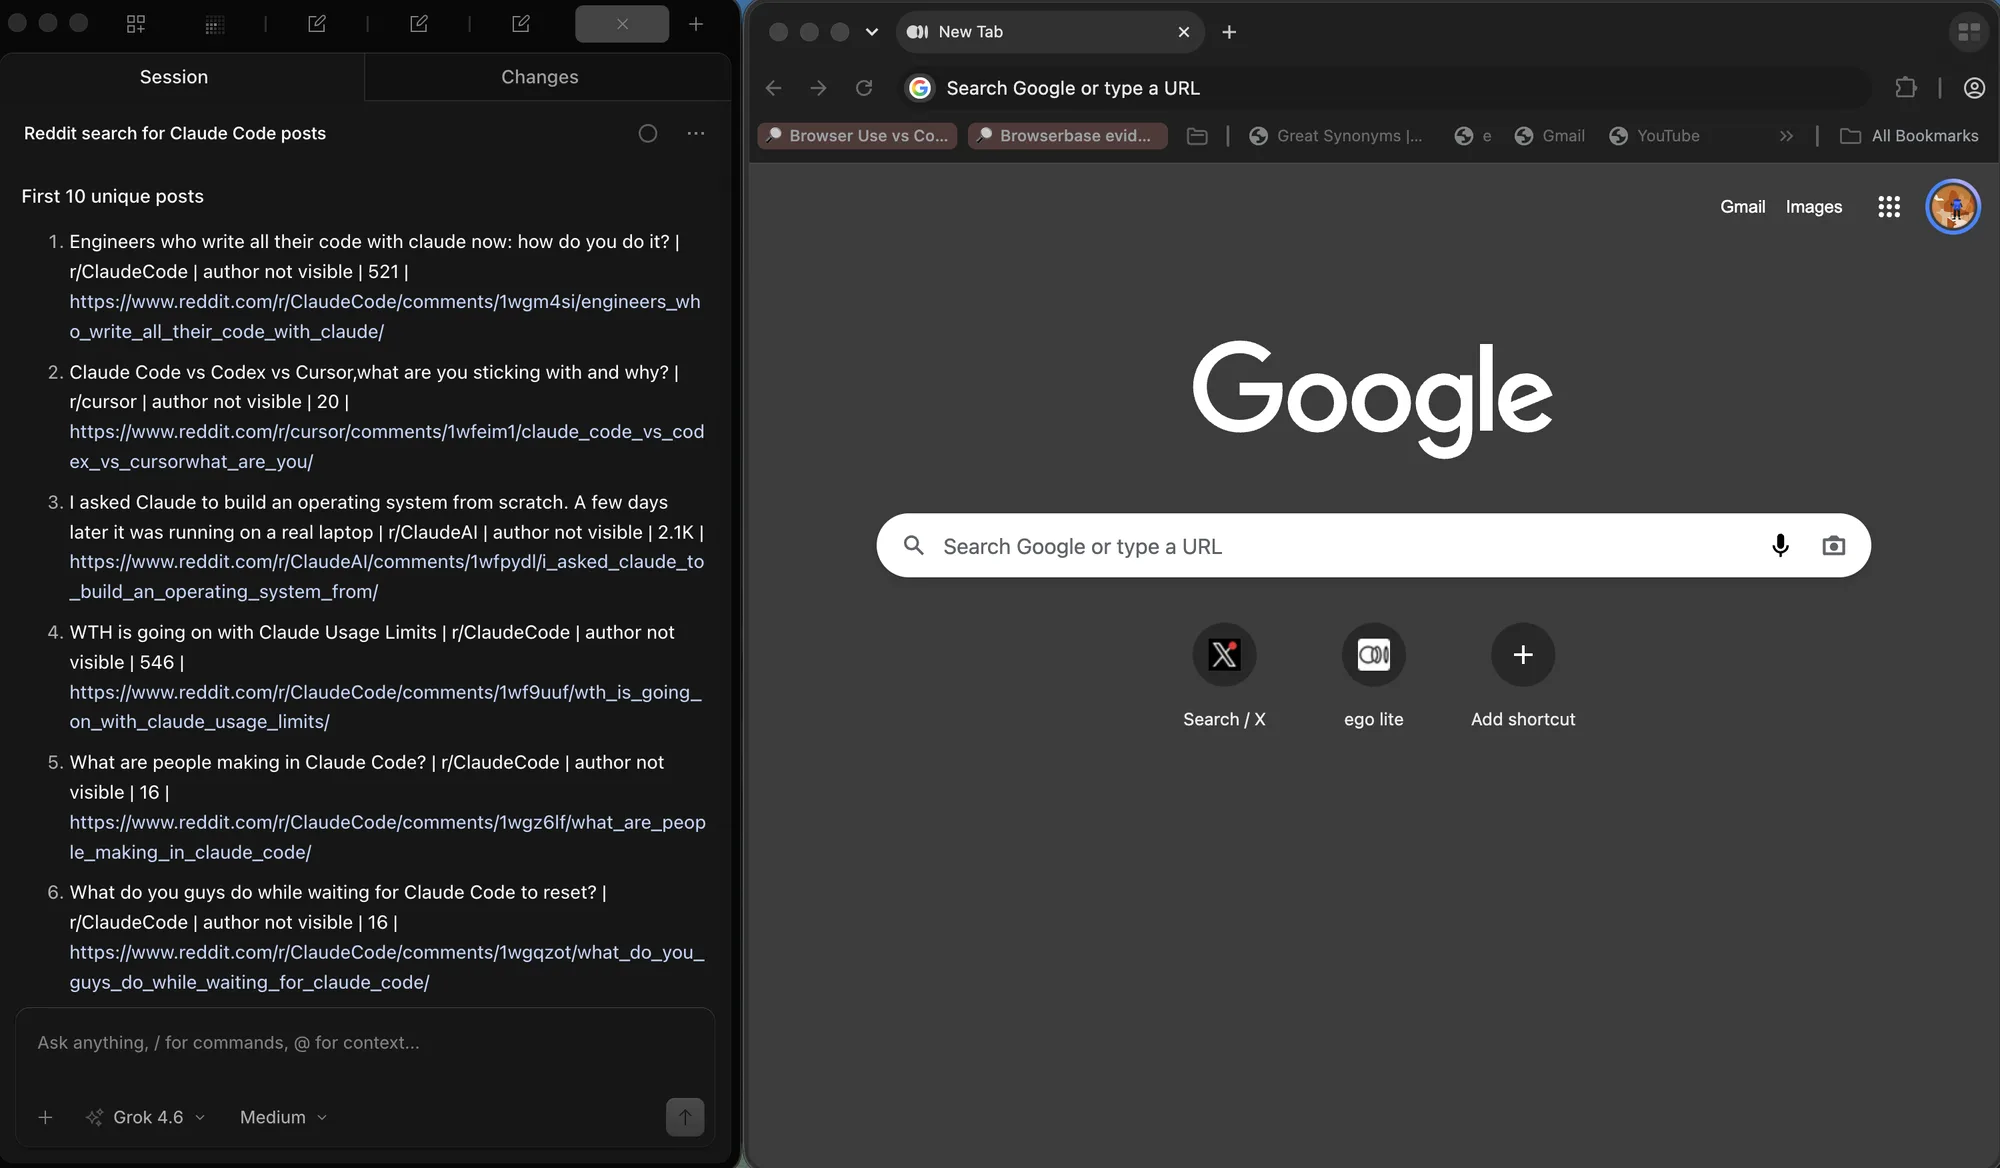
Запуск Reddit применил ту же проверку к живому уникальному списку, а не к фикстуре на 135 строк. В каждой строке нужны были заголовок, subreddit, число голосов и URL. После прокрутки проверяют нумерованный вывод.
Когда обычного HTTP достаточно, а когда нет
Те же данные стенда доступны без браузера, и измерить оба пути это честный способ решить, что нужно задаче. Обычный HTTP-клиент прошёл нумерованные страницы по URL, забрал пачки load more с их JSON-эндпоинта и вытянул бесконечную ленту по offset, собрав все 135, 81 и 60 строк суммарно за 24 milliseconds. Без рендеринга, без ожиданий, без прокрутки.
Это рекомендация по умолчанию, и её стоит сказать прямо: если есть официальный API, используйте его. Если нумерованный список отдаёт сервер, запрашивайте страницы напрямую. Если за load more или бесконечным режимом стоит JSON-эндпоинт без подписи, запрашивайте этот эндпоинт и листайте по offset. Фреймворк вроде Playwright для этого не нужен, а HTTP-путь быстрее и дешевле в запуске. Разбор пагинации Apify, документация селекторов пагинации Web Scraper, и сценарий панели сети в руководстве по сети Playwright закрывают ту же тему с разных точек входа.
Браузер оправдан, когда данные появляются только после клиентского рендеринга, когда запросы несут подпись или токен, который страница генерирует сама, когда список требует входа, или когда эндпоинт отвечает иначе без настоящей сессии и настоящего user agent. Тогда браузер это не предпочтение скрапинга, а единственный честный путь, и предыдущие разделы применяются без изменений.
ego (lite) подключается только после того, как этот HTTP-путь не сработал. Если списку нужна cookie входа, токен со страницы или прокрутка, которая не случается без настоящего viewport, запускайте тот же цикл numbered / load-more / infinite внутри браузера, который уже держит сессию. Не начинайте с этого. Стенд уже показал более дешёвый ответ: 135, 81 и 60 строк обычным HTTP за 24 ms.
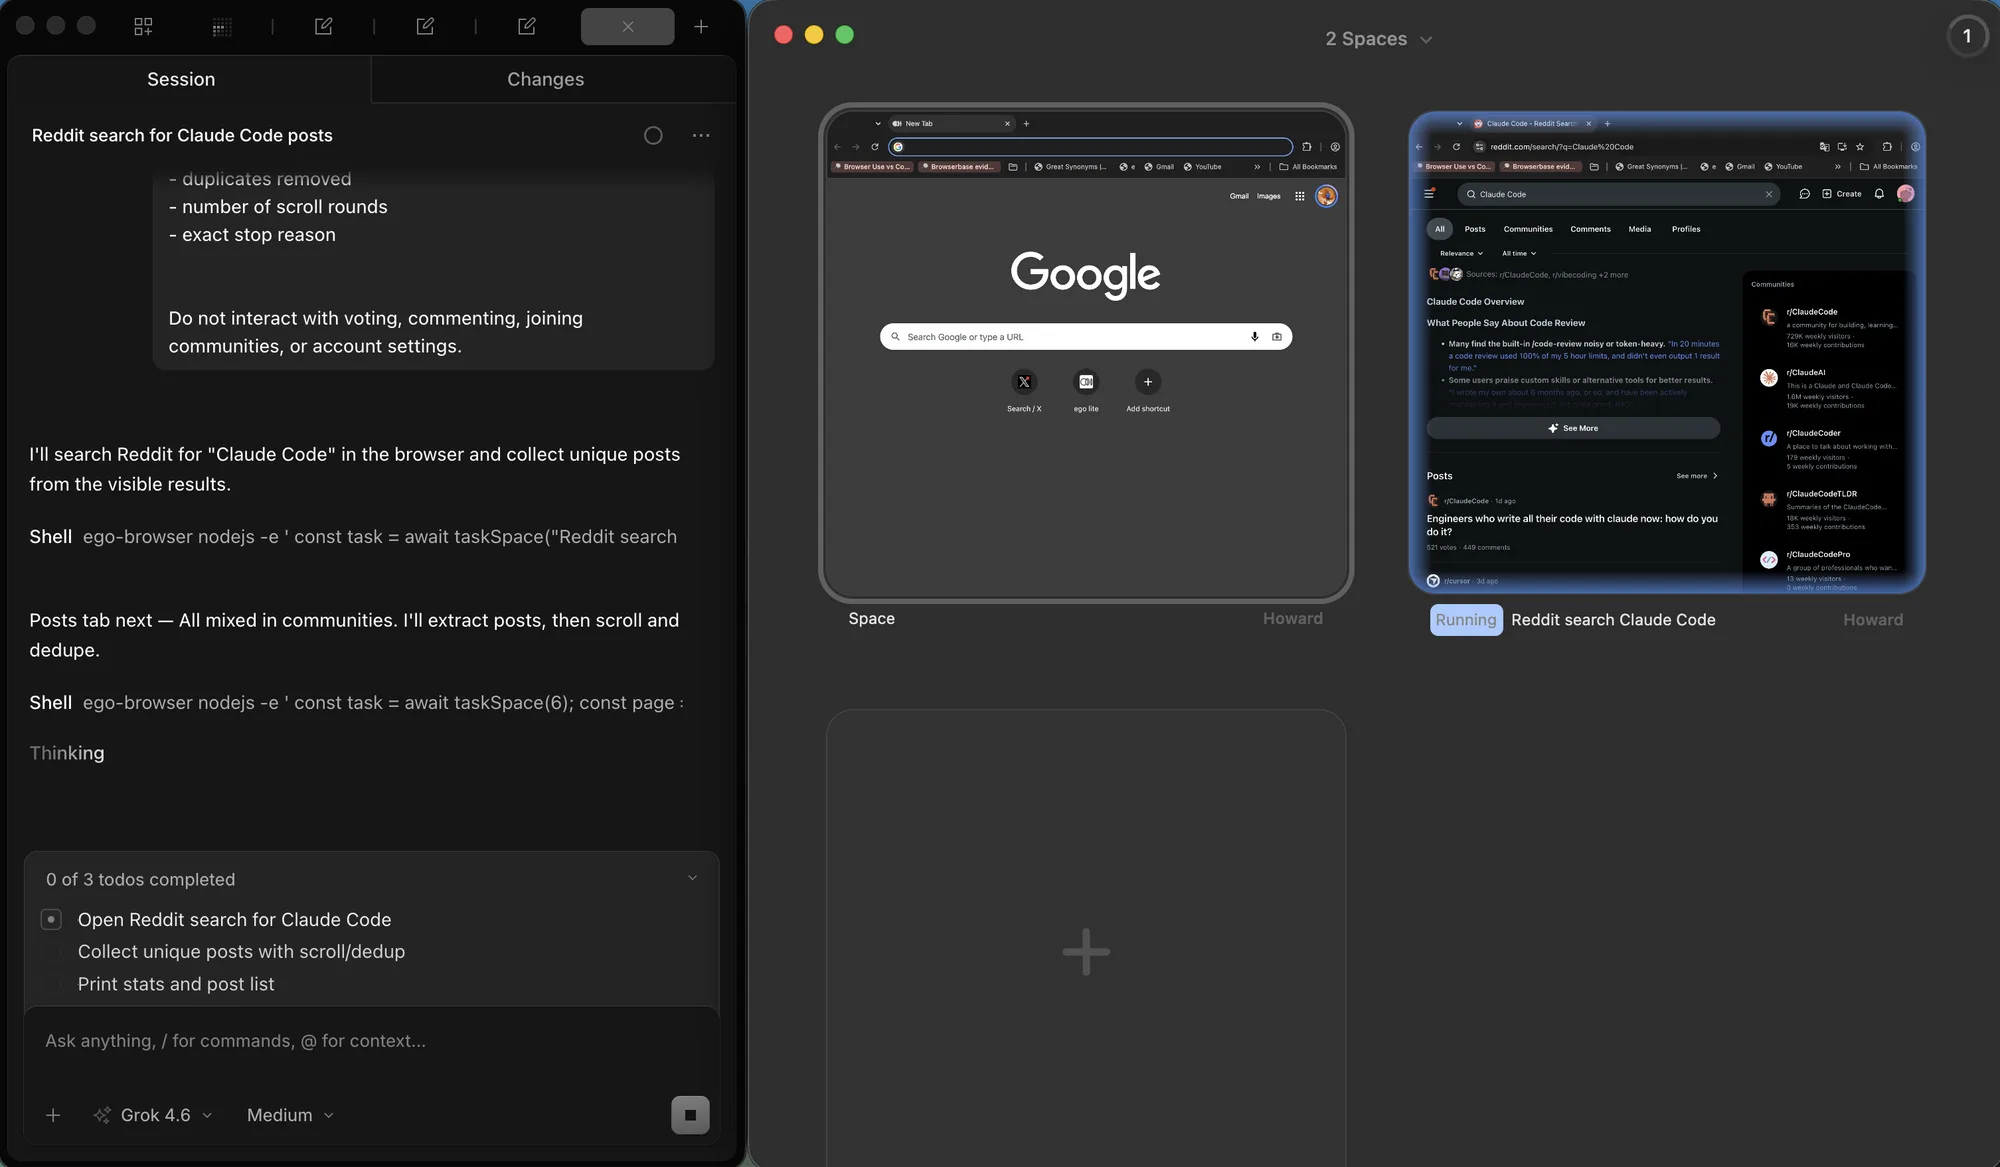
Когда браузер всё же нужен, оставьте логику обхода из предыдущих разделов. ego (lite) даёт страницу с уже выполненным входом и Space, за которым можно наблюдать; новый алгоритм пагинации он не придумывает. Если шаг требует человека, остановитесь. Если curl или официальный API уже возвращают строки, оставайтесь на HTTP.
Правило изоляции нумерованных страниц всё ещё действует. Два краулера в одном окне спорят за позицию прокрутки и затирают последнюю увиденную строку. В том же браузере два Space равны двум контекстам Playwright: один может простаивать на Google, второй продолжает крутить Reddit. Смысл в изоляции. Обзор лишь показывает оба сразу.
Версия 0.5.0.32 записана в changelog (2026-09-12). Снова проверьте эту страницу, быстрый старт, и репозиторий на GitHub перед тем как цитировать более новую сборку. Соседнее руководство Веб-скрапинг на JavaScript разбирает выбор между статикой и рендерингом с другой стороны.
FAQ
Как узнать, сколько страниц у нумерованного списка?
Число страниц нумерованного списка узнаёте по элементу последней страницы, делением итога в шапке на размер страницы и одним проходом до конца. Считайте эту оценку проверкой, а не условием остановки цикла.
Почему скрапер собирает дубликаты между страницами?
Скраперы собирают дубликаты между страницами, когда исходный список пересортировывается и запись переезжает из одной пачки в следующую. Дедуплицируйте по стабильному record id, не по видимому заголовку, и логируйте, сколько дубликатов сняли.
Сколько ждать после клика по load more?
Пока не станет истинным наблюдаемое условие: выросло число строк, снялось состояние disabled у кнопки или появилась известная строка из следующей пачки. Фиксированная задержка это догадка, которая работает, пока сеть быстрая, и ломается именно когда сеть медленная.
Как определить конец бесконечной ленты?
Предпочитайте явный сигнал, если сайт его даёт: отрисованное сообщение о конце или флаг has-more в ответе. Без того и другого требуйте несколько проверок подряд без новых элементов и без изменения высоты загруженного контента, а не одну тихую секунду.
Нужен ли headless-браузер для скрапинга с пагинацией?
Только когда данным нужен рендеринг, сессия или токены на странице. Списки с серверным рендерингом и JSON-эндпоинты лучше забирать обычным HTTP: это быстрее и проще. Измерьте оба пути один раз; сравнение обычно делает выбор очевидным.
Почему пагинированный обход останавливается раньше времени?
Три обычных виновника: ожидание, которое кончилось до отрисовки пачки, переходная ошибка, принятая за пустую страницу, и сессия, которая истекла посреди прогона, так что следующая страница нарисовала форму входа вместо строк. У каждого свой ремонт, поэтому причину остановки нужно писать рядом со счётчиком.
Как продолжить обход после сбоя?
Делайте checkpoint после каждой завершённой пачки: режим, позиция и уже собранные строки. Продолжение читает этот файл и снова входит в режим на записанной позиции. Один раз запросите пачку непосредственно перед позицией checkpoint, чтобы убедиться, что источник не сдвинулся под сохранённым состоянием.
Как проверить, что обход завершён полностью?
Сравните число уникальных записей хотя бы с двумя независимыми числами, например с собственным итогом последней страницы и суммой постраничных счётчиков, затем проверьте полноту полей на каждой строке и сообщите исключения. Совпадающий счётчик и все заполненные поля это сильный сигнал; любой из них по отдельности слаб.
Нужно ли медленно прокручивать, чтобы сработал lazy loading?
Обычно нет, но загрузчик нужно запускать снова, а не парковаться у нижнего края. Сайты используют intersection observers, которые срабатывают на изменении, поэтому чередовать позицию или крутить шагами надёжнее, чем один большой прыжок, и проверка роста становится осмысленной.
Можно ли скрапить пагинированный список за логином?
Да, с настоящей сессией и теми же правилами: листайте вежливо, держите сессию живой и считайте редирект на страницу входа проблемой сессии, а не концом списка. Браузер, который уже несёт ваш вход, например ego (lite), полностью убирает шаг восстановления сессии. руководство по постоянной сессии разбирает работу с состоянием, а сценарий скрапинга цен показывает, как выглядит полный сбор уже после входа.
