

Веб-скрейпинг на JavaScript часто терпит неудачу не из-за ошибки в коде, а из-за неверно выбранного маршрута доступа. Если данные уже есть в исходном HTML, достаточно fetch в Node.js и парсера HTML. Браузер становится нужен только тогда, когда странице необходимо выполнить JavaScript, перелистнуть страницу, кликнуть или как-то иначе взаимодействовать, прежде чем появятся данные, и именно это — граница между статическим HTML и страницами с рендерингом.
Playwright хорошо подходит для сценариев, которые известны заранее и часто повторяются: открыть страницу, дождаться элемента, нажать на элемент управления, извлечь поля и снова пройти тот же путь. Проблемы начинаются, когда меняется структура страницы, пагинация или сценарий взаимодействия и жёсткая последовательность селекторов и действий начинает ломаться.
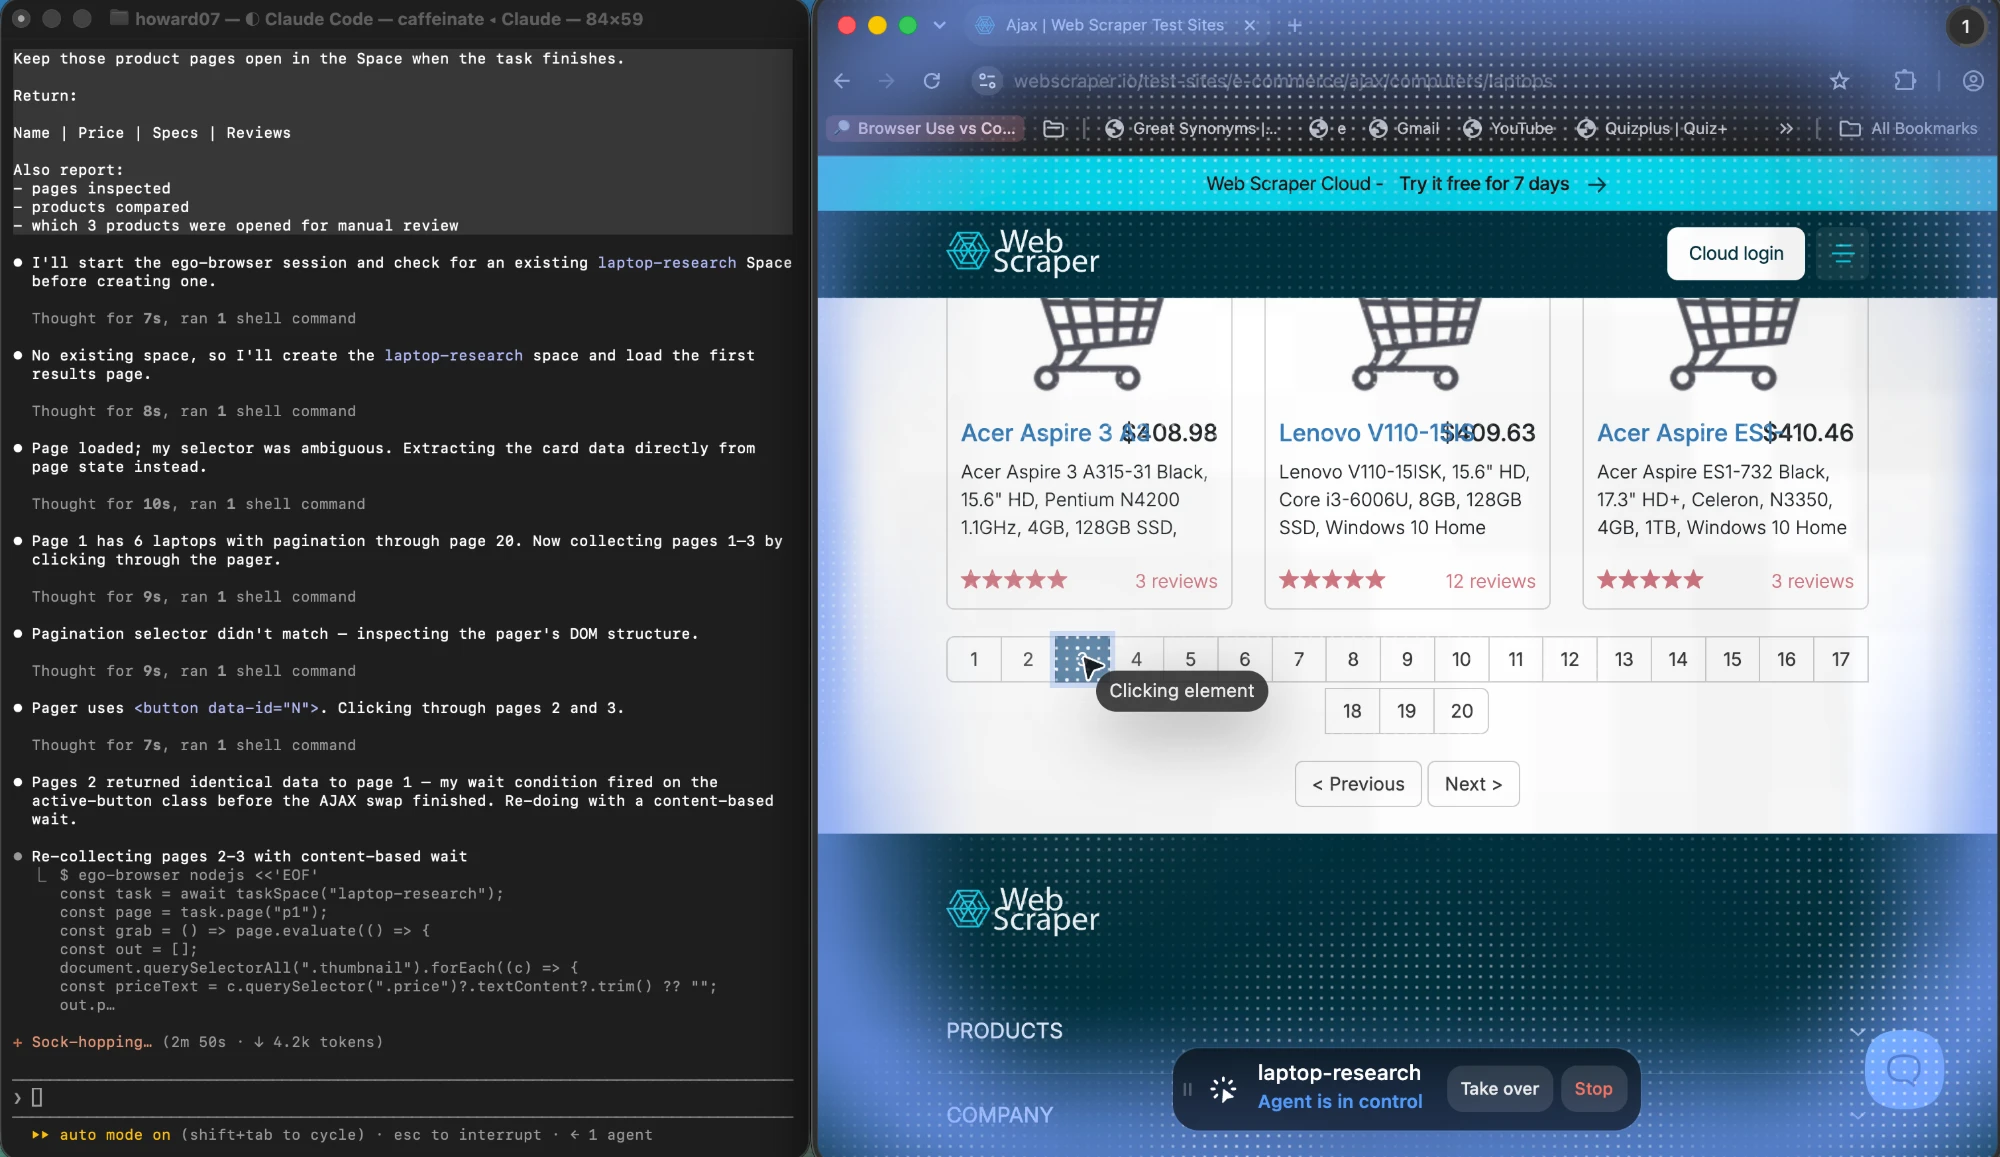
Именно здесь лучше подходит браузер, управляемый агентом, например ego (lite). Вместо того чтобы предполагать, что прежний путь всё ещё существует, агент может осмотреть текущую отрисованную страницу, решить, что делать дальше, и надёжно продолжать выполнение после навигации или динамических изменений.
Что на самом деле определяет, работает ли скрейпер на JavaScript?
Результат определяет маршрут доступа. Один и тот же целевой сайт может легко скрейпиться по HTTP и быть полностью непрозрачным для HTTP — в зависимости от того, приходят данные в исходном HTML-ответе или подгружаются и отрисовываются позже с помощью JavaScript, выполняемого в браузере.
Так что первая задача — не написать скрейпер. А открыть целевую страницу, посмотреть исходный код, а не отрисованный DOM, и выяснить, где на самом деле находятся нужные значения. Всё остальное в этом руководстве вытекает из этого ответа.
Какой из трёх маршрутов доступа нужен вашему целевому сайту?
Три маршрута покрывают почти любую задачу скрейпинга, и они упорядочены по стоимости. Статический HTML — самый дешёвый и быстрый. JSON-эндпоинт, который страница уже вызывает, часто даёт самые чистые данные. Настоящий браузер — самый мощный и самый дорогой по процессорному времени, памяти и хрупкости.
| Маршрут | Что он умеет | Что он не умеет |
|---|---|---|
| HTTP-запрос + парсер HTML | Запрашивает любой URL напрямую, читает тело ответа и делает выборку по полученной разметке. Обрабатывает тысячи страниц в минуту на процесс и не требует бинарного файла браузера. | Выполнять скрипты страницы, кликать, прокручивать и заполнять формы. На странице с клиентским рендерингом он возвращает пустую оболочку, потому что данных в ответе никогда не было. |
| Прямой JSON-эндпоинт | Возвращает структурированные данные без разбора разметки, поэтому имена полей переживают редизайн вёрстки страницы. Самый маленький объём и самый быстрый разбор. | Оставаться стабильным при обновлениях сайта. Такие эндпоинты внутренние, недокументированные и могут измениться или начать отклонять запросы без предупреждения. |
| Автоматизация настоящего браузера | Выполняет JavaScript страницы, ждёт появления контента и взаимодействует с отрисованным результатом точно так же, как это делал бы человек. | Дешёво масштабироваться. Каждый контекст браузера расходует реальную память, а их парк требует больше инфраструктуры, чем цикл HTTP-запросов. |
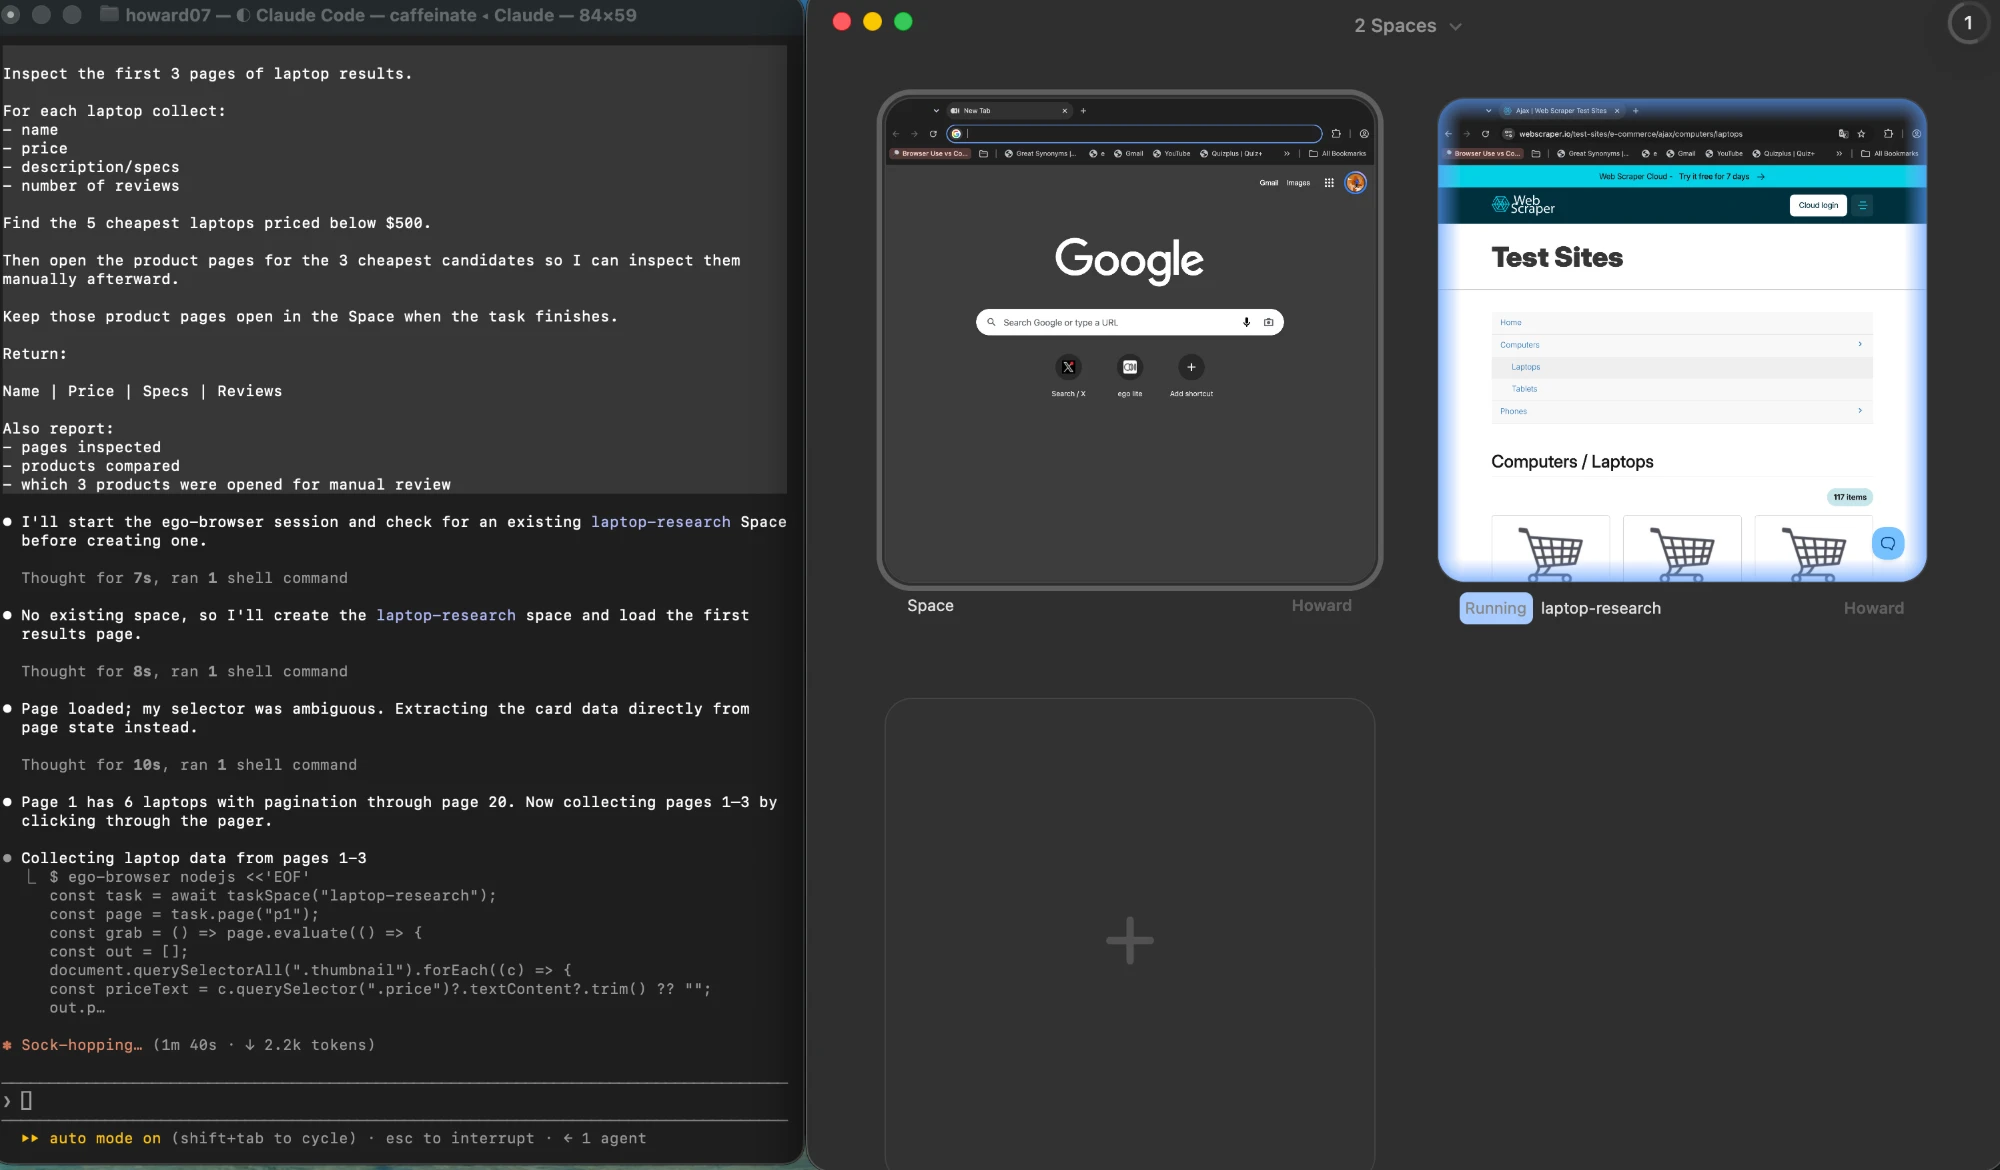
Как получить и разобрать статический HTML в Node.js?
Начните с платформы. В Node.js Fetch API доступен как глобальный объект, поэтому для запроса вообще не нужны зависимости. Шаблон ниже — это весь первый маршрут: запрос, проверка статуса, чтение текста и передача разметки парсеру.
Сам запрос не требует ничего, кроме платформы, потому что Fetch API входит в Node.js как глобальный объект, так что обычному GET не нужна HTTP-библиотека.
Проверку статуса убирают первой и потом больше всего о ней жалеют. Страница 404 или страница блокировки ботов всё равно возвращает тело, и это тело прекрасно разбирается в ноль совпадающих элементов, что выглядит в точности как ошибка селектора.
const res = await fetch(url, {
  headers: { "user-agent": "my-scraper/1.0 (+contact@example.com)" },
});

if (!res.ok) {
  throw new Error(`${res.status} ${res.statusText} for ${url}`);
}

const html = await res.text();
Ограничение частоты должно быть в том же цикле, а не прикручено потом. Одна ожидаемая задержка между запросами делает небольшую задачу вежливой и не даёт вашему адресу попасть в чёрный список:
const sleep = (ms) => new Promise((r) => setTimeout(r, ms));

for (const url of urls) {
  const html = await getHtml(url);
  await parse(html);
  await sleep(1000);
}
Вот что на самом деле возвращает первый маршрут. Таблица ниже — реальный результат обычного HTTP-запроса и библиотеки селекторов по публичному тестовому каталогу ноутбуков: без браузера, без этапа рендеринга, три страницы получены как три статических ответа.
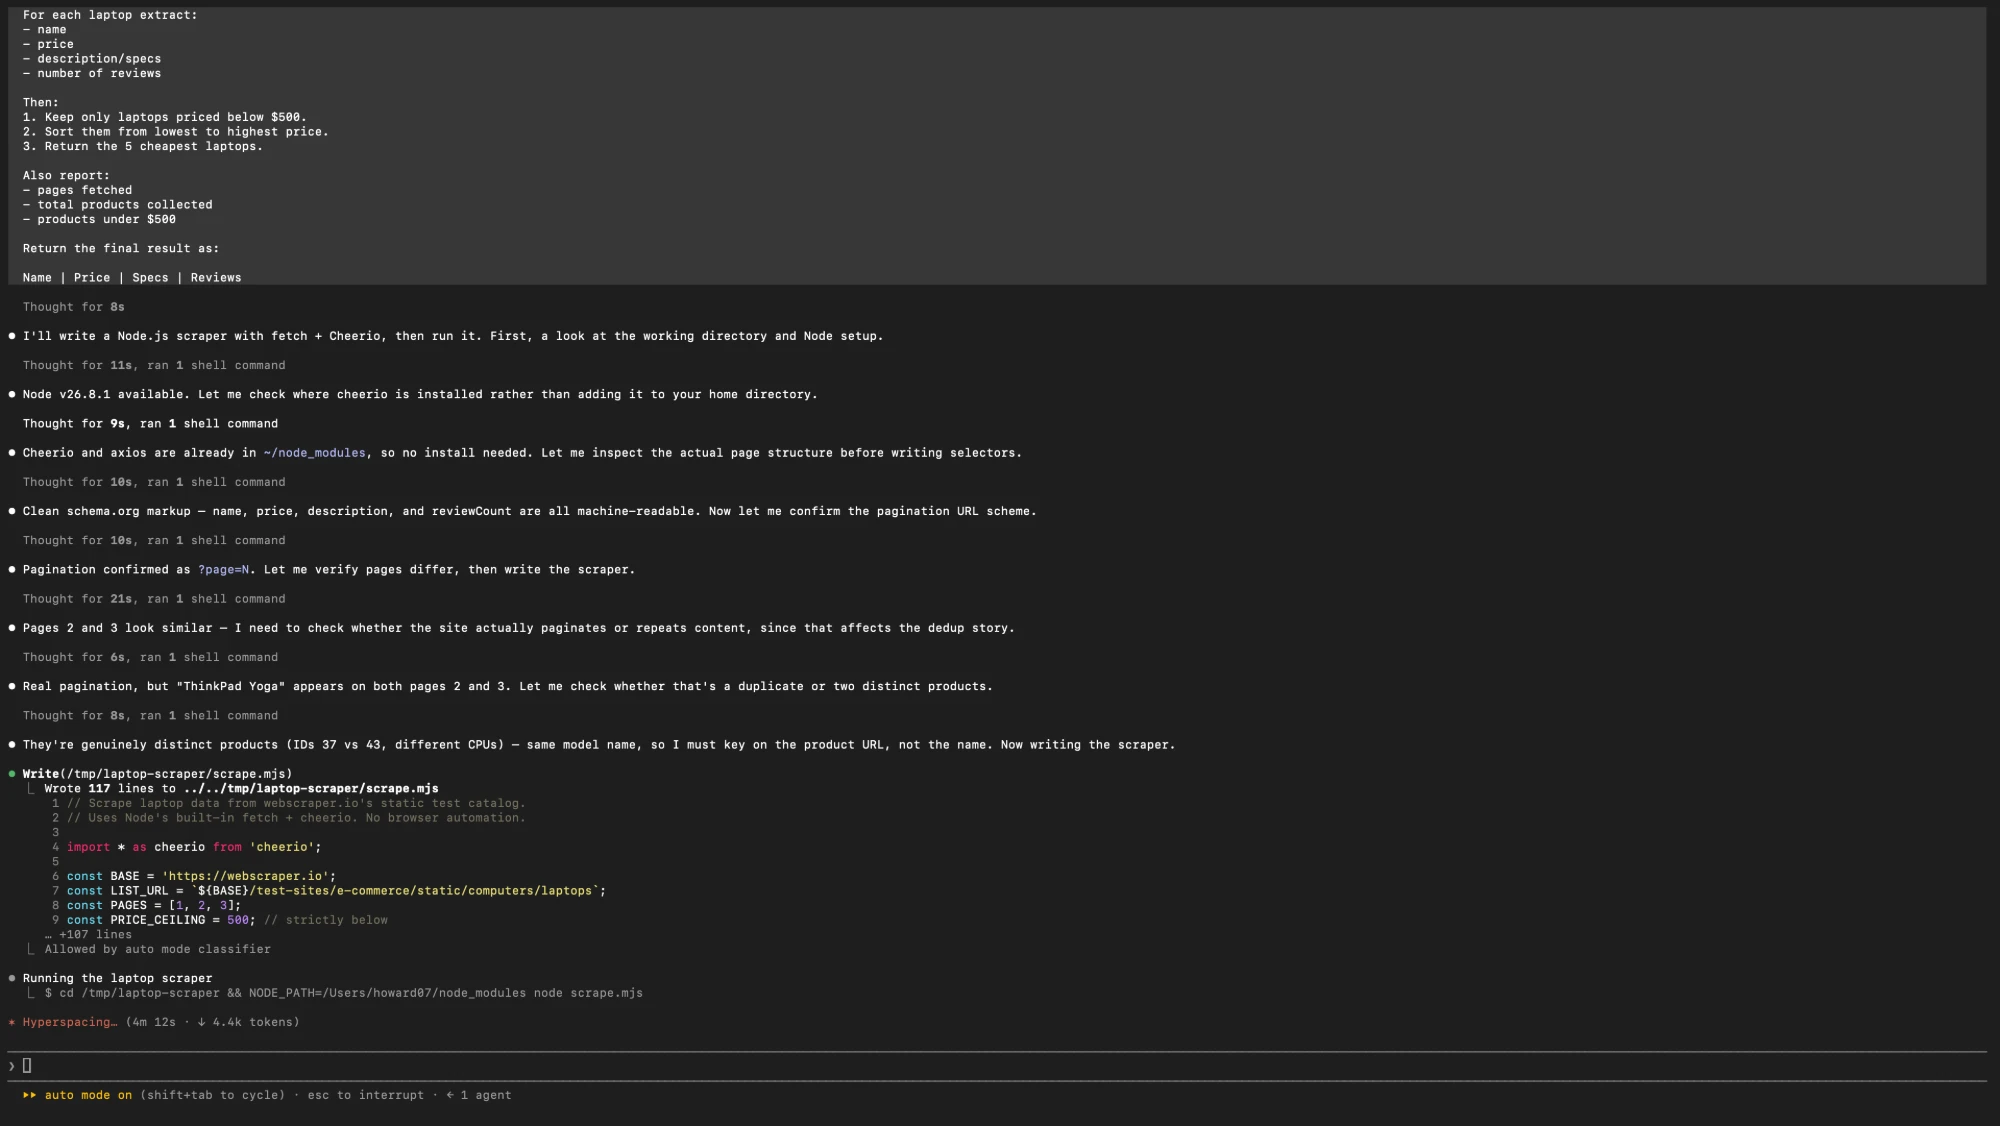
| ID | Название | Цена | Характеристики | Отзывы |
|---|---|---|---|---|
| 32 | Aspire E1-510 | $306.99 | 15.6", Pentium N3520 2.16GHz, 4GB, 500GB, Linux | 2 |
| 45 | Asus VivoBook Max | $399 | 15.6" HD, Pentium N4200 1.1GHz, 4GB, 500GB, Windows 10 Home | 4 |
| 31 | Packard 255 G2 | $416.99 | 15.6", AMD E2-3800 1.3GHz, 4GB, 500GB, Windows 8.1 | 2 |
| 46 | Dell Vostro 15 | $488.78 | 15.6" FHD, Core i5-7200U, 4GB, 128GB SSD, Radeon R5 M420 2GB, Linux | 14 |
Четыре товара из восемнадцати стоят меньше $500. Это весь результат первого маршрута по этому каталогу: три запроса, без рендеринга, без процесса браузера. И именно здесь начинается честная часть, потому что в этой таблице не хватает того, что читатель ожидал бы увидеть.
Cheerio, DOMParser или jsdom: какой парсер выбрать?
Эти три инструмента сравнивают так, будто это взаимозаменяемые библиотеки. Это не так, потому что они дают разные обещания: два из них разбирают разметку для выборки, а один реализует DOM с выполнением скриптов.
Парсер, на который опирается это руководство, описан на cheerio.js.org, где прямо сказано, что Cheerio разбирает и выбирает разметку, а не выполняет скрипты страницы.
| Вариант | Что он умеет | Что он не умеет |
|---|---|---|
| Cheerio | Быстро разбирает строку HTML и делает выборку селекторами в стиле jQuery. Небольшая зависимость, без браузера, идеально для нескольких сотен полей из тела ответа. | Выполнять скрипты страницы, рендерить компоненты или вычислять вёрстку. Он разбирает разметку, но не ведёт себя как браузер. |
| jsdom | Даёт реализацию DOM в Node.js с document, window и выполнением скриптов, поэтому код, написанный под браузерные API, работает без изменений. | Сравниться с настоящим браузером по рендерингу или точности, и он гораздо тяжелее на каждую страницу. Это замена DOM, а не Chrome. |
| DOMParser | Превращает строку в документ, по которому можно делать выборку, с помощью встроенного браузерного API, вообще не добавляя зависимостей в проект. | Быть ожидаемым: он синхронный и блокирующий, а в Node.js стал глобальным только в последних версиях. |
Чтение из Cheerio использует знакомый API селекторов. Обратите внимание, что извлечённый текст обрезается по краям, потому что в разметке есть отступы и переводы строк, которые иначе попадут в ваш набор данных:
import * as cheerio from "cheerio";

const $ = cheerio.load(html);
const items = $(".product-card").map((i, el) => ({
  name: $(el).find(".name").text().trim(),
  price: $(el).find(".price").text().trim(),
})).get();
То же извлечение через DOMParser выглядит так, и оно работает только там, где этот глобальный объект существует:
const doc = new DOMParser().parseFromString(html, "text/html");
const rows = [...doc.querySelectorAll("table tbody tr")].map((tr) => ({
  cells: [...tr.querySelectorAll("td")].map((td) => td.textContent.trim()),
}));
Как найти JSON-эндпоинт, который страница уже использует?
Прежде чем писать хоть один селектор, откройте панель сети в браузере, отфильтруйте по fetch и XHR, перезагрузите страницу и посмотрите, что вернулось. Многие сайты, работающие с данными, собирают видимую страницу из небольшого числа JSON-ответов, которые гораздо проще использовать, чем разметку.
Когда вы его найдёте, запросу обычно нужны те же заголовки, что отправляла страница, а иногда и сессионный Cookie. Воспроизведите его через вывод «копировать как fetch» в панели сети, а не собирайте заново вручную.
const res = await fetch("https://example.com/api/listings?page=1", {
  headers: { accept: "application/json" },
});

if (!res.ok) throw new Error(`${res.status} for listings page 1`);

const { items } = await res.json();Почему страница с клиентским рендерингом возвращает пустую оболочку?
Страница с клиентским рендерингом отдаёт разметку, в которой почти нет контента. В исходном ответе есть корневой элемент, пакет скриптов и, возможно, состояние загрузки. Текст, который человек видит на экране, создаётся JavaScript уже после прихода ответа, поэтому HTTP-запросу, который только читает ответ, читать нечего.
Это можно диагностировать, а не гадать. Две проверки охватывают большинство случаев: видимого текста в ответе — малая доля от того, что показывает браузер, а в разметке преобладают теги script:
const text = html.replace(/<script[\s\S]*?<\/script>/g, "").replace(/<[^>]+>/g, " ").replace(/\s+/g, " ").trim();

console.log({
  textLength: text.length,
  scriptCount: (html.match(/<script\b/g) ?? []).length,
  hasRoot: /id="(root|app|__next)"/.test(html),
});
Короткий текст, много скриптов и пустой корневой div вместе означают, что честный ответ — третий маршрут. Несколько десятков символов текста вообще без тега script обычно означают что-то более простое: запрос заблокировали или вы обратились не по тому URL.
Как это различие выглядит на практике:
| Сигнал в HTTP-ответе | Что это обычно значит | Следующий шаг |
|---|---|---|
| Полный контент, настоящая разметка | Страницу отрисовал сервер. Больше ничего не нужно. | Разберите её библиотекой селекторов. |
| Корневой div и много скриптов | Клиентский рендеринг. Контент приходит после ответа. | Ищите JSON-эндпоинт или отрисуйте страницу. |
| Очень короткий текст, без скриптов | Блокировка, перенаправление или просто не тот URL. | Перед разбором залогируйте статус, конечный URL и заголовки. |
Как Playwright собирает данные с реальной страницы в браузере?
Playwright управляет настоящим браузером, поэтому страница выполняется точно так же, как для посетителя. Схема скрейпинга проще, чем ожидает большинство: открыть контекст, перейти по URL, дождаться именно нужного элемента, а затем прочитать его.
Используемый здесь API описан на playwright.dev, каноническом справочнике по запуску браузеров, контекстов и локаторов.
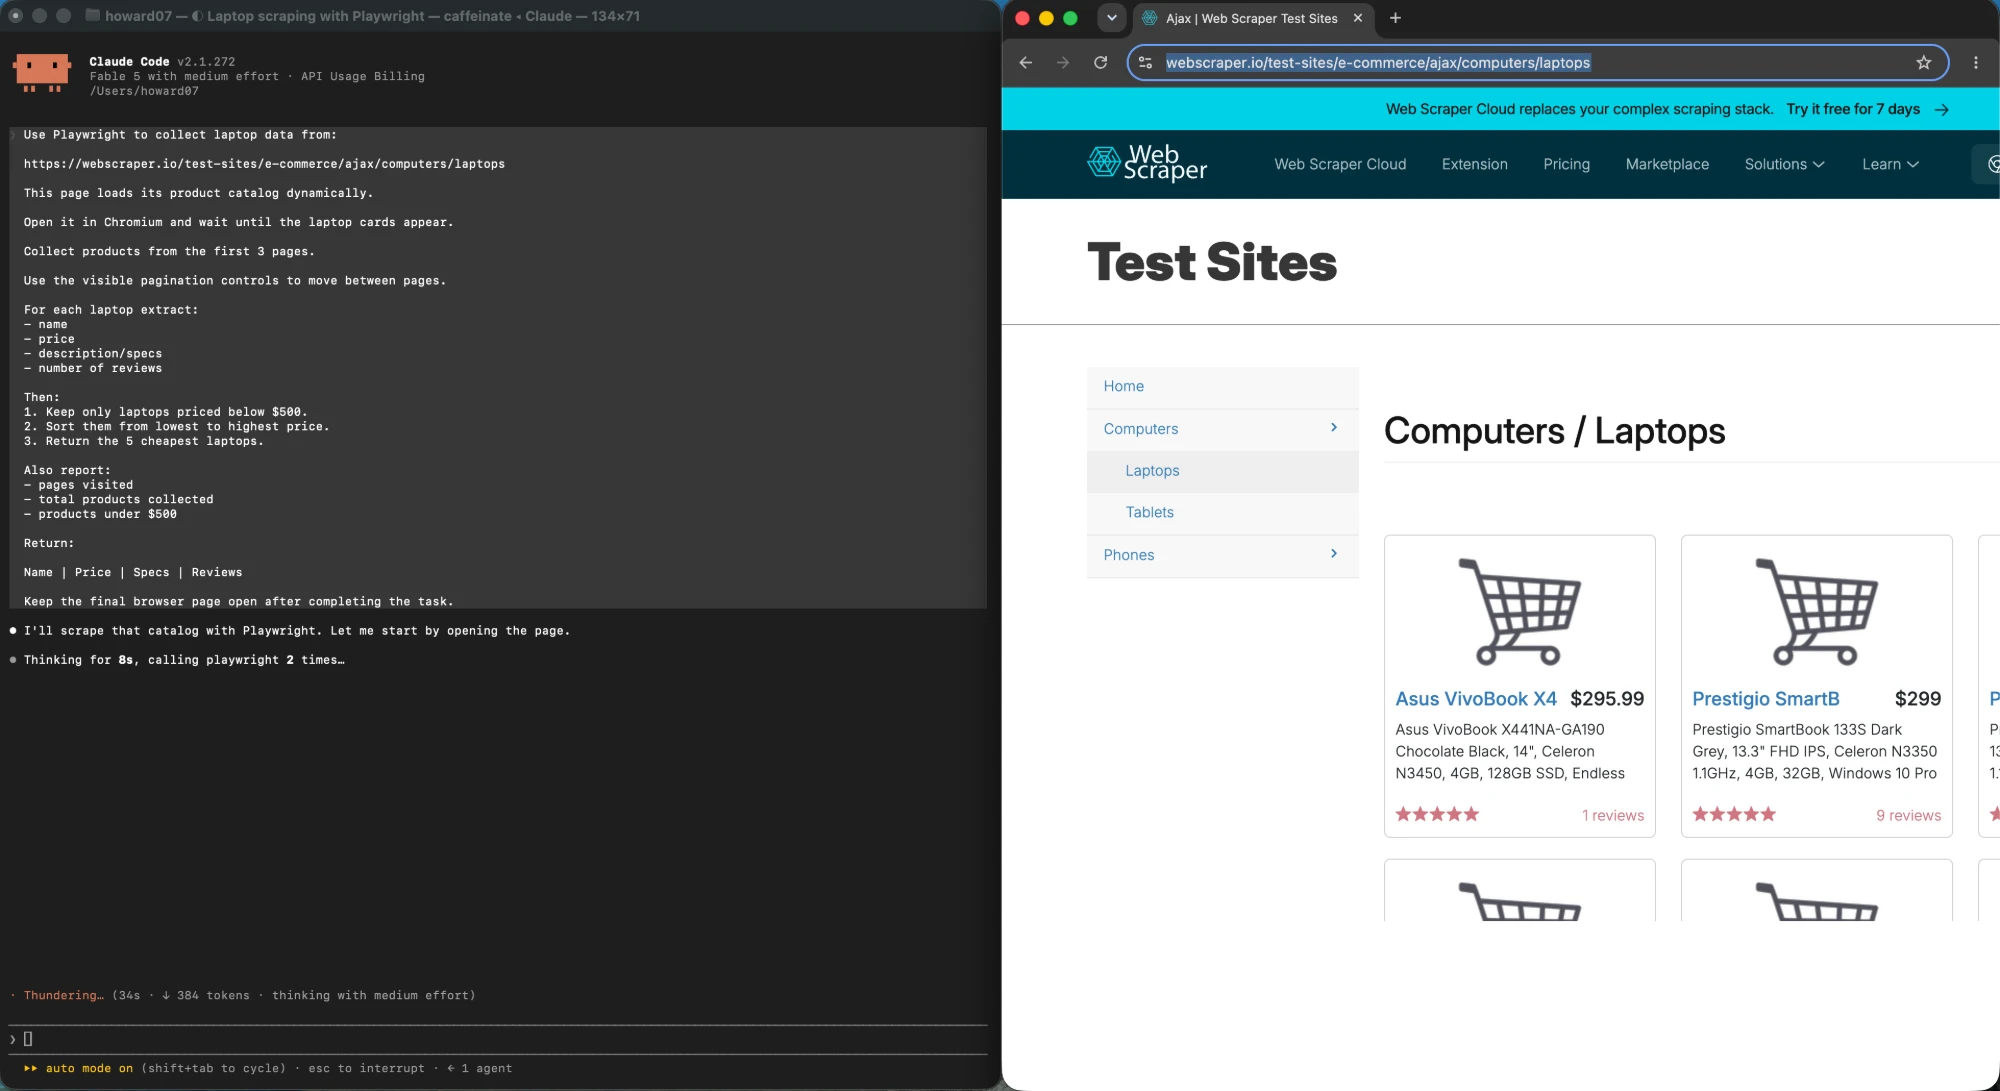
Приведённый ниже шаблон извлечения ждёт селектор, а затем извлекает данные через page.evaluate, который выполняет вашу функцию внутри страницы и возвращает сериализуемый результат:
import { chromium } from "playwright";

const browser = await chromium.launch();
const context = await browser.newContext();

try {
  const page = await context.newPage();
  await page.goto(url, { waitUntil: "domcontentloaded" });
  await page.waitForSelector(".product-card");

  const rows = await page.evaluate(() =>
    [...document.querySelectorAll(".product-card")].map((el) => ({
      name: el.querySelector(".name")?.textContent?.trim() ?? null,
      price: el.querySelector(".price")?.textContent?.trim() ?? null,
    })),
  );

  console.log(rows);
} finally {
  // contexts hold the memory; close it even when the scrape throws
  await context.close();
  await browser.close();
}
Две детали жизненного цикла важнее селекторов. Контекст — это дешёвая одноразовая единица, поэтому один браузер может обслуживать несколько изолированных запусков, и каждый из них завершается закрытием. Вторая: извлечение текста на странице возвращает текстовые узлы, а не отрисованные значения, поэтому контент, скрытый через CSS, всё равно остаётся в DOM и попадёт в ваш вывод.
Когда цель — конкретный элемент, а не весь список, локаторы оказываются более чистым путём извлечения. В документации Playwright по локаторам отмечено, что для кнопок, ссылок и полей ввода ждать перед кликом не требуется, и об этом стоит помнить, прежде чем оборачивать каждое взаимодействие в явное ожидание:
const title = await page.getByRole("heading", { level: 1 }).innerText();
const price = await page.locator("[data-testid=price]").innerText();
Как сессии, риск блокировки и CAPTCHA меняют план?
Как только цели нужен вход, скрейпер перестаёт быть упражнением с данными и становится задачей управления сессиями. Playwright поддерживает это напрямую: аутентифицируйтесь один раз, сохраните состояние хранилища браузера в файл и переиспользуйте его в последующих запусках вместо того, чтобы каждый раз прописывать ввод учётных данных.
// once, interactively
await context.storageState({ path: "auth.json" });

// later runs
const context = await browser.newContext({ storageState: "auth.json" });
Отсюда следуют два эксплуатационных факта. Сохранённое состояние сессии — это учётные данные, поэтому ему место в хранилище секретов, а не в репозитории. И сохранённая сессия истекает, поэтому запуск, который вдруг начал возвращать страницы входа, — это проблема сессии, а не селектора.
Сохранять это состояние между запусками — отдельная тема: постоянные сессии браузера между запусками агента подробно разбирают её.
Для автоматического трафика в целом три ограничения решают, есть ли у вас задача скрейпинга или заведомо проигранная борьба: что разрешают директивы robots и условия сайта, какую частоту сайт публикует или терпит, и является ли пришедший ответ контентом или страницей-проверкой. Это вопросы политики, которые нужно решить до написания кода, и они подробнее разобраны в нашем руководстве о скрейпинге за стеной входа.
Что ломает скрейпер на JavaScript в продакшене?
Скрейперы редко ломаются из-за неверного селектора. Они ломаются на втором запуске, на сотом URL, когда страница отвечает медленнее, ответ оказывается перенаправлением или сайт начинает ограничивать частоту. Исправления неброские и конкретные.
async function getWithRetry(url, attempt = 0) {
  const res = await fetch(url);
  if (res.status === 429 || res.status >= 500) {
    if (attempt >= 3) throw new Error(`giving up on ${url}`);
    const retryAfter = Number(res.headers.get("retry-after"));
    const waitMs = Number.isFinite(retryAfter)
      ? retryAfter * 1000
      : 2 ** attempt * 1000;
    await new Promise((r) => setTimeout(r, waitMs));
    return getWithRetry(url, attempt + 1);
  }
  if (!res.ok) throw new Error(`${res.status} for ${url}`);
  return res.text();
}
Параллелизм — вторая ловушка. Десять параллельных контекстов браузера на одной машине в основном конкурируют за один и тот же процессор, поэтому выигрыш в пропускной способности меньше затрат памяти, а сайт видит всплеск, а не ручеёк. Начните последовательно, измерьте и только потом увеличивайте число, если цель это выдерживает.
Третье: любому скрейперу, читающему эндпоинт без обещаний, нужен запасной вариант. Держите в кодовой базе разбор видимой страницы по селекторам и позволяйте неудачному JSON-вызову переходить к нему, чтобы тихое изменение на стороне источника ухудшало запуск, а не обнуляло его.
Когда настоящий браузер действительно необходим?
Настоящий браузер — правильный ответ, когда задаче нужно то, что может дать только браузер: аутентифицированная сессия, которая уже существует на вашей машине, контент, появляющийся только после взаимодействия, процесс, где человеку нужно вмешаться на полпути, или результат, за которым нужно наблюдать в момент выполнения, а не просто забрать его. Вне этих случаев HTTP с парсером быстрее, дешевле и проще в поддержке.
Компромисс между headless-браузером и настоящим браузером разобран в материале headless-браузер против настоящего браузера для ИИ-агентов.
Именно в такой ситуации стоит задуматься о браузерном агенте, управляемом задачей. ego (lite) — это браузер, созданный для работы под управлением агента: вы описываете цель, и он действует в настоящем браузере, включая уже открытые у вас сессии входа, с видимым интерфейсом, который можно перехватить, когда на каком-то шаге нужно человеческое суждение. Для задач скрейпинга, которым нужны реальное состояние входа, динамическая страница, видимое выполнение или передача управления человеку, это убирает описанную выше работу по настройке сессий. Он не заменяет Playwright и не даёт обещаний насчёт любого сайта: страницы, отвечающие проверкой, или запрещающие автоматический доступ, для него закрыты так же, как и для любого другого маршрута. Там, где обычный HTTP-запрос или официальный API уже возвращает нужное, добавление браузерного агента лишь замедлит работу.
Для более подробного сравнения браузерных инструментов, когда браузер действительно оказывается ответом, наш разбор скрейпинга Playwright против Puppeteer посвящён выбору библиотеки как таковой, а обзор сценариев работы ИИ-скрейперов рассказывает, где агенты встраиваются в конвейер скрейпинга.
Каковы основные сложности и ограничения?
У каждого маршрута в этой схеме есть режим отказа, от которого нельзя избавиться инженерными средствами, и знание их заранее отличает скрейпер, работающий год, от того, что живёт неделю.
Статический разбор ломается, когда сайт меняет разметку. Он никак не может это заметить, поэтому поле, которое молча становится null, встречается чаще, чем явное падение. Проверяйте образец при каждом запуске, а не доверяйте конвейеру.
Внутренние JSON-эндпоинты ломаются вообще без предупреждения, и это наименее договорная часть любого сайта. Успешный запуск сегодня ничего не доказывает про следующий месяц.
Автоматизация браузера — самая реалистичная и самая хрупкая в масштабе. Память растёт вместе с параллелизмом, сессии истекают, а антибот-системы реагируют на шаблоны, а не на намерения, поэтому приём, работающий с ноутбука, может не работать из дата-центра.
И самое большое ограничение не техническое. Что вам разрешено собирать, как часто и что потом с этим можно делать, определяется условиями сайта, директивами robots и законом вашей юрисдикции, и ничто из этого не меняется от того, что код работает.
Последовательность диагностики, которая из всего этого следует, коротка. Когда скрейпинг ничего не возвращает, сначала проверьте код статуса, затем — есть ли контент в ответе вообще, затем — совпадает ли селектор с отрисованным DOM, а не с исходником. И только после этих трёх шагов стоит рассматривать браузер.
Часто задаваемые вопросы
Нужна ли библиотека для HTTP-запросов в Node.js?
Нет. В Node.js Fetch API доступен как глобальный объект, поэтому fetch работает без установки чего-либо, вместе с объектом response и его членами ok, status и text(). Что действительно нужно — парсер, потому что fetch возвращает строку, а сопоставление строк по HTML ломается, как только меняется разметка.
Почему мой скрейпер возвращает пустой список со страницы, которая нормально выглядит в браузере?
Самая вероятная причина — страница отрисовывается на клиенте, и данных никогда не было в HTTP-ответе. Подтвердите это, сравнив видимый текст в сыром ответе с тем, что показывает браузер, и подсчитав теги script относительно контента. Если ответ — оболочка, переходите к JSON-эндпоинту сайта или отрисуйте страницу в настоящем браузере.
Заменяет ли Cheerio браузер без интерфейса?
Нет. Cheerio разбирает HTML и позволяет делать выборку селекторами. Он не выполняет JavaScript, поэтому не может создать контент, который страница генерирует после загрузки. Это правильный инструмент для первого маршрута и неправильный для третьего, а обращение к браузеру там, где хватило бы Cheerio, — самая частая лишняя трата в коде скрейпинга.
Как понять, отрисовывается страница на сервере или на клиенте?
Запросите URL и посмотрите на сырой ответ, а не на отрисованный DOM. Если нужные значения присутствуют в теле ответа, страница отрисована на сервере и дешёвый маршрут работает. Если в теле есть корневой элемент, пакеты скриптов и мало текста, контент собирается в браузере.
Как скрейпить страницу, требующую входа?
Войдите один раз в контексте браузера, сохраните состояние хранилища в файл и загружайте это состояние в последующих запусках. Обращайтесь с файлом как с секретом, ожидайте, что он истечёт, и предпочитайте сессию, на использование которой у вас есть право. Если цель требует обойти CAPTCHA или проверку владения, остановитесь и используйте официальный маршрут.
Что лучше для скрейпинга — Playwright или Puppeteer?
Оба управляют настоящим браузером и могут собирать данные с одних и тех же страниц. Решение касается деталей библиотеки — поддержки локаторов, поведения при ожидании и привязок к языкам, — а не маршрутов доступа, и оно разобрано в нашем сравнении Playwright и Puppeteer. Что бы вы ни выбрали, решение о маршруте из этой статьи идёт первым.
Сколько страниц можно скрейпить одновременно?
Начните последовательно и измерьте, прежде чем повышать параллелизм. HTTP-запросы масштабируются гораздо дешевле, чем контексты браузера, а параллельные браузеры на одной машине в основном конкурируют за один и тот же процессор и дают целевому сайту всплеск трафика. Для HTTP-скрейпинга безопаснее начать с четырёх-восьми одновременных запросов с задержкой, чем с десятков.
Что делать при ответе 429?
Прочитайте заголовок Retry-After и подождите как минимум указанное время, затем повторите с экспоненциальной задержкой до небольшого предела, а после него явно сообщите об ошибке. 429 — это сигнал о частоте, а не ошибка, которую нужно пробивать плотным циклом повторов, и именно игнорирование его приводит адрес в чёрный список.
Законен ли скрейпинг?
Это зависит от сайта, данных, юрисдикции и того, что вы делаете с результатом. Директивы robots и условия использования указывают, что сайт разрешает, а правила о персональных данных и правах на базы данных различаются по странам. Ничто в этой статье не является юридической консультацией; проверьте условия и применимое право, прежде чем собирать что-либо в масштабе.
Когда использовать официальный API вместо скрейпинга?
Всякий раз, когда он существует и покрывает нужные вам поля. Документированный API — это стабильный контракт, у него обычно есть явные лимиты частоты, и он не ломается при изменении вёрстки страницы. Скрейпинг — запасной вариант для данных, опубликованных в браузере без поддерживаемого пути доступа, а не значение по умолчанию.
Нужен ли браузерный агент для скрейпинга?
Только для задач, которым нужно реальное состояние входа, контент, появляющийся после взаимодействия, видимое выполнение или перехват управления человеком по ходу процесса. Для страниц, отдающих контент по HTTP, или сайтов с официальным API браузерный агент добавляет затраты, не добавляя возможностей.
Если вы хотите попробовать маршрут с браузерным агентом на задаче скрейпинга, которой он действительно нужен, ego (lite) можно скачать бесплатно, а страницы скрейпер цен и SERP-скрейпер подробно разбирают две конкретные задачи от начала до конца.