Paginierung beim Web Scraping bedeutet nicht nur, zur nächsten Seite zu gelangen. Der schwierigere Teil ist zu wissen, ob noch Daten zu holen sind und wann die Liste wirklich zu Ende ist. Die meisten Sites nutzen eines von drei Mustern, nummerierte Seiten, Load More oder Infinite Scroll, und jedes braucht eine andere Navigationsstrategie, eine andere Wartebedingung und eine andere Stoppregel. Liegen Sie daneben, kann ein Crawler früh anhalten, ohne je einen Fehler zu werfen.
Liegen die Daten direkt im HTML oder an einem JSON-Endpunkt, brauchen Sie in der Regel gar keinen Browser; schlichtes HTTP ist einfacher und schneller. Ein Browser wird nützlich, wenn die Liste von clientseitigem Rendering, einer authentifizierten Sitzung, in der Seite erzeugten Token oder echtem Scroll-Verhalten abhängt. Und wenn diese Daten von einem Browser abhängen, in dem Sie bereits angemeldet sind, lässt ego (lite) einen KI-Agenten dieselbe Paginierungslogik in dieser bestehenden Browser-Sitzung ausführen, statt den Login-Zustand nachzubauen.
In den folgenden Abschnitten prüfen wir nummerierte Seiten, Load More und Infinite Scroll mit einer Frage: Ist die Liste wirklich zu Ende, oder hat der Crawler nur aufgehört nachzufragen? Die Beispiele nutzen ein wiederholbares lokales Fixture mit 135 Zeilen über nummerierte Seiten, 81 gerenderten Zeilen hinter Load More und einem Infinite-Feed mit 60 Einträgen. Am Ende paginiert der Crawler nicht nur, er zeichnet auch auf, wo er angehalten hat, behandelt Duplikate und verpasste Zeilen und prüft, ob die gesammelten Daten vollständig sind.
Wie Sie erkennen, welchen Paginierungsmodus Sie vor sich haben
Drei Beobachtungen klären die Einordnung. Eine geänderte URL oder ein Klick auf einen nummerierten Link verändert die Ergebnismenge: das ist nummerierte Paginierung. Ein Button, dessen Beschriftung mehr Inhalt verspricht, hängt Zeilen an, ohne die URL zu ändern: das ist Load More. Zeilen, die beim Scrollen erscheinen, ohne dass etwas zu klicken ist, sind Infinite Scroll. Mischt eine Seite die Muster, behandeln Sie jeden Übergang als eigenen Modus, statt eine Schleife beides abdecken zu lassen.
Ein kurzer Blick im Browser klärt das schneller als das Lesen des Codes: öffnen Sie die DevTools, beobachten Sie das Netzwerk-Panel und interagieren Sie einmal. Eine Navigationsanfrage mit einem page-Parameter ist nummerierte Paginierung. Eine JSON- oder HTML-Anfrage im Hintergrund, ausgelöst durch einen Klick, ist Load More. Anfragen, die sich beim Scrollen wiederholen, sind Infinite Scroll, und die Antwort enthält meist den nächsten Offset, ein Geschenk für einen Crawler.
Nummerierte Seiten: die URL-Regel ableiten und korrekt anhalten
Nummerierte Paginierung ist der freundlichste Modus, weil der Zustand in der URL liegt. Leiten Sie die Regel aus den ersten drei Seiten ab: welcher Parameter sich ändert, ob es eine Seitenzahl oder ein Offset ist, und ob die Seitengröße fest ist. Die Regel muss sich als Funktion ausdrücken lassen, und eine korrekte Funktion erzeugt Seite 4 aus Seite 3, ohne dazwischen etwas zu besuchen.
// Derive once, then verify against page 2 and page 3 before trusting it.
const pageUrl = (n) => `https://example.com/listings?page=${n}`;

let page = 1;
const rows = [];
while (true) {
  await browserPage.goto(pageUrl(page));
  const batch = await browserPage.locator("tr.row").evaluateAll((nodes) =>
    nodes.map((node) => ({
      id: node.dataset.id,
      title: node.querySelector(".title").textContent.trim(),
      price: Number(node.querySelector(".price").textContent.replace(/[^0-9.]/g, "")),
    })),
  );
  if (batch.length === 0) break;
  rows.push(...batch);

  const hasNext = (await browserPage.locator("a#next").count()) > 0;
  if (!hasNext) break;
  page += 1;
}
Das Ende verdient mehr Sorgfalt, als es meist bekommt. Ein fehlender next-Link und ein leerer Batch sind echte Ende-Signale; eine fest eingetragene Seitenzahl ist es nicht, weil Listen wachsen und die heute fest verdrahtete Zahl nächsten Monat falsch ist. Im Fixture-Lauf ging der Crawler die Seiten 1 bis 5, sammelte 135 Zeilen in 80 milliseconds und hielt an, als der next-Link verschwand. Eine dieser fünf Anfragen lieferte beim ersten Versuch einen 503, der Crawler wiederholte dieselbe Seite einmal, und der Retry gelang.
Zwei Regeln halten die Schleife ehrlich. Erstens pausieren Sie zwischen Seitenanfragen, statt sie so schnell wie möglich abzufeuern, und respektieren Sie die Nutzungsbedingungen der Site sowie das robots-exclusion-Protokoll, beschrieben in RFC 9309. Zweitens behandeln Sie eine wiederholte Seite als Stoppsignal, wenn die Liste geordnet sein soll, weil Paginierung, die ihre eigenen Parameter ignoriert, sonst endlos laufen kann.
Load More: klicken, warten und deduplizieren
Load More versteckt den Zustand hinter einem Button, deshalb muss der Crawler das Wachstum selbst erzeugen: klicken, warten, bis die Zeilenzahl wirklich steigt, das Neue einsammeln und wiederholen, bis der Button verschwindet oder nichts mehr ändert. Beim Warten scheitern die meisten Implementierungen. Eine feste Pause klappt zufällig auf einer schnellen Verbindung und kürzt die Liste auf einer langsamen stillschweigend.
await browserPage.goto("https://example.com/listings");

while (true) {
  const button = browserPage.locator("#load-more");
  if ((await button.count()) === 0) break;

  const before = await browserPage.locator("tr.row").count();
  await button.click();
  await browserPage.waitForFunction(
    (n) => document.querySelectorAll("tr.row").length > n,
    before,
    { timeout: 10000 },
  );
}

const rows = await browserPage.locator("tr.row").evaluateAll((nodes) =>
  nodes.map((node) => ({ id: node.dataset.id, title: node.textContent.trim() })),
);
Im Fixture-Lauf kamen vier Batches zu je zwanzig Zeilen in 273 milliseconds an, und die sichtbare Liste hielt 81 Zeilen gegen einen Datensatz von 80. Die Extra-Zeile war ein Duplikat, das das Fixture einpflanzt, um eine häufige Realität abzubilden: derselbe Datensatz kommt über Batches hinweg zweimal. Die Statuszeile der Seite selbst las "Loaded 81 of 80", eine gute Erinnerung, dass der von der Site gerenderte Zähler keine Validierungsquelle ist. Deduplizieren Sie über eine stabile Kennung wie die record id der Zeile, nicht über den sichtbaren Titel, und Sie entfernen genau das eine Duplikat.
Infinite Scroll: Auslöser, Höhenstabilität und Stoppregeln
Infinite Scroll hat weder Button noch URL, deshalb müssen Auslöser und Stoppbedingung erschlossen werden. Der Auslöser ist meist ein Sentinel-Element, das in den Viewport tritt, oder ein Schwellenwert der Scroll-Position. Bei der Stoppbedingung ist Urteilskraft gefragt, weil die Liste das Ende nicht auf eine Weise ankündigt, die Sie anklicken können.
Ein gemessener Fehlschlag lohnt sich zu zeigen, weil es der Fehlschlag ist, mit dem die meisten Crawler ausgeliefert werden. Einmal nach unten scrollen und prüfen, ob die Zeilenzahl gewachsen ist, ohne auf das Rendern des nächsten Batch zu warten, meldet sofort "no growth": das Fixture hielt bei 15 of 60 Zeilen, einen Batch weit, während das Netz den nächsten Batch bereits angefragt hatte. Die Prüfung lag nicht falsch zum Zeitpunkt; falsch war, einen ruhigen Augenblick als Ende der Liste zu werten.
Die zuverlässige Variante wartet auf eine beobachtbare Bedingung und bestätigt das Ende über mehrere Prüfungen statt über eine. Scrollen, warten, bis die Item-Zahl wächst oder die Seite erklärt, dass der Feed zu Ende ist, und erst wenn keines von beidem bei drei aufeinanderfolgenden Prüfungen eintritt, die Liste als fertig behandeln. Im Fixture liefen dieselben 60 Items in vier Scroll-Runden ohne falsche Stopps durch, und die letzte Statuszeile las "End of feed (60 of 60)".
let stableChecks = 0;
while (stableChecks < 3) {
  const items = await browserPage.locator("article.post").count();
  await browserPage.evaluate(() => window.scrollTo(0, document.body.scrollHeight));

  const grew = await browserPage
    .waitForFunction(
      (n) =>
        document.querySelectorAll("article.post").length > n ||
        /end of feed/i.test(document.body.innerText),
      items,
      { timeout: 3000 },
    )
    .then(() => true)
    .catch(() => false);

  stableChecks = grew ? 0 : stableChecks + 1;
  if (!grew) await browserPage.waitForTimeout(700);
}
Zwei Details trennen eine stabile Schleife von einer unzuverlässigen. Höhenstabilität muss an der Zahl extrahierter Items gemessen werden, nicht an der Dokumenthöhe, weil Lazy-Images und Anzeigen die Höhe ändern, ohne Datensätze hinzuzufügen. Und das Scrollen muss den Loader der Site tatsächlich erneut auslösen: Implementierungen auf Basis der Intersection Observer API feuern bei Änderungen der Überschneidung, deshalb sind wechselnde Scroll-Positionen zuverlässiger, als die Seite unten festzuhalten.
Crawl-Zustand speichern und nach einem Absturz fortsetzen
Alle drei Modi teilen eine Anforderung: ein Lauf muss seine eigene Unterbrechung überstehen. Schreiben Sie nach jedem abgeschlossenen Batch einen Checkpoint mit Modus, Position und den bisher gesammelten Datensätzen, und machen Sie das Fortsetzen zum Standardweg statt zu einem Sonderfall. Am Fixture wurde der nummerierte Crawl nach Seite 2 mit 54 Zeilen im Checkpoint beendet. Ein neuer Prozess las den Checkpoint, machte bei Seite 3 weiter und endete mit denselben 135 Zeilen und 133 eindeutigen ids wie ein ununterbrochener Lauf.
import { readFileSync, writeFileSync } from "node:fs";

const CHECKPOINT = "./crawl-state.json";
const save = (state) => writeFileSync(CHECKPOINT, JSON.stringify(state));
const load = () => {
  try {
    return JSON.parse(readFileSync(CHECKPOINT, "utf8"));
  } catch {
    return { mode: "numbered", lastPage: 0, rows: [] };
  }
};

const state = load();
for (let page = state.lastPage + 1; page <= 5; page += 1) {
  state.rows.push(...(await crawlPage(page)));
  state.lastPage = page;
  save(state); // checkpoint after every page
}
Der Checkpoint ändert auch das Debugging. Liefert ein Crawl eine falsche Zahl, können Sie die Zustandsdatei prüfen, statt den ganzen Auftrag neu zu fahren, und die dort gespeicherte Position sagt, welchen Batch Sie erneut holen.
Duplikate, verpasste Zeilen und falsche letzte Seiten
Drei Symptome decken die meisten Paginierungsfehler ab, und jedes hat eine Signatur in den Daten statt im Code. Duplikate entstehen, wenn ein Batch den Nachbarn überlappt, was passiert, wenn die darunterliegende Liste zwischen Anfragen neu sortiert und die stabile Kennung sich wiederholt. Das Fixture hat das genau nachgestellt: dieselbe id erschien einmal auf Seite 2, erneut auf Seite 3 und noch einmal innerhalb von Seite 5. Beide Duplikate verschwanden mit einer id-basierten Deduplizierung.
Verpasste Zeilen bedeuten meist eine zu kurze Wartezeit oder eine übersprungene Seite. Fehlt am Total genau ein Batch, schauen Sie auf die Interaktion vor der Lücke; fehlt eine Seite, schauen Sie auf das Inkrement der Schleife. Der vorübergehende 503 des Fixture ist die andere Spielart dieses Fehlers: ohne Retry hätte Seite 3 nichts beigetragen, und der Lauf hätte 106 Zeilen gemeldet, ganz ohne Fehler.
Eine falsche letzte Seite ist am gefährlichsten, weil der Crawl Erfolg mit weniger Daten meldet. Das passiert, wenn eine Seite wegen eines Sitzungs- oder Rendering-Problems null Zeilen liefert, nicht weil die Liste zu Ende ist, und die Schleife beides gleich behandelt. Unterscheiden Sie sie, indem Sie noch einmal nachfassen: fordern Sie die nächste Seite nach einer kurzen Pause erneut an, und verlangen Sie entweder eine echte Ende-Markierung oder zwei aufeinanderfolgende leere Antworten, bevor Sie das Ende akzeptieren.
Zählungen und Vollständigkeit der Felder prüfen
Validierung sind zwei Prüfungen, die Sekunden dauern und die meisten stillen Ausfälle fangen. Die Zählprüfung vergleicht das Gesammelte mit jeder unabhängigen Zahl, die Sie finden: der eigenen Angabe "page 5 of 5" der letzten nummerierten Seite, einem Total in einem Header oder der Summe der Seitenzählungen unterwegs. Die Feldprüfung bestätigt, dass jeder Datensatz die Felder trägt, die der Auftrag versprochen hat, und zählt die Ausnahmen, statt sie zu ignorieren.
const unique = new Map(rows.map((row) => [row.id, row]));
const missing = rows.filter((row) => !row.title || !Number.isFinite(row.price));

console.log({
  raw: rows.length,
  unique: unique.size,
  removedDuplicates: rows.length - unique.size,
  missingFields: missing.length,
});
Bei den 135 nummerierten Zeilen des Fixture meldete die Prüfung null fehlende Felder, zwei entfernte Duplikate und 133 eindeutige Datensätze, passend zum Datensatz. Bei der Load-More-Liste meldete sie ein Duplikat von 81. Keine der Zahlen ist für sich interessant; entscheidend ist, dass eine Änderung in jeder sofort sichtbar wird, statt später als Bericht mit rätselhafter Lücke aufzutauchen.
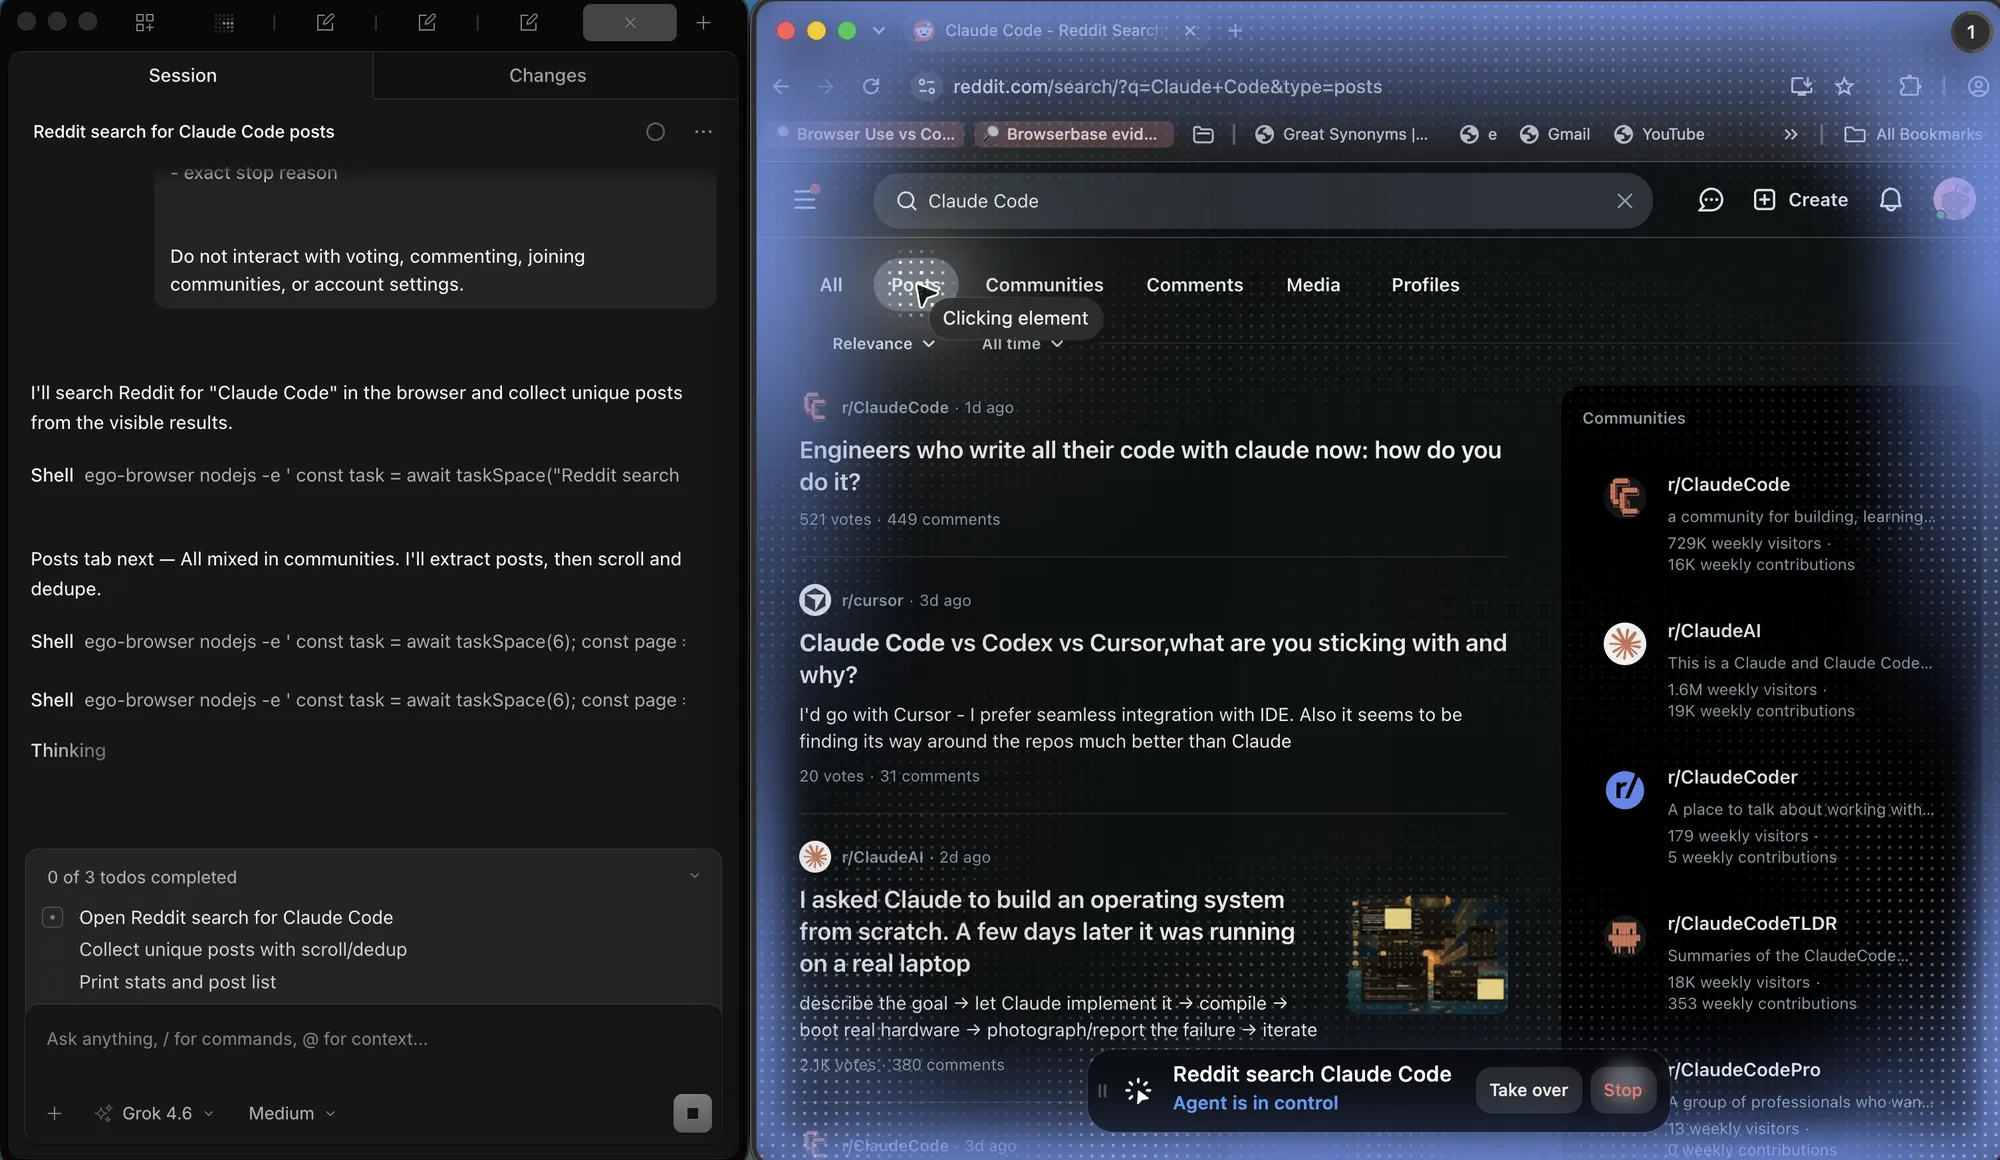
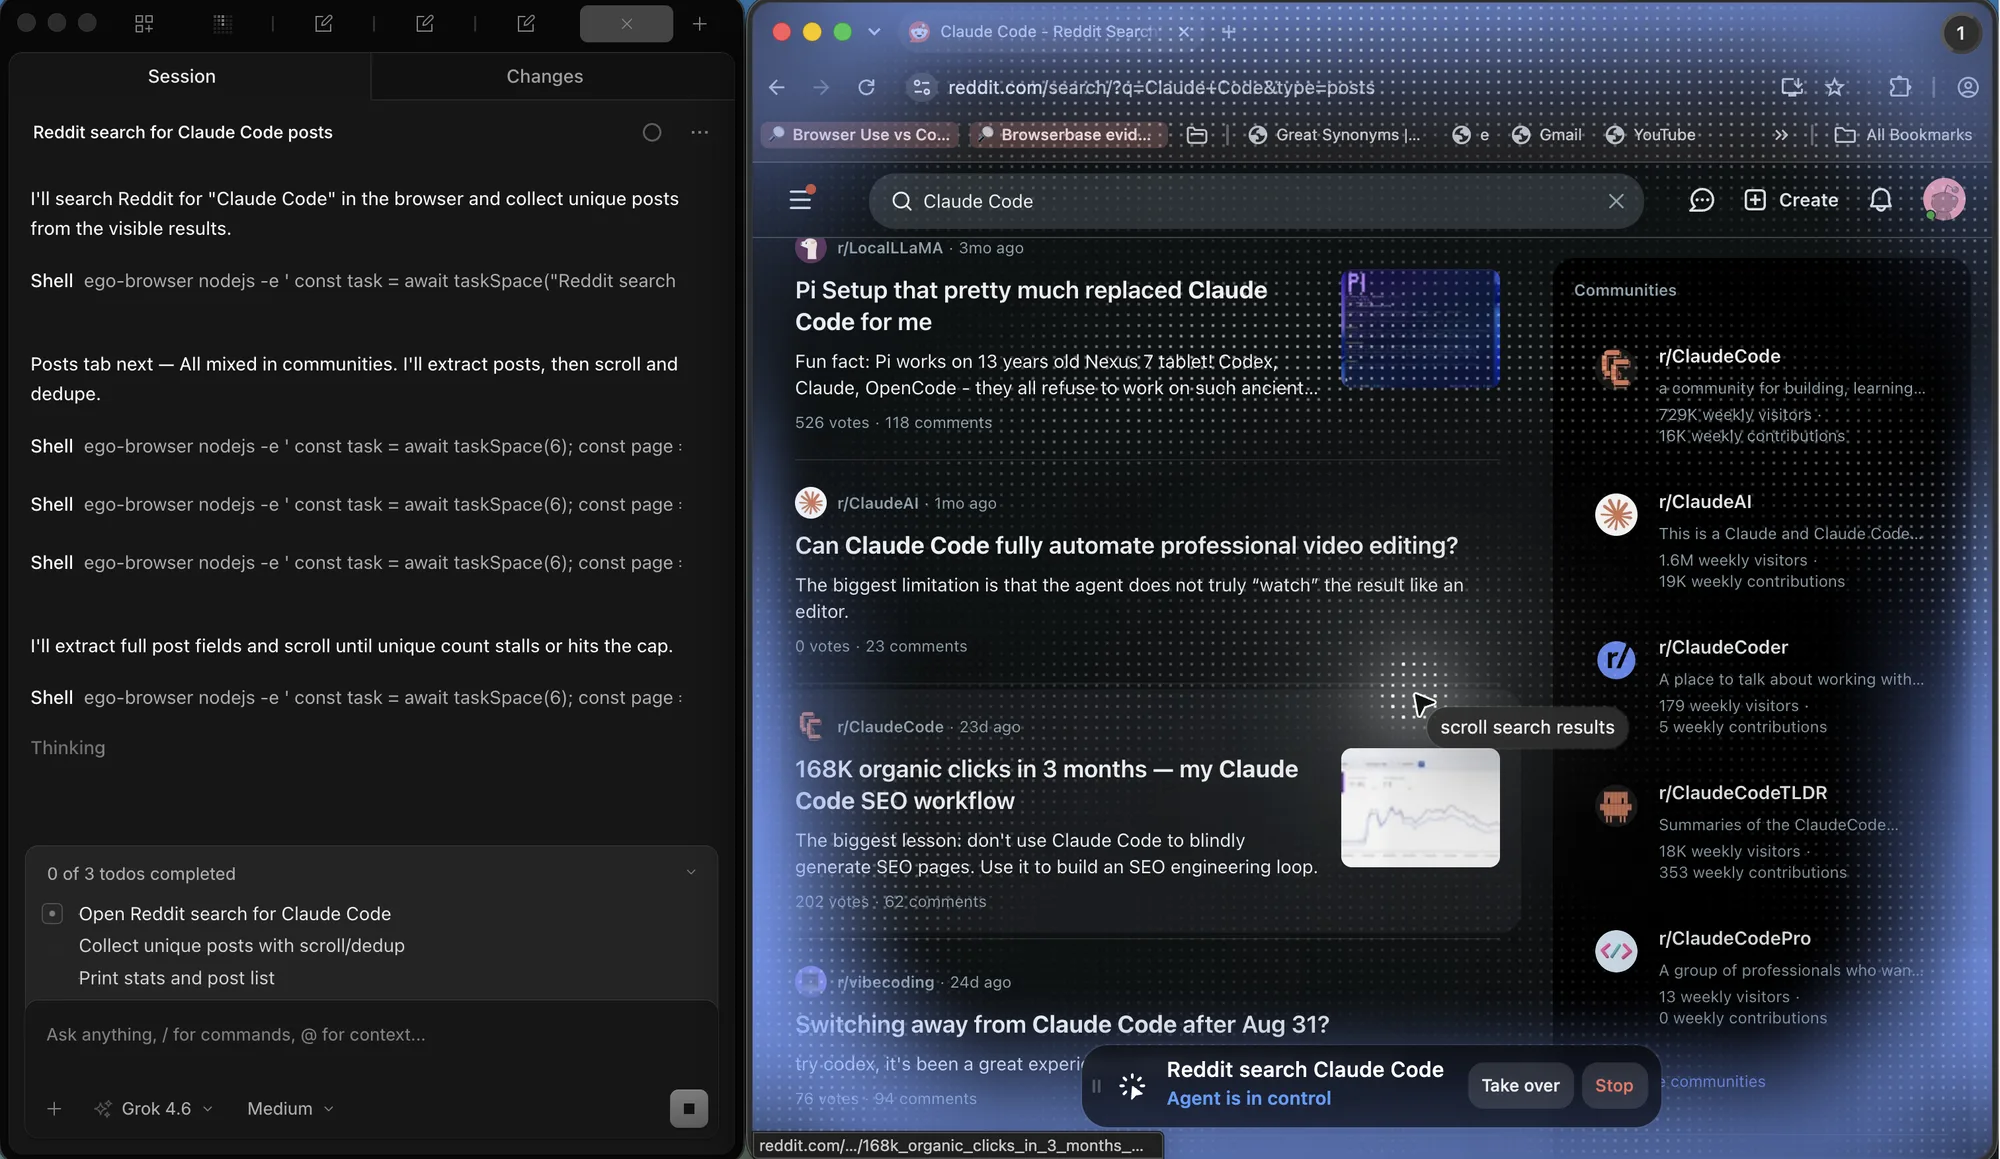
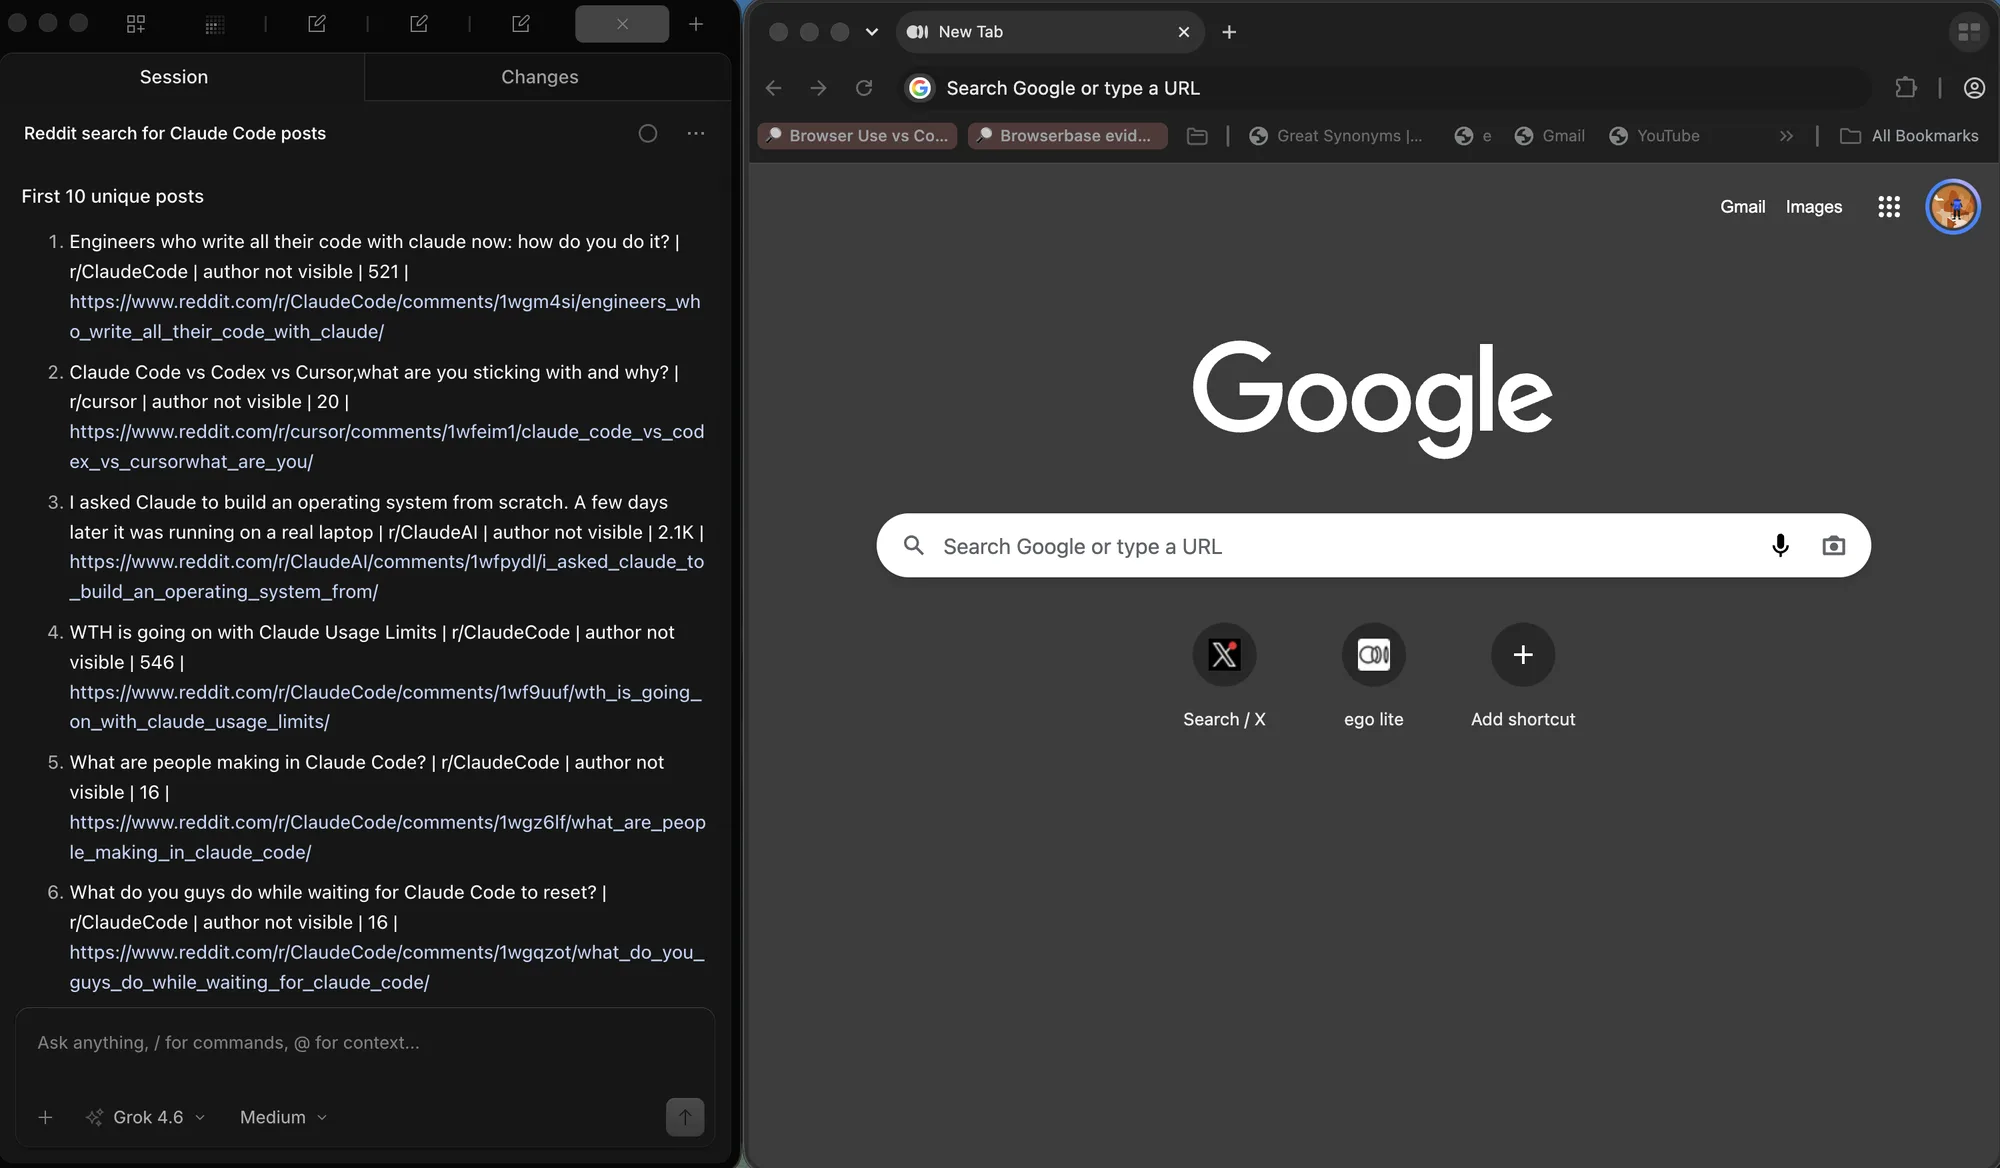
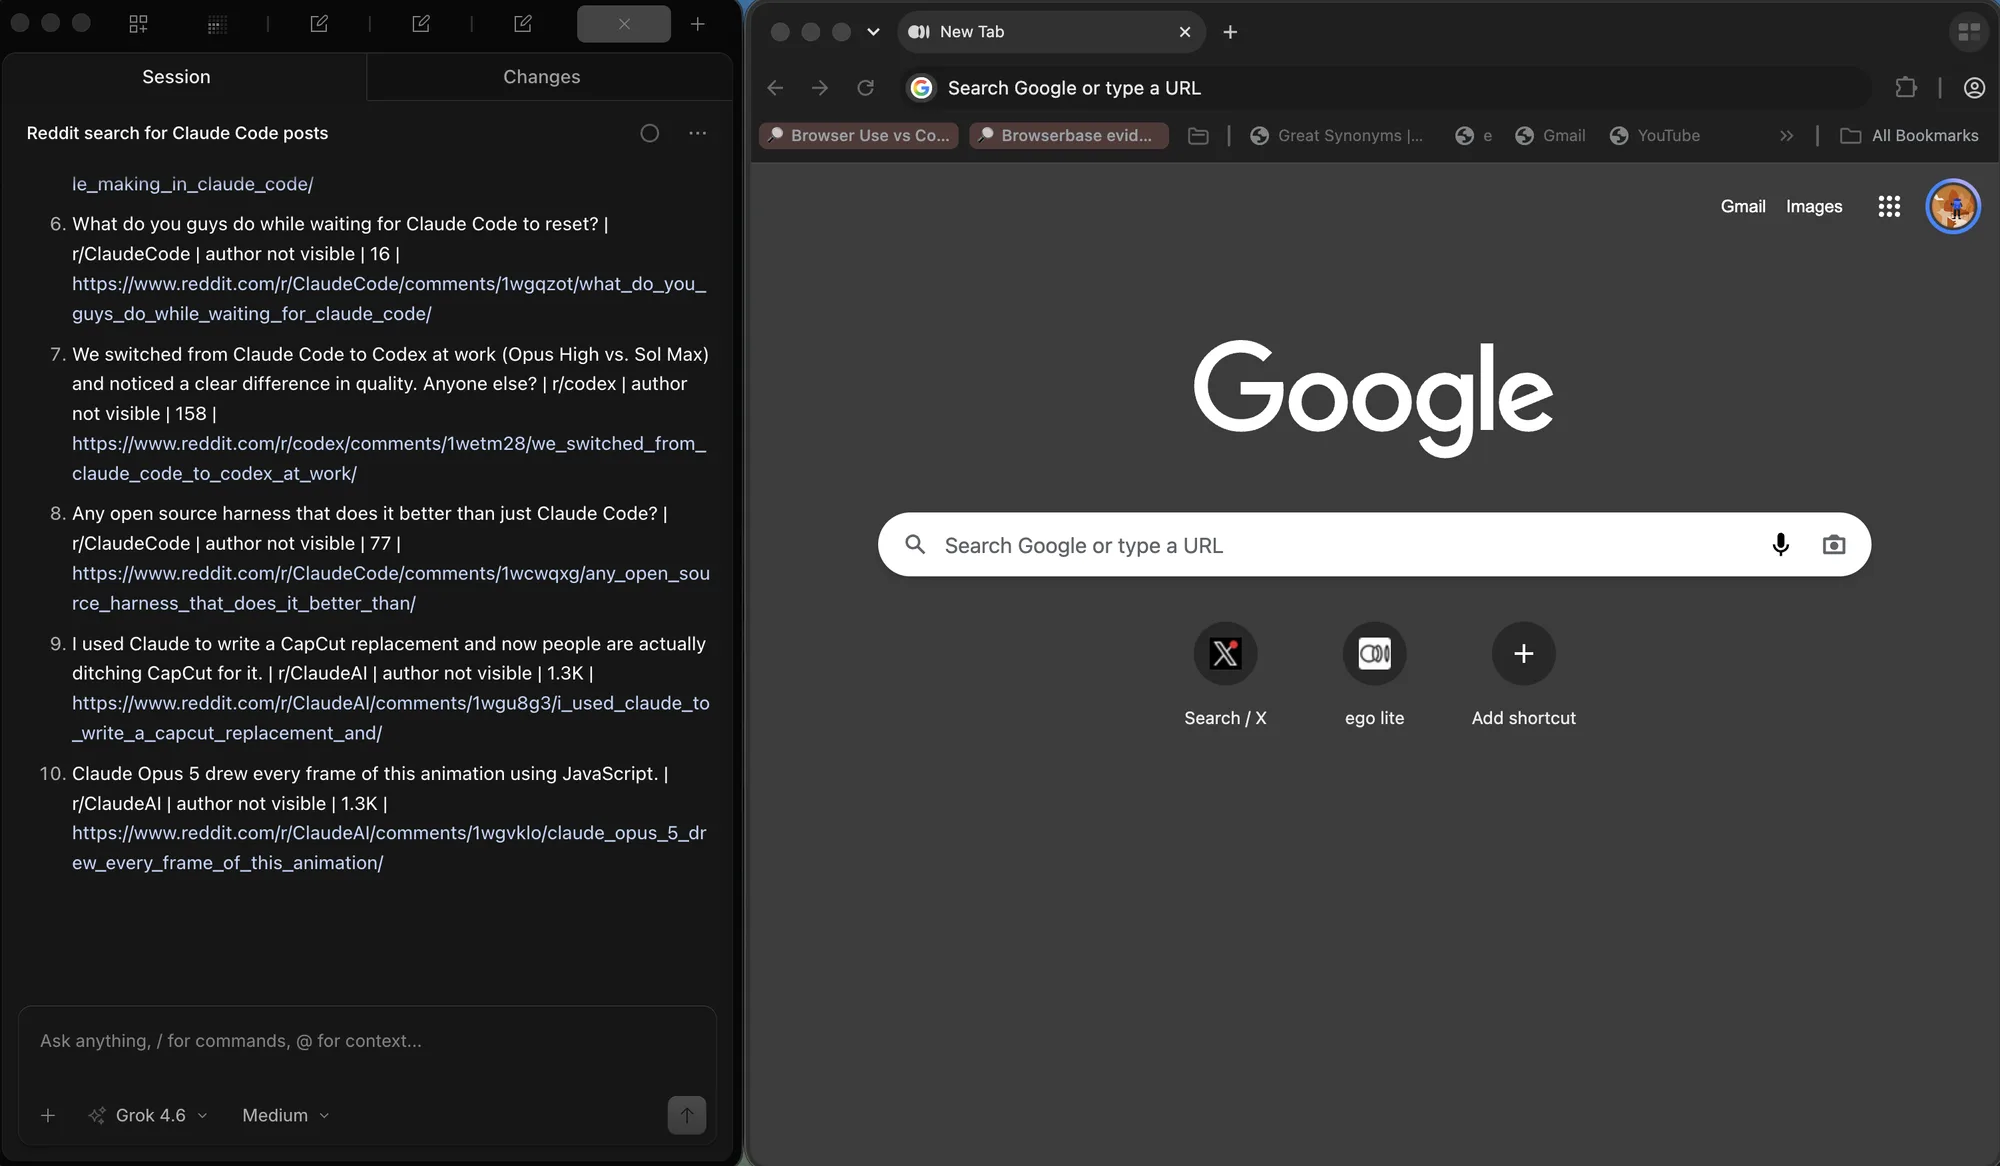
Der Reddit-Lauf nutzte dieselbe Pruefung auf einer live eindeutigen Liste, nicht auf dem 135-Zeilen-Fixture. Jede Zeile brauchte Titel, Subreddit, Stimmenzahl und URL. Die nummerierte Ausgabe ist das, was Sie nach dem Scroll pruefen.
Wann schlichtes HTTP reicht, und wann nicht
Dieselben Fixture-Daten sind ohne Browser erreichbar, und beide Wege zu messen ist der ehrliche Weg zu entscheiden, was der Auftrag braucht. Ein schlichter HTTP-Client ging die nummerierten Seiten per URL, holte die Load-More-Batches von ihrem JSON-Endpunkt und zog den Infinite-Feed per Offset, und sammelte alle 135, 81 und 60 Zeilen in 24 milliseconds zusammen. Kein Rendering, kein Warten, kein Scrollen.
Das ist die Standardempfehlung, und sie sollte klar stehen: existiert eine offizielle API, nutzen Sie sie. Ist die nummerierte Liste serverseitig gerendert, fordern Sie die Seiten direkt an. Stecken hinter Load More oder Infinite ein JSON-Endpunkt ohne Signatur, fordern Sie diesen Endpunkt an und paginieren Sie über den Offset. Ein Framework wie Playwright ist dafür nicht nötig, und der HTTP-Weg ist schneller und günstiger im Betrieb. Der Apify-Paginierungs-Walkthrough, die Web-Scraper-Dokumentation zu Paginierungsselektoren und der Netzwerk-Panel-Ablauf im Playwright-Netzwerkleitfaden decken denselben Stoff von unterschiedlichen Startpunkten ab.
Ein Browser ist gerechtfertigt, wenn die Daten erst nach clientseitigem Rendering existieren, wenn Anfragen eine in der Seite erzeugte Signatur oder ein Token tragen, wenn die Liste einen Login braucht oder wenn der Endpunkt ohne echte Sitzung und echten User-Agent anders antwortet. Dann ist der Browser keine Scraping-Vorliebe, sondern der einzige ehrliche Weg, und die früheren Abschnitte gelten unverändert.
ego (lite) kommt erst ins Spiel, wenn dieser HTTP-Weg scheitert. Braucht die Liste ein angemeldetes Cookie, ein in der Seite erzeugtes Token oder ein Scrollen, das ohne echten Viewport nie passiert, führen Sie dieselbe numbered / load-more / infinite-Schleife in einem Browser aus, der die Sitzung schon hält. Fangen Sie nicht dort an. Das Fixture hat die günstigere Antwort schon gezeigt: 135, 81 und 60 Zeilen über schlichtes HTTP in 24 ms.
Wenn Sie den Browser wirklich brauchen, behalten Sie die Crawl-Logik aus den früheren Abschnitten. ego (lite) liefert die angemeldete Seite und einen Space, den Sie beobachten können; es erfindet keinen neuen Paginierungsalgorithmus. Braucht ein Schritt einen Menschen, halten Sie an. Liefert curl oder eine offizielle API die Zeilen bereits, bleiben Sie bei HTTP.
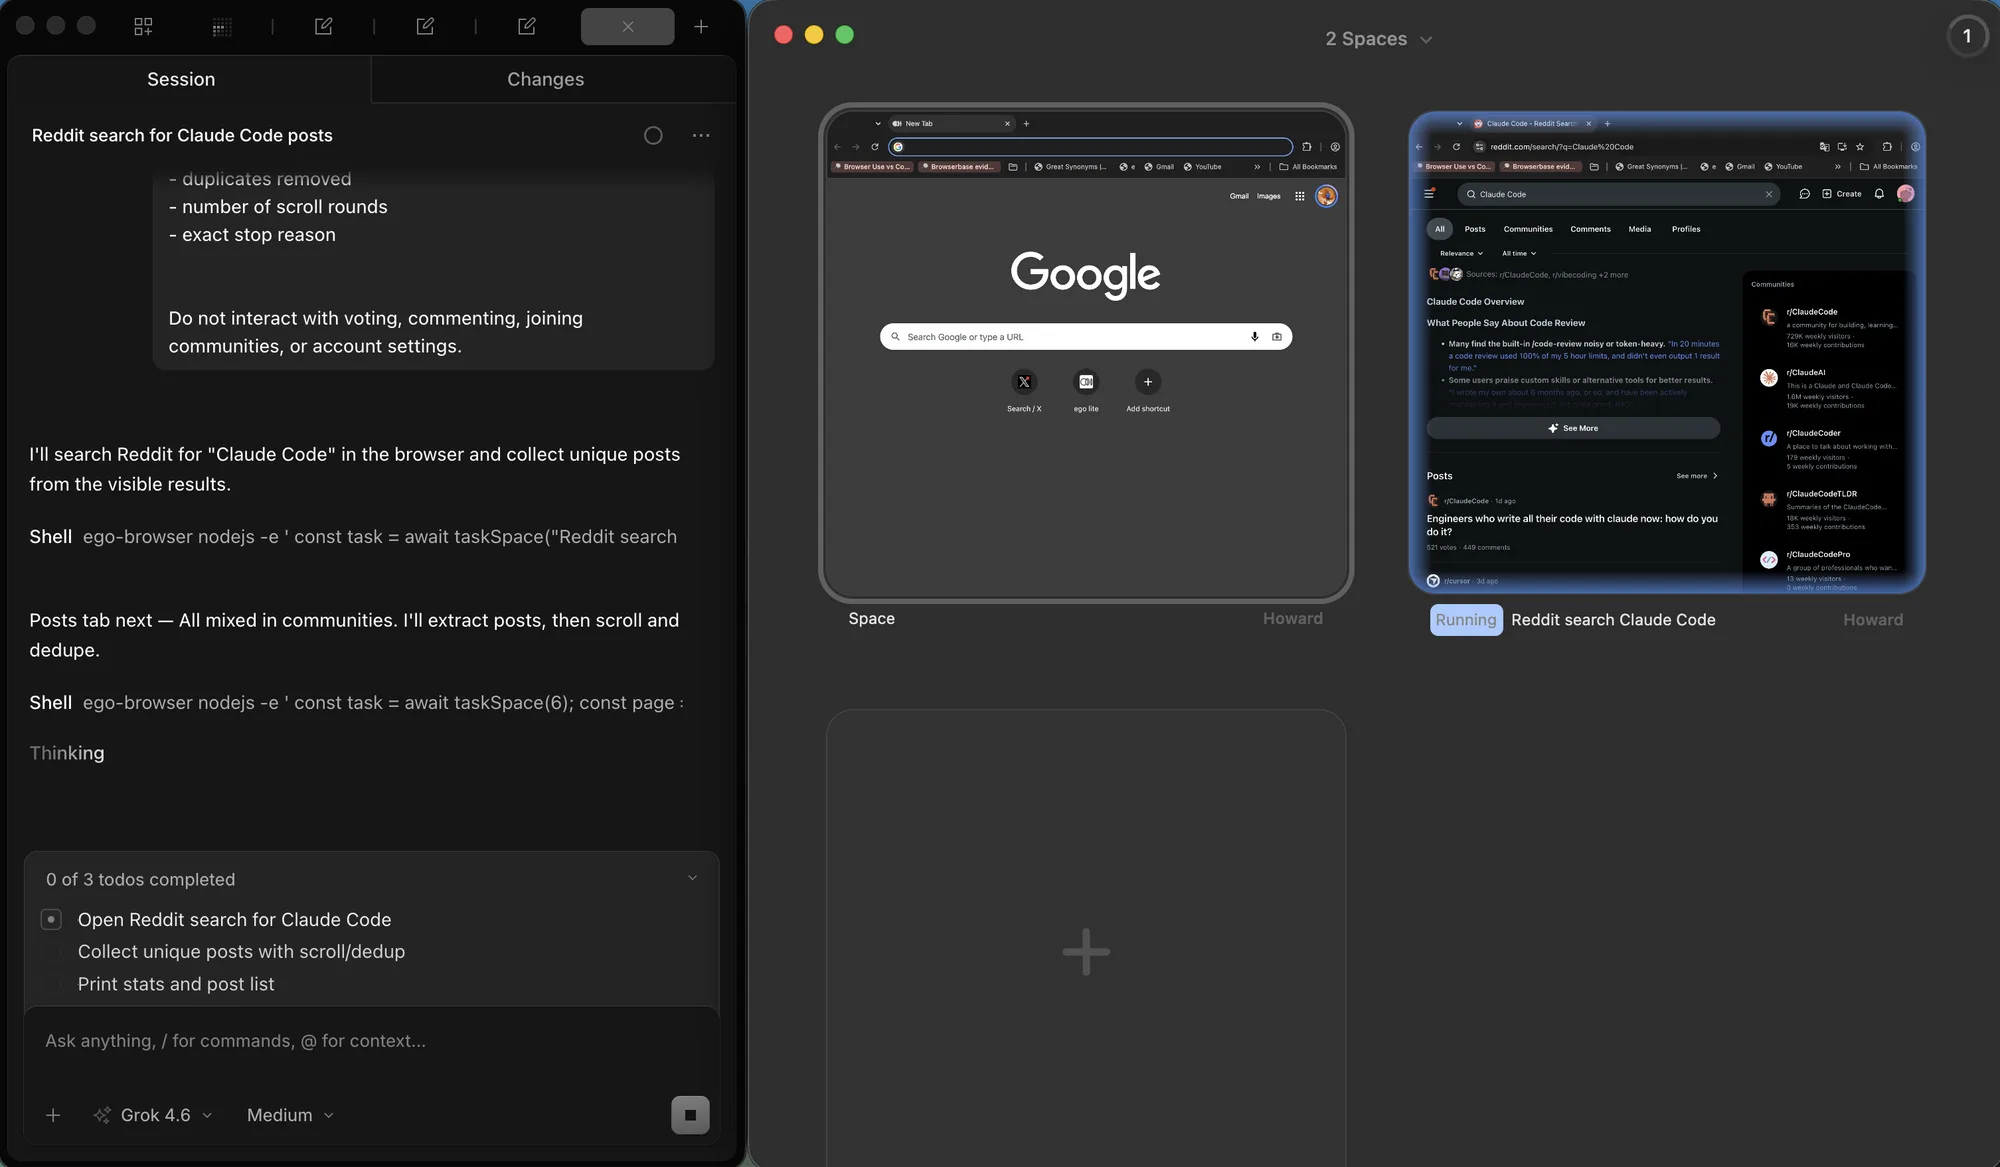
Die Isolationsregel der nummerierten Seiten gilt weiter. Zwei Crawler in einem Fenster kaempfen um die Scrollposition und ueberschreiben die zuletzt gesehene Zeile. Im selben Browser sind zwei Spaces zwei Playwright-Kontexte: einer kann auf Google idle bleiben, der andere scrollt weiter auf Reddit. Isolation ist der Punkt. Die Uebersicht zeigt nur beides gleichzeitig.
Version 0.5.0.32 steht im Changelog (2026-09-12). Prüfen Sie diese Seite, den Schnellstart und das GitHub-Repository, bevor Sie einen neueren Build zitieren. Der benachbarte Leitfaden Web Scraping mit JavaScript behandelt die Entscheidung statisch gegen gerendert von der anderen Seite.
FAQ
Woher weiß ich, wie viele Seiten eine nummerierte Liste hat?
Sie wissen, wie viele Seiten eine nummerierte Liste hat, indem Sie das Steuerelement der letzten Seite lesen, ein Header-Total durch die Seitengröße teilen und einmal bis zum Ende gehen. Behandeln Sie diese Schätzung als Prüfung, nicht als Stoppbedingung der Schleife.
Warum sammelt mein Scraper Duplikate zwischen Seiten?
Scraper sammeln Duplikate zwischen Seiten, wenn die darunterliegende Liste neu sortiert und ein Datensatz von einem Batch in den nächsten wandert. Deduplizieren Sie über eine stabile record id, nicht über den sichtbaren Titel, und protokollieren Sie, wie viele Duplikate Sie entfernt haben.
Wie lange soll ich nach einem Klick auf Load More warten?
Bis eine beobachtbare Bedingung wahr ist: die Zeilenzahl ist gestiegen, der disabled-Zustand des Buttons ist weg, oder eine bekannte Zeile aus dem nächsten Batch ist erschienen. Eine feste Verzögerung ist eine Schätzung, die funktioniert, bis das Netz langsam ist, und genau dann versagt sie.
Wie erkenne ich das Ende eines Infinite-Feeds?
Bevorzugen Sie ein explizites Signal, wenn die Site eines liefert, etwa eine gerenderte Ende-Meldung oder ein has-more-Flag in der Antwort. Fehlt beides, verlangen Sie mehrere aufeinanderfolgende Prüfungen ohne neue Items und ohne Höhenänderung im geladenen Inhalt, bevor Sie anhalten, nicht einen einzelnen ruhigen Moment.
Soll ich für Paginierungs-Scraping einen Headless-Browser nutzen?
Nur wenn die Daten Rendering, eine Sitzung oder Token in der Seite brauchen. Serverseitig gerenderte Listen und JSON-Endpunkte sind mit schlichtem HTTP besser bedient, das schneller und einfacher läuft. Messen Sie beide Wege einmal; der Vergleich macht die Entscheidung meist offensichtlich.
Was lässt einen paginierten Crawl früh anhalten?
Drei übliche Verdächtige: eine Wartezeit, die endete, bevor der Batch gerendert war, ein vorübergehender Fehler, der als leere Seite galt, und eine Sitzung, die mitten im Lauf ablief, sodass die nächste Seite das Login-Formular statt Zeilen zeigte. Jeder hat eine andere Behebung, deshalb sollte der Stoppgrund mit der Zahl protokolliert werden.
Wie setze ich einen Crawl nach einem Absturz fort?
Setzen Sie nach jedem abgeschlossenen Batch einen Checkpoint mit Modus, Position und bisher gesammelten Zeilen. Das Fortsetzen liest diese Datei und steigt im Modus an der gespeicherten Position wieder ein. Holen Sie einmal den Batch unmittelbar vor der Checkpoint-Position erneut, um zu bestätigen, dass sich die Quelle unter dem gespeicherten Zustand nicht verschoben hat.
Wie prüfe ich, dass ein Crawl vollständig ist?
Vergleichen Sie die Zahl eindeutiger Datensätze mit mindestens zwei unabhängigen Zahlen, etwa dem eigenen Total der letzten Seite und der Summe der Seitenzählungen, prüfen Sie dann die Feldvollständigkeit in jeder Zeile und melden Sie die Ausnahmen. Eine passende Zahl und durchgängig vorhandene Felder sind ein starkes Signal; jedes für sich ist schwach.
Muss ich langsam scrollen, um Lazy Loading auszulösen?
Meist nein, aber lösen Sie den Loader erneut aus, statt unten stehen zu bleiben. Sites nutzen Intersection Observer, die bei Änderung feuern, deshalb sind wechselnde Position oder schrittweises Scrollen zuverlässiger als ein großer Sprung, und die Wachstumsprüfung wird dadurch aussagekräftig.
Kann ich eine paginierte Liste hinter einem Login scrapen?
Ja, mit einer echten Sitzung und denselben Regeln: paginieren Sie höflich, halten Sie die Sitzung am Leben, und behandeln Sie eine Umleitung zur Login-Seite als Sitzungsproblem, nicht als Ende der Liste. Ein Browser, der Ihren Login bereits trägt, etwa ego (lite), nimmt den Schritt des Sitzungsnachbaus ganz heraus. Der Leitfaden zu persistenten Sitzungen behandelt den Umgang mit dem Zustand, und der Anwendungsfall Preis-Scraping zeigt, wie eine vollständige angemeldete Sammlung aussieht.