
JavaScript-रेंडर पेज सफल प्रतिक्रिया भी दे सकता है, और फिर भी आपके स्क्रैपर के पास शून्य पंक्तियाँ रह जाती हैं। HTML लोड हो चुका है, लेकिन ब्राउज़र में यूज़र को दिखने वाले कार्ड DOM में अभी हो ही नहीं सकते। ego (lite) में यह गैप दिखता है। आपका काम एक देखे जा रहे Chromium Space के अंदर चलता है, इसलिए आप देख सकते हैं कि पेज अभी रेंडर हो रहा है, सेलेक्टर मैच नहीं कर रहा, या जिस डेटा की ज़रूरत है वह कभी आया ही नहीं।
Playwright उस पुष्टि किए व्यवहार को स्थिर, दोहराए जाने वाले स्क्रैपिंग वर्कफ़्लो में बदल देता है। यह टारगेट कार्ड के रेंडर होने का इंतज़ार कर सकता है, लाइव DOM से फ़ील्ड निकाल सकता है, और जाँच सकता है कि नतीजे में वही डेटा है जिसकी आपने उम्मीद की थी। एक बार सेलेक्टर और wait की शर्त पता चल जाए, तो Playwright उन्हें भरोसेमंद स्क्रिप्ट में बाँधने का स्वाभाविक तरीका है। जब काम में अभी भी आँख से देखना, पहले से साइन-इन ब्राउज़र सत्र, या किसी खास चरण पर किसी व्यक्ति का नियंत्रण लेना पड़े, तो ego (lite) ब्राउज़र स्टेट को दिखता और इंटरैक्टिव रखता है, ताकि सफल exit वाली स्क्रिप्ट यह छिपा न सके कि असल में उसने कुछ स्क्रैप ही नहीं किया।
Playwright से वेब स्क्रैपिंग क्या है?
Playwright से वेब स्क्रैपिंग का मतलब है असली ब्राउज़र चलाना ताकि JavaScript पेज पेंट कर सके, फिर रेंडर हुए नोड पढ़ना। ब्राउज़र ही स्क्रैपर है। स्क्रिप्ट चलने तक HTML प्रतिक्रिया सिर्फ़ शेल है।
Playwright, Chromium, Firefox या WebKit लॉन्च करता है, एक context खोलता है, और आपको page.goto, wait, locator और page.evaluate देता है। ये API टेस्ट के लिए बने हैं। एक्सट्रैक्शन पर भी चलते हैं, क्योंकि दोनों काम को एक ही चीज़ चाहिए: वह DOM जो व्यक्ति को दिखता है।
आस-पास के काम इस पेज से बाहर रहते हैं।
JavaScript में fetch बनाम ब्राउज़र का चुनाव यहाँ कवर है: JavaScript से वेब स्क्रैपिंग। रनों के बीच साइन-इन सत्र दोबारा इस्तेमाल करना यहाँ कवर है: पर्सिस्टेंट ब्राउज़र सत्र। X और LinkedIn की लॉगिन दीवारें यहाँ कवर हैं: लॉगिन दीवारों के पीछे AI स्क्रैपिंग। नंबर वाले पेज, Load More और infinite scroll तब तक रुकते हैं जब तक यह एक पेज सही पंक्तियाँ लौटा न दे।
HTTP की जगह Playwright से स्क्रैप कब करें?
Playwright तब इस्तेमाल करें जब URL के GET में वे नोड न हों जिन्हें आप स्क्रैप करना चाहते हैं। HTTP तब इस्तेमाल करें जब वैल्यू पहले से प्रतिक्रिया के बॉडी में हों, या पेज पहले से कोई डॉक्युमेंटेड JSON एंडपॉइंट दिखाता हो।
quotes.toscrape.com/js जानबूझकर ऐसा बनाया गया है। URL का GET ऐसा HTML लौटाता है जिसमें class="quote" नोड नहीं होते। कोट्स एक inline var data ऐरे में बैठे होते हैं, फिर jQuery कार्ड पेंट करता है। raw प्रतिक्रिया पर .quote की ओर इशारा करता CSS पार्सर कुछ सेव नहीं करता और सेलेक्टर बग जैसा लगता है।
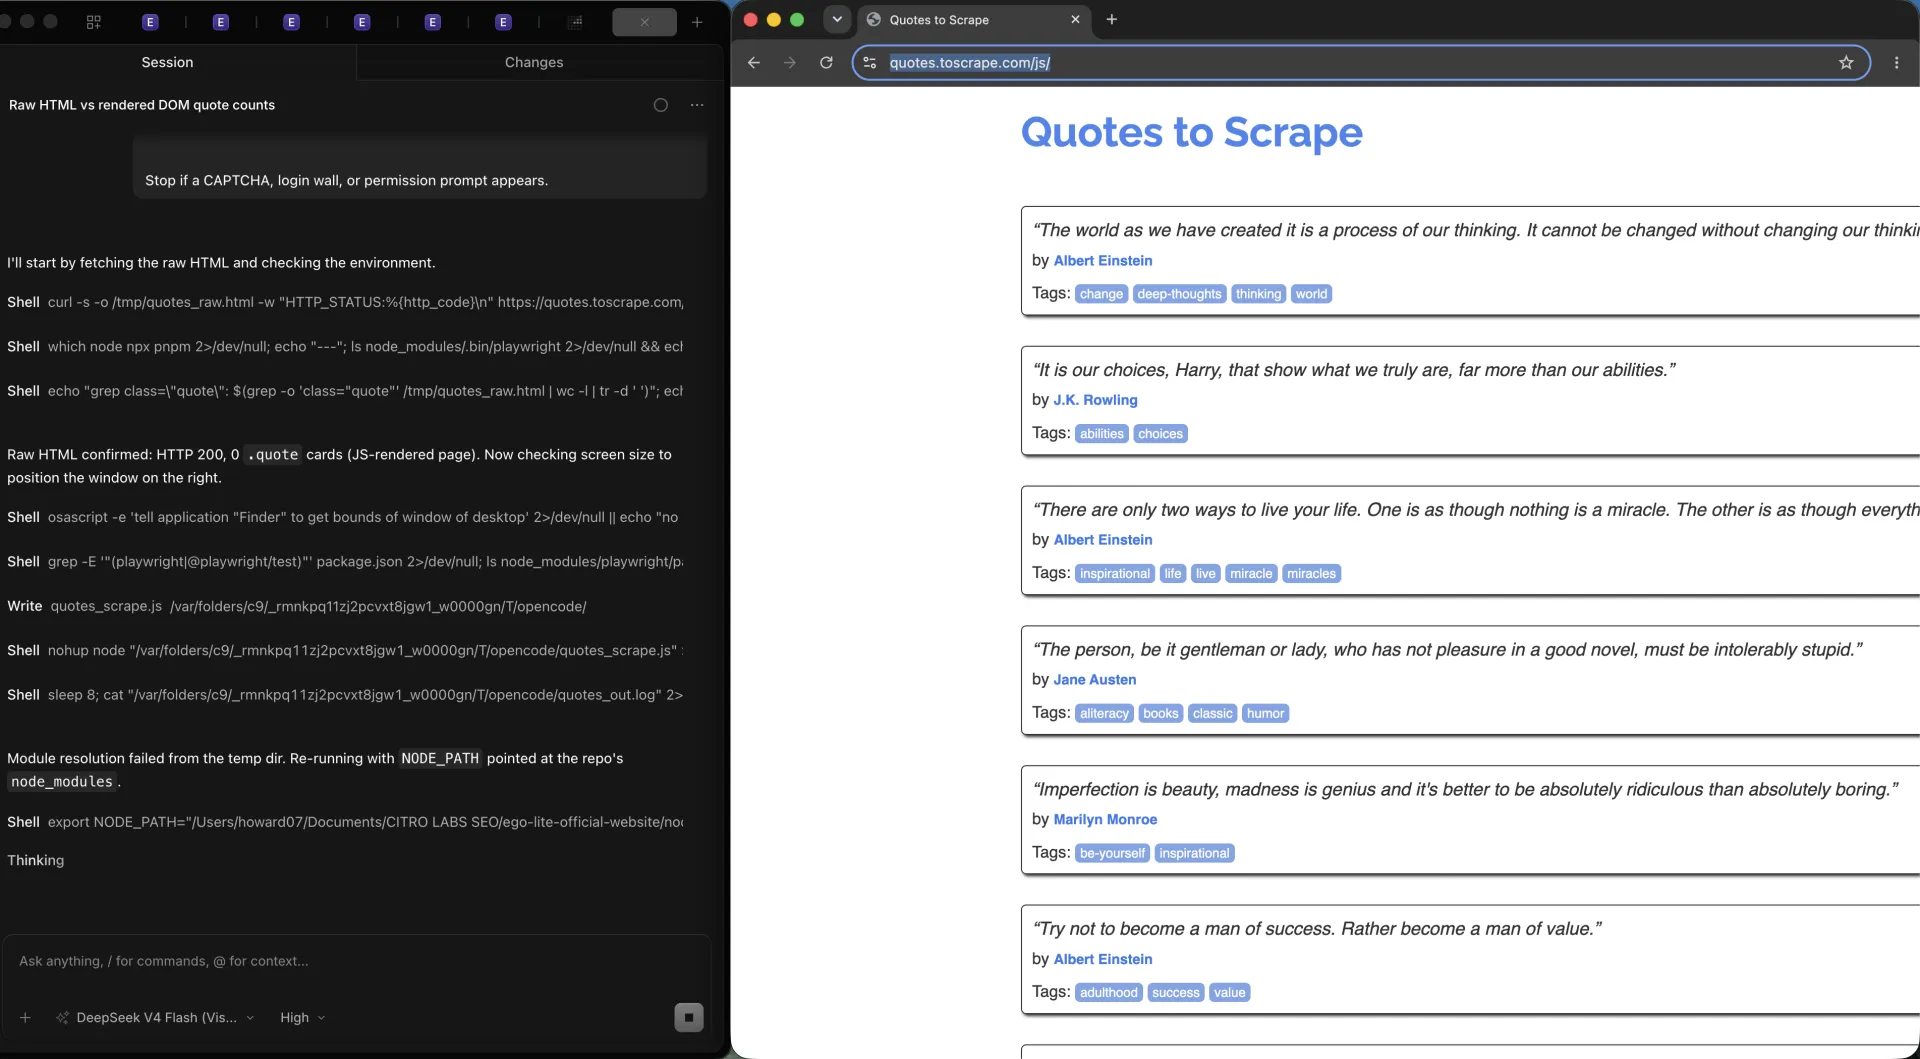
हमने वह फ़र्क 2026-09-18 को OpenCode से टेस्ट किया। quotes.toscrape.com/js के GET ने HTTP 200 और raw HTML में 0 .quote कार्ड लौटाए, जबकि दाईं ओर headed Chromium विंडो पहले से पेंट की गई लिस्ट दिखा रही थी।
इस फ़र्क को इस तरह देखें।
| रूट | यह क्या कर सकता है | यह क्या नहीं कर सकता |
|---|---|---|
| HTTP GET + HTML पार्सर | सर्वर ने जो बाइट भेजे, उन्हें पढ़ना। सस्ता, तेज़, और तब काफी जब कार्ड पहले से मार्कअप में हों। | पेज स्क्रिप्ट चलाना या बाद में आने वाले नोड का इंतज़ार करना संभव नहीं। quotes.toscrape.com/js पर raw HTML में इसे .quote कार्ड नहीं दिखते। |
| inline पेलोड पार्स करें | quotes.toscrape.com/js पर regex और var data का JSON.parse उसी HTML से कोट्स निकाल सकता है, बिना ब्राउज़र के। | ऐसे रीडिज़ाइन को सहना जिसमें ऐरे एम्बेड होना बंद हो जाए। आंतरिक पेलोड कोई API अनुबंध नहीं हैं। |
| Playwright रेंडर हुआ DOM | पेज की JavaScript चलाएँ, .quote का इंतज़ार करें, और वे कार्ड निकालें जो व्यक्ति देखता है। | सस्ता बने रहना। हर context मेमोरी लेता है, और उनका बेड़ा स्टैटिक HTML के लिए गलत टूल है। |
इस डेमो पर ईमानदार अतिरिक्त बात: अगर var data सीधे पार्स हो जाए तो Playwright ज़रूरी नहीं। ज़्यादातर JS साइटें पहली प्रतिक्रिया में नाम वाला ऐरे नहीं छोड़तीं। Playwright वही रूट है जो तब भी चलता है जब वे नहीं छोड़तीं।
लॉन्च, नेविगेट और कंटेंट का इंतज़ार कैसे करें?
न्यूनतम Playwright स्क्रैप है launch, नया context, goto, कार्ड सेलेक्टर का इंतज़ार, निकालना, फिर close। wait छोड़ना ही सफल खाली फ़ाइल पाने का तरीका है।
Playwright के page.goto commit, domcontentloaded, load या networkidle पर रुक सकते हैं। waitForSelector वही जाँच है कि जिसके लिए आप आए थे वह असल में मौजूद है। quotes.toscrape.com/js पर goto({ waitUntil: 'domcontentloaded' }) पहले से काफी हो सकता है, क्योंकि inline स्क्रिप्ट उसी HTML में चलती है। यह किस्मत है, नियम नहीं।
import { chromium } from "playwright";

const browser = await chromium.launch();
const context = await browser.newContext();
const page = await context.newPage();

try {
  await page.goto("https://quotes.toscrape.com/js/", {
    waitUntil: "domcontentloaded",
  });
  await page.waitForSelector(".quote");
  const rows = await page.evaluate(() =>
    [...document.querySelectorAll(".quote")].map((el) => ({
      text: el.querySelector(".text")?.textContent?.trim() ?? "",
      author: el.querySelector(".author")?.textContent?.trim() ?? "",
      tags: [...el.querySelectorAll(".tag")].map((tag) =>
        tag.textContent?.trim(),
      ),
    })),
  );
  console.log(rows.length);
} finally {
  await context.close();
  await browser.close();
}
खाली स्क्रैप देखने के लिए कार्ड आने से पहले commit पर निकालें, या उन्हें पेंट करने वाली स्क्रिप्ट को देर से चलाएँ। वह जल्दी extract 0 पंक्तियाँ लौटाता है। waitForSelector('.quote') के बाद वही पेज रेंडर हुए कार्ड लौटाता है। खाली मामले में कुछ throw नहीं होता।
| इंतज़ार | यह क्या साबित करता है | यह कैसे फेल होता है |
|---|---|---|
| सिर्फ़ commit | नेविगेशन शुरू हुआ। नेगेटिव टेस्ट के रूप में काम आता है। | स्क्रिप्ट अभी चली ही न हों। painter चलने से पहले commit पर extract 0 कोट्स लौटाता है। |
| domcontentloaded | शुरुआती HTML पार्स हो चुका है। इस फ़िक्स्चर पर काफी है क्योंकि var data उसी HTML में चलता है। | देर से आने वाले XHR कार्ड अभी भी गायब हो सकते हैं। इसे 'कंटेंट तैयार है' न मानें। |
| waitForSelector('.quote') | DOM में कम से कम एक कार्ड मौजूद है। यही वह wait है जो इस डेमो को स्क्रैप करने लायक पंक्तियाँ बनाता है। | पुरानी class पिछली लिस्ट से मैच कर सकती है। ऐसे फ़ील्ड पर wait करें जो डेटा के साथ बदलता है, उस रैपर पर नहीं जो कभी जाता ही नहीं। |
finally में context बंद करें। Context मेमोरी पकड़े रहते हैं। बीच extract में throw करने वाला स्क्रैप भी Chromium छोड़ना पड़ता है।
रेंडर हुए पेज से फ़ील्ड कैसे निकालें?
पेज के अंदर page.evaluate से निकालें, या जब पूरी लिस्ट के बजाय एक कंट्रोल चाहिए तो locator से। दोनों रेंडर हुए DOM पढ़ते हैं। कोई भी goto के मूल HTML स्नैपशॉट को नहीं पढ़ता।
हर .quote को text, author और tags पर मैप करें। सार्वजनिक डेमो दस कार्ड पेंट करता है। ज़रूरी फ़ील्ड text और author हैं। unique key कोट का टेक्स्ट है, author नहीं, क्योंकि Einstein एक से ज़्यादा बार आता है।
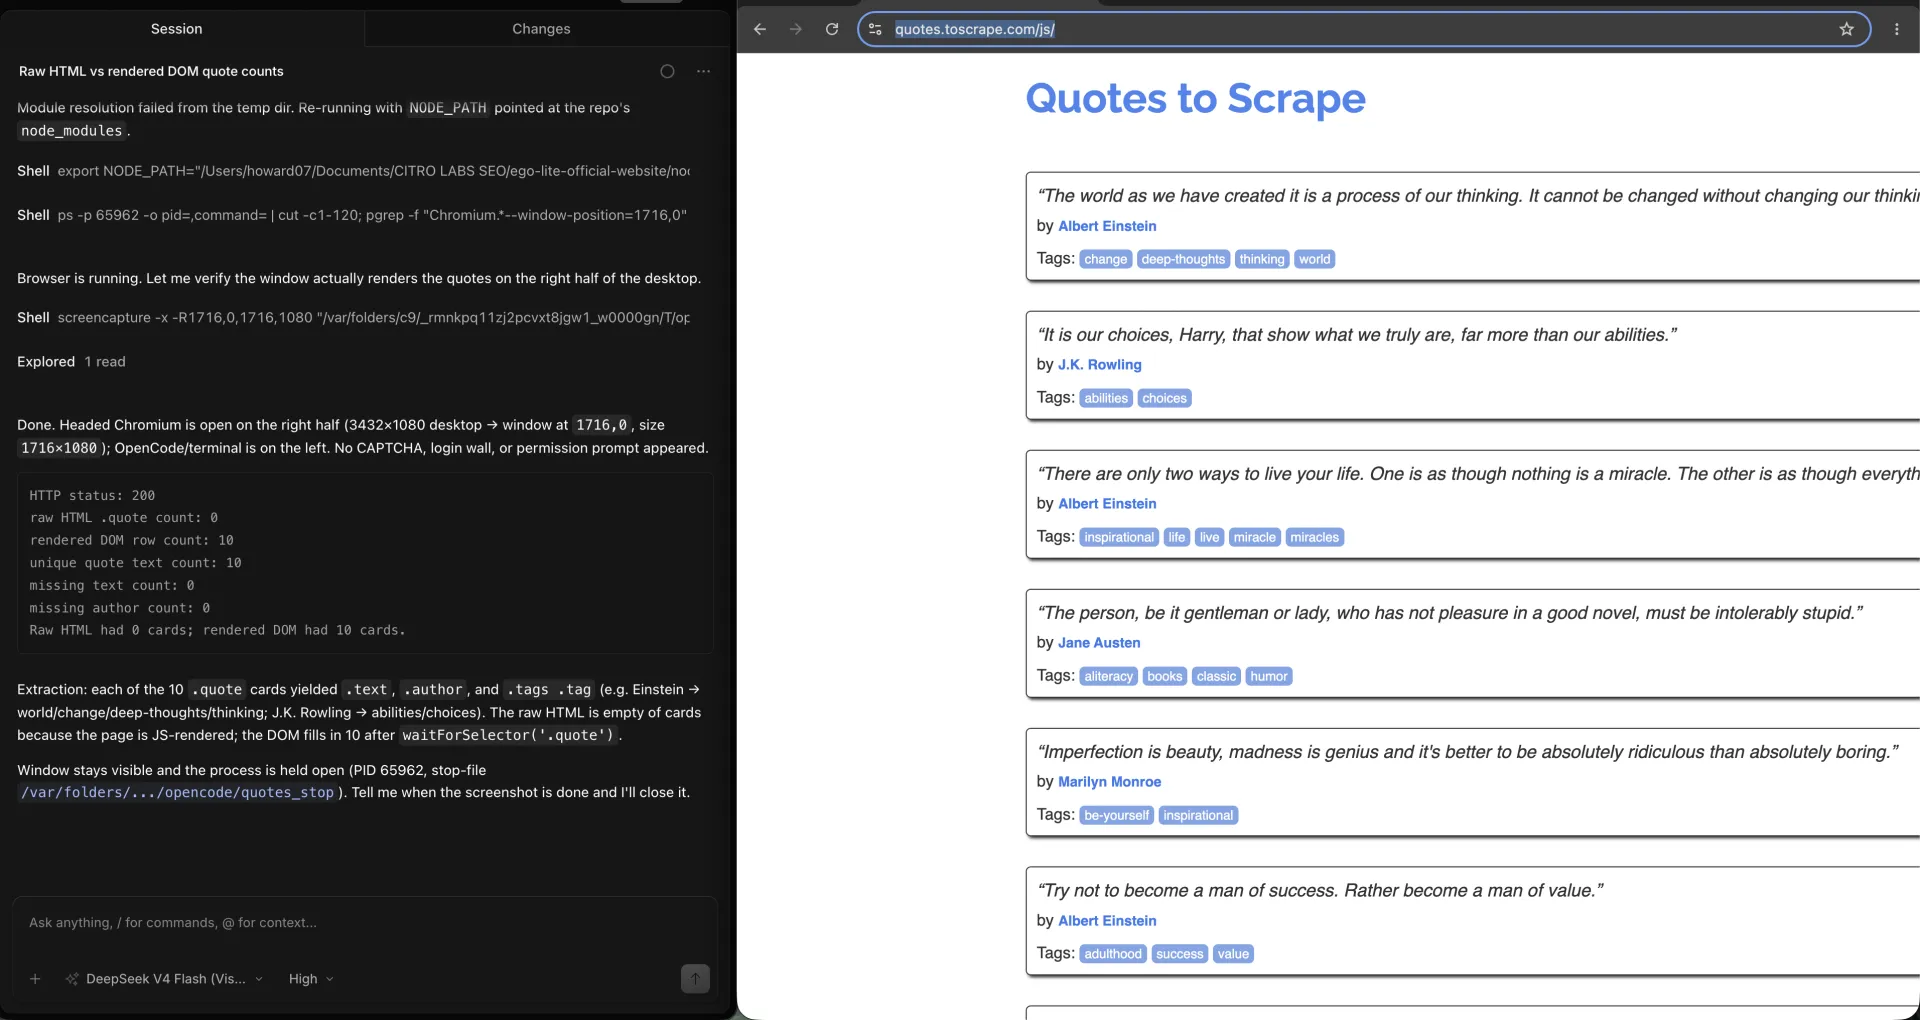
हमने वह extract उसी OpenCode सत्र में टेस्ट किया। waitForSelector('.quote') के बाद headed रन ने 10 पंक्तियाँ, 10 unique टेक्स्ट और 0 गायब author प्रिंट किए। raw HTML में अभी भी 0 कार्ड थे।
एक फ़ील्ड के लिए locator ज़्यादा साफ़ रास्ता हैं। Playwright locators हर एक्शन से पहले दोबारा क्वेरी करते हैं, इसलिए वे उस री-रेंडर को सह लेते हैं जो स्टोर किए element handle को तोड़ देता है।
const title = await page.locator(".quote .text").first().innerText();
const author = await page.locator(".quote .author").first().innerText();
लिस्ट निकालने के लिए page.evaluate बेहतर है। यह पेज के अंदर चलता है और JSON लौटाता है। mapper छोटा रखें। text, author, tags और एक unique key निकालें। स्क्रैप लूप से स्क्रीनशॉट और PDF बाहर रखें।
CSS से छिपा टेक्स्ट भी DOM में बैठता है। innerText लेआउट का पालन करता है। textContent नहीं। अगर कोई साइट CSS से टाइटल काटती है, तो textContent फिर भी पूरी स्ट्रिंग देगा। वैलिडेटर लिखने से पहले तय करें कि आप कौन सा इकट्ठा कर रहे हैं।
पेज का अपना डेटा कैसे इंटरसेप्ट करें?
Interception तब काम आता है जब पेज पहले से ऐसा JSON fetch करता हो जिसे कार्ड से पार्स करने के बजाय सेव किया जा सके। quotes.toscrape.com/js पर वह अनुरोध कभी चलता ही नहीं, और बात यही है।
उस डेमो के कोट्स किसी API से नहीं आ रहे। वे HTML में var data के रूप में एम्बेड हैं, फिर jQuery उन्हें .quote नोड में पेंट करता है। JSON ढूँढता response listener कुछ काम का नहीं देखेगा।
Playwright के network डॉक्स page.route और response listener दिखाते हैं। उन्हें इस्तेमाल करें। फिर रिकॉर्ड करें कि पेज ने असल में क्या भेजा, कुछ नहीं सहित।
const jsonResponses = [];
page.on("response", async (response) => {
  const type = response.headers()["content-type"] || "";
  if (type.includes("json")) {
    jsonResponses.push({
      url: response.url(),
      status: response.status(),
    });
  }
});
await page.goto(url, { waitUntil: "domcontentloaded" });
await page.waitForSelector(".quote");
console.log(jsonResponses.length);
जब JSON बॉडी न हो, तो रेंडर हुए कार्ड पर जाएँ या वह inline स्क्रिप्ट पार्स करें जो आप पहले ही डाउनलोड कर चुके। एंडपॉइंट इसलिए मत गढ़ें कि ट्यूटोरियल हमेशा एक दिखाते हैं। Oxylabs, BrowserStack और ScraperAPI सभी intercept दिखाते हैं। वे यह नहीं बताते कि साइट अनुरोध चलाए ही नहीं तो क्या होता है।
फ़ील्ड, डुप्लिकेट और काउंट कैसे जाँचें?
स्क्रैप तब पूरा नहीं होता जब स्क्रिप्ट 0 से exit करे। तब पूरा होता है जब फ़ाइल में अपेक्षित काउंट हो, हर ज़रूरी फ़ील्ड मौजूद हो, और unique key दो पंक्तियों को एक में न मिला दे।
इस डेमो पर पास extract दस पंक्तियाँ लिखता है, unique टेक्स्ट के साथ और बिना गायब author के। कार्ड आने से पहले का extract 0 पंक्तियाँ लिखता है, उसी खुश लॉगर के साथ, जब तक काउंट न जाँचा जाए।
function validate(rows, expectedCount) {
  const missing = rows.filter((row) => !row.text || !row.author);
  const unique = new Set(rows.map((row) => row.text));
  if (rows.length !== expectedCount) {
    throw new Error(`expected ${expectedCount}, got ${rows.length}`);
  }
  if (missing.length) {
    throw new Error(`${missing.length} rows missing text or author`);
  }
  if (unique.size !== rows.length) {
    throw new Error("duplicate texts");
  }
}
छोटी चेकलिस्ट इस्तेमाल करें और साफ़ फेल हों।
| जाँच | पास | रखने लायक फेल मोड |
|---|---|---|
| अपेक्षित काउंट | waitForSelector('.quote') के बाद दस कार्ड | painter से पहले extract चलने पर 0 पंक्तियाँ |
| ज़रूरी फ़ील्ड | हर पंक्ति पर text और author | ऐसा सेलेक्टर जो कार्ड से मैच करे लेकिन .author छोड़ दे |
| यूनिक key | Unique quote टेक्स्ट, unique author नहीं | author पर dedupe, जो Einstein को मिला देगा |
खाली extract रखें। 0-पंक्ति वाला नतीजा सबूत है कि wait मायने रखता है। उसे मिटाने से बाद का पूरा extract डिफ़ॉल्ट जैसा लगने लगता है।
Playwright स्क्रैप कहाँ टूटता है?
यहाँ जो फेलियर मायने रखते हैं वे खाली रेंडर, पुराने सेलेक्टर और रेट लिमिट हैं। अगर आप सिर्फ़ ऐसी catch के बाद पंक्ति की लंबाई लॉग करते हैं जो एरर निगल जाती है, तो इनमें से कोई भी लाल स्टैक ट्रेस जैसा नहीं दिखता।
खाली रेंडर: नेविगेशन सफल रहा, सेलेक्टर कभी मैच नहीं हुआ, आपने [] सेव कर लिया। wait ठीक करें। उसी अधूरे DOM पर वही extract दोबारा न चलाएँ।
पुराना सेलेक्टर: .quote अभी भी मौजूद है, लेकिन टेक्स्ट खिसक गया। रन कल की 10 पंक्तियाँ लौटाता है। ऐसे फ़ील्ड पर wait करें जो कंटेंट के साथ बदलता है, फिर unique key की तुलना पिछली फ़ाइल से करें।
रेट लिमिट: 429 एक रुकने का संकेत है। Retry-After हो तो पढ़ें, बैक ऑफ़ करें, और retry की सीमा बाँधें। उसी URL को पीटना IP ब्लॉक करवाने का तरीका है, और यह गाइड bypass कवर नहीं करती।
async function gotoWithRetry(page, url, attempt = 0) {
  const response = await page.goto(url, { waitUntil: "domcontentloaded" });
  const status = response?.status() ?? 0;
  if (status === 429 || status >= 500) {
    if (attempt >= 3) throw new Error(`giving up on ${url}: ${status}`);
    const retryAfter = Number(response?.headers()["retry-after"]);
    const waitMs = Number.isFinite(retryAfter)
      ? retryAfter * 1000
      : 2 ** attempt * 1000;
    await page.waitForTimeout(waitMs);
    return gotoWithRetry(page, url, attempt + 1);
  }
  if (status && status >= 400) throw new Error(`${status} for ${url}`);
  return response;
}दिखने वाला ब्राउज़र एजेंट कब बेहतर रास्ता है?
दिखने वाला ब्राउज़र एजेंट तब बेहतर रास्ता है जब wait गलत हो, सेलेक्टर खिसक गया हो, या किसी व्यक्ति को पेज देखकर नियंत्रण लेना पड़े। यह उस जमे Playwright लूप का विकल्प नहीं जिसे आप पहले से CI में भरोसा करते हैं।
यह पूरक है, प्रतिद्वंद्वी नहीं। Playwright उसी wait को बाँधता है जो पहले से समझ आ चुका है। ego (lite) 0.5.0.32 काम को एक देखे जा रहे Chromium Space में रखता है ताकि कार्ड आते दिखें, एजेंट रोका जा सके, या wait झूठ बोल रहा हो तो कोई व्यक्ति नियंत्रण ले सके। अगले स्क्रैप को पहले से मौजूद लॉगिन चाहिए तो यह असली प्रोफ़ाइल दोबारा इस्तेमाल करता है। यह स्टैटिक HTML पेज सस्ता नहीं बनाता, और ब्लॉक बायपास नहीं करता। उस वर्शन का changelog 2026-09-12 को ego (lite) चेंजलॉग पर है।
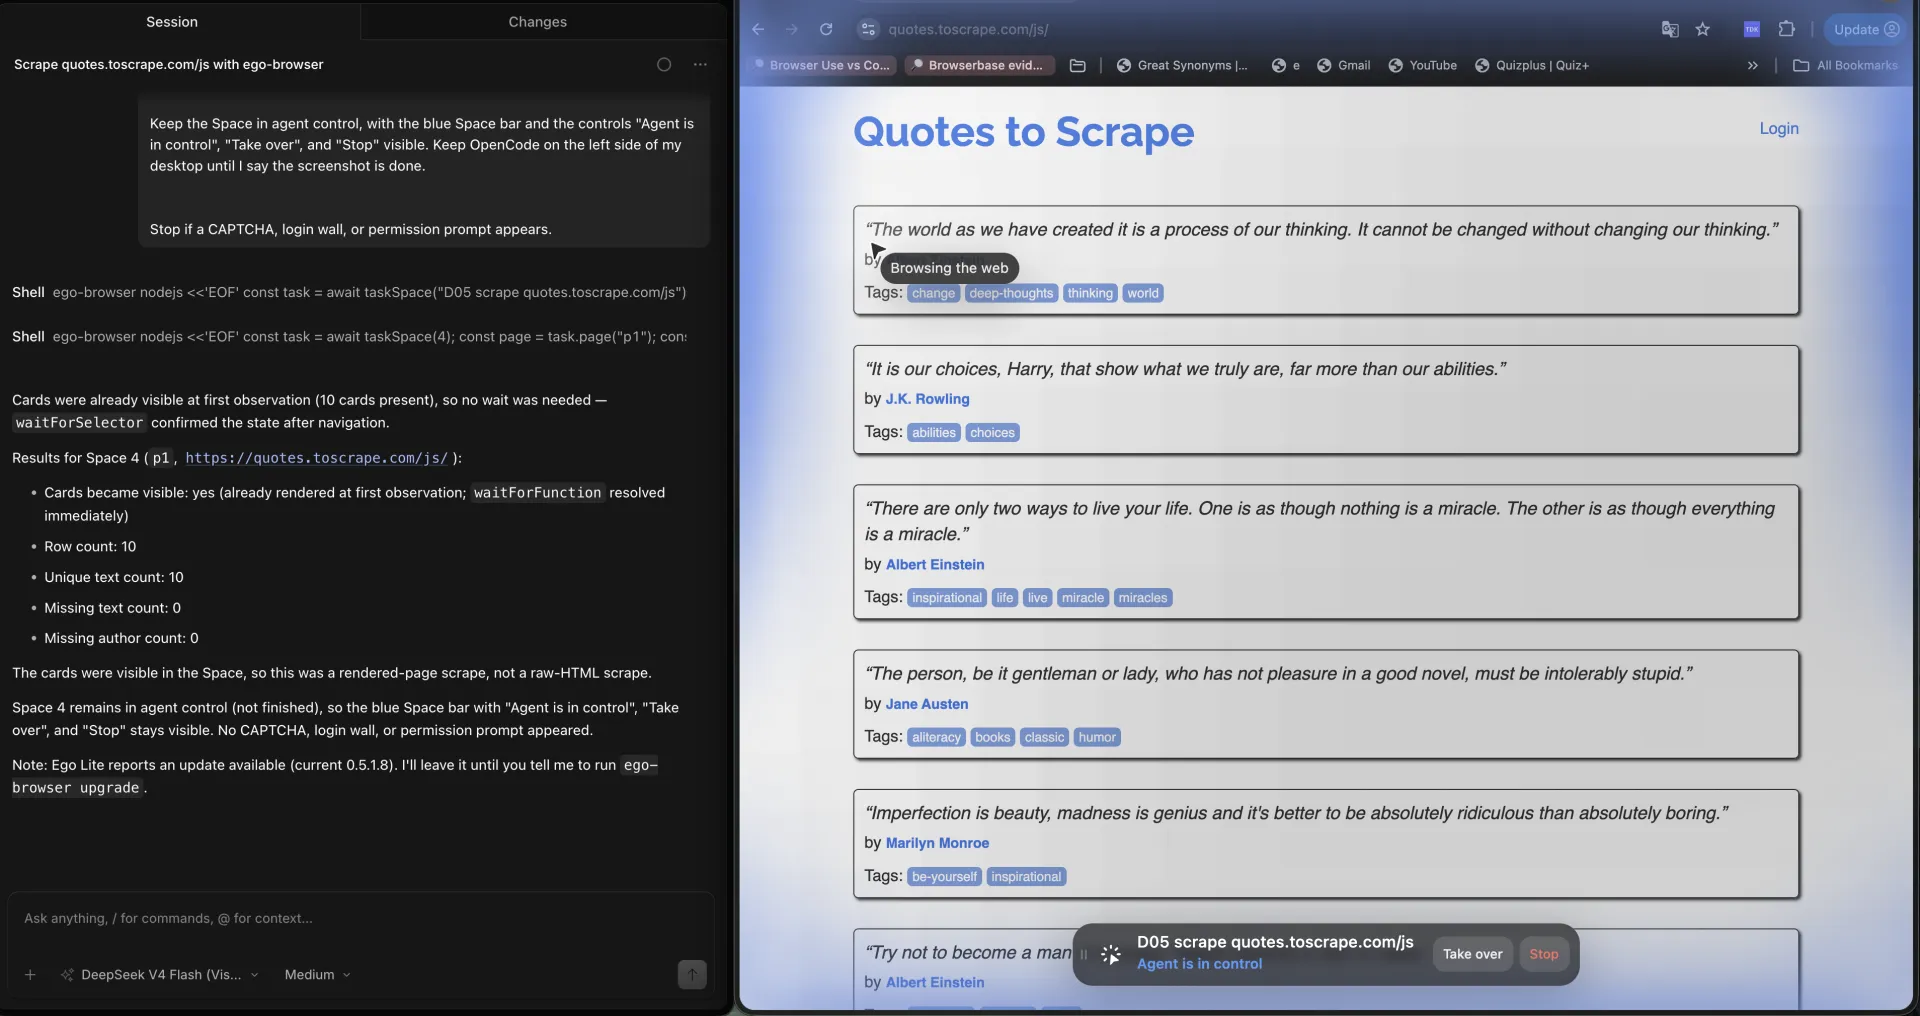
हमने वह आइसोलेशन ego (lite) में OpenCode से टेस्ट किया। Spaces ओवरव्यू ने quotes स्क्रैप को उसके अपने चलते Space में रखा, बाकी काम अलग Space में, एक headed Chromium विंडो साझा करने के बजाय।
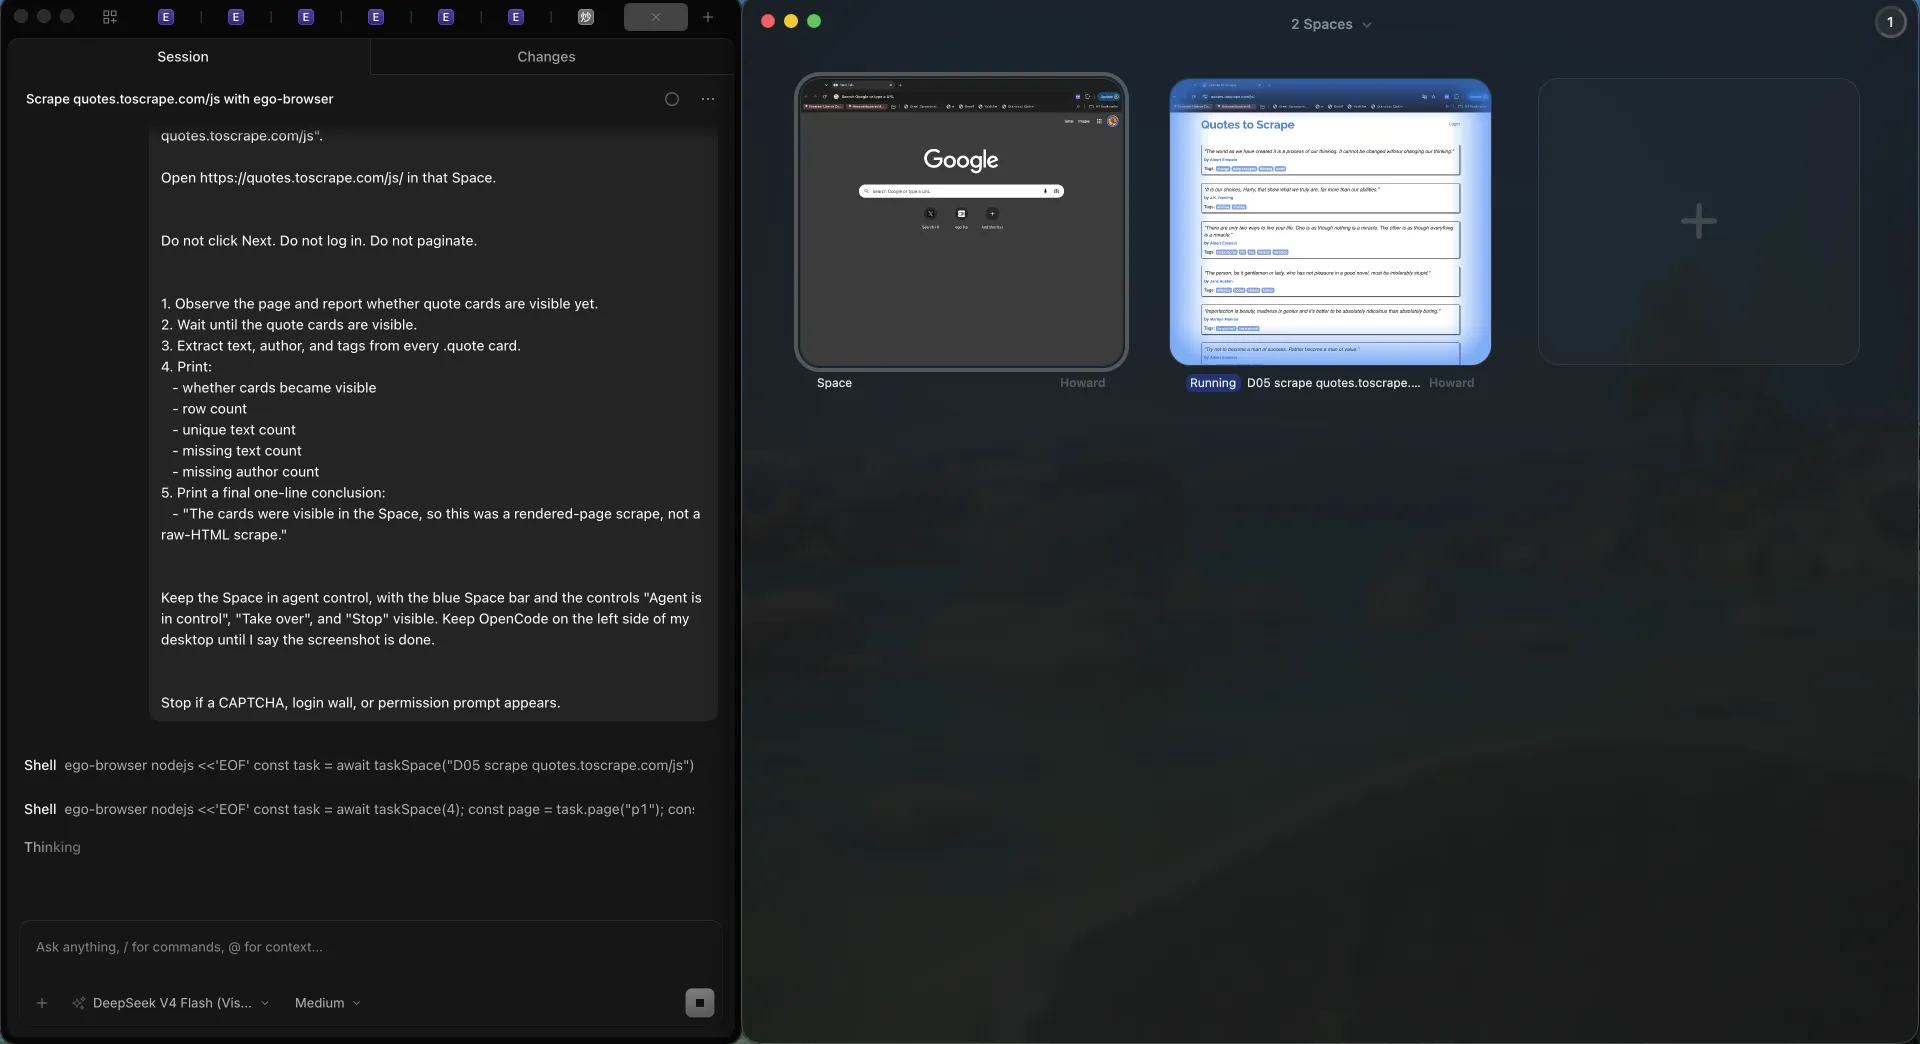
हमने वही सार्वजनिक URL उन Space में से एक के अंदर टेस्ट किया। Space 4, quotes.toscrape.com/js पर एजेंट नियंत्रण में रहा, Take over और Stop दिख रहे थे, और 10 unique कार्ड प्रिंट हुए।
हेडलेस बनाम headed ट्रेड-ऑफ़ यहाँ कवर हैं: AI एजेंट्स के लिए हेडलेस ब्राउज़र बनाम असली ब्राउज़र। लाइब्रेरी का चुनाव यहाँ कवर है: स्क्रैपिंग के लिए Playwright बनाम Puppeteer। प्रोडक्ट-स्तरीय फ़र्क यहाँ है: ego (lite) बनाम Playwright पर है।
चुनौतियाँ और सीमाएँ क्या हैं?
Playwright स्क्रैपिंग, HTTP स्क्रैपिंग से ज़्यादा चुप तरीकों से फेल होती है, क्योंकि ब्राउज़र ठीक दिख सकता है जबकि फ़ाइल गलत हो।
पहली सीमा लागत है। एक Chromium context एक GET नहीं है। अगर कार्ड पहले से HTML में हैं, तो आप ऐसे ब्राउज़र की कीमत चुका रहे हैं जिसकी ज़रूरत नहीं।
दूसरी, intercept पर ईमानदारी। ट्यूटोरियल XHR कैप्चर को एडवांस्ड चाल मानते हैं। इस डेमो पर एडवांस्ड चाल यह मानना है कि पेलोड inline है।
तीसरी, नंबर वाले पेज, Load More और infinite scroll हैं, और यहाँ यह एक-लाइन सीमा रहती है। एक रेंडर हुआ पेज जाँच लेने के बाद वे अपना काम बन जाते हैं। उन लूपों को इस wait-और-extract पेज में मिलाने से खाली-DOM फेलियर छिप जाएगी।
चौथी, अनुमति। robots नियम, शर्तें और व्यक्तिगत डेटा कानून अभी भी लागू रहते हैं। Headed ब्राउज़र इकट्ठा करने का अधिकार नहीं बनाता।
अगर स्क्रैप खाली है और पेज भरा दिखता है, तो कार्ड का इंतज़ार करें, फिर पंक्तियाँ गिनें। Headed विंडो सबूत नहीं है। इस फ़िक्स्चर पर intercept ने कोई JSON XHR भी नहीं पाया; कोट्स पहले से var data के रूप में inline थे।
अक्सर पूछे जाने वाले प्रश्न
क्या Playwright वेब स्क्रैपिंग के लिए अच्छा है?
Playwright स्क्रैपिंग के लिए तब अच्छा है जब दिखने वाले कार्ड raw HTML में गायब हों और स्क्रैपर असली ब्राउज़र में उनका इंतज़ार कर सके। quotes.toscrape.com/js सार्वजनिक उदाहरण है: GET कोई .quote नोड नहीं लौटाता, और .quote का wait पेंट किए कार्ड पढ़ता है। स्टैटिक HTML या डॉक्युमेंटेड API के लिए यह गलत डिफ़ॉल्ट है।
Playwright की जगह HTTP कब इस्तेमाल करूँ?
HTTP तब इस्तेमाल करें जब वैल्यू पहले से प्रतिक्रिया के बॉडी में हों। JavaScript डेमो में अभी भी var data के साथ कोट्स हैं, भले .quote कार्ड न हों। अगर उस पेलोड का पार्सर स्थिर है, तो ब्राउज़र छोड़ दें।
मेरे Playwright स्क्रैप ने शून्य पंक्तियाँ क्यों लौटाईं?
शून्य पंक्तियाँ आमतौर पर मतलब है कि extract कार्ड आने से पहले चल गया। painter चलने से पहले commit पर DOM पढ़ना इस डेमो पर 0 कोट्स लौटाता है, फिर waitForSelector('.quote') के बाद रेंडर हुए कार्ड, खाली मामले में कोई exception नहीं।
क्या मुझे networkidle का इंतज़ार करना चाहिए?
उस सेलेक्टर का इंतज़ार करें जो डेटा को दर्शाता है, शांत नेटवर्क का नहीं। networkidle एनालिटिक्स बीकन पर लटक सकता है। इस डेमो पर पास wait .quote है, networkidle नहीं।
Playwright से JSON कैसे इंटरसेप्ट करूँ?
उन प्रतिक्रियाओं को सुनें जिनके content-type में json हो, या उस URL को route करें जिसे पेज पहले से कॉल करता है। quotes.toscrape.com/js पर कोट्स inline हैं, इसलिए कैप्चर करने को कोई JSON XHR नहीं। Intercept वैकल्पिक है। DOM wait फिर भी चलता है।
Playwright से कई पेजों वाली लिस्ट कैसे स्क्रैप करूँ?
पहले एक रेंडर हुआ पेज पूरा करें: wait, निकालें, काउंट जाँचें। नंबर वाले पेज, Load More और infinite scroll अलग काम हैं। यह पेज वे लूप लागू नहीं करता।
Playwright स्क्रैप में लॉगिन कैसे दोबारा इस्तेमाल करूँ?
जिस लॉगिन के उपयोग की आपको अनुमति है उसके बाद storage state सेव करें, फिर बाद के context में लोड करें। फ़ाइल को सीक्रेट मानें और यह उम्मीद रखें कि वह समाप्त होगी।
429 आने पर क्या करूँ?
रुकें, Retry-After हो तो उसका सम्मान करें, बैक ऑफ़ करें, और छोटी retry सीमा के बाद फेल हों। 429 रेट संकेत है, सेलेक्टर की समस्या नहीं।
क्या Playwright स्क्रैपिंग के लिए ego (lite) चाहिए?
नहीं। जब wait और सेलेक्टर पहले से पता हों तो Playwright इस्तेमाल करें। जब स्क्रैप को देखा जा रहा Space, असली साइन-इन प्रोफ़ाइल, या किसी व्यक्ति का takeover चाहिए तो ego (lite) इस्तेमाल करें। 2026-09-18 को दोनों रास्तों ने quotes.toscrape.com/js से 10 unique कार्ड निकाले; Space ने Take over और Stop दिखते रखे।
क्या असली ब्राउज़र से स्क्रैपिंग कानूनी है?
यह साइट, डेटा, क्षेत्राधिकार और इस पर निर्भर करता है कि आप फ़ाइल का क्या करते हैं। Headed ब्राउज़र में भी robots नियम और शर्तें लागू रहती हैं। यह कानूनी सलाह नहीं है।
स्क्रैपिंग के लिए Playwright या Puppeteer?
दोनों एक ही पेज रेंडर कर सकते हैं। लाइब्रेरी का चुनाव locator, wait और language bindings का है। इस पेज का HTTP-बनाम-ब्राउज़र फ़ैसला पहले आता है।
अगर अगले स्क्रैप को एक और बाँधे wait के बजाय देखा जा रहा ब्राउज़र चाहिए, तो ego (lite) मुफ़्त डाउनलोड करें। कीमत स्क्रैपर वॉकथ्रू उस Space में एक ठोस काम है।
