브라우저 에이전트를 Claude Fable 5.2로 전환할 가치가 있을까?

브라우저 에이전트가 현재 5.1을 사용한다면 Claude Fable 5.2로 전환하기를 권합니다. 더 빠르고 저렴하며 정확합니다. 이번 Claude Fable 5.2 대 5.1 테스트에서는 같은 웹 작업 28개를 각 모델로 한 번씩 실행했습니다. Fable 5.2는 89.3%, Fable 5.1은 82.1%를 통과했습니다. 두 모델이 모두 통과한 작업에서 Fable 5.2는 작업당 418.5초가 걸렸고 비용은 $2.63이었습니다. Fable 5.1은 450.6초가 걸렸고 비용은 $3.28이었습니다.
- 여러 공식 웹사이트에서 같은 세부 항목을 모을 때 Fable 5.2는 평균 비용이 더 낮았고 성공률도 약간 높았습니다.
- 하나의 웹 앱 안에서 수행하는 워크플로는 두 모델 모두 4회 시도를 전부 통과했으며, Fable 5.2의 작업당 비용이 더 낮았습니다.
- 다만 주된 작업이 자유도가 높은 조사라면, Fable 5.1이 Fable 5.2와 같은 성공률을 유지하면서 비용은 약간 더 낮았습니다.
| 모델 | 성공률 | 성공한 작업당 시간 | 성공한 작업당 비용 | 성공한 시도 한 건당 비용 |
|---|---|---|---|---|
| Claude Fable 5.2 | 89.3% (25/28) | 418.5 s | $2.63 | $3.13 |
| Claude Fable 5.1 | 82.1% (23/28) | 450.6 s | $3.28 | $4.85 |
Fable 5.2가 이전 모델이 끝내지 못한 일을 완료하는 경우
두 Fable 모델 모두 브라우저 에이전트로서 능력이 뛰어나므로, 까다로운 조건이 붙은 일상 업무로 테스트했습니다. 그중 하나는 업무용 휴대전화 선택이었습니다. 각 제조사의 공식 사이트에서 플래그십 휴대전화 아홉 대의 여러 항목을 모아 사양표를 만드는 작업입니다. OnePlus 15 개요 페이지에서는 IP 등급이 대체 텍스트가 없는 제품 이미지 안에만 표시됩니다. 두 모델 모두 ego(lite)에서 이 페이지를 열었습니다. Fable 5.2는 이미지의 스크린샷을 찍어 IP66, IP68, IP69, IP69K 네 등급을 모두 읽었습니다.
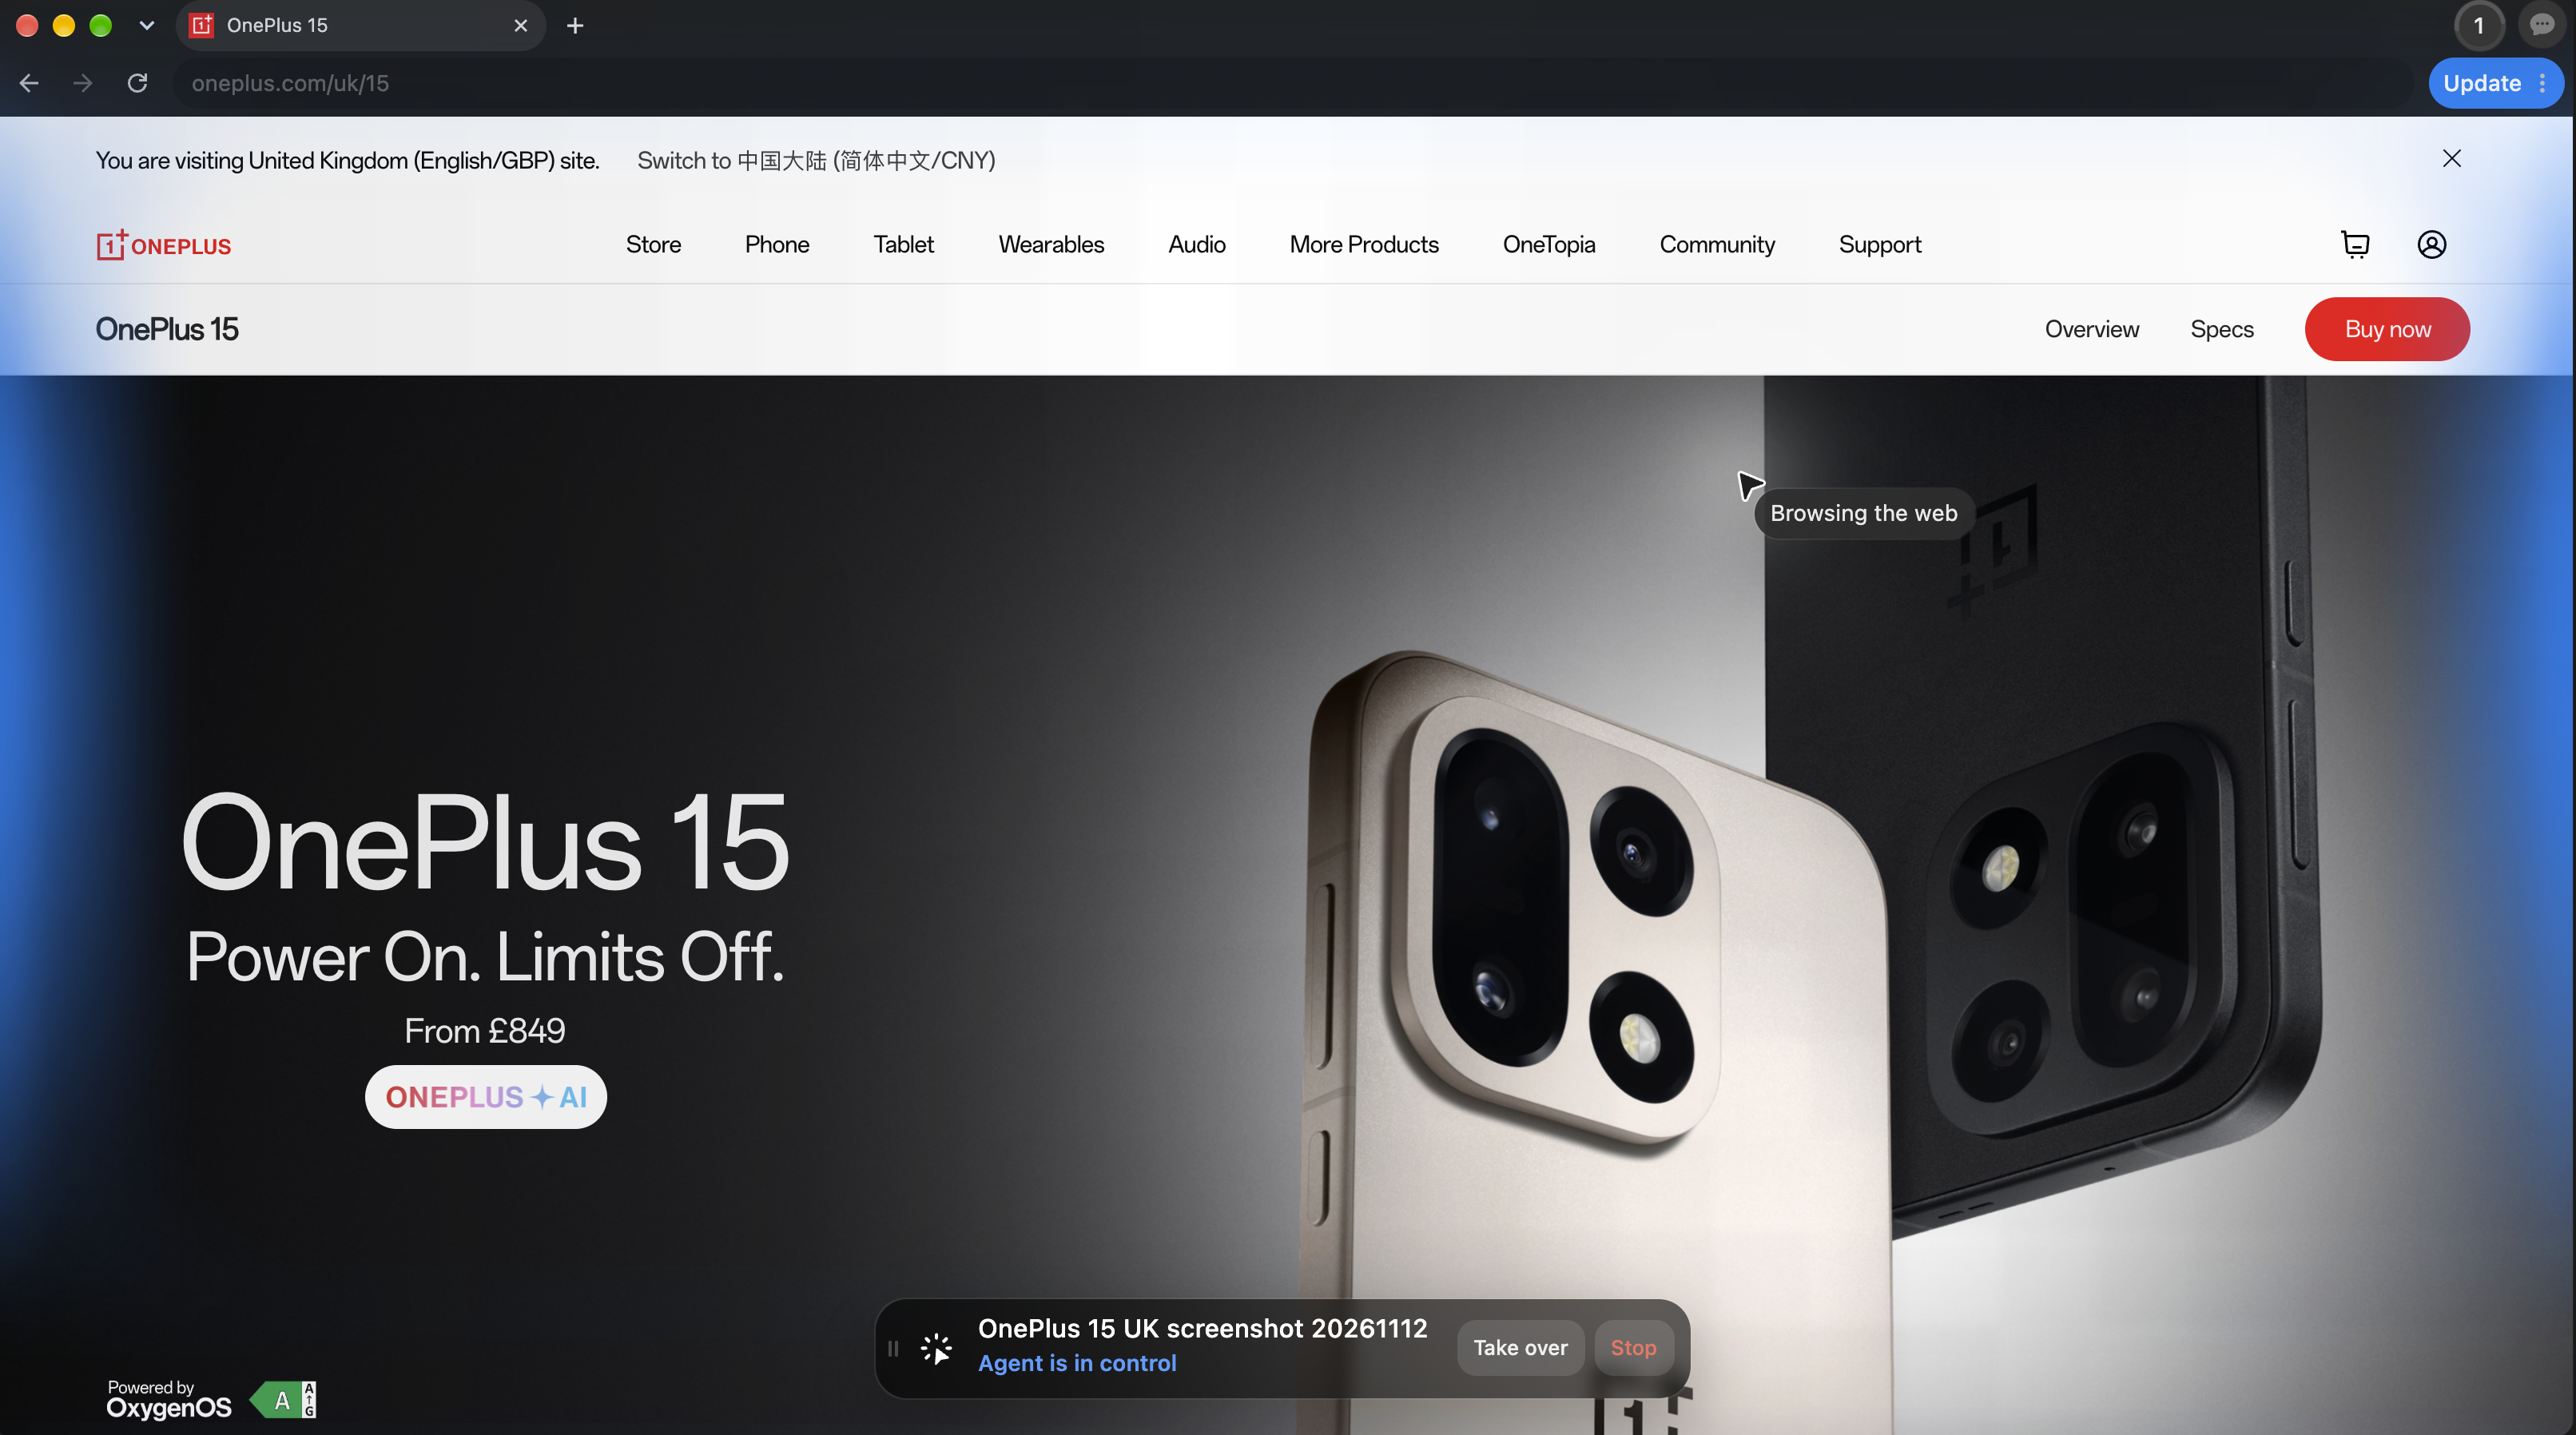
Fable 5.1은 같은 페이지의 텍스트에서 IP 코드를 검색했지만 찾지 못했습니다. 이후 사양 페이지의 친환경 설계 관련 문구에서 IP68을 가져왔습니다. 최종 표에는 OnePlus 15의 등급 하나만 기재되었고, 그래서 IP69 기기 목록에서도 이 휴대전화가 빠졌습니다. 이 작업에서 Fable 5.2는 65회, Fable 5.1은 31회의 도구 호출을 했습니다. 따라서 올바른 답변에는 $6.04가 들었고, 다른 쪽은 $3.13이 들었습니다.
Fable 5.1도 충분히 잘 해내는 작업
Fable 5.1도 유능한 브라우저 에이전트이므로 계속 사용하는 선택에도 이유가 있습니다. 여행 예약, 구매 주문서 작성, 정보 출처 추적 등 모든 웹 앱 워크플로와 조사 작업을 통과했습니다. 에이전트가 주로 이런 일을 한다면 전환으로 완료 작업 수가 극적으로 늘어나지는 않습니다. 실제로 얻는 것은 약 20% 낮아진 가격입니다. 다만 에이전트가 여러 사이트를 오가며 긴 사양표나 비교표를 자주 채운다면 Fable 5.2가 여전히 더 나은 선택입니다. 이런 작업에서는 누락되거나 잘못된 값을 보통 발견하기 어렵습니다.
Fable 5.2가 더 저렴한 이유
Fable 5.2가 더 저렴한 주된 이유는 Anthropic이 가격을 내렸기 때문입니다. 정가는 모든 토큰 종류에서 Fable 5.1보다 20% 낮습니다. 전환을 추천하는 가장 큰 이유도 이것입니다. 효율 면에서는 두 모델이 작업을 마치는 데 수행한 일의 양이 거의 같았기 때문입니다. Fable 5.2가 생성한 작업당 출력 토큰은 약 18% 적었지만 도구 호출은 32회 대비 35회로 조금 더 많아 서로 상쇄되었습니다. Fable 5.1의 요율로 계산하면 비용은 같게 나옵니다.
브라우저 에이전트에서는 주로 모델이 쓰는 데보다 읽는 데 비용을 냅니다. Fable 5.2 지출의 약 70%는 컨텍스트에 쓰였습니다. 가져온 페이지 텍스트, 스냅샷, 스크린샷에 더해 매 턴 다시 읽는 이전 단계가 포함됩니다. 그래서 너무 많은 사이트에 걸친 작업은 비용이 가장 많이 드는 경우가 많습니다. Fable 5.2로 8~12개 공식 사이트에서 같은 항목을 모으는 작업은 작업당 $4.65가 들었고, 최대 세 사이트에서 조회하는 작업은 $1.35가 들었습니다. 모델 가격만 보기보다는 에이전트가 하는 작업 유형에 맞춰 예산을 잡는 편을 권합니다.
활용할 수 있는 결과 한 건을 기준으로 보면 절감 폭은 더 큽니다. 작업이 잘못되었을 때 Fable 5.1은 멈추기 전에 더 많은 비용을 썼습니다. 그래서 전체 비용의 약 삼분의 일이 실패한 시도에 들었고, Fable 5.2는 팔분의 일이었습니다. 이런 실패까지 포함하면 성공한 시도 한 건당 비용은 Fable 5.1이 $4.85, Fable 5.2가 $3.13이었습니다. 비용을 비교할 때 살펴볼 수치는 이것입니다.
표로 보기
| 작업 유형 | Fable 5.2 성공 건수 | Fable 5.1 성공 건수 | Fable 5.2 작업당 비용 | Fable 5.1 작업당 비용 | 비용 집계 대상 작업 수 |
|---|---|---|---|---|---|
| 모든 작업 유형 | 25/28 | 23/28 | $2.63 | $3.28 | 23 |
| 다중 사이트 데이터 수집 | 9/10 | 8/10 | $4.65 | $5.77 | 8 |
| 검색과 비교 | 8/8 | 7/8 | $1.35 | $1.84 | 7 |
| 웹 앱 자동화 | 4/4 | 4/4 | $1.44 | $1.84 | 4 |
| 조사와 종합 | 3/3 | 3/3 | $2.02 | $1.87 | 3 |
| 소셜 미디어 검증 | 1/3 | 1/3 | $1.96 | $3.32 | 1 |
실행 방법
저희는 claude-fable-5-2를 추론 강도 high로 설정하고 Bash, Read, Write, Edit, Skill 도구를 갖춘 Claude Code에서 실행했습니다. 에이전트는 ego-browser의 skill 파일을 불러와 ego(lite)를 ego-browser를 통해 조작합니다. 짧은 JavaScript 스크립트를 작성하고, ego-browser가 이를 실행해 ego(lite)의 페이지를 제어합니다.
자주 묻는 질문
브라우저 에이전트에는 Claude Fable 5.2가 Fable 5.1보다 더 나은가요?
이번 테스트에서는 그렇습니다. Claude Fable 5.2는 Fable 5.1이 통과한 모든 작업에 더해 두 개를 추가로 통과했습니다. 같은 에이전트 실행 환경과 브라우저 도구에서 웹 작업 28개를 한 번씩 실행했을 때 Fable 5.2는 28회 중 25회(89.3%), Fable 5.1은 28회 중 23회(82.1%)의 시도를 통과했습니다. 추가 성공 중 하나는 사양표 작성으로, Fable 5.2가 제품 이미지에서 IP 코드를 읽어 냈습니다.
Fable 5.1에서 Claude Fable 5.2로 업그레이드할 가치가 있나요?
네. 같은 일을 더 적은 비용으로 처리했고 Fable 5.1이 통과한 작업을 하나도 놓치지 않았으므로, 브라우저 에이전트는 Claude Fable 5.2로 업그레이드할 가치가 있습니다. 28회 중 25회 시도를 통과했고, Fable 5.1은 28회 중 23회였습니다. 두 모델이 모두 통과한 23개 작업에서 작업당 비용은 $2.63 대 $3.28로, Anthropic의 20% 가격 인하에 해당합니다.
Claude Fable 5.2는 Fable 5.1보다 작업당 비용도 저렴한가요, 아니면 토큰 단가만 저렴한가요?
Claude Fable 5.2는 토큰 단가뿐 아니라 작업당 비용도 더 저렴합니다. 두 모델이 모두 통과한 23개 웹 작업에서 작업당 비용은 $2.63 대 $3.28이었습니다. 정가는 모든 종류의 토큰에서 20% 낮습니다. 이 작업들의 사용량을 Fable 5.1의 요율로 계산하면 약 $3.28가 되므로, 완료한 작업의 작업당 절감액은 가격 인하에서 나온 것입니다.
Claude Fable 5.2는 Fable 5.1보다 토큰을 적게 쓰나요?
전체 28회 시도에서 Claude Fable 5.2의 출력 토큰은 29% 적었으며, 시도당 20,138개 대 Fable 5.1의 28,481개였습니다. 두 모델이 모두 통과한 23개 작업에서도 작업당 출력 토큰은 18,581개 대 22,607개로 더 적었습니다. 같은 요율을 적용하면 이 작업들의 총사용량에 대한 비용은 Fable 5.1과 거의 같았습니다.
브라우저 작업에서 Claude Fable 5.2가 Fable 5.1보다 빠른가요?
네, 약간 더 빠릅니다. 두 모델이 모두 통과한 23개 웹 작업에서 Claude Fable 5.2는 작업당 418.5초, Fable 5.1은 450.6초가 걸렸습니다. 그 23개 중 13개 작업에서 Fable 5.2가 더 빨랐습니다. 두 모델 모두 같은 에이전트 실행 환경과 브라우저 도구에서 실행했으며, 시간에는 모델 API를 기다리는 시간도 포함됩니다.
Claude Fable 5.2를 브라우저 에이전트로 실행하는 비용은 얼마인가요?
이번 테스트에서 Claude Fable 5.2는 두 모델이 모두 통과한 23개 웹 작업에서 작업당 평균 $2.63가 들었고, 전체 28회 시도를 포함하면 성공한 시도 한 건당 $3.13이 들었습니다. Fable 5.1은 작업당 $3.28, 성공한 시도 한 건당 $4.85가 들었습니다. 비용이 가장 많이 드는 작업 유형은 다중 사이트 데이터 수집으로, Fable 5.2의 작업당 비용은 $4.65였습니다.
Claude Fable 5.2는 브라우저 자동화에서 어떤 일을 잘하나요?
이번 테스트에서 Claude Fable 5.2는 웹 앱 자동화, 검색과 비교, 조사의 모든 시도를 통과했으며, 다중 사이트 데이터 수집은 10회 중 9회를 통과했습니다. Fable 5.1은 다중 사이트 시도에서 10회 중 8회, 검색과 비교에서 8회 중 7회를 통과했습니다. Fable 5.2의 추가 성공 두 건은 이 두 작업 유형에서 나왔습니다.
Claude Fable 5.1이 여전히 Fable 5.2와 대등한 작업은 무엇인가요?
Claude Fable 5.1은 웹 앱 워크플로와 자유도가 높은 조사에서 Fable 5.2와 대등했습니다. 두 모델 모두 웹 앱 자동화 4회와 조사·종합 3회 시도를 전부 통과했습니다. 조사에서는 Fable 5.1의 작업당 비용이 $1.87로 다른 쪽의 $2.02보다 낮았고, 웹 앱 워크플로에서는 Fable 5.2가 $1.44 대 $1.84로 더 저렴했습니다.
Claude Fable 5.2는 여러 단계의 브라우저 작업을 마치기 전에 멈추나요?
이번 테스트에서는 그렇지 않았습니다. Claude Fable 5.2의 모든 시도는 최종 답변으로 끝났으며, 100단계 한도를 소진한 시도는 없었습니다. 실패 세 건은 최종 답변에서 필요한 모든 값을 정확히 맞히지 못한 경우였습니다.
Claude Fable 5.2에 브라우저 작업을 무인으로 맡길 수 있나요?
Claude Fable 5.2는 대부분의 작업을 스스로 끝내 28회 중 25회 시도를 통과했습니다. 다만 실패한 세 시도도 모두 오류가 있는 최종 답변을 내고 끝났습니다. 두 번은 나중에 나온 보안 릴리스나 별도의 지역 보도자료처럼 잘못된 출처에서 값을 가져왔습니다. 릴리스나 가격 데이터는 각 값이 어느 페이지에서 왔는지 확인하세요.
Claude Fable 5.2는 어떻게 브라우저를 사용하나요?
Claude Fable 5.2는 에이전트 실행 환경과 브라우저 도구를 통해 브라우저를 제어할 수 있습니다. 이번 테스트에서는 Claude Code에서 실행하며 ego-browser로 ego(lite)를 제어했습니다. 짧은 JavaScript 스크립트를 작성하면 ego-browser가 이를 실행해 페이지를 제어합니다. 이 구성으로 웹 작업 28회 시도 중 25회를 통과했습니다.
테스트 방법
Claude Fable 5.2(claude-fable-5-2)와 Claude Fable 5.1(claude-fable-5-1)을 모두 추론 강도 high로 설정해 같은 에이전트 실행 환경에서 비교했습니다. Bash, Read, Write, Edit, Skill 도구를 갖춘 Claude Code였습니다. 두 모델 모두 ego-browser를 통해 ego(lite)를 제어했습니다. ego-browser는 모델의 스크립트가 요청하는 형식에 따라 접근성 스냅샷, 페이지 텍스트 또는 스크린샷으로 페이지를 모델에 제공합니다. 테스트는 2026년 11월 12일 Linux에서 실행했습니다.
28개 작업은 다섯 가지 유형을 다룹니다. 웹 앱 자동화는 송장과 결제 내역 맞추기처럼 테스트용 비즈니스 앱 안에서 수행하는 워크플로입니다. 검색과 비교는 MDN과 Can I use에서 브라우저 지원을 확인하는 작업처럼 한 곳에서 세 곳의 사이트를 다룹니다. 다중 사이트 데이터 수집은 12개 중앙은행의 금리 결정처럼 8~12개 공식 사이트에서 같은 항목을 모으는 일입니다. 조사와 종합은 Wikipedia 표의 출처를 추적하는 작업처럼 자유도가 높은 작업입니다. 소셜 미디어 검증은 X 게시물과 공식 페이지를 맞춰 봅니다. 각 작업은 한 유형에만 속합니다.
각 모델로 각 작업을 한 번씩 실행했으며, 작업의 한 번 실행을 한 번의 시도로 봅니다. 최종 답변에서 필요한 값을 모두 정확히 맞히면 그 시도는 성공입니다. 각 시도의 한도는 최대 100단계, 60분이었습니다. 한 단계는 모델의 한 턴, 도구 호출은 모델이 도구에 보내는 호출 한 번, 브라우저 명령은 ego-browser에 전달하는 스크립트 하나입니다. 시간은 시도별로 실제 흐른 시간이며, 모델 API를 기다리는 시간도 포함합니다. 비용은 각 시도의 토큰 사용량에 Anthropic의 정가를 적용해 계산한 미국 달러 금액입니다. 캐시 읽기와 쓰기에는 각각 해당 요율을 적용합니다. 성공한 작업당 시간과 비용은 두 모델이 모두 통과한 23개 작업에서 비교합니다. 성공한 시도 한 건당 비용은 모든 시도의 총비용을 성공한 시도 수로 나눈 값입니다.
전체 결과
각 셀은 모델의 한 번 시도가 성공했는지, 모델 API 대기를 포함해 몇 초가 걸렸는지, 미국 달러로 얼마가 들었는지를 보여 줍니다. 다른 부분의 평균값은 반올림하지 않은 비용으로 계산했습니다.
| 작업 | 작업 유형 | Claude Fable 5.2 | Claude Fable 5.1 |
|---|---|---|---|
| 예약 앱에서 여행 규정에 맞게 항공편, 좌석, 호텔 예약 | 웹 앱 자동화 | 성공 · 220.0 초 · $1.66 | 성공 · 208.2 초 · $2.19 |
| 모니터링 앱에서 서비스 모니터를 문서로 정해진 기준에 맞추기 | 웹 앱 자동화 | 성공 · 140.7 초 · $1.02 | 성공 · 158.2 초 · $1.60 |
| 재고 앱에서 재고 수준에 따라 구매 주문서 만들기 | 웹 앱 자동화 | 성공 · 163.0 초 · $1.06 | 성공 · 128.2 초 · $1.29 |
| 재무 앱에서 2월 송장을 결제 내역과 맞추고 이의 제기 접수 | 웹 앱 자동화 | 성공 · 316.3 초 · $2.02 | 성공 · 308.8 초 · $2.28 |
| 강의 영상의 챕터를 GitHub 코드 및 arXiv 논문과 대조 | 검색과 비교 | 성공 · 136.3 초 · $1.14 | 성공 · 221.8 초 · $1.57 |
| FRED에서 인플레이션 수치를 계산하고 BLS에서 확인 | 검색과 비교 | 성공 · 122.7 초 · $1.03 | 성공 · 93.3 초 · $1.11 |
| MDN과 Can I use에서 여섯 가지 웹 기능의 브라우저 지원을 교차 확인 | 검색과 비교 | 성공 · 179.2 초 · $1.14 | 성공 · 239.1 초 · $2.13 |
| 항공편 검색 사이트에서 세 도시를 대상으로 최저가 직항 운임 찾기 | 검색과 비교 | 성공 · 683.0 초 · $2.24 | 실패 · 768.3 초 · $4.41 |
| ClinicalTrials.gov의 임상 3상 시험을 해당 DailyMed 의약품 표시사항과 대조 | 검색과 비교 | 성공 · 178.6 초 · $1.52 | 성공 · 267.6 초 · $2.24 |
| 제조사 미국 스토어에서 노트북 구성 세 가지의 가격을 조사하고 비교 | 검색과 비교 | 성공 · 378.2 초 · $2.46 | 성공 · 392.0 초 · $3.17 |
| 박스오피스 데이터베이스와 Wikipedia에서 영화 여섯 편의 흥행 수입 대조 | 검색과 비교 | 성공 · 102.2 초 · $1.09 | 성공 · 87.6 초 · $1.12 |
| Companies House에서 영국 기업 네 곳을 심사 | 검색과 비교 | 성공 · 101.2 초 · $1.09 | 성공 · 185.4 초 · $1.52 |
| 9개 SaaS 트러스트 센터에서 규정 준수 매트릭스 작성 | 다중 사이트 데이터 수집 | 성공 · 1110.0 초 · $6.16 | 성공 · 737.9 초 · $5.56 |
| 제조사 사이트에서 카메라 8대의 사양을 다섯 항목씩 수집 | 다중 사이트 데이터 수집 | 성공 · 482.4 초 · $3.49 | 성공 · 480.9 초 · $4.35 |
| 제조사 영국 사이트에서 플래그십 휴대전화 9대의 사양을 다섯 항목씩 수집 | 다중 사이트 데이터 수집 | 성공 · 992.6 초 · $6.04 | 실패 · 467.5 초 · $3.13 |
| 9개 개발자 컨퍼런스의 개막 기조연설 세부 정보 수집 | 다중 사이트 데이터 수집 | 성공 · 920.8 초 · $4.85 | 성공 · 1168.4 초 · $8.85 |
| 제조사 미국 사이트에서 전기 SUV 9종의 주행거리와 충전 수치 수집 | 다중 사이트 데이터 수집 | 성공 · 1120.9 초 · $6.91 | 성공 · 1261.0 초 · $6.91 |
| Hugging Face와 공급업체 페이지에서 오픈웨이트 모델 9개의 사양과 라이선스 수집 | 다중 사이트 데이터 수집 | 성공 · 758.7 초 · $5.24 | 성공 · 1059.6 초 · $6.26 |
| 노동 기관 9곳에서 법정 최저임금 수집 | 다중 사이트 데이터 수집 | 성공 · 567.0 초 · $4.25 | 성공 · 640.1 초 · $5.32 |
| 중앙은행 사이트 12곳에서 2026년 첫 금리 결정 수집 | 다중 사이트 데이터 수집 | 성공 · 525.9 초 · $3.51 | 성공 · 435.1 초 · $4.52 |
| 서버리스 플랫폼 9개의 무료 요금제 비교 | 다중 사이트 데이터 수집 | 성공 · 501.1 초 · $2.77 | 성공 · 665.2 초 · $4.40 |
| 음악 서비스 9곳에서 같은 앨범의 등록 정보 비교 | 다중 사이트 데이터 수집 | 실패 · 408.6 초 · $1.98 | 실패 · 292.4 초 · $2.22 |
| 공개 모델 데이터베이스에서 EU 연산량 기준을 넘는 모델 집계 | 조사와 종합 | 성공 · 195.2 초 · $1.64 | 성공 · 80.4 초 · $1.08 |
| 인터랙티브 리더보드 차트에서 비용과 점수 데이터점 읽기 | 조사와 종합 | 성공 · 317.1 초 · $2.39 | 성공 · 327.3 초 · $2.41 |
| Wikipedia 표의 10개 셀을 출처까지 추적 | 조사와 종합 | 성공 · 382.2 초 · $2.03 | 성공 · 342.7 초 · $2.12 |
| 8개 브랜드의 X 제품 게시물을 해당 보도자료와 대조 | 소셜 미디어 검증 | 실패 · 1132.7 초 · $3.79 | 실패 · 2200.8 초 · $14.22 |
| 8개 오픈소스 프로젝트의 X 보안 게시물을 각 프로젝트 자체 공지와 대조 | 소셜 미디어 검증 | 실패 · 750.8 초 · $3.75 | 실패 · 3302.8 초 · $12.30 |
| 일주일간의 SpaceX X 발사 게시물을 Wikipedia 발사 목록과 대조 | 소셜 미디어 검증 | 성공 · 706.2 초 · $1.96 | 성공 · 875.8 초 · $3.32 |