
웹 스크래핑의 페이지네이션은 다음 페이지로 가는 일만이 아니다. 더 어려운 일은 아직 모을 데이터가 있는지, 목록이 정말 끝났는지를 아는 것이다. 대부분의 사이트는 번호 페이지, Load More(더 보기), 무한 스크롤 중 하나를 쓰며, 각각 다른 이동 전략, 대기 조건, 중단 규칙이 필요하다. 여기서 틀리면 크롤러는 오류도 내지 않고 일찍 멈출 수 있다.
데이터가 HTML이나 JSON 엔드포인트에 바로 있으면 브라우저는 보통 필요 없다. 순수 HTTP가 더 단순하고 빠르다. 브라우저가 쓸모 있는 때는 목록이 클라이언트 렌더링, 인증된 세션, 페이지에서 만든 Token, 실제 스크롤에 의존할 때다. 그 데이터가 이미 로그인한 브라우저에 달려 있다면, ego (lite)는 로그인 상태를 다시 만들지 않고 기존 브라우저 세션 안에서 AI Agent가 같은 페이지네이션 로직을 돌리게 한다.
아래 절에서는 번호 페이지, 더 보기, 무한 스크롤을 같은 질문으로 시험한다. 목록이 정말 끝났는가, 아니면 크롤러가 더 이상 요청을 안 한 것뿐인가. 예제는 재현 가능한 로컬 픽스처를 쓰며, 번호 페이지에 135행, 더 보기 뒤에 렌더된 81행, 무한 피드에 60건이 있다. 끝나면 크롤러는 페이지만 넘기는 것이 아니라 멈춘 위치도 기록하고, 중복과 누락 행도 다루며, 수집 데이터가 완전한지 확인한다.
지금 페이지네이션이 어떤 모드인지 구분하는 방법
분류는 세 가지 관찰로 끝난다. URL을 바꾸거나 번호 링크를 클릭해 결과 집합이 바뀌면 번호 페이지네이션이다. 더 있다고 약속하는 버튼이 URL은 그대로 두고 행만 붙이면 더 보기다. 클릭할 컨트롤 없이 스크롤할 때 행이 나타나면 무한 스크롤이다. 페이지가 패턴을 섞으면 한 루프로 둘 다 덮지 말고, 전환마다 별도 모드로 다룬다.
코드를 읽는 것보다 브라우저에서 짧게 확인하는 편이 빠르다. DevTools를 열고 네트워크 패널을 보며 한 번 조작한다. page 매개변수가 있는 탐색 요청은 번호 페이지네이션, 클릭으로 나가는 백그라운드 JSON이나 HTML은 더 보기, 스크롤할 때마다 반복되는 요청은 무한 스크롤이다. 응답에는 보통 다음 offset이 들어 있어 크롤러에게는 선물이다.
번호 페이지: URL 규칙을 도출하고 올바른 지점에서 멈추기
번호 페이지네이션이 가장 다루기 쉬운 이유는 상태가 URL에 있기 때문이다. 처음 세 페이지에서 규칙을 도출한다. 어떤 매개변수가 바뀌는지, 페이지 번호인지 offset인지, 페이지 크기가 고정인지. 규칙은 함수로 쓸 수 있어야 하고, 올바른 함수는 3페이지에서 4페이지를 중간을 방문하지 않고 만든다.
// Derive once, then verify against page 2 and page 3 before trusting it.
const pageUrl = (n) => `https://example.com/listings?page=${n}`;

let page = 1;
const rows = [];
while (true) {
  await browserPage.goto(pageUrl(page));
  const batch = await browserPage.locator("tr.row").evaluateAll((nodes) =>
    nodes.map((node) => ({
      id: node.dataset.id,
      title: node.querySelector(".title").textContent.trim(),
      price: Number(node.querySelector(".price").textContent.replace(/[^0-9.]/g, "")),
    })),
  );
  if (batch.length === 0) break;
  rows.push(...batch);

  const hasNext = (await browserPage.locator("a#next").count()) > 0;
  if (!hasNext) break;
  page += 1;
}
종료 조건은 평소보다 더 공을 들일 가치가 있다. 다음 링크가 사라진 것과 빈 배치는 둘 다 진짜 종료 신호다. 고정된 총 페이지 수는 아니다. 목록은 늘고, 오늘 박아 넣은 숫자는 다음 달에 틀린다. 픽스처 실행에서 크롤러는 1페이지부터 5페이지까지 걷고, 80 milliseconds에 135행을 모았으며, 다음 링크가 사라졌을 때 멈췄다. 다섯 요청 중 하나는 첫 시도가 503이었고, 같은 페이지를 한 번 재시도해 성공했다.
루프를 정직하게 유지하는 규칙은 두 가지다. 첫째, 페이지 요청을 가능한 한 빠르게 쏘지 말고 사이를 쉬며, 사이트 약관과 RFC 9309 에 적힌 robots 배제 프로토콜을 지킨다. 둘째, 목록이 순서를 지켜야 한다면 같은 페이지가 반복되는 것을 중단 신호로 본다. 자기 매개변수를 무시하는 페이지네이션은 그렇지 않으면 영원히 돈다.
더 보기: 클릭, 대기, 중복 제거
더 보기는 상태를 버튼 뒤에 숨기므로 크롤러가 증가를 스스로 만들어야 한다. 클릭하고, 행 수가 실제로 늘 때까지 기다리고, 새로 생긴 것을 모으고, 버튼이 사라지거나 더 이상 아무것도 바꾸지 않을 때까지 반복한다. 실패는 거의 대기에서 난다. 고정 대기는 빠른 연결에서는 우연히 통하고, 느린 연결에서는 목록을 조용히 자른다.
await browserPage.goto("https://example.com/listings");

while (true) {
  const button = browserPage.locator("#load-more");
  if ((await button.count()) === 0) break;

  const before = await browserPage.locator("tr.row").count();
  await button.click();
  await browserPage.waitForFunction(
    (n) => document.querySelectorAll("tr.row").length > n,
    before,
    { timeout: 10000 },
  );
}

const rows = await browserPage.locator("tr.row").evaluateAll((nodes) =>
  nodes.map((node) => ({ id: node.dataset.id, title: node.textContent.trim() })),
);
픽스처 실행에서 스무 행짜리 배치 네 개가 273 milliseconds에 도착했고, 보이는 목록은 81행, 데이터셋은 80행이었다. 여분 한 행은 배치를 건너 같은 레코드가 두 번 오는 흔한 현실을 흉내 내려고 픽스처가 심어 둔 중복이다. 페이지 자체 상태 줄은 "Loaded 81 of 80"이었고, 사이트가 그리는 카운터는 검증 근거가 아니라는 좋은 경고다. 보이는 제목이 아니라 행의 record id 같은 안정 식별자로 중복을 제거하면 그 한 건만 빠진다.
무한 스크롤: 트리거, 높이 안정, 중단 규칙
무한 스크롤에는 버튼도 URL도 없어서 트리거와 중단 조건을 모두 추론해야 한다. 트리거는 대개 감시 요소가 뷰포트에 들어오거나 스크롤 위치 임계값이다. 중단 조건에서 판단이 필요하다. 목록이 클릭할 수 있는 방식으로 끝을 알리지 않기 때문이다.
실측한 실패는 보여 줄 가치가 있다. 대부분의 크롤러가 출고 때부터 안고 있는 실패이기 때문이다. 한 번만 맨 아래로 스크롤하고 다음 배치가 그려지기를 기다리지 않은 채 행 수가 늘었는지만 보면 즉시 "no growth"가 나온다. 픽스처는 60행 중 15행, 배치 하나에서 멈췄지만 네트워크에는 이미 다음 배치가 요청돼 있었다. 그 순간에 대한 검사는 틀리지 않았다. 고요한 한순간을 목록의 끝으로 본 것이 틀렸다.
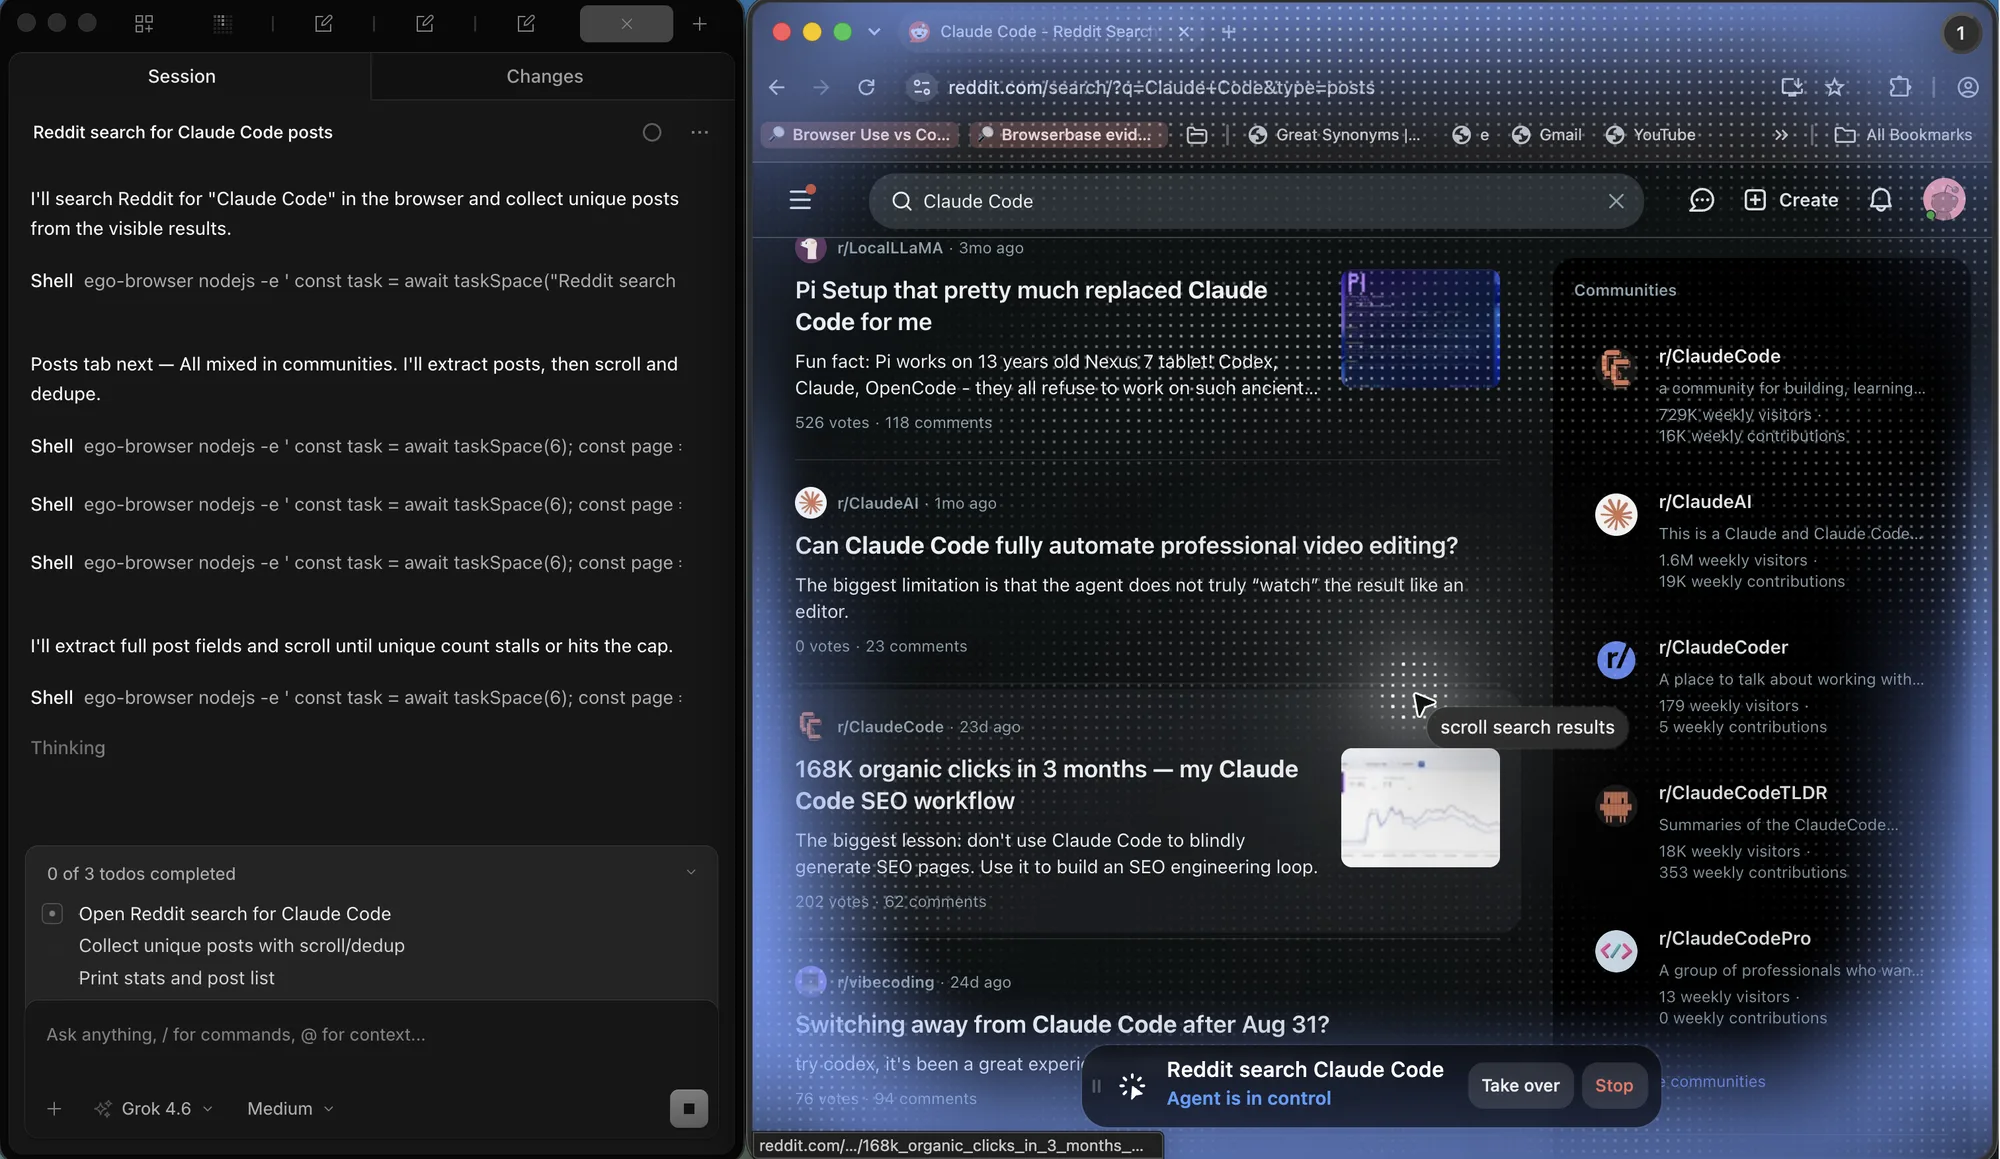
믿을 수 있는 버전은 관찰 가능한 조건을 기다린 뒤, 한 번이 아니라 여러 번 검사로 끝을 확인한다. 스크롤하고, 항목 수가 늘거나 페이지가 피드가 끝났다고 말할 때까지 기다리며, 둘 다 세 번 연속 일어나지 않을 때만 목록이 끝났다고 본다. 픽스처에서는 같은 60건이 스크롤 네 라운드에 끝났고 오탐 정지는 0이었으며, 마지막 상태 줄은 "End of feed (60 of 60)"이었다.
let stableChecks = 0;
while (stableChecks < 3) {
  const items = await browserPage.locator("article.post").count();
  await browserPage.evaluate(() => window.scrollTo(0, document.body.scrollHeight));

  const grew = await browserPage
    .waitForFunction(
      (n) =>
        document.querySelectorAll("article.post").length > n ||
        /end of feed/i.test(document.body.innerText),
      items,
      { timeout: 3000 },
    )
    .then(() => true)
    .catch(() => false);

  stableChecks = grew ? 0 : stableChecks + 1;
  if (!grew) await browserPage.waitForTimeout(700);
}
안정적인 루프와 들쭉날쭉한 루프의 차이는 두 가지 디테일이다. 높이 안정은 문서 높이가 아니라 추출한 항목 수로 판단한다. 지연 이미지와 광고는 레코드를 더하지 않고도 높이를 바꾸기 때문이다. 스크롤은 사이트의 로더를 실제로 다시 켜야 한다. Intersection Observer API 위에 만든 구현은 교차 변화에 발화하므로, 맨 아래에 붙잡아 두는 것보다 스크롤 위치를 번갈아 움직이는 편이 더 확실하다.
크롤 상태를 기록하고 충돌 후 이어 받기
세 모드가 공유하는 요구는 하나다. 실행은 자기 중단에 살아남아야 한다. 끝난 배치마다 체크포인트를 쓰고 모드, 위치, 지금까지 모은 레코드를 넣으며, 이어 받기를 특수 경로가 아니라 기본 경로로 둔다. 픽스처에서 번호 크롤은 2페이지 뒤에 죽었고 체크포인트에는 54행이 있었다. 새 프로세스가 그 파일을 읽고 3페이지부터 이어, 끊기지 않은 실행과 같은 135행과 133개의 고유 id로 끝냈다.
import { readFileSync, writeFileSync } from "node:fs";

const CHECKPOINT = "./crawl-state.json";
const save = (state) => writeFileSync(CHECKPOINT, JSON.stringify(state));
const load = () => {
  try {
    return JSON.parse(readFileSync(CHECKPOINT, "utf8"));
  } catch {
    return { mode: "numbered", lastPage: 0, rows: [] };
  }
};

const state = load();
for (let page = state.lastPage + 1; page <= 5; page += 1) {
  state.rows.push(...(await crawlPage(page)));
  state.lastPage = page;
  save(state); // checkpoint after every page
}
체크포인트는 디버깅도 바꾼다. 크롤이 틀린 건수를 내더라도 작업 전체를 다시 돌리지 않고 상태 파일을 볼 수 있고, 거기에 적힌 위치가 어떤 배치를 다시 받을지 알려 준다.
중복, 누락 행, 가짜 마지막 페이지
대부분의 페이지네이션 버그는 세 증상으로 덮이고, 각각의 서명은 코드가 아니라 데이터에 있다. 중복은 배치가 이웃과 겹칠 때 나타나며, 아래 목록이 요청 사이에 다시 정렬되어 안정 식별자가 반복될 때 생긴다. 픽스처는 이를 정확히 재현했다. 같은 id가 2페이지에 한 번, 3페이지에 다시, 5페이지 안에도 나타났고, id 기반 중복 제거로 둘 다 사라졌다.
누락 행은 대개 대기가 너무 짧았거나 페이지가 건너뛰어졌다는 뜻이다. 합계가 정확히 한 배치 모자라면 부족 직전 상호작용을 보고, 한 페이지가 모자라면 루프의 증가분을 본다. 픽스처의 일시 503은 이 버그의 다른 맛이다. 재시도가 없으면 3페이지는 아무것도 보태지 않고, 실행은 오류 없이 106행이라고 보고했을 것이다.
가짜 마지막 페이지가 가장 위험하다. 데이터가 적은 채로 성공을 보고하기 때문이다. 목록이 끝나서가 아니라 세션이나 렌더링 문제로 0행이 돌아올 때 생기며, 루프는 둘을 같게 취급한다. 한 번 더 찔러 구분한다. 짧게 기다린 뒤 다음 페이지를 다시 요청하고, 진짜 종료 표시나 연속된 빈 응답 두 번이 있어야 끝을 인정한다.
건수와 필드 완결성을 검증하기
검증은 몇 초면 끝나고 조용한 실패의 대부분을 잡는 두 검사다. 건수 검사는 모은 수를 찾을 수 있는 모든 독립 숫자와 맞춘다. 마지막 번호 페이지 자신의 "page 5 of 5", 헤더의 합계, 도중에 본 페이지별 건수의 합이다. 필드 검사는 작업이 약속한 필드를 모든 레코드가 갖고 있는지 확인하고, 예외를 무시하지 않고 센다.
const unique = new Map(rows.map((row) => [row.id, row]));
const missing = rows.filter((row) => !row.title || !Number.isFinite(row.price));

console.log({
  raw: rows.length,
  unique: unique.size,
  removedDuplicates: rows.length - unique.size,
  missingFields: missing.length,
});
픽스처의 번호 페이지 135행에서 검사는 누락 필드 0, 제거한 중복 2, 고유 레코드 133을 보고했고 데이터셋과 정확히 맞았다. 더 보기 목록에서는 81건 중 중복 1건이었다. 숫자 자체는 재미없다. 중요한 것은 어느 쪽이든 바뀌면 바로 보인다는 점이며, 이후 보고서의 수수께끼 공백으로 나타나지 않는다는 점이다.
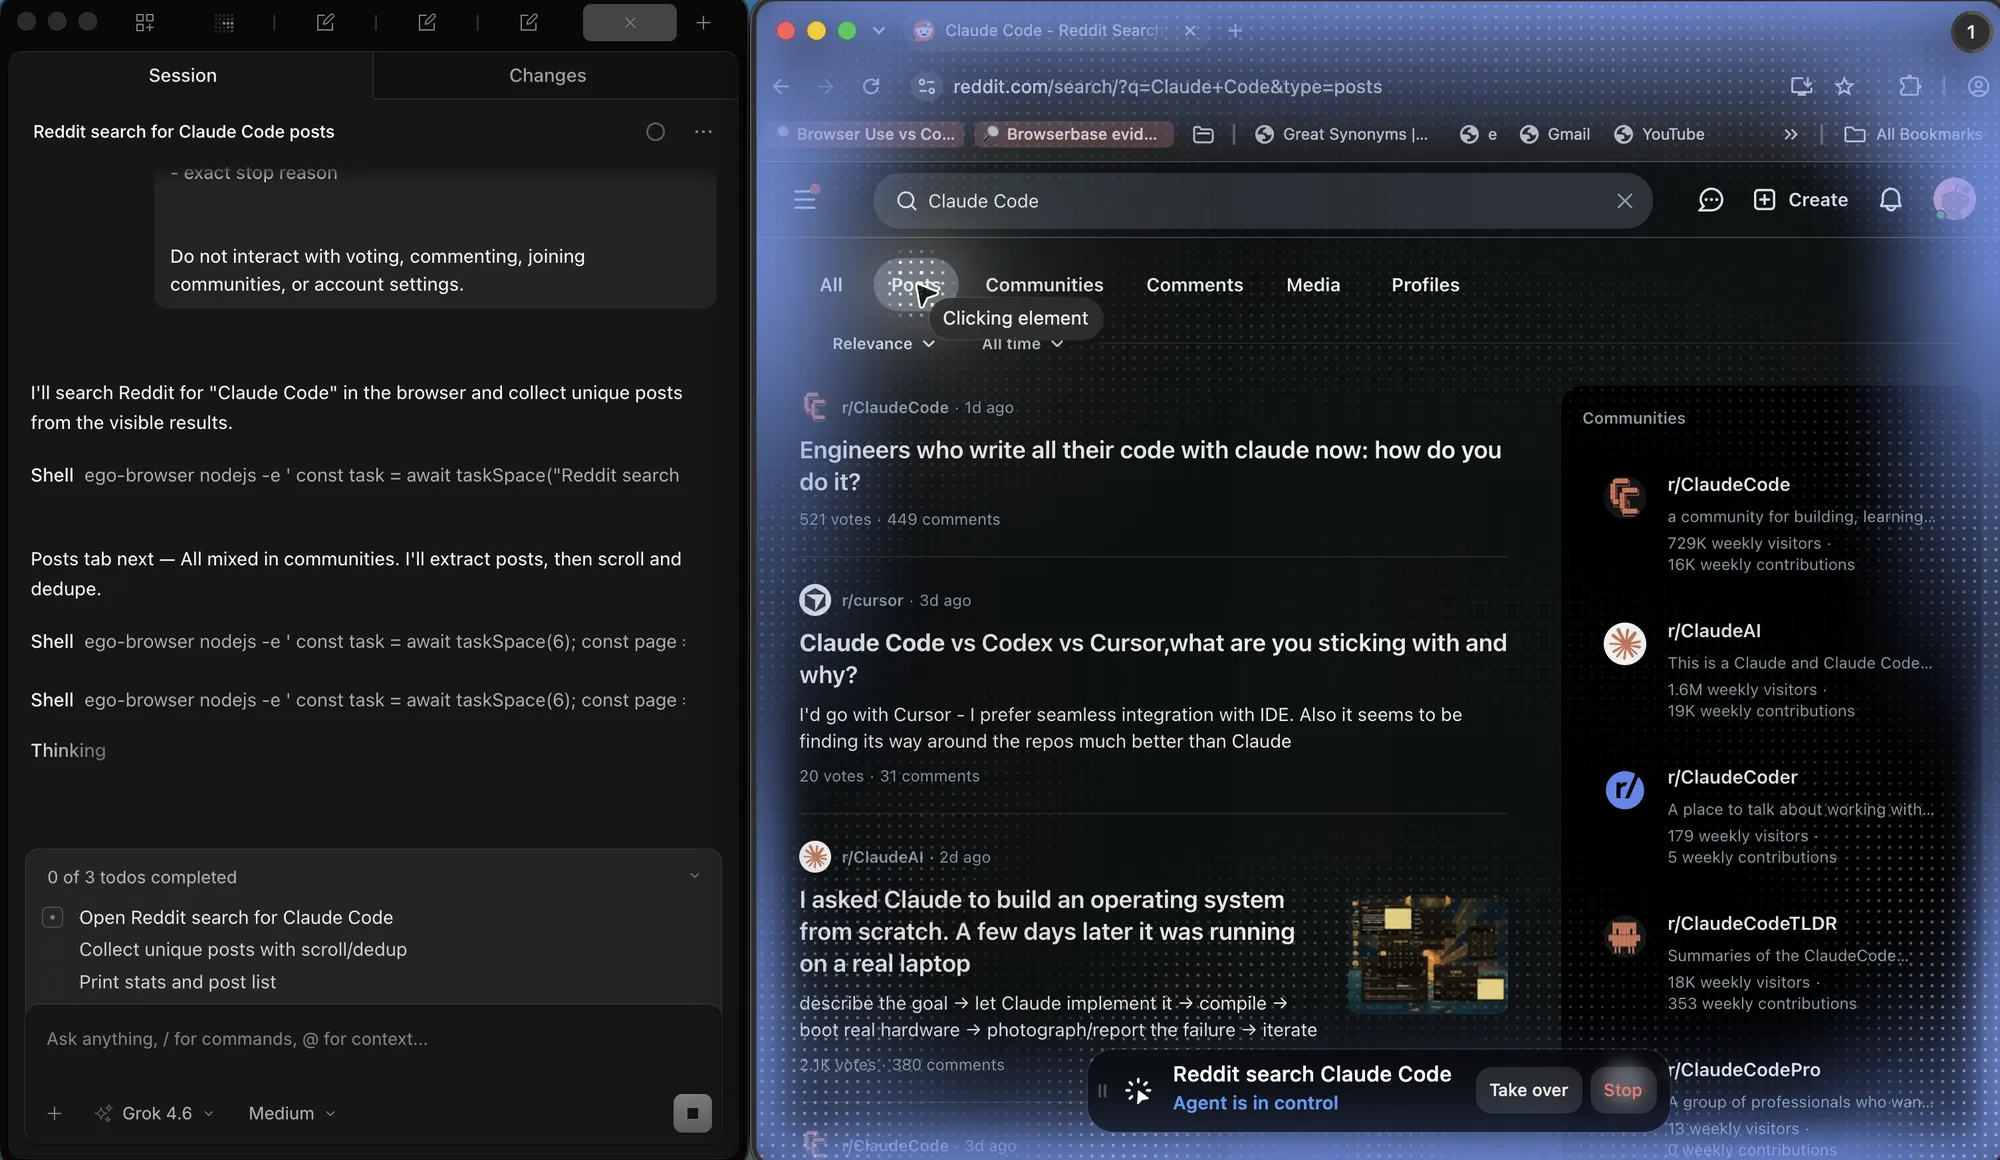
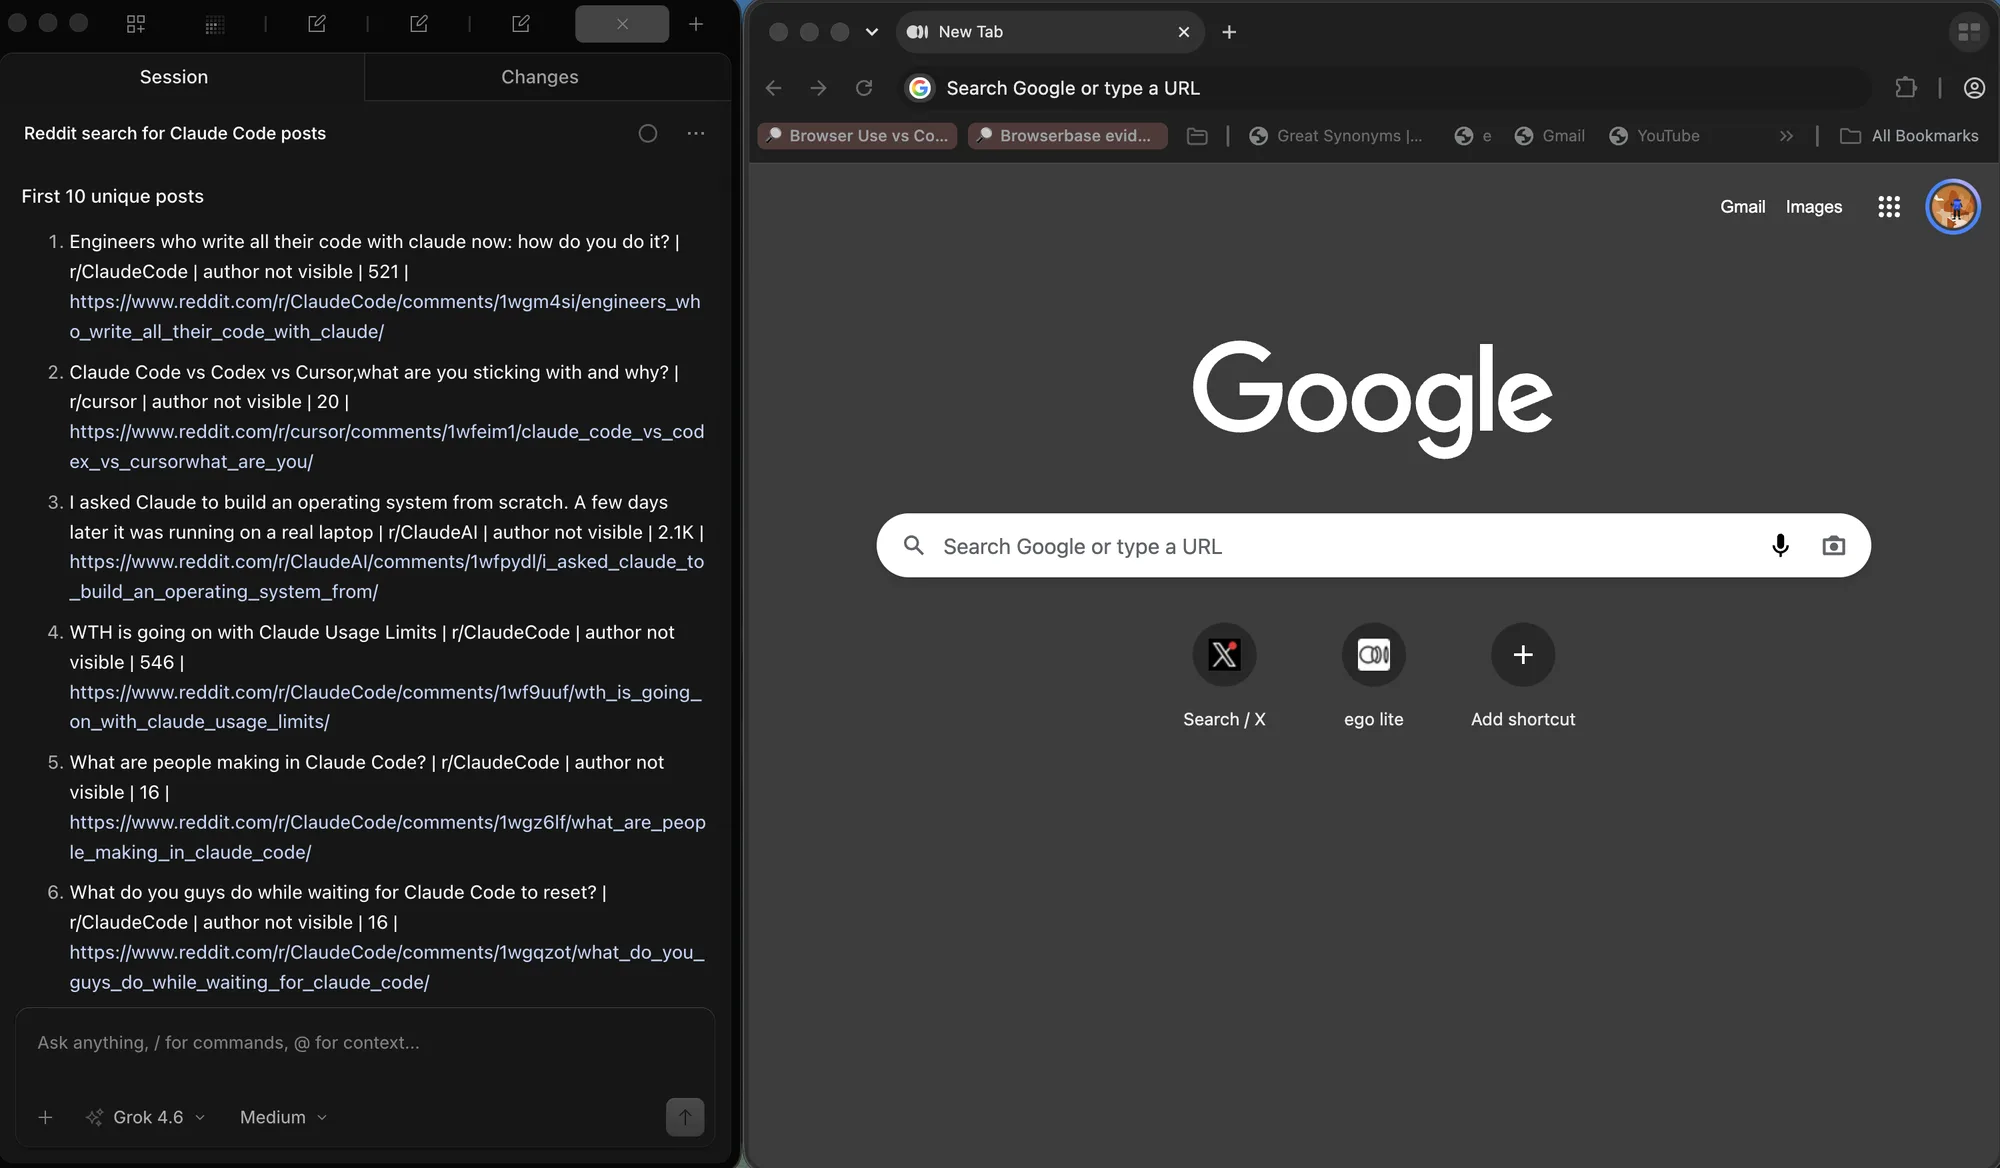
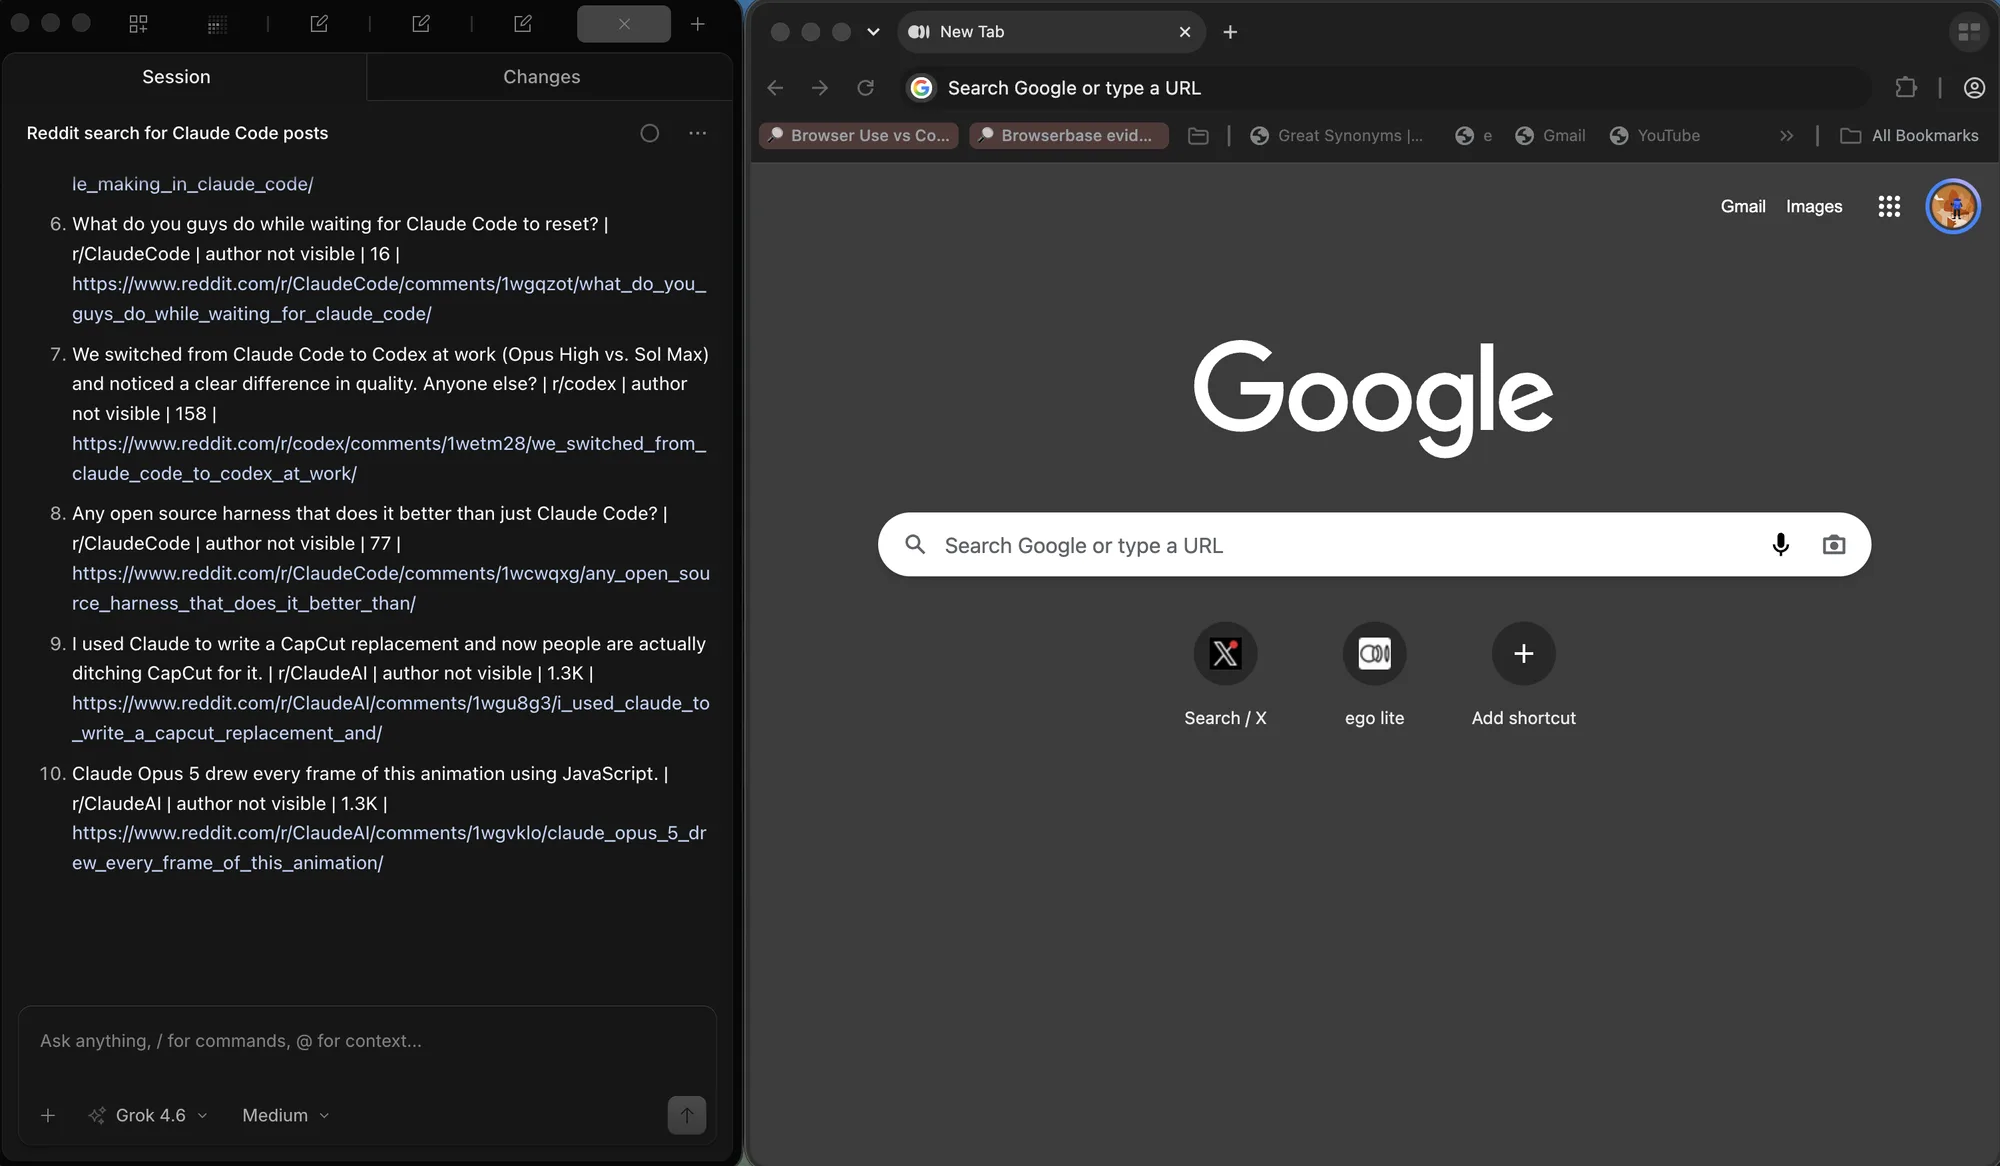
Reddit 실행은 135행 fixture가 아니라 실제 고유 목록에 같은 검사를 썼습니다. 각 행에는 제목, subreddit, 투표 수, URL이 필요했습니다. 스크롤 후 검증하는 것은 번호 매긴 출력입니다.
순수 HTTP로 충분한 때, 부족한 때
같은 픽스처 데이터는 브라우저 없이도 닿을 수 있다. 두 경로를 모두 재는 것이 작업에 무엇이 필요한지 정하는 정직한 방법이다. 순수 HTTP 클라이언트는 URL로 번호 페이지를 걷고, JSON 엔드포인트에서 더 보기 배치를 가져오고, offset으로 무한 피드를 끌어, 135, 81, 60행을 합쳐 24 milliseconds에 모았다. 렌더링도, 대기도, 스크롤도 없다.
그것이 기본 권고이며 분명히 써야 한다. 공식 API가 있으면 그걸 쓴다. 번호 목록이 서버 렌더면 페이지를 직접 요청한다. 더 보기나 무한 모드 뒤가 서명이 필요 없는 JSON 엔드포인트면 그 엔드포인트를 요청하고 offset으로 페이지를 넘긴다. Playwright 같은 프레임워크는 어느 것에도 필요 없고, HTTP 경로가 더 빠르고 싸게 돈다. Apify 페이지네이션 실습, Web Scraper 페이지네이션 선택자 문서, 그리고 Playwright 네트워크 가이드 의 네트워크 패널 흐름은 다른 출발점에서 같은 범위를 다룬다.
브라우저가 정당화되는 때는 데이터가 클라이언트 렌더링 뒤에만 존재할 때, 요청이 페이지에서 만든 서명이나 Token을 실을 때, 목록에 로그인이 필요할 때, 실제 세션과 실제 user agent가 없으면 엔드포인트 응답이 달라질 때다. 그 지점에서 브라우저는 취향이 아니라 유일한 정직한 경로이며, 앞 절은 그대로 적용된다.
ego (lite)는 그 HTTP 경로가 실패한 뒤에야 등장한다. 목록에 로그인된 cookie, 페이지가 만든 Token, 실제 뷰포트가 없으면 일어나지 않는 스크롤이 필요하면, 이미 세션을 가진 브라우저 안에서 같은 번호 / 더 보기 / 무한 루프를 돌린다. 거기서 시작하지 마라. 픽스처는 이미 더 싼 답을 보여 줬다. 순수 HTTP로 135, 81, 60행을 24 ms에.
브라우저가 정말 필요할 때도 앞 절의 크롤 로직은 그대로 둔다. ego (lite)가 주는 것은 로그인한 페이지와 지켜볼 수 있는 Space이지, 새 페이지네이션 알고리즘이 아니다. 한 단계에 사람이 필요하면 멈춘다. curl이나 공식 API가 이미 행을 돌려주면 HTTP에 머문다.
번호 페이지의 격리 규칙은 그대로입니다. 창 하나를 공유하는 크롤러 두 개는 스크롤 위치를 다투고 서로의 마지막 행을 덮어씁니다. 같은 브라우저에서 Space 두 개는 Playwright context 두 개와 같습니다. 하나는 Google에서 idle로 두고, 다른 하나는 Reddit을 계속 스크롤할 수 있습니다. 핵심은 격리입니다. 개요는 둘을 한눈에 보는 방법일 뿐입니다.
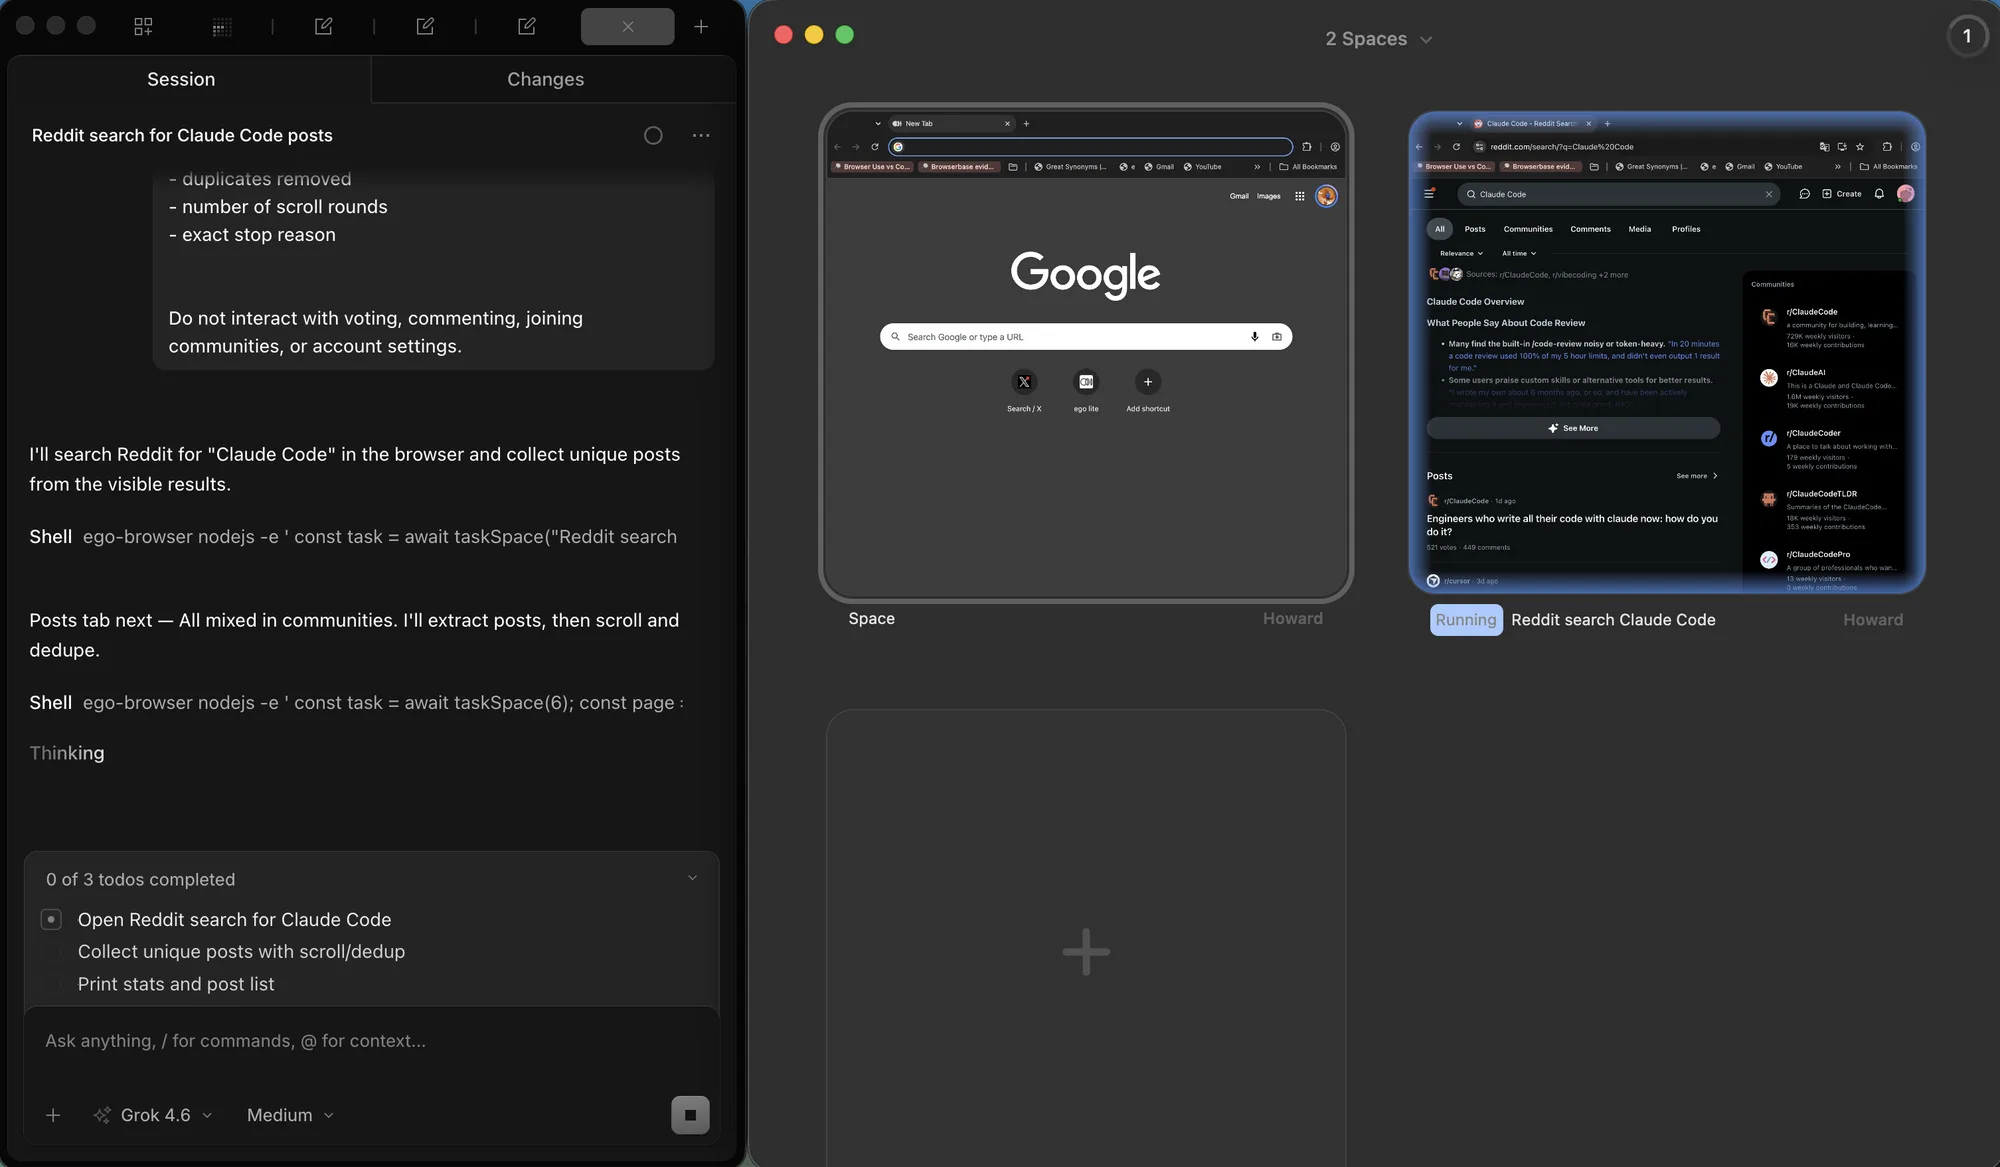
버전 0.5.0.32는 changelog(2026-09-12)에 기록돼 있다. 더 새 빌드를 인용하기 전에 그 페이지, 빠른 시작, 그리고 GitHub 저장소를 다시 확인하라. 인접 가이드 JavaScript 웹 스크래핑 는 정적 대 렌더 판단을 다른 쪽에서 다룬다.
FAQ
번호 목록이 몇 페이지인지 어떻게 아는가?
마지막 페이지 컨트롤을 보고, 헤더 합계를 페이지 크기로 나눈 뒤, 끝까지 한 번 걸어 가면 번호 목록의 페이지 수를 안다. 그 추정은 검사이며 루프의 중단 조건이 아니다.
스크레이퍼가 페이지 사이에서 중복을 모으는 이유는?
아래 목록이 다시 정렬되어 레코드가 다음 배치로 넘어가면 스크레이퍼는 페이지 사이에서 중복을 모은다. 보이는 제목이 아니라 안정적인 record id로 중복을 제거하고, 뺀 건수를 기록한다.
더 보기를 클릭한 뒤 얼마나 기다려야 하는가?
관찰 가능한 조건이 참이 될 때까지다. 행 수가 늘었거나, 버튼의 disabled가 풀렸거나, 다음 배치의 알려진 행이 나타난 경우다. 고정 지연은 추측이며, 네트워크가 느려질 때까지 통하고, 바로 그때 실패한다.
무한 피드의 끝은 어떻게 감지하는가?
사이트가 명시 신호를 주면 그걸 우선한다. 렌더된 종료 메시지, 응답의 has-more 플래그 같은 것이다. 둘 다 없으면 새 항목이 없고 로드된 내용의 높이도 안 바뀌는 검사를 여러 번 연속으로 통과한 뒤에 멈추고, 고요한 한순간으로 멈추지 않는다.
페이지네이션 스크래핑에 헤드리스 브라우저를 써야 하는가?
데이터가 렌더링, 세션, 페이지 안 Token을 필요로 할 때만 쓴다. 서버 렌더 목록과 JSON 엔드포인트는 순수 HTTP가 더 맞고, 더 빠르고 단순하다. 두 경로를 한 번 재면 비교가 대개 결정을 분명하게 만든다.
페이지네이션 크롤이 일찍 멈추는 원인은?
흔한 용의자는 셋이다. 배치가 그려지기 전에 끝난 대기, 빈 페이지로 취급한 일시 오류, 실행 중 만료된 세션 때문에 다음 페이지가 행 대신 로그인 폼을 그린 경우. 고치는 법이 각각 다르므로 중단 이유는 건수와 함께 남겨야 한다.
충돌 후 크롤을 어떻게 이어 받는가?
끝난 배치마다 모드, 위치, 지금까지 모은 행을 체크포인트한다. 이어 받기는 그 파일을 읽고 기록된 위치에서 같은 모드로 다시 들어간다. 저장된 상태 아래에서 원본이 밀리지 않았는지 확인하려고, 체크포인트 위치 직전 배치를 한 번 다시 받는다.
크롤이 완전한지 어떻게 검증하는가?
고유 레코드 수를 마지막 페이지 자신의 합계와 페이지별 건수 합처럼 독립된 숫자 두 개 이상과 맞춘 뒤, 모든 행의 필드 완결성을 보고 예외를 보고한다. 건수가 맞고 필드가 모두 있으면 강한 신호다. 하나만으로는 약하다.
지연 로딩을 켜려면 천천히 스크롤해야 하는가?
보통은 아니다. 다만 맨 아래에 주차하지 말고 로더를 다시 켜라. 사이트는 변화에 발화하는 intersection observer를 쓰므로, 한 번의 큰 점프보다 위치를 번갈아 움직이거나 단계적으로 스크롤하는 편이 더 확실하고 증가 검사도 의미를 갖는다.
로그인 뒤에 있는 페이지네이션 목록을 스크래핑할 수 있는가?
가능하다. 실제 세션과 같은 규칙이다. 예의를 지켜 페이지를 넘기고, 세션을 살려 두고, 로그인 페이지로 가는 리다이렉트는 목록의 끝이 아니라 세션 문제로 본다. ego (lite)처럼 이미 로그인을 실은 브라우저는 세션 재구성 단계를 통째로 없앤다. 지속 세션 가이드 가 상태 처리를 다루고, 가격 스크래핑 사용 사례 가 로그인한 상태의 완전한 수집이 어떤 모습인지 보여 준다.
