任務完成率
每個工具都拿到同樣的 31 項任務:在真實網站上的多步驟工作,其中許多需要先登入。只有每項要求都達成,任務才算完成。沒有部分分數。 會把 MCP 工具呼叫預算吃乾抹淨的任務:從已登入的 X 帳號整理一週的貼文分析、在兩個月的時間範圍內找出飛往任何地點最便宜的週末票價、跨法院紀錄資料庫準備證詞資料。
agent: pi · 模型: ChatGPT 5.6 Sol · 思考強度: max · 31 項任務
- ego(lite)93.5%
- playwright-cli71.0%
Playwright MCP 把瀏覽器操控包裝成給模型呼叫的工具。ego(lite) 則給 AI Agent 一個瀏覽器原生的工作空間。 在我們公開的基準測試中,ego(lite) 於 31 項真實網站瀏覽器自動化工作裡完美完成 93.5% 的任務,是受測工具中最高的完美完成率。
| 功能 | ego(lite) | Playwright MCP |
|---|---|---|
| AI Agent 如何在頁面上執行動作 | 寫 JavaScript 把多個動作批次寫進同一回合 | 每個動作一次 MCP 工具呼叫,每次都要往返模型 |
| 每項任務的 Token 成本 | 較低:Snapshot 輸入加上批次動作,以整項任務計算 | 較高:每一步都要透過 MCP 迴圈重新傳送上下文 |
| 真實網站上的瀏覽器自動化(31 項任務,同一模型) | 93.5% 完美完成,每項完成任務 $1.75,平均 6 分 38 秒 | 71% 完美完成,每項完成任務 $4.82,平均 10 分 48 秒(透過 playwright-cli 測得) |
| 沿用你真實的 Chrome 登入狀態 | 可以,一鍵匯入 Chrome 設定檔(Cookie、工作階段、擴充功能) | 沒有。每次都會啟動全新的瀏覽器,每個網站都得手動設定登入 |
| 設定 | 安裝應用程式,在你的 AI Agent 中執行 /ego-browser | 在每個 Agent 的 MCP 設定檔中把 Playwright MCP 加入 Claude Code 或 Codex,然後自行管理伺服器的生命週期 |
| 平行任務隔離 | 可以,Space 能在同一個瀏覽器裡並排執行任務 | 一個伺服器對應一個工作階段;要平行處理就得開多個伺服器實例 |
| 同時可作為你日常使用的瀏覽器 | 可以,你在自己的 Space 裡瀏覽,Agent 在它們自己的 Space 裡工作 | 沒有,純粹是自動化用的瀏覽器實例 |
| 可重複使用的 skills(即將推出) | 把成功的執行過程萃取成可重複使用的 skills,供重複性任務使用(限量 beta) | 沒有內建的對應功能 |
| 價格 | 免費,無需訂閱 | 免費、開源 |
最後更新 2026年8月30日




這項基準測試衡量的是 Agent 在真實網站上的瀏覽表現,而不是固定的測試頁面:31 項多步驟工作,其中許多需要先登入,由 ego(lite) 和 Agent 驅動的 Playwright 從頭到尾完整執行。
agent: pi · 模型: ChatGPT 5.6 Sol · 思考強度: max · 31 項任務
每個工具都拿到同樣的 31 項任務:在真實網站上的多步驟工作,其中許多需要先登入。只有每項要求都達成,任務才算完成。沒有部分分數。 會把 MCP 工具呼叫預算吃乾抹淨的任務:從已登入的 X 帳號整理一週的貼文分析、在兩個月的時間範圍內找出飛往任何地點最便宜的週末票價、跨法院紀錄資料庫準備證詞資料。
agent: pi · 模型: ChatGPT 5.6 Sol · 思考強度: max · 31 項任務
失敗的執行一樣要付費。這項指標把模型總花費除以實際完成的任務數,算出每個結果真正的成本。越低越好。
agent: pi · 模型: ChatGPT 5.6 Sol · 思考強度: max · 31 項任務
每千個模型回合獲得的評分標準分數:代表每次模型呼叫能換到多少完成的工作。越高越好。
agent: pi · 模型: ChatGPT 5.6 Sol · 思考強度: max · 31 項任務
全部 31 項任務中,每項任務的平均實際耗時。ego(lite) 完成任務的速度比 playwright-cli 快 63%。
agent: pi · 模型: ChatGPT 5.6 Sol · 思考強度: max · 31 項任務
Real-World Bench 是一項開源基準測試:在真實網站上執行 31 項複雜的真實世界瀏覽器自動化任務,每個工具都由同一個 pi Agent 搭配同一個模型(gpt-5.6-sol,思考強度 max)驅動,並由同一位評審依每項任務的評分標準打分。每個分數都涵蓋全部 31 項任務,不會逐題挑選最佳結果。 Playwright MCP 本身並未單獨參賽:本基準測試透過 playwright-cli 驅動 Playwright,它是微軟兩種 Agent 介面中較精簡的一種。MCP 伺服器共用同一個引擎,只是在每個動作之上再多一趟 MCP 工具呼叫往返。
差別在於執行介面。MCP 讓模型每一步都要協調一次工具呼叫;ego(lite) 則讓程式碼 AI Agent 操作完整的瀏覽器、組合動作,並回傳結果。搜尋、研究、資料擷取、表單、測試,或任何需要真實工作階段的網頁工作流程,都能用同一套設定完成。
Playwright MCP 每一步都要透過工具呼叫重新讀取頁面,模型思考時瀏覽器就閒置在那裡,而每多一趟往返,長任務就多一次功虧一簣的機會。在這 31 項工作中,由 Agent 驅動的 Playwright 有 29% 的任務沒能拿到滿分。在 ego(lite) 中,每個頁面都會以 Snapshot 的形式送到你的 Agent 手上:一份壓縮過的無障礙樹,帶有可立即操作的穩定 @N 參照,每一輪 JavaScript 可執行多個動作。Agent 把時間花在完成任務,而不是解析頁面:同樣 31 項任務中有 93.5% 完美完成,以平均任務時間計算,比由 Agent 驅動的 Playwright 快 63%。
Time to finish a task, shorter is better
Data source - Task: finish an average live-site job
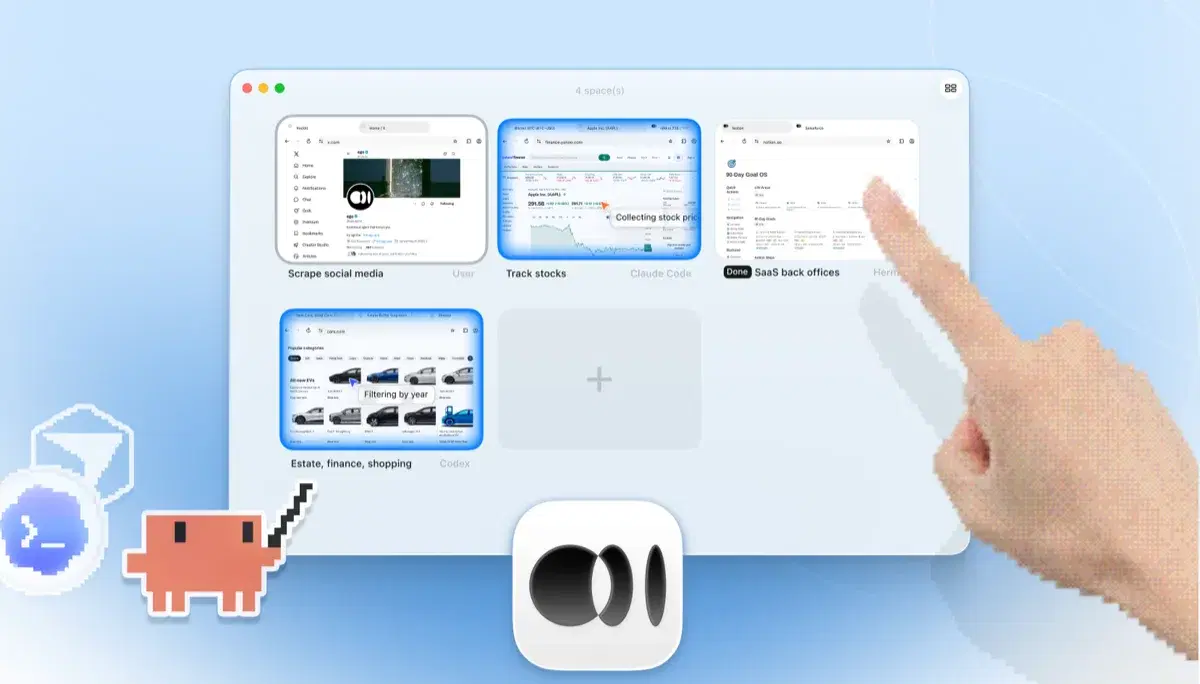
一個 Playwright MCP 伺服器只能驅動一個瀏覽器工作階段,想要平行處理就得同時管理好幾組伺服器設定。在 ego(lite) 裡,你能在同一個瀏覽器中開多少個 Space 沒有上限:每個 Space 都在自己匯入的 Chrome 設定檔上同時執行各自的任務,可以是同一個 Agent,也可以是不同的 Agent。它們都不會搶走你正在使用的分頁,而且你隨時可以旁觀或接管任何一個 Space。
Playwright MCP 的每個動作都是一次獨立的工具往返,都要把上下文重新送回模型一次。在 ego(lite) 裡,你的 Agent 每回合用幾行 JavaScript 就能批次執行多個動作。疊加上 Snapshot 輸入,同一個任務整體用的 Token 少了非常多。
同一個任務,同一個模型。 左邊:ego(lite) 用一次批次 JavaScript 呼叫,總共 1.1k Token。 右邊:Playwright MCP 來回 7 次,Token 攀升到 13.6k。
Playwright MCP 伺服器啟動的是一個空白瀏覽器,遇到 SSO、2FA 和驗證碼就會卡住。ego(lite) 建構於 Chromium 之上,能一鍵匯入你完整的 Chrome 環境。它用起來就像 Chrome,所以 Agent 可以從已授權的工作階段開始;但它不會繞過 CAPTCHA、2FA、SSO 重新導向或任何網站的存取控制。遇到驗證關卡時,請暫停並讓真人完成,或改用經核准的資料來源。
已經把 Playwright MCP 接進 Claude Code 或 Codex 了嗎?切換只需要幾分鐘,而且你不需要移除任何東西。
下載 ego(lite)
下載 ego(lite),一鍵匯入你的 Chrome 設定檔,登入狀態、Cookie 和擴充功能全部一併帶入。
用 /ego-browser 執行你的第一個任務
把一句話貼進 Claude Code、Codex 或 Cursor,按下 Enter 就好。不用設定 MCP 伺服器,不用改 JSON,也不用寫測試腳本。
貼到你的 Agent 裡
/ego-browser 打開 ego.app,檢查頁面有沒有主控台錯誤
看它實際運作
任務會在專屬的 Space 中執行,所以你的分頁完全不受影響。瀏覽器視窗是真實存在的:你可以即時觀看,也能隨時接手。結果會回傳到你 AI Agent 的 CLI 中。
在適合其工具協定的場景,繼續使用 Playwright MCP。ego(lite) 為你的 Agent 提供更寬廣的瀏覽器路徑,用於搜尋、研究、資料擷取、表單、測試和其他網頁工作,而且不會取代已提交的 Playwright 測試。
與 Puppeteer、Claude Chrome extension、Browser Harness、Browserbase,以及另外 7 款工具的逐項比較。
免費,在你的電腦上執行,一鍵匯入你的 Chrome 個人設定檔。適用於 Claude Code、Codex、Cursor,以及任何會寫程式碼的 CLI AI Agent。