
Eine JavaScript-gerenderte Seite kann eine erfolgreiche Antwort liefern und Ihren Scraper trotzdem mit null Zeilen zurücklassen. Das HTML ist geladen, aber die Karten, die ein Nutzer im Browser sieht, existieren im DOM möglicherweise noch nicht. Mit ego (lite) ist diese Lücke sichtbar. Ihre Aufgabe läuft in einem beobachteten Chromium-Space, sodass Sie sehen, ob die Seite noch rendert, der Selektor nicht greift oder die benötigten Daten gar nicht erschienen sind.
Playwright macht dieses bestätigte Verhalten zu einem stabilen, wiederholbaren Scraping-Ablauf. Es kann auf das Rendern der Zielkarten warten, Felder aus dem Live-DOM extrahieren und prüfen, dass das Ergebnis die erwarteten Daten enthält. Sobald Selektor und Wartebedingung feststehen, ist Playwright der natürliche Weg, sie in ein zuverlässiges Skript zu gießen. Wenn die Aufgabe weiterhin visuelle Prüfung, eine bereits angemeldete Browser-Sitzung oder eine menschliche Übernahme an einem bestimmten Schritt braucht, hält ego (lite) den Browserzustand sichtbar und interaktiv, sodass ein Skript mit Exit 0 nicht verbergen kann, dass es tatsächlich nichts gescrapet hat.
Was ist Web Scraping mit Playwright?
Web Scraping mit Playwright bedeutet, einen echten Browser zu steuern, damit JavaScript die Seite zeichnen kann, und dann die gerenderten Knoten zu lesen. Der Browser ist der Scraper. Die HTML-Antwort ist nur die Hülle, bis Skripte laufen.
Playwright startet Chromium, Firefox oder WebKit, öffnet einen Kontext und stellt page.goto, Waits, Locators und page.evaluate bereit. Diese APIs existieren für Tests. Sie funktionieren auch für die Extraktion, weil beide Aufgaben dasselbe brauchen: ein DOM, das dem entspricht, was ein Mensch sieht.
Die benachbarten Aufgaben bleiben von dieser Seite fern.
Die Wahl zwischen fetch und einem Browser in JavaScript wird behandelt in Web Scraping mit JavaScript. Eine angemeldete Sitzung über Läufe hinweg wiederzuverwenden, wird behandelt in dauerhafte Browser-Sitzungen. Login-Walls auf X und LinkedIn werden behandelt in KI-Scraping hinter Login-Walls. Nummerierte Seiten, Load More und Infinite Scroll warten, bis diese einzelne Seite bereits die richtigen Zeilen liefert.
Wann scrapen Sie mit Playwright statt mit HTTP?
Nutzen Sie Playwright, wenn ein GET der URL die Knoten nicht enthält, die Sie scrapen wollen. Nutzen Sie HTTP, wenn die Werte bereits im Response-Body stehen oder die Seite bereits einen dokumentierten JSON-Endpunkt bereitstellt.
quotes.toscrape.com/js ist absichtlich so gebaut. Ein GET der URL liefert HTML ohne class="quote"-Knoten. Die Zitate liegen in einem Inline-Array var data, dann zeichnet jQuery die Karten. Ein CSS-Parser, der .quote gegen die Rohantwort richtet, speichert nichts und sieht aus wie ein Selektorfehler.
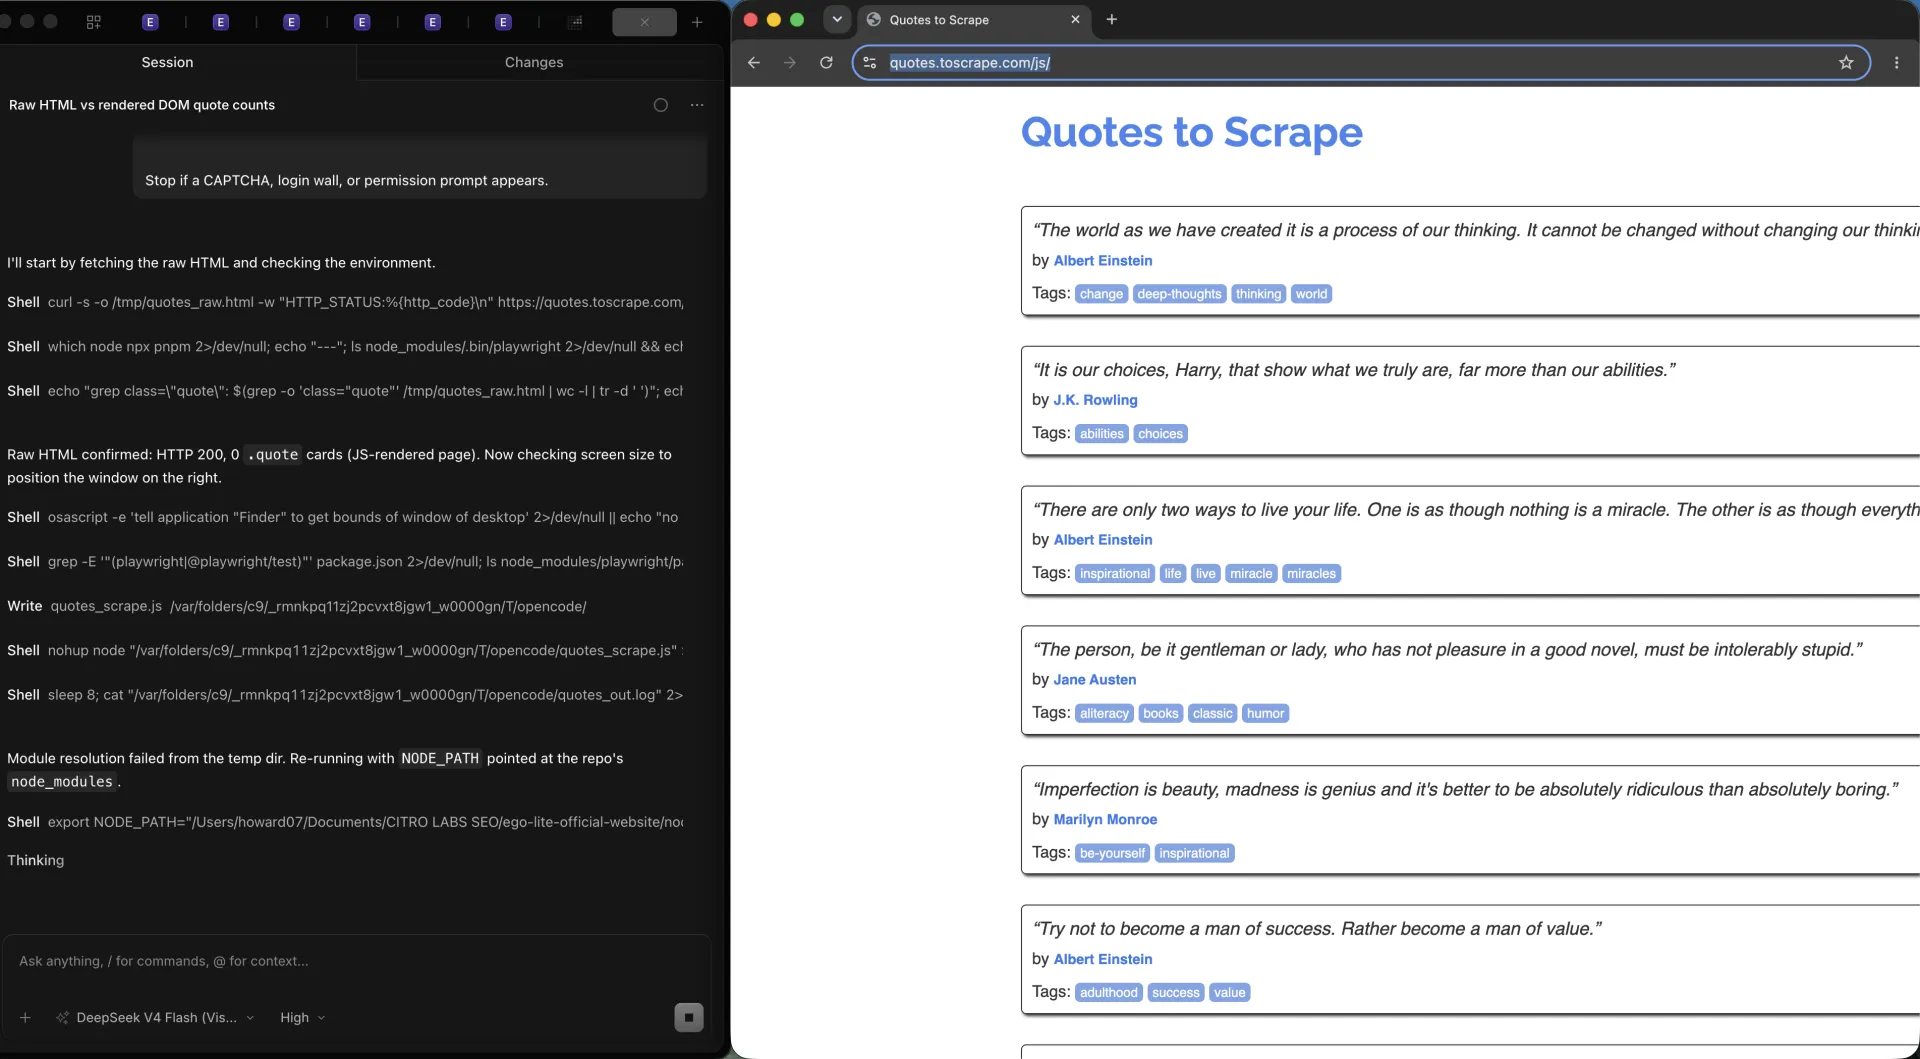
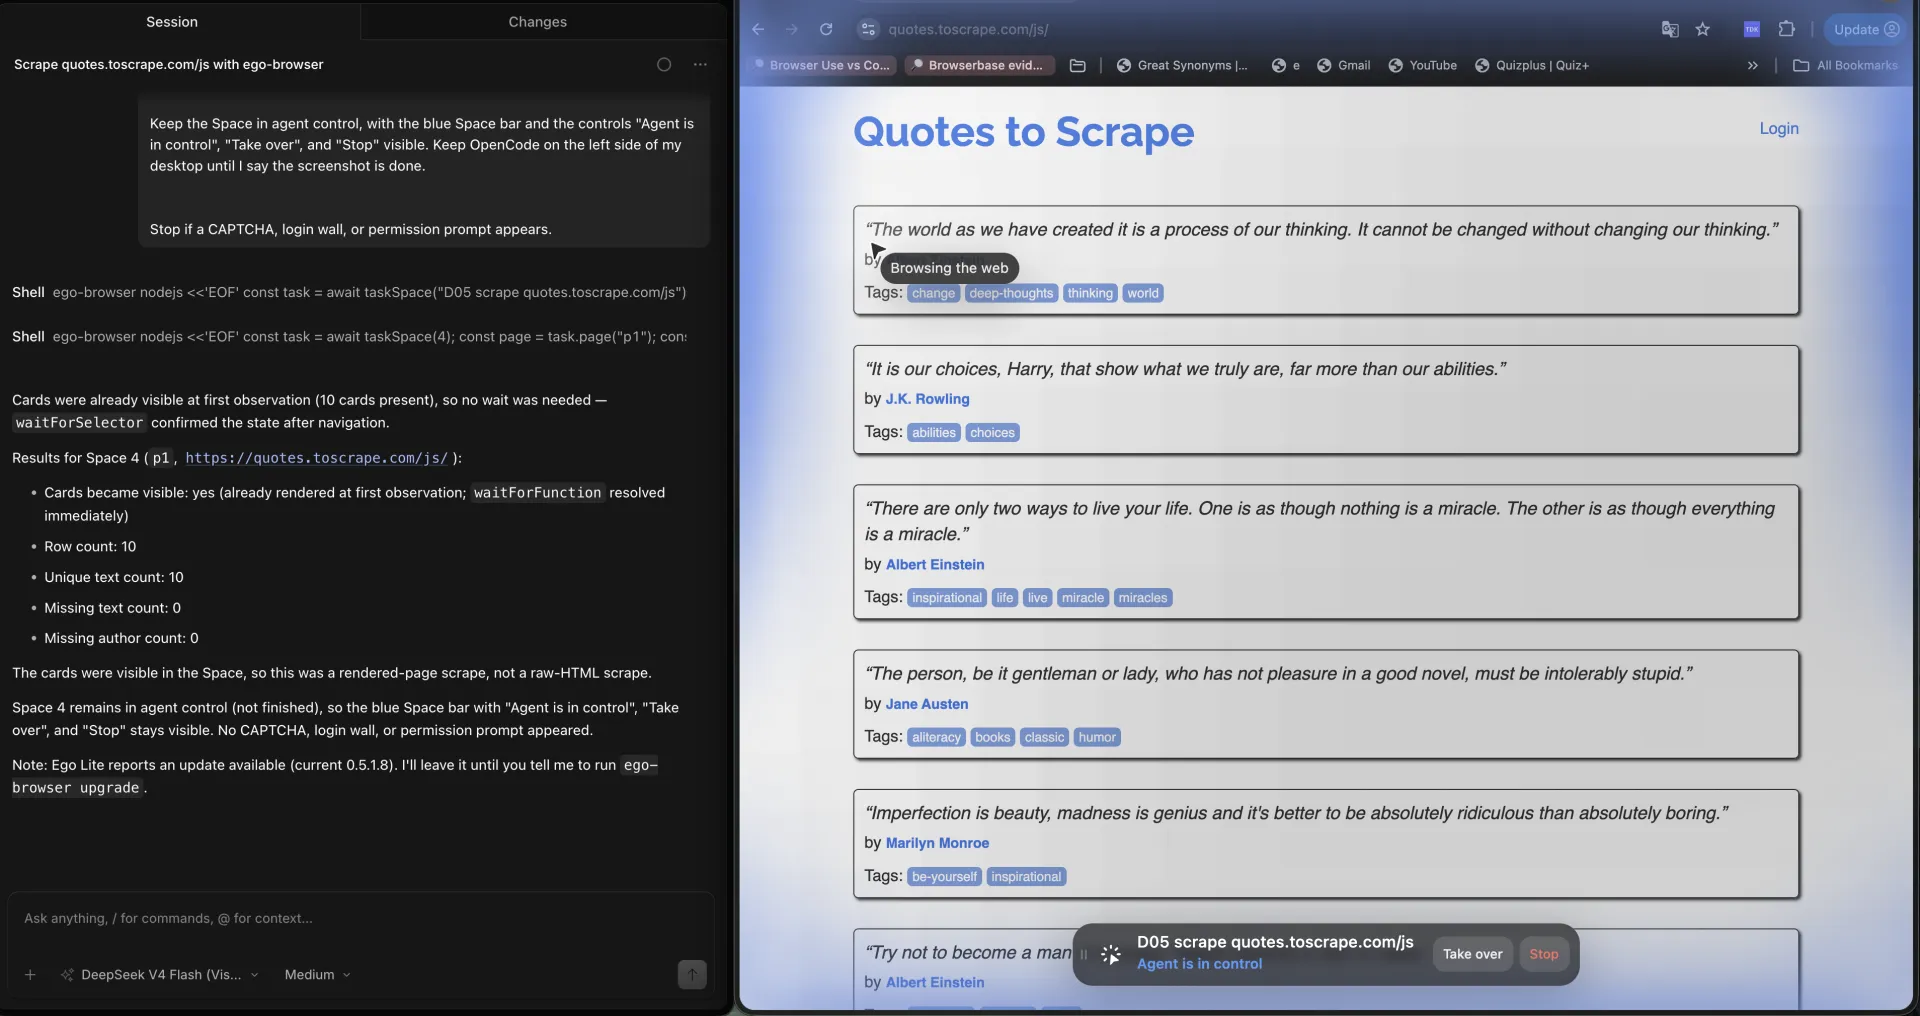
Wir haben diese Trennung am 2026-09-18 aus OpenCode getestet. Ein GET von quotes.toscrape.com/js lieferte HTTP 200 und 0 .quote-Karten im Roh-HTML, während das headed-Chromium-Fenster rechts bereits die gezeichnete Liste zeigte.
Betrachten Sie die Trennung so.
| Route | Was möglich ist | Was nicht möglich ist |
|---|---|---|
| HTTP GET + HTML-Parser | Liest die Bytes, die der Server gesendet hat. Günstig, schnell und ausreichend, wenn die Karten bereits im Markup stehen. | Seitenskripte ausführen oder auf später erscheinende Knoten warten. Gegen quotes.toscrape.com/js sieht er keine .quote-Karten im Roh-HTML. |
| Die Inline-Nutzlast parsen | Auf quotes.toscrape.com/js kann ein Regex plus JSON.parse von var data die Zitate aus demselben HTML holen, ohne Browser. | Ein Redesign überstehen, das das Array nicht mehr einbettet. Interne Nutzlasten sind kein API-Vertrag. |
| Von Playwright gerendertes DOM | Führt das Seiten-JavaScript aus, wartet auf .quote und extrahiert die Karten, die ein Mensch sieht. | Günstig bleiben. Jeder Kontext kostet Speicher, und eine Flotte davon ist das falsche Werkzeug für statisches HTML. |
Der ehrliche Zusatz zu dieser Demo: Playwright ist nicht nötig, wenn var data direkt geparst wird. Die meisten JS-Sites lassen kein benanntes Array in der ersten Antwort. Playwright ist die Route, die trotzdem funktioniert, wenn sie das nicht tun.
Wie starten, navigieren und warten Sie auf Inhalte?
Der minimale Playwright-Scrape ist Start, neuer Kontext, goto, Warten auf den Kartenselektor, Extrahieren, dann Schließen. Das Warten zu überspringen, liefert eine erfolgreiche leere Datei.
Playwrights page.goto kann bei commit, domcontentloaded, load oder networkidle anhalten. waitForSelector ist die Prüfung, dass das, wofür Sie gekommen sind, tatsächlich existiert. Auf quotes.toscrape.com/js kann goto({ waitUntil: 'domcontentloaded' }) bereits reichen, weil das Inline-Skript in diesem HTML läuft. Das ist Glück, keine Regel.
import { chromium } from "playwright";

const browser = await chromium.launch();
const context = await browser.newContext();
const page = await context.newPage();

try {
  await page.goto("https://quotes.toscrape.com/js/", {
    waitUntil: "domcontentloaded",
  });
  await page.waitForSelector(".quote");
  const rows = await page.evaluate(() =>
    [...document.querySelectorAll(".quote")].map((el) => ({
      text: el.querySelector(".text")?.textContent?.trim() ?? "",
      author: el.querySelector(".author")?.textContent?.trim() ?? "",
      tags: [...el.querySelectorAll(".tag")].map((tag) =>
        tag.textContent?.trim(),
      ),
    })),
  );
  console.log(rows.length);
} finally {
  await context.close();
  await browser.close();
}
Um den leeren Scrape zu sehen, extrahieren Sie bei commit, bevor die Karten existieren, oder verzögern Sie das Skript, das sie zeichnet. Diese frühe Extraktion liefert 0 Zeilen. Nach waitForSelector('.quote') liefert dieselbe Seite die gerenderten Karten. Im leeren Fall wirft nichts.
| Warten | Was es belegt | Wie es scheitert |
|---|---|---|
| nur commit | Die Navigation hat begonnen. Nützlich als Negativtest. | Skripte sind möglicherweise nicht gelaufen. Eine Extraktion bei commit, bevor das Zeichenskript läuft, liefert 0 Zitate. |
| domcontentloaded | Das initiale HTML ist geparst. Auf diesem Fixture reicht das, weil var data in diesem HTML läuft. | Späte XHR-Karten können noch fehlen. Behandeln Sie es nicht als „Inhalt ist bereit“. |
| waitForSelector('.quote') | Mindestens eine Karte existiert im DOM. Das ist das Warten, das aus dieser Demo scrapbare Zeilen macht. | Eine veraltete Klasse kann die vorherige Liste treffen. Warten Sie auf ein Feld, das sich mit den Daten ändert, nicht auf einen Wrapper, der nie verschwindet. |
Schließen Sie den Kontext in finally. Kontexte halten den Speicher. Ein Scrape, der mitten in der Extraktion wirft, muss Chromium trotzdem freigeben.
Wie extrahieren Sie Felder aus einer gerenderten Seite?
Extrahieren Sie in der Seite mit page.evaluate, oder mit Locators, wenn Sie ein Steuerelement statt einer Liste brauchen. Beide lesen das gerenderte DOM. Keines liest den ursprünglichen HTML-Snapshot von goto.
Mappen Sie jedes .quote auf text, author und tags. Die öffentliche Demo zeichnet zehn Karten. Pflichtfelder sind text und author. Der eindeutige Schlüssel ist der Zitattext, nicht der Autor, weil Einstein mehrfach vorkommt.
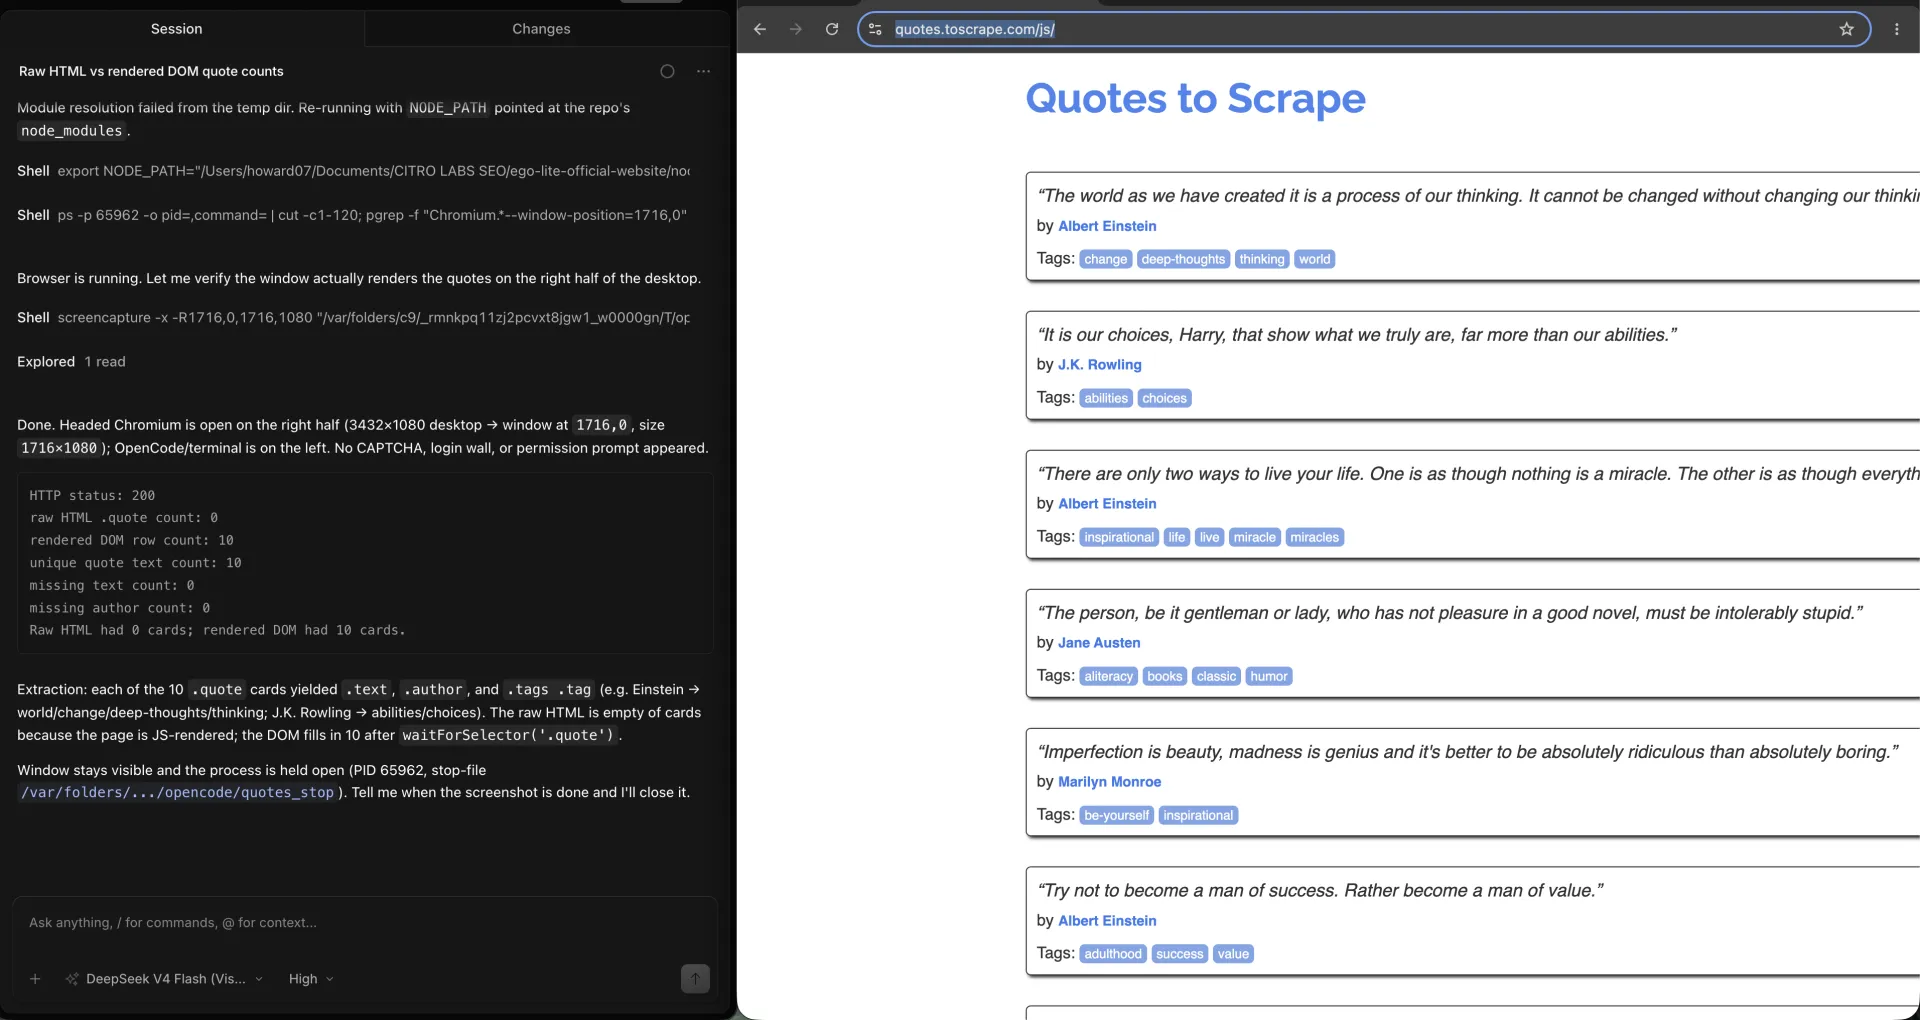
Wir haben diese Extraktion in derselben OpenCode-Sitzung getestet. Nach waitForSelector('.quote') druckte der headed Lauf 10 Zeilen, 10 eindeutige Texte und 0 fehlende Autoren. Das Roh-HTML hatte weiterhin 0 Karten.
Locators sind der sauberere Weg für ein einzelnes Feld. Playwright-Locators fragen vor jeder Aktion neu ab, weshalb sie ein Re-Render überstehen, das ein gespeichertes Element-Handle zerbricht.
const title = await page.locator(".quote .text").first().innerText();
const author = await page.locator(".quote .author").first().innerText();
page.evaluate ist die bessere Listenextraktion. Es läuft in der Seite und liefert JSON. Halten Sie den Mapper klein. Holen Sie text, author, tags und einen eindeutigen Schlüssel. Lassen Sie Screenshots und PDFs aus der Scrape-Schleife.
Per CSS versteckter Text sitzt weiterhin im DOM. innerText folgt dem Layout. textContent nicht. Wenn eine Site einen Titel per CSS abschneidet, liefert textContent trotzdem den vollständigen String. Entscheiden Sie, welchen Sie erheben, bevor Sie den Validator schreiben.
Wie fangen Sie die eigenen Daten der Seite ab?
Interception ist nützlich, wenn die Seite bereits JSON holt, das statt aus Karten geparst gespeichert werden kann. Auf quotes.toscrape.com/js feuert diese Anfrage nie, und das ist der Punkt.
Die Zitate in dieser Demo kommen nicht von einer API. Sie sind als var data im HTML eingebettet und werden dann von jQuery in .quote-Knoten gezeichnet. Ein Response-Listener, der nach JSON sucht, sieht nichts Brauchbares.
Playwrights Netzwerk-Dokumentation zeigen page.route und Response-Listener. Nutzen Sie sie. Zeichnen Sie dann auf, was die Seite tatsächlich gesendet hat, einschließlich nichts.
const jsonResponses = [];
page.on("response", async (response) => {
  const type = response.headers()["content-type"] || "";
  if (type.includes("json")) {
    jsonResponses.push({
      url: response.url(),
      status: response.status(),
    });
  }
});
await page.goto(url, { waitUntil: "domcontentloaded" });
await page.waitForSelector(".quote");
console.log(jsonResponses.length);
Wenn kein JSON-Body da ist, fallen Sie auf die gerenderten Karten zurück oder parsen Sie das Inline-Skript, das Sie bereits heruntergeladen haben. Erfinden Sie keinen Endpunkt, nur weil Tutorials immer einen zeigen. Oxylabs, BrowserStack und ScraperAPI demonstrieren alle Intercept. Sie sagen nicht, was passiert, wenn die Site die Anfrage nie feuert.
Wie prüfen Sie Felder, Duplikate und Anzahlen?
Ein Scrape ist nicht fertig, wenn das Skript mit 0 endet. Er ist fertig, wenn die Datei die erwartete Anzahl hat, jedes Pflichtfeld vorhanden ist und der eindeutige Schlüssel zwei Zeilen nicht zu einer zusammenzieht.
Eine bestandene Extraktion auf dieser Demo schreibt zehn Zeilen mit eindeutigen Texten und ohne fehlende Autoren. Eine Extraktion, bevor die Karten existieren, schreibt 0 Zeilen mit demselben zufriedenen Logger, sofern die Anzahl nicht geprüft wird.
function validate(rows, expectedCount) {
  const missing = rows.filter((row) => !row.text || !row.author);
  const unique = new Set(rows.map((row) => row.text));
  if (rows.length !== expectedCount) {
    throw new Error(`expected ${expectedCount}, got ${rows.length}`);
  }
  if (missing.length) {
    throw new Error(`${missing.length} rows missing text or author`);
  }
  if (unique.size !== rows.length) {
    throw new Error("duplicate texts");
  }
}
Nutzen Sie eine kurze Checkliste und scheitern Sie laut.
| Prüfung | Bestanden | Fehlermodus, den Sie behalten |
|---|---|---|
| Erwartete Anzahl | Zehn Karten nach waitForSelector('.quote') | 0 Zeilen, wenn die Extraktion vor dem Zeichenskript läuft |
| Pflichtfelder | text und author in jeder Zeile | Ein Selektor, der die Karte trifft, aber .author verfehlt |
| Eindeutiger Schlüssel | Eindeutige Zitattexte, nicht eindeutige Autoren | Dedup über den Autor, die Einstein zusammenziehen würde |
Behalten Sie die leere Extraktion. Das 0-Zeilen-Ergebnis ist der Beleg, dass das Warten zählt. Es zu löschen lässt eine spätere volle Extraktion wie den Standard aussehen.
Was lässt einen Playwright-Scrape scheitern?
Die Fehler, die hier zählen, sind leere Renders, veraltete Selektoren und Rate Limits. Keiner sieht nach einem roten Stacktrace aus, wenn Sie nur die Zeilenlänge nach einem catch protokollieren, der Fehler schluckt.
Leerer Render: Die Navigation war erfolgreich, der Selektor hat nie getroffen, Sie haben [] gespeichert. Korrigieren Sie das Warten. Wiederholen Sie nicht dieselbe Extraktion gegen dasselbe unfertige DOM.
Veralteter Selektor: .quote existiert noch, aber der Text ist umgezogen. Der Lauf liefert 10 Zeilen von gestern. Warten Sie auf ein Feld, das sich mit dem Inhalt ändert, und vergleichen Sie dann die eindeutigen Schlüssel mit der vorherigen Datei.
Rate Limit: Eine 429 ist ein Stoppschild. Lesen Sie Retry-After, wenn er da ist, gehen Sie zurück und deckeln Sie die Retries. Dieselbe URL zu hämmern, ist der Weg, wie eine IP gesperrt wird, und dieser Leitfaden behandelt kein Bypass.
async function gotoWithRetry(page, url, attempt = 0) {
  const response = await page.goto(url, { waitUntil: "domcontentloaded" });
  const status = response?.status() ?? 0;
  if (status === 429 || status >= 500) {
    if (attempt >= 3) throw new Error(`giving up on ${url}: ${status}`);
    const retryAfter = Number(response?.headers()["retry-after"]);
    const waitMs = Number.isFinite(retryAfter)
      ? retryAfter * 1000
      : 2 ** attempt * 1000;
    await page.waitForTimeout(waitMs);
    return gotoWithRetry(page, url, attempt + 1);
  }
  if (status && status >= 400) throw new Error(`${status} for ${url}`);
  return response;
}Wann ist ein sichtbarer Browser-Agent der bessere Weg?
Ein sichtbarer Browser-Agent ist der bessere Weg, wenn das Warten falsch ist, der Selektor umgezogen ist oder eine Person auf die Seite schauen und übernehmen muss. Er ist kein Ersatz für eine eingefrorene Playwright-Schleife, der Sie in CI bereits vertrauen.
Das ist die Ergänzung, nicht der Wettbewerber. Playwright kodiert das Warten, das bereits verstanden ist. ego (lite) 0.5.0.32 hält die Aufgabe in einem beobachteten Chromium-Space, sodass die Karten beim Erscheinen sichtbar sind, der Agent gestoppt oder eine Person übernehmen kann, wenn das Warten lügt. Es verwendet ein echtes Profil wieder, wenn der nächste Scrape einen bereits vorhandenen Login braucht. Es macht eine statische HTML-Seite nicht günstiger und umgeht keine Sperre. Das Changelog zu dieser Version ist vom 2026-09-12 auf dem ego (lite)-Changelog.
Wir haben diese Isolation in ego (lite) aus OpenCode getestet. Die Spaces-Übersicht hielt den Zitat-Scrape in einem eigenen laufenden Space, andere Arbeit in einem getrennten Space statt in einem gemeinsamen headed-Chromium-Fenster.
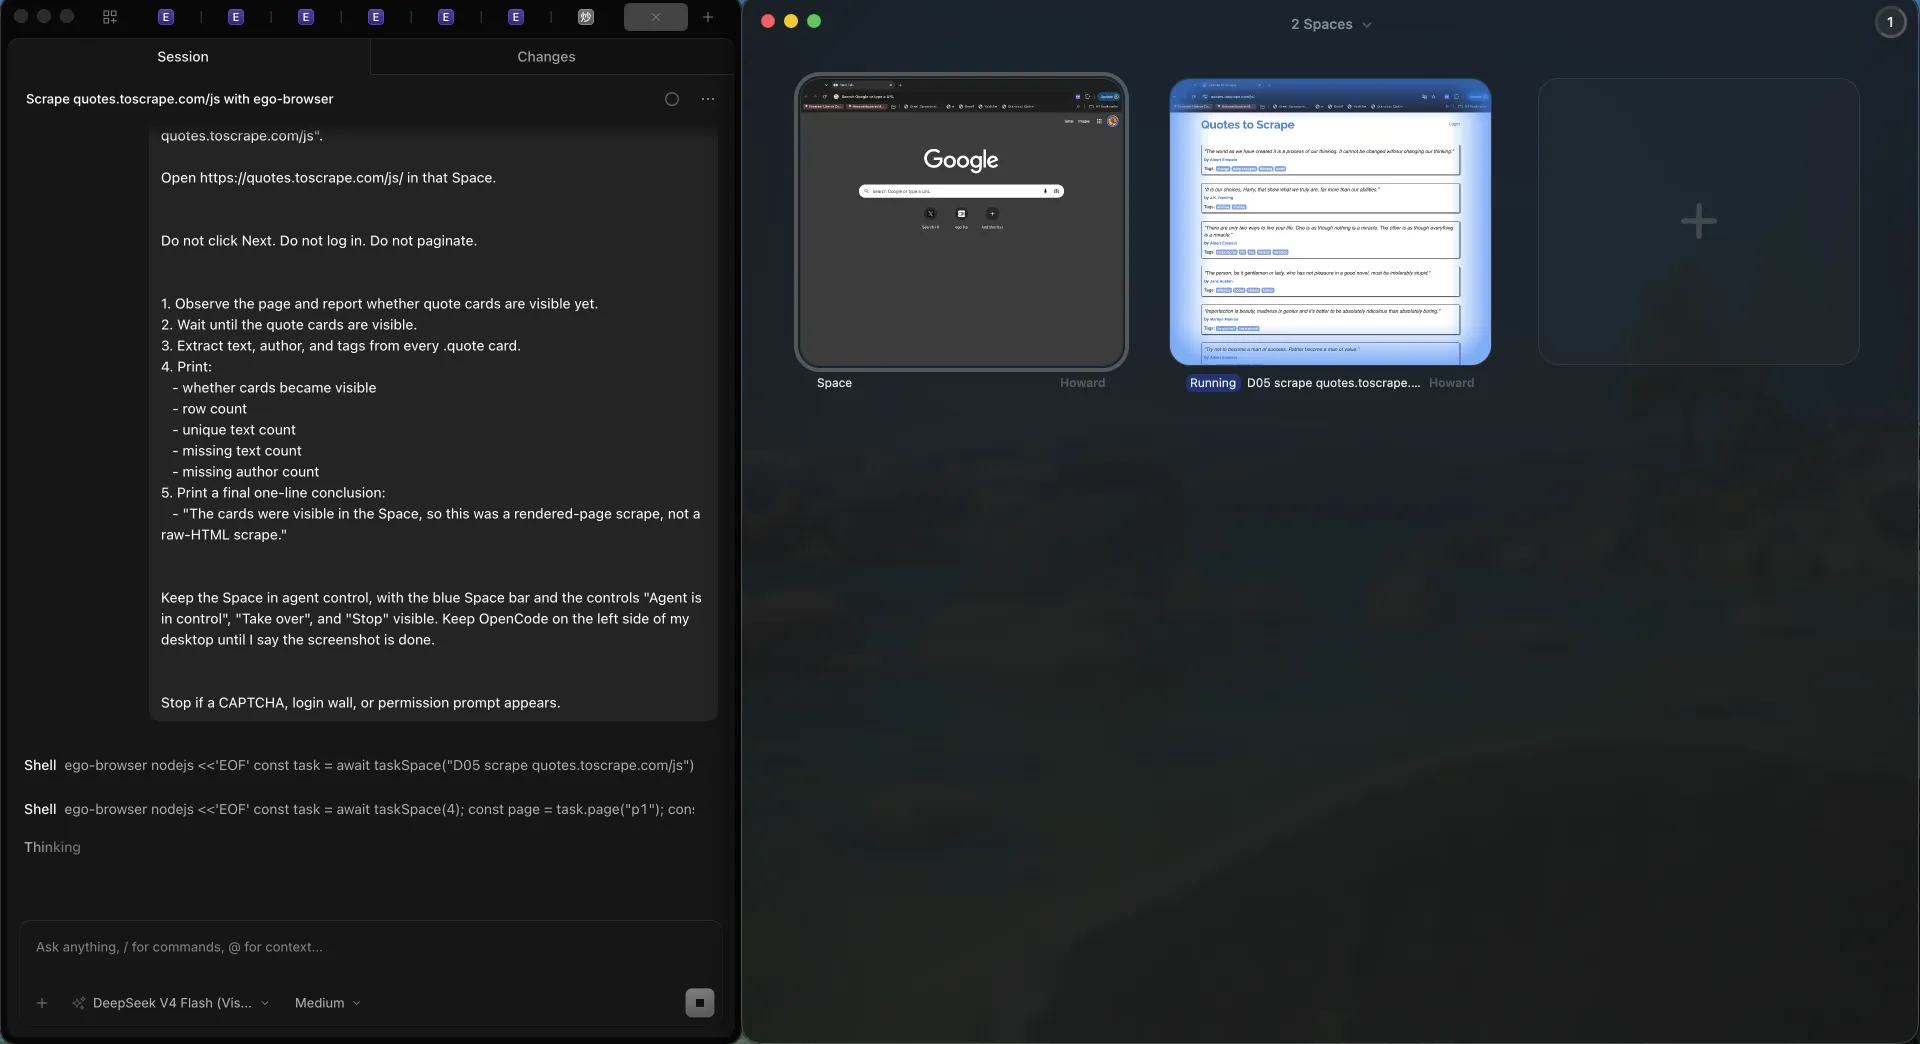
Wir haben dieselbe öffentliche URL in einem dieser Spaces getestet. Space 4 blieb unter Agentensteuerung auf quotes.toscrape.com/js, mit sichtbarem Take over und Stop, und druckte 10 eindeutige Karten.
Der Kompromiss zwischen Headless und Headed wird behandelt in Headless-Browser vs. echter Browser für KI-Agenten. Die Bibliothekswahl wird behandelt in Playwright vs. Puppeteer zum Scraping. Der Produktvergleich steht auf ego (lite) vs. Playwright.
Was sind die Herausforderungen und Grenzen?
Playwright-Scraping scheitert leiser als HTTP-Scraping, weil der Browser in Ordnung aussehen kann, während die Datei falsch ist.
Die erste Grenze ist die Kosten. Ein Chromium-Kontext ist nicht ein GET. Stehen die Karten bereits im HTML, zahlen Sie für einen Browser, den Sie nicht brauchen.
Die zweite ist Ehrlichkeit beim Intercept. Tutorials behandeln XHR-Capture als den fortgeschrittenen Schritt. Auf dieser Demo ist der fortgeschrittene Schritt zuzugeben, dass die Nutzlast inline liegt.
Die dritte Grenze bleibt hier eine Zeile. Sobald eine gerenderte Seite validiert, werden nummerierte Seiten, Load More und Infinite Scroll zu einer eigenen Aufgabe. Diese Schleifen in diese Warte-und-Extrahier-Seite zu mischen, würde den Fehler des leeren DOM verdecken.
Die vierte ist die Erlaubnis. robots-Regeln, Nutzungsbedingungen und Datenschutzrecht gelten weiterhin. Ein headed Browser schafft kein Recht zu erheben.
Wenn der Scrape leer ist und die Seite voll aussieht, warten Sie auf die Karte und zählen Sie dann die Zeilen. Ein sichtbares Fenster ist kein Beweis. Auf diesem Fixture fand der Intercept auch kein JSON-XHR; die Zitate lagen bereits inline als var data.
FAQ
Eignet sich Playwright für Web Scraping?
Playwright eignet sich zum Scraping, wenn die sichtbaren Karten im Roh-HTML fehlen und der Scraper in einem echten Browser auf sie warten kann. quotes.toscrape.com/js ist das öffentliche Beispiel: Ein GET liefert keine .quote-Knoten, und ein Warten auf .quote liest die gezeichneten Karten. Für statisches HTML oder eine dokumentierte API ist es der falsche Standard.
Wann reicht HTTP statt Playwright?
Nutzen Sie HTTP, wenn die Werte bereits im Response-Body stehen. Die JavaScript-Demo enthält weiterhin var data mit den Zitaten, obwohl sie keine .quote-Karten enthält. Ist ein Parser dieser Nutzlast stabil, lassen Sie den Browser weg.
Warum liefert mein Playwright-Scrape null Zeilen?
Null Zeilen bedeuten meist, dass die Extraktion lief, bevor die Karten existierten. Das DOM bei commit zu lesen, bevor das Zeichenskript läuft, liefert auf dieser Demo 0 Zitate, danach die gerenderten Karten nach waitForSelector('.quote'), ohne Exception im leeren Fall.
Wie warte ich auf gerenderte Karten in Playwright?
Warten Sie auf den Selektor, der die Daten repräsentiert, nicht auf ein ruhiges Netz. networkidle kann an Analytics-Beacons hängen. Das bestandene Warten auf dieser Demo ist .quote, nicht networkidle.
Wie fange ich JSON mit Playwright ab?
Hören Sie auf Antworten, deren content-type json enthält, oder routen Sie die URL, die die Seite bereits aufruft. Auf quotes.toscrape.com/js liegen die Zitate inline, es gibt also kein JSON-XHR zum Abfangen. Intercept ist optional. Das DOM-Warten funktioniert trotzdem.
Wie scrape ich mehrseitige Listen mit Playwright?
Schließen Sie zuerst eine gerenderte Seite ab: warten, extrahieren, Anzahl prüfen. Nummerierte Seiten, Load More und Infinite Scroll sind eine eigene Aufgabe. Diese Seite implementiert diese Schleifen nicht.
Wie übernehme ich einen Login in einem Playwright-Scrape?
Speichern Sie den Storage State nach einem Login, den Sie verwenden dürfen, und laden Sie ihn in einem späteren Kontext. Behandeln Sie die Datei als Geheimnis und rechnen Sie mit ihrem Ablauf.
Was tun bei einer 429?
Halten Sie an, beachten Sie Retry-After, wenn er da ist, gehen Sie zurück und scheitern Sie nach einer kleinen Retry-Obergrenze. Eine 429 ist ein Rate-Signal, kein Selektorproblem.
Brauche ich ego (lite) für Playwright-Scraping?
Nein. Nutzen Sie Playwright, wenn Warten und Selektor bereits feststehen. Nutzen Sie ego (lite), wenn der Scrape einen beobachteten Space, ein echtes angemeldetes Profil oder eine menschliche Übernahme braucht. Am 2026-09-18 extrahierten beide Wege 10 eindeutige Karten von quotes.toscrape.com/js; der Space hielt Take over und Stop sichtbar.
Ist Scraping mit einem echten Browser legal?
Das hängt von der Site, den Daten, der Gerichtsbarkeit und davon ab, was Sie mit der Datei tun. robots-Regeln und Nutzungsbedingungen gelten auch in einem headed Browser. Das ist keine Rechtsberatung.
Playwright oder Puppeteer zum Scraping?
Beide können dieselbe Seite rendern. Die Bibliothekswahl betrifft Locators, Warten und Sprachbindungen. Die Entscheidung HTTP gegen Browser auf dieser Seite kommt zuerst.
Wenn der nächste Scrape einen beobachteten Browser braucht statt eines weiteren kodierten Wartens, ist ego (lite) kostenlos zum Herunterladen. Der Preis-Scraper-Durchgang ist eine konkrete Aufgabe in diesem Space.
