
JavaScript 渲染頁可以回傳成功回應,爬蟲卻仍是 0 筆。HTML 已經載入,使用者在瀏覽器看到的卡片,DOM 裡卻可能還沒出現。用 ego (lite) 時,這個落差看得到。任務跑在可監看的 Chromium Space 裡,你能看出頁面還在渲染、選擇器沒對上,或你要的資料根本沒出現。
Playwright 把已確認的行為寫成穩定、可重跑的抓取流程。它可以等候目標卡片渲染、從即時 DOM 擷取欄位,並驗證結果裡有你預期的資料。選擇器與等候條件一旦確定,用 Playwright 寫進腳本最自然。若任務還需要目視檢查、既有的已登入瀏覽器工作階段,或某個步驟要人接手,ego (lite) 會把瀏覽器狀態維持可見、可互動。腳本即使正常結束,也藏不住其實一筆都沒抓到。
怎麼用 Playwright 抓 JS 渲染頁?
用 Playwright 抓網頁,就是驅動真實瀏覽器讓 JavaScript 把頁面畫出來,再讀取渲染後的節點。瀏覽器本身就是爬蟲。HTML 回應在指令碼跑完前只是空殼。
Playwright 會啟動 Chromium、Firefox 或 WebKit,開一個 context,再給你 page.goto、等候、locator 與 page.evaluate。這些 API 是為測試寫的,擷取也能用,因為兩件事要的是同一樣:跟肉眼看到的一樣的 DOM。
相鄰的工作不在這頁處理。
在 JavaScript 裡該用 fetch 還是瀏覽器,見 用 JavaScript 做網頁抓取。跨次執行重用已登入工作階段,見 持久瀏覽器工作階段。X 與 LinkedIn 的登入牆,見 登入牆後方的 AI 抓取。編號頁、Load More 與無限捲動,要等這一頁已經回傳正確資料列之後再談。
什麼時候該用 Playwright 抓,而不是 HTTP?
對 URL 做 GET 卻沒有你要抓的節點時,用 Playwright。數值已經在回應內容裡,或頁面已提供有文件的 JSON 端點時,用 HTTP。
quotes.toscrape.com/js 就是故意做成這樣。對這個 URL 做 GET,回傳的 HTML 沒有 class="quote" 節點。名言放在行內的 var data 陣列,再由 jQuery 畫成卡片。CSS 解析器拿 .quote 去對原始回應,什麼都存不到,看起來像選擇器寫錯。
我們在 2026-09-18 從 OpenCode 測過這個落差。對 quotes.toscrape.com/js 做 GET,拿到 HTTP 200,原始 HTML 裡 0 張 .quote 卡片;右側 headed Chromium 視窗卻已經顯示畫好的清單。
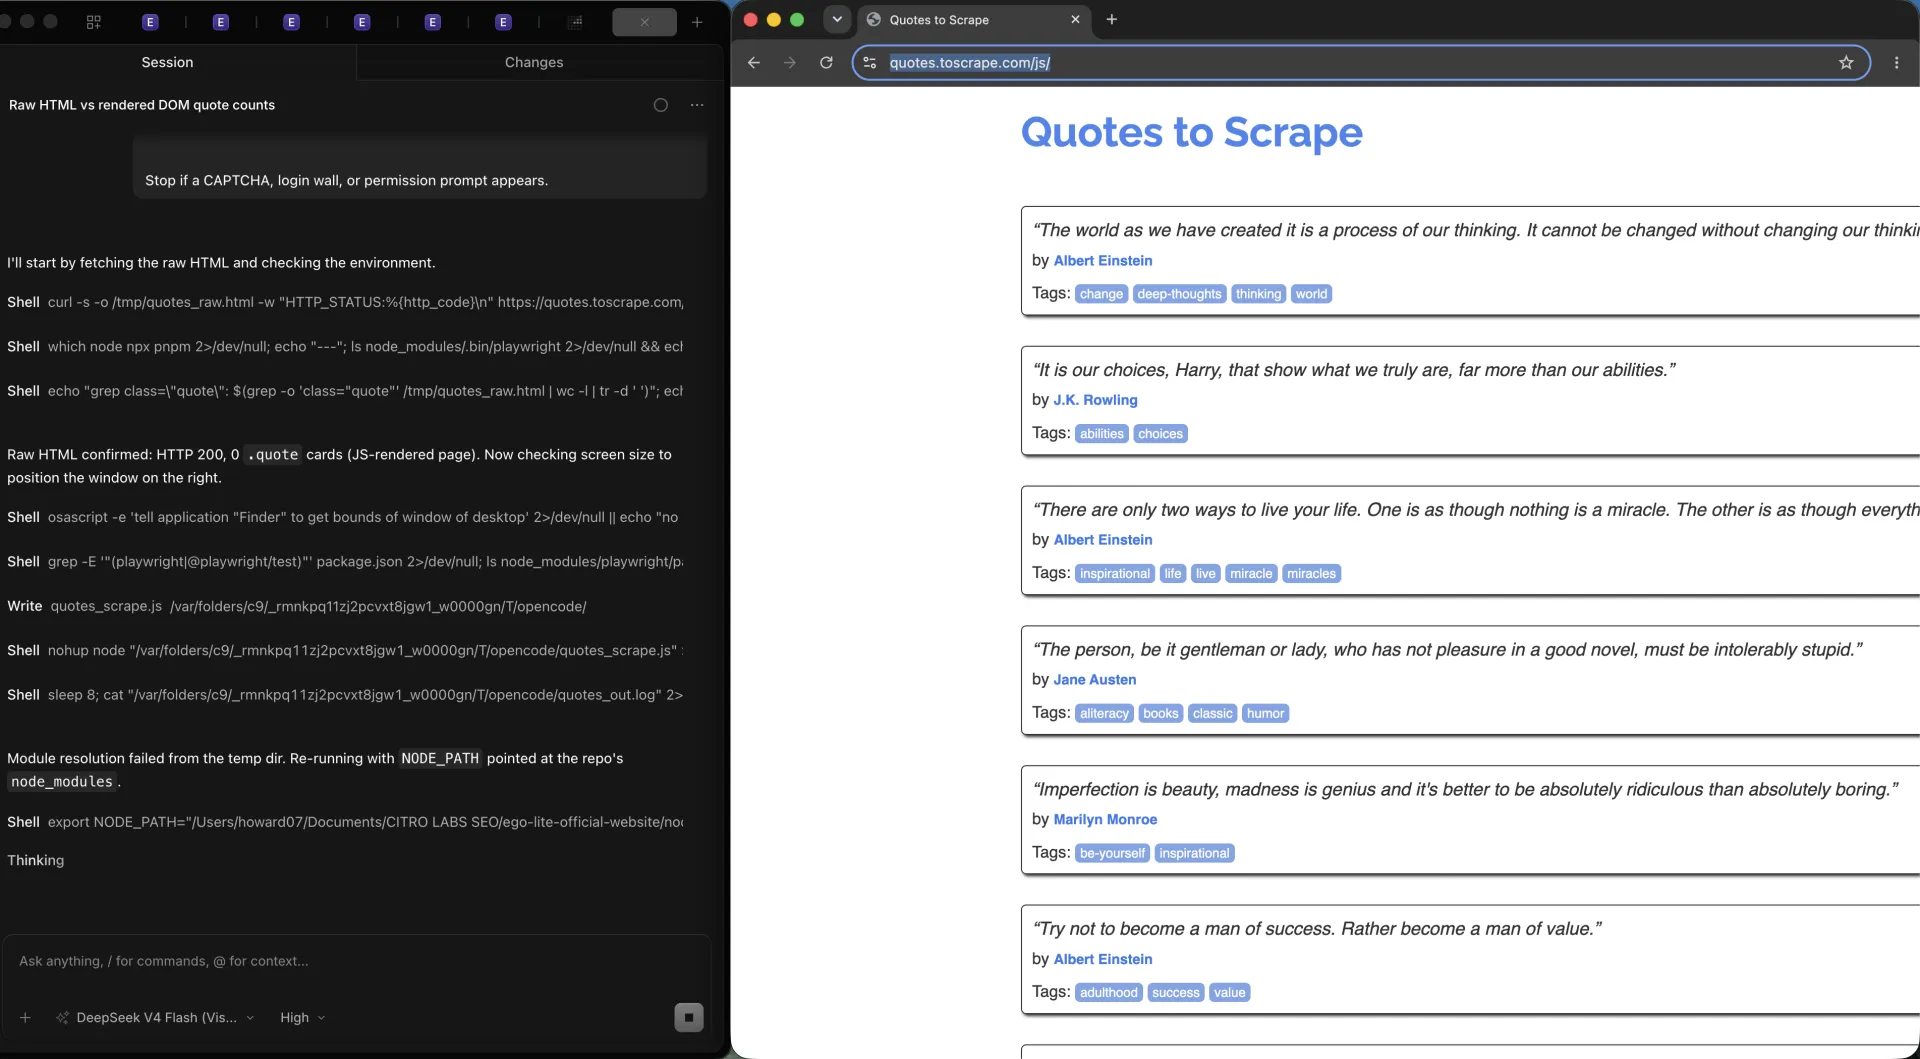
這個落差可以這樣看。
| 路線 | 它能做什麼 | 它不能做什麼 |
|---|---|---|
| HTTP GET + HTML 解析器 | 讀伺服器送來的位元組。便宜、快,卡片已經在標記裡時就夠用。 | 無法執行頁面指令碼,也無法等候稍後才出現的節點。對 quotes.toscrape.com/js,它在原始 HTML 裡看不到 .quote 卡片。 |
| 解析行內 payload | 在 quotes.toscrape.com/js,用 regex 加上對 var data 做 JSON.parse,就能從同一份 HTML 還原名言,不必開瀏覽器。 | 網站一改版、不再嵌入這個陣列,這條路就斷了。內部 payload 不是 API 契約。 |
| Playwright 渲染後的 DOM | 執行頁面 JavaScript,等候 .quote,再擷取人眼看到的卡片。 | 無法保持便宜。每個 context 都吃記憶體,拿一整批去打靜態 HTML 是錯工具。 |
這個示範還有一句實話:直接解析 var data 的話,其實不必 Playwright。多數 JS 網站不會把具名陣列留在第一次回應裡。它們不留的時候,Playwright 這條路還走得通。
怎麼啟動、導覽,並等候內容出現?
最小的 Playwright 抓取就是啟動、new context、goto、等候卡片選擇器、擷取、再關閉。跳過等候,就會得到一份成功寫出的空檔。
Playwright 的 page.goto 可以停在 commit、domcontentloaded、load 或 networkidle。waitForSelector 才是在確認你要的東西真的存在。在 quotes.toscrape.com/js,goto({ waitUntil: 'domcontentloaded' }) 有時就夠了,因為行內指令碼就寫在那份 HTML 裡。那是運氣,不是規則。
import { chromium } from "playwright";

const browser = await chromium.launch();
const context = await browser.newContext();
const page = await context.newPage();

try {
  await page.goto("https://quotes.toscrape.com/js/", {
    waitUntil: "domcontentloaded",
  });
  await page.waitForSelector(".quote");
  const rows = await page.evaluate(() =>
    [...document.querySelectorAll(".quote")].map((el) => ({
      text: el.querySelector(".text")?.textContent?.trim() ?? "",
      author: el.querySelector(".author")?.textContent?.trim() ?? "",
      tags: [...el.querySelectorAll(".tag")].map((tag) =>
        tag.textContent?.trim(),
      ),
    })),
  );
  console.log(rows.length);
} finally {
  await context.close();
  await browser.close();
}
想看到空抓取,就在 commit、卡片還不存在時擷取,或把畫卡片的指令碼延後。那樣提早擷取會回傳 0 筆。等 waitForSelector('.quote') 之後,同一頁才回傳渲染後的卡片。空結果時什麼例外都不丟。
| 等候 | 它證明什麼 | 它怎麼失敗 |
|---|---|---|
| 只等到 commit | 導覽已開始。適合當反向測試。 | 指令碼可能還沒跑。在 commit、畫家還沒動手前擷取,會拿到 0 則名言。 |
| domcontentloaded | 初始 HTML 已解析。這個示範夠用,因為 var data 就寫在那份 HTML 裡。 | 晚到的 XHR 卡片仍可能缺席。別把它當成「內容已就緒」。 |
| waitForSelector('.quote') | DOM 裡至少有一張卡片。這次等候才把示範變成可抓的資料列。 | 過期的 class 可能對到上一份清單。要等候會隨資料變動的欄位,不要等一個永遠不消失的外層。 |
在 finally 裡關閉 context。記憶體是 context 佔住的。擷取中途丟例外,還是得把 Chromium 放掉。
怎麼從渲染後的頁面擷取欄位?
用 page.evaluate 在頁面內擷取;只要單一控制項而不是清單時,改用 locator。兩者都讀渲染後的 DOM,都不會去讀 goto 當下的原始 HTML 快照。
把每張 .quote 對到 text、author、tags。公開示範會畫十張卡片。必填欄位是 text 與 author。唯一鍵是名言文字,不是作者,因為 Einstein 會出現不只一次。
同一段 OpenCode 工作階段裡,我們測過這次擷取。等 waitForSelector('.quote') 之後,headed 執行印出 10 筆、10 則不重複文字、0 筆缺作者。原始 HTML 仍是 0 張卡片。
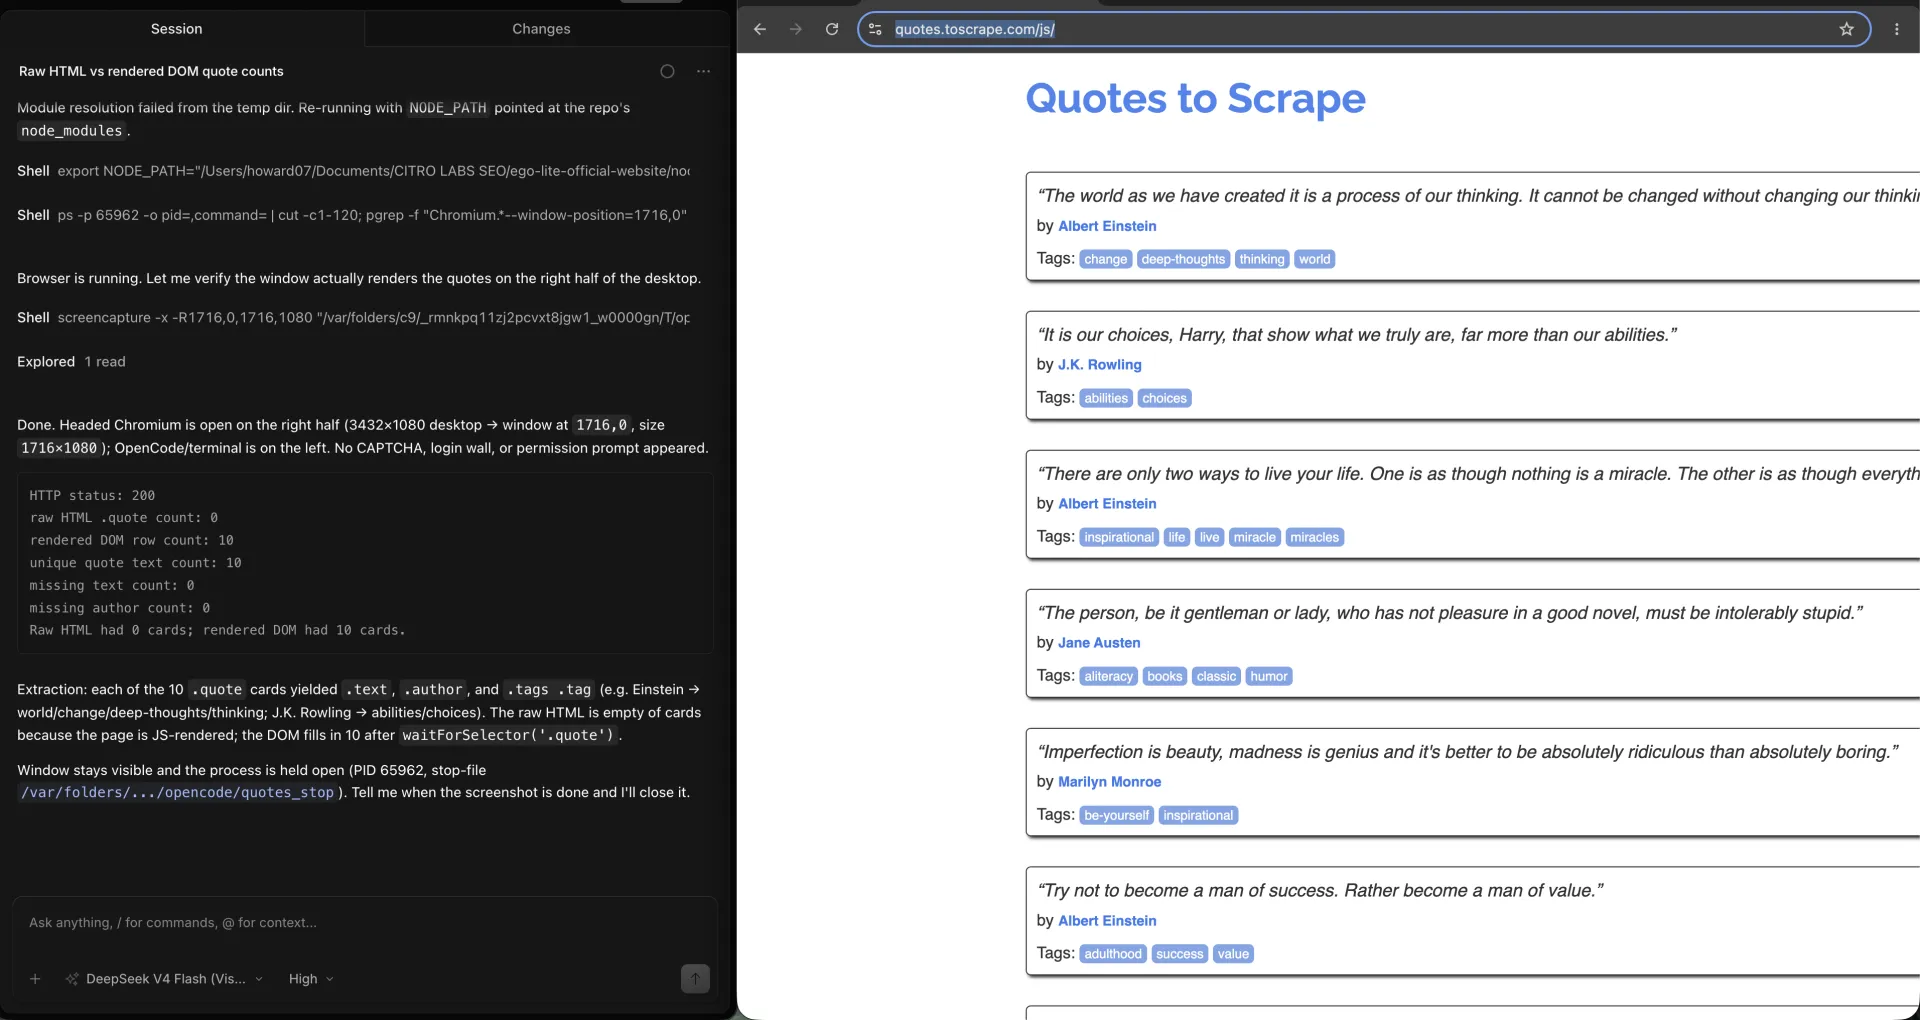
只要單一欄位時,locator 比較乾淨。Playwright locator 在每次動作前會重新查詢,所以頁面重繪時,已存的 element handle 會壞,locator 還在。
const title = await page.locator(".quote .text").first().innerText();
const author = await page.locator(".quote .author").first().innerText();
清單擷取比較適合 page.evaluate。它跑在頁面裡,並回傳 JSON。mapper 保持精簡。只拉 text、author、tags 與唯一鍵。截圖與 PDF 不要放進抓取迴圈。
被 CSS 藏起來的文字仍在 DOM 裡。innerText 跟版面走,textContent 不跟。網站用 CSS 截斷標題時,textContent 仍會給你完整字串。寫驗證器之前,先決定你要收哪一種。
怎麼攔截頁面自己的資料?
頁面本來就會抓一份可直接存檔的 JSON、不必再從卡片解析時,攔截才有用。quotes.toscrape.com/js 根本不發那個請求,重點就在這裡。
那個示範裡的名言不是來自 API。它們以 var data 嵌在 HTML 裡,再由 jQuery 畫成 .quote 節點。專門聽 JSON 的 response listener 什麼有用的都看不到。
Playwright 的 網路文件 說明了 page.route 與 response listener。去用。然後把頁面實際送出的東西記下來,包括什麼都沒有。
const jsonResponses = [];
page.on("response", async (response) => {
  const type = response.headers()["content-type"] || "";
  if (type.includes("json")) {
    jsonResponses.push({
      url: response.url(),
      status: response.status(),
    });
  }
});
await page.goto(url, { waitUntil: "domcontentloaded" });
await page.waitForSelector(".quote");
console.log(jsonResponses.length);
沒有 JSON 內容時,退回渲染後的卡片,或解析你已經下載的行內指令碼。別因為教學總會秀一個端點,就自己發明一個。Oxylabs、BrowserStack、ScraperAPI 都示範攔截。它們沒告訴你,網站根本不發請求時會怎樣。
怎麼驗證欄位、重複與筆數?
腳本以 0 結束,不代表抓取完成。檔案有預期筆數、每個必填欄位都在、唯一鍵沒把兩列併成一列,才算完成。
這個示範通過的擷取會寫出十筆、文字不重複、沒有缺作者。卡片還不存在就擷取,會寫出 0 筆;若不檢查筆數,同一個開心 logger 還是會說沒事。
function validate(rows, expectedCount) {
  const missing = rows.filter((row) => !row.text || !row.author);
  const unique = new Set(rows.map((row) => row.text));
  if (rows.length !== expectedCount) {
    throw new Error(`expected ${expectedCount}, got ${rows.length}`);
  }
  if (missing.length) {
    throw new Error(`${missing.length} rows missing text or author`);
  }
  if (unique.size !== rows.length) {
    throw new Error("duplicate texts");
  }
}
用一份短清單,失敗就大聲報錯。
| 檢查 | 通過 | 要保留的失敗模式 |
|---|---|---|
| 預期筆數 | waitForSelector('.quote') 之後十張卡片 | 畫家還沒動手前擷取,就是 0 筆 |
| 必填欄位 | 每一資料列都有 text 與 author | 對到卡片、卻漏掉 .author 的選擇器 |
| 唯一鍵 | 不重複的名言文字,不是不重複的作者 | 用作者去重,會把 Einstein 併掉 |
空擷取要留著。0 筆結果就是等候很重要的證據。刪掉它,後來那次完整擷取看起來會像預設值。
Playwright 抓取會在哪裡壞掉?
這裡真正要緊的失敗是空渲染、過期選擇器,以及頻率限制。若你只在吞掉錯誤的 catch 之後印資料列長度,它們都不會變成紅色 stack trace。
空渲染:導覽成功,選擇器從未對上,你存了 []。去修等候。別對同一個還沒完成的 DOM 重跑同一段擷取。
過期選擇器:.quote 還在,文字卻搬走了。這次執行回傳昨天的 10 筆。等候會隨內容變動的欄位,再拿唯一鍵跟上一份檔案做 diff。
頻率限制:429 是停的訊號。有 Retry-After 就讀它,後退,並幫重試設上限。猛打同一個 URL,IP 就會被擋。本指南不談繞過。
async function gotoWithRetry(page, url, attempt = 0) {
  const response = await page.goto(url, { waitUntil: "domcontentloaded" });
  const status = response?.status() ?? 0;
  if (status === 429 || status >= 500) {
    if (attempt >= 3) throw new Error(`giving up on ${url}: ${status}`);
    const retryAfter = Number(response?.headers()["retry-after"]);
    const waitMs = Number.isFinite(retryAfter)
      ? retryAfter * 1000
      : 2 ** attempt * 1000;
    await page.waitForTimeout(waitMs);
    return gotoWithRetry(page, url, attempt + 1);
  }
  if (status && status >= 400) throw new Error(`${status} for ${url}`);
  return response;
}什麼時候改用看得見的瀏覽器 Agent 比較好?
等候不對、選擇器搬走,或必須有人看著頁面接手時,看得見的瀏覽器 Agent 比較合適。它不是你已在 CI 信任的那段凍結 Playwright 迴圈的替代品。
這是互補,不是對手。Playwright 把已經搞清楚的等候寫進腳本。ego (lite) 0.5.0.32 把任務放在可監看的 Chromium Space,卡片出現時看得到,Agent 可以停,等候在說謊時也可以由人接手。下一次抓取需要既有登入時,它重用真實設定檔。它不會讓靜態 HTML 頁變更便宜,也不會繞過封鎖。該版本的更新紀錄日期是 2026-09-12,見 ego (lite) 更新紀錄。
我們從 OpenCode 在 ego (lite) 測過這層隔離。Spaces 總覽把名言抓取放在自己正在跑的 Space,其他工作在另一個 Space,而不是共用同一個 headed Chromium 視窗。
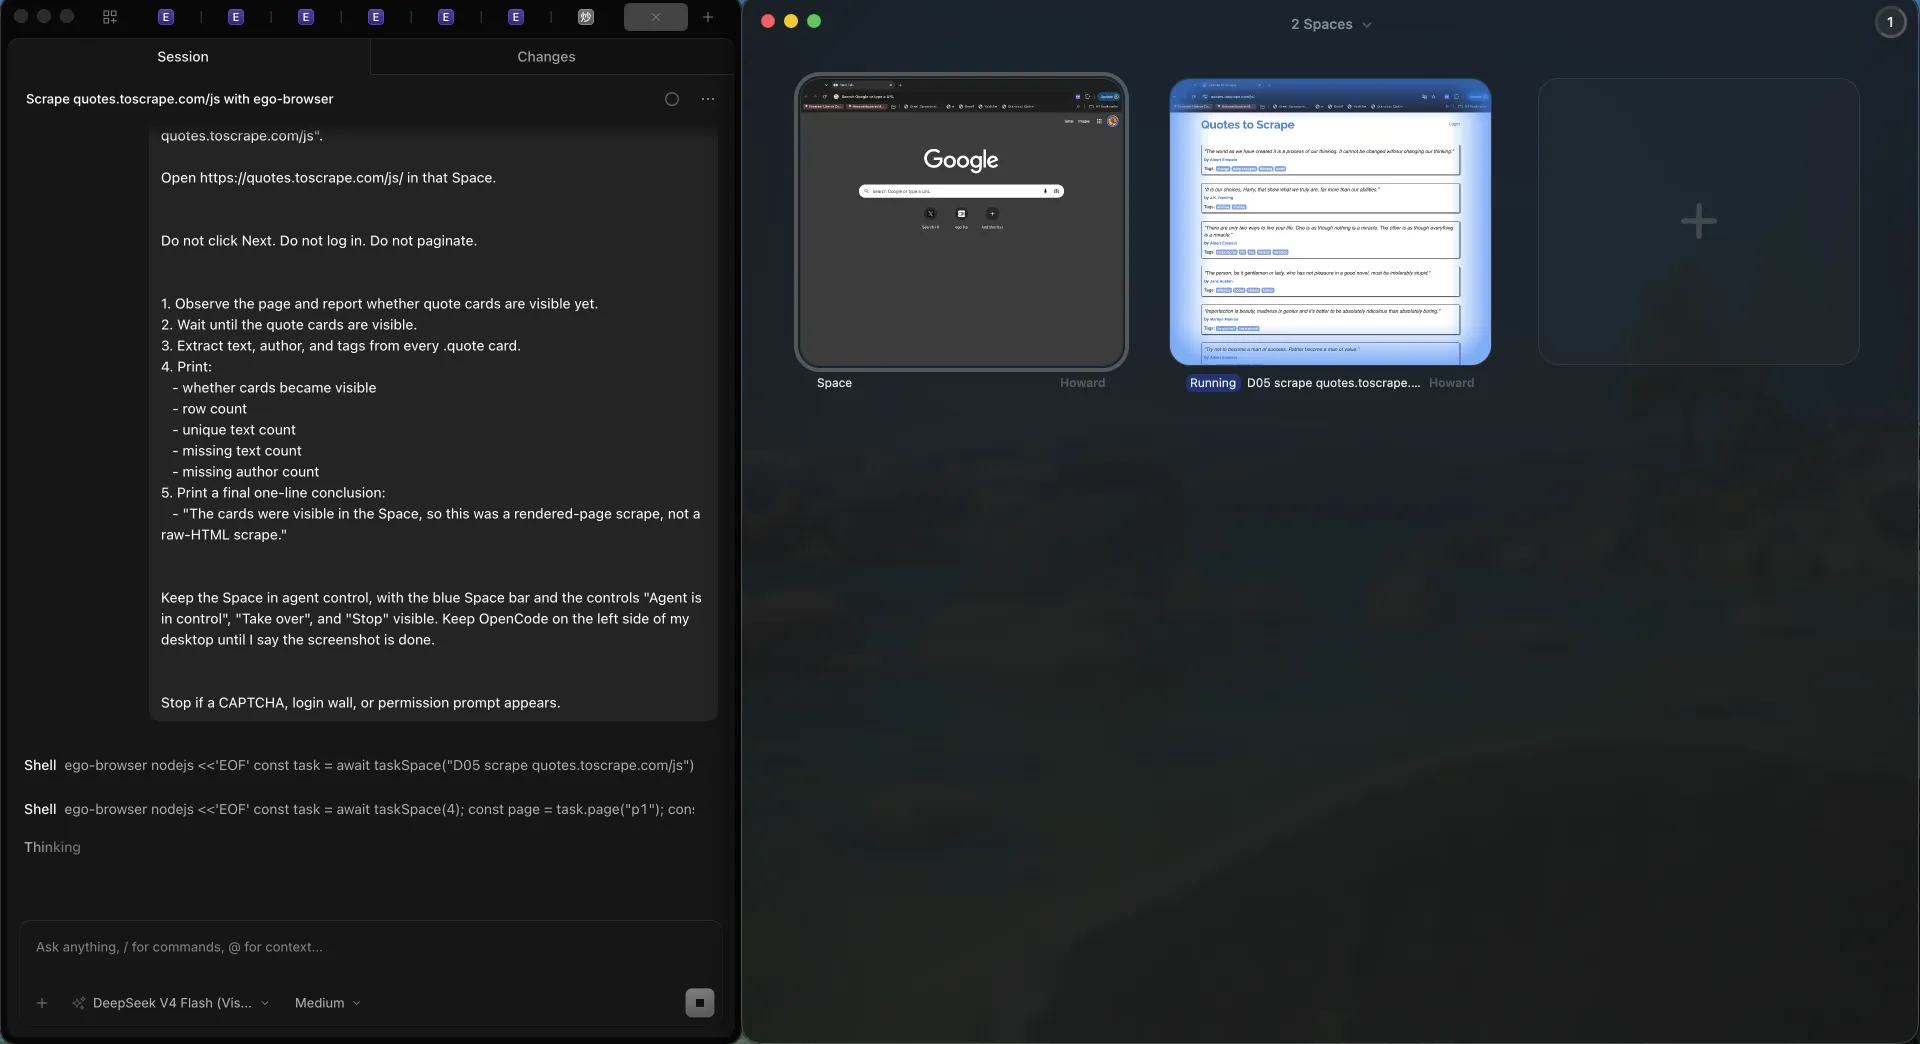
我們在其中一個 Space 裡測過同一個公開 URL。Space 4 在 quotes.toscrape.com/js 維持 agent control,Take over 與 Stop 看得到,並印出 10 張不重複卡片。
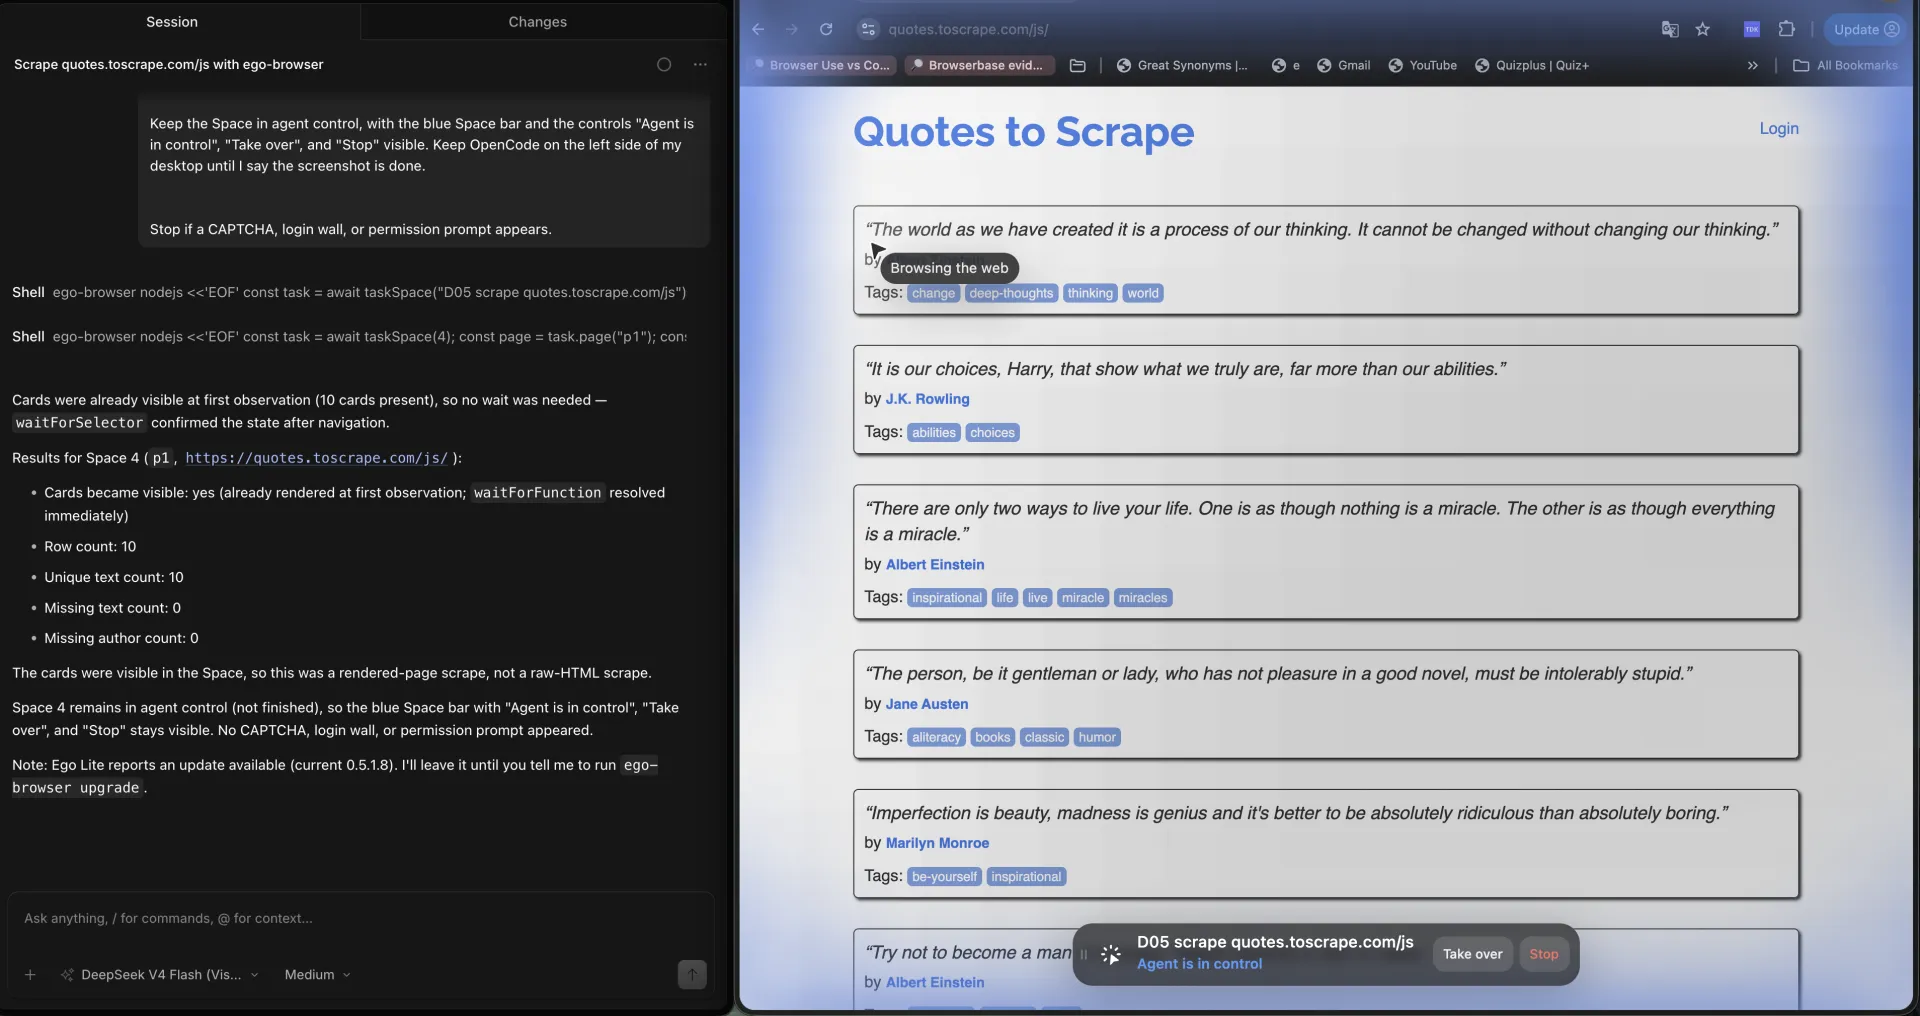
無頭與 headed 的取捨見 面向 AI Agent 的無頭瀏覽器與真實瀏覽器比較。函式庫選擇見 用 Playwright 還是 Puppeteer 抓取。產品層級對照見 ego (lite) 與 Playwright 比較。
挑戰與限制有哪些?
Playwright 抓取的失敗比 HTTP 更安靜,因為瀏覽器看起來正常,檔案卻是錯的。
第一個限制是成本。一個 Chromium context 不是一次 GET。卡片已經在 HTML 裡時,你是在為不需要的瀏覽器付費。
第二是對攔截要誠實。教學把攔截 XHR 當成進階招。這個示範裡,進階的是承認 payload 就在行內。
第三是多頁,這裡只留一行限制。單一渲染頁驗證通過後,編號頁、Load More 與無限捲動才是另一份工作。把那些迴圈混進這頁的等候與擷取,會把空 DOM 失敗藏起來。
第四是權限。robots 規則、條款與個人資料法仍然適用。headed 瀏覽器不會因此取得蒐集權。
抓取是空的、頁面卻看起來滿的,就先等候卡片,再數資料列。headed 視窗不是證據。這個示範的攔截也沒找到 JSON XHR;名言本來就以 var data 寫在行內。
常見問題
Playwright 適合抓網頁嗎?
可見卡片不在原始 HTML、爬蟲又能在真實瀏覽器裡等候時,Playwright 適合抓。quotes.toscrape.com/js 是公開例子:GET 回傳沒有 .quote 節點,等候 .quote 就能讀到畫好的卡片。靜態 HTML 或已有文件的 API,不該預設走這條。
什麼時候該用 HTTP,而不是 Playwright?
數值已經在回應內容裡時,用 HTTP。這個 JavaScript 示範仍有帶著名言的 var data,即使沒有 .quote 卡片。若解析那段 payload 夠穩,就別開瀏覽器。
為什麼 Playwright 抓下來是 0 筆?
0 筆通常代表卡片還沒出現就擷取了。這個示範在 commit、畫家還沒動手前讀 DOM,會拿到 0 則名言;等 waitForSelector('.quote') 之後才是渲染後的卡片。空結果時沒有例外。
該不該等候 networkidle?
等候代表資料的選擇器,不要等網路安靜。networkidle 可能卡在分析 beacon。這個示範通過的等候是 .quote,不是 networkidle。
怎麼用 Playwright 攔截 JSON?
聽 content-type 含 json 的回應,或 route 頁面本來就會呼叫的 URL。quotes.toscrape.com/js 的名言在行內,沒有 JSON XHR 可抓。攔截是可選的。DOM 等候仍然有效。
單頁抓完後,多頁清單怎麼辦?
先完成單一渲染頁:等候、擷取、核對筆數。編號頁、Load More 與無限捲動是另一份工作。這頁不寫那些迴圈。
Playwright 抓取要怎麼重用登入狀態?
在你有權使用的登入之後存 storage state,之後的 context 再載入。把檔案當機密,並預期它會過期。
遇到 429 該怎麼辦?
停。有 Retry-After 就遵守,後退,並在很小的重試上限後失敗。429 是頻率訊號,不是選擇器問題。
用 Playwright 抓網頁一定要裝 ego (lite) 嗎?
不必。等候與選擇器已經確定時,用 Playwright。抓取需要可監看的 Space、真實已登入設定檔,或人工接手時,用 ego (lite)。2026-09-18 兩條路都從 quotes.toscrape.com/js 擷取到 10 張不重複卡片;Space 仍看得到 Take over 與 Stop。
用真實瀏覽器抓取合法嗎?
取決於網站、資料、司法管轄區,以及你拿檔案做什麼。headed 瀏覽器裡,robots 規則與條款仍然適用。這不是法律建議。
抓網頁該用 Playwright 還是 Puppeteer?
兩者都能渲染同一頁。函式庫差異在 locator、等候與語言綁定。這頁的 HTTP 對瀏覽器決策要先做。
若下一次抓取需要可監看的瀏覽器,而不是再寫一段等候,ego (lite) 可免費下載。價格爬蟲 示範就是那個 Space 裡的一份具體工作。
